
Curso
Introducción a la regresión en R
4 h
78.5K
Si pudiera recomendarte aprender a fondo una sola cosa para ser mejor analista de datos o data scientist, sería la regresión. Y una parte clave de aprender regresión es entender exactamente qué es la heterocedasticidad.
En este artículo, veremos el fenómeno de la heterocedasticidad, por qué importa, cómo identificarla y qué pasos seguir para abordarla. Seré completo pero iré al grano. Así que, tanto si ya tienes experiencia como si acabas de empezar, espero que encuentres aquí algo útil e interesante. Para ampliar y empezar tu camino hacia el dominio del tema, haz nuestro Intro to Regression in R o nuestro Intro to Regression in Python. También tengo un tutorial sobre regresión lineal simple, por si necesitas un repaso rápido.
Entonces, ¿qué es exactamente la heterocedasticidad? Quitémonos de encima las definiciones técnicas antes de ver algunos ejemplos. Si se te traba la palabra, como a mí, puedes decir "varianza desigual" y te harás entender.
La heterocedasticidad se refiere a una situación en la que la variabilidad de una variable dependiente no es constante a lo largo del rango de valores de una variable independiente. O, con una definición más anclada en la construcción de modelos, podemos decir que hay heterocedasticidad cuando la dispersión de los residuos no es constante, como a veces vemos en un modelo de regresión o en un modelo de series temporales.
En cierto modo, prefiero esta segunda definición porque nos recuerda que la heterocedasticidad es en realidad un aspecto común (aunque también un problema frecuente) del modelado estadístico. Pero, para que quede claro, aunque la heterocedasticidad se comenta sobre todo en el contexto de modelos como la regresión, puede ser tanto una característica de la especificación del modelo como una propiedad de los propios datos.
Veamos algunos ejemplos con R y elijamos un ámbito: las finanzas del hogar. Para empezar, mostraré la clásica forma de embudo o abanico que es la que me viene a la cabeza cuando pienso en varianza desigual.
Esta versión de heterocedasticidad puede darse, por ejemplo, en datos de ingresos frente a gastos: los hogares con ingresos más bajos suelen tener un gasto mensual más estable centrado en lo esencial (alquiler, comida), lo que implica poca variabilidad; en cambio, los hogares con ingresos más altos pueden mostrar mayor variabilidad porque solo algunos optan por compras discrecionales caras (vacaciones, lujo) mientras que otros ahorran. Así que, en este ejemplo, a medida que aumentan los ingresos, también aumenta la variabilidad del gasto mensual: de ahí la forma de abanico.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )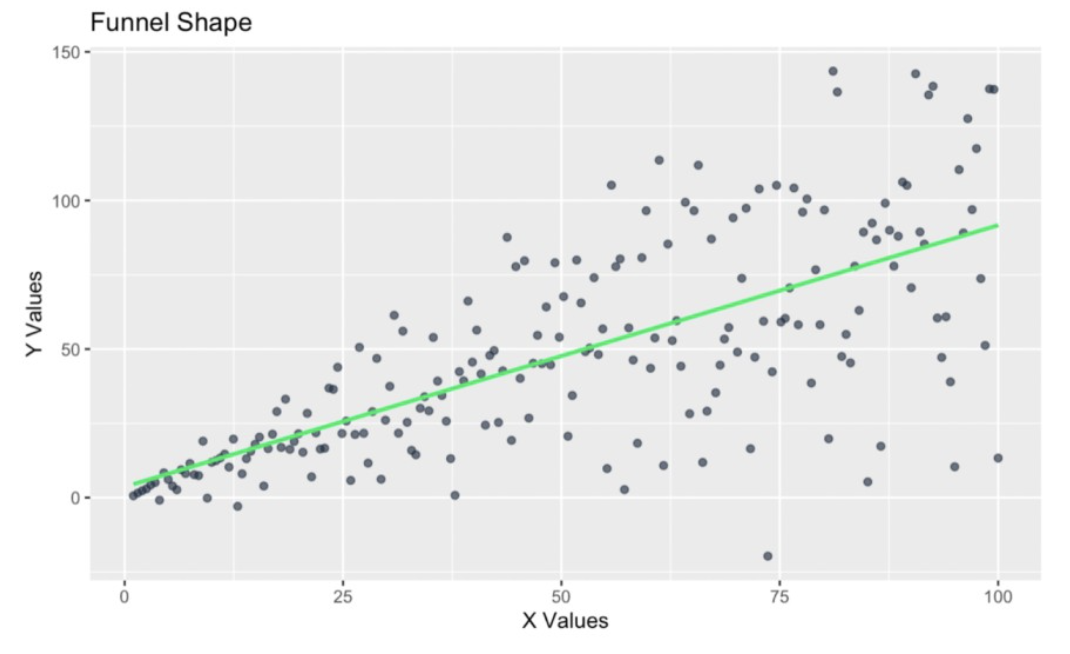
Forma de embudo en los residuos. Imagen del autor
Probemos otro ejemplo, también en el ámbito de las finanzas del hogar. Imagina ahora que creamos un modelo de regresión para mostrar la variabilidad del ahorro según la edad de las personas del hogar.
Sospechamos que estos datos mostrarán heterocedasticidad porque los hogares más jóvenes podrían tener una alta variabilidad en el ahorro por ingresos irregulares (trabajos por encargo, prácticas) o gastos imprevistos (préstamos estudiantiles, formar una familia). Pero, a medida que el hogar envejece y se estabiliza financieramente, el comportamiento de ahorro se vuelve más consistente, creando una forma de embudo inverso donde la variabilidad disminuye con la edad.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )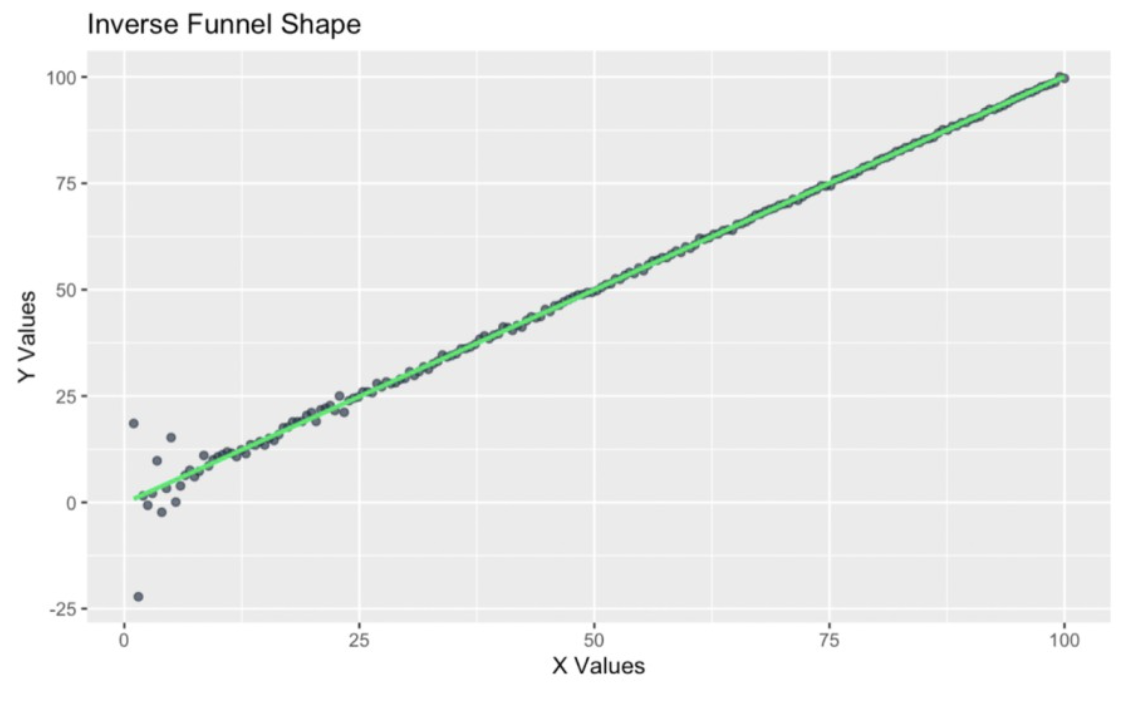
Forma de embudo inverso en los residuos. Imagen del autor
Veamos un último ejemplo con ingresos del hogar. Aquí observamos varianza cíclica, en concreto la variación del gasto a lo largo de las estaciones. Puede que reconozcas este patrón si has hecho alguno de nuestros cursos de forecasting, como el popular Forecasting in R.
Sabemos que el gasto de los hogares fluctúa de forma cíclica a lo largo del año. Por ejemplo, la varianza puede aumentar en épocas navideñas por compras de regalos o viajes para ver a la familia, y disminuir en otros meses con menos festivos, quizá marzo o septiembre. El siguiente gráfico muestra heterocedasticidad, pero de forma más compleja, aumentando y disminuyendo en distintos periodos.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )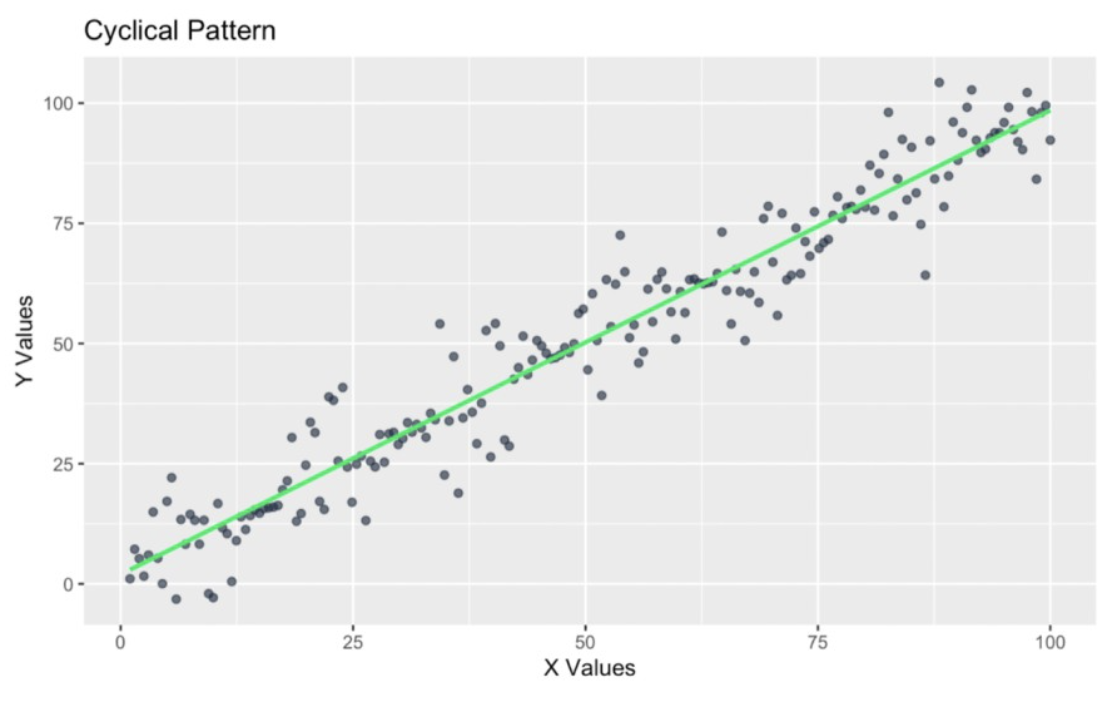
Patrón cíclico en los residuos. Imagen del autor
Como ves, la heterocedasticidad puede adoptar varias formas. Veamos ahora por qué todo esto importa.
Me atrevería a decir que, en general, no puedes hacer regresiones correctamente sin entender algo sobre heterocedasticidad, ya que es tan común y puede distorsionar tanto los resultados.
Probablemente por eso la homocedasticidad —lo contrario de la heterocedasticidad— es una de las principales suposiciones de los modelos de regresión, junto con la linealidad, la independencia de errores, la normalidad de residuos y la ausencia de multicolinealidad.
Estas suposiciones importan porque ayudan a garantizar que las predicciones e inferencias del modelo sean significativas. Cuando se incumplen, la fiabilidad de las estimaciones —incluyendo errores estándar e intervalos de confianza— puede deteriorarse y nuestros tests de hipótesis pierden validez.
La heterocedasticidad no aparece de la nada. A menudo tiene su origen en cómo se recogen o transforman los datos. Veamos tanto problemas de transformación como de recogida de datos.
A veces, los pasos que damos para preparar los datos pueden introducir heterocedasticidad. Pienso en cómo un escalado inadecuado o transformaciones no lineales pueden crear variabilidad no deseada.
Para entenderlo, imaginemos que estudiamos la relación entre el tamaño de un piso y su alquiler mensual. Normalmente, esperaríamos una relación lineal entre tamaño y alquiler porque los pisos más grandes cuestan más, y la varianza del alquiler no tendría por qué aumentar con el tamaño si la relación (podría ser) proporcional. Así podría verse:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")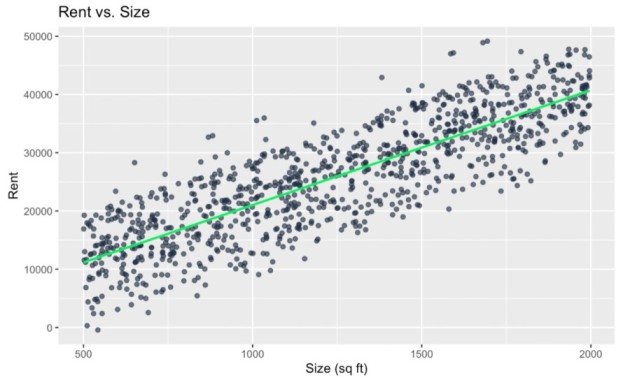
Sin heterocedasticidad. Imagen del autor
Si escalamos el alquiler por el tamaño para calcular el "alquiler por pie cuadrado", creamos una nueva métrica. Si luego intentamos predecir el alquiler por pie cuadrado en función del alquiler, podríamos ver que esta transformación crea o exagera la heterocedasticidad. Para ser claros, en general reconozco que no es buena idea dividir la variable dependiente por la independiente, porque estamos creando una situación en la que y ya está influida por x y, por tanto, inducimos una correlación espuria. Así que soy consciente de los retos conceptuales y estadísticos. Pero (tenme paciencia) uso esto como ejemplo para ilustrar la idea:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")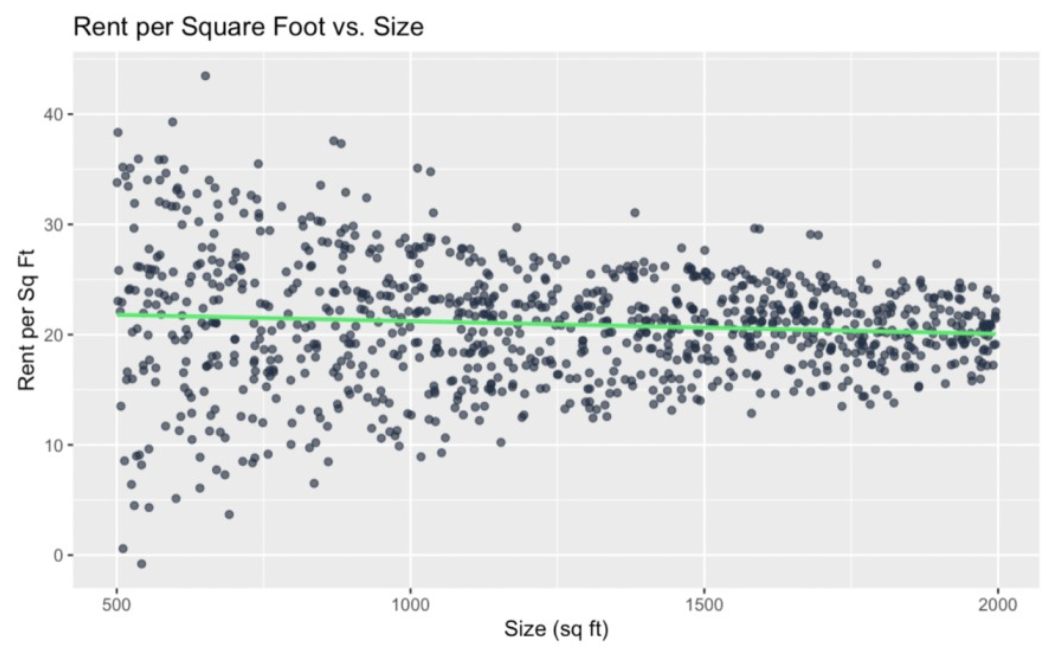
Heterocedasticidad inducida por dependencia funcional. Imagen del autor
Vemos una forma de embudo donde la variabilidad del alquiler por pie cuadrado disminuye a medida que aumenta el tamaño. Es decir, hemos creado heterocedasticidad de la nada. Para otro ejemplo, podemos elevar ambas variables al cuadrado:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")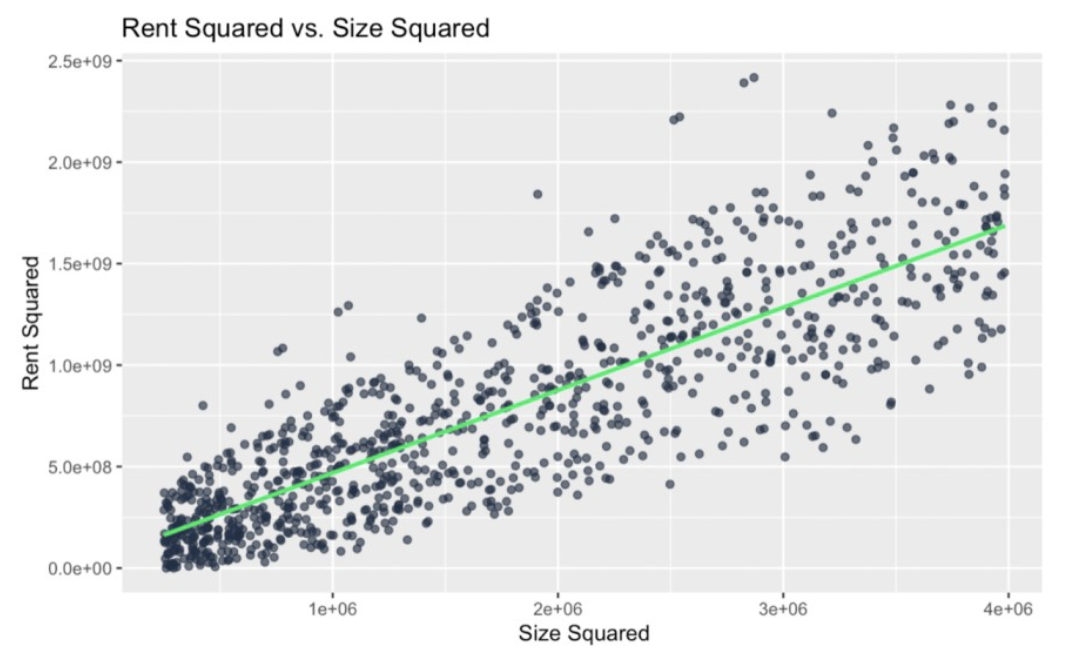
Heterocedasticidad inducida al elevar al cuadrado. Imagen del autor
De nuevo, hemos creado heterocedasticidad donde antes no existía simplemente por insistir en elevar x e y al cuadrado. En algunos contextos no pasaría nada, pero aquí sospechaba que esta transformación amplificaría las diferencias de varianza a medida que crecieran los valores de las variables.
Este segundo ejemplo también es un poco forzado porque no deberíamos construir este modelo: sería difícil de interpretar sin motivo. Pero, en un flujo de trabajo real, las transformaciones que crean heterocedasticidad sin querer pueden ser más sutiles, y se te pueden pasar por alto si el proceso tiene muchos pasos.
Más exactamente, en este caso la heterocedasticidad ha surgido por ingeniería de características con razones. Razones como "alquiler por pie cuadrado" son habituales en feature engineering. Sin embargo, estas variables pueden introducir heterocedasticidad si, en particular, el denominador varía mucho entre observaciones. Las transformaciones logarítmicas o exponenciales también se usan a menudo para estabilizar la varianza o linearizar relaciones. Pero aplicarlas de forma inconsistente puede salir mal. Imagina que en un modelo transformas ingresos con logaritmo, pero no ajustas variables relacionadas como el gasto. Este desajuste es una fuente común de heterocedasticidad, así que asegúrate de alinear todo para no inducir dinámicas falsas.
La heterocedasticidad también puede deberse a prácticas inconsistentes de recogida de datos. Por ejemplo, cambiar el instrumento de medición a mitad de un estudio puede introducirla. Tener grupos de distinto tamaño y, por tanto, distintos tamaños muestrales en un estudio también puede crear heterocedasticidad. Mantener un enfoque coherente importa.
Detectarla es el primer paso para abordarla, y por suerte contamos con herramientas visuales y estadísticas.
Los diagramas de dispersión pueden revelar patrones que delatan heterocedasticidad. Me gusta el gráfico de valores ajustados frente a residuos para esto. Ojo: un histograma de residuos o un gráfico q-q de residuos no basta para detectarla, porque estos gráficos sirven sobre todo para evaluar normalidad.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")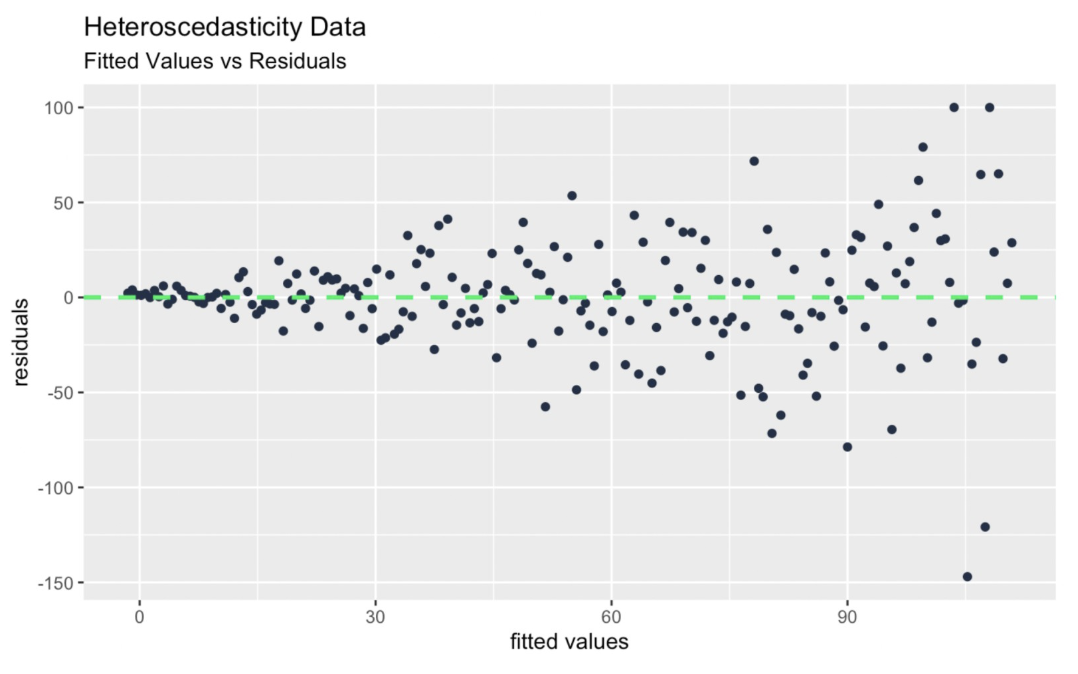 Gráfico de diagnóstico: valores ajustados vs. residuos. Imagen del autor
Pruebas como el test de Breusch-Pagan ofrecen un enfoque más cuantitativo. El Breusch-Pagan comprueba si los residuos al cuadrado del modelo están relacionados con los predictores. Para realizarlo, ajustamos el modelo y usamos la función bptest() de la librería lmtest. Ten en cuenta que la prueba asume residuos normales.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Una vez identificada, el siguiente paso es atajarla con técnicas contrastadas.
Transformaciones sencillas, como aplicar logaritmos, suelen reducir o eliminar la heterocedasticidad. Antes tomamos un modelo sin varianza desigual, aplicamos transformaciones y generamos problemas, pero lo normal es lo contrario: usamos transformaciones como logaritmos, raíces cuadradas o recíprocos para comprimir valores grandes y expandir los pequeños. Por ejemplo, si el alquiler creciera exponencialmente con el tamaño, hacer log del alquiler aplanaría el crecimiento exponencial y haría la relación lineal con (quizá) varianza más uniforme.
Además, cuando preparamos datos solemos pensar en corregir la asimetría. Por ejemplo, si tenemos datos asimétricos a la derecha, podríamos usar una raíz cuadrada para acercarlos a una distribución gaussiana. Pero quizá no apreciamos tanto que, en datos sesgados, los valores grandes también tienden a tener mayor variabilidad, lo que también vulnera la homocedasticidad.
Cuando las transformaciones no bastan, métodos robustos como la mínimos cuadrados ponderados (WLS) pueden ayudar. WLS es especialmente interesante aquí porque está diseñado para lidiar con problemas como heterocedasticidad y outliers. En concreto, asigna pesos a las observaciones en función de su varianza, reduciendo la influencia de los puntos con mayor variabilidad y ofreciendo estimaciones más estables. Ojo: con WLS asumimos que los pesos son bien conocidos o bien estimados.
Ignorarla puede parecer inofensivo, pero acarrea problemas.
La heterocedasticidad puede distorsionar cómo interpreta un modelo la importancia de las variables. Por ejemplo, en un modelo de gasto, variables como ingresos pueden parecer más relevantes si están ligadas a grupos con alta variabilidad, como hogares de renta alta con compras discrecionales. Esta mala representación puede llevarnos a sobrevalorar predictores menos fiables y a infravalorar otros más consistentes, afectando la utilidad del modelo.
La heterocedasticidad puede invalidar el uso de pruebas habituales como t o F si asumes varianzas iguales y esta suposición no se cumple. La varianza desigual también es problemática en series temporales, donde los patrones de variabilidad evolucionan con el tiempo, generando confusión al analizar tendencias estacionales. Las errores estándar consistentes ante heterocedasticidad (HCSE) pueden ayudar a lograr una inferencia más fiable.
En este artículo hemos estudiado la situación en la que la varianza de los residuos no es constante a lo largo de los niveles de una variable independiente en un modelo. Aquí quiero hablar brevemente de una idea relacionada: la heterogeneidad de varianza a nivel de grupo, que se refiere a la variabilidad entre grupos predefinidos. Es menos un problema estadístico ligado a suposiciones del modelo y más una observación descriptiva de los datos.
Lo muestro con un ejemplo final usando una simulación de datos de encuesta. Considero un escenario en el que los ingresos se recogen con dos métodos: encuestas y registros administrativos. Estos métodos pueden tener distinta precisión (¿no son las encuestas famosas por esto?). Vemos que la cantidad de variación dentro de cada grupo no es consistente, lo que podría ser un problema para algo como un ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)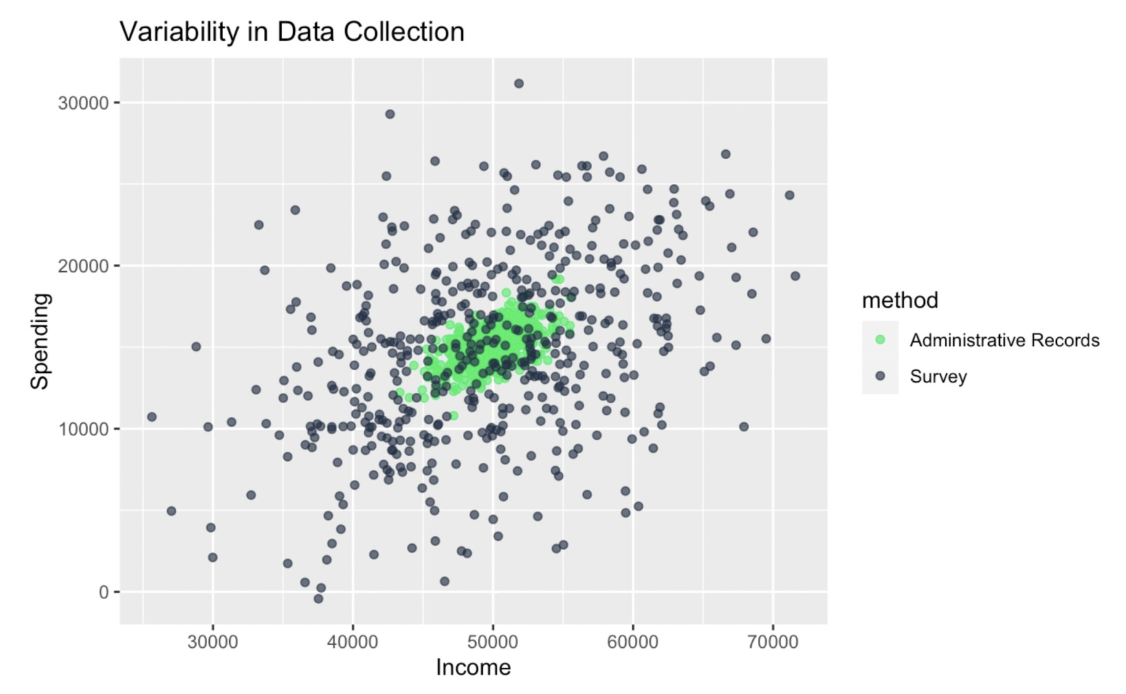
Heterogeneidad de varianza a nivel de grupo. Imagen del autor
Abordar la heterocedasticidad no es solo mejorar tu modelo de regresión. Es asegurarte de que tu trabajo aguanta el escrutinio. Para seguir aprendiendo y convertirte en experto, haz nuestro itinerario Statistical Inference in R y el curso Foundations of Inference in R. También creo que nuestro Statistician in R es otra gran opción tanto para aprender como para tu desarrollo profesional.
Aprende regresión con DataCamp
Curso
Curso
Curso
Tutorial
Arunn Thevapalan
9 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Łukasz Deryło
10 min


