
Cours
Introduction à la régression dans R
4 h
78.5K
S’il ne fallait approfondir qu’un seul sujet pour devenir un meilleur data analyst ou data scientist, ce serait la régression. Et un élément clé pour bien la maîtriser, c’est de comprendre précisément ce qu’est l’hétéroscédasticité.
Dans cet article, nous allons définir le phénomène d’hétéroscédasticité, voir pourquoi il compte, comment l’identifier et quelles actions entreprendre pour y remédier. Je serai complet tout en allant droit au but. Que vous soyez analyste confirmé ou que vous débutiez, j’espère que vous y trouverez des idées utiles. Pour aller plus loin et amorcer votre parcours d’expert, suivez notre cours Intro to Regression in R ou notre Intro to Regression in Python. J’ai également rédigé un tutoriel sur la régression linéaire simple pour un rappel express.
Concrètement, qu’est-ce que l’hétéroscédasticité ? Commençons par la définition technique avant de passer aux exemples. Si le terme vous fait trébucher, dites simplement « variance inégale », le sens y est.
L’hétéroscédasticité désigne une situation où la variabilité d’une variable dépendante n’est pas constante sur l’ensemble des valeurs d’une variable indépendante. Ou, pour une définition ancrée dans la modélisation, on peut dire qu’il y a hétéroscédasticité lorsque l’étendue ou la dispersion des résidus n’est pas constante, comme on l’observe parfois dans un modèle de régression ou de série temporelle.
À vrai dire, je préfère cette seconde définition car elle rappelle que l’hétéroscédasticité est un aspect courant (même si problématique) de la modélisation statistique. Pour être clair, si l’on en parle surtout dans le contexte des modèles de régression, elle peut relever à la fois de la spécification du modèle ou d’une propriété intrinsèque des données.
Voyons quelques exemples avec R et prenons le thème des finances des ménages. Pour commencer, voici la forme classique en entonnoir ou en éventail, celle à laquelle je pense d’abord quand je parle de variance inégale.
Cette version peut apparaître, par exemple, sur des données « revenu vs dépenses » : les foyers à faibles revenus ont souvent des dépenses mensuelles régulières concentrées sur les essentiels (loyer, alimentation), donc une faible variabilité ; à l’inverse, les foyers à hauts revenus présentent davantage de dispersion car certains optent pour des achats discrétionnaires coûteux (vacances, articles de luxe) tandis que d’autres épargnent. Dans cet exemple, à mesure que le revenu augmente, la variabilité des dépenses mensuelles augmente également, d’où la forme en éventail.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )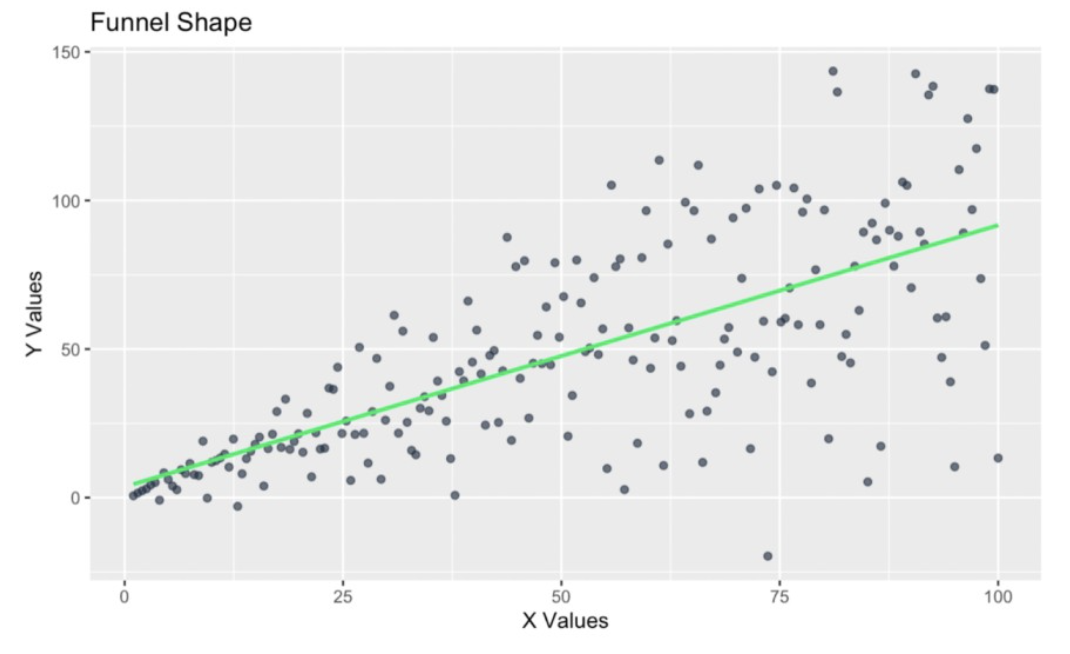
Forme en entonnoir dans les résidus. Image de l’auteur
Prenons un autre exemple, toujours sur les finances des ménages. Imaginons un modèle de régression de la variabilité de l’épargne en fonction de l’âge des membres du foyer.
On s’attend à observer de l’hétéroscédasticité : les ménages plus jeunes peuvent avoir une forte variabilité d’épargne en raison de revenus irréguliers (gig economy, stages) ou de dépenses imprévues (prêts étudiants, création de famille). À mesure que l’âge avance et que la situation financière se stabilise, le comportement d’épargne devient plus régulier, créant une forme d’entonnoir inversé où la variabilité diminue avec l’âge.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )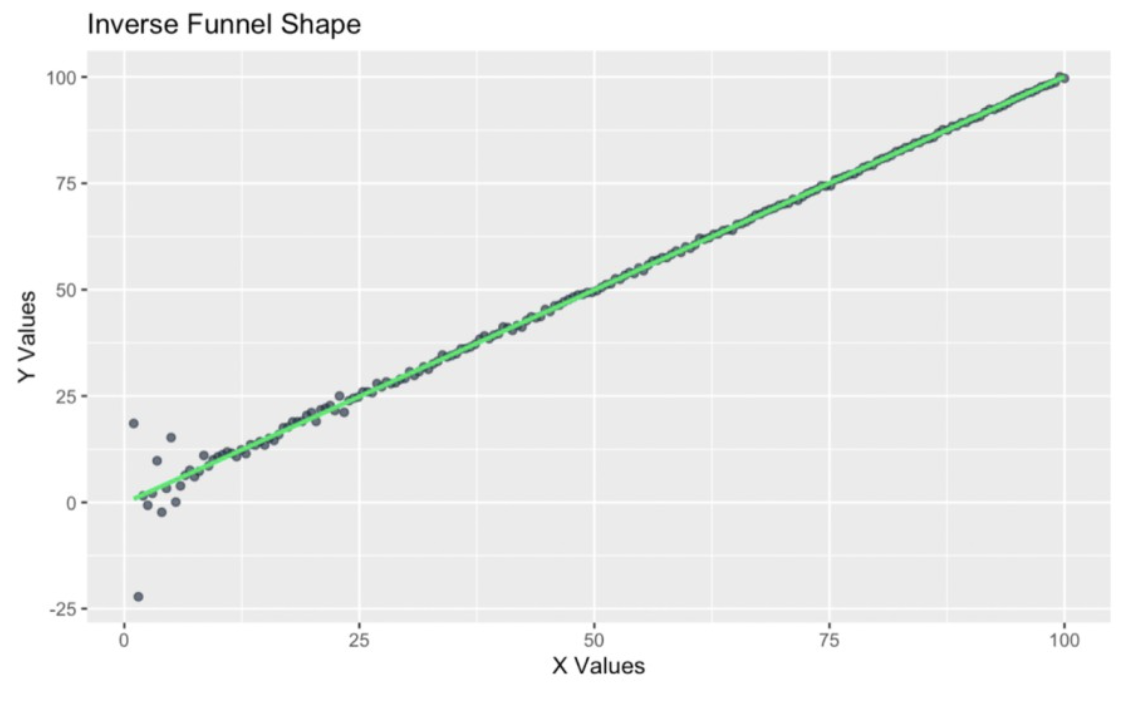
Forme en entonnoir inversé dans les résidus. Image de l’auteur
Dernier exemple avec les revenus des ménages : un schéma de variance cyclique, en particulier la variance des dépenses selon les saisons. Vous reconnaîtrez sans doute ce motif si vous avez suivi l’un de nos cours de prévision, comme le très populaire Forecasting in R.
On sait que les dépenses des ménages fluctuent de façon cyclique tout au long de l’année. Par exemple, la variance augmente souvent pendant les périodes de fêtes (achats de cadeaux, déplacements) et diminue lors de mois plus calmes, comme mars ou septembre. Le graphique suivant montre une hétéroscédasticité plus complexe, qui augmente et diminue selon les périodes.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )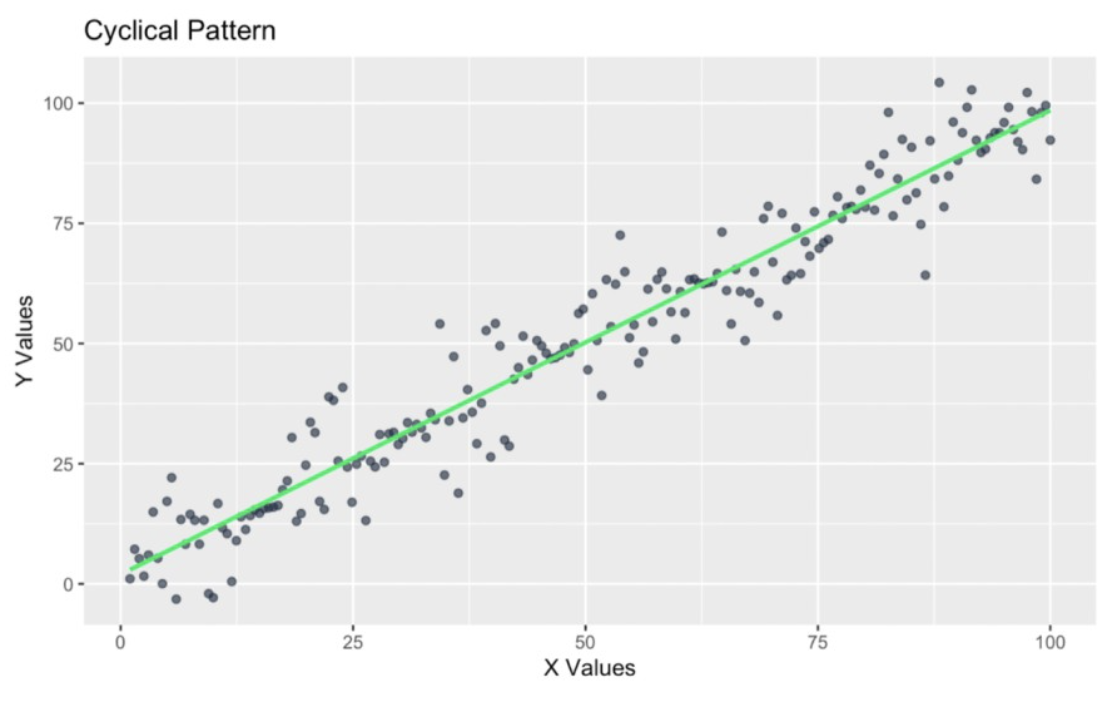
Motif cyclique dans les résidus. Image de l’auteur
Vous le voyez, l’hétéroscédasticité peut prendre plusieurs formes. Voyons maintenant pourquoi cela importe.
De manière générale, il est difficile de mener des régressions correctement sans comprendre l’hétéroscédasticité, tant elle est fréquente et peut déformer fortement nos résultats.
C’est sans doute pour cela que l’homoscedasticité — l’opposé de l’hétéroscédasticité — fait partie des hypothèses majeures d’un modèle de régression, aux côtés de la linéarité, de l’indépendance des erreurs, de la normalité des résidus, et de l’absence de multicolinéarité.
Ces hypothèses importent car elles garantissent la pertinence des prédictions et inférences du modèle. Lorsqu’elles sont violées, la fiabilité des estimations — y compris erreurs standards et intervalles de confiance — se dégrade, et nos tests d’hypothèse perdent en validité.
L’hétéroscédasticité n’apparaît pas par magie. Elle trouve souvent son origine dans la façon de collecter ou de transformer les données. Voyons les deux volets : transformations et collecte.
Parfois, nos propres étapes de préparation induisent de l’hétéroscédasticité. Je pense notamment à des mises à l’échelle inadaptées ou des transformations non linéaires qui créent une variabilité non voulue.
Imaginons que nous étudions la relation entre la surface d’un appartement et son loyer mensuel. On peut s’attendre à une relation linéaire — plus c’est grand, plus c’est cher — sans nécessairement une variance croissante avec la taille si la relation est (à peu près) proportionnelle. Cela pourrait donner :
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")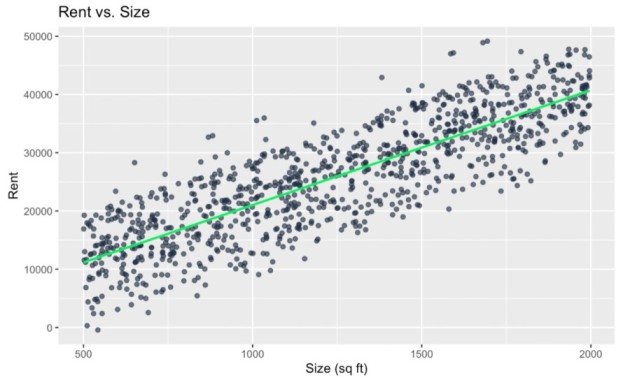
Pas d’hétéroscédasticité. Image de l’auteur
Si l’on divise le loyer par la surface pour obtenir un « loyer au m² », on crée un nouvel indicateur. En tentant ensuite de prédire le loyer au m² par la surface, on peut voir que cette transformation crée ou accentue l’hétéroscédasticité. Soyons clairs : en général, ce n’est pas une bonne idée de diviser la variable dépendante par l’indépendante — on introduit une dépendance fonctionnelle qui engendre une corrélation fallacieuse. C’est un écueil conceptuel et statistique. Mais (restez avec moi), j’utilise cet exemple pour illustrer le mécanisme :
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")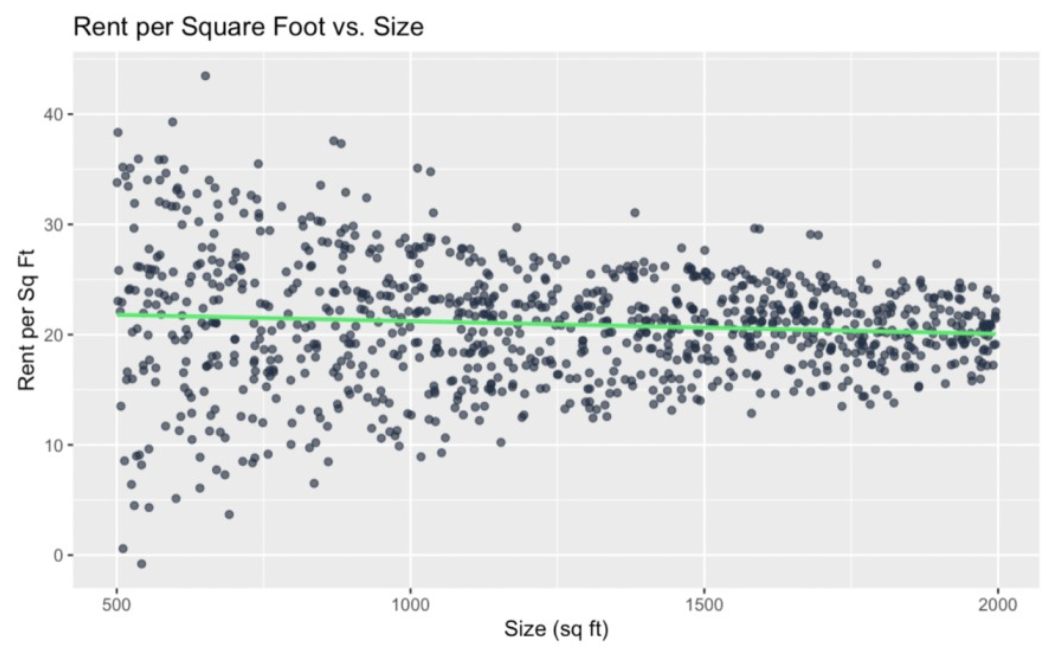
Hétéroscédasticité induite par dépendance fonctionnelle. Image de l’auteur
On observe une forme d’entonnoir : la variabilité du loyer au m² diminue quand la surface augmente. Nous avons créé de l’hétéroscédasticité ex nihilo. Autre exemple : si l’on élève les deux variables au carré :
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")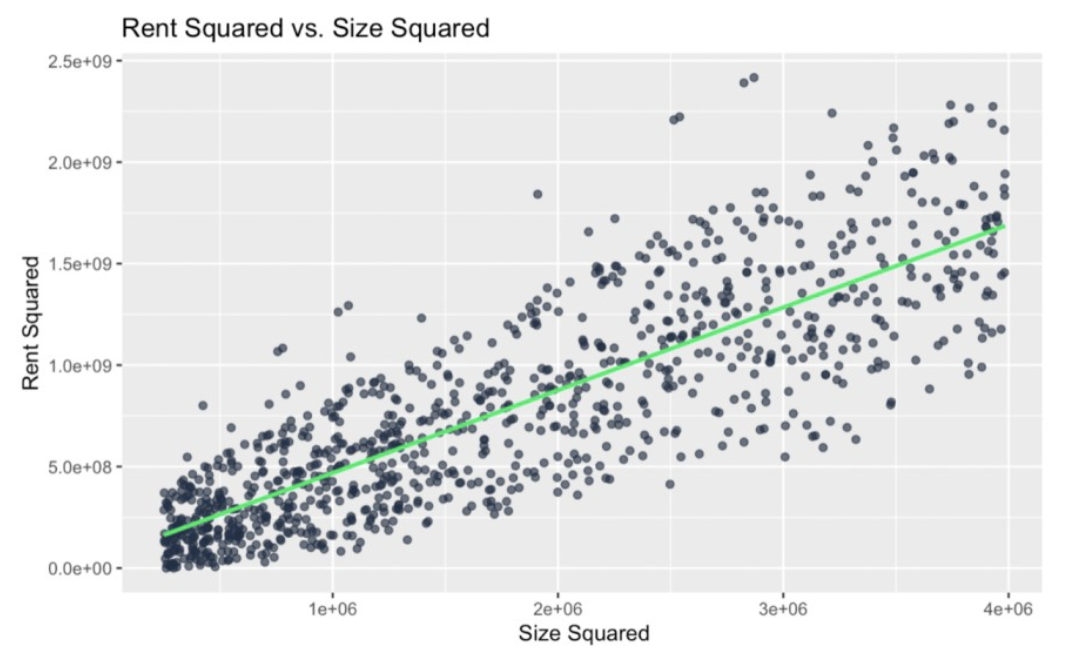
Hétéroscédasticité induite par l’élévation au carré. Image de l’auteur
Là encore, nous avons créé de l’hétéroscédasticité là où il n’y en avait pas, simplement en forçant le passage au carré de x et y. Dans certains contextes, cela peut se justifier, mais je m’attendais ici à ce que la transformation amplifie les différences de variance à mesure que les valeurs augmentent.
Cet exemple est aussi un peu artificiel : on ne construirait pas ce modèle car il serait inutilement difficile à interpréter. Mais, dans un flux de modélisation réel, des transformations qui induisent subrepticement de l’hétéroscédasticité peuvent passer inaperçues si le processus comporte de multiples étapes.
Plus précisément, ici, l’hétéroscédasticité découle de la feature engineering via des ratios. Les ratios comme « loyer au m² » sont courants, mais peuvent induire de l’hétéroscédasticité si, notamment, le dénominateur varie fortement entre observations. Les transformations logarithmiques ou exponentielles servent souvent à stabiliser la variance ou linéariser les relations ; mal harmonisées, elles se retournent contre vous. Par exemple, si vous log-transformez le revenu sans ajuster des variables liées comme les dépenses. Ce décalage est une source fréquente d’hétéroscédasticité : alignez vos transformations pour éviter des dynamiques artificielles.
L’hétéroscédasticité peut aussi venir de pratiques de collecte incohérentes. Par exemple, changer d’instrument de mesure en cours d’étude peut l’introduire. Avoir des groupes de tailles différentes, et donc des tailles d’échantillon inégales, peut également la créer. La constance méthodologique compte.
Détecter l’hétéroscédasticité est la première étape pour y remédier. Heureusement, il existe des outils visuels et statistiques.
Les nuages de points révèlent souvent des motifs caractéristiques. J’apprécie particulièrement le graphique « valeurs ajustées vs résidus ». À noter : un histogramme des résidus ou un q-q plot des résidus ne suffisent pas pour détecter l’hétéroscédasticité ; ils servent surtout à tester la normalité.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")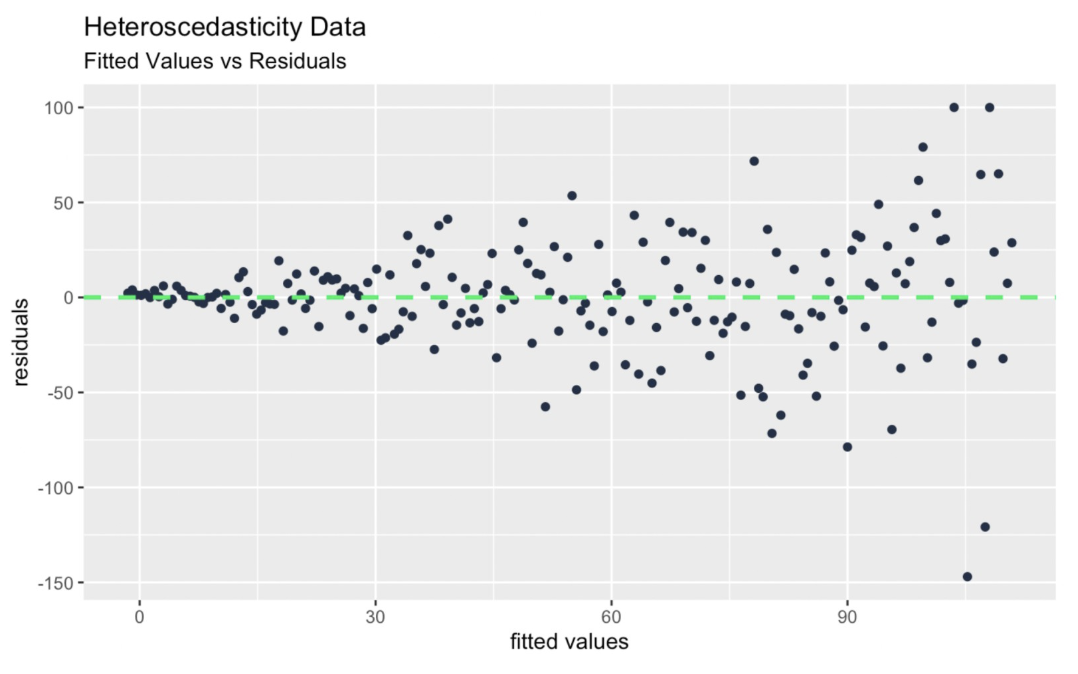 Graphique diagnostic valeurs ajustées vs résidus. Image de l’auteur
Des tests comme le test de Breusch-Pagan offrent une approche plus quantitative. Le test Breusch-Pagan examine si les résidus au carré sont liés aux prédicteurs du modèle. Pour le réaliser, on ajuste le modèle puis on utilise la fonction bptest() du package lmtest. Notez que le test suppose des résidus normaux.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Une fois l’hétéroscédasticité identifiée, il faut la traiter avec des techniques éprouvées.
Des transformations simples, comme le logarithme, réduisent souvent l’hétéroscédasticité. Plus haut, nous avons créé le problème via des transformations ; en pratique, c’est l’inverse : on utilise log, racine carrée ou inverse pour comprimer les grandes valeurs et étendre les petites. Par exemple, si le loyer croissait exponentiellement avec la surface, prendre le log du loyer aplatirait la croissance et rendrait la relation linéaire avec (potentiellement) une variance plus homogène.
Autre point : lors du prétraitement, on pense souvent à corriger l’asymétrie (skewness). Par exemple, pour une distribution asymétrique à droite, on applique une racine carrée pour se rapprocher d’une loi gaussienne. Mais on sous-estime parfois que, dans une distribution asymétrique, les grandes valeurs tendent aussi à présenter une variabilité accrue, ce qui viole l’hypothèse d’homoscedasticité.
Si les transformations ne suffisent pas, des méthodes robustes comme les moindres carrés pondérés (WLS) aident. Les WLS sont particulièrement adaptés ici : ils pondèrent les observations selon leur variance, réduisent l’influence des points à forte variabilité et stabilisent les estimations. À noter : on suppose les poids connus ou bien estimés.
Ignorer l’hétéroscédasticité peut sembler anodin, mais cela pose de vrais problèmes.
L’hétéroscédasticité peut fausser l’importance apparente de certaines variables. Dans un modèle de dépenses, par exemple, le revenu peut paraître plus décisif s’il est associé à des groupes très variables (foyers aisés avec achats discrétionnaires). On risque alors de surévaluer des prédicteurs moins fiables et de sous-estimer des signaux plus réguliers, ce qui nuit à l’utilité du modèle.
Si vous supposez l’égalité des variances alors qu’elle n’est pas respectée, des tests classiques comme t ou F perdent de leur validité. La variance inégale est également problématique en séries temporelles, où la variabilité évolue dans le temps et complique la lecture des tendances saisonnières. Les erreurs standards robustes à l’hétéroscédasticité (HCSE) peuvent améliorer l’inférence.
Nous avons étudié le cas où la variance des résidus n’est pas constante selon les niveaux d’une variable indépendante dans un modèle. Évoquons brièvement une idée proche : l’hétérogénéité de variance entre groupes, c’est-à-dire des variabilités différentes selon des groupes prédéfinis — davantage une observation descriptive des données qu’une question d’hypothèses de modèle.
Un dernier exemple par simulation d’enquête : je considère un scénario où le revenu est collecté via deux méthodes — enquêtes et fichiers administratifs — avec des précisions différentes (les enquêtes ont la réputation qu’on leur connaît). On constate que la variation intra-groupe n’est pas homogène, ce qui peut poser problème pour une ANOVA, par exemple.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)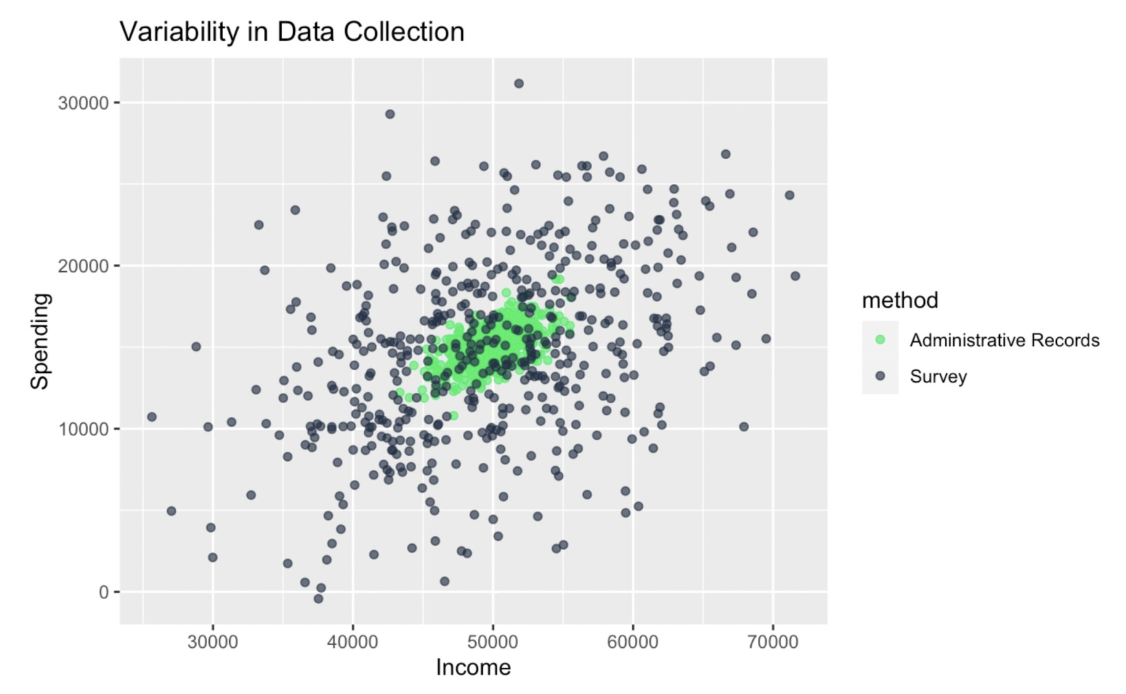
Hétérogénéité de variance entre groupes. Image de l’auteur
Traiter l’hétéroscédasticité ne sert pas qu’à améliorer un modèle de régression : c’est essentiel pour que votre travail résiste à l’examen. Pour continuer à monter en expertise, suivez notre parcours Statistical Inference in R et notre cours Foundations of Inference in R. Notre parcours Statistician in R est aussi une excellente option pour apprendre et faire avancer votre carrière.
Apprenez la régression avec DataCamp
Cours
Cours
Cours