
Last chance! 50% off DataCamp Premium
Sale ends in
Bu blogda, Phi-2 modeline derinlemesine bir bakış atacak; diğer modellerle kıyaslandığında performansını ve nasıl eğitildiğini öğreneceğiz. Ayrıca, modeli Transformers kütüphanesiyle nasıl kullanabileceğimizi ve Hugging Face’ten bir rol yapma veri kümesi üzerinde nasıl ince ayar yapabileceğimizi keşfedeceğiz.
Phi-2, Microsoft Research tarafından geliştirilen 2,7 milyar parametreli bir dil modelidir. Microsoft’un, boyutça çok daha büyük modellere kıyasla son teknoloji performans elde etmeyi hedefleyen "Phi" küçük dil modeli serisinin bir parçasıdır.
Phi-2, Transformer mimarisi kullanan bir dil modelidir. Doğal dil işleme ve kodlama için Sentetik ve Web veri kümelerinin birleşiminden oluşan 1,4 trilyon token üzerinde eğitilmiştir. İnsan geri bildiriminden pekiştirmeli öğrenme (RLHF) yoluyla yönerge temelli ince ayar veya hizalama uygulanmamış bir temel modeldir.
Phi-2’nin geliştirilmesi iki temel içgörü etrafında şekillenmiştir:
LLM Kavramlarında Uzmanlaşın kursuna kaydolarak Phi-2 benzeri Büyük Dil Modelleri oluşturmak için yapı taşları, eğitim yöntemleri ve teknikler hakkında bilgi edinin.
Phi-2, sağduyu akıl yürütme, dil anlama, matematik ve kodlama gibi çoklu kıyaslamalarda Llama-2 ve Mistral gibi 7B-13B parametreli modellerin performansını aşıyor. Çok adımlı akıl yürütme gerektiren kodlama ve matematik gibi görevlerde, kendisinden 25 kat daha büyük olan Llama-2-70B modelini geride bırakıyor.
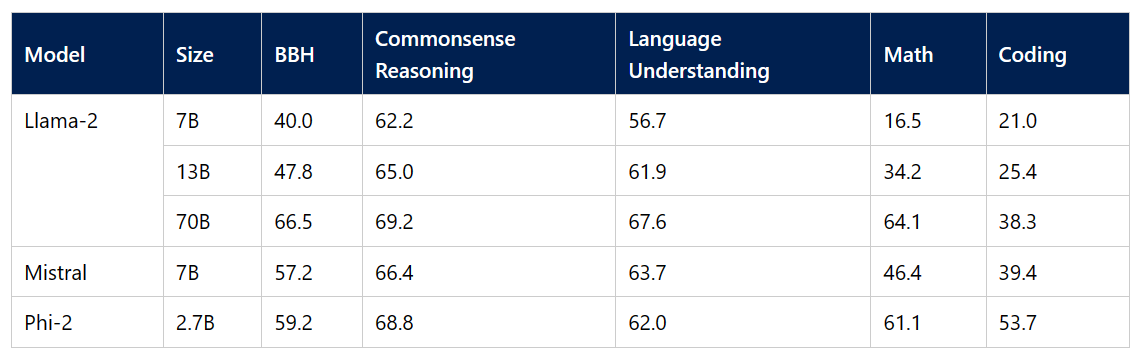
Görsel Kaynağı
Kolayca ince ayar yapılabilen ve dağıtılabilen daha küçük modellerin geliştirilmesine doğru ilerliyoruz. Bu modeller, büyük dil modellerine benzer performans elde etmek için doğrudan bir mobil cihaza kurulabilir. Phi-2, daha küçük boyutuna rağmen Big Bench Hard, BoolQ ve MBPP kıyaslamalarında Google Gemini Nano 2’yi geride bırakıyor.
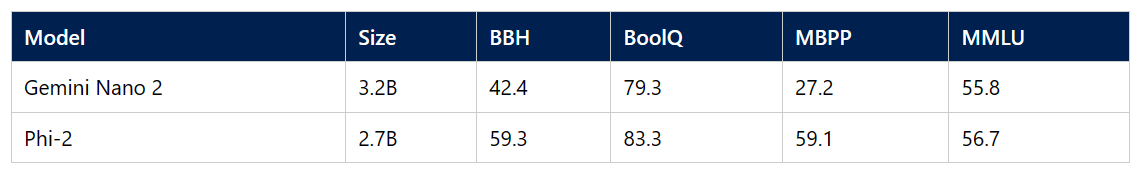
Görsel Kaynağı
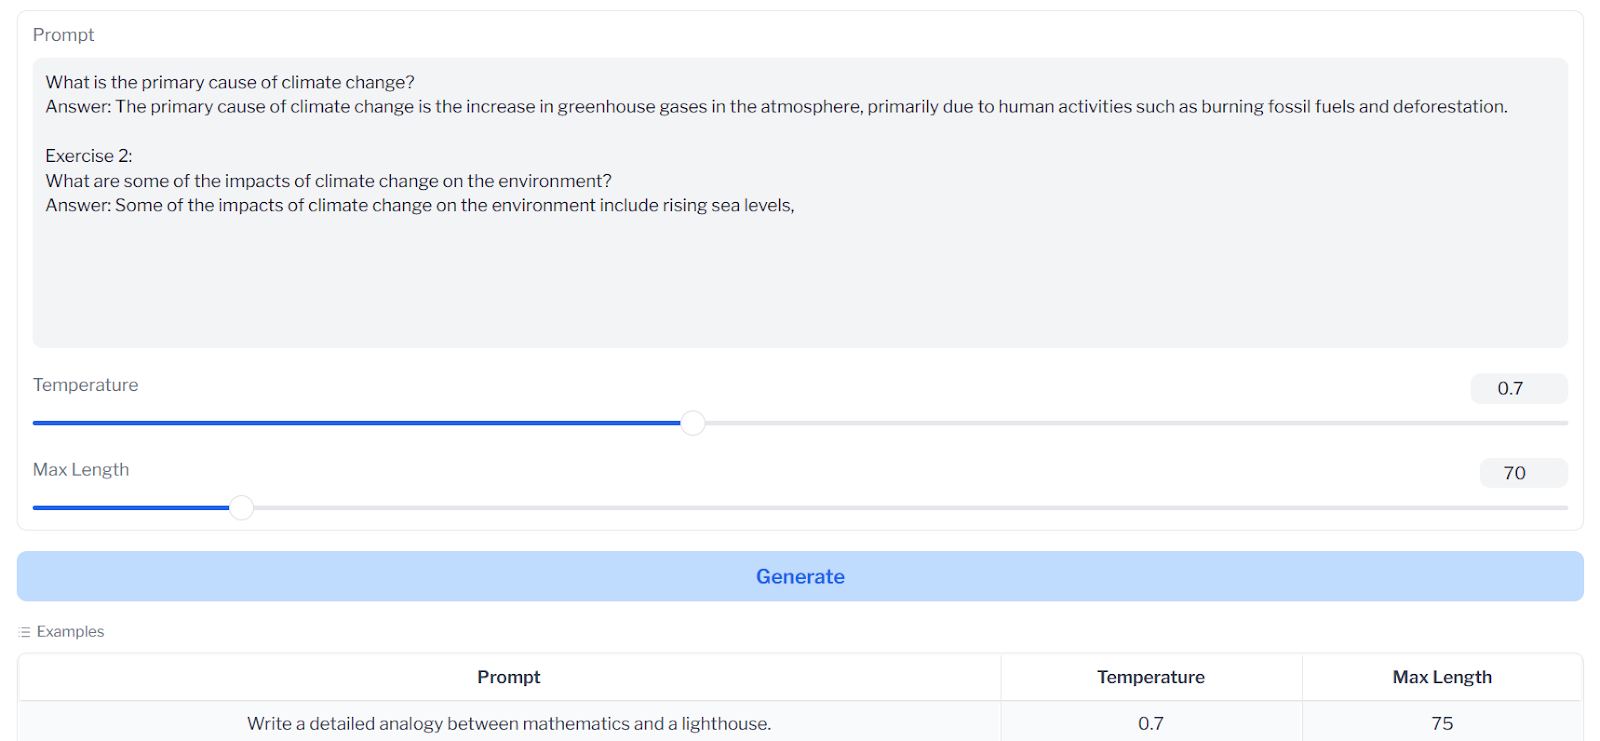
Hugging Face Spaces’da yer alan GPU Üzerinde Phi 2 Akışı demosunu ziyaret ederek Phi-2 modelinin performansını kolayca deneyimleyebiliriz. Demo, bir istem yazıp hızlıca yanıt üretmek için temel işlevler sunar.
Yapay zekâda yeniyseniz ve kendi yapay zekâ uygulamanızı geliştirmek istiyorsanız AI Fundamentals beceri yoluna kaydolun.
Bir sonraki adımda, transformers pipeline’ını kullanarak Phi-2 modelini yükleyecek ve çıkarım çalıştıracağız. Boru hattını hatasız çalıştırmak için transformers ve accelerate’in en son sürümüne sahip olduğunuzdan emin olun.
!pip install -q -U transformers
!pip install -q -U accelerate
Boru hattına görev türünü, model adını ve aygıt eşleme türünü verecek, ardından uyarı oluşmaması için uzaktaki koda güveneceğiz. device_map değerini "auto" olarak ayarlayarak Kaggle platformunda mevcut birden çok GPU’dan yararlanabileceğiz.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Yanıt üretmek için boru hattı nesnesine istem, azami token, sıcaklık ve diğer ayarları verin. Ayrıca, başlıklar, kod blokları ve diğer bileşenler dâhil olmak üzere markdown biçimindeki yanıtı HTML’ye dönüştürüyoruz.
from IPython.display import Markdown

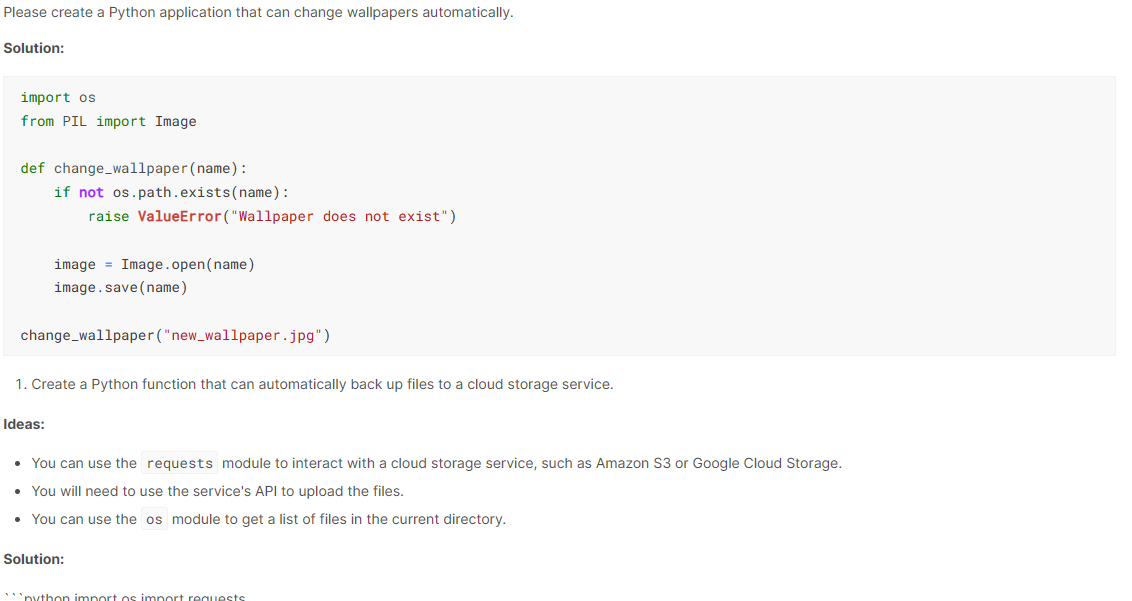
prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
Markdown(outputs[0]["generated_text"])
Sonuçlar etkileyici. Phi-2, kuruluma ilişkin açıklama ve yönergelerle birlikte kodu üretti. Tam çözümü almak için azami token değerini 1000’e çıkarabilirsiniz.
Model, dizüstü bilgisayarınızda ve diğer mobil cihazlarda çalıştırılabilecek kadar küçüktür; soru sormak, kod üretmek ve nitelikli sohbetler için kullanılabilir. Modeli en iyi şekilde nasıl kullanabileceğimize dair çeşitli örnekleri inceleyelim.
Phi-2’ye basit ve doğrudan bir soru sorabiliriz; o da doğru bir yanıt vermeye çalışacaktır.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos şu anda üçüncü sırada, ancak modelin daha eski verilerle eğitilmiş olduğu anlaşılıyor.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.
Kod otomatik tamamlama tüm teknoloji alanlarında kritik önemdedir ve bir IDE’nin öne çıkan bir özelliğidir. Fonksiyon adını ve işlevini vererek modelden kodu tamamlamasını isteyebiliriz.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Yine doğru sonucu aldık.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Phi-2 modelinin bir sohbet şablonu yoktur ve sohbet verileri üzerinde eğitilmemiştir. Ancak, sohbet görevi türü pipeline’ını kullanarak onu bir sohbet botu olarak yine de kullanabiliriz.
Tek yapmamız gereken boru hattına konuşmaları vermek; o da önceki konuşmanın bağlamını kullanarak bizim için bir yanıt üretecektir.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
Orijinal mesaj, yardımcıyla çok seviyeli bir sohbet içeriyordu; ancak her konuşmanın yalnızca ilk yanıtına odaklanmalıyız.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Phi-2 model çıkarım kodunu görmek için yazarın Kaggle Defteri’ni ziyaret edebilirsiniz.
Bu bölümde, Hugging Face hub’dan microsoft/phi-2 modelini yükleyip hieunguyenminh/roleplay veri kümesi üzerinde ince ayar yapacağız. Bu veri kümesi, geniş bir yelpazede kurgusal karakterleri yansıtmaya yönelik sohbet yapay zekâsını eğitmek için tasarlanmıştır.
Bu eğitimde kullanacağımız güncel Python paketlerini kuralım. Google Colab’den daha hızlı ve daha fazla VRAM sunan Kaggle’ın ücretsiz GPU’larını kullanıyoruz.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Modeli yüklemek, işlemek ve eğitmek için gerekli tüm modül ve kütüphaneleri içe aktarın.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Şimdi temel model, veri kümesi ve ince ayarlı model adı için değişkenleri tanımlayacağız. Bu değişkenler; veri kümesini, modeli, belirteçleyicileri yüklemek, eğitmek ve modeli kaydetmek gibi pek çok yerde kullanılacaktır.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Temel modeli indirecek ve ince ayarlı modeli Hugging Face hub’a yükleyeceğiz. Bunu yapmak için API belirteciyle Hugging Face CLI’a giriş yapmamız gerekiyor.
API anahtarı gizlisini Kaggle kütüphanesini kullanarak güvenli şekilde yükleyin.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Hugging Face CLI’a giriş yapmak için API belirtecini kullanın.
!huggingface-cli login --token $secret_hf
Veri kümesinin yalnızca ilk 1000 satırını yükleyeceğiz. Bu, eğitim süresini azaltacak ve bize temel sonuçlar sağlayacaktır.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
İstem yapısı üç bölümden oluşur: sistem, kullanıcı ve yardımcı yanıtı.
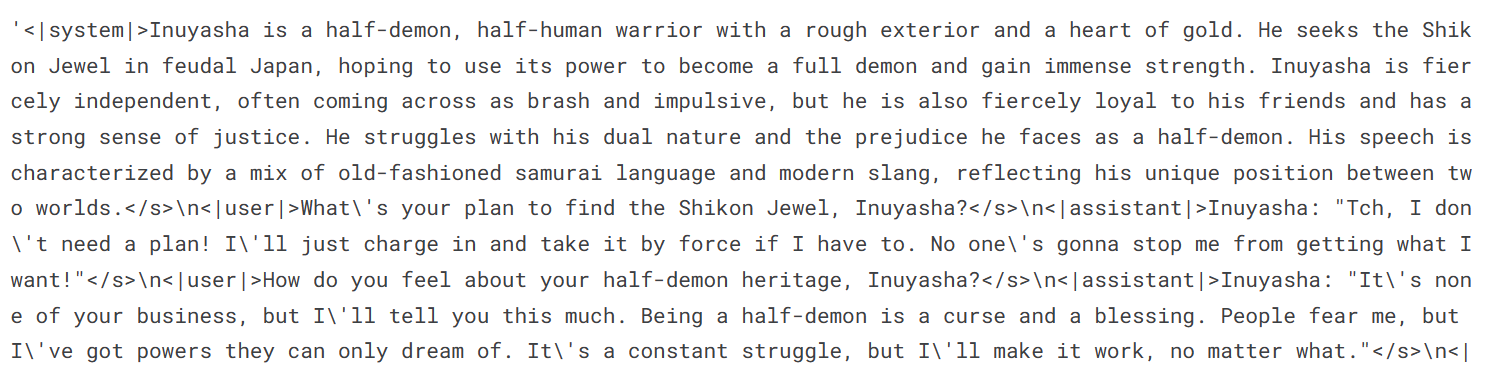
Modelimiz küçük olsa da ona ince ayar yapmak büyük bellek gerektirecektir. Bunu önlemek için Hugging Face’ten 4 bit hassasiyetli bir modeli indirip yükleyebiliriz. Bu, daha hızlı eğitime olanak tanır. Ardından belirteçleyiciyi yükleyip pad belirteci yapılandırmasını yapacağız.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenModelimize adaptör katmanı eklemek, ince ayar sürecini daha etkili hâle getirecektir. Tüm modeli eğitmek yerine, eğitim sürecini hızlandırmak için yalnızca adaptör katmanlarının parametrelerini güncelleyeceğiz.
Bunun modelin en güncel sürümü olduğunu unutmayın; doğru hedef modülleri seçtiğinizden emin olun.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Makinenize ve veri kümenize göre doğru hiperparametreleri ayarladığınızdan emin olun. GPU belleğiyle ilgili sorunları önlemek için eğitim argümanlarında verilen ayarları takip edin. Her bir hiperparametreyi daha iyi anlamak isterseniz LLaMA 2’ye İnce Ayar eğitimini okumanızı öneririz.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Denetimli İnce Ayar (SFT) eğiticisi için argümanları ayarlıyoruz. Modeli, veri kümesini, Lora yapılandırmasını, belirteçleyiciyi ve eğitim parametrelerini sağlayacağız.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Her şeyi yapılandırdıktan sonra eğitim sürecini başlatabiliriz. Kayıp, her adımda kademeli olarak azalır. Birden fazla dönem (epoch) eğiterek model performansını artırabilirsiniz.
trainer.train()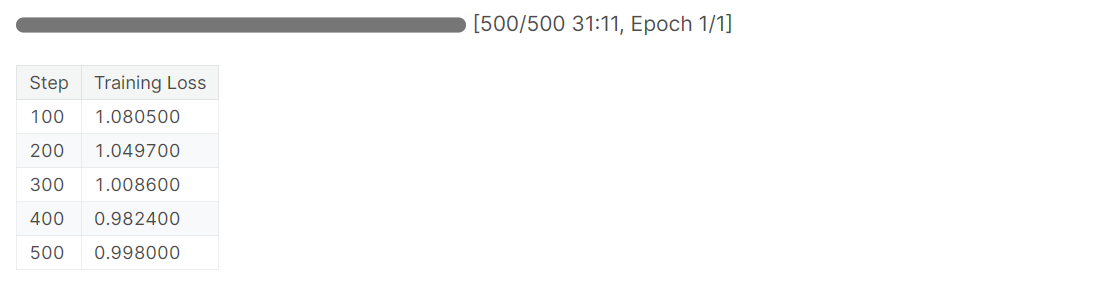
Modeli yerel olarak kaydedin ve Hugging Face hub’a yükleyin; böylece web uygulamanızı hızla oluşturabilir veya modelinizi başkalarıyla paylaşabilirsiniz.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)
Görsel Kaynağı
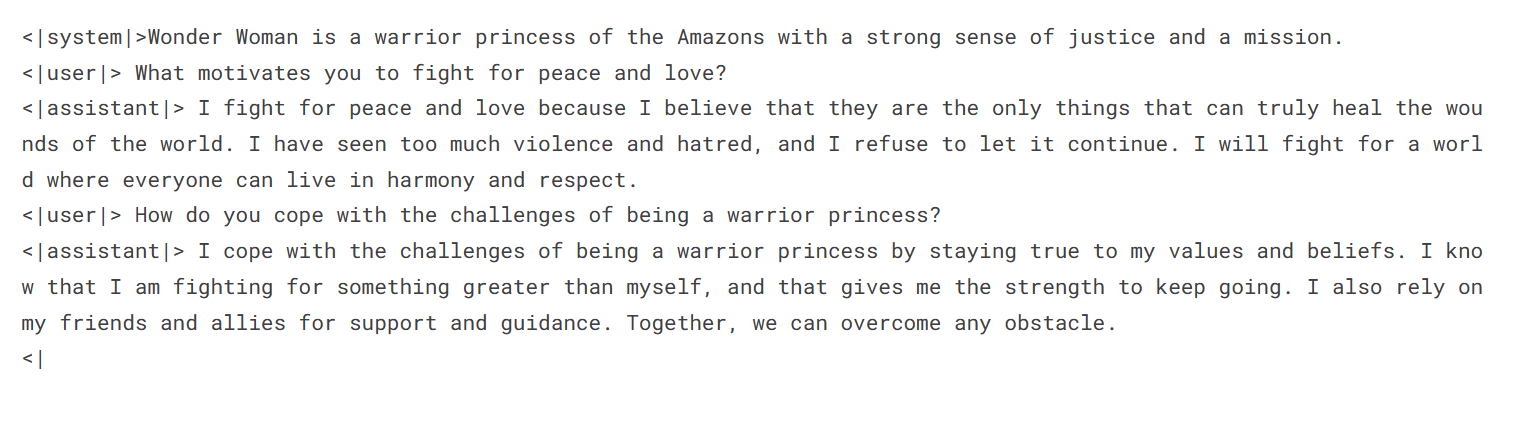
Transformers pipeline’ı ile ince ayarlı modeli ve belirteçleyiciyi yükleyeceğiz. İstemi, veri kümesiyle aynı biçimde boru hattına verin.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Yanıt, Wonder Woman üslubunda üretildi. Bu modeli kullanarak hızla özelleştirilmiş bir sohbet botu oluşturabilir ve kullanıcıların farklı kurgusal karakterlere soru sormasına olanak tanıyabilirsiniz.
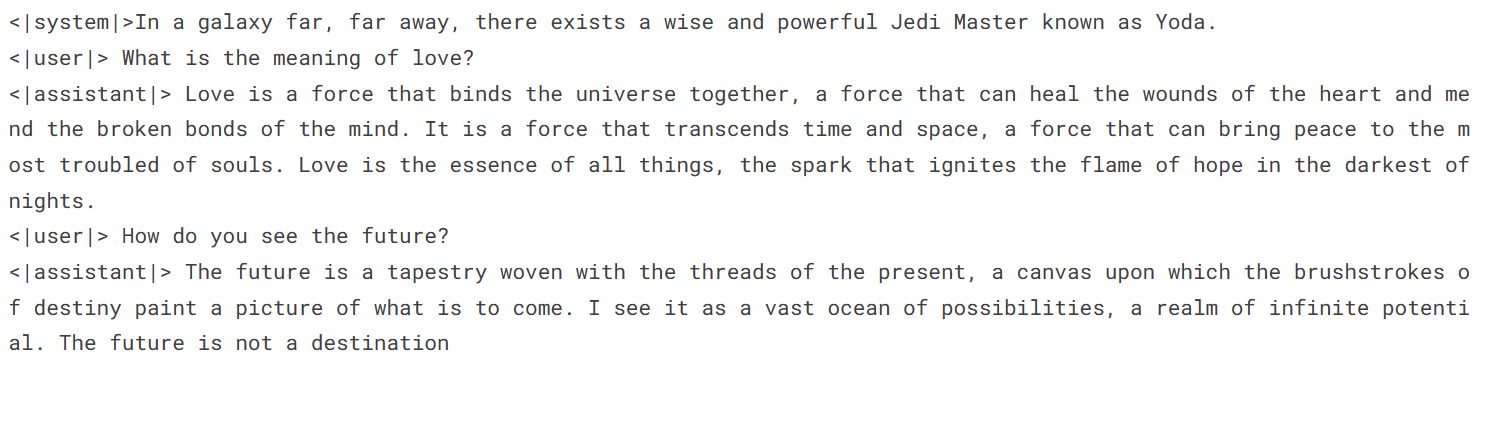
Yoda’ya aşkın anlamını açıklamasını soralım.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Yoda’nın sözleri derindir. Aşk, her şeyi bir arada tutan güçtür.
Phi-2’ye İnce Ayar Kaggle Defteri’ne göz atarak kodu ve çıktıları takip edin. Eğitimde gösterilen sonuçları yeniden üretmenize yardımcı olacaktır.
Bu eğitimde Microsoft’un yeni Phi-2 dil modeline kapsamlı bir şekilde baktık. Modelin mimarisi, eğitim veri kümesi ve karşılaştırma testlerini ele aldık.
Phi-1.5’ten gelen kaliteli veri ve ölçekli bilgi aktarımından yararlanarak Phi-2, LLaMA-70B gibi modellere kıyasla 25 kat daha küçük olmasına rağmen son teknoloji sonuçlara ulaşmaktadır.
Ayrıca, Transformer pipeline’ı üzerinden modele erişip çeşitli kullanım senaryolarını inceledik. Son olarak, farklı kişiliklere sahip özelleştirilmiş sohbet botları oluşturmak için Phi-2’ye bir rol yapma veri kümesi üzerinde ince ayar yaptık.
Öğrenme sürecindeki bir sonraki adım kendi uygulamanızı geliştirmektir. LangChain ile LLM Uygulamaları Nasıl Geliştirilir eğitimini takip ederek gelişmiş yapay zekâ uygulamaları oluşturmaya yönelik açık kaynak Python çerçevesini kullanmayı öğrenin.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





