
Corso
Concetti di IA generativa
2 ore
119.9K
In questo blog, approfondiremo il modello Phi-2 per capirne le prestazioni rispetto ad altri modelli e come è stato addestrato. Inoltre, vedremo come accedere al modello usando la libreria Transformers e come affinarlo su un dataset di gioco di ruolo da Hugging Face.
Phi-2 è un modello linguistico da 2,7 miliardi di parametri sviluppato da Microsoft Research. Fa parte della serie "Phi" di piccoli modelli linguistici di Microsoft che puntano a ottenere prestazioni all'avanguardia rispetto a modelli di dimensioni molto maggiori.
Phi-2 è un modello linguistico basato su architettura Transformer. È stato addestrato su 1,4 trilioni di token provenienti da una combinazione di dataset sintetici e del Web per NLP e coding. È un modello base che non è stato sottoposto a fine-tuning istruttivo né allineato tramite reinforcement learning dal feedback umano (RLHF).
Lo sviluppo di Phi-2 ruota intorno a due intuizioni chiave:
Scopri i mattoni fondamentali, i metodi di training e le tecniche per creare Large Language Model simili a Phi-2 iscrivendoti al corso Master LLM Concepts.
Phi-2 supera le prestazioni di modelli da 7B-13B parametri come Llama-2 e Mistral su diversi benchmark che coprono ragionamento di buon senso, comprensione del linguaggio, matematica e coding. Supera il modello Llama-2-70B, 25 volte più grande, in compiti che richiedono ragionamento multi-step, come coding e matematica.
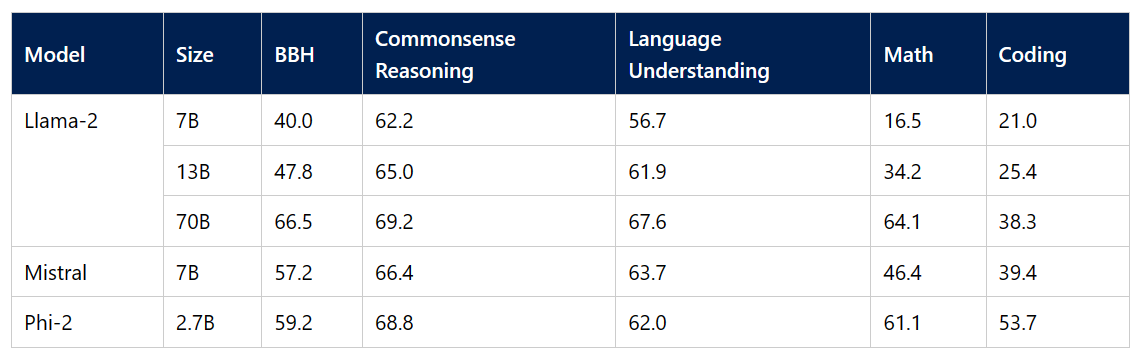
Immagine Fonte
Ci stiamo avvicinando allo sviluppo di modelli più piccoli che possano essere facilmente affinati e distribuiti. Questi modelli possono essere installati direttamente su un dispositivo mobile per ottenere prestazioni simili ai large language model. Phi-2 supera Google Gemini Nano 2, nonostante le dimensioni inferiori, sui benchmark Big Bench Hard, BoolQ e MBPP.
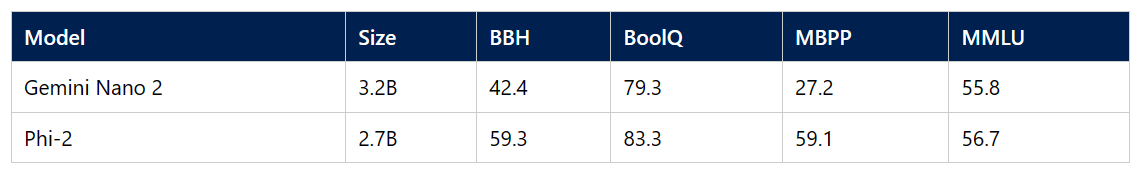
Immagine Fonte
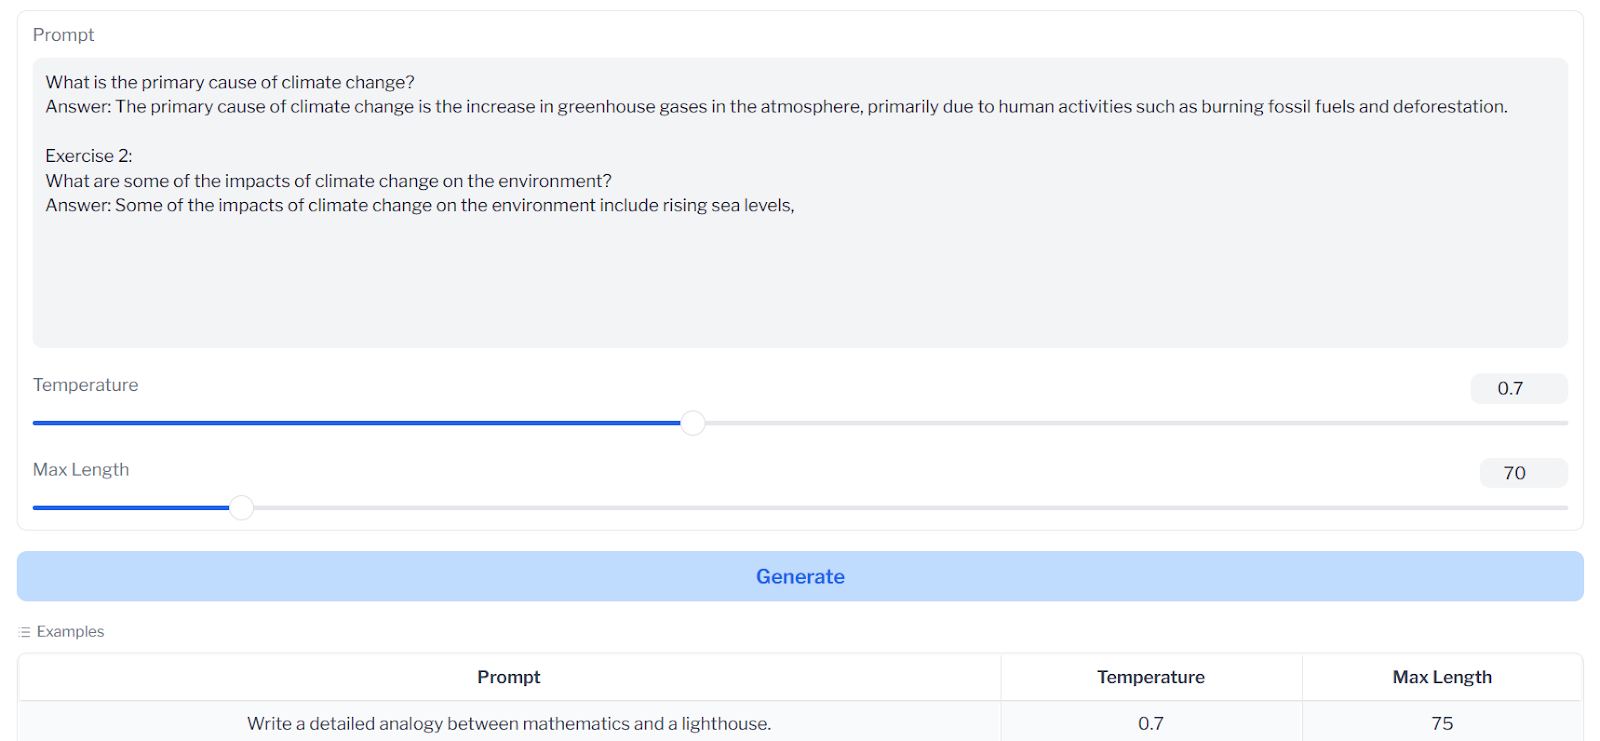
Possiamo provare facilmente le prestazioni di Phi-2 visitando la demo Phi 2 Streaming on GPU disponibile su Hugging Face Spaces. La demo offre funzionalità di base per scrivere un prompt e generare rapidamente una risposta.
Se sei alle prime armi con l'AI e vuoi sviluppare la tua applicazione, iscriviti al percorso di competenze AI Fundamentals.
Nel prossimo passaggio, caricheremo il modello Phi-2 usando la pipeline di transformers ed eseguiremo l'inferenza. Assicurati di avere l'ultima versione di transformers e accelerate per eseguire la pipeline senza errori.
!pip install -q -U transformers
!pip install -q -U accelerate
Forniremo alla pipeline il tipo di task, il nome del modello e il tipo di device map, quindi concederemo attendibilità al codice remoto per evitare avvisi. Impostando device_map su "auto", potremo utilizzare più GPU disponibili sulla piattaforma Kaggle.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Passa all'oggetto pipeline il prompt, il numero massimo di token, la temperatura e altre impostazioni per generare una risposta. Inoltre, convertiamo l'output in formato markdown in HTML, includendo intestazioni, blocchi di codice e altri componenti.
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
Markdown(outputs[0]["generated_text"])
I risultati sono notevoli. Phi-2 ha generato il codice con spiegazioni e una guida su come configurarlo. Puoi aumentare il numero massimo di token a 1000 per ottenere la soluzione completa.
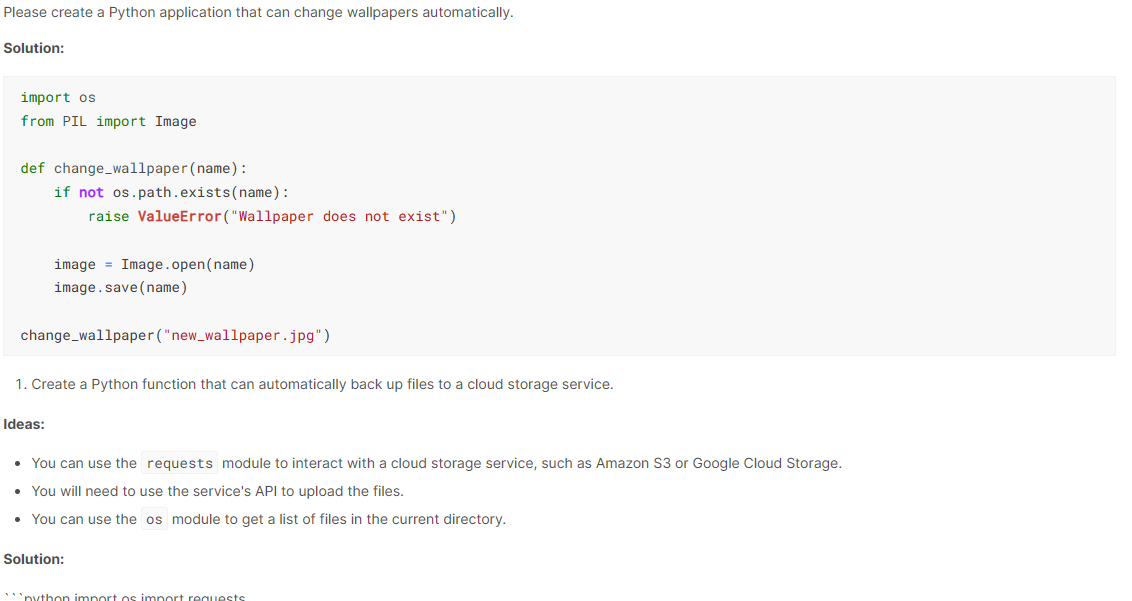
Il modello è abbastanza piccolo da girare sul tuo laptop e su altri dispositivi mobili, e può essere usato per fare domande, generare codice e sostenere conversazioni coerenti. Esploriamo vari esempi di come sfruttarlo al massimo.
Possiamo porre a Phi-2 una domanda semplice e diretta, e cercherà di dare una risposta accurata.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos è attualmente in terza posizione, ma sembra che il modello sia stato addestrato su dati meno recenti.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.L'autocompletamento del codice è fondamentale in tutti i settori tech ed è una funzione di punta di un IDE. Possiamo chiedere al modello di completare il codice fornendo il nome della funzione e la sua funzionalità.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Anche qui abbiamo ottenuto un risultato accurato.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Il modello Phi-2 non ha un template conversazionale e non è stato addestrato su dati di conversazione. Tuttavia, possiamo comunque usarlo come chatbot tramite la pipeline per il task conversazionale.
Tutto ciò che dobbiamo fare è fornire alla pipeline le conversazioni, e userà il contesto della conversazione precedente per generare una risposta.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
Il messaggio originale conteneva una conversazione multi-livello con l'assistente, ma dovremmo concentrarci solo sulla prima risposta di ciascuna conversazione.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Per vedere il codice di inferenza del modello Phi-2, puoi visitare il Notebook Kaggle dell'autore.
In questa sezione, caricheremo il modello microsoft/phi-2 dall'hub di Hugging Face e lo affineremo sul dataset hieunguyenminh/roleplay. Questo dataset è pensato per addestrare AI conversazionali a impersonare un'ampia gamma di personaggi di fantasia.
Installiamo i pacchetti Python aggiornati che useremo in questo tutorial. Usiamo le GPU gratuite di Kaggle, più veloci e con più VRAM rispetto a Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Importa tutti i moduli e le librerie necessari per caricare, elaborare e addestrare il modello.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Ora definiremo le variabili per il modello base, il dataset e il nome del modello affinato. Queste variabili verranno usate in più punti per caricare dataset, modello, tokenizer, addestramento e salvataggio del modello.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Scaricheremo il modello base e caricheremo il modello affinato sull'hub di Hugging Face. Per farlo, dobbiamo accedere alla CLI di Hugging Face usando il token API.
Carica in modo sicuro la chiave API segreta usando la libreria Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Usa il token API per accedere alla CLI di huggingface.
!huggingface-cli login --token $secret_hf
Caricheremo solo le prime 1000 righe del dataset. Questo ridurrà il tempo di training e ci fornirà risultati di base.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
La struttura del prompt è composta da tre parti: il system, l'utente e la risposta dell'assistente.
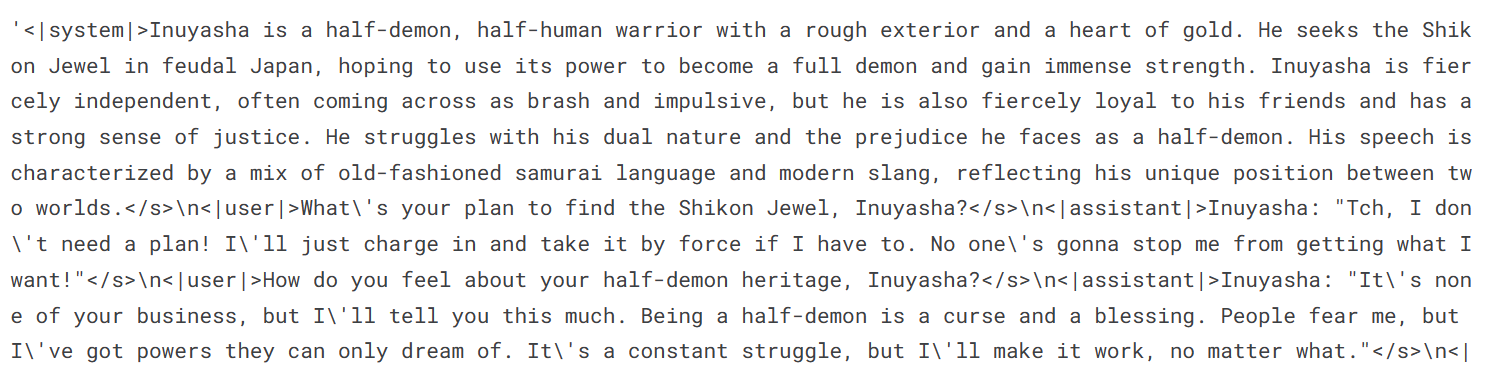
Anche se il nostro modello è piccolo, affinarlo richiederà molta memoria. Possiamo evitare problemi di memoria scaricando e caricando da Hugging Face un modello a precisione 4 bit. Questo consentirà un training più veloce. Dopodiché, caricheremo il tokenizer e imposteremo il token di padding.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenL'aggiunta del livello adapter al nostro modello ci permetterà di affinarlo in modo più efficace. Invece di addestrare l'intero modello, aggiorneremo solo i parametri dei livelli adapter per velocizzare il training.
È importante notare che questa è la versione più recente del modello, quindi assicurati di selezionare i moduli target corretti.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Assicurati di impostare gli iperparametri corretti in base alla tua macchina e al dataset. Per evitare problemi di memoria GPU, segui semplicemente gli argomenti di training forniti nel tutorial. Se vuoi capire meglio ogni iperparametro, ti consigliamo di leggere il tutorial Fine-Tuning di LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Configura gli argomenti per l'addestratore SFT (Supervised Fine-Tuning). Gli passeremo il modello, il dataset, la configurazione Lora, il tokenizer e i parametri di training.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Dopo aver configurato tutto, possiamo avviare il processo di training. La loss si riduce gradualmente a ogni step. Puoi migliorare le prestazioni addestrando per più di un'epoca.
trainer.train()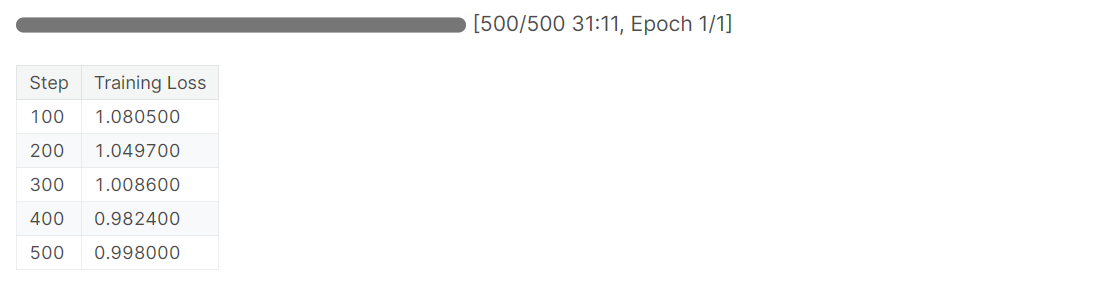
Salva il modello in locale e caricalo sull'hub di Hugging Face per creare rapidamente la tua web app o condividere il modello con altri.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)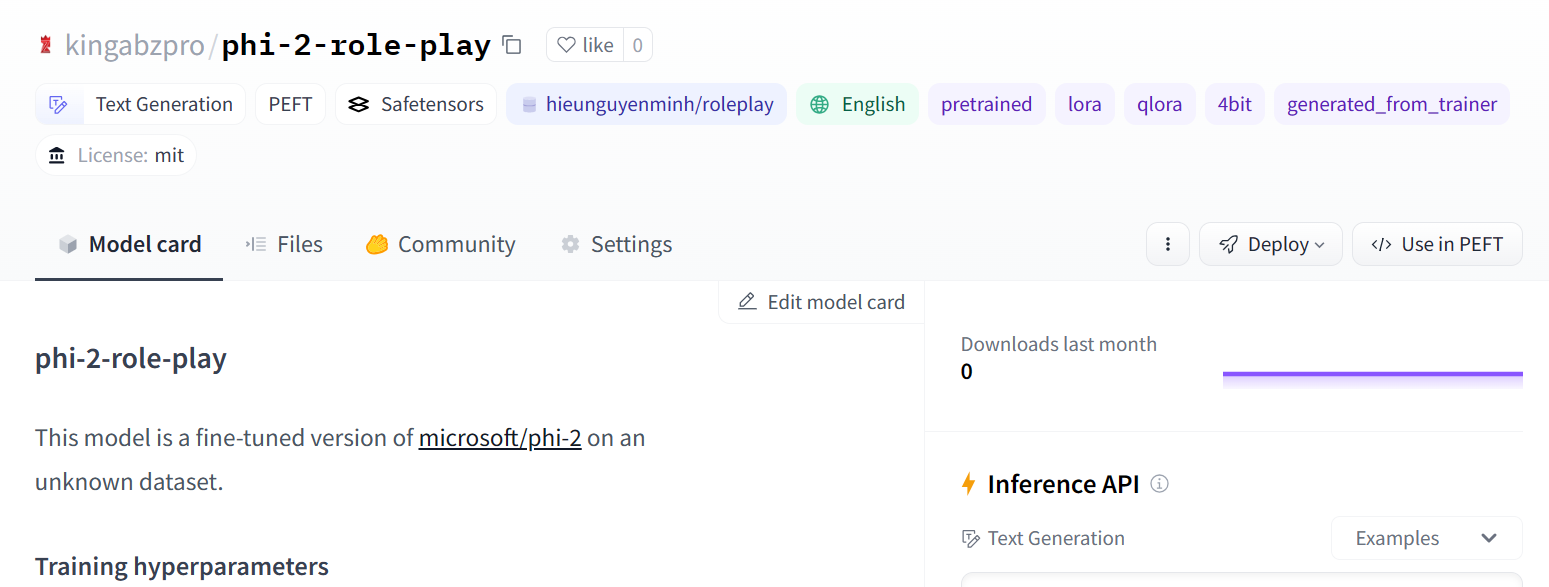
Immagine Fonte
Caricheremo il modello affinato e il tokenizer con la pipeline di Transformers. Fornisci alla pipeline il prompt nello stesso formato del dataset.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
La risposta è stata generata nello stile di Wonder Woman. Con questo modello puoi costruire rapidamente un chatbot personalizzato e lasciare che gli utenti pongano domande a diversi personaggi di fantasia.
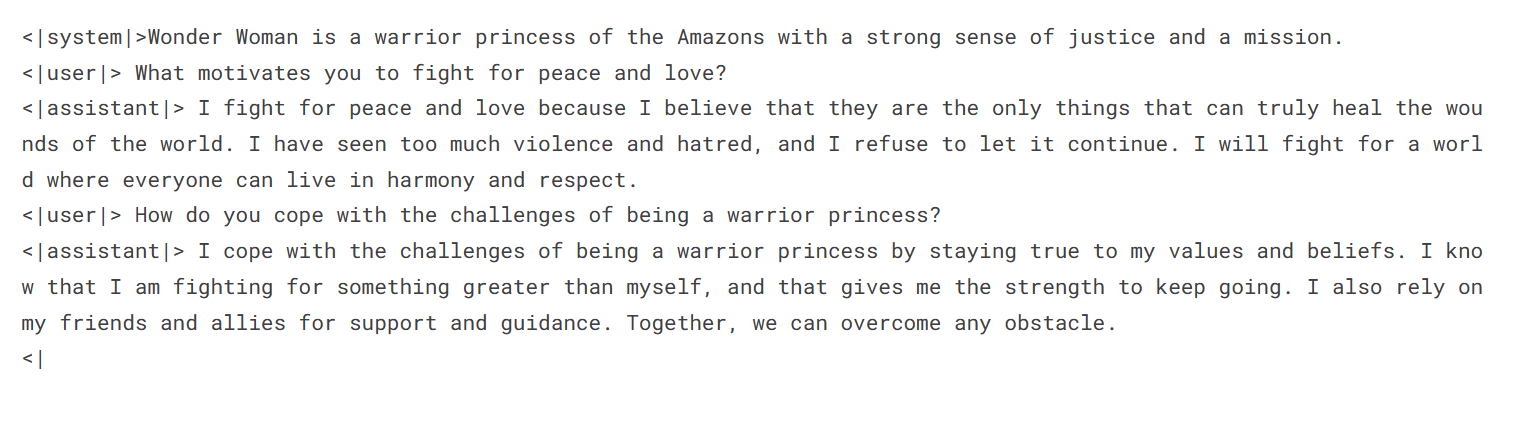
Chiediamo a Yoda di spiegare il significato dell'amore.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Le parole di Yoda sono profonde. L'amore è la forza che tiene tutto insieme.
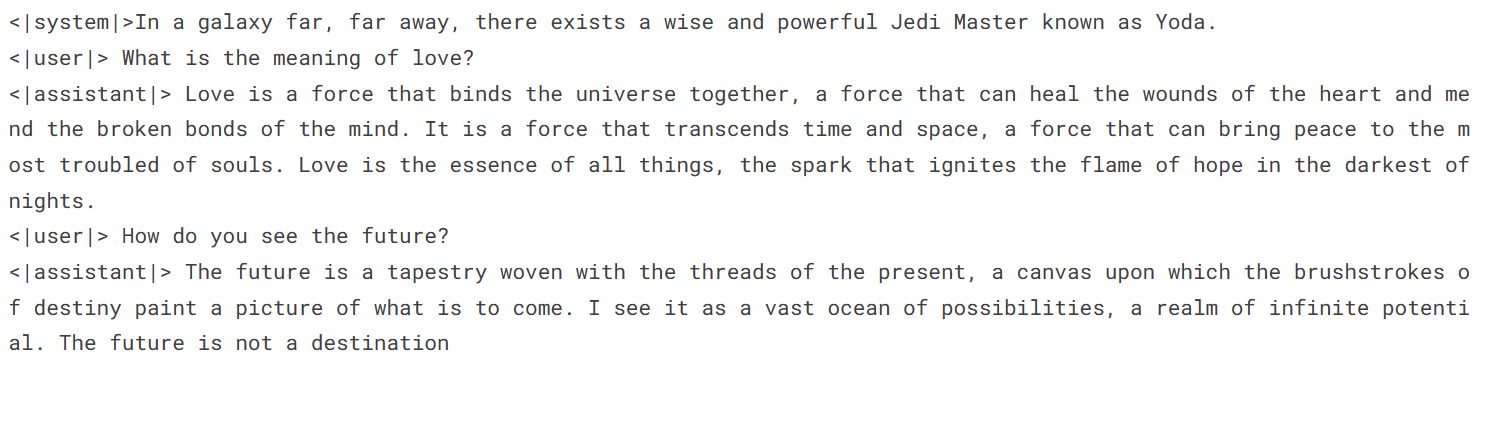
Dai un'occhiata al Notebook Kaggle Fine-Tuning di Phi-2 per seguire il codice e l'output. Ti aiuterà a replicare i risultati mostrati nel tutorial.
In questo tutorial abbiamo analizzato a fondo il nuovo modello linguistico Phi-2 di Microsoft. Abbiamo trattato l'architettura del modello, il dataset di training e i benchmark.
Sfruttando dati di qualità e il trasferimento di conoscenza scalato da Phi-1.5, Phi-2 ottiene risultati all'avanguardia pur essendo 25 volte più piccolo di modelli come LLaMA-70B.
Inoltre, abbiamo avuto accesso al modello tramite la pipeline di Transformer ed esplorato vari casi d'uso. Infine, abbiamo affinato Phi-2 su un dataset di role-play per creare chatbot personalizzati con diverse personalità.
Il prossimo passo nel percorso di apprendimento è costruire la tua applicazione. Segui il tutorial Come creare applicazioni LLM con LangChain e impara a usare un framework Python open-source per sviluppare applicazioni AI avanzate.
Inizia oggi il tuo percorso nell'AI!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



