
Cursus
Generatieve AI-concepten
2 uur
119.5K
In deze blog duiken we diep in het Phi-2-model. We bekijken de prestaties ten opzichte van andere modellen en hoe het getraind is. Daarnaast laten we zien hoe je het model benadert met de Transformers-bibliotheek en het finetunet op een role-playing-dataset van Hugging Face.
Phi-2 is een taalmodel met 2,7 miljard parameters, ontwikkeld door Microsoft Research. Het maakt deel uit van Microsofts "Phi"-reeks kleine taalmodellen die mikken op state-of-the-art prestaties vergeleken met veel grotere modellen.
Phi-2 is een taalmodel dat een Transformer-architectuur gebruikt. Het is getraind op 1,4 biljoen tokens uit een combinatie van synthetische en webdatasets voor natural language processing en coderen. Het is een basismodel dat niet instructief gefinetuned of gealigneerd is via reinforcement learning from human feedback (RLHF).
De ontwikkeling van Phi-2 draait om twee belangrijke inzichten:
Leer over bouwstenen, trainingsmethoden en technieken voor het maken van Large Language Models zoals Phi-2 in de cursus Master LLM Concepts.
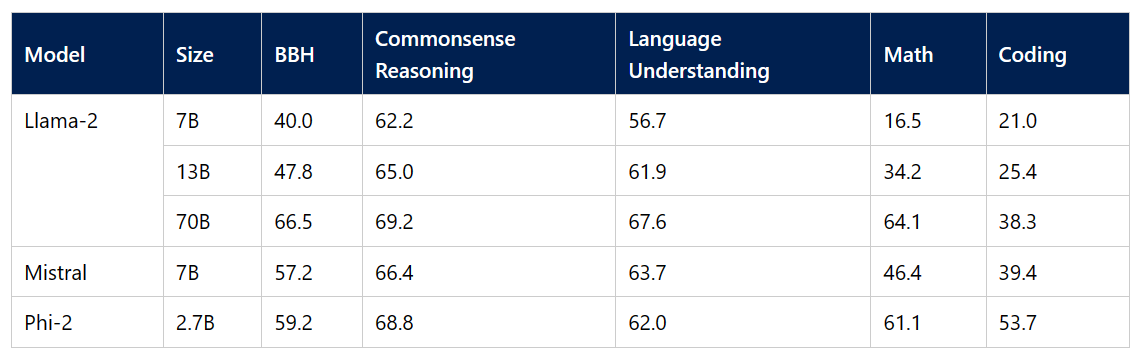
Phi-2 overtreft 7B-13B-parametermodellen zoals Llama-2 en Mistral op meerdere benchmarks, variërend van gezond verstand-redeneren en taalbegrip tot wiskunde en coderen. Het presteert beter dan het 25x grotere Llama-2-70B-model op taken met meerstapsredeneren, zoals coderen en wiskunde.
Afbeelding Bron
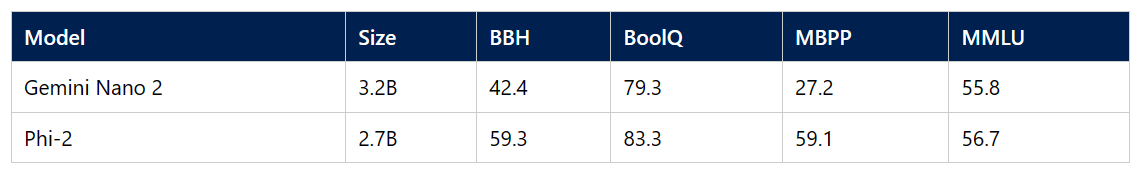
We bewegen richting de ontwikkeling van kleinere modellen die eenvoudig te finetunen en te deployen zijn. Deze modellen kunnen rechtstreeks op een mobiel apparaat worden geïnstalleerd en prestaties leveren die vergelijkbaar zijn met grote taalmodellen. Phi-2 presteert beter dan Google Gemini Nano 2, ondanks het kleinere formaat, op de Big Bench Hard-, BoolQ- en MBPP-benchmarks.
Afbeelding Bron
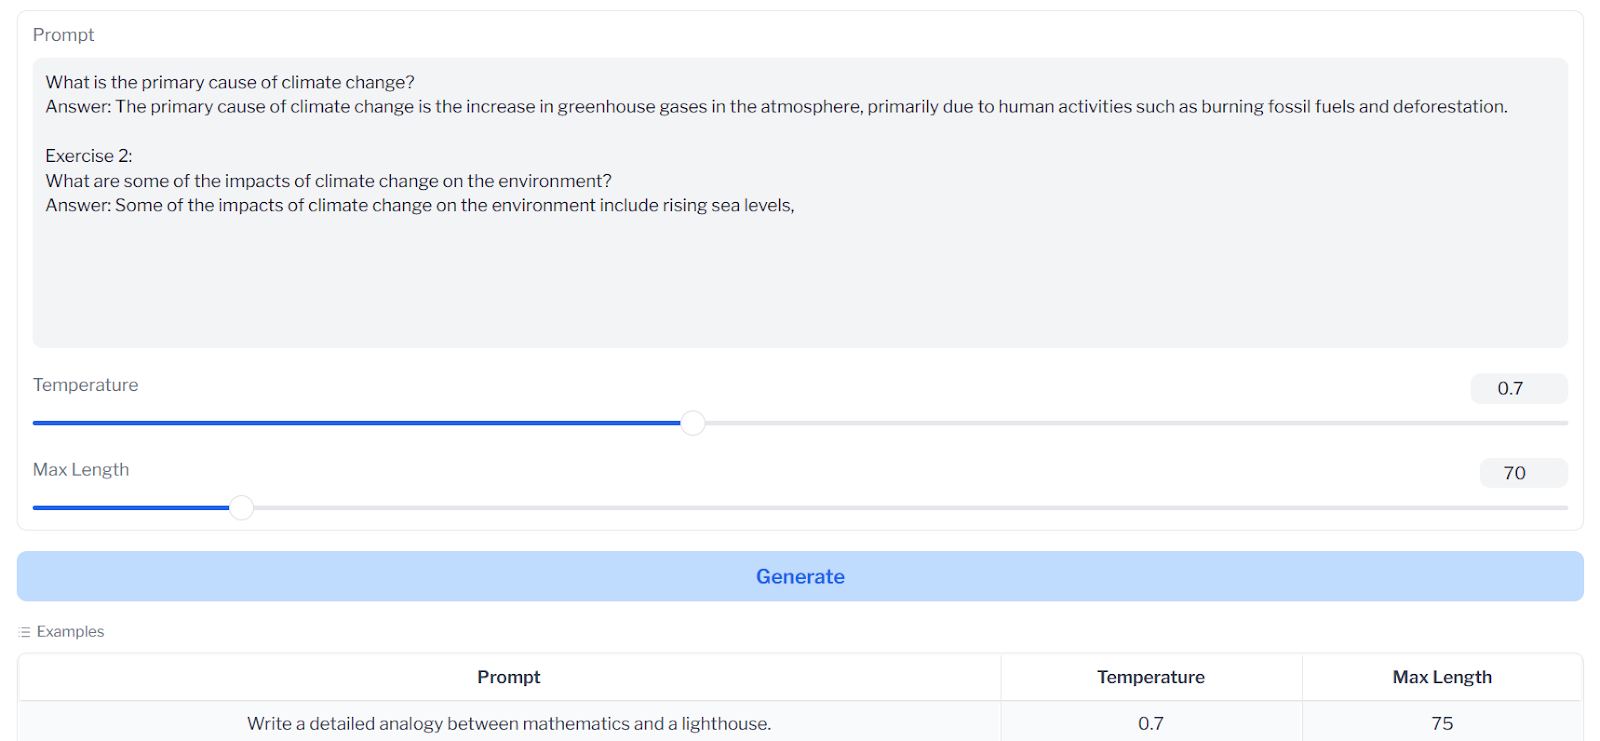
Je kunt de prestaties van het Phi-2-model eenvoudig ervaren via de demo Phi 2 Streaming on GPU op Hugging Face Spaces. De demo biedt basisfunctionaliteit om een prompt te schrijven en snel een reactie te genereren.
Ben je nieuw in AI en wil je je eigen AI-app ontwikkelen? Schrijf je in voor het skill track AI Fundamentals.
In de volgende stap laden we het Phi-2-model met de transformers-pipeline en voeren we inferentie uit. Zorg dat je de nieuwste versies van transformers en accelerate hebt om de pipeline foutloos te draaien.
!pip install -q -U transformers
!pip install -q -U accelerate
We geven de pipeline het taaktype, de modelnaam en het device map-type en vertrouwen vervolgens de remote code om waarschuwingen te vermijden. Door device_map op "auto" te zetten, kunnen we meerdere GPU's op het Kaggle-platform benutten.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Geef het pipeline-object een prompt, maximaal aantal tokens, temperatuur en andere instellingen om een reactie te genereren. Daarnaast zetten we de markdown-uitvoer om naar HTML, inclusief koppen, codeblokken en andere componenten.
from IPython.display import Markdown

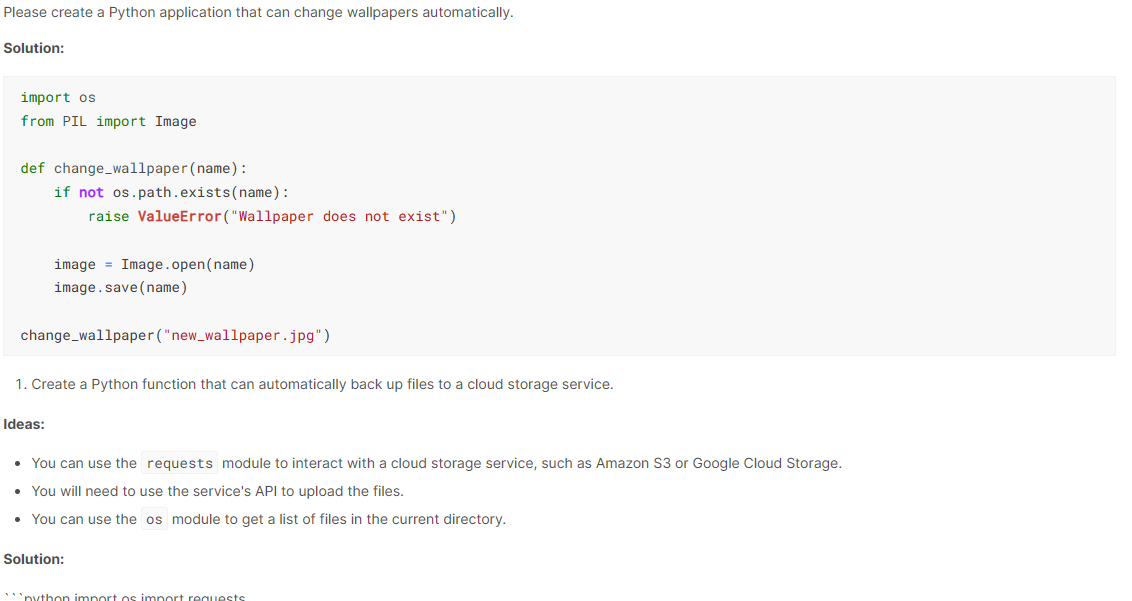
prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
Markdown(outputs[0]["generated_text"])
De resultaten zijn indrukwekkend. Phi-2 heeft de code gegenereerd met een uitleg en stappenplan voor de installatie. Je kunt het maximum aantal tokens verhogen naar 1000 om de volledige oplossing te krijgen.
Het model is klein genoeg om op je laptop en andere mobiele apparaten te draaien en kan worden gebruikt om vragen te stellen, code te genereren en volwaardige gesprekken te voeren. Laten we verschillende voorbeelden bekijken om het model optimaal te benutten.
We kunnen Phi-2 een simpele, directe vraag stellen, en het zal proberen een nauwkeurig antwoord te geven.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos staat momenteel op de derde plaats, maar het lijkt erop dat het model op oudere data is getraind.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.Codeaanvulling is cruciaal in alle techdomeinen en een opvallende functie van een IDE. We kunnen het model vragen de code aan te vullen door de functienaam en functionaliteit te geven.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Ook hier krijgen we het juiste resultaat.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Het Phi-2-model heeft geen conversatiesjabloon en is niet getraind op conversatiedata. Toch kunnen we het als chatbot gebruiken via de conversational-taakpipeline.
Alles wat we hoeven te doen is de pipeline voorzien van gesprekken; het gebruikt dan de context van het eerdere gesprek om een reactie te genereren.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
Het oorspronkelijke bericht bevatte een meerlagig gesprek met de assistant, maar we focussen hier alleen op het eerste antwoord van elk gesprek.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
De inferentiecode voor het Phi-2-model vind je in het Kaggle-notebook van de auteur.
In deze sectie laden we het microsoft/phi-2-model van de Hugging Face-hub en finetunen we het op de hieunguyenminh/roleplay-dataset. Deze dataset is ontworpen om conversationale AI te trainen om een breed scala aan fictieve personages neer te zetten.
Laten we de bijgewerkte Python-pakketten installeren die we in deze tutorial gebruiken. We maken gebruik van de gratis GPU's van Kaggle, die sneller zijn en meer VRAM bieden dan Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Importeer alle benodigde modules en libraries voor het laden, verwerken en trainen van het model.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
We definiëren nu variabelen voor het basismodel, de dataset en de naam van het gefinetunede model. Deze variabelen gebruiken we op meerdere plekken voor het laden van dataset, model, tokenizers, training en het opslaan van het model.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"We downloaden het basismodel en uploaden het gefinetunede model naar de Hugging Face-hub. Daarvoor moeten we inloggen bij de Hugging Face CLI met de API-token.
Laad de API-sleutel veilig als secret met de Kaggle-bibliotheek.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Gebruik de API-token om in te loggen bij de huggingface CLI.
!huggingface-cli login --token $secret_hf
We laden alleen de eerste 1000 rijen van de dataset. Dit verkort de traintijd en geeft ons basisresultaten.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
De promptstructuur bestaat uit drie delen: de system, de user en het assistant-antwoord.
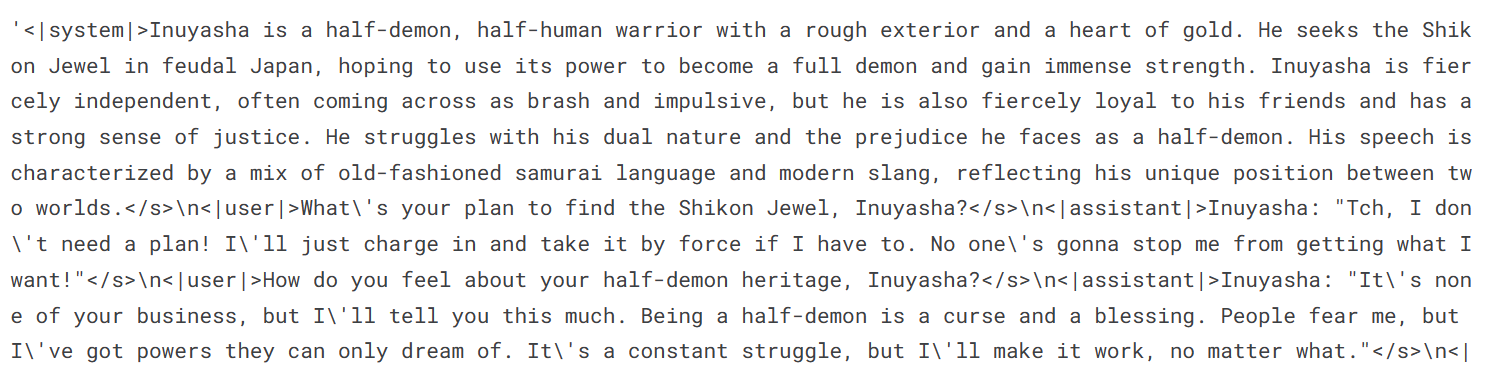
Hoewel ons model klein is, vereist finetuning veel geheugen. We kunnen geheugenproblemen vermijden door een 4-bit-precisiemodel van Hugging Face te downloaden en te laden. Dit maakt de training sneller. Daarna laden we de tokenizer en configureren we de pad-token.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenDoor een adapterlaag toe te voegen kunnen we het model effectiever finetunen. In plaats van het hele model te trainen, updaten we alleen de parameters van de adapterlagen om het trainingsproces te versnellen.
Let op: dit is de meest recente versie van het model, zorg dus dat je de juiste target-modules selecteert.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Zorg dat je de juiste hyperparameters instelt op basis van je machine en dataset. Volg de trainingsargumenten in de tutorial om problemen met GPU-geheugen te vermijden. Wil je elk hyperparameter beter begrijpen? Lees dan de tutorial Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
We stellen de argumenten in voor de Supervised Fine-tuning (SFT) trainer. We geven het model, de dataset, de Lora-configuratie, de tokenizer en de trainingsparameters mee.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Na de configuratie kunnen we met de training beginnen. De loss neemt geleidelijk af bij elke stap. Je kunt de prestaties verbeteren door langer dan één epoch te trainen.
trainer.train()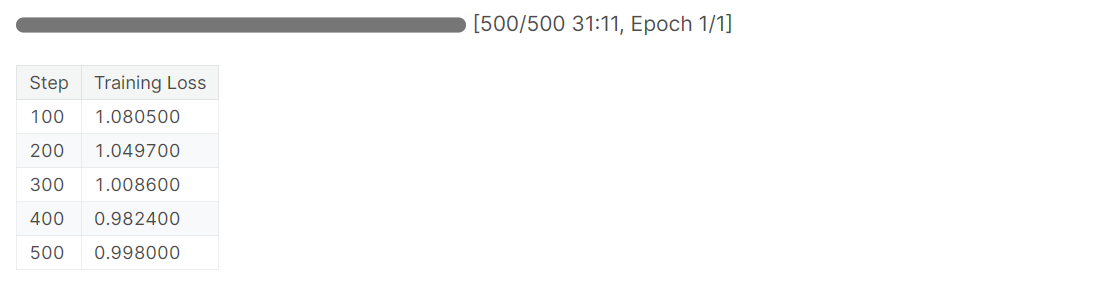
Sla het model lokaal op en upload het naar de Hugging Face-hub om snel je webapp te bouwen of je model te delen met anderen.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)
Afbeelding Bron
We laden het gefinetunede model en de tokenizer met de Transformers-pipeline. Geef de prompt aan de pipeline in hetzelfde formaat als de dataset.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
De reactie is gegenereerd in de stijl van Wonder Woman. Met dit model kun je snel een aangepaste chatbot bouwen en gebruikers vragen laten stellen aan verschillende fictieve personages.
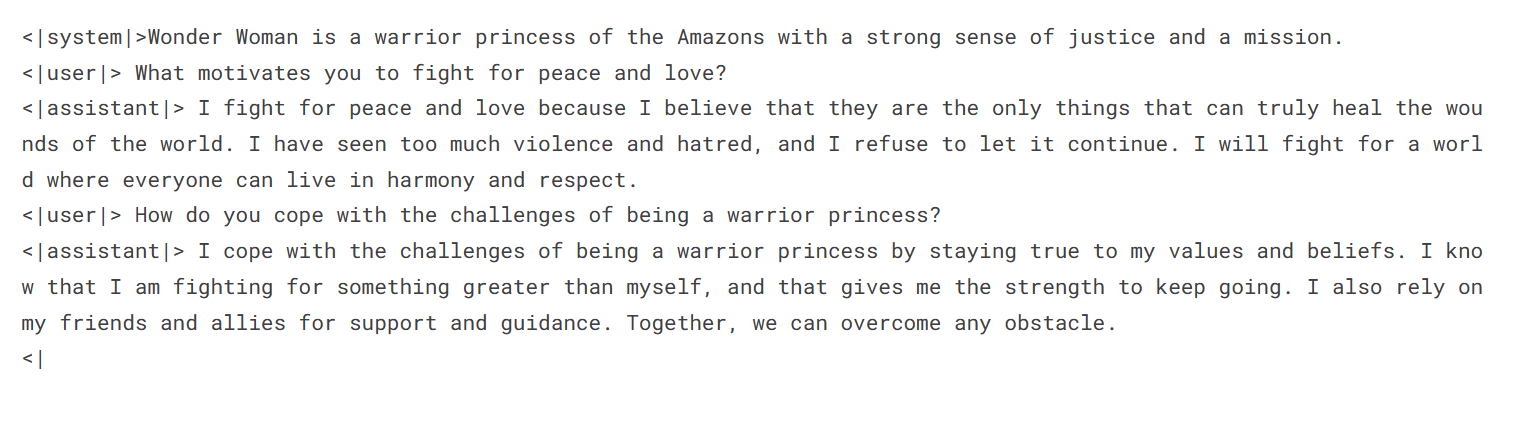
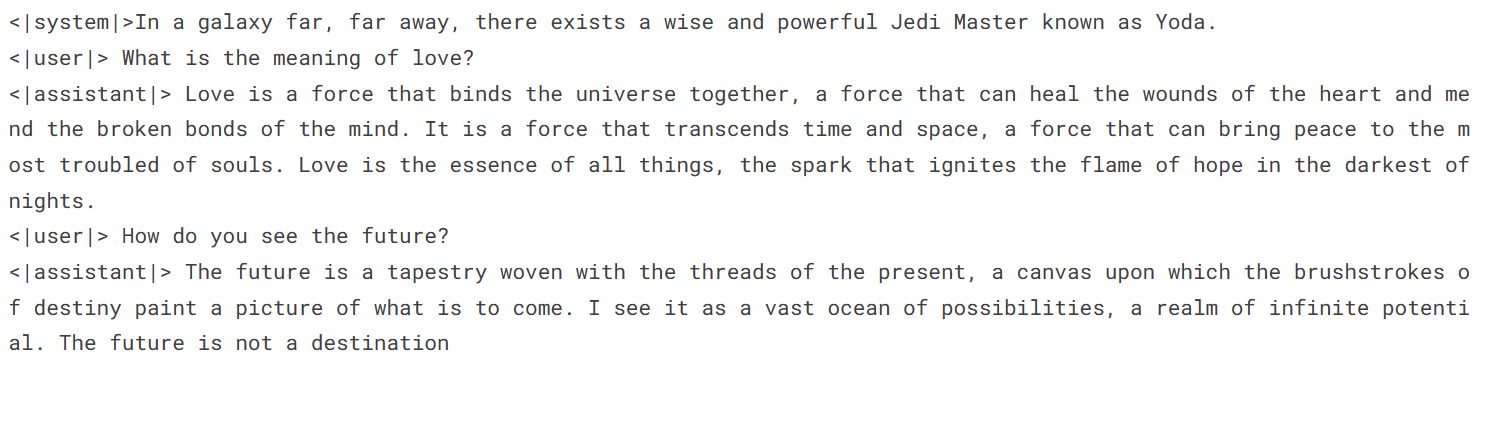
Laten we Yoda vragen om de betekenis van liefde uit te leggen.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
De woorden van Yoda zijn veelzeggend. Liefde is de kracht die alles bij elkaar houdt.
Bekijk het Fine-Tuning Phi-2 Kaggle-notebook om de code en uitvoer te volgen. Dit helpt je de resultaten uit de tutorial te reproduceren.
In deze tutorial hebben we uitgebreid gekeken naar Microsofts nieuwe taalmodel Phi-2. We bespraken de architectuur, de trainingsdataset en de benchmarks.
Door kwaliteitsdata en geschaalde kennisoverdracht van Phi-1.5 te benutten, behaalt Phi-2 state-of-the-art resultaten terwijl het 25x kleiner is dan modellen zoals LLaMA-70B.
Bovendien hebben we toegang tot het model via de Transformer-pipeline en verschillende use-cases verkend. Tot slot hebben we Phi-2 gefinetuned op een role-playing-dataset om aangepaste chatbots met verschillende persona's te maken.
De volgende stap in je leerproces is het bouwen van je eigen applicatie. Volg de tutorial How to Build LLM Applications with LangChain en leer een open-source Python-framework gebruiken voor het bouwen van geavanceerde AI-toepassingen.
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

