

कोर्स
जनरेटिव AI कॉन्सेप्ट्स
2 घंटा
120.9K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंइस ब्लॉग में, हम Phi-2 मॉडल की गहराई से पड़ताल करेंगे और जानेंगे कि यह अन्य मॉडलों की तुलना में कैसा प्रदर्शन करता है और इसे कैसे प्रशिक्षित किया गया। साथ ही, हम Transformers लाइब्रेरी का उपयोग करके मॉडल तक कैसे पहुँचा जाए और Hugging Face के रोल-प्ले डेटासेट पर इसे फाइन-ट्यून कैसे किया जाए, यह भी देखेंगे।
Phi-2 माइक्रोसॉफ्ट रिसर्च द्वारा विकसित 2.7 बिलियन-पैरामीटर वाला एक भाषा मॉडल है। यह माइक्रोसॉफ्ट की "Phi" श्रृंखला का हिस्सा है, जो आकार में कहीं बड़े मॉडलों की तुलना में अत्याधुनिक प्रदर्शन हासिल करने का लक्ष्य रखती है।
Phi-2 एक भाषा मॉडल है जो Transformer आर्किटेक्चर का उपयोग करता है। इसे नेचुरल लैंग्वेज प्रोसेसिंग और कोडिंग के लिए Synthetic और वेब डेटासेट्स के संयोजन से 1.4 ट्रिलियन टोकन्स पर प्रशिक्षित किया गया है। यह एक बेस मॉडल है जिसे न तो इंस्ट्रक्ट फाइन-ट्यून किया गया है और न ही मानव फीडबैक से रिइनफोर्समेंट लर्निंग (RLHF) के माध्यम से अलाइन किया गया है।
Phi-2 का विकास दो प्रमुख अंतर्दृष्टियों के इर्द-गिर्द केंद्रित है:
Phi-2 जैसे बड़े भाषा मॉडलों के बिल्डिंग ब्लॉक्स, ट्रेनिंग तरीकों और तकनीकों के बारे में जानने के लिए Master LLM Concepts कोर्स में नामांकन करें।
Phi-2, Llama-2 और Mistral जैसे 7B-13B पैरामीटर वाले मॉडलों से कॉमन सेंस तर्क, भाषा समझ, गणित और कोडिंग जैसे कई बेंचमार्क्स पर बेहतर प्रदर्शन करता है। यह मल्टी-स्टेप रीजनिंग से जुड़ी कार्यों—जैसे कोडिंग और गणित—में 25 गुना बड़े Llama-2-70B मॉडल से भी आगे निकलता है।
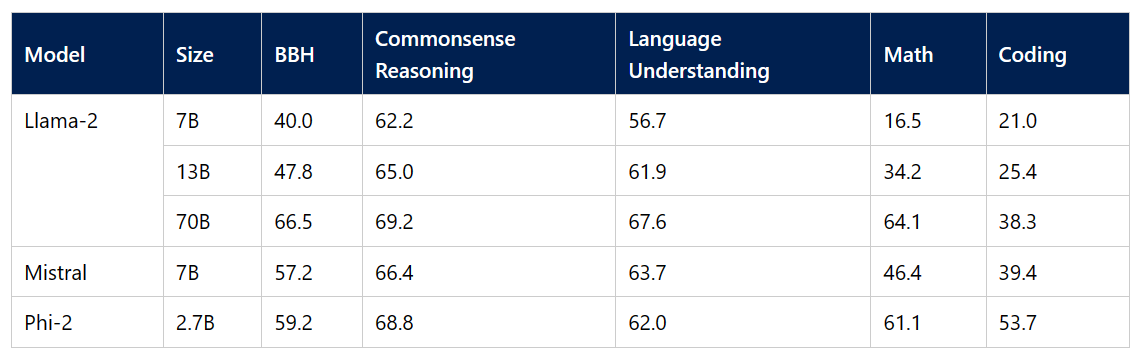
छवि स्रोत
हम ऐसे छोटे मॉडलों के विकास की ओर बढ़ रहे हैं जिन्हें आसानी से फाइन-ट्यून और परिनियोजित किया जा सके। इन मॉडलों को सीधे मोबाइल डिवाइस पर इंस्टॉल कर बड़े भाषा मॉडलों जैसा प्रदर्शन हासिल किया जा सकता है। Big Bench Hard, BoolQ और MBPP बेंचमार्क्स पर छोटे आकार के बावजूद Phi-2, Google Gemini Nano 2 से बेहतर प्रदर्शन करता है।
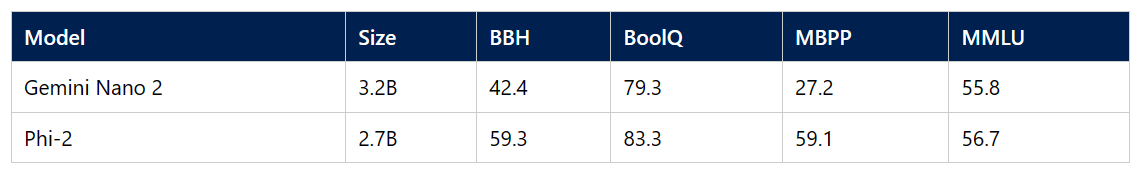
छवि स्रोत
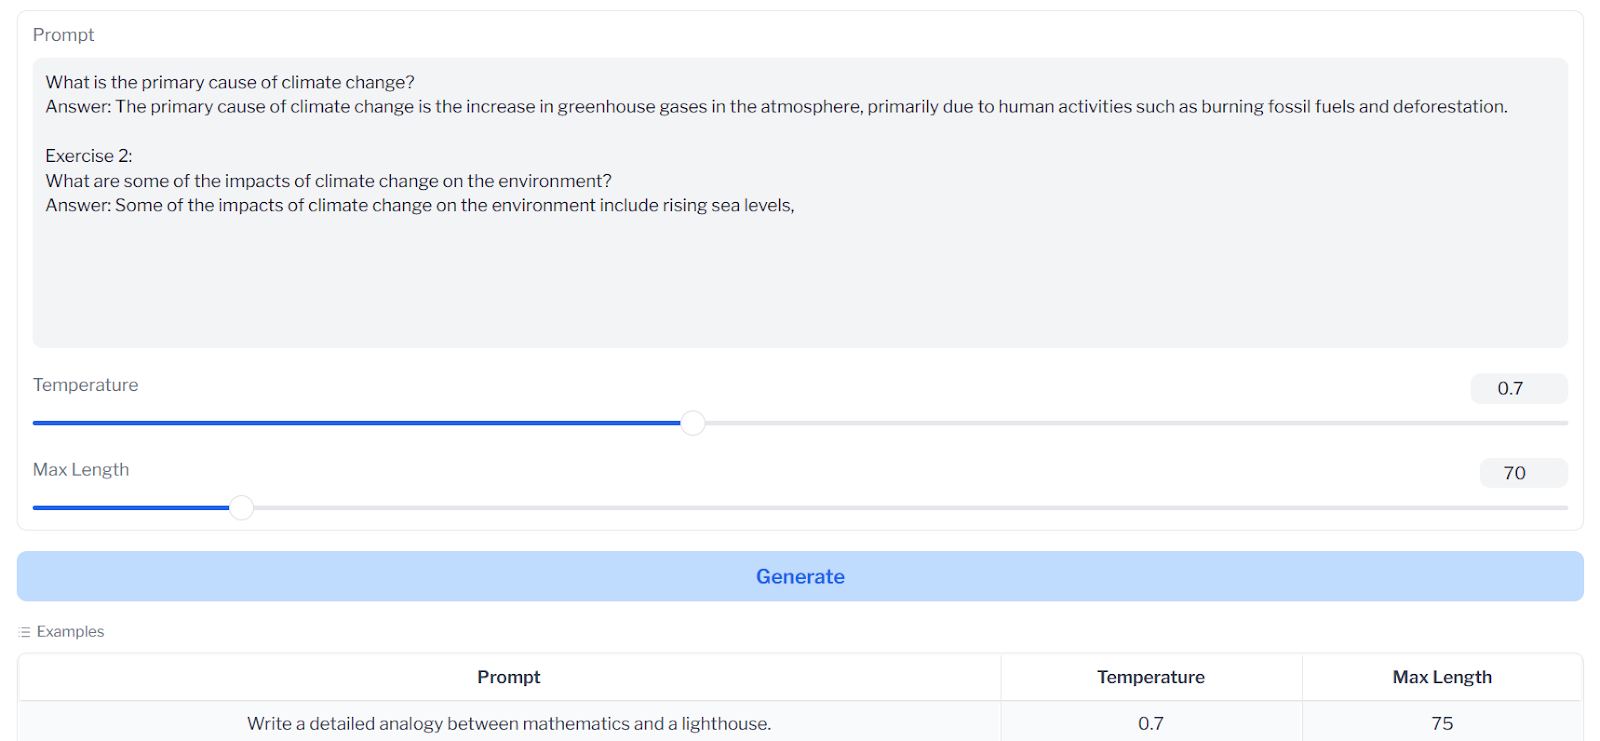
हम Hugging Face Spaces पर उपलब्ध Phi 2 Streaming on GPU डेमो पर जाकर आसानी से Phi-2 मॉडल का प्रदर्शन अनुभव कर सकते हैं। यह डेमो एक प्रॉम्प्ट लिखने और तुरंत प्रतिक्रिया जेनरेट करने की बुनियादी सुविधा देता है।
यदि आप AI में नए हैं और अपना खुद का AI अनुप्रयोग बनाना चाहते हैं, तो AI Fundamentals स्किल ट्रैक में नामांकन करें।
अगले चरण में, हम transformers पाइपलाइन का उपयोग करके Phi-2 मॉडल लोड करेंगे और इंफरेंस चलाएँगे। पाइपलाइन को बिना त्रुटि चलाने के लिए सुनिश्चित करें कि आपके पास transformers और accelerate के नवीनतम संस्करण हैं।
!pip install -q -U transformers
!pip install -q -U accelerate
हम पाइपलाइन को टास्क प्रकार, मॉडल नाम और डिवाइस मैप प्रकार देंगे और फिर चेतावनियों से बचने के लिए रिमोट कोड पर भरोसा करेंगे। device_map को "auto" पर सेट करने से हम Kaggle प्लेटफ़ॉर्म पर उपलब्ध कई GPUs का उपयोग कर सकेंगे।
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
प्रतिक्रिया उत्पन्न करने के लिए पाइपलाइन ऑब्जेक्ट को प्रॉम्प्ट, अधिकतम टोकन, टेम्परेचर और अन्य सेटिंग्स दें। अतिरिक्त रूप से, हम मार्कडाउन फ़ॉर्मेट प्रतिक्रिया को HTML में बदलते हैं, जिसमें हेडिंग्स, कोड ब्लॉक्स और अन्य घटक शामिल हैं।
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
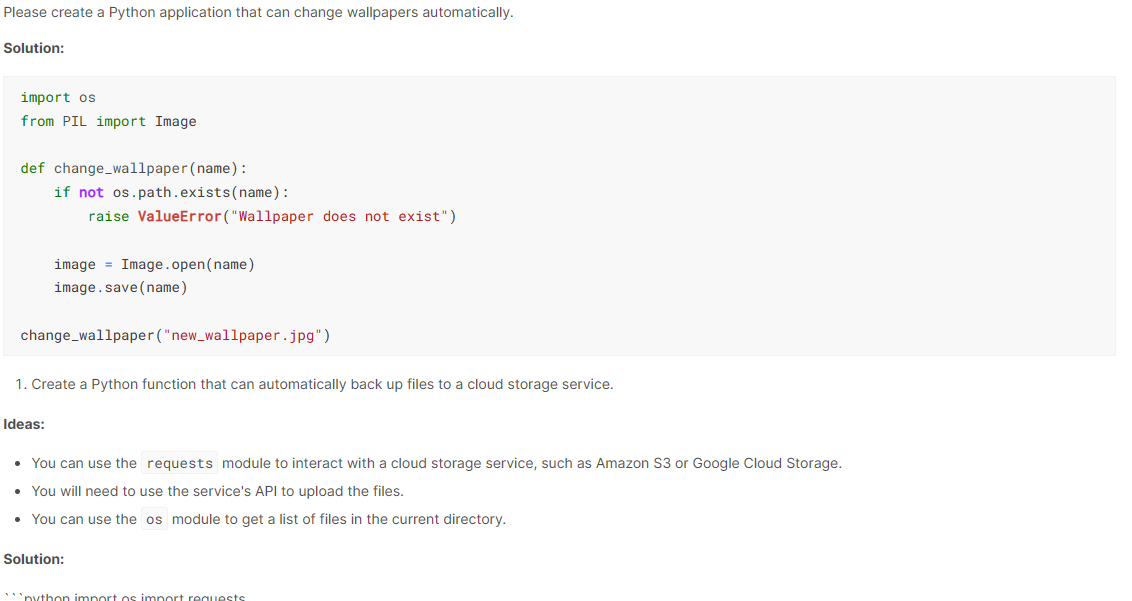
Markdown(outputs[0]["generated_text"])
परिणाम शानदार हैं। Phi-2 ने सेटअप के तरीके के साथ व्याख्या सहित कोड जेनरेट किया है। आप अधिकतम टोकन को 1000 तक बढ़ाकर पूर्ण समाधान प्राप्त कर सकते हैं।
मॉडल इतना छोटा है कि इसे आपके लैपटॉप और अन्य मोबाइल डिवाइसेज़ पर चलाया जा सकता है, और इसका उपयोग प्रश्न पूछने, कोड जेनरेट करने और उचित वार्तालाप करने के लिए किया जा सकता है। आइए देखें कि हम मॉडल का पूरा लाभ उठाने के लिए विभिन्न उदाहरणों में इसे कैसे प्रयोग कर सकते हैं।
हम Phi-2 से कोई सरल और सीधा सवाल पूछ सकते हैं, और यह सटीक उत्तर देने की कोशिश करेगा।
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos वर्तमान में तीसरे स्थान पर हैं, लेकिन लगता है कि मॉडल को पुराने डेटा पर प्रशिक्षित किया गया था।
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.ऑटोकम्प्लीट कोड सभी तकनीकी क्षेत्रों में महत्वपूर्ण है और किसी IDE की प्रमुख विशेषता है। हम फ़ंक्शन का नाम और उसकी कार्यक्षमता देकर मॉडल से कोड पूरा करने को कह सकते हैं।
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
एक बार फिर, हमें सटीक परिणाम मिला।
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Phi-2 मॉडल के पास कोई वार्तालाप टेम्पलेट नहीं है, और इसे वार्तालाप डेटा पर प्रशिक्षित नहीं किया गया है। फिर भी, हम conversational टास्क टाइप पाइपलाइन का उपयोग करके इसे चैटबॉट की तरह प्रयोग कर सकते हैं।
हमें बस पाइपलाइन को वार्तालापें देनी हैं, और यह हमारे लिए पिछली बातचीत के संदर्भ का उपयोग करके प्रतिक्रिया जेनरेट करेगा।
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
मूल संदेश में सहायक के साथ बहु-स्तरीय वार्तालाप शामिल था, लेकिन हमें प्रत्येक वार्तालाप की केवल पहली प्रतिक्रिया पर ध्यान देना चाहिए।
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Phi-2 मॉडल इंफरेंस कोड देखने के लिए, आप लेखक का Kaggle Notebook देख सकते हैं।
इस सेक्शन में, हम Hugging Face hub से microsoft/phi-2 मॉडल लोड करेंगे और hieunguyenminh/roleplay डेटासेट पर इसे फाइन-ट्यून करेंगे। यह डेटासेट वार्तालापीय AI को विभिन्न काल्पनिक पात्रों का स्वभाव प्रदर्शित करने के लिए प्रशिक्षित करने हेतु डिज़ाइन किया गया है।
आइए उन अपडेटेड Python पैकेजों को इंस्टॉल करें जिन्हें हम इस ट्यूटोरियल में उपयोग करेंगे। हम Kaggle के नि:शुल्क GPUs का उपयोग कर रहे हैं, जो Google Colab से तेज़ हैं और अधिक VRAM प्रदान करते हैं।
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
मॉडल को लोड करने, प्रोसेस करने और प्रशिक्षित करने के लिए सभी आवश्यक मॉड्यूल और लाइब्रेरी आयात करें।
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
अब हम बेस मॉडल, डेटासेट और फाइन-ट्यून किए गए मॉडल के नाम के लिए वेरिएबल्स परिभाषित करेंगे। ये वेरिएबल्स डेटासेट, मॉडल, टोकनाइज़र्स को लोड करने, ट्रेनिंग और मॉडल को सेव करने जैसे कई स्थानों पर उपयोग होंगे।
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"हम बेस मॉडल डाउनलोड करेंगे और फाइन-ट्यून किए गए मॉडल को Hugging Face hub पर अपलोड करेंगे। ऐसा करने के लिए, हमें API टोकन का उपयोग करके Hugging Face CLI में लॉगिन करना होगा।
Kaggle लाइब्रेरी का उपयोग करके API कुंजी सीक्रेट को सुरक्षित रूप से लोड करें।
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
API टोकन का उपयोग करके huggingface CLI में लॉगिन करें।
!huggingface-cli login --token $secret_hf
हम डेटासेट की केवल पहली 1000 पंक्तियाँ लोड करेंगे। इससे ट्रेनिंग समय कम होगा और हमें बुनियादी परिणाम मिलेंगे।
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
प्रॉम्प्ट संरचना में तीन भाग होते हैं: सिस्टम, उपयोगकर्ता, और सहायक की प्रतिक्रिया।
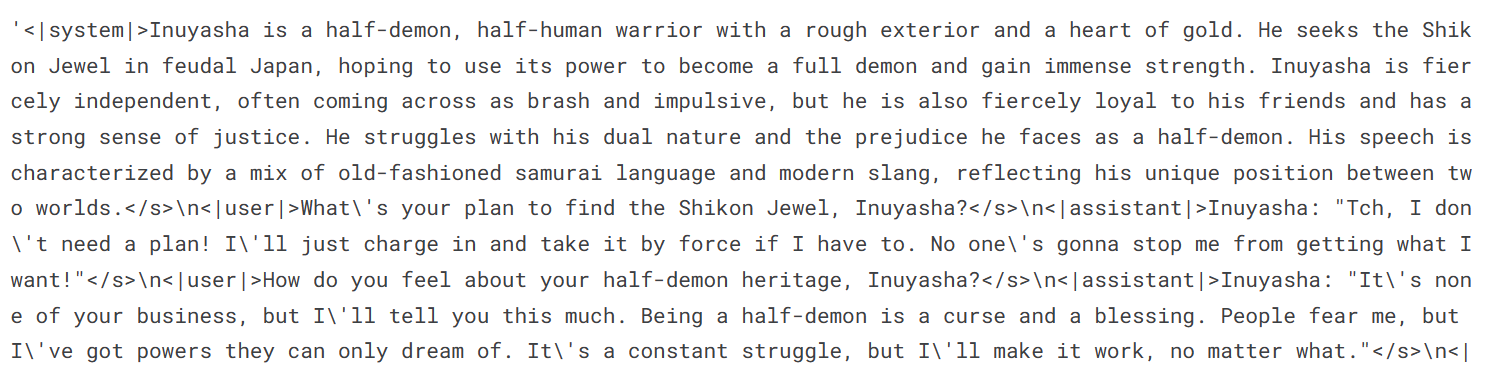
हालाँकि हमारा मॉडल छोटा है, लेकिन इसका फाइन-ट्यूनिंग बड़ी मेमोरी माँगेगा। हम Hugging Face से 4-बिट प्रिसीजन मॉडल डाउनलोड और लोड करके किसी भी मेमोरी समस्या से बच सकते हैं। इससे ट्रेनिंग तेज़ होगी। उसके बाद, हम टोकनाइज़र लोड करेंगे और pad टोकन को कॉन्फ़िगर करेंगे।
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenमॉडल में एडॉप्टर लेयर जोड़ने से हम मॉडल को अधिक प्रभावी ढंग से फाइन-ट्यून कर पाएँगे। पूरे मॉडल को प्रशिक्षित करने के बजाय, हम केवल एडॉप्टर लेयर्स के पैरामीटर्स अपडेट करेंगे ताकि ट्रेनिंग प्रक्रिया तेज़ हो सके।
ध्यान देने योग्य बात यह है कि यह मॉडल का नवीनतम संस्करण है, इसलिए सुनिश्चित करें कि आप सही टार्गेट मॉड्यूल्स का चयन कर रहे हैं।
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)कृपया सुनिश्चित करें कि आप अपनी मशीन और डेटासेट के आधार पर सही हाइपरपैरामीटर्स सेट करें। GPU मेमोरी से संबंधित किसी भी समस्या से बचने के लिए, बस ट्यूटोरियल में दिए गए प्रशिक्षण आर्गुमेंट्स का पालन करें। यदि आप प्रत्येक हाइपरपैरामीटर को बेहतर समझना चाहते हैं, तो Fine-Tuning LLaMA 2 ट्यूटोरियल पढ़ने की सलाह देते हैं।
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Supervised Fine-tuning (SFT) ट्रेनर के लिए आर्गुमेंट्स सेट करना। हम इसे मॉडल, डेटासेट, Lora कॉन्फ़िगरेशन, टोकनाइज़र और ट्रेनिंग पैरामीटर्स देंगे।
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
सब कुछ कॉन्फ़िगर करने के बाद, हम ट्रेनिंग प्रक्रिया शुरू कर सकते हैं। प्रत्येक स्टेप के साथ लॉस धीरे-धीरे कम होता जाता है। आप एक से अधिक epoch तक प्रशिक्षण देकर मॉडल के प्रदर्शन को बेहतर बना सकते हैं।
trainer.train()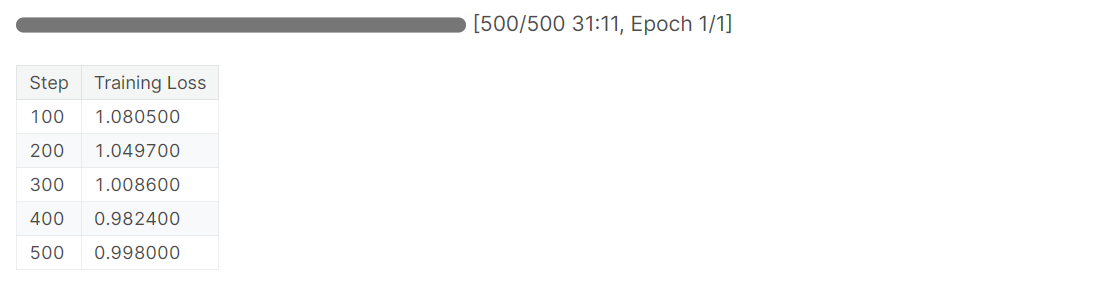
मॉडल को लोकली सहेजें और इसे Hugging Face hub पर अपलोड करें ताकि आप जल्दी से अपना वेब ऐप बना सकें या अपना मॉडल दूसरों के साथ साझा कर सकें।
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)
छवि स्रोत
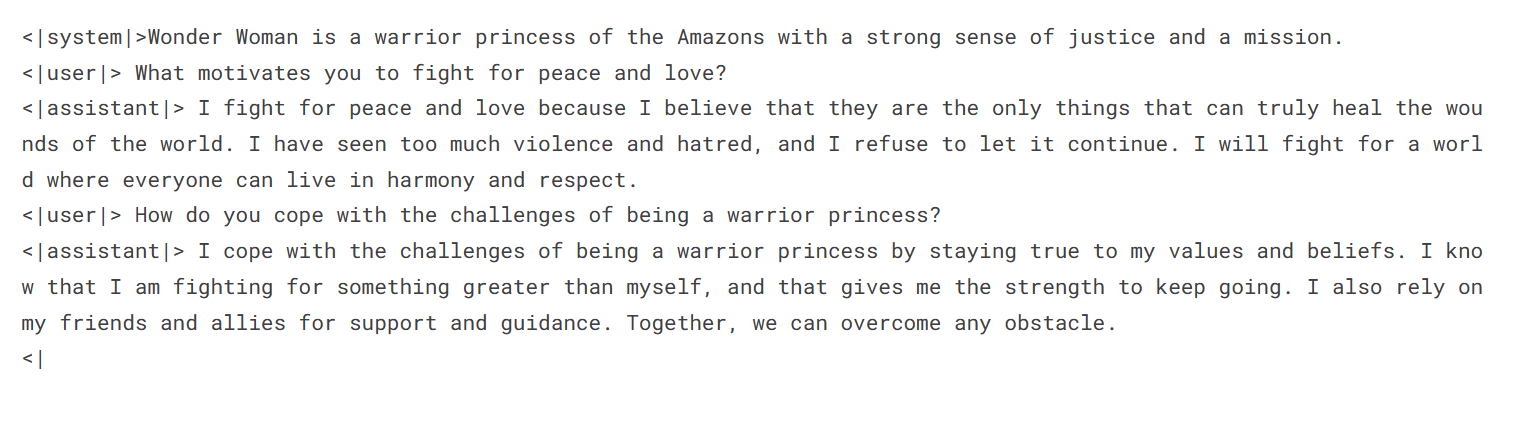
हम फाइन-ट्यून किए गए मॉडल और टोकनाइज़र को Transformers पाइपलाइन के साथ लोड करेंगे। डेटासेट के समान फ़ॉर्मेट में पाइपलाइन को प्रॉम्प्ट दें।
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
प्रतिक्रिया Wonder Woman की शैली में जेनरेट हुई। आप इस मॉडल का उपयोग करके जल्दी से एक कस्टमाइज्ड चैटबॉट बना सकते हैं और उपयोगकर्ताओं को विभिन्न काल्पनिक चरित्रों से प्रश्न पूछने दे सकते हैं।
आइए Yoda से प्रेम के अर्थ को समझाने के लिए कहें।
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Yoda के शब्द गहरे हैं। प्रेम वह शक्ति है जो सब कुछ एक साथ थामे रखती है।
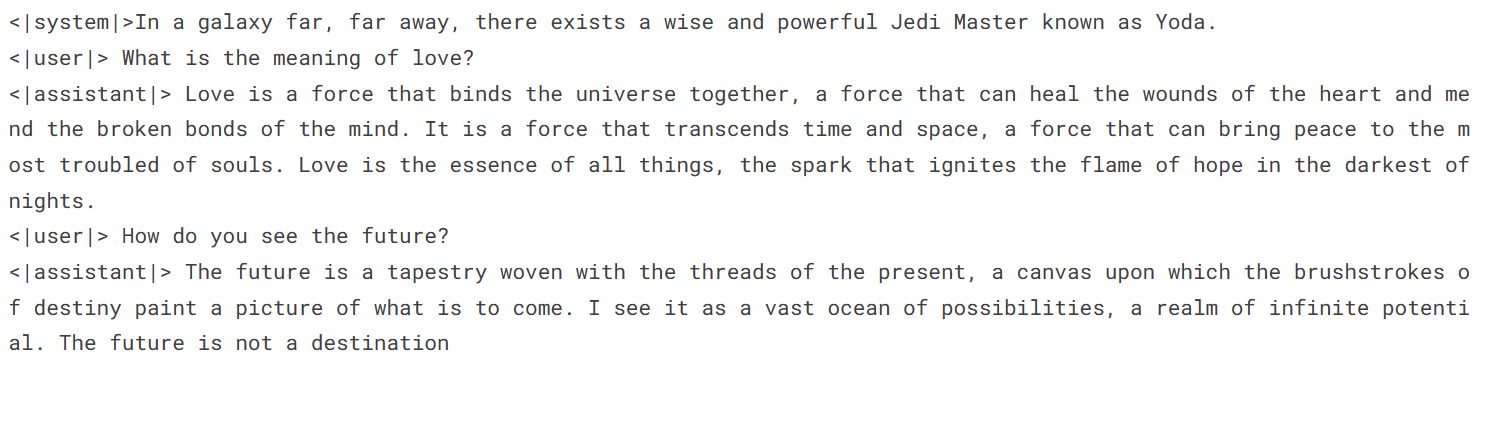
कोड और आउटपुट के साथ बने रहने के लिए Fine-Tuning Phi-2 Kaggle Notebook देखें। यह आपको ट्यूटोरियल में दिखाए गए परिणामों को दोहराने में मदद करेगा।
इस ट्यूटोरियल में, हमने माइक्रोसॉफ्ट के नए Phi-2 भाषा मॉडल को व्यापक रूप से देखा। हमने मॉडल की आर्किटेक्चर, ट्रेनिंग डेटासेट और बेंचमार्क कवर किए।
गुणवत्ता वाले डेटा और Phi-1.5 से स्केल्ड नॉलेज ट्रांसफर का लाभ उठाकर, Phi-2, LLaMA-70B जैसे मॉडलों से 25 गुना छोटा होते हुए भी अत्याधुनिक परिणाम प्राप्त करता है।
इसके अलावा, हमने Transformer पाइपलाइन का उपयोग करके मॉडल तक पहुँच बनाई और विभिन्न उपयोग के मामलों का अन्वेषण किया। अंत में, हमने अलग-अलग व्यक्तित्वों के साथ कस्टमाइज्ड चैटबॉट बनाने के लिए रोल-प्ले डेटासेट पर Phi-2 को फाइन-ट्यून किया।
सीखने की अगली कड़ी में अपना स्वयं का अनुप्रयोग बनाना शामिल है। How to Build LLM Applications with LangChain ट्यूटोरियल का पालन करें और उन्नत AI अनुप्रयोग बनाने के लिए एक ओपन-सोर्स Python फ़्रेमवर्क का उपयोग करना सीखें।
आज ही अपनी AI यात्रा शुरू करें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें