

Particle Swarm Optimization (PSO)
Particle swarm optimization (PSO) terinspirasi dari perilaku sekawanan burung dan gerombolan ikan. Dalam sistem alami ini, individu bergerak berdasarkan pengalaman sebelumnya dan posisi tetangganya, secara bertahap menyesuaikan diri mengikuti anggota kelompok yang paling berhasil. PSO menerapkan konsep ini pada masalah optimisasi, di mana partikel, disebut agen, bergerak melalui ruang pencarian untuk menemukan solusi optimal.
Dibandingkan ACO, PSO beroperasi di ruang kontinu, bukan diskret. Dalam ACO, fokusnya pada pencarian jalur dan pilihan diskret, sedangkan PSO lebih cocok untuk masalah yang melibatkan variabel kontinu, seperti penyetelan parameter.
Dalam PSO, partikel menjelajahi ruang pencarian. Mereka menyesuaikan posisinya berdasarkan dua faktor utama: posisi terbaik pribadi yang pernah diketahui dan posisi terbaik yang diketahui oleh seluruh kawanan. Mekanisme umpan balik ganda ini memungkinkan mereka berkonvergensi menuju optimum global.
Cara kerja particle swarm optimization
Proses dimulai dengan kawanan partikel yang diinisialisasi secara acak di seluruh ruang solusi. Setiap partikel merepresentasikan solusi yang mungkin untuk masalah optimisasi. Saat partikel bergerak, mereka mengingat posisi terbaik pribadi (solusi terbaik yang mereka temukan sejauh ini) dan tertarik ke posisi terbaik global (solusi terbaik yang ditemukan partikel mana pun).
Gerakan ini didorong oleh dua faktor: eksploitasi dan eksplorasi. Eksploitasi melibatkan penyempurnaan pencarian di sekitar solusi terbaik saat ini, sementara eksplorasi mendorong partikel untuk mencari bagian lain dari ruang solusi agar tidak terjebak pada optimum lokal. Dengan menyeimbangkan dua dinamika ini, PSO secara efisien berkonvergensi pada solusi terbaik.
Implementasi Python untuk particle swarm optimization
Dalam manajemen portofolio keuangan, menemukan cara terbaik untuk mengalokasikan aset guna memperoleh imbal hasil setinggi mungkin dengan risiko rendah bisa jadi rumit. Mari gunakan PSO untuk mencari campuran aset yang akan memberi kita tingkat pengembalian investasi tertinggi.
Kode di bawah menunjukkan cara kerja PSO untuk mengoptimalkan portofolio keuangan fiksi. Ia memulai dengan alokasi aset acak, lalu menyetelnya selama beberapa iterasi berdasarkan apa yang paling berhasil, secara bertahap menemukan campuran aset optimal untuk imbal hasil tertinggi dengan risiko terendah.
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")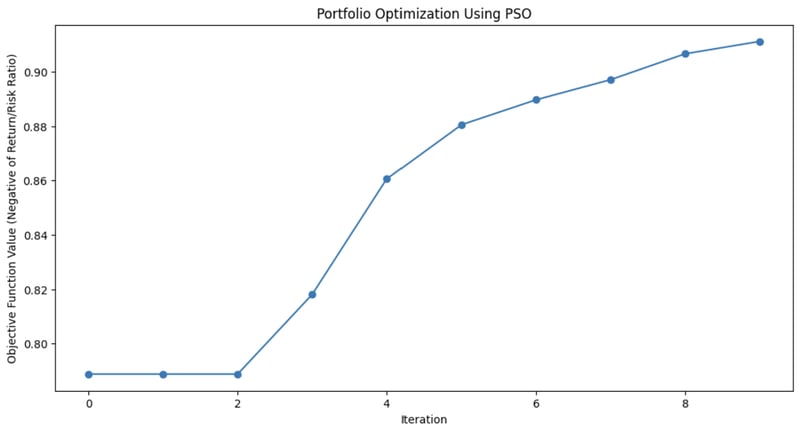
Grafik ini menunjukkan sejauh mana algoritma PSO memperbaiki komposisi aset portofolio di setiap iterasi.
Aplikasi particle swarm optimization
PSO digunakan karena kesederhanaan dan efektivitasnya dalam menyelesaikan berbagai masalah optimisasi, khususnya pada domain kontinu. Fleksibilitasnya membuatnya berguna untuk banyak skenario dunia nyata yang memerlukan solusi presisi.
Aplikasinya meliputi:
- Machine learning: PSO dapat diterapkan untuk menyetel hiperparameter pada algoritma machine learning, membantu menemukan konfigurasi model terbaik.
- Desain rekayasa: PSO berguna untuk mengoptimalkan parameter desain untuk sistem seperti komponen dirgantara atau rangkaian listrik.
- Pemodelan keuangan: Dalam keuangan, PSO dapat membantu optimisasi portofolio, meminimalkan risiko sekaligus memaksimalkan imbal hasil.
Kemampuan PSO untuk secara efisien mengeksplorasi ruang solusi membuatnya dapat diterapkan lintas bidang, mulai dari robotika hingga manajemen energi dan logistik.
Artificial Bee Colony (ABC)
Algoritma artificial bee colony (ABC) dimodelkan dari perilaku mencari makan lebah madu.
Di alam, lebah madu secara efisien mencari sumber nektar dan membagikan informasi ini kepada anggota sarang lainnya. ABC menangkap proses pencarian kolaboratif ini dan menerapkannya pada masalah optimisasi, terutama yang melibatkan ruang berdimensi tinggi dan kompleks.
Yang membedakan ABC dari algoritma kecerdasan kawanan lainnya adalah kemampuannya menyeimbangkan eksploitasi, berfokus menyempurnakan solusi saat ini, dan eksplorasi, mencari solusi baru yang berpotensi lebih baik. Ini membuat ABC sangat berguna untuk masalah skala besar di mana optimisasi global adalah kunci.
Cara kerja artificial bee colony
Dalam algoritma ABC, kawanan lebah dibagi menjadi tiga peran khusus: employed bees, onlookers, dan scouts. Masing-masing peran ini meniru aspek berbeda dari cara lebah mencari dan mengeksploitasi sumber makanan di alam.
- Employed bees: Lebah ini bertanggung jawab menjelajahi sumber makanan yang sudah diketahui, merepresentasikan solusi saat ini dalam masalah optimisasi. Mereka menilai kualitas (kebugaran/fitness) sumber tersebut dan membagikan informasinya ke seluruh sarang.
- Onlooker bees: Setelah mengumpulkan informasi dari employed bees, onlooker memilih sumber makanan mana yang akan dieksplorasi lebih lanjut. Mereka mendasarkan pilihan pada kualitas solusi yang dibagikan employed bees, dengan fokus lebih pada opsi yang lebih baik, sehingga menyempurnakan pencarian solusi optimal.
- Scout bees: Ketika sumber makanan (solusi) milik employed bee menjadi habis atau stagnan (tidak ada perbaikan setelah sejumlah iterasi), lebah tersebut menjadi scout. Scout menjelajahi area baru dari ruang solusi, mencari sumber makanan yang mungkin belum dijelajahi, sehingga menyuntikkan keragaman ke dalam proses pencarian.
Dinamika ini memungkinkan ABC menyeimbangkan pencarian antara mengeksplorasi area menjanjikan secara intensif dan secara luas menelusuri area baru dalam ruang pencarian. Ini membantu algoritma menghindari jebakan optimum lokal dan meningkatkan peluang menemukan optimum global.
Implementasi Python untuk artificial bee colony
Fungsi Rastrigin adalah masalah populer dalam optimisasi, dikenal memiliki banyak minimum lokal, sehingga menjadi tantangan berat bagi banyak algoritma. Tujuannya sederhana: menemukan minimum global.
Dalam contoh ini, kita akan menggunakan algoritma artificial bee colony untuk mengatasi masalah ini. Setiap lebah dalam algoritma ABC menjelajahi ruang pencarian, mencari solusi yang lebih baik untuk meminimalkan fungsi. Kode ini mensimulasikan lebah yang mengeksplorasi, mengeksploitasi, dan mencari area baru, memastikan keseimbangan antara eksplorasi dan eksploitasi.
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()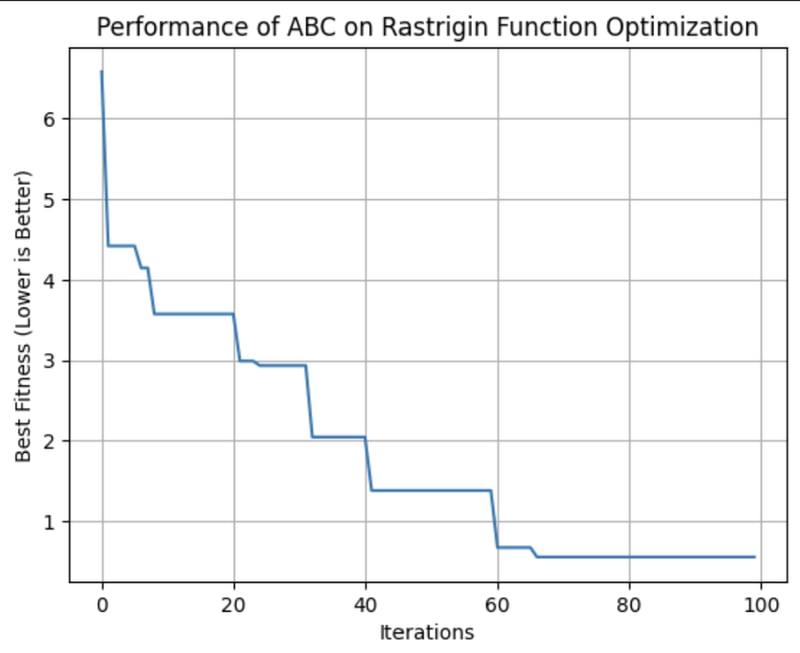
Grafik ini menunjukkan fitness dari solusi terbaik yang ditemukan algoritma ABC di setiap iterasi. Pada percobaan ini, ia mencapai fitness optimum sekitar iterasi ke-64.
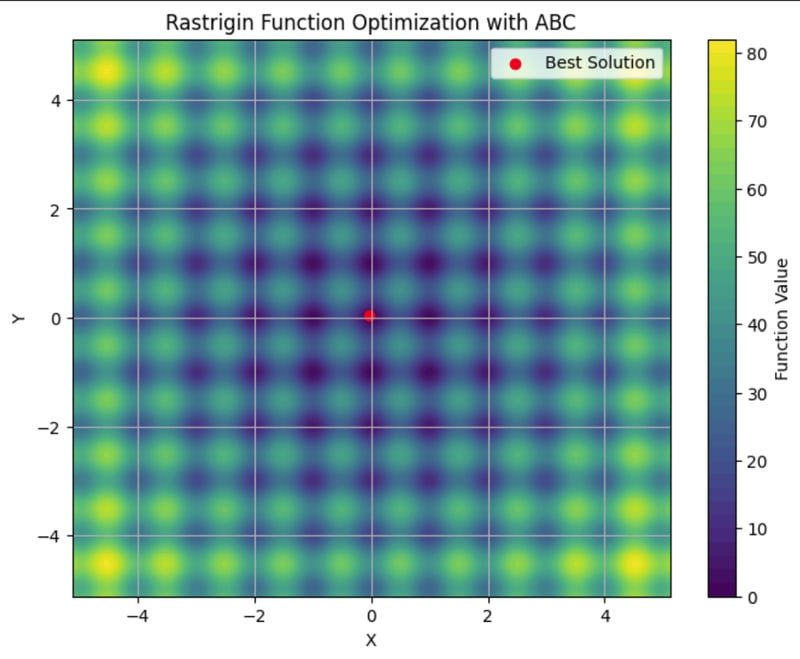
Di sini Anda dapat melihat fungsi Rastrigin yang digambarkan pada contour plot, dengan banyak minimum lokal. Titik merah adalah minimum global yang ditemukan oleh algoritma ABC yang kita jalankan.
Aplikasi artificial bee colony
Algoritma ABC adalah alat yang tangguh untuk menyelesaikan masalah optimisasi. Kemampuannya untuk secara efisien menjelajahi ruang pencarian yang besar dan kompleks menjadikannya andalan bagi industri yang memerlukan kemampuan beradaptasi dan skalabilitas.
Aplikasinya meliputi:
- Telekomunikasi: ABC dapat digunakan untuk mengoptimalkan penempatan sumber daya jaringan dan antena, memaksimalkan cakupan dan kekuatan sinyal sekaligus meminimalkan biaya.
- Rekayasa: ABC dapat menyetel parameter dalam optimisasi desain struktural.
- Data Science: ABC dapat diterapkan untuk pemilihan fitur, guna mengidentifikasi variabel paling penting dalam suatu dataset untuk machine learning.
ABC adalah algoritma yang fleksibel, cocok untuk masalah apa pun di mana solusi optimal perlu ditemukan dalam lingkungan dinamis dan berdimensi tinggi. Sifatnya yang terdesentralisasi membuatnya cocok untuk situasi di mana algoritma lain mungkin kesulitan menyeimbangkan eksplorasi dan eksploitasi secara efisien.
Membandingkan Algoritma Kecerdasan Kawanan
Ada beberapa algoritma kecerdasan kawanan, masing-masing dengan karakteristik berbeda. Saat memutuskan mana yang akan digunakan, penting untuk mempertimbangkan kelebihan dan kelemahannya guna menentukan mana yang paling sesuai dengan kebutuhan Anda.
ACO efektif untuk masalah kombinatorial seperti perutean dan penjadwalan tetapi mungkin memerlukan sumber daya komputasi yang signifikan. PSO lebih sederhana dan unggul dalam optimisasi kontinu, seperti penyetelan hiperparameter, namun dapat kesulitan dengan optimum lokal. ABC berhasil menyeimbangkan eksplorasi dan eksploitasi, meskipun membutuhkan penyetelan yang cermat.
Algoritma kecerdasan kawanan lainnya, seperti Firefly Algorithm dan Cuckoo Search Optimization, juga menawarkan keunggulan unik untuk jenis masalah optimisasi tertentu.
|
Algoritma |
Kekuatan |
Kelemahan |
Pustaka yang Disarankan |
Aplikasi Terbaik |
|
Ant Colony Optimization (ACO) |
Efektif untuk masalah kombinatorial dan mampu menangani ruang diskret yang kompleks dengan baik |
Intensif komputasi dan memerlukan penyetelan yang presisi |
Masalah perutean, penjadwalan, dan alokasi sumber daya | |
|
Particle Swarm Optimization (PSO) |
Baik untuk optimisasi kontinu serta sederhana dan mudah diimplementasikan |
Dapat berkonvergensi ke optimum lokal dan kurang efektif untuk masalah diskret |
Penyetelan hiperparameter, desain rekayasa, pemodelan keuangan | |
|
Artificial Bee Colony (ABC) |
Adaptif untuk masalah besar dan dinamis serta seimbang antara eksplorasi dan eksploitasi |
Intensif komputasi dan memerlukan penyetelan parameter yang cermat |
Telekomunikasi, optimisasi skala besar, dan ruang berdimensi tinggi | |
|
Firefly Algorithm (FA) |
Unggul dalam optimisasi multimodal dan memiliki kemampuan pencarian global yang kuat |
Sensitif terhadap pengaturan parameter dan konvergensi lebih lambat |
Pemrosesan citra, desain rekayasa, dan optimisasi multimodal | |
|
Cuckoo Search (CS) |
Efisien untuk menyelesaikan masalah optimisasi dan memiliki kemampuan eksplorasi yang kuat |
Dapat berkonvergensi terlalu cepat dan performa bergantung pada penyetelan |
Penjadwalan, pemilihan fitur, dan aplikasi rekayasa |
Tantangan dan Keterbatasan
Algoritma kecerdasan kawanan, seperti banyak teknik machine learning lainnya, menghadapi tantangan yang dapat memengaruhi kinerjanya. Ini termasuk:
- Konvergensi prematur: Kawanan mungkin terlalu cepat menetap pada solusi suboptimal.
- Penyetelan parameter: Untuk mencapai hasil optimal sering kali diperlukan penyesuaian pengaturan algoritma yang cermat.
- Sumber daya komputasi & skalabilitas: Algoritma ini dapat intensif komputasi, terutama untuk masalah yang lebih besar dan kompleks, dan kinerjanya dapat menurun saat kompleksitas masalah meningkat.
- Sifat stokastik: Keacakan yang melekat pada algoritma ini dapat menyebabkan variasi hasil.
Riset dan Kemajuan Terbaru
Tren yang menonjol adalah integrasi kecerdasan kawanan dengan teknik machine learning lainnya. Para peneliti mengeksplorasi bagaimana algoritma kawanan dapat meningkatkan tugas seperti pemilihan fitur dan optimisasi hiperparameter. Lihat A hybrid particle swarm optimization algorithm for solving engineering problem.
Kemajuan terbaru juga berfokus pada penanganan beberapa tantangan tradisional yang terkait dengan kecerdasan kawanan, seperti konvergensi prematur. Algoritma dan teknik baru dikembangkan untuk mengurangi risiko berkonvergensi pada solusi suboptimal. Untuk informasi lebih lanjut, lihat Pendekatan berbasis memori untuk menghilangkan konvergensi prematur pada particle swarm optimization
Skalabilitas adalah area riset penting lainnya. Seiring masalah menjadi semakin kompleks dan volume data meningkat, para peneliti bekerja untuk membuat algoritma kecerdasan kawanan lebih skalabel dan efisien. Ini termasuk pengembangan algoritma yang dapat menangani dataset besar dan ruang berdimensi tinggi secara lebih efektif, sekaligus mengoptimalkan sumber daya komputasi untuk mengurangi waktu dan biaya menjalankan algoritma ini. Untuk informasi lebih lanjut, lihat Perkembangan Terbaru dalam Teori dan Keterterapan Swarm Search.
Algoritma kawanan diterapkan pada masalah mulai dari robotika, hingga large language model (LLM), hingga diagnosis medis. Ada riset yang sedang berlangsung tentang apakah algoritma ini dapat berguna untuk membantu LLM secara strategis melupakan informasi guna mematuhi regulasi Right to Be Forgotten. Dan, tentu saja, algoritma kawanan memiliki banyak aplikasi dalam data science.
Kesimpulan
Kecerdasan kawanan menawarkan solusi yang kuat untuk masalah optimisasi di berbagai industri. Prinsip-prinsip desentralisasi, umpan balik positif, dan adaptasi memungkinkannya menangani tugas-tugas yang kompleks dan dinamis yang mungkin sulit ditangani algoritma tradisional.
Lihat ulasan tentang kondisi terkini algoritma kawanan, “Swarm intelligence: A survey of model classification and applications”.
Untuk menggali lebih dalam aplikasi bisnis AI, lihat Artificial Intelligence (AI) Strategy atau Artificial Intelligence for Business Leaders. Untuk mempelajari algoritma lain yang meniru alam, lihat Genetic Algorithm: Complete Guide With Python Implementation.

Saya seorang PhD dengan pengalaman 13 tahun bekerja dengan data di lingkungan riset biologi. Saya membuat perangkat lunak dalam beberapa bahasa pemrograman termasuk Python, MATLAB, dan R. Saya bersemangat membagikan kecintaan saya terhadap pembelajaran kepada dunia.





Bayangkan Anda menyaksikan sekawanan burung sedang terbang. Tidak ada pemimpin, tidak ada yang memberi arahan, tetapi mereka menukik dan meluncur bersama dengan harmoni sempurna. Sekilas tampak kacau, namun ada keteraturan tersembunyi. Pola yang sama dapat Anda lihat pada gerombolan ikan yang menghindari predator atau semut yang menemukan jalur terpendek menuju makanan. Makhluk-makhluk ini mengandalkan aturan sederhana dan komunikasi lokal untuk menyelesaikan tugas-tugas yang mengejutkan kompleks tanpa kendali terpusat.
Itulah keajaiban kecerdasan kawanan.
Kita dapat mereplikasi perilaku ini menggunakan algoritma yang memecahkan masalah sulit dengan meniru kecerdasan kawanan.
Apa Itu Kecerdasan Kawanan?
Kecerdasan kawanan adalah pendekatan komputasional yang memecahkan masalah kompleks dengan meniru perilaku terdesentralisasi dan swaterorganisasi yang diamati pada kawanan alami seperti sekawanan burung atau koloni semut.
Mari kita telaah dua konsep kunci: desentralisasi dan umpan balik positif.
Desentralisasi dan kemunculan (emergence)
Inti dari kecerdasan kawanan adalah konsep desentralisasi. Alih-alih mengandalkan seorang pemimpin pusat untuk mengarahkan tindakan, setiap individu, atau "agen", beroperasi secara otonom berdasarkan informasi lokal yang terbatas.
Pengambilan keputusan yang terdesentralisasi ini menghasilkan sifat emergen—perilaku kompleks dan terorganisasi yang muncul dari interaksi sederhana antar agen. Dalam sistem kawanan, hasil keseluruhan, atau solusi, tidak diprogram sebelumnya tetapi muncul secara alami dari tindakan individu ini.
Ambil contoh semut. Saat mencari makan, seekor semut menjelajah lingkungannya secara acak hingga menemukan makanan, lalu ia menebarkan jejak feromon dalam perjalanan kembali ke koloni. Semut lain menemukan jejak ini dan cenderung mengikutinya, memperkuat jalur jika mereka menemukan makanan di ujungnya. Seiring waktu, rute yang lebih pendek atau lebih efisien secara alami menarik lebih banyak semut karena jejak feromon yang lebih kuat terbentuk di sepanjang jalur tersebut. Tidak ada satu semut pun yang "tahu" rute terbaik sejak awal, tetapi secara kolektif, melalui keputusan terdesentralisasi dan penguatan jalur yang berhasil, koloni berkonvergensi pada solusi yang optimal.
Diagram ini menunjukkan bagaimana aturan sederhana yang diikuti oleh semut individual menghasilkan solusi optimal bagi seluruh koloni.
Umpan balik positif dan adaptasi
Umpan balik positif adalah mekanisme dalam sistem kecerdasan kawanan, di mana tindakan yang berhasil diberi penghargaan dan diperkuat. Ini menghasilkan proses yang saling memperkuat, seperti semut yang menguatkan jejak feromon di sepanjang jalur pencarian makan yang lebih pendek. Penguatan perilaku yang menguntungkan ini membantu kawanan meningkatkan kinerjanya secara keseluruhan dari waktu ke waktu.
Dalam kecerdasan buatan, algoritma kecerdasan kawanan menirunya dengan menyesuaikan faktor-faktor kunci, seperti probabilitas atau bobot, berdasarkan kualitas solusi yang ditemukan. Saat solusi yang lebih baik ditemukan, agen semakin memfokuskan perhatian pada solusi tersebut, sehingga mempercepat proses konvergensi. Lingkar umpan balik dinamis ini memungkinkan sistem kawanan beradaptasi dengan lingkungan yang berubah dan menyempurnakan kinerjanya.
Ada beberapa algoritma kecerdasan kawanan yang meniru berbagai sistem biologis. Mari kita bahas beberapa yang populer.
Ant Colony Optimization (ACO)
Ant colony optimization (ACO) adalah algoritma yang terinspirasi oleh perilaku mencari makan semut seperti dijelaskan di atas. Algoritma ini dirancang untuk memecahkan masalah optimisasi kombinatorial, khususnya yang mengharuskan kita menemukan solusi terbaik di antara banyak kemungkinan. Contoh klasiknya adalah masalah pedagang keliling, di mana tujuannya adalah menentukan rute terpendek yang menghubungkan satu set lokasi.
Cara kerja ant colony optimization
Di alam, semut berkomunikasi dengan meninggalkan jejak feromon, yang memberi sinyal kepada semut lain tentang jalur menuju sumber makanan. Semakin banyak semut mengikuti jejak tersebut, semakin kuat jejaknya. ACO meniru perilaku ini dengan feromon yang direpresentasikan oleh nilai matematis yang disimpan dalam matriks feromon. Matriks ini melacak keterpilihan berbagai solusi, dan diperbarui seiring algoritma berjalan.
Dalam ACO, setiap "semut buatan" merepresentasikan solusi potensial untuk masalah, seperti rute dalam masalah pedagang keliling. Algoritma dimulai dengan semua semut memilih jalur secara acak, dan nilai feromon membantu membimbing semut berikutnya. Nilai-nilai ini disimpan dalam matriks di mana setiap entri berkorespondensi dengan "tingkat feromon" antara dua titik (seperti kota).
Representasi matematis feromon ini memungkinkan ACO menyeimbangkan eksplorasi dan eksploitasi secara efektif, menelusuri ruang solusi yang besar tanpa terjebak pada optimum lokal.
Implementasi Python untuk ant colony optimization
Mari coba sebuah contoh, menggunakan ACO untuk memecahkan masalah sederhana: menemukan jalur terpendek antar titik pada sebuah grafik.
Implementasi ACO ini mensimulasikan bagaimana "semut" buatan melintasi 20 simpul pada grafik untuk menemukan jalur terpendek. Setiap semut memulai di simpul acak dan memilih langkah berikutnya berdasarkan jejak feromon dan jarak antar simpul. Setelah menjelajahi semua jalur, semut kembali ke titik awal, menyelesaikan satu putaran penuh.
Seiring waktu, feromon diperbarui: jalur yang lebih pendek menerima penguatan lebih kuat, sementara yang lain menguap. Proses dinamis ini memungkinkan algoritma berkonvergensi menuju solusi optimal.
Grafik ini menunjukkan solusi akhir, jalur terbaik yang ditemukan, untuk mengunjungi setiap simpul dengan jarak terpendek. Pada percobaan ini, rute terbaik adalah [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4], dengan total jarak 129.
Pada grafik ini, kita dapat melihat jarak yang ditempuh saat melintasi simpul-simpul berkurang seiring iterasi. Ini menunjukkan bahwa model memperbaiki panjang perjalanan dari waktu ke waktu.
Aplikasi ant colony optimization
Kemampuan adaptasi dan efisiensi ACO menjadikannya alat yang kuat di berbagai industri. Beberapa aplikasinya meliputi:
Kekuatan ACO terletak pada kemampuannya untuk berevolusi dan beradaptasi, menjadikannya cocok untuk lingkungan dinamis yang kondisinya dapat berubah, seperti perutean lalu lintas waktu nyata atau perencanaan industri.