

Tối ưu bầy hạt (PSO)
Tối ưu bầy hạt (PSO) lấy cảm hứng từ hành vi của đàn chim và đàn cá. Trong các hệ tự nhiên này, từng cá thể di chuyển dựa trên trải nghiệm trước đó của chính mình và vị trí của hàng xóm, dần điều chỉnh để theo những thành viên thành công nhất. PSO áp dụng khái niệm này cho các bài toán tối ưu, nơi các hạt, gọi là tác nhân, di chuyển trong không gian tìm kiếm để tìm nghiệm tối ưu.
So với ACO, PSO hoạt động trong không gian liên tục thay vì rời rạc. Ở ACO, trọng tâm là tìm đường và lựa chọn rời rạc, trong khi PSO phù hợp hơn với các bài toán biến liên tục, như tinh chỉnh tham số.
Trong PSO, các hạt khám phá không gian tìm kiếm. Chúng điều chỉnh vị trí dựa trên hai yếu tố chính: vị trí tốt nhất mà bản thân từng biết và vị trí tốt nhất mà cả bầy từng biết. Cơ chế phản hồi kép này giúp chúng hội tụ về cực trị toàn cục.
Cách tối ưu bầy hạt hoạt động
Quá trình bắt đầu với một bầy hạt được khởi tạo ngẫu nhiên khắp không gian nghiệm. Mỗi hạt đại diện cho một nghiệm khả dĩ của bài toán tối ưu. Khi các hạt di chuyển, chúng ghi nhớ vị trí tốt nhất của riêng mình (nghiệm tốt nhất mà chúng từng gặp) và bị hút về vị trí tốt nhất toàn cục (nghiệm tốt nhất mà bất kỳ hạt nào đã tìm thấy).
Sự di chuyển này được dẫn dắt bởi hai yếu tố: khai thác và khám phá. Khai thác liên quan đến việc tinh chỉnh tìm kiếm xung quanh nghiệm tốt hiện tại, trong khi khám phá khuyến khích các hạt tìm kiếm ở những phần khác của không gian nghiệm để tránh mắc kẹt ở cực trị cục bộ. Bằng cách cân bằng hai động lực này, PSO hội tụ hiệu quả tới nghiệm tốt nhất.
Hiện thực hóa PSO bằng Python
Trong quản lý danh mục tài chính, tìm cách phân bổ tài sản tối ưu để tối đa hóa lợi nhuận trong khi vẫn giữ rủi ro thấp có thể rất khó. Hãy dùng PSO để tìm tổ hợp tài sản mang lại tỷ suất sinh lời cao nhất.
Đoạn mã dưới đây minh họa cách PSO hoạt động để tối ưu một danh mục tài chính giả định. Nó bắt đầu với các phân bổ tài sản ngẫu nhiên, sau đó điều chỉnh trong vài vòng lặp dựa trên những gì hiệu quả, dần tìm ra cơ cấu tài sản tối ưu cho lợi nhuận cao nhất với rủi ro thấp nhất.
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")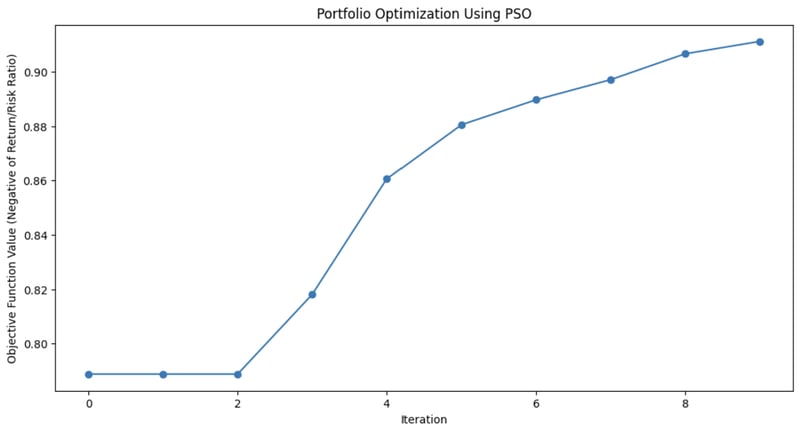
Biểu đồ này minh họa mức độ PSO đã cải thiện cơ cấu tài sản của danh mục qua từng vòng lặp.
Ứng dụng của tối ưu bầy hạt
PSO được sử dụng nhờ tính đơn giản và hiệu quả trong việc giải nhiều bài toán tối ưu, đặc biệt ở miền liên tục. Tính linh hoạt khiến nó hữu ích trong nhiều kịch bản thực tế cần nghiệm chính xác.
Các ứng dụng bao gồm:
- Học máy: PSO có thể dùng để tinh chỉnh siêu tham số trong các thuật toán học máy, giúp tìm cấu hình mô hình tốt nhất.
- Thiết kế kỹ thuật: PSO hữu ích để tối ưu các tham số thiết kế cho những hệ như linh kiện hàng không vũ trụ hoặc mạch điện.
- Mô hình tài chính: Trong tài chính, PSO có thể hỗ trợ tối ưu danh mục, tối thiểu hóa rủi ro đồng thời tối đa hóa lợi nhuận.
Khả năng khám phá không gian nghiệm hiệu quả giúp PSO có thể ứng dụng rộng rãi, từ robot đến quản lý năng lượng và logistics.
Đàn ong nhân tạo (ABC)
Thuật toán đàn ong nhân tạo (ABC) được mô phỏng theo hành vi kiếm mật của ong mật.
Trong tự nhiên, ong mật tìm kiếm nguồn mật hiệu quả và chia sẻ thông tin này với những thành viên khác trong tổ. ABC nắm bắt quá trình tìm kiếm cộng tác này và áp dụng vào các bài toán tối ưu, đặc biệt là những bài toán phức tạp, có không gian chiều cao.
Điểm nổi bật của ABC so với các thuật toán trí tuệ bầy đàn khác là khả năng cân bằng giữa khai thác, tập trung tinh chỉnh các nghiệm hiện tại, và khám phá, tìm kiếm những nghiệm mới có tiềm năng tốt hơn. Điều này khiến ABC đặc biệt hữu ích cho các bài toán quy mô lớn, nơi tối ưu toàn cục là then chốt.
Cách đàn ong nhân tạo hoạt động
Trong thuật toán ABC, bầy ong được chia thành ba vai trò chuyên biệt: ong thợ, ong quan sát và ong trinh sát. Mỗi vai trò mô phỏng một khía cạnh khác nhau của cách ong tìm và khai thác nguồn thức ăn trong tự nhiên.
- Ong thợ: Những con ong này chịu trách nhiệm khám phá các nguồn thức ăn đã biết, đại diện cho các nghiệm hiện tại trong bài toán tối ưu. Chúng đánh giá chất lượng (độ phù hợp) của các nguồn này và chia sẻ thông tin với cả tổ.
- Ong quan sát: Sau khi thu thập thông tin từ ong thợ, ong quan sát chọn nguồn thức ăn để tiếp tục khai thác. Chúng đưa ra lựa chọn dựa trên chất lượng các nghiệm do ong thợ chia sẻ, tập trung nhiều hơn vào các phương án tốt hơn, từ đó tinh chỉnh việc tìm kiếm nghiệm tối ưu.
- Ong trinh sát: Khi nguồn thức ăn (nghiệm) của một ong thợ cạn kiệt hoặc trì trệ (không cải thiện sau một số vòng lặp), ong đó trở thành ong trinh sát. Trinh sát khám phá những khu vực mới trong không gian nghiệm, tìm kiếm các nguồn chưa được khai phá, từ đó bơm thêm tính đa dạng vào quá trình tìm kiếm.
Động lực này cho phép ABC cân bằng tìm kiếm giữa việc khai thác chuyên sâu các vùng hứa hẹn và khám phá rộng các vùng mới của không gian nghiệm. Điều này giúp thuật toán tránh bị kẹt ở cực trị cục bộ và tăng cơ hội tìm được cực trị toàn cục.
Hiện thực hóa đàn ong nhân tạo bằng Python
Hàm Rastrigin là một bài toán phổ biến trong tối ưu hóa, nổi tiếng với vô số cực tiểu cục bộ, khiến nó trở thành thách thức khó cho nhiều thuật toán. Mục tiêu rất đơn giản: tìm cực tiểu toàn cục.
Trong ví dụ này, chúng ta sẽ dùng thuật toán đàn ong nhân tạo để giải bài toán này. Mỗi con ong trong ABC khám phá không gian tìm kiếm, tìm nghiệm tốt hơn để cực tiểu hóa hàm. Mã mô phỏng các con ong khám phá, khai thác và trinh sát vùng mới, đảm bảo cân bằng giữa khám phá và khai thác.
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()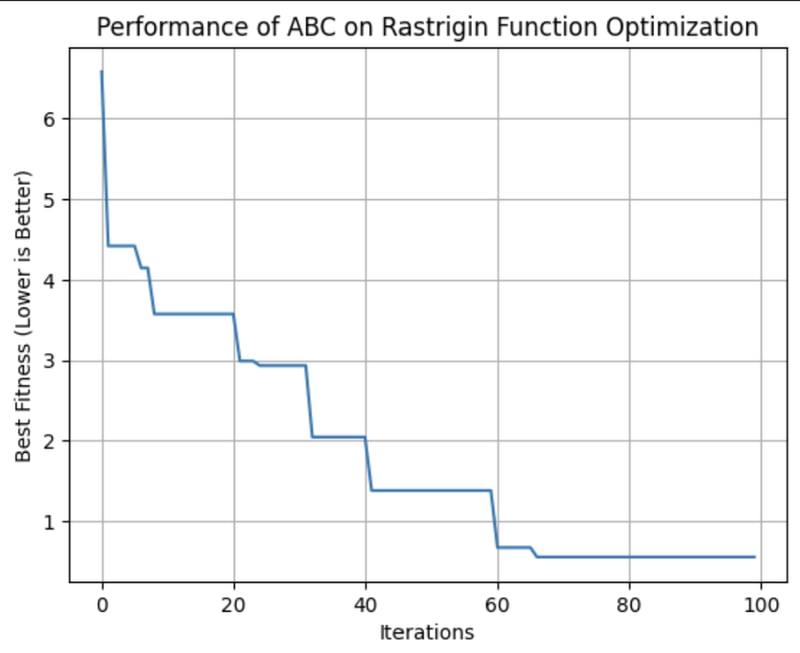
Biểu đồ này cho thấy độ phù hợp của nghiệm tốt nhất do thuật toán ABC tìm được qua từng vòng lặp. Ở lần chạy này, nó đạt độ phù hợp tối ưu khoảng vòng lặp thứ 64.
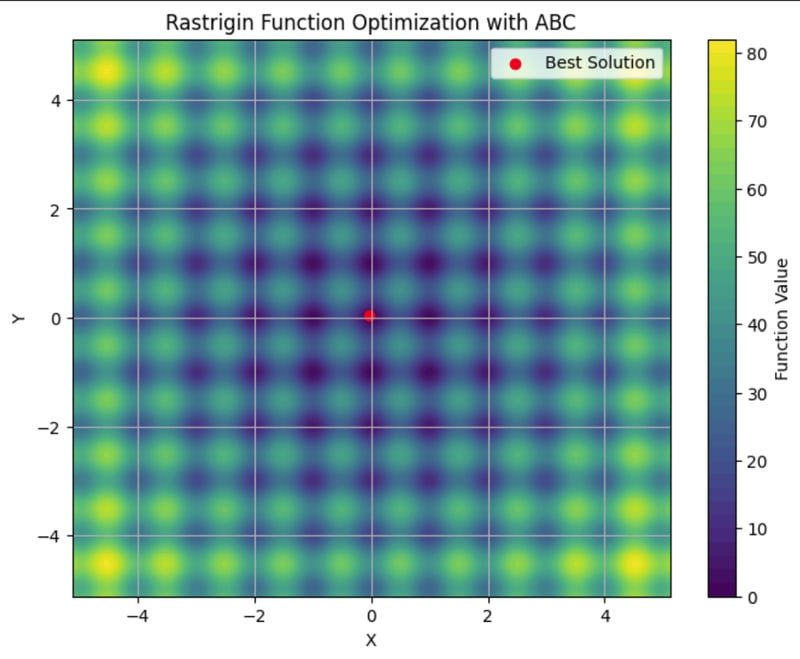
Ở đây bạn có thể thấy hàm Rastrigin được vẽ trên đồ thị đường đồng mức, với rất nhiều cực tiểu cục bộ. Chấm đỏ là cực tiểu toàn cục do thuật toán ABC chúng ta chạy tìm được.
Ứng dụng của đàn ong nhân tạo
Thuật toán ABC là một công cụ vững chắc để giải các bài toán tối ưu. Khả năng khám phá hiệu quả các không gian tìm kiếm lớn và phức tạp khiến nó trở thành lựa chọn hàng đầu cho các ngành đòi hỏi khả năng thích ứng và khả năng mở rộng.
Các ứng dụng bao gồm:
- Viễn thông: ABC có thể được dùng để tối ưu vị trí tài nguyên mạng và ăng-ten, tối đa vùng phủ và cường độ tín hiệu đồng thời tối thiểu chi phí.
- Kỹ thuật: ABC có thể tinh chỉnh các tham số trong tối ưu thiết kế kết cấu.
- Khoa học dữ liệu: ABC có thể áp dụng cho chọn đặc trưng, để nhận diện các biến quan trọng nhất trong tập dữ liệu phục vụ học máy.
ABC là một thuật toán linh hoạt, phù hợp với mọi bài toán cần tìm nghiệm tối ưu trong môi trường động, có số chiều lớn. Tính phi tập trung khiến nó phù hợp với những tình huống mà các thuật toán khác có thể gặp khó khăn trong việc cân bằng khám phá và khai thác một cách hiệu quả.
So sánh các Thuật toán Trí tuệ Bầy đàn
Có nhiều thuật toán trí tuệ bầy đàn, mỗi thuật toán có thuộc tính khác nhau. Khi quyết định sử dụng cái nào, điều quan trọng là cân nhắc điểm mạnh và điểm yếu của chúng để chọn phương án phù hợp nhất với nhu cầu của bạn.
ACO hiệu quả cho các bài toán tổ hợp như định tuyến và lập lịch nhưng có thể cần nhiều tài nguyên tính toán. PSO đơn giản hơn và xuất sắc trong tối ưu liên tục, như tinh chỉnh siêu tham số, nhưng có thể bị kẹt ở cực trị cục bộ. ABC cân bằng tốt giữa khám phá và khai thác, dù yêu cầu tinh chỉnh cẩn thận.
Các thuật toán trí tuệ bầy đàn khác, như Thuật toán Đom đóm và Tối ưu Tìm kiếm Chim cu gáy, cũng mang lại lợi thế riêng cho các loại bài toán tối ưu khác nhau.
|
Thuật toán |
Điểm mạnh |
Điểm yếu |
Thư viện ưa dùng |
Ứng dụng tốt nhất |
|
Tối ưu Đàn kiến (ACO) |
Hiệu quả cho các bài toán tổ hợp và xử lý tốt không gian rời rạc phức tạp |
Tốn tài nguyên tính toán và cần tinh chỉnh kỹ |
Bài toán định tuyến, lập lịch và phân bổ tài nguyên | |
|
Tối ưu Bầy hạt (PSO) |
Tốt cho tối ưu liên tục, đơn giản và dễ hiện thực |
Có thể hội tụ vào cực trị cục bộ và kém hiệu quả với bài toán rời rạc |
Tinh chỉnh siêu tham số, thiết kế kỹ thuật, mô hình tài chính | |
|
Đàn ong Nhân tạo (ABC) |
Thích ứng với các bài toán lớn, động và cân bằng tốt giữa khám phá và khai thác |
Tốn tài nguyên tính toán và cần tinh chỉnh tham số cẩn thận |
Viễn thông, tối ưu quy mô lớn và không gian nhiều chiều | |
|
Thuật toán Đom đóm (FA) |
Vượt trội ở tối ưu đa cực trị và có khả năng tìm kiếm toàn cục mạnh |
Nhạy với thiết lập tham số và hội tụ chậm hơn |
Xử lý ảnh, thiết kế kỹ thuật và tối ưu đa cực trị | |
|
Tìm kiếm Chim cu gáy (CS) |
Hiệu quả trong giải bài toán tối ưu và có khả năng khám phá mạnh |
Có thể hội tụ sớm và hiệu năng phụ thuộc tinh chỉnh |
Lập lịch, chọn đặc trưng và ứng dụng kỹ thuật |
Thách thức và Hạn chế
Các thuật toán trí tuệ bầy đàn, giống nhiều kỹ thuật học máy, gặp phải những thách thức có thể ảnh hưởng tới hiệu năng. Bao gồm:
- Hội tụ sớm: Bầy có thể chấp nhận một nghiệm kém tối ưu quá nhanh.
- Tinh chỉnh tham số: Để đạt kết quả tối ưu thường cần điều chỉnh cẩn thận các thiết lập thuật toán.
- Tài nguyên tính toán & khả năng mở rộng: Các thuật toán này có thể tốn tài nguyên tính toán, đặc biệt với bài toán lớn, phức tạp, và hiệu năng có thể suy giảm khi độ phức tạp tăng lên.
- Tính ngẫu nhiên: Tính ngẫu nhiên vốn có trong các thuật toán này có thể dẫn tới kết quả biến động.
Nghiên cứu và Tiến bộ Mới nhất
Một xu hướng đáng chú ý là tích hợp trí tuệ bầy đàn với các kỹ thuật học máy khác. Các nhà nghiên cứu đang khám phá cách thuật toán bầy đàn có thể tăng cường các nhiệm vụ như chọn đặc trưng và tối ưu siêu tham số. Xem Một thuật toán tối ưu bầy hạt lai để giải bài toán kỹ thuật.
Những tiến bộ gần đây cũng tập trung vào việc giải quyết một số thách thức truyền thống gắn với trí tuệ bầy đàn, như hội tụ sớm. Các thuật toán và kỹ thuật mới đang được phát triển để giảm rủi ro hội tụ vào nghiệm kém tối ưu. Để biết thêm, hãy xem Các phương pháp dựa trên bộ nhớ nhằm loại bỏ hội tụ sớm trong tối ưu bầy hạt
Khả năng mở rộng là một lĩnh vực nghiên cứu quan trọng khác. Khi bài toán ngày càng phức tạp và dữ liệu tăng, các nhà nghiên cứu đang tìm cách giúp thuật toán trí tuệ bầy đàn có thể mở rộng và hiệu quả hơn. Điều này bao gồm phát triển các thuật toán có thể xử lý tập dữ liệu lớn và không gian nhiều chiều hiệu quả hơn, đồng thời tối ưu tài nguyên tính toán để giảm thời gian và chi phí vận hành. Để biết thêm, hãy xem Những phát triển gần đây trong lý thuyết và khả năng ứng dụng của tìm kiếm bầy đàn.
Các thuật toán bầy đàn đang được áp dụng cho các bài toán từ robot, đến mô hình ngôn ngữ lớn (LLM), đến chẩn đoán y khoa. Có nghiên cứu đang diễn ra về việc liệu các thuật toán này có thể hữu ích trong việc giúp LLM chủ động quên thông tin để tuân thủ quy định Quyền được lãng quên. Và dĩ nhiên, các thuật toán bầy đàn có vô số ứng dụng trong khoa học dữ liệu.
Kết luận
Trí tuệ bầy đàn mang đến những lời giải mạnh mẽ cho các bài toán tối ưu trong nhiều ngành. Các nguyên lý phi tập trung, phản hồi dương và thích nghi cho phép nó giải quyết những nhiệm vụ phức tạp, động mà các thuật toán truyền thống có thể gặp khó.
Xem bài điểm khảo sát về trạng thái hiện tại của các thuật toán bầy đàn, “Trí tuệ bầy đàn: Khảo sát phân loại mô hình và ứng dụng”.
Để tìm hiểu sâu hơn về ứng dụng kinh doanh của AI, hãy xem Chiến lược Trí tuệ Nhân tạo (AI) hoặc Trí tuệ Nhân tạo cho Nhà lãnh đạo Doanh nghiệp. Để tìm hiểu các thuật toán khác mô phỏng tự nhiên, hãy xem Thuật toán Di truyền: Hướng dẫn đầy đủ kèm hiện thực bằng Python.

Tôi là Tiến sĩ với 13 năm kinh nghiệm làm việc với dữ liệu trong môi trường nghiên cứu sinh học. Tôi phát triển phần mềm bằng nhiều ngôn ngữ lập trình, bao gồm Python, MATLAB và R. Tôi đam mê chia sẻ tình yêu học hỏi của mình với mọi người.
Hãy tưởng tượng bạn đang quan sát một đàn chim bay. Không có thủ lĩnh, không ai đưa chỉ dẫn, vậy mà cả đàn vẫn lượn và sải cánh nhịp nhàng hoàn hảo. Trông có vẻ hỗn loạn, nhưng thực ra có một trật tự ẩn giấu. Bạn có thể thấy cùng một mô hình ở những đàn cá tránh kẻ săn mồi hoặc kiến tìm đường ngắn nhất đến thức ăn. Những sinh vật này dựa vào các quy tắc đơn giản và giao tiếp cục bộ để giải quyết những nhiệm vụ đáng ngạc nhiên về độ phức tạp mà không cần điều khiển tập trung.
Đó chính là điều kỳ diệu của trí tuệ bầy đàn.
Chúng ta có thể mô phỏng hành vi này bằng các thuật toán giải bài toán khó bằng cách bắt chước trí tuệ bầy đàn.
Trí tuệ bầy đàn là gì?
Trí tuệ bầy đàn là một cách tiếp cận tính toán giải quyết các bài toán phức tạp bằng cách mô phỏng hành vi phi tập trung, tự tổ chức quan sát thấy ở các bầy đàn tự nhiên như đàn chim hay đàn kiến.
Hãy cùng xem hai khái niệm then chốt: phi tập trung và phản hồi dương.
Phi tập trung và xuất hiện
Trọng tâm của trí tuệ bầy đàn là khái niệm phi tập trung. Thay vì dựa vào một thủ lĩnh trung tâm để điều phối hành động, mỗi cá thể, hay "tác nhân", hoạt động tự chủ dựa trên thông tin hạn chế, cục bộ.
Quyết định phi tập trung này dẫn tới một thuộc tính xuất hiện—hành vi phức tạp, có tổ chức nảy sinh từ tương tác đơn giản của các tác nhân. Trong hệ bầy đàn, kết quả tổng thể, hay nghiệm, không được lập trình sẵn mà tự nhiên xuất hiện từ các hành động cá thể.
Lấy kiến làm ví dụ. Khi đi kiếm ăn, một con kiến khám phá ngẫu nhiên môi trường cho đến khi tìm được thức ăn, lúc đó nó sẽ để lại vệt mùi pheromone trên đường quay về tổ. Những con khác bắt gặp vệt này và có xu hướng đi theo, củng cố lộ trình nếu chúng cũng tìm thấy thức ăn ở cuối đường. Theo thời gian, các tuyến ngắn hơn hoặc hiệu quả hơn tự nhiên thu hút nhiều kiến hơn khi vệt pheromone trên những đường này trở nên đậm hơn. Không một con kiến nào "biết" sẵn đường tốt nhất, nhưng tập thể, thông qua các quyết định phi tập trung và việc củng cố những lối đi thành công, cả đàn sẽ hội tụ về nghiệm tối ưu.
Sơ đồ này cho thấy cách các quy tắc đơn giản mà từng con kiến tuân theo dẫn tới một nghiệm tối ưu cho cả đàn.
Phản hồi dương và thích nghi
Phản hồi dương là một cơ chế trong các hệ trí tuệ bầy đàn, nơi các hành động thành công được thưởng và củng cố. Điều này dẫn đến quá trình tự khuếch đại, như kiến tăng cường vệt pheromone dọc theo những lối đi kiếm ăn ngắn hơn. Việc củng cố các hành vi có lợi giúp bầy đàn cải thiện hiệu suất tổng thể theo thời gian.
Trong trí tuệ nhân tạo, các thuật toán trí tuệ bầy đàn bắt chước điều này bằng cách điều chỉnh các yếu tố then chốt, như xác suất hoặc trọng số, dựa trên chất lượng của nghiệm tìm được. Khi phát hiện nghiệm tốt hơn, các tác nhân ngày càng tập trung vào chúng, giúp tăng tốc quá trình hội tụ. Vòng lặp phản hồi động này cho phép hệ bầy đàn thích nghi với môi trường thay đổi và tinh chỉnh hiệu suất.
Có nhiều thuật toán trí tuệ bầy đàn mô phỏng các hệ sinh học khác nhau. Hãy điểm qua một vài thuật toán phổ biến.
Tối ưu đàn kiến (ACO)
Tối ưu đàn kiến (ACO) là thuật toán lấy cảm hứng từ hành vi kiếm ăn của kiến như mô tả bên trên. Thuật toán này được thiết kế để giải các bài toán tối ưu hóa tổ hợp, đặc biệt là những bài toán cần tìm nghiệm tốt nhất trong vô số khả năng. Ví dụ kinh điển là bài toán người du lịch, nơi mục tiêu là xác định lộ trình ngắn nhất nối một tập các địa điểm.
Cách tối ưu đàn kiến hoạt động
Trong tự nhiên, kiến giao tiếp bằng cách để lại vệt pheromone, báo hiệu cho các con khác đường tới nguồn thức ăn. Càng nhiều kiến đi theo, vệt càng đậm. ACO mô phỏng hành vi này với pheromone được biểu diễn bằng các giá trị toán học lưu trong ma trận pheromone. Ma trận này theo dõi mức độ hấp dẫn của các nghiệm khác nhau và được cập nhật khi thuật toán tiến triển.
Trong ACO, mỗi "kiến nhân tạo" đại diện cho một nghiệm tiềm năng, như một lộ trình trong bài toán người du lịch. Thuật toán bắt đầu với việc tất cả kiến chọn đường ngẫu nhiên, và các giá trị pheromone giúp định hướng cho những kiến về sau. Các giá trị này được lưu trong ma trận, trong đó mỗi phần tử tương ứng với "mức pheromone" giữa hai điểm (như hai thành phố).
Việc biểu diễn pheromone bằng toán học cho phép ACO cân bằng hiệu quả giữa khám phá và khai thác, tìm kiếm trong không gian nghiệm lớn mà không bị kẹt ở cực tiểu cục bộ.
Hiện thực hóa ACO bằng Python
Hãy thử một ví dụ, dùng ACO để giải một bài toán đơn giản: tìm đường ngắn nhất giữa các điểm trên một đồ thị.
Hiện thực ACO này mô phỏng cách các "kiến" nhân tạo đi qua 20 nút trên một đồ thị để tìm đường đi ngắn nhất. Mỗi kiến bắt đầu ở một nút ngẫu nhiên và chọn bước đi tiếp theo dựa trên vệt pheromone và khoảng cách giữa các nút. Sau khi khám phá tất cả các đường, kiến quay lại điểm xuất phát, hoàn tất một vòng khép kín.
Theo thời gian, pheromone được cập nhật: các đường ngắn hơn nhận được sự củng cố mạnh hơn, trong khi các đường khác bị bay hơi. Quá trình động này giúp thuật toán hội tụ về nghiệm tối ưu.
Biểu đồ này cho thấy nghiệm cuối cùng, tức đường đi tốt nhất, để đi qua mỗi nút với khoảng cách ngắn nhất. Ở lần chạy này, lộ trình tốt nhất là [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4], với tổng khoảng cách 129.
Trong biểu đồ này, ta thấy tổng quãng đường khi đi qua các nút giảm dần theo các vòng lặp. Điều này cho thấy mô hình đang cải thiện độ dài hành trình theo thời gian.
Ứng dụng của tối ưu đàn kiến
Khả năng thích ứng và hiệu quả khiến ACO trở thành công cụ mạnh trong nhiều ngành. Một số ứng dụng gồm:
Điểm mạnh của ACO nằm ở khả năng tiến hóa và thích nghi, phù hợp với môi trường động nơi điều kiện có thể thay đổi, như định tuyến giao thông thời gian thực hoặc hoạch định công nghiệp.