

Particle Swarm Optimization (PSO)
Particle swarm optimization (PSO) पक्षियों के झुंड और मछलियों के समूहों के व्यवहार से प्रेरित है। इन प्राकृतिक प्रणालियों में, व्यक्ति अपनी पिछली अनुभूतियों और अपने पड़ोसियों की स्थिति के आधार पर चलते हैं, और समूह के सबसे सफल सदस्यों का अनुसरण करने के लिए धीरे-धीरे समायोजित होते हैं। PSO इस अवधारणा को ऑप्टिमाइज़ेशन समस्याओं पर लागू करता है, जहाँ कण, जिन्हें एजेंट कहा जाता है, खोज-स्थान में घूमते हुए एक इष्टतम समाधान खोजते हैं।
ACO की तुलना में, PSO निरंतर (continuous) स्थानों में काम करता है न कि विविक्त (discrete) में। ACO में ध्यान पाथफाइंडिंग और विविक्त विकल्पों पर होता है, जबकि PSO सतत चरों वाली समस्याओं, जैसे पैरामीटर ट्यूनिंग, के लिए अधिक उपयुक्त है।
PSO में, कण एक खोज-स्थान का अन्वेषण करते हैं। वे दो मुख्य कारकों के आधार पर अपनी स्थिति समायोजित करते हैं: उनकी व्यक्तिगत सर्वश्रेष्ठ ज्ञात स्थिति और पूरे स्वॉर्म की सर्वश्रेष्ठ ज्ञात स्थिति। यह दोहरा फीडबैक तंत्र उन्हें वैश्विक इष्टतम की ओर अभिसरित होने में सक्षम बनाता है।
Particle swarm optimization कैसे काम करता है
प्रक्रिया समाधान-स्थान में यादृच्छिक रूप से प्रारंभ किए गए कणों के स्वॉर्म से शुरू होती है। प्रत्येक कण ऑप्टिमाइज़ेशन समस्या के एक संभावित समाधान का प्रतिनिधित्व करता है। जैसे-जैसे कण चलते हैं, वे अपनी व्यक्तिगत सर्वश्रेष्ठ स्थितियों (अब तक मिली सर्वोत्तम स्थिति) को याद रखते हैं और वैश्विक सर्वश्रेष्ठ स्थिति (किसी भी कण द्वारा मिली सर्वोत्तम स्थिति) की ओर आकर्षित होते हैं।
यह गति दो कारकों से संचालित होती है: उपयोग (exploitation) और अन्वेषण (exploration)। उपयोग वर्तमान सर्वोत्तम समाधान के आसपास खोज को परिष्कृत करता है, जबकि अन्वेषण कणों को समाधान-स्थान के अन्य भागों की खोज के लिए प्रोत्साहित करता है ताकि स्थानीय इष्टतम में फँसने से बचा जा सके। इन दोनों गतिशीलताओं के संतुलन से PSO कुशलतापूर्वक सर्वश्रेष्ठ समाधान तक अभिसरित होता है।
Particle swarm optimization का Python इम्प्लीमेंटेशन
वित्तीय पोर्टफोलियो प्रबंधन में, अधिकतम रिटर्न पाने के लिए परिसंपत्तियों का सबसे अच्छा आवंटन ढूँढना और जोखिम कम रखना चुनौतीपूर्ण हो सकता है। आइए PSO का उपयोग करके यह पता लगाएँ कि किस मिश्रण से हमें सबसे अधिक निवेश रिटर्न मिलेगा।
नीचे दिया गया कोड एक काल्पनिक वित्तीय पोर्टफोलियो के अनुकूलन के लिए PSO कैसे काम करता है, यह दर्शाता है। यह यादृच्छिक परिसंपत्ति आवंटनों से शुरू होता है, फिर कई आवृत्तियों में जो सबसे अच्छा काम करता है उसके आधार पर उन्हें समायोजित करता है, और धीरे-धीरे उच्चतम रिटर्न और न्यूनतम जोखिम के लिए इष्टतम मिश्रण खोजता है।
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")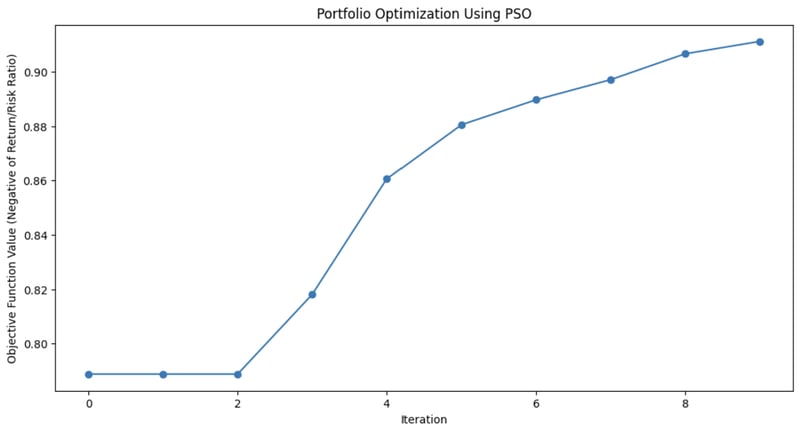
यह ग्राफ दिखाता है कि हर आवृत्ति के साथ PSO एल्गोरिदम ने पोर्टफोलियो के परिसंपत्ति मिश्रण में कितना सुधार किया।
Particle swarm optimization के अनुप्रयोग
PSO को उसकी सरलता और विभिन्न ऑप्टिमाइज़ेशन समस्याओं, विशेषकर निरंतर डोमेन में, प्रभावी समाधान के लिए प्रयोग किया जाता है। इसकी लचीलापन इसे अनेक वास्तविक-world परिस्थितियों में उपयोगी बनाता है जहाँ सटीक समाधान आवश्यक होते हैं।
इन अनुप्रयोगों में शामिल हैं:
- मशीन लर्निंग: PSO का उपयोग मशीन लर्निंग एल्गोरिदम में हाइपरपैरामीटर ट्यून करने में किया जा सकता है, ताकि सर्वोत्तम मॉडल कॉन्फ़िगरेशन मिल सके।
- इंजीनियरिंग डिज़ाइन: एयरोस्पेस घटकों या विद्युत परिपथों जैसे प्रणालियों के डिज़ाइन पैरामीटर को अनुकूलित करने में PSO उपयोगी है।
- वित्तीय मॉडलिंग: वित्त में, PSO पोर्टफोलियो ऑप्टिमाइज़ेशन में मदद कर सकता है, जोखिम को कम करते हुए रिटर्न को अधिकतम करना।
समाधान-स्थानों का कुशलतापूर्वक अन्वेषण करने की PSO की क्षमता इसे रोबोटिक्स से लेकर ऊर्जा प्रबंधन और लॉजिस्टिक्स तक अनेक क्षेत्रों में लागू बनाती है।
Artificial Bee Colony (ABC)
Artificial bee colony (ABC) एल्गोरिदम मधुमक्खियों के भोजन-खोज व्यवहार पर आधारित है।
प्रकृति में, मधुमक्खियाँ कुशलतापूर्वक अमृत स्रोतों की खोज करती हैं और यह जानकारी छत्ते के अन्य सदस्यों से साझा करती हैं। ABC इस सहयोगी खोज प्रक्रिया को पकड़ता है और इसे ऑप्टिमाइज़ेशन समस्याओं पर लागू करता है, खासकर वे जो जटिल, उच्च-आयामी स्थानों से संबंधित होती हैं।
ABC को अन्य स्वॉर्म इंटेलिजेंस एल्गोरिदम से जो अलग करता है, वह है उपयोग (वर्तमान समाधानों को परिष्कृत करने पर ध्यान) और अन्वेषण (नए और संभावित बेहतर समाधानों की खोज) के बीच संतुलन बनाने की इसकी क्षमता। यह ABC को बड़े पैमाने की समस्याओं के लिए खास तौर पर उपयोगी बनाता है जहाँ वैश्विक ऑप्टिमाइज़ेशन महत्वपूर्ण होता है।
Artificial bee colony कैसे काम करता है
ABC एल्गोरिदम में मधुमक्खियों के स्वॉर्म को तीन विशिष्ट भूमिकाओं में विभाजित किया जाता है: employed bees, onlookers, और scouts। प्रत्येक भूमिका प्रकृति में भोजन स्रोतों की खोज और उपयोग करने के तरीके के एक अलग पहलू की नकल करती है।
- Employed bees: ये मधुमक्खियाँ ज्ञात भोजन स्रोतों का अन्वेषण करने के लिए जिम्मेदार होती हैं, जो ऑप्टिमाइज़ेशन समस्या में वर्तमान समाधानों का प्रतिनिधित्व करती हैं। वे इन स्रोतों की गुणवत्ता (फिटनेस) का आकलन करती हैं और जानकारी छत्ते के बाकी सदस्यों से साझा करती हैं।
- Onlooker bees: employed मधुमक्खियों से जानकारी इकट्ठा करने के बाद, onlooker यह चुनती हैं कि किन भोजन स्रोतों का आगे अन्वेषण किया जाए। वे employed मधुमक्खियों द्वारा साझा किए गए समाधानों की गुणवत्ता के आधार पर चयन करती हैं, बेहतर विकल्पों पर अधिक ध्यान केंद्रित करते हुए इष्टतम समाधान की खोज को परिष्कृत करती हैं।
- Scout bees: जब employed मधुमक्खी का भोजन स्रोत (समाधान) समाप्त या स्थिर हो जाता है (किसी निश्चित संख्या की आवृत्तियों के बाद कोई सुधार नहीं मिलता), तो वह स्काउट बन जाती है। स्काउट समाधान-स्थान के नए क्षेत्रों का अन्वेषण करती हैं, संभावित रूप से अनदेखे भोजन स्रोत ढूँढती हैं, और इस तरह खोज प्रक्रिया में विविधता लाती हैं।
यह गतिशीलता ABC को आशाजनक क्षेत्रों के गहन अन्वेषण और खोज-स्थान के नए क्षेत्रों के व्यापक अन्वेषण के बीच संतुलन बनाने देती है। इससे एल्गोरिदम स्थानीय इष्टतम में फँसने से बचता है और वैश्विक इष्टतम खोजने की संभावना बढ़ती है।
Artificial bee colony का Python इम्प्लीमेंटेशन
Rastrigin फ़ंक्शन ऑप्टिमाइज़ेशन में एक लोकप्रिय समस्या है, जो अपने कई स्थानीय न्यूनतमों के लिए जानी जाती है, और कई एल्गोरिदम के लिए कठिन चुनौती पेश करती है। लक्ष्य सरल है: वैश्विक न्यूनतम खोजना।
इस उदाहरण में, हम इस समस्या से निपटने के लिए artificial bee colony एल्गोरिदम का उपयोग करेंगे। ABC एल्गोरिदम में प्रत्येक मधुमक्खी खोज-स्थान का अन्वेषण करती है, ताकि फ़ंक्शन को न्यूनतम करने के लिए बेहतर समाधान ढूँढे जा सकें। कोड मधुमक्खियों का सिमुलेशन करता है जो अन्वेषण, उपयोग और नए क्षेत्रों की तलाश करती हैं, जिससे अन्वेषण और उपयोग के बीच संतुलन बना रहता है।
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()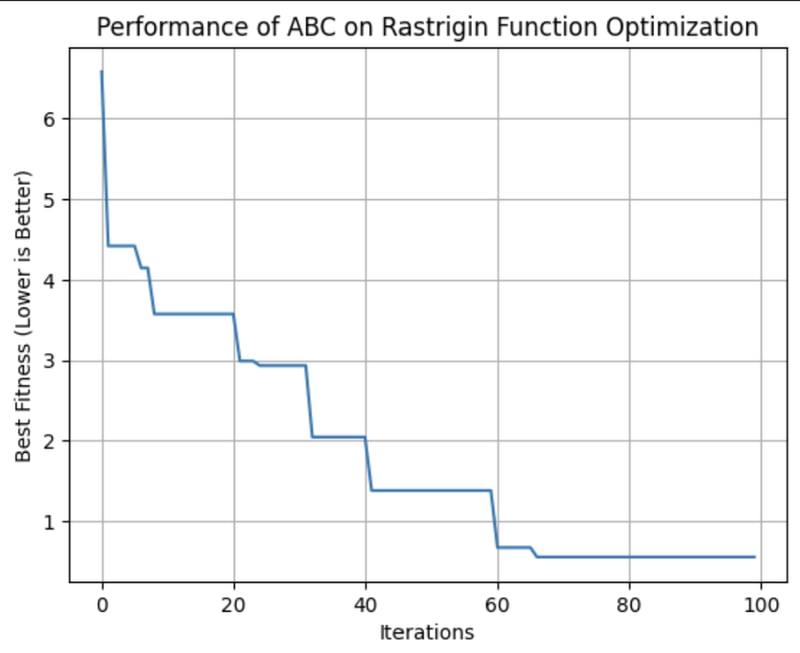
यह ग्राफ हर आवृत्ति के साथ ABC एल्गोरिदम द्वारा पाए गए सर्वश्रेष्ठ समाधान की फिटनेस दिखाता है। इस रन में, यह लगभग 64वीं आवृत्ति पर अपने इष्टतम फिटनेस तक पहुँचा।
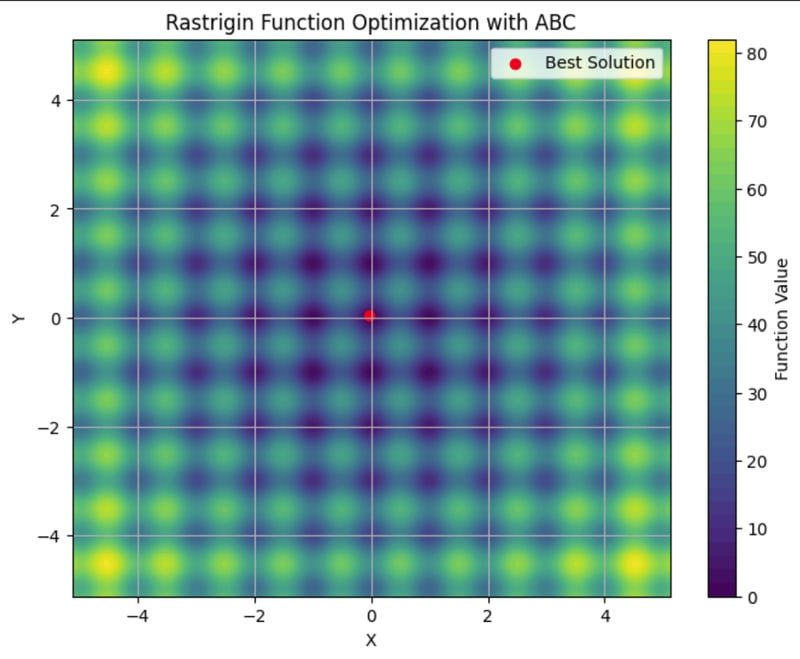
यहाँ आप कंटूर प्लॉट पर Rastrigin फ़ंक्शन को उसके अनेक स्थानीय न्यूनतमों के साथ देख सकते हैं। लाल बिंदु वह वैश्विक न्यूनतम है जिसे हमारे द्वारा चलाए गए ABC एल्गोरिदम ने पाया।
Artificial bee colony के अनुप्रयोग
ABC एल्गोरिदम ऑप्टिमाइज़ेशन समस्याओं को हल करने के लिए एक सुदृढ़ उपकरण है। बड़े और जटिल खोज-स्थानों का कुशलतापूर्वक अन्वेषण करने की इसकी क्षमता इसे उन उद्योगों के लिए पसंदीदा विकल्प बनाती है जहाँ अनुकूलनशीलता और स्केलेबिलिटी महत्वपूर्ण हैं।
इन अनुप्रयोगों में शामिल हैं:
- टेलीकम्यूनिकेशन: ABC का उपयोग नेटवर्क संसाधनों और एंटेना की प्लेसमेंट को अनुकूलित करने में किया जा सकता है, जिससे कवरेज और सिग्नल शक्ति अधिकतम हो और लागत न्यूनतम रहे।
- इंजीनियरिंग: संरचनात्मक डिज़ाइन ऑप्टिमाइज़ेशन में पैरामीटरों को बारीकी से ट्यून करने के लिए ABC उपयोगी है।
- डेटा साइंस: मशीन लर्निंग के लिए किसी डेटासेट में सबसे महत्वपूर्ण चरों की पहचान करने हेतु फीचर चयन में ABC लागू किया जा सकता है।
ABC एक लचीला एल्गोरिदम है, जो उन सभी समस्याओं के लिए उपयुक्त है जहाँ गतिशील, उच्च-आयामी परिवेशों में इष्टतम समाधान ढूँढने होते हैं। इसका विकेंद्रीकृत स्वभाव इसे उन स्थितियों के लिए उपयुक्त बनाता है जहाँ अन्य एल्गोरिदम अन्वेषण और उपयोग के बीच संतुलन बनाने में संघर्ष कर सकते हैं।
स्वॉर्म इंटेलिजेंस एल्गोरिदम की तुलना
कई स्वॉर्म इंटेलिजेंस एल्गोरिदम हैं, प्रत्येक के अलग गुण हैं। किसका उपयोग करना है, यह तय करते समय, उनकी ताकतों और कमजोरियों को तौलना महत्त्वपूर्ण है ताकि आपकी आवश्यकताओं के लिए सबसे उपयुक्त विकल्प चुना जा सके।
ACO रूटिंग और शेड्यूलिंग जैसी संयोज्य समस्याओं के लिए प्रभावी है, लेकिन इसे महत्वपूर्ण संगणनात्मक संसाधनों की आवश्यकता हो सकती है। PSO सरल है और निरंतर ऑप्टिमाइज़ेशन, जैसे हाइपरपैरामीटर ट्यूनिंग, में उत्कृष्ट है, पर स्थानीय इष्टतम के साथ संघर्ष कर सकता है। ABC अन्वेषण और उपयोग के बीच सफलतापूर्वक संतुलन बनाता है, हालांकि इसमें सावधानीपूर्वक ट्यूनिंग की आवश्यकता होती है।
अन्य स्वॉर्म इंटेलिजेंस एल्गोरिदम, जैसे Firefly Algorithm और Cuckoo Search Optimization, विशिष्ट प्रकार की ऑप्टिमाइज़ेशन problems.
|
एल्गोरिदम |
ताकत |
कमजोरियाँ |
पसंदीदा लाइब्रेरी |
सर्वश्रेष्ठ अनुप्रयोग |
|
Ant Colony Optimization (ACO) |
संयोज्य समस्याओं के लिए प्रभावी और जटिल विविक्त स्थानों को अच्छी तरह संभालता है |
संगणनात्मक रूप से गहन और सूक्ष्म ट्यूनिंग की आवश्यकता |
रूटिंग समस्याएँ, शेड्यूलिंग, और संसाधन आवंटन | |
|
Particle Swarm Optimization (PSO) |
निरंतर ऑप्टिमाइज़ेशन के लिए अच्छा, सरल और लागू करने में आसान |
स्थानीय इष्टतम पर अभिसरित हो सकता है और विविक्त समस्याओं के लिए कम प्रभावी |
हाइपरपैरामीटर ट्यूनिंग, इंजीनियरिंग डिज़ाइन, वित्तीय मॉडलिंग | |
|
Artificial Bee Colony (ABC) |
बड़े, गतिशील समस्याओं के लिए अनुकूल और अन्वेषण व उपयोग में संतुलित |
संगणनात्मक रूप से गहन और पैरामीटर ट्यूनिंग में सावधानी चाहिए |
टेलीकम्यूनिकेशन, बड़े पैमाने का ऑप्टिमाइज़ेशन, और उच्च-आयामी स्थान | |
|
Firefly Algorithm (FA) |
मल्टीमोडल ऑप्टिमाइज़ेशन में उत्कृष्ट और वैश्विक खोज क्षमता मजबूत |
पैरामीटर सेटिंग के प्रति संवेदनशील और अभिसरण धीमा |
इमेज प्रोसेसिंग, इंजीनियरिंग डिज़ाइन, और मल्टीमोडल ऑप्टिमाइज़ेशन | |
|
Cuckoo Search (CS) |
ऑप्टिमाइज़ेशन समस्याओं को हल करने में कुशल और मजबूत अन्वेषण क्षमताएँ |
समय से पहले अभिसरित हो सकता है और प्रदर्शन ट्यूनिंग पर निर्भर |
शेड्यूलिंग, फीचर चयन, और इंजीनियरिंग अनुप्रयोग |
चुनौतियाँ और सीमाएँ
स्वॉर्म इंटेलिजेंस एल्गोरिदम, जैसे कई मशीन लर्निंग तकनीकें, कुछ चुनौतियों का सामना करते हैं जो उनके प्रदर्शन को प्रभावित कर सकती हैं। इनमें शामिल हैं:
- समयपूर्व अभिसरण: स्वॉर्म बहुत जल्दी किसी उप-इष्टतम समाधान पर ठहर सकता है।
- पैरामीटर ट्यूनिंग: इष्टतम परिणाम पाने के लिए अक्सर एल्गोरिदम सेटिंग्स का सावधानीपूर्वक समायोजन आवश्यक होता है।
- संगणनात्मक संसाधन और स्केलेबिलिटी: ये एल्गोरिदम, विशेष रूप से बड़े, अधिक जटिल समस्याओं में, संगणनात्मक रूप से गहन हो सकते हैं, और समस्या की जटिलता बढ़ने पर उनका प्रदर्शन घट सकता है।
- स्टोकेस्टिक प्रकृति: इन एल्गोरिदम में अंतर्निहित यादृच्छिकता के कारण परिणामों में भिन्नता आ सकती है।
नवीनतम शोध और प्रगति
एक उल्लेखनीय प्रवृत्ति स्वॉर्म इंटेलिजेंस का अन्य मशीन लर्निंग तकनीकों के साथ एकीकरण है। शोधकर्ता यह जाँच रहे हैं कि स्वॉर्म एल्गोरिदम कैसे फीचर चयन और हाइपरपैरामीटर ऑप्टिमाइज़ेशन जैसे कार्यों को बेहतर बना सकते हैं। देखें A hybrid particle swarm optimization algorithm for solving engineering problem।
हालिया प्रगति स्वॉर्म इंटेलिजेंस से जुड़ी पारंपरिक चुनौतियों, जैसे समयपूर्व अभिसरण, को संबोधित करने पर भी केंद्रित है। उप-इष्टतम समाधानों पर अभिसरित होने के जोखिम को कम करने के लिए नए एल्गोरिदम और तकनीकें विकसित की जा रही हैं। अधिक जानकारी के लिए देखें Memory-based approaches for eliminating premature convergence in particle swarm optimization
स्केलेबिलिटी भी शोध का एक महत्त्वपूर्ण क्षेत्र है। जैसे-जैसे समस्याएँ अधिक जटिल होती जाती हैं और डेटा की मात्रा बढ़ती है, शोधकर्ता स्वॉर्म इंटेलिजेंस एल्गोरिदम को अधिक स्केलेबल और कुशल बनाने के तरीकों पर काम कर रहे हैं। इसमें ऐसे एल्गोरिदम विकसित करना शामिल है जो बड़े डेटासेट और उच्च-आयामी स्थानों को अधिक प्रभावी ढंग से संभाल सकें, साथ ही संगणनात्मक संसाधनों का अनुकूलन कर इन एल्गोरिदम को चलाने में लगने वाले समय और लागत को घटाया जा सके। इस पर अधिक के लिए देखें Recent Developments in the Theory and Applicability of Swarm Search।
स्वॉर्म एल्गोरिदम रोबोटिक्स से लेकर बड़े भाषा मॉडल (LLMs) और चिकित्सा निदान जैसी समस्याओं पर लागू किए जा रहे हैं। इस बात पर लगातार शोध चल रहा है कि क्या ये एल्गोरिदम LLMs को राइट टू बी फॉरगॉटन नियमों का पालन करने हेतु रणनीतिक रूप से जानकारी भूलने में सहायक हो सकते हैं या नहीं। और, निश्चित रूप से, स्वॉर्म एल्गोरिदम के डेटा साइंस में अनेक अनुप्रयोग हैं।
निष्कर्ष
स्वॉर्म इंटेलिजेंस विभिन्न उद्योगों में ऑप्टिमाइज़ेशन समस्याओं के लिए शक्तिशाली समाधान प्रस्तुत करता है। विकेंद्रीकरण, सकारात्मक फीडबैक और अनुकूलन के इसके सिद्धांत इसे जटिल, गतिशील कार्यों से निपटने में सक्षम बनाते हैं जिनसे पारंपरिक एल्गोरिदम जूझ सकते हैं।
स्वॉर्म एल्गोरिदम की वर्तमान स्थिति की इस समीक्षा को देखें, “Swarm intelligence: A survey of model classification and applications”।
AI के व्यावसायिक अनुप्रयोगों में गहराई से जानने के लिए देखें Artificial Intelligence (AI) Strategy या Artificial Intelligence for Business Leaders। प्रकृति की नकल करने वाले अन्य एल्गोरिदम के बारे में जानने के लिए देखें Genetic Algorithm: Complete Guide With Python Implementation।

मैं एक पीएचडी हूँ, जिसके पास जैविक अनुसंधान परिवेश में डेटा के साथ काम करने का 13 वर्षों का अनुभव है। मैं Python, MATLAB और R सहित कई प्रोग्रामिंग भाषाओं में सॉफ्टवेयर बनाती/बनाता हूँ। मुझे सीखने के प्रति अपने प्रेम को दुनिया के साथ साझा करने का जुनून है।
कल्पना कीजिए कि आप उड़ते हुए पक्षियों के झुंड को देख रहे हैं। कोई नेता नहीं, कोई निर्देश नहीं, फिर भी वे एकदम सामंजस्य में गोते लगाते और ग्लाइड करते हैं। यह अराजकता जैसा दिख सकता है, लेकिन इसमें एक छिपा हुआ क्रम है। यही पैटर्न आप शिकारियों से बचती मछलियों के झुंडों में या चींटियों द्वारा भोजन तक की सबसे छोटी राह खोजने में देख सकते हैं। ये जीव बिना किसी केंद्रीय नियंत्रण के, सरल नियमों और स्थानीय संचार पर भरोसा करके हैरान करने वाले जटिल कार्यों को पूरा करते हैं।
इसे ही कहते हैं स्वॉर्म इंटेलिजेंस।
हम ऐसे एल्गोरिदम के जरिए इस व्यवहार की नकल कर सकते हैं जो स्वॉर्म इंटेलिजेंस की नकल करते हुए कठिन समस्याएँ हल करते हैं।
स्वॉर्म इंटेलिजेंस क्या है?
स्वॉर्म इंटेलिजेंस एक संगणनात्मक दृष्टिकोण है जो पक्षियों के झुंड या चींटियों की कॉलोनी जैसी प्राकृतिक स्वॉर्म में देखे गए विकेंद्रीकृत, स्व-संगठित व्यवहार की नकल करके जटिल समस्याएँ हल करता है।
आइए दो प्रमुख अवधारणाएँ समझते हैं: विकेंद्रीकरण और सकारात्मक फीडबैक।
विकेंद्रीकरण और उद्भव
स्वॉर्म इंटेलिजेंस के केंद्र में विकेंद्रीकरण की अवधारणा है। कार्यों का निर्देशन करने के लिए किसी केंद्रीय नेता पर निर्भर होने के बजाय, प्रत्येक व्यक्ति, या "एजेंट", सीमित, स्थानीय जानकारी के आधार पर स्वायत्त रूप से कार्य करता है।
यह विकेंद्रीकृत निर्णय-निर्माण एक उद्भव गुण की ओर ले जाता है—एजेंटों की सरल अंत:क्रियाओं से उत्पन्न जटिल, संगठित व्यवहार। स्वॉर्म प्रणालियों में, समग्र परिणाम या समाधान पूर्व-प्रोग्राम नहीं होता, बल्कि इन व्यक्तिगत क्रियाओं से स्वाभाविक रूप से उभरता है।
उदाहरण के लिए चींटियों को लें। भोजन खोजते समय, एक चींटी बेतरतीब ढंग से अपने वातावरण का पता लगाती है, और जैसे ही उसे भोजन मिलता है, वह कॉलोनी की ओर लौटते हुए फेरोमोन ट्रेल बिछाती है। अन्य चींटियाँ इस ट्रेल से टकराती हैं और उसके अनुसरण की अधिक संभावना होती है, और अगर अंत में भोजन मिलता है तो वे उस राह को और मज़बूत करती हैं। समय के साथ, छोटी या अधिक कुशल राहें स्वाभाविक रूप से अधिक चींटियों को आकर्षित करती हैं क्योंकि इन रास्तों पर मजबूत फेरोमोन ट्रेल बनती जाती है। कोई भी एकल चींटी शुरू से "सबसे अच्छी" राह नहीं जानती, लेकिन सामूहिक रूप से, विकेंद्रीकृत निर्णयों और सफल राहों के सुदृढ़ीकरण के माध्यम से, कॉलोनी इष्टतम समाधान पर पहुँची जाती है।
यह आरेख दिखाता है कि व्यक्तिगत चींटियों द्वारा अपनाए गए सरल नियम पूरी कॉलोनी के लिए इष्टतम समाधान में कैसे परिणत होते हैं।
सकारात्मक फीडबैक और अनुकूलन
सकारात्मक फीडबैक स्वॉर्म इंटेलिजेंस प्रणालियों में एक ऐसी प्रक्रिया है जिसमें सफल क्रियाओं को पुरस्कृत और सुदृढ़ किया जाता है। इससे एक स्व-विस्तारित प्रक्रिया बनती है, जैसे छोटी खोज-राहों पर फेरोमोन ट्रेल का मजबूत होना। लाभदायक व्यवहारों का यह सुदृढ़ीकरण समय के साथ स्वॉर्म के समग्र प्रदर्शन में सुधार करने में मदद करता है।
कृत्रिम बुद्धिमत्ता में, स्वॉर्म इंटेलिजेंस एल्गोरिदम इसे इस तरह अनुकरण करते हैं कि प्राप्त समाधानों की गुणवत्ता के आधार पर संभावनाओं या वेट जैसे प्रमुख कारकों को समायोजित किया जाता है। जैसे-जैसे बेहतर समाधान मिलते हैं, एजेंट उन पर अधिक ध्यान केंद्रित करने लगते हैं, जिससे अभिसरण तेज होता है। यह गतिशील फीडबैक लूप स्वॉर्म प्रणालियों को बदलते परिवेशों के साथ अनुकूलित होने और अपने प्रदर्शन को परिष्कृत करने की अनुमति देता है।
कई स्वॉर्म इंटेलिजेंस एल्गोरिदम हैं जो विभिन्न जैविक प्रणालियों की नकल करते हैं। आइए कुछ लोकप्रिय एल्गोरिदमों पर नज़र डालें।
Ant Colony Optimization (ACO)
Ant colony optimization (ACO) ऊपर वर्णित चींटियों के भोजन-खोज व्यवहार से प्रेरित एक एल्गोरिदम है। इसे संयोज्य ऑप्टिमाइज़ेशन समस्याओं को हल करने के लिए डिज़ाइन किया गया है, खासकर जहाँ हमें कई में से सर्वश्रेष्ठ समाधान खोजना होता है। इसका एक क्लासिक उदाहरण ट्रैवलिंग सेल्समैन समस्या है, जिसमें लक्ष्य स्थानों के एक सेट को जोड़ने वाला सबसे छोटा संभव मार्ग निर्धारित करना होता है।
Ant colony optimization कैसे काम करता है
प्रकृति में, चींटियाँ पीछे फेरोमोन ट्रेल छोड़कर संचार करती हैं, जो अन्य चींटियों को खाद्य स्रोत का रास्ता बताती हैं। जितनी अधिक चींटियाँ उस ट्रेल का अनुसरण करती हैं, वह उतनी ही मजबूत होती जाती है। ACO इस व्यवहार की नकल एक फेरोमोन मैट्रिक्स में संग्रहीत गणितीय मानों के माध्यम से करता है। यह मैट्रिक्स विभिन्न समाधानों की वांछनीयता पर नज़र रखता है और एल्गोरिदम के आगे बढ़ने के साथ अपडेट होता है।
ACO में, प्रत्येक "कृत्रिम चींटी" समस्या के एक संभावित समाधान का प्रतिनिधित्व करती है, जैसे ट्रैवलिंग सेल्समैन समस्या में एक मार्ग। एल्गोरिदम की शुरुआत में सभी चींटियाँ बेतरतीब ढंग से रास्ते चुनती हैं, और फेरोमोन मान आगे की चींटियों का मार्गदर्शन करते हैं। ये मान एक मैट्रिक्स में संग्रहीत होते हैं जहाँ प्रत्येक प्रविष्टि दो बिंदुओं (जैसे शहरों) के बीच के "फेरोमोन स्तर" से मेल खाती है।
फेरोमोन की यह गणितीय अभिव्यक्ति ACO को अन्वेषण और उपयोग के बीच प्रभावी संतुलन बनाने में सक्षम बनाती है, जिससे यह बड़े समाधान-स्थानों में खोज कर सके और स्थानीय इष्टतम में फँसे बिना आगे बढ़े।
Ant colony optimization का Python इम्प्लीमेंटेशन
आइए एक उदाहरण आज़माएँ—ग्राफ़ पर बिंदुओं के बीच सबसे छोटा मार्ग खोजने के लिए ACO का उपयोग करें।
ACO का यह इम्प्लीमेंटेशन 20 नोड वाले एक ग्राफ़ पर कृत्रिम "चींटियों" के भ्रमण का सिमुलेशन करता है ताकि सबसे छोटा मार्ग मिल सके। प्रत्येक चींटी एक यादृच्छिक नोड से शुरू होती है और अगला कदम फेरोमोन ट्रेल और नोड्स के बीच की दूरी के आधार पर चुनती है। सभी रास्तों का अन्वेषण करने के बाद, चींटियाँ अपने शुरुआती बिंदु पर लौट आती हैं और एक पूर्ण लूप पूरा करती हैं।
समय के साथ फेरोमोन अपडेट होते हैं: छोटे मार्गों को अधिक सुदृढ़ीकरण मिलता है, जबकि अन्य वाष्पित हो जाते हैं। यह गतिशील प्रक्रिया एल्गोरिदम को इष्टतम समाधान की ओर अभिसरित होने देती है।
यह ग्राफ अंतिम समाधान, यानी प्रत्येक नोड तक सबसे कम दूरी में यात्रा करने के लिए मिला सर्वश्रेष्ठ पथ दिखाता है। इस रन में सबसे अच्छा मार्ग [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4] पाया गया, जिसकी कुल दूरी 129 रही।
इस ग्राफ में, हम देख सकते हैं कि नोड्स का भ्रमण करते समय तय की गई दूरी आवृत्तियों के साथ घटती है। यह दर्शाता है कि मॉडल समय के साथ यात्रा लंबाई में सुधार कर रहा है।
Ant colony optimization के अनुप्रयोग
ACO की अनुकूलनशीलता और दक्षता इसे विभिन्न उद्योगों में एक शक्तिशाली उपकरण बनाती है। कुछ अनुप्रयोग इस प्रकार हैं:
ACO की ताकत इसके विकसित होने और अनुकूलित होने की क्षमता में निहित है, जो इसे ऐसे गतिशील परिवेशों के लिए उपयुक्त बनाती है जहाँ परिस्थितियाँ बदल सकती हैं, जैसे रियल-टाइम ट्रैफिक रूटिंग या औद्योगिक योजना।