

Particle Swarm Optimization (PSO)
Particle swarm optimization (PSO) haalt zijn inspiratie uit het gedrag van vogelzwermen en scholen vissen. In deze natuurlijke systemen bewegen individuen op basis van hun eigen eerdere ervaringen en de posities van hun buren; ze passen zich geleidelijk aan om de meest succesvolle leden van de groep te volgen. PSO past dit concept toe op optimalisatieproblemen, waarbij deeltjes, ook wel agents genoemd, door de zoekruimte bewegen om een optimale oplossing te vinden.
In vergelijking met ACO werkt PSO in continue in plaats van discrete ruimtes. Bij ACO ligt de nadruk op het vinden van paden en discrete keuzes, terwijl PSO beter geschikt is voor problemen met continue variabelen, zoals het afstellen van parameters.
In PSO verkennen deeltjes een zoekruimte. Ze passen hun positie aan op basis van twee hoofd factoren: hun persoonlijk beste bekende positie en de beste bekende positie van de hele zwerm. Dit dubbele feedbackmechanisme stelt ze in staat te convergeren naar het globale optimum.
Hoe particle swarm optimization werkt
Het proces start met een zwerm deeltjes die willekeurig over de oplossingsruimte zijn geïnitialiseerd. Elk deeltje vertegenwoordigt een mogelijke oplossing voor het optimalisatieprobleem. Terwijl de deeltjes bewegen, onthouden ze hun persoonlijk beste posities (de beste oplossing die ze tot nu toe hebben gevonden) en worden ze aangetrokken tot de globaal beste positie (de beste oplossing die een deeltje heeft gevonden).
Deze beweging wordt gedreven door twee factoren: exploitatie en exploratie. Exploitatie houdt in dat de zoekopdracht rondom de huidige beste oplossing wordt verfijnd, terwijl exploratie deeltjes aanmoedigt om andere delen van de oplossingsruimte te verkennen om te voorkomen dat ze vastlopen in lokale optima. Door deze twee dynamieken te balanceren, convergeert PSO efficiënt naar de beste oplossing.
Particle swarm optimization Python-implementatie
In financieel portefeuillebeheer kan het lastig zijn om de beste manier te vinden om activa toe te wijzen om zo veel mogelijk rendement te behalen met zo min mogelijk risico. Laten we een PSO gebruiken om te bepalen welke mix van activa het hoogste rendement oplevert.
De onderstaande code laat zien hoe PSO werkt voor het optimaliseren van een fictieve financiële portefeuille. Het begint met willekeurige toewijzingen en verfijnt deze vervolgens over meerdere iteraties op basis van wat het beste werkt, waarna het geleidelijk de optimale mix van activa vindt voor het hoogste rendement met het laagste risico.
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")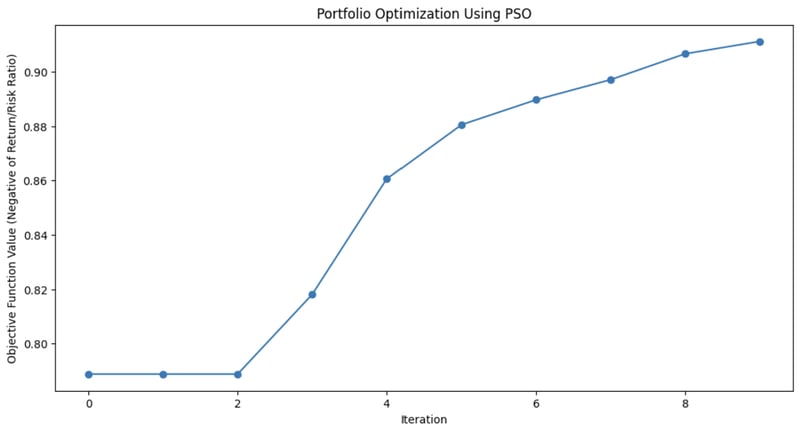
Deze grafiek laat zien hoeveel het PSO-algoritme de activamix van de portefeuille bij elke iteratie heeft verbeterd.
Toepassingen van particle swarm optimization
PSO wordt gebruikt vanwege zijn eenvoud en effectiviteit bij het oplossen van verschillende optimalisatieproblemen, met name in continue domeinen. De flexibiliteit maakt het bruikbaar voor veel praktijksituaties waarbij precieze oplossingen nodig zijn.
Deze toepassingen omvatten:
- Machine learning: PSO kan worden toegepast om hyperparameters af te stemmen in machinelearning-algoritmen en zo de beste modelconfiguraties te vinden.
- Engineeringontwerp: PSO is nuttig voor het optimaliseren van ontwerpparameters voor systemen zoals lucht- en ruimtevaartcomponenten of elektrische circuits.
- Financiële modellering: In finance kan PSO helpen bij portefeuille-optimalisatie: risico minimaliseren en rendement maximaliseren.
Het vermogen van PSO om oplossingsruimten efficiënt te verkennen maakt het toepasbaar in uiteenlopende velden, van robotica tot energiemanagement en logistiek.
Artificial Bee Colony (ABC)
Het artificial bee colony (ABC)-algoritme is gemodelleerd naar het foerageergedrag van honingbijen.
In de natuur zoeken honingbijen efficiënt naar nectarbronnen en delen deze informatie met andere leden van de bijenkorf. ABC vangt dit collaboratieve zoekproces en past het toe op optimalisatieproblemen, vooral die in complexe, hoog-dimensionale ruimtes.
Wat ABC onderscheidt van andere zwermintelligentie-algoritmen is het vermogen om exploitatie, het verfijnen van huidige oplossingen, te balanceren met exploratie, het zoeken naar nieuwe en mogelijk betere oplossingen. Dit maakt ABC bijzonder nuttig voor grootschalige problemen waar globale optimalisatie cruciaal is.
Hoe artificial bee colony werkt
In het ABC-algoritme wordt de zwerm bijen verdeeld in drie gespecialiseerde rollen: employed bees, onlookers en scouts. Elk van deze rollen bootst een ander aspect na van hoe bijen in de natuur voedselbronnen zoeken en benutten.
- Employed bees: Deze bijen verkennen bekende voedselbronnen, die huidige oplossingen in het optimalisatieprobleem vertegenwoordigen. Ze beoordelen de kwaliteit (fitness) van deze bronnen en delen de informatie met de rest van de korf.
- Onlooker bees: Na informatie te hebben verzameld van de employed bees, kiezen onlookers welke voedselbronnen ze verder gaan onderzoeken. Ze baseren hun keuzes op de kwaliteit van de oplossingen die door de employed bees zijn gedeeld, met meer focus op de betere opties, en verfijnen zo de zoektocht naar een optimale oplossing.
- Scout bees: Wanneer de voedselbron (oplossing) van een employed bee is uitgeput of stagneert (als er na een bepaald aantal iteraties geen verbetering wordt gevonden), wordt de bij een scout. Scouts verkennen nieuwe gebieden in de oplossingsruimte om mogelijk onontdekte voedselbronnen te vinden en zo diversiteit in het zoekproces te injecteren.
Deze dynamiek stelt ABC in staat de zoektocht te balanceren tussen het intensief verkennen van veelbelovende gebieden en het breed verkennen van nieuwe delen van de zoekruimte. Dit helpt het algoritme te voorkomen dat het vastloopt in lokale optima en vergroot de kans om een globaal optimum te vinden.
Artificial bee colony Python-implementatie
De Rastrigin-functie is een populair optimalisatieprobleem, bekend om zijn talrijke lokale minima, wat het een lastige uitdaging maakt voor veel algoritmen. Het doel is eenvoudig: vind het globale minimum.
In dit voorbeeld gebruiken we het artificial bee colony-algoritme om dit probleem aan te pakken. Elke bij in het ABC-algoritme verkent de zoekruimte op zoek naar betere oplossingen om de functie te minimaliseren. De code simuleert bijen die verkennen, benutten en als scout nieuwe gebieden opsporen, zodat er een balans is tussen exploratie en exploitatie.
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()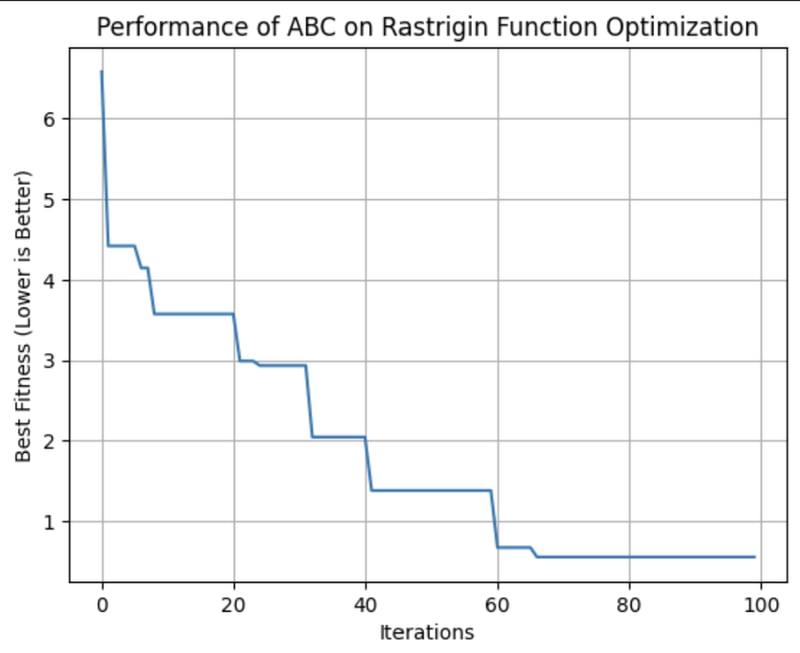
Deze grafiek toont de fitness van de beste oplossing die bij elke iteratie door het ABC-algoritme is gevonden. In deze run werd de optimale fitness rond de 64e iteratie bereikt.
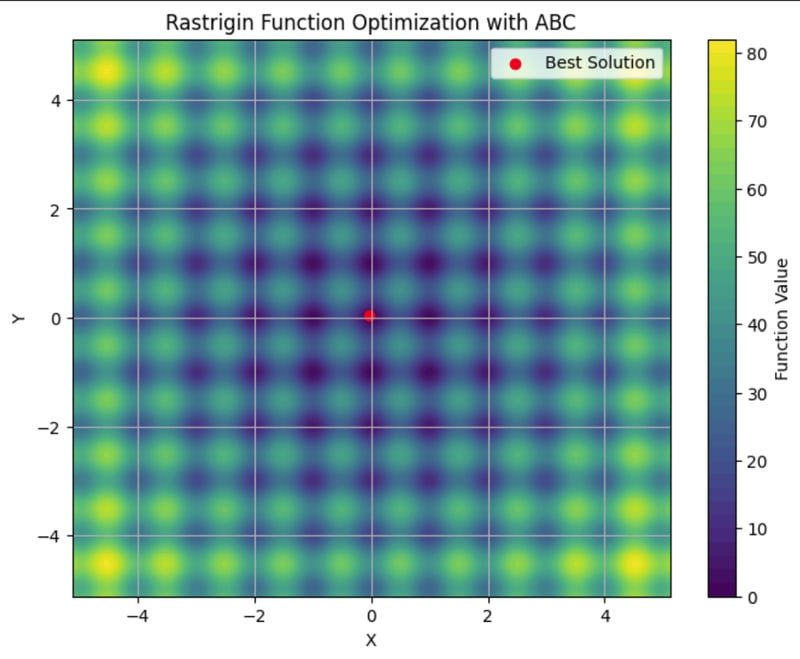
Hier zie je de Rastrigin-functie uitgezet in een contourplot, met zijn vele lokale minima. De rode stip is het globale minimum dat door het ABC-algoritme dat we draaiden is gevonden.
Toepassingen van artificial bee colony
Het ABC-algoritme is een robuust hulpmiddel voor het oplossen van optimalisatieproblemen. Het vermogen om grote en complexe zoekruimten efficiënt te verkennen maakt het een logische keuze voor sectoren waar aanpasbaarheid en schaalbaarheid cruciaal zijn.
Deze toepassingen omvatten:
- Telecommunicatie: ABC kan worden gebruikt om de plaatsing van netwerkbronnen en antennes te optimaliseren, zodat dekking en signaalsterkte worden gemaximaliseerd en kosten geminimaliseerd.
- Engineering: ABC kan parameters fijn afstellen bij structurele ontwerpoptimalisatie.
- Data Science: ABC kan worden toegepast op featureselectie om de belangrijkste variabelen in een dataset voor machine learning te identificeren.
ABC is een flexibel algoritme dat geschikt is voor elk probleem waarbij optimale oplossingen moeten worden gevonden in dynamische, hoog-dimensionale omgevingen. Door zijn gedecentraliseerde karakter is het goed inzetbaar in situaties waarin andere algoritmen moeite hebben om exploratie en exploitatie efficiënt in balans te houden.
Zwermintelligentie-algoritmen vergelijken
Er zijn meerdere zwermintelligentie-algoritmen, elk met verschillende eigenschappen. Als je beslist welke je gebruikt, is het belangrijk hun sterke en zwakke punten af te wegen om te bepalen wat het beste bij jouw behoeften past.
ACO is effectief voor combinatorische problemen zoals routering en planning, maar kan aanzienlijke rekenkracht vergen. PSO is eenvoudiger en blinkt uit in continue optimalisatie, zoals hyperparametertuning, maar kan last hebben van lokale optima. ABC balanceert exploratie en exploitatie succesvol, al vereist het zorgvuldige afstelling.
Andere zwermintelligentie-algoritmen, zoals Firefly Algorithm en Cuckoo Search Optimization, bieden ook unieke voordelen voor specifieke soorten optimalisatie problemen.
|
Algoritme |
Sterke punten |
Zwakke punten |
Voorkeursbibliotheken |
Beste toepassingen |
|
Ant Colony Optimization (ACO) |
Effectief voor combinatorische problemen en gaat goed om met complexe discrete ruimtes |
Rekenintensief en vereist fijne afstemming |
Routeringsproblemen, planning en resource-allocatie | |
|
Particle Swarm Optimization (PSO) |
Goed voor continue optimalisatie en eenvoudig te implementeren |
Kan naar lokale optima convergeren en is minder effectief voor discrete problemen |
Hyperparametertuning, engineeringontwerp, financiële modellering | |
|
Artificial Bee Colony (ABC) |
Aanpasbaar aan grote, dynamische problemen en goede balans tussen exploratie en exploitatie |
Rekenintensief en vereist zorgvuldige parameterafstemming |
Telecommunicatie, grootschalige optimalisatie en hoog-dimensionale ruimtes | |
|
Firefly Algorithm (FA) |
Blinkt uit in multimodale optimalisatie en heeft een sterke globale zoekcapaciteit |
Gevoelig voor parameterinstellingen en tragere convergentie |
Beeldverwerking, engineeringontwerp en multimodale optimalisatie | |
|
Cuckoo Search (CS) |
Efficiënt voor het oplossen van optimalisatieproblemen en sterke exploratiecapaciteiten |
Kan te vroeg convergeren en prestaties hangen af van afstemming |
Planning, featureselectie en engineeringtoepassingen |
Uitdagingen en beperkingen
Zwermintelligentie-algoritmen, net als veel machinelearning-technieken, stuiten op uitdagingen die hun prestaties kunnen beïnvloeden. Deze omvatten:
- Vroegtijdige convergentie: De zwerm kan te snel op een suboptimale oplossing uitkomen.
- Parameterafstemming: Optimale resultaten vereisen vaak zorgvuldige afstelling van algoritme-instellingen.
- Rekenmiddelen & schaalbaarheid: Deze algoritmen kunnen rekenintensief zijn, vooral bij grotere, complexere problemen, en hun prestaties kunnen verslechteren naarmate de complexiteit toeneemt.
- Stochastisch karakter: De inherente willekeur in deze algoritmen kan leiden tot variabiliteit in resultaten.
Recente onderzoeken en ontwikkelingen
Een opvallende trend is de integratie van zwermintelligentie met andere machinelearning-technieken. Onderzoekers verkennen hoe zwermalgoritmen taken als featureselectie en hyperparameteroptimalisatie kunnen verbeteren. Bekijk A hybrid particle swarm optimization algorithm for solving engineering problem.
Recente ontwikkelingen richten zich ook op het aanpakken van enkele traditionele uitdagingen van zwermintelligentie, zoals vroegtijdige convergentie. Er worden nieuwe algoritmen en technieken ontwikkeld om het risico te verkleinen dat op suboptimale oplossingen wordt geconvergeerd. Voor meer informatie, zie Memory-based approaches for eliminating premature convergence in particle swarm optimization
Schaalbaarheid is een ander belangrijk onderzoeksgebied. Naarmate problemen complexer worden en datavolumes groeien, werken onderzoekers aan manieren om zwermintelligentie-algoritmen schaalbaarder en efficiënter te maken. Dit omvat het ontwikkelen van algoritmen die grote datasets en hoog-dimensionale ruimtes effectiever aankunnen, terwijl rekenmiddelen worden geoptimaliseerd om de tijd en kosten van het uitvoeren van deze algoritmen te verlagen. Lees hierover meer in Recent Developments in the Theory and Applicability of Swarm Search.
Zwermalgoritmen worden toegepast op problemen van robotica, tot large language models (LLM's), tot medische diagnose. Er is doorlopend onderzoek naar de vraag of deze algoritmen nuttig kunnen zijn om LLM's strategisch informatie te laten vergeten om te voldoen aan Right to Be Forgotten-regelgeving. En natuurlijk hebben zwermalgoritmen een veelvoud aan toepassingen in data science.
Conclusie
Zwermintelligentie biedt krachtige oplossingen voor optimalisatieproblemen in uiteenlopende sectoren. De principes van decentralisatie, positieve feedback en adaptatie stellen het in staat complexe, dynamische taken aan te pakken waar traditionele algoritmen moeite mee kunnen hebben.
Bekijk deze review van de huidige stand van zaken rond zwermalgoritmen, “Swarm intelligence: A survey of model classification and applications”.
Wil je dieper duiken in zakelijke toepassingen van AI? Bekijk dan Artificial Intelligence (AI) Strategy of Artificial Intelligence for Business Leaders. Wil je meer leren over andere algoritmen die de natuur imiteren? Bekijk dan Genetic Algorithm: Complete Guide With Python Implementation.

Ik ben gepromoveerd en heb 13 jaar ervaring met het werken met data in een biologische onderzoeksomgeving. Ik maak software in verschillende programmeertalen, waaronder Python, MATLAB en R. Ik deel met plezier mijn liefde voor leren met de wereld.


Stel je voor dat je een zwerm vogels in vlucht bekijkt. Er is geen leider, niemand die de richting aangeeft, en toch duiken en glijden ze samen in perfecte harmonie. Het lijkt misschien chaotisch, maar er is een verborgen orde. Je ziet hetzelfde patroon bij scholen vissen die roofdieren ontwijken of mieren die de kortste weg naar voedsel vinden. Deze dieren vertrouwen op simpele regels en lokale communicatie om zonder centrale aansturing verrassend complexe taken uit te voeren.
Dat is de magie van zwermintelligentie.
We kunnen dit gedrag nabootsen met algoritmen die lastige problemen oplossen door zwermintelligentie te imiteren.
Wat is zwermintelligentie?
Zwermintelligentie is een computationele aanpak die complexe problemen oplost door het gedecentraliseerde, zelfgeorganiseerde gedrag te imiteren dat we zien in natuurlijke zwermen zoals vogelvluchten of mierenkolonies.
Laten we twee kernbegrippen verkennen: decentralisatie en positieve feedback.
Decentralisatie en emergentie
In de kern van zwermintelligentie staat het concept van decentralisatie. In plaats van te vertrouwen op een centrale leider die acties aanstuurt, opereert elk individu, ofwel "agent", autonoom op basis van beperkte, lokale informatie.
Deze gedecentraliseerde besluitvorming leidt tot een emergente eigenschap: complex, georganiseerd gedrag dat voortkomt uit de eenvoudige interacties van agents. In zwermsystemen is de totale uitkomst, of oplossing, niet vooraf geprogrammeerd maar ontstaat die natuurlijk uit deze individuele acties.
Neem mieren als voorbeeld. Bij het foerageren verkent een mier willekeurig zijn omgeving totdat hij voedsel vindt; op de weg terug naar de kolonie legt hij een feromoonspoor. Andere mieren komen dit spoor tegen en volgen het eerder, en als zij ook voedsel vinden versterken ze het pad. Na verloop van tijd trekken kortere of efficiëntere routes van nature meer mieren aan doordat sterkere feromoonsporen langs deze paden worden opgebouwd. Geen enkele mier "weet" vanaf het begin de beste route, maar gezamenlijk, via gedecentraliseerde beslissingen en het versterken van succesvolle paden, convergeert de kolonie naar de optimale oplossing.
Dit diagram laat zien hoe eenvoudige regels die individuele mieren volgen, resulteren in een optimale oplossing voor de hele kolonie.
Positieve feedback en adaptatie
Positieve feedback is een mechanisme in zwermintelligentiesystemen waarbij succesvolle acties worden beloond en versterkt. Dit leidt tot een zelfversterkend proces, zoals mieren die feromoonsporen langs kortere foerageerpaden versterken. Deze bekrachtiging van gunstig gedrag helpt de zwerm om zijn algehele prestaties in de tijd te verbeteren.
In artificial intelligence bootsen zwermintelligentie-algoritmen dit na door sleutelvariabelen, zoals waarschijnlijkheden of gewichten, aan te passen op basis van de kwaliteit van de gevonden oplossingen. Naarmate betere oplossingen worden ontdekt, richten agents zich daar steeds meer op, wat het convergentieproces versnelt. Deze dynamische feedbacklus stelt zwermsystemen in staat zich aan te passen aan veranderende omgevingen en hun prestaties te verfijnen.
Er zijn verschillende zwermintelligentie-algoritmen die diverse biologische systemen imiteren. Laten we er een paar populaire doornemen.
Ant Colony Optimization (ACO)
Ant colony optimization (ACO) is een algoritme geïnspireerd op het hierboven beschreven foerageergedrag van mieren. Het is ontworpen om combinatorische optimalisatieproblemen op te lossen, met name die waarbij we de beste mogelijke oplossing uit veel opties moeten vinden. Een klassiek voorbeeld is het traveling salesman-probleem, waarbij het doel is de kortst mogelijke route te bepalen die een reeks locaties met elkaar verbindt.
Hoe ant colony optimization werkt
In de natuur communiceren mieren door feromoonsporen achter te laten, die voor andere mieren het pad naar een voedselbron aangeven. Hoe meer mieren dat spoor volgen, hoe sterker het wordt. ACO bootst dit gedrag na met feromonen die worden weergegeven door wiskundige waarden in een feromonenmatrix. Deze matrix houdt de aantrekkelijkheid van verschillende oplossingen bij en wordt bijgewerkt naarmate het algoritme vordert.
In ACO vertegenwoordigt elke "kunstmatige mier" een potentiële oplossing voor het probleem, zoals een route in het traveling salesman-probleem. Het algoritme begint met mieren die willekeurig paden kiezen, en de feromoonwaarden helpen toekomstige mieren te sturen. Deze waarden worden opgeslagen in een matrix waarbij elk element overeenkomt met het "feromoongniveau" tussen twee punten (zoals steden).
Deze wiskundige representatie van feromonen stelt ACO in staat effectief te balanceren tussen exploratie en exploitatie, zodat grote oplossingsruimten kunnen worden doorzocht zonder vast te lopen in lokale optima.
Ant colony optimization Python-implementatie
Laten we een voorbeeld proberen, waarbij we ACO gebruiken om een eenvoudig probleem op te lossen: vind het kortste pad tussen punten in een graaf.
Deze implementatie van ACO simuleert hoe kunstmatige "mieren" 20 knooppunten in een graaf doorkruisen om het kortste pad te vinden. Elke mier start bij een willekeurig knooppunt en kiest zijn volgende stap op basis van feromoonsporen en afstanden tussen knooppunten. Na alle paden te hebben verkend, keren de mieren terug naar hun startpunt, waarmee ze een volledige lus maken.
Na verloop van tijd worden feromonen bijgewerkt: de kortere paden krijgen sterkere bekrachtiging, terwijl andere verdampen. Dit dynamische proces stelt het algoritme in staat te convergeren naar een optimale oplossing.
Deze grafiek toont de uiteindelijke oplossing, het beste gevonden pad, om elk knooppunt met de kortste afstand te bezoeken. In deze run was de beste route [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4], met een totale afstand van 129.
In deze grafiek zien we dat de afgelegde afstand tijdens het doorkruisen van de knooppunten afneemt over iteraties. Dit laat zien dat het model de reisafstand in de tijd verbetert.
Toepassingen van ant colony optimization
De aanpasbaarheid en efficiëntie van ACO maken het een krachtig hulpmiddel in diverse sectoren. Enkele toepassingen zijn:
De kracht van ACO ligt in het vermogen om te evolueren en zich aan te passen, waardoor het geschikt is voor dynamische omgevingen waar omstandigheden kunnen veranderen, zoals realtime verkeersroutering of industriële planning.