

Parçacık Sürü Optimizasyonu (PSO)
Parçacık sürü optimizasyonu (PSO), kuş sürüleri ve balık sürülerinin davranışından ilham alır. Bu doğal sistemlerde bireyler, kendi önceki deneyimlerine ve komşularının konumlarına göre hareket eder; zamanla grubun en başarılı üyelerini izlemek üzere ayarlama yaparlar. PSO, bu kavramı optimizasyon problemlerine uygular; ajan denilen parçacıklar, en iyi çözümü bulmak için arama uzayında hareket eder.
ACO ile karşılaştırıldığında PSO, ayrık değil sürekli uzaylarda çalışır. ACO’da odak, yol bulma ve ayrık seçimler üzerindedir; PSO ise parametre ayarlama gibi sürekli değişkenleri içeren problemler için daha uygundur.
PSO’da parçacıklar bir arama uzayını keşfeder. Konumlarını iki ana faktöre göre ayarlarlar: kendi kişisel en iyi bilinen konumları ve tüm sürünün en iyi bilinen konumu. Bu çift yönlü geri bildirim mekanizması, küresel optimuma yakınsamalarını sağlar.
Parçacık sürü optimizasyonu nasıl çalışır
Süreç, çözüm uzayına rastgele yerleştirilmiş bir parçacık sürüsüyle başlar. Her parçacık, optimizasyon problemine ait olası bir çözümü temsil eder. Parçacıklar hareket ettikçe, kişisel en iyi konumlarını (şimdiye dek karşılaştıkları en iyi çözüm) hatırlar ve küresel en iyi konuma (herhangi bir parçacığın bulduğu en iyi çözüm) doğru çekilirler.
Bu hareket, sömürü ve keşif olmak üzere iki faktör tarafından yönlendirilir. Sömürü, mevcut en iyi çözüm çevresinde aramayı iyileştirmeyi; keşif ise parçacıkları yerel optimumlarda takılı kalmamak için çözüm uzayının diğer kısımlarını aramaya teşvik etmeyi içerir. Bu iki dinamiği dengeleyerek PSO en iyi çözüme verimli biçimde yakınsar.
Parçacık sürü optimizasyonu Python uygulaması
Finansal portföy yönetiminde, getirileri en üst düzeye çıkarmak ve riskleri düşük tutmak için varlıkları en iyi şekilde tahsis etmek zor olabilir. En yüksek yatırım getirisini sağlayacak varlık karışımını bulmak için bir PSO kullanalım.
Aşağıdaki kod, kurgusal bir finansal portföyün optimize edilmesinde PSO’nun nasıl çalıştığını gösterir. Rastgele varlık dağılımlarıyla başlar, ardından en iyi sonuç verenleri temel alarak birkaç yineleme boyunca bunları ayarlayarak, en yüksek getiri ve en düşük risk için en uygun varlık karışımını kademeli olarak bulur.
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")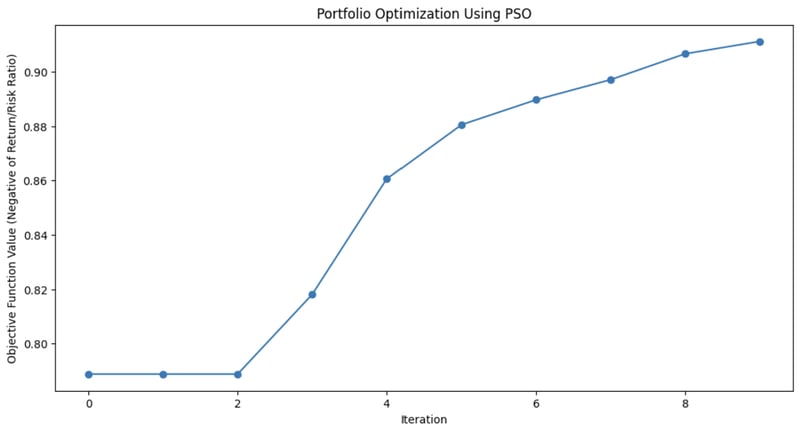
Bu grafik, PSO algoritmasının portföyün varlık karışımını her yinelemede ne kadar iyileştirdiğini gösterir.
Parçacık sürü optimizasyonunun kullanım alanları
PSO, özellikle sürekli alanlarda çeşitli optimizasyon problemlerini çözmedeki sadeliği ve etkinliği nedeniyle kullanılır. Esnekliği, kesin çözümlerin gerektiği birçok gerçek dünya senaryosu için faydalıdır.
Bu kullanım alanlarına şunlar dahildir:
- Makine öğrenimi: PSO, makine öğrenimi algoritmalarında hiperparametre ayarlamada uygulanabilir ve en iyi model yapılandırmalarını bulmaya yardımcı olur.
- Mühendislik tasarımı: PSO, havacılık bileşenleri veya elektrik devreleri gibi sistemlerin tasarım parametrelerini optimize etmede faydalıdır.
- Finansal modelleme: Finans alanında PSO, getirileri en üst düzeye çıkarırken riski en aza indirmek için portföy optimizasyonunda yardımcı olabilir.
PSO’nun çözüm uzaylarını verimli şekilde keşfetme yeteneği, robotikten enerji yönetimine ve lojistiğe kadar pek çok alanda uygulanabilir olmasını sağlar.
Yapay Arı Kolonisi (ABC)
Yapay arı kolonisi (ABC) algoritması, bal arılarının yiyecek arama davranışı üzerine modellenmiştir.
Doğada bal arıları, nektar kaynaklarını verimli şekilde arar ve bu bilgiyi kovandaki diğer üyelerle paylaşır. ABC, bu işbirlikçi arama sürecini yakalar ve özellikle karmaşık, yüksek boyutlu uzayları içeren optimizasyon problemlerine uygular.
ABC’yi diğer sürü zekâsı algoritmalarından ayıran, mevcut çözümleri iyileştirmeye odaklanan sömürü ile yeni ve potansiyel olarak daha iyi çözümler arayan keşif arasında denge kurabilmesidir. Bu, küresel optimizasyonun kritik olduğu büyük ölçekli problemler için ABC’yi özellikle kullanışlı kılar.
Yapay arı kolonisi nasıl çalışır
ABC algoritmasında arı sürüsü üç uzman role ayrılır: çalışan arılar, izleyiciler ve kaşifler. Bu rollerin her biri, arıların doğada yiyecek kaynaklarını nasıl aradıkları ve yararlandıklarının farklı bir yönünü taklit eder.
- Çalışan arılar: Bu arılar, optimizasyon problemindeki mevcut çözümleri temsil eden bilinen yiyecek kaynaklarını keşfetmekten sorumludur. Bu kaynakların kalitesini (uygunluğunu) değerlendirir ve bilgiyi kovanın geri kalanıyla paylaşırlar.
- İzleyici arılar: Çalışan arılardan bilgi topladıktan sonra, izleyiciler hangi yiyecek kaynaklarının daha fazla araştırılacağını seçer. Seçimlerini çalışan arıların paylaştığı çözümlerin kalitesine göre yapar ve daha iyi seçeneklere odaklanarak en iyi çözüm arayışını rafine ederler.
- Kaşif arılar: Bir çalışan arının yiyecek kaynağı (çözüm) tükendiğinde veya durağanlaştığında (belirli sayıda yineleme sonrası iyileşme olmadığında) arı kaşife dönüşür. Kaşifler, arama sürecine çeşitlilik katmak için çözüm uzayında potansiyel olarak keşfedilmemiş yiyecek kaynaklarını arayarak yeni bölgeleri keşfeder.
Bu dinamik, ABC’nin umut vadeden alanları yoğun şekilde araştırma ile arama uzayının yeni alanlarını genişçe keşfetme arasında denge kurmasını sağlar. Bu da algoritmanın yerel optimumlarda takılı kalmasını önlemeye yardımcı olur ve küresel optimumu bulma şansını artırır.
Yapay arı kolonisi Python uygulaması
Rastrigin fonksiyonu, çok sayıda yerel minimuma sahip olmasıyla bilinen ve birçok algoritma için zorlayıcı bir optimizasyon problemidir. Amaç basittir: küresel minimumu bulmak.
Bu örnekte, bu problemi çözmek için yapay arı kolonisi algoritmasını kullanacağız. ABC’deki her arı, fonksiyonu en aza indirmek için daha iyi çözümler arayarak arama uzayını keşfeder. Kod, keşif yapan, yararlanan ve yeni alanlar arayan arıları simüle ederek keşif ve sömürü arasında bir denge sağlar.
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()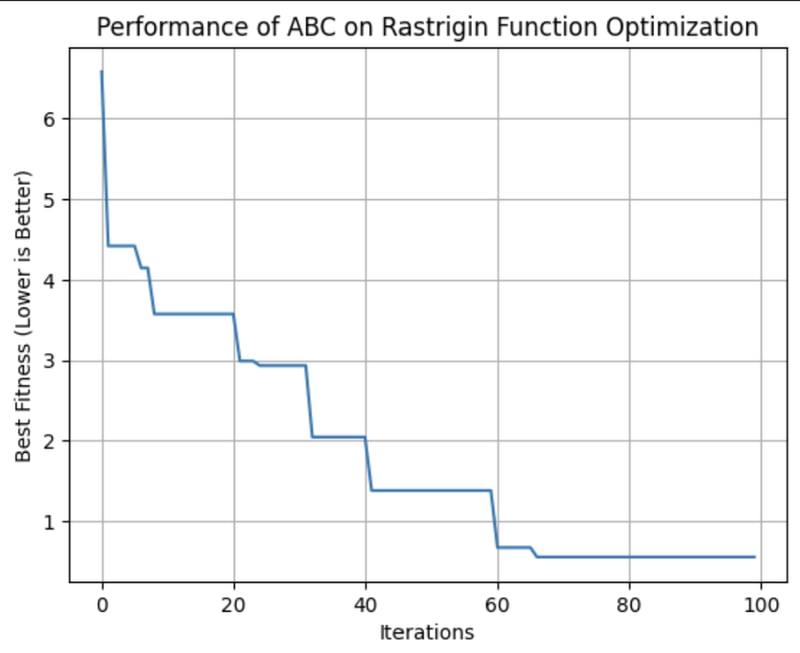
Bu grafik, ABC algoritmasının her yinelemede bulduğu en iyi çözümün uygunluğunu gösterir. Bu çalıştırmada, yaklaşık 64. yineleme civarında en iyi uygunluğa ulaştı.
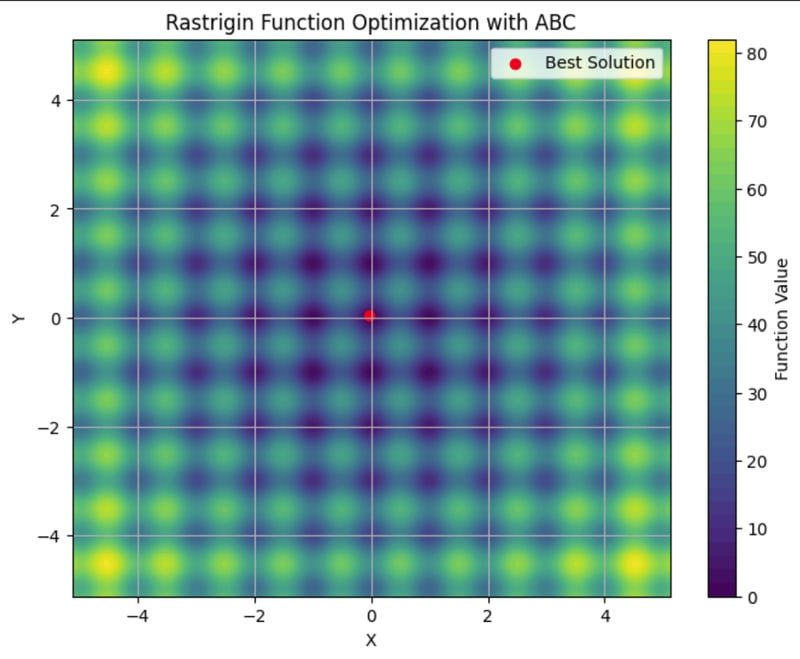
Burada çok sayıda yerel minimuma sahip Rastrigin fonksiyonunu bir kontur grafikte görebilirsiniz. Kırmızı nokta, çalıştırdığımız ABC algoritmasının bulduğu küresel minimumdur.
Yapay arı kolonisinin kullanım alanları
ABC algoritması, optimizasyon problemlerini çözmede sağlam bir araçtır. Geniş ve karmaşık arama uzaylarını verimli şekilde keşfetme yeteneği, uyarlanabilirliğin ve ölçeklenebilirliğin kritik olduğu sektörler için onu başvurulacak bir seçenek yapar.
Bu kullanım alanlarına şunlar dahildir:
- Telekomünikasyon: ABC, kapsama alanını ve sinyal gücünü en üst düzeye çıkarırken maliyetleri en aza indirmek için ağ kaynaklarının ve antenlerin yerleşimini optimize etmekte kullanılabilir.
- Mühendislik: ABC, yapısal tasarım optimizasyonunda parametreleri ince ayar yapabilir.
- Veri bilimi: ABC, makine öğrenimi için bir veri kümesindeki en önemli değişkenleri belirlemek üzere öznitelik seçimine uygulanabilir.
ABC, dinamik ve yüksek boyutlu ortamlarda en iyi çözümlerin bulunması gereken her problem için esnek bir algoritmadır. Merkeziyetsiz doğası, diğer algoritmaların keşif ve sömürü dengesini verimli şekilde kurmakta zorlanabileceği durumlar için onu uygun kılar.
Sürü Zekâsı Algoritmalarının Karşılaştırılması
Birden fazla sürü zekâsı algoritması vardır ve her birinin farklı özellikleri bulunur. Hangisini kullanacağınıza karar verirken, güçlü ve zayıf yönlerini tartarak ihtiyaçlarınıza en uygun olanı belirlemek önemlidir.
ACO, rotalama ve çizelgeleme gibi kombinatoryel problemler için etkilidir ancak önemli hesaplama kaynaklarına ihtiyaç duyabilir. PSO daha basittir ve hiperparametre ayarlama gibi sürekli optimizasyonda üstün performans gösterir, ancak yerel optimumlarla mücadele edebilir. ABC, keşif ve sömürüyü başarıyla dengeler; ancak dikkatli ayarlama gerektirir.
Diğer sürü zekâsı algoritmaları, örneğin Ateşböceği Algoritması ve Guguk Kuşu Araması Optimizasyonu, belirli türdeki optimizasyon problemleri için de kendine özgü avantajlar sunar.
|
Algoritma |
Güçlü Yönler |
Zayıf Yönler |
Tercih Edilen Kütüphaneler |
En İyi Uygulamalar |
|
Karınca Kolonisi Optimizasyonu (ACO) |
Kombinatoryel problemler için etkilidir ve karmaşık ayrık uzayları iyi yönetir |
Hesaplama açısından yoğun ve ince ayar gerektirir |
Rotalama problemleri, çizelgeleme ve kaynak tahsisi | |
|
Parçacık Sürü Optimizasyonu (PSO) |
Sürekli optimizasyon için iyidir; basit ve uygulaması kolaydır |
Yerel optimumlara yakınsayabilir ve ayrık problemler için daha az etkilidir |
Hiperparametre ayarlama, mühendislik tasarımı, finansal modelleme | |
|
Yapay Arı Kolonisi (ABC) |
Büyük, dinamik problemlere uyarlanabilir ve keşif-sömürü dengesi iyidir |
Hesaplama açısından yoğun ve dikkatli parametre ayarı gerektirir |
Telekomünikasyon, büyük ölçekli optimizasyon ve yüksek boyutlu uzaylar | |
|
Ateşböceği Algoritması (FA) |
Çok modlu optimizasyonda başarılıdır ve güçlü küresel arama yeteneğine sahiptir |
Parametre ayarlarına duyarlıdır ve yakınsama daha yavaştır |
Görüntü işleme, mühendislik tasarımı ve çok modlu optimizasyon | |
|
Guguk Kuşu Araması (CS) |
Optimizasyon problemlerini çözmede verimlidir ve güçlü keşif yeteneklerine sahiptir |
Erken yakınsamaya gidebilir ve performans ayarlamaya bağlıdır |
Çizelgeleme, öznitelik seçimi ve mühendislik uygulamaları |
Zorluklar ve Sınırlamalar
Sürü zekâsı algoritmaları, birçok makine öğrenimi tekniğinde olduğu gibi, performanslarını etkileyebilecek zorluklarla karşılaşır. Bunlar şunları içerir:
- Erken yakınsama: Sürü, çok hızlı bir şekilde optimal olmayan bir çözüme yerleşebilir.
- Parametre ayarı: En iyi sonuçlara ulaşmak çoğu zaman algoritma ayarlarının dikkatli şekilde düzenlenmesini gerektirir.
- Hesaplama kaynakları ve ölçeklenebilirlik: Bu algoritmalar, özellikle daha büyük ve daha karmaşık problemler için hesaplama açısından yoğun olabilir ve problem karmaşıklığı arttıkça performansları düşebilir.
- Stokastik doğa: Bu algoritmaların doğasında bulunan rastgelelik, sonuçlarda değişkenliğe yol açabilir.
Güncel Araştırmalar ve Gelişmeler
Dikkat çekici bir trend, sürü zekâsının diğer makine öğrenimi teknikleriyle entegrasyonudur. Araştırmacılar, sürü algoritmalarının öznitelik seçimi ve hiperparametre optimizasyonu gibi görevleri nasıl geliştirebileceğini araştırıyor. Şuna göz atın: Mühendislik problemini çözmek için hibrit parçacık sürü optimizasyon algoritması.
Son gelişmeler, sürü zekâsıyla ilişkilendirilen erken yakınsama gibi geleneksel zorlukların ele alınmasına da odaklanıyor. Optimal olmayan çözümlere yakınsama riskini azaltmak için yeni algoritmalar ve teknikler geliştiriliyor. Daha fazla bilgi için şuna bakın: Parçacık sürü optimizasyonunda erken yakınsamayı ortadan kaldırmaya yönelik bellek tabanlı yaklaşımlar
Ölçeklenebilirlik bir diğer önemli araştırma alanıdır. Problemler giderek daha karmaşık hale gelirken ve veri hacimleri artarken, araştırmacılar sürü zekâsı algoritmalarını daha ölçeklenebilir ve verimli hale getirmenin yolları üzerinde çalışıyor. Buna, büyük veri kümelerini ve yüksek boyutlu uzayları daha etkili şekilde işleyebilen algoritmalar geliştirmek ve bu algoritmaların çalıştırılmasıyla ilişkili zamanı ve maliyeti azaltmak için hesaplama kaynaklarını optimize etmek de dahildir. Bununla ilgili daha fazla bilgi için şuna bakın: Sürü Aramasının Kuramı ve Uygulanabilirliğindeki Son Gelişmeler.
Sürü algoritmaları, robotikten, büyük dil modellerine (LLM’ler), tıbbi teşhise kadar pek çok probleme uygulanıyor. Bu algoritmaların, LLM’lerin devam eden araştırmalar kapsamında Unutulma Hakkı düzenlemelerine uyum sağlamak için stratejik olarak bilgiyi unutmada faydalı olup olamayacağı da araştırılıyor. Ve elbette sürü algoritmalarının veri biliminde çok sayıda uygulaması vardır.
Sonuç
Sürü zekâsı, çeşitli sektörlerdeki optimizasyon problemleri için güçlü çözümler sunar. Merkeziyetsizlik, olumlu geri bildirim ve uyum sağlama ilkeleri, geleneksel algoritmaların zorlanabileceği karmaşık ve dinamik görevlerin üstesinden gelmesine olanak tanır.
Sürü algoritmalarının mevcut durumuna ilişkin bu derlemeye göz atın: “Sürü zekâsı: Model sınıflandırması ve uygulamalarına ilişkin bir inceleme”.
Yapay zekânın iş dünyası uygulamalarına daha derinlemesine dalmak için Artificial Intelligence (AI) Strategy veya Artificial Intelligence for Business Leaders kaynaklarına göz atın. Doğayı taklit eden diğer algoritmaları öğrenmek için ise Genetic Algorithm: Complete Guide With Python Implementation kaynağına bakın.

Biyolojik araştırma ortamında verilerle çalışma konusunda 13 yıllık deneyime sahip bir doktora sahibiyim. Python, MATLAB ve R dahil olmak üzere birkaç programlama dilinde yazılım geliştiriyorum. Öğrenme sevgimi dünyayla paylaşma konusunda tutkuluyum.





Uçan bir kuş sürüsünü izlediğinizi hayal edin. Bir lider yok, kimse yön vermiyor ama yine de kusursuz bir uyumla dalışlar yapıp süzülüyorlar. Kaos gibi görünebilir, ancak gizli bir düzen vardır. Aynı deseni, yırtıcılardan kaçan balık sürülerinde ya da yiyeceğe en kısa yolu bulan karıncalarda da görebilirsiniz. Bu canlılar, merkezi bir denetim olmadan şaşırtıcı derecede karmaşık görevlerin üstesinden gelmek için basit kurallara ve yerel iletişime güvenirler.
İşte bu, sürü zekâsının sihridir.
Bu davranışı, sürü zekâsını taklit ederek zorlu problemleri çözen algoritmalarla yeniden üretebiliriz.
Sürü Zekâsı Nedir?
Sürü zekâsı, kuş sürüleri veya karınca kolonileri gibi doğal sürülerde gözlemlenen merkeziyetsiz, kendi kendini örgütleyen davranışı taklit ederek karmaşık problemleri çözen hesaplamalı bir yaklaşımdır.
İki temel kavramı inceleyelim: merkeziyetsizlik ve olumlu geri bildirim.
Merkeziyetsizlik ve ortaya çıkış
Sürü zekâsının özünde merkeziyetsizlik kavramı vardır. Eylemleri yönlendirecek bir merkezî lidere güvenmek yerine, her bir birey ya da "ajan" sınırlı, yerel bilgiye dayanarak özerk biçimde hareket eder.
Bu merkeziyetsiz karar alma, ortaya çıkan bir özelliğe yol açar—ajanların basit etkileşimlerinden karmaşık, örgütlü davranış doğar. Sürü sistemlerinde genel sonuç ya da çözüm, önceden programlanmış değildir; bu bireysel eylemlerden doğal olarak ortaya çıkar.
Karıncaları örnek alın. Yiyecek ararken bir karınca rastgele çevresini keşfeder; yiyecek bulduğunda koloniye dönerken bir feromon izi bırakır. Diğer karıncalar bu izi takip etme olasılığı daha yüksek olduğundan, yolun sonunda yiyecek bulurlarsa izi güçlendirirler. Zamanla, daha kısa veya daha verimli güzergâhlar boyunca daha güçlü feromon izleri oluştuğu için buralara daha fazla karınca yönelir. Başlangıçta hiçbir karınca en iyi rotayı "bilmez"; ancak merkeziyetsiz kararlar ve başarılı yolların pekiştirilmesiyle koloni, topluca en iyi çözüme yakınsar.
Bu diyagram, bireysel karıncaların izlediği basit kuralların tüm koloni için en iyi çözüme nasıl ulaştığını gösterir.
Olumlu geri bildirim ve uyum sağlama
Olumlu geri bildirim, sürü zekâsı sistemlerinde başarılı eylemlerin ödüllendirildiği ve pekiştirildiği bir mekanizmadır. Bu, karıncaların daha kısa yiyecek arama yollarındaki feromon izlerini güçlendirmesine benzer şekilde, kendini büyüten bir sürece yol açar. Faydalı davranışların pekiştirilmesi, sürünün zamanla genel performansını iyileştirmesine yardımcı olur.
Yapay zekâda, sürü zekâsı algoritmaları bulunan çözümlerin kalitesine göre olasılık veya ağırlık gibi temel faktörleri ayarlayarak bunu taklit eder. Daha iyi çözümler keşfedildikçe ajanlar giderek bunlara odaklanır; bu da yakınsama sürecini hızlandırır. Bu dinamik geri bildirim döngüsü, sürü sistemlerinin değişen ortamlara uyum sağlamasına ve performanslarını iyileştirmesine olanak tanır.
Farklı biyolojik sistemleri taklit eden çeşitli sürü zekâsı algoritmaları vardır. Popüler olanlardan bazılarına göz atalım.
Karınca Kolonisi Optimizasyonu (ACO)
Karınca kolonisi optimizasyonu (ACO), yukarıda anlatılan karıncaların yiyecek arama davranışından esinlenen bir algoritmadır. Kombinatoryel optimizasyon problemlerini, özellikle de birçok seçenek arasından en iyi olası çözümü bulmamız gereken durumları çözmek için tasarlanmıştır. Bunun klasik bir örneği, bir dizi konumu birbirine bağlayan en kısa rotayı bulmayı amaçlayan gezgin satıcı problemidir.
Karınca kolonisi optimizasyonu nasıl çalışır
Doğada karıncalar, diğer karıncalara bir yiyecek kaynağına giden yolu göstermek için feromon izleri bırakır. O izi ne kadar çok karınca takip ederse o kadar güçlenir. ACO bu davranışı, bir feromon matrisinde saklanan sayısal değerlerle temsil edilen feromonlarla taklit eder. Bu matris, farklı çözümlerin çekiciliğini takip eder ve algoritma ilerledikçe güncellenir.
ACO’da her "yapay karınca", gezgin satıcı problemindeki bir rota gibi, probleme yönelik olası bir çözümü temsil eder. Algoritma, tüm karıncaların rastgele yollar seçmesiyle başlar ve feromon değerleri sonraki karıncalara rehberlik eder. Bu değerler, her bir girdinin iki nokta (ör. şehirler) arasındaki "feromon düzeyine" karşılık geldiği bir matris içinde saklanır.
Feromonların bu sayısal temsili, ACO’nun keşif ve sömürü arasında etkili bir denge kurmasını, büyük çözüm uzaylarını yerel optimumlara takılmadan taramasını sağlar.
Karınca kolonisi optimizasyonu Python uygulaması
Basit bir örnek deneyelim: ACO’yu bir grafikteki noktalar arasında en kısa yolu bulmak için kullanalım.
Bu ACO uygulaması, yapay "karıncaların" graf üzerindeki 20 düğümü en kısa yolu bulmak için nasıl dolaştığını simüle eder. Her karınca rastgele bir düğümde başlar ve bir sonraki hamlesini feromon izleri ile düğümler arası mesafelere göre seçer. Tüm yolları keşfettikten sonra başlangıç noktasına dönerek tam bir turu tamamlarlar.
Zamanla feromonlar güncellenir: daha kısa yollar daha güçlü pekiştirme alırken diğerleri buharlaşır. Bu dinamik süreç, algoritmanın en iyi çözüme yakınsamasını sağlar.
Bu grafik, her düğüme en kısa mesafeyle seyahat etmek için bulunan en iyi yolu, yani nihai çözümü gösterir. Bu çalıştırmada en iyi rota [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4] olarak ve toplam mesafe 129 olarak bulundu.
Bu grafikte, düğümler arasında gezinirken kat edilen mesafenin yinelemeler boyunca azaldığını görebiliriz. Bu, modelin zamanla yolculuk uzunluğunu iyileştirdiğini gösterir.
Karınca kolonisi optimizasyonunun kullanım alanları
ACO’nun uyarlanabilirliği ve verimliliği onu çeşitli sektörlerde güçlü bir araç kılar. Bazı kullanım alanları şunlardır:
ACO’nun gücü, evrilme ve uyum sağlama yeteneğinde yatar; bu da onu gerçek zamanlı trafik yönlendirme veya endüstriyel planlama gibi koşulların değişebildiği dinamik ortamlar için uygun kılar.