

Particle Swarm Optimization (PSO)
La particle swarm optimization (PSO) trae ispirazione dal comportamento degli stormi di uccelli e dei banchi di pesci. In questi sistemi naturali, gli individui si muovono in base alle proprie esperienze precedenti e alle posizioni dei vicini, adattandosi gradualmente a seguire i membri più di successo del gruppo. PSO applica questo concetto ai problemi di ottimizzazione, in cui particelle, chiamate agenti, si muovono nello spazio di ricerca per trovare una soluzione ottimale.
Rispetto ad ACO, PSO opera in spazi continui piuttosto che discreti. In ACO, l’attenzione è sul tracciamento dei percorsi e sulle scelte discrete, mentre PSO è più adatto a problemi con variabili continue, come la messa a punto dei parametri.
In PSO, le particelle esplorano uno spazio di ricerca. Regolano le proprie posizioni in base a due fattori principali: la loro migliore posizione personale nota e la migliore posizione nota dell’intero sciame. Questo duplice meccanismo di feedback consente di convergere verso l’ottimo globale.
Come funziona la particle swarm optimization
Il processo inizia con uno sciame di particelle inizializzate casualmente nello spazio delle soluzioni. Ogni particella rappresenta una possibile soluzione al problema di ottimizzazione. Man mano che le particelle si muovono, ricordano le loro migliori posizioni personali (la migliore soluzione incontrata finora) e sono attratte verso la posizione migliore globale (la migliore soluzione trovata da qualsiasi particella).
Questo movimento è guidato da due fattori: sfruttamento ed esplorazione. Lo sfruttamento consiste nel perfezionare la ricerca intorno alla soluzione migliore corrente, mentre l’esplorazione incoraggia le particelle a cercare in altre parti dello spazio delle soluzioni per evitare di bloccarsi in ottimi locali. Bilanciando queste due dinamiche, PSO converge in modo efficiente sulla soluzione migliore.
Implementazione in Python della particle swarm optimization
Nella gestione di portafogli finanziari, trovare il modo migliore di allocare gli asset per ottenere i rendimenti più alti mantenendo basso il rischio può essere complicato. Usiamo un PSO per scoprire quale mix di asset ci darà il rendimento sull’investimento più alto.
Il codice seguente mostra come PSO funziona per ottimizzare un portafoglio finanziario fittizio. Parte da allocazioni di asset casuali, poi le affina in più iterazioni in base a ciò che funziona meglio, trovando gradualmente il mix ottimale di asset per il rendimento più alto con il rischio più basso.
import numpy as np
import matplotlib.pyplot as plt
# Define the PSO parameters
class Particle:
def __init__(self, n_assets):
# Initialize a particle with random weights and velocities
self.position = np.random.rand(n_assets)
self.position /= np.sum(self.position) # Normalize weights so they sum to 1
self.velocity = np.random.rand(n_assets)
self.best_position = np.copy(self.position)
self.best_score = float('inf') # Start with a very high score
def objective_function(weights, returns, covariance):
"""
Calculate the portfolio's performance.
- weights: Asset weights in the portfolio.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
portfolio_return = np.dot(weights, returns) # Calculate the portfolio return
portfolio_risk = np.sqrt(np.dot(weights.T, np.dot(covariance, weights))) # Calculate portfolio risk (standard deviation)
return -portfolio_return / portfolio_risk # We want to maximize return and minimize risk
def update_particles(particles, global_best_position, returns, covariance, w, c1, c2):
"""
Update the position and velocity of each particle.
- particles: List of particle objects.
- global_best_position: Best position found by all particles.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
- w: Inertia weight to control particle's previous velocity effect.
- c1: Cognitive coefficient to pull particles towards their own best position.
- c2: Social coefficient to pull particles towards the global best position.
"""
for particle in particles:
# Random coefficients for velocity update
r1, r2 = np.random.rand(len(particle.position)), np.random.rand(len(particle.position))
# Update velocity
particle.velocity = (w * particle.velocity +
c1 * r1 * (particle.best_position - particle.position) +
c2 * r2 * (global_best_position - particle.position))
# Update position
particle.position += particle.velocity
particle.position = np.clip(particle.position, 0, 1) # Ensure weights are between 0 and 1
particle.position /= np.sum(particle.position) # Normalize weights to sum to 1
# Evaluate the new position
score = objective_function(particle.position, returns, covariance)
if score < particle.best_score:
# Update the particle's best known position and score
particle.best_position = np.copy(particle.position)
particle.best_score = score
def pso_portfolio_optimization(n_particles, n_iterations, returns, covariance):
"""
Perform Particle Swarm Optimization to find the optimal asset weights.
- n_particles: Number of particles in the swarm.
- n_iterations: Number of iterations for the optimization.
- returns: Expected returns of the assets.
- covariance: Covariance matrix representing risk.
"""
# Initialize particles
particles = [Particle(len(returns)) for _ in range(n_particles)]
# Initialize global best position
global_best_position = np.random.rand(len(returns))
global_best_position /= np.sum(global_best_position)
global_best_score = float('inf')
# PSO parameters
w = 0.5 # Inertia weight: how much particles are influenced by their own direction
c1 = 1.5 # Cognitive coefficient: how well particles learn from their own best solutions
c2 = 0.5 # Social coefficient: how well particles learn from global best solutions
history = [] # To store the best score at each iteration
for _ in range(n_iterations):
update_particles(particles, global_best_position, returns, covariance, w, c1, c2)
for particle in particles:
score = objective_function(particle.position, returns, covariance)
if score < global_best_score:
# Update the global best position and score
global_best_position = np.copy(particle.position)
global_best_score = score
# Store the best score (negative return/risk ratio) for plotting
history.append(-global_best_score)
return global_best_position, history
# Example data for 3 assets
returns = np.array([0.02, 0.28, 0.15]) # Expected returns for each asset
covariance = np.array([[0.1, 0.02, 0.03], # Covariance matrix for asset risks
[0.02, 0.08, 0.04],
[0.03, 0.04, 0.07]])
# Run the PSO algorithm
n_particles = 10 # Number of particles
n_iterations = 10 # Number of iterations
best_weights, optimization_history = pso_portfolio_optimization(n_particles, n_iterations, returns, covariance)
# Plotting the optimization process
plt.figure(figsize=(12, 6))
plt.plot(optimization_history, marker='o')
plt.title('Portfolio Optimization Using PSO')
plt.xlabel('Iteration')
plt.ylabel('Objective Function Value (Negative of Return/Risk Ratio)')
plt.grid(False) # Turn off gridlines
plt.show()
# Display the optimal asset weights
print(f"Optimal Asset Weights: {best_weights}")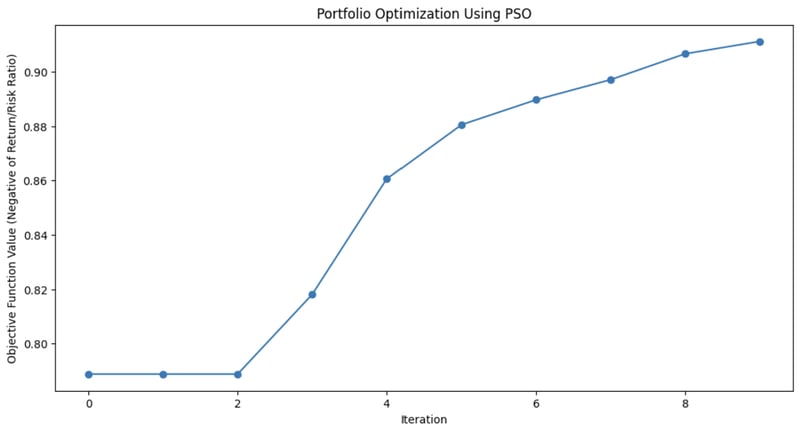
Questo grafico dimostra quanto l’algoritmo PSO abbia migliorato il mix di asset del portafoglio a ogni iterazione.
Applicazioni della particle swarm optimization
PSO è usato per la sua semplicità ed efficacia nel risolvere vari problemi di ottimizzazione, in particolare nei domini continui. La sua flessibilità lo rende utile in molti scenari reali in cui servono soluzioni precise.
Tra queste applicazioni rientrano:
- Machine learning: PSO può essere applicato per sintonizzare gli iperparametri negli algoritmi di machine learning, aiutando a trovare le migliori configurazioni di modello.
- Progettazione ingegneristica: PSO è utile per ottimizzare parametri di progetto per sistemi come componenti aerospaziali o circuiti elettrici.
- Modellazione finanziaria: in finanza, PSO può aiutare nell’ottimizzazione di portafoglio, minimizzando il rischio e massimizzando i rendimenti.
La capacità di PSO di esplorare efficientemente gli spazi di soluzione lo rende applicabile in campi che vanno dalla robotica alla gestione energetica alla logistica.
Artificial Bee Colony (ABC)
L’algoritmo artificial bee colony (ABC) è modellato sul comportamento di foraggiamento delle api mellifere.
In natura, le api mellifere cercano con efficienza le fonti di nettare e condividono queste informazioni con gli altri membri dell’alveare. ABC cattura questo processo di ricerca collaborativa e lo applica ai problemi di ottimizzazione, specialmente quelli che coinvolgono spazi complessi e ad alta dimensionalità.
Ciò che distingue ABC da altri algoritmi di swarm intelligence è la sua capacità di bilanciare sfruttamento, focalizzato sul perfezionamento delle soluzioni attuali, ed esplorazione, orientata alla ricerca di soluzioni nuove e potenzialmente migliori. Questo rende ABC particolarmente utile per problemi su larga scala in cui l’ottimizzazione globale è fondamentale.
Come funziona l’artificial bee colony
Nell’algoritmo ABC, lo sciame di api è suddiviso in tre ruoli specializzati: employed, onlooker e scout. Ognuno di questi ruoli imita un aspetto diverso del modo in cui le api cercano ed exploitano le fonti di cibo in natura.
- Employed bees: queste api si occupano di esplorare fonti di cibo note, che rappresentano le soluzioni correnti nel problema di ottimizzazione. Valutano la qualità (fitness) di queste fonti e condividono le informazioni con il resto dell’alveare.
- Onlooker bees: dopo aver raccolto informazioni dalle employed, le onlooker selezionano quali fonti di cibo esplorare ulteriormente. Basano le loro scelte sulla qualità delle soluzioni condivise dalle employed, concentrandosi sulle opzioni migliori, perfezionando così la ricerca della soluzione ottimale.
- Scout bees: quando la fonte di cibo (soluzione) di una employed si esaurisce o ristagna (cioè non migliora dopo un certo numero di iterazioni), l’ape diventa una scout. Le scout esplorano nuove aree dello spazio delle soluzioni, cercando fonti potenzialmente inesplorate, introducendo così diversità nel processo di ricerca.
Questa dinamica consente ad ABC di bilanciare la ricerca tra un’esplorazione intensiva delle aree promettenti e un’esplorazione ampia di nuove aree dello spazio di ricerca. Ciò aiuta l’algoritmo a evitare di restare intrappolato in ottimi locali e aumenta le probabilità di trovare un ottimo globale.
Implementazione in Python dell’artificial bee colony
La funzione di Rastrigin è un problema noto in ottimizzazione, famoso per i suoi numerosi minimi locali, che la rendono una sfida ardua per molti algoritmi. L’obiettivo è semplice: trovare il minimo globale.
In questo esempio useremo l’algoritmo artificial bee colony per affrontare questo problema. Ogni ape dell’algoritmo ABC esplora lo spazio di ricerca alla ricerca di soluzioni migliori per minimizzare la funzione. Il codice simula api che esplorano, sfruttano e vanno in ricognizione di nuove aree, garantendo un equilibrio tra esplorazione e sfruttamento.
import numpy as np
import matplotlib.pyplot as plt
# Rastrigin function: The objective is to minimize this function
def rastrigin(X):
A = 10
return A * len(X) + sum([(x ** 2 - A * np.cos(2 * np.pi * x)) for x in X])
# Artificial Bee Colony (ABC) algorithm for continuous optimization of Rastrigin function
def artificial_bee_colony_rastrigin(n_iter=100, n_bees=30, dim=2, bound=(-5.12, 5.12)):
"""
Apply Artificial Bee Colony (ABC) algorithm to minimize the Rastrigin function.
Parameters:
n_iter (int): Number of iterations
n_bees (int): Number of bees in the population
dim (int): Number of dimensions (variables)
bound (tuple): Bounds for the search space (min, max)
Returns:
tuple: Best solution found, best fitness value, and list of best fitness values per iteration
"""
# Initialize the bee population with random solutions within the given bounds
bees = np.random.uniform(bound[0], bound[1], (n_bees, dim))
best_bee = bees[0]
best_fitness = rastrigin(best_bee)
best_fitnesses = []
for iteration in range(n_iter):
# Employed bees phase: Explore new solutions based on the current bees
for i in range(n_bees):
# Generate a new candidate solution by perturbing the current bee's position
new_bee = bees[i] + np.random.uniform(-1, 1, dim)
new_bee = np.clip(new_bee, bound[0], bound[1]) # Keep within bounds
# Evaluate the fitness of the new solution
new_fitness = rastrigin(new_bee)
if new_fitness < rastrigin(bees[i]):
bees[i] = new_bee # Update bee if the new solution is better
# Onlooker bees phase: Exploit good solutions
fitnesses = np.array([rastrigin(bee) for bee in bees])
probabilities = 1 / (1 + fitnesses) # Higher fitness gets higher chance
probabilities /= probabilities.sum() # Normalize probabilities
for i in range(n_bees):
if np.random.rand() < probabilities[i]:
selected_bee = bees[i]
# Generate a new candidate solution by perturbing the selected bee
new_bee = selected_bee + np.random.uniform(-0.5, 0.5, dim)
new_bee = np.clip(new_bee, bound[0], bound[1])
if rastrigin(new_bee) < rastrigin(selected_bee):
bees[i] = new_bee
# Scouting phase: Randomly reinitialize some bees to explore new areas
if np.random.rand() < 0.1: # 10% chance to reinitialize a bee
scout_index = np.random.randint(n_bees)
bees[scout_index] = np.random.uniform(bound[0], bound[1], dim)
# Track the best solution found so far
current_best_bee = bees[np.argmin(fitnesses)]
current_best_fitness = min(fitnesses)
if current_best_fitness < best_fitness:
best_fitness = current_best_fitness
best_bee = current_best_bee
best_fitnesses.append(best_fitness)
return best_bee, best_fitness, best_fitnesses
# Apply ABC to minimize the Rastrigin function
best_solution, best_fitness, best_fitnesses = artificial_bee_colony_rastrigin()
# Display results
print("Best Solution (x, y):", best_solution)
print("Best Fitness (Minimum Value):", best_fitness)
# Plot the performance over iterations
plt.figure()
plt.plot(best_fitnesses)
plt.title('Performance of ABC on Rastrigin Function Optimization')
plt.xlabel('Iterations')
plt.ylabel('Best Fitness (Lower is Better)')
plt.grid(True)
plt.show()
# Plot a surface graph of the Rastrigin function
x = np.linspace(-5.12, 5.12, 200)
y = np.linspace(-5.12, 5.12, 200)
X, Y = np.meshgrid(x, y)
Z = 10 * 2 + (X ** 2 - 10 * np.cos(2 * np.pi * X)) + (Y ** 2 - 10 * np.cos(2 * np.pi * Y))
plt.figure(figsize=(8, 6))
plt.contourf(X, Y, Z, levels=50, cmap='viridis')
plt.colorbar(label='Function Value')
plt.scatter(best_solution[0], best_solution[1], c='red', label='Best Solution')
plt.title('Rastrigin Function Optimization with ABC')
plt.xlabel('X')
plt.ylabel('Y')
plt.legend()
plt.grid(True)
plt.show()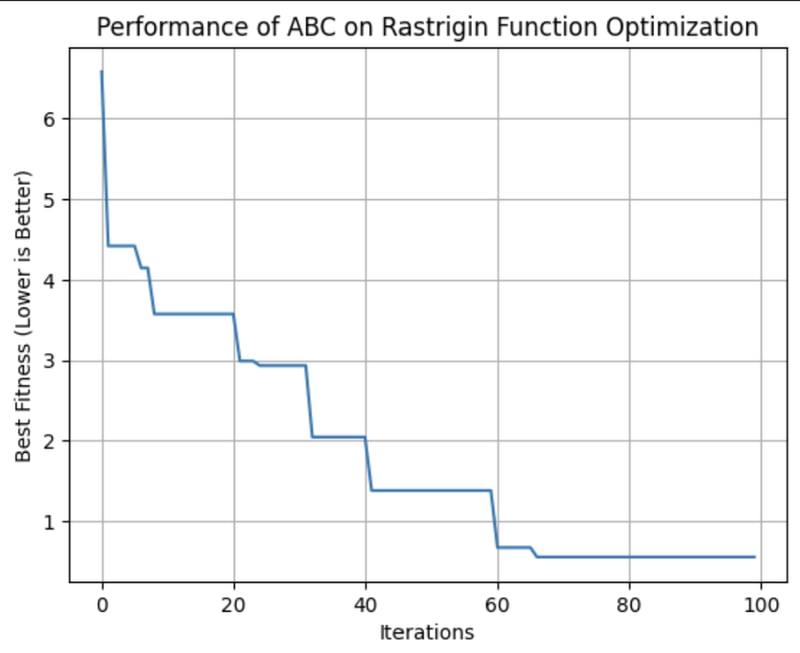
Questo grafico mostra la fitness della migliore soluzione trovata dall’algoritmo ABC a ogni iterazione. In questa esecuzione, ha raggiunto la fitness ottimale intorno alla 64ª iterazione.
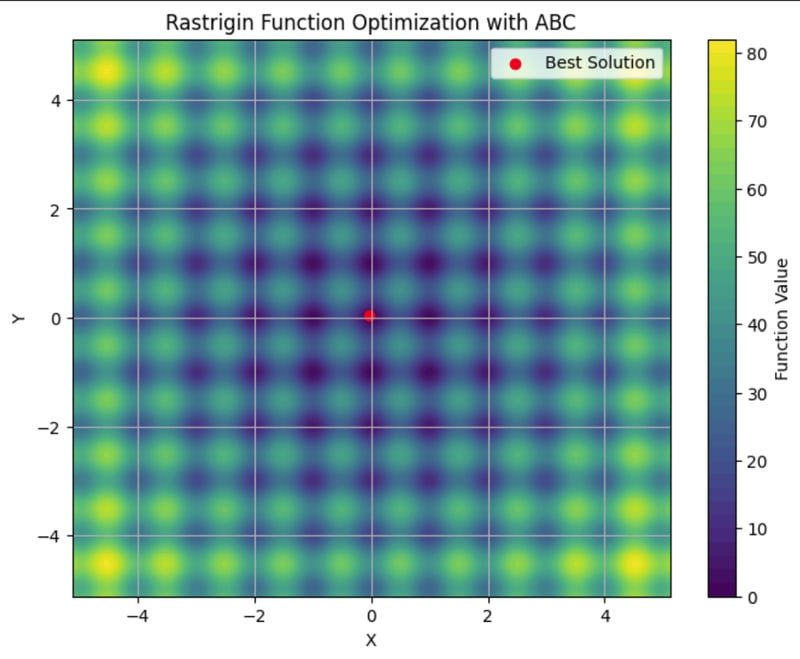
Qui puoi vedere la funzione di Rastrigin tracciata in un contour plot, con i suoi numerosi minimi locali. Il punto rosso è il minimo globale trovato dall’algoritmo ABC che abbiamo eseguito.
Applicazioni dell’artificial bee colony
L’algoritmo ABC è uno strumento robusto per risolvere problemi di ottimizzazione. La sua capacità di esplorare in modo efficiente spazi di ricerca ampi e complessi lo rende una scelta di riferimento per settori in cui adattabilità e scalabilità sono fondamentali.
Tra queste applicazioni rientrano:
- Telecomunicazioni: ABC può essere usato per ottimizzare il posizionamento di risorse di rete e antenne, massimizzando copertura e potenza del segnale e minimizzando i costi.
- Ingegneria: ABC può mettere a punto parametri nell’ottimizzazione strutturale.
- Data science: ABC può essere applicato alla selezione delle caratteristiche, per identificare le variabili più importanti in un dataset per il machine learning.
ABC è un algoritmo flessibile adatto a qualsiasi problema in cui occorra trovare soluzioni ottimali in ambienti dinamici e ad alta dimensionalità. La sua natura decentralizzata lo rende indicato per situazioni in cui altri algoritmi possono faticare a bilanciare in modo efficiente esplorazione e sfruttamento.
Confronto tra algoritmi di Swarm Intelligence
Esistono molteplici algoritmi di swarm intelligence, ciascuno con attributi diversi. Quando scegli quale usare, è importante valutarne punti di forza e debolezze per capire quale si adatta meglio alle tue esigenze.
ACO è efficace per problemi combinatori come instradamento e pianificazione, ma può richiedere risorse computazionali significative. PSO è più semplice ed eccelle nell’ottimizzazione continua, come la regolazione di iperparametri, ma può bloccarsi in ottimi locali. ABC bilancia con successo esplorazione e sfruttamento, sebbene richieda una taratura attenta.
Altri algoritmi di swarm intelligence, come il Firefly Algorithm e la Cuckoo Search Optimization, offrono anch’essi vantaggi unici per specifiche tipologie di problems.
|
Algorithm |
Strengths |
Weaknesses |
Preferred Libraries |
Best Applications |
|
Ant Colony Optimization (ACO) |
Effective for combinatorial problems and handles complex discrete spaces well |
Computationally intensive and requires fine-tuning |
Routing problems, scheduling, and resource allocation | |
|
Particle Swarm Optimization (PSO) |
Good for continuous optimization and simple and easy to implement |
Can converge to local optima and is less effective for discrete problems |
Hyperparameter tuning, engineering design, financial modeling | |
|
Artificial Bee Colony (ABC) |
Adaptable to large, dynamic problems and balanced exploration and exploitation |
Computationally intensive and requires careful parameter tuning |
Telecommunications, large-scale optimization, and high-dimensional spaces | |
|
Firefly Algorithm (FA) |
Excels in multimodal optimization and has strong global search ability |
Sensitive to parameter settings and slower convergence |
Image processing, engineering design, and multimodal optimization | |
|
Cuckoo Search (CS) |
Efficient for solving optimization problems and has strong exploration capabilities |
May converge prematurely and performance depends on tuning |
Scheduling, feature selection, and engineering applications |
Sfide e limitazioni
Gli algoritmi di swarm intelligence, come molte tecniche di machine learning, incontrano sfide che possono influenzarne le prestazioni. Tra queste:
- Convergenza prematura: lo sciame può stabilizzarsi troppo rapidamente su una soluzione subottimale.
- Taratura dei parametri: per ottenere risultati ottimali spesso è necessario regolare con attenzione le impostazioni dell’algoritmo.
- Risorse computazionali e scalabilità: questi algoritmi possono essere intensivi dal punto di vista computazionale, specialmente con problemi più grandi e complessi, e le loro prestazioni possono degradare all’aumentare della complessità del problema.
- Natura stocastica: la casualità intrinseca in questi algoritmi può portare a variabilità nei risultati.
Ricerche e progressi recenti
Una tendenza rilevante è l’integrazione della swarm intelligence con altre tecniche di machine learning. I ricercatori stanno esplorando come gli algoritmi a sciame possano migliorare compiti come la selezione delle caratteristiche e la ottimizzazione degli iperparametri. Dai un’occhiata a A hybrid particle swarm optimization algorithm for solving engineering problem.
I progressi recenti si concentrano anche sull’affrontare alcune sfide tradizionali associate alla swarm intelligence, come la convergenza prematura. Si stanno sviluppando nuovi algoritmi e tecniche per mitigare il rischio di convergere su soluzioni subottimali. Per saperne di più, vedi Memory-based approaches for eliminating premature convergence in particle swarm optimization
La scalabilità è un altro ambito di ricerca significativo. Con l’aumentare della complessità dei problemi e dei volumi di dati, i ricercatori stanno lavorando su modalità per rendere gli algoritmi di swarm intelligence più scalabili ed efficienti. Ciò include lo sviluppo di algoritmi in grado di gestire più efficacemente grandi dataset e spazi ad alta dimensionalità, ottimizzando al contempo le risorse computazionali per ridurre il tempo e i costi di esecuzione. Per approfondire, consulta Recent Developments in the Theory and Applicability of Swarm Search.
Gli algoritmi a sciame vengono applicati a problemi che vanno dalla robotica, ai large language models (LLM), alla diagnosi medica. È in corso una ricerca per capire se questi algoritmi possano aiutare gli LLM a dimenticare strategicamente informazioni per rispettare le normative sul diritto all’oblio. E, naturalmente, gli algoritmi a sciame hanno una moltitudine di applicazioni nella data science.
Conclusione
La swarm intelligence offre soluzioni potenti per problemi di ottimizzazione in vari settori. I suoi principi di decentralizzazione, feedback positivo e adattamento le permettono di affrontare compiti complessi e dinamici con cui gli algoritmi tradizionali possono avere difficoltà.
Dai un’occhiata a questa rassegna sullo stato attuale degli algoritmi a sciame, “Swarm intelligence: A survey of model classification and applications”.
Per approfondire le applicazioni di business dell’AI, dai un’occhiata a Artificial Intelligence (AI) Strategy o a Artificial Intelligence for Business Leaders. Per conoscere altri algoritmi che imitano la natura, vedi Genetic Algorithm: Complete Guide With Python Implementation.

Sono un PhD con 13 anni di esperienza nel lavoro con i dati in un contesto di ricerca biologica. Creo software in diversi linguaggi di programmazione, tra cui Python, MATLAB e R. Sono appassionato di condividere con il mondo il mio amore per l’apprendimento.





Immagina di osservare uno stormo di uccelli in volo. Non c’è un leader, nessuno che dia indicazioni, eppure virano e planano all’unisono in perfetta armonia. Può sembrare caos, ma c’è un ordine nascosto. Lo stesso schema si vede nei banchi di pesci che evitano i predatori o nelle formiche che trovano il percorso più breve verso il cibo. Questi animali si affidano a regole semplici e a comunicazioni locali per affrontare compiti sorprendentemente complessi senza un controllo centrale.
Questa è la magia della swarm intelligence.
Possiamo replicare questo comportamento usando algoritmi che risolvono problemi difficili imitando la swarm intelligence.
Che cos’è la Swarm Intelligence?
La swarm intelligence è un approccio computazionale che risolve problemi complessi imitando il comportamento decentralizzato e auto-organizzato osservato negli sciami naturali, come gli stormi di uccelli o le colonie di formiche.
Esploriamo due concetti chiave: decentralizzazione e feedback positivo.
Decentralizzazione ed emergenza
Al cuore della swarm intelligence c’è la decentralizzazione. Invece di fare affidamento su un leader centrale che diriga le azioni, ogni individuo, o "agente", opera in autonomia basandosi su informazioni locali e limitate.
Questo processo decisionale decentralizzato porta a un fenomeno emergente: un comportamento complesso e organizzato che nasce da interazioni semplici tra agenti. Nei sistemi a sciame, il risultato complessivo, o la soluzione, non è pre-programmato ma emerge naturalmente da queste azioni individuali.
Prendiamo le formiche come esempio. Durante il foraggiamento, una formica esplora casualmente l’ambiente finché non trova del cibo; a quel punto, depone una scia di feromoni tornando alla colonia. Altre formiche incontrano questa scia e hanno maggiori probabilità di seguirla, rinforzando il percorso se trovano cibo alla fine. Col tempo, i percorsi più corti o più efficienti attirano naturalmente più formiche, man mano che le scie più forti si concentrano su questi tragitti. Nessuna singola formica "conosce" la strada migliore fin dall’inizio, ma collettivamente, attraverso decisioni decentralizzate e il rinforzo dei percorsi di successo, la colonia converge verso la soluzione ottimale.
Questo diagramma mostra come regole semplici seguite dalle singole formiche portino a una soluzione ottimale per l’intera colonia.
Feedback positivo e adattamento
Il feedback positivo è un meccanismo dei sistemi di swarm intelligence in cui le azioni di successo vengono premiate e rinforzate. Ciò porta a un processo auto-amplificante, come l’irrobustimento delle scie di feromoni lungo i percorsi di foraggiamento più brevi. Questo rinforzo dei comportamenti vantaggiosi aiuta lo sciame a migliorare le sue prestazioni complessive nel tempo.
Nell’intelligenza artificiale, gli algoritmi di swarm intelligence imitano questo comportamento regolando fattori chiave, come probabilità o pesi, in base alla qualità delle soluzioni trovate. Man mano che si scoprono soluzioni migliori, gli agenti si concentrano sempre più su di esse, accelerando il processo di convergenza. Questo ciclo dinamico di feedback consente ai sistemi a sciame di adattarsi agli ambienti mutevoli e affinare le loro prestazioni.
Esistono diversi algoritmi di swarm intelligence che imitano differenti sistemi biologici. Vediamone alcuni tra i più popolari.
Ant Colony Optimization (ACO)
L’ant colony optimization (ACO) è un algoritmo ispirato al comportamento di foraggiamento delle formiche descritto sopra. È progettato per risolvere problemi di ottimizzazione combinatoria, in particolare quelli in cui dobbiamo trovare la migliore soluzione possibile tra molte. Un esempio classico è il problema del commesso viaggiatore, in cui l’obiettivo è determinare il percorso più breve che collega un insieme di località.
Come funziona l’ant colony optimization
In natura, le formiche comunicano lasciando scie di feromoni, che segnalano ad altre formiche il percorso verso una fonte di cibo. Più formiche seguono quella scia, più questa si rafforza. ACO imita questo comportamento con feromoni rappresentati da valori matematici memorizzati in una matrice di feromoni. Questa matrice tiene traccia della desiderabilità delle diverse soluzioni e viene aggiornata man mano che l’algoritmo procede.
In ACO, ogni "formica artificiale" rappresenta una potenziale soluzione al problema, come un percorso nel problema del commesso viaggiatore. L’algoritmo inizia con tutte le formiche che selezionano casualmente i percorsi, e i valori dei feromoni aiutano a guidare le formiche successive. Questi valori sono memorizzati in una matrice in cui ogni voce corrisponde al "livello di feromone" tra due punti (come città).
Questa rappresentazione matematica dei feromoni consente ad ACO di bilanciare efficacemente esplorazione e sfruttamento, esplorando ampi spazi di soluzioni senza bloccarsi in ottimi locali.
Implementazione in Python dell’ant colony optimization
Proviamo un esempio, usando ACO per risolvere un problema semplice: trovare il percorso più breve tra punti su un grafo.
Questa implementazione di ACO simula come "formiche" artificiali attraversano 20 nodi su un grafo per trovare il percorso più corto. Ogni formica parte da un nodo casuale e seleziona la mossa successiva in base alle scie di feromoni e alle distanze tra nodi. Dopo aver esplorato tutti i percorsi, le formiche tornano al punto di partenza, completando un ciclo.
Col tempo, i feromoni vengono aggiornati: i percorsi più brevi ricevono un rinforzo più forte, mentre gli altri evaporano. Questo processo dinamico consente all’algoritmo di convergere verso una soluzione ottimale.
Questo grafico mostra la soluzione finale, il percorso migliore trovato, per visitare ciascun nodo alla distanza più breve. In questa esecuzione, il percorso migliore è risultato essere [4, 5, 17, 9, 11, 16, 13, 2, 7, 3, 6, 1, 14, 12, 18, 0, 10, 19, 15, 8, 4], con una distanza totale di 129.
In questo grafico, si vede che la distanza percorsa attraversando i nodi diminuisce con le iterazioni. Questo dimostra che il modello migliora la lunghezza del viaggio nel tempo.
Applicazioni dell’ant colony optimization
L’adattabilità e l’efficienza di ACO lo rendono uno strumento potente in vari settori. Alcune applicazioni includono:
La forza di ACO risiede nella sua capacità di evolvere e adattarsi, rendendolo adatto ad ambienti dinamici in cui le condizioni possono cambiare, come l’instradamento del traffico in tempo reale o la pianificazione industriale.