
Corso
AI Security and Risk Management
2 ore
11.8K
Pratica and corso your progress.
Continua Con GoogleAI e ML sono di solito usati in modo intercambiabile. Ma se dovessi definirli e mostrarne rapidamente le differenze, direi che l’AI si riferisce alla tecnologia che costruisce macchine per imitare funzioni cognitive associate all’intelligenza umana, mentre l’ML è un sottoinsieme di algoritmi di AI che apprendono e migliorano dai dati.
In questo articolo voglio esplorare l’applicabilità delle tecniche di machine learning nella cybersecurity, mostrando una serie di casi d’uso e le sfide di spiegabilità, interpretabilità e robustezza che devono essere affrontate per sfruttarne il potenziale.
Threat detection and response indica il rilevamento di minacce informatiche contro reti o sistemi, seguito da strategie di mitigazione rapide ed efficaci. Questo processo coinvolge l’individuazione di comportamenti anomali all’interno di reti e sistemi, l’identificazione di intrusioni non autorizzate e l’analisi di campioni di malware per proteggere i nostri sistemi.
Rilevare anomalie significa identificare pattern nei dati che non si conformano a una nozione ben definita di comportamento normale.
Questo concetto fondamentale trova applicazione in campi diversi, e la cybersecurity non fa eccezione. Uso il rilevamento delle anomalie per individuare svariate attività malevole come esfiltrazione di dati, attacchi Distributed Denial of Service (DDoS), infezioni da malware e altro.Vari algoritmi di machine learning, come Local Outlier Factor (LOF), Isolation Forest, One-Class Support Vector Machine (OC-SVM), sono stati impiegati per rilevare anomalie. Tuttavia, scegliere la tecnica appropriata per identificare gli outlier è un compito complesso che richiede un’attenta considerazione di diversi fattori, tra cui:
Esploreremo come selezioniamo le giuste tecniche di machine learning e spiegheremo anche come rilevano attività malevole di cybersecurity. Ci concentreremo su due applicazioni critiche: intrusion detection e analisi dei malware.
Gli intrusion detection system (IDS) sono gli occhi e le orecchie delle reti e dei sistemi, monitorando e analizzando il traffico di rete (IDS basati sulla rete) e le system call (IDS basati sull’host) per attività malevole.
Nel corso dei miei esperimenti, ho visto la potenza degli approcci di anomaly detection in entrambi i sistemi nel rilevare la presenza di minacce nuove o precedentemente sconosciute che eludono le tecniche basate su firme, le quali si affidano a pattern di attacco predefiniti per il rilevamento.
Prima di addentrarci negli IDS basati sull’host, è importante capire cosa sono le system call. Sono essenzialmente richieste effettuate da un programma al sistema operativo per svolgere compiti specifici. Supponi di usare un editor di testo per modificare un file su un sistema Linux. Dietro le quinte, il tuo editor richiede di aprire un file usando la system call open(), scrivere le modifiche con write() e poi salvarlo chiudendo il file con close().
Mentre le system call di un editor di testo sono lineari e prevedibili, la sequenza di system call di un attore malevolo è spesso ingannevole. Un programma malevolo potrebbe usare una serie come open(), write() per depositare un file nascosto, poi usare execve() per eseguirlo con privilegi elevati. Questo è seguito da chiamate relative alla rete come socket() per potenzialmente stabilire un canale di command-and-control.
Per affrontare questo problema, le sequenze di system call vengono spesso trasformate in una rappresentazione di feature statica adatta agli algoritmi di machine learning. Ma ti starai chiedendo: quale tecnica di apprendimento è più adatta per addestrare i modelli in questo caso?
La scelta della tecnica dipende molto dalla disponibilità di etichette. Se è accessibile un dataset bilanciato composto da sequenze di system call sia normali che anomale, opterei sicuramente per modelli di anomaly detection supervisionati come le Support Vector Machines (SVM).
Al contrario, in assenza di dati etichettati, posso usare modelli di apprendimento non supervisionato come Isolation Forest. Per scenari in cui nel training sono presenti solo comportamenti normali, ricorro a tecniche semi-supervisionate come One-Class SVM o DBSCAN.
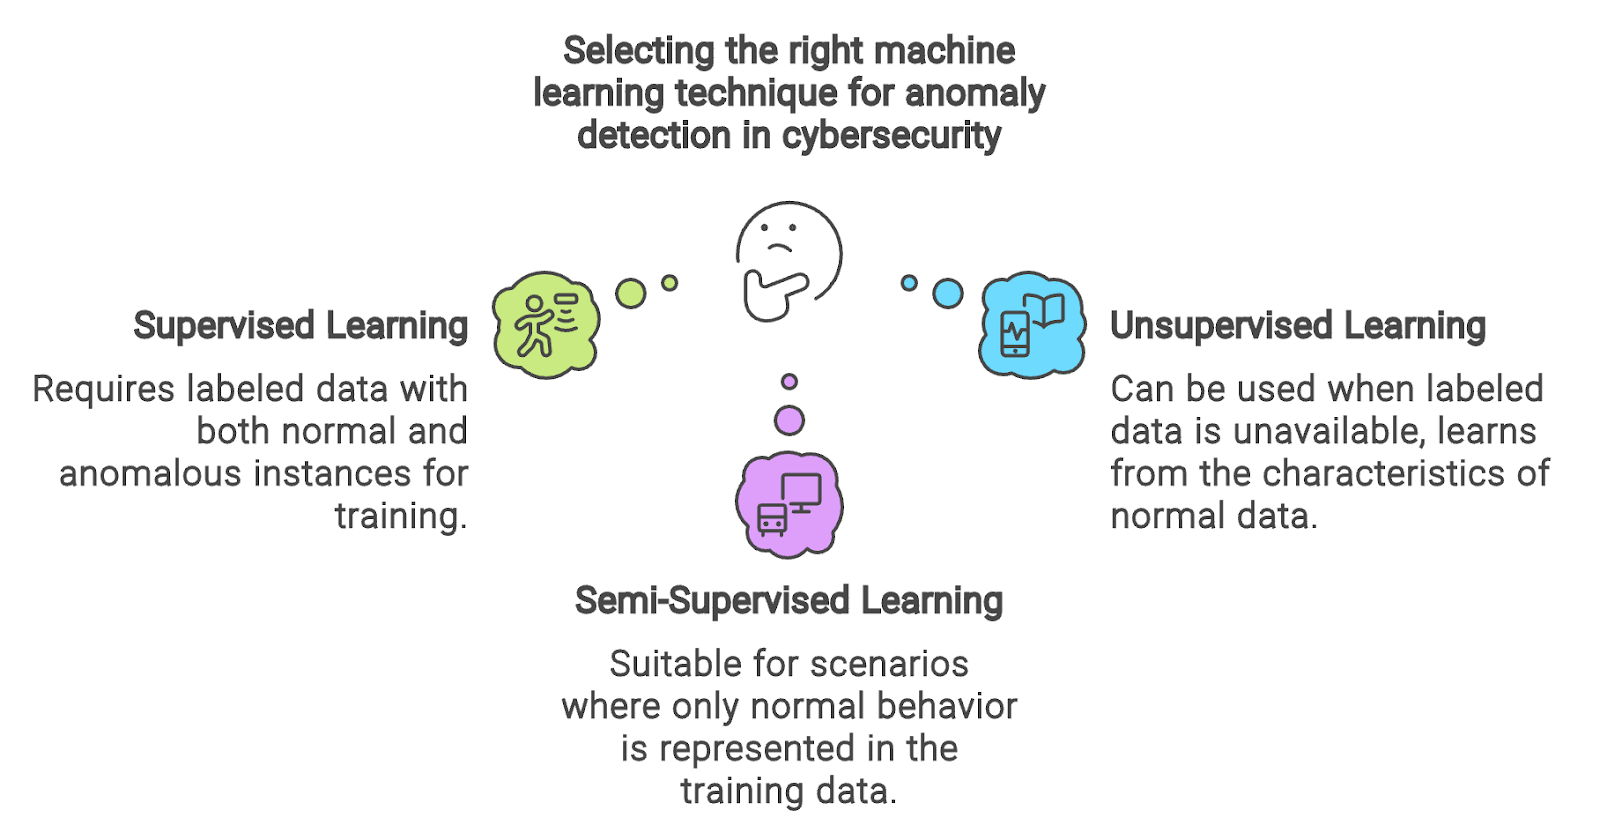
Diagramma creato con Napkin.ai
Ora che abbiamo capito come l’ML si applica agli IDS basati sull’host, passiamo al mondo degli IDS basati sulla rete. Mentre i sistemi host-based si concentrano sulle singole macchine, gli IDS di rete individuano intrusioni nei dati di rete; cioè, invece di analizzare le system call, gli IDS di rete ispezionano furti di informazioni e attività di interruzione della rete monitorando statistiche di flusso, dati di payload e intestazioni dei pacchetti.
Un rapido sguardo alla tabella seguente può aiutarti a capire com’è un dataset di flussi di rete.
|
Porta di destinazione |
Porta di origine |
Durata del flusso (ms) |
Totale pacchetti in invio |
Totale pacchetti in ritorno |
Etichetta |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Statistiche sintetiche di flusso di rete normali e anomale.
Ogni riga del dataset rappresenta una sessione di comunicazione di rete indipendente tra due endpoint, senza relazioni intrinseche con gli altri flussi nel dataset.
Ogni flusso è definito da attributi come i numeri di porta di origine e destinazione, la durata del flusso in millisecondi e il numero totale di pacchetti scambiati in entrambe le direzioni. Un’etichetta categoriale indica se il flusso è classificato come anomalo o come attacco, fornendo ground truth essenziale per i modelli di intrusion detection.
In particolare, ogni riga rappresenta un flusso indipendente senza dipendenze sequenziali o relazionali con altri flussi nel dataset.
Data la natura indipendente dei flussi di rete, il dataset può essere fornito dopo alcune tecniche di feature engineering agli algoritmi di machine learning per il rilevamento delle anomalie. Come discusso in precedenza nel contesto degli IDS host-based, la scelta delle tecniche adatte dipende dalla disponibilità di dati etichettati.
Prima di arrivare all’analisi dei malware, dobbiamo prima spiegare cosa sono i malware e come operano.
Malware è un termine per indicare software malevoli o eseguibili binari progettati per portare a termine le intenzioni dannose di un attaccante. Questo pezzo di codice sfrutta intenzionalmente vulnerabilità nei sistemi target per comprometterne l’integrità, rubare dati sensibili, cancellare dati e persino cifrarli per un riscatto. Può rientrare in molte categorie, tra cui virus, worm, spyware, trojan, ransomware, ecc.
Per comprendere il tipo di malware, la sua funzionalità e il suo potenziale impatto, vengono estratte diverse feature da analisi statiche e dinamiche e fornite ad appropriati algoritmi di machine learning.
Considera l’analisi di eseguibili Windows, cioè i Portable Executable (PE). Possiamo estrarre diverse feature sia dall’analisi dinamica che statica dei PE, come sequenze di byte, API/system call, opcode, rete, file system, registri CPU, caratteristiche dei file PE e stringhe, per poi alimentarle in modelli di machine learning supervisionati, non supervisionati e semi-supervisionati adatti a rilevare malware.
Per mitigare i rischi di esposizione ad attacchi informatici, dobbiamo identificare, valutare e affrontare rapidamente le potenziali debolezze di sicurezza nelle nostre reti, nei computer e nelle applicazioni. Vediamo il ruolo svolto da algoritmi di AI e ML nel migliorare il vulnerability management attraverso vulnerability scanning, patch management e risk assessment.
Come ricercatore in cybersecurity, sviluppo spesso strumenti personalizzati per automatizzare attività come parser dei log del traffico di rete, fuzzer e altro.
Sebbene questi strumenti possano migliorare significativamente le nostre operazioni di sicurezza, è importante sottoporli a rigorose scansioni di vulnerabilità prima di usarli e condividerli con i miei colleghi.
Altrimenti, un attaccante può sfruttare vulnerabilità scoperte e non patchate nel mio script personalizzato per ottenere accessi non autorizzati, compromettere informazioni sensibili o interrompere servizi nella nostra azienda.
I modelli di machine learning sanno vedere il quadro d’insieme. Eccellono nell’estrarre feature significative da grandi dataset scoprendo pattern e correlazioni sottili. Tenendo questo a mente, ho iniziato a esplorarli per vedere se sono in grado di automatizzare il rilevamento delle vulnerabilità, velocizzare l’analisi e identificare vulnerabilità non divulgate in precedenza.
Per costruire un modello ML di rilevamento delle vulnerabilità, inizio raccogliendo vari tipi di dati vulnerabili e non vulnerabili per addestrare il modello da diverse fonti, tra cui NVD (National Vulnerability Database), OWASP, ecc.
La raccolta viene poi preprocessata ed embeddizzata per essere fornita al modello scelto. L’input potrebbe essere rappresentato come un grafo o un albero che mostra le relazioni tra diversi elementi di codice, come il Code Property Graph (CPG) o gli Abstract Syntax Trees (AST).
L’input può anche avere una rappresentazione basata su token, in cui il codice sorgente è trasformato in vettori di token. Possono poi essere applicate varie tecniche di embedding, tra cui Word2Vec, graph embedding, one-hot embedding, feature n-gram, ecc.
Come spiegato nelle applicazioni precedenti, la scelta di un modello di machine learning e della sua tecnica di apprendimento dipende principalmente dalla disponibilità di etichette. In fase di training, il dataset per il rilevamento delle vulnerabilità è separato in set di addestramento e di validazione, e il modello apprende dai dati etichettati.
I parametri del modello vengono aggiornati iterativamente in base agli errori di previsione usando tecniche di ottimizzazione. Dopo che il modello completa il suo processo di apprendimento, la sua capacità di rilevare vulnerabilità viene misurata su dati mai visti. Indicatori chiave come accuratezza, precisione, recall e F1 score sono calcolati per valutarne le prestazioni.
Una volta rilevate vulnerabilità nel mio script personalizzato, è essenziale una valutazione del rischio completa. Se i controlli di sicurezza esistenti impediscono lo sfruttamento delle vulnerabilità scoperte o le potenziali conseguenze sono minime, il rischio potrebbe essere accettato.
In alternativa, si potrebbe considerare di evitare del tutto l’uso del codice sviluppato per eliminare qualsiasi rischio di sfruttamento. Tuttavia, se l’eliminazione completa non è praticabile, è fondamentale implementare strategie di mitigazione.
Successivamente, esploreremo il patching del software vulnerabile come tattica primaria di mitigazione.
Sebbene affrontare tutte le vulnerabilità aperte e critiche sia l’ideale, spesso non è praticabile. Serve un approccio più strategico. Usando il machine learning, possiamo prevedere proattivamente quali vulnerabilità hanno maggiori probabilità di essere sfruttate e causare incidenti di sicurezza. Questo ci consente di dare priorità alle attività di patching.
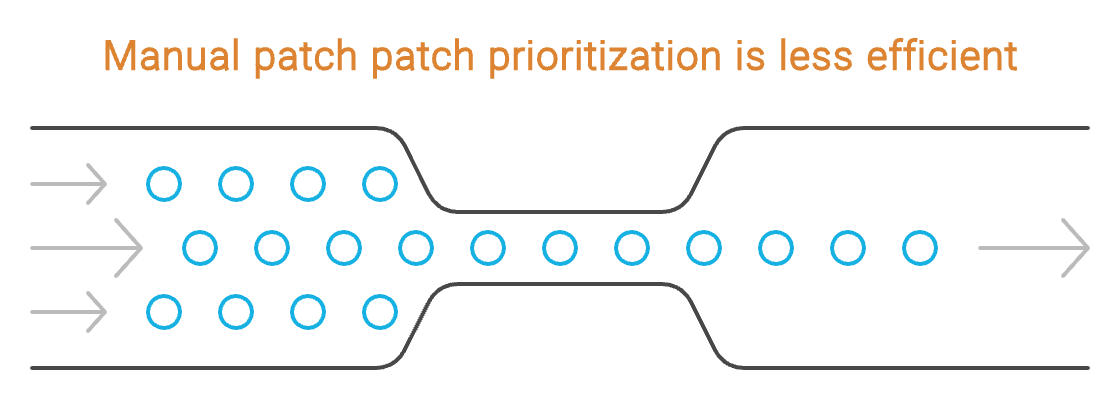
Creato con Napkin.ai
Per snellire il nostro processo di prioritizzazione delle patch, utilizziamo il modello pre-addestrato tree-based Exploit Prediction Scoring System (EPSS) che combina informazioni sulle vulnerabilità con attività di exploit reali per prevedere la probabilità che gli attaccanti tenteranno di usare una vulnerabilità specifica nei successivi trenta giorni.
Il modello di machine learning EPSS identifica pattern e relazioni tra informazioni sulle vulnerabilità, come il CVSS, e l’attività di exploit per identificare matematicamente la probabilità che gli attaccanti sfruttino una vulnerabilità.
Dopo la prioritizzazione delle vulnerabilità, le patch vengono sottoposte a rigorose fasi di acquisizione, validazione e test per mitigare i rischi operativi. Il deployment delle patch è un processo complesso che dipende da diversi fattori, tra cui:
Data la scala e la diversità degli ambienti IT moderni, il deployment manuale delle patch è spesso laborioso e dispendioso in termini di tempo. L’automazione guidata dall’AI può semplificare questo processo selezionando e distribuendo in modo intelligente la patch appropriata a ciascun sistema in base a questi fattori critici.
Algoritmi di clustering, come K-means, possono essere sfruttati in questo caso per raggruppare sistemi simili e rendere il deployment delle patch più efficiente.
La valutazione del cyber-rischio è importante per identificare, valutare e mitigare potenziali minacce e vulnerabilità rilevate.
Poiché gli approcci tradizionali spesso non riescono a individuare indicatori di rischi informatici imprevedibili, i ricercatori hanno iniziato a rivolgersi al machine learning.
Usando ML supervisionato e classificazione multiclasse, i ricercatori possono migliorare la valutazione del cyber-rischio tramite un’analisi completa dei fattori chiave.
Come illustrato nella tabella sottostante, questi fattori includono investimenti in cybersecurity, caratteristiche della forza lavoro, storia degli attacchi, vulnerabilità dell’infrastruttura, consulenza esterna e rischio associato. Il loro framework ML proof-of-concept SecRiskAI dimostra il potenziale dell’ML nel prevedere la probabilità di attacchi DDoS o phishing.
|
Informazione |
Esempio |
|
Ricavi |
2.500.000 |
|
Investimento in cybersecurity |
500.000 |
|
Attacchi riusciti |
5 |
|
Attacchi falliti |
10 |
|
Numero di dipendenti |
4.450 |
|
Formazione dei dipendenti |
Media |
|
Vulnerabilità note |
9 |
|
Consulente esterno di cybersecurity |
No |
|
Rischio |
Basso |
Un esempio di attributi chiave per la valutazione del cyber-rischio (Fonte)
Vediamo ora come AI e ML stanno cambiando l’incident response. Esploreremo come automatizzano i workflow di risposta agli incidenti, riducono i tempi di risposta, scoprono proattivamente minacce nascoste e migliorano l’analisi forense per tracciare origini e impatto degli attacchi informatici.
Ho osservato in prima persona come i sistemi SOAR siano progettati per ricevere alert dai sistemi di Security Information and Event Management (SIEM) e attivare playbook appropriati che automatizzano e coordinano una serie di attività di sicurezza.
Queste attività possono includere azioni investigative, come il controllo della reputazione degli URL o il recupero dei dettagli di utenti e asset, nonché azioni di risposta, come bloccare un indirizzo IP su un firewall o terminare un processo malevolo su un endpoint.
Tuttavia, al momento affrontiamo limitazioni significative in questi sistemi. Gli analisti di sicurezza devono definire, creare e modificare manualmente i playbook, e la selezione tra più playbook è governata da regole impostate dagli analisti.
Per superare queste limitazioni, ho visto come l’integrazione di AI e ML nelle piattaforme SOC possa rivoluzionare questo processo, permettendoci di generare automaticamente playbook che possano
rispondere ad alert sconosciuti.
Questo non solo aumenta l’efficienza della nostra risposta, ma permette anche agli analisti di concentrarsi su più attività. Usando algoritmi di ML, possiamo anche addestrare il sistema a calcolare il costo di penalità di ogni azione di risposta in base all’alert ricevuto e selezionare la risposta con la penalità più bassa.
Immagina quanto sarebbe stressante setacciare milioni di log cercando di identificare potenziali minacce.
Ora, amplifica la sfida alla scala di un’azienda, dove ogni singolo log deve essere esaminato uno per uno e classificato come malevolo o benigno.
Incorporando il machine learning nel processo, possiamo semplificare questo compito e accelerare il rilevamento delle minacce. Algoritmi di AI e ML, ad es. SVM, Random Forest, possono essere addestrati per analizzare e categorizzare i log in modo efficiente, consentendo un’identificazione rapida delle minacce e riducendo il carico sui team di sicurezza.
Man mano che i dati digitali crescono in volume e complessità, integrare AI e ML nella digital forensics—l’analisi delle prove digitali per indagare sui crimini informatici—è diventato essenziale.
Questa integrazione ci consente di migliorare velocità, accuratezza ed efficacia nell’identificazione e nella risposta alle minacce.
AI e ML possono essere usati nel triage forense, per esempio. In questo caso, usiamo algoritmi di ML per classificare e categorizzare grandi quantità di file digitali in base alla loro rilevanza per un’indagine.
L’integrazione dell’AI nella cybersecurity presenta opportunità significative. Tuttavia, è importante riconoscerne anche le sfide e i limiti intrinseci.
Molti sistemi di AI sono suscettibili ad attacchi adversarial, cioè poisoning, evasion, model extraction, prompt injection e inference, che ne sfruttano le vulnerabilità.
In questi attacchi, gli avversari aggiungono con cura perturbazioni all’input, impercettibili agli esseri umani ma in grado di indurre i modelli a fare previsioni errate. Questo solleva preoccupazioni sulla sicurezza del deployment di tali sistemi in ambienti critici, e la cybersecurity non fa eccezione.
Per contrastare efficacemente questi attacchi, impieghiamo vari meccanismi difensivi come l’adversarial training, la distillazione difensiva e il gradient masking.
Sebbene gli algoritmi di AI dimostrino efficacia nel raggiungere risultati e previsioni, faccio fatica a comprendere i loro meccanismi interni.
Questo è molto importante nel mio campo, poiché affidare scelte critiche a un sistema non spiegabile comporta rischi evidenti.
Qui, l’Explainable AI (XAI) offre una strada per sviluppare sistemi di cybersecurity basati su AI con maggiore spiegabilità mantenendo alte prestazioni. Fornendo trasparenza nel decision making dell’AI, l’XAI mi aiuta a fare analisi informate e a prendere le azioni più appropriate in risposta agli incidenti di sicurezza.
I recenti progressi nelle tecniche XAI, ossia analisi dell’importanza delle feature e visualizzazione degli alberi decisionali, stanno rendendo questa trasparenza raggiungibile.
Ogni volta che seleziono un dataset per addestrare le mie soluzioni di cybersecurity basate su AI, mi assicuro che non sia distorto. Altrimenti, i modelli sviluppati potrebbero produrre output ingiusti o discriminatori. Impiego tecniche di preprocessing dei dati per identificare e rimuovere i bias presenti nei dati di training e applico tecniche di fairness per valutare l’output del modello alla ricerca di potenziali bias.
Se sei arrivato fin qui, hai visto come AI e ML stanno cambiando il modo in cui proteggiamo computer, dispositivi mobili, reti e applicazioni. Hai visto come potenziano i team di sicurezza, rilevano più rapidamente le minacce e rafforzano vari strumenti di cybersecurity.
E la cosa entusiasmante è questa: penso che siamo solo all’inizio.
Il futuro della cybersecurity risiede nella continua evoluzione di AI e ML, in particolare dei large language model (LLM). Grazie al maggiore limite di token, alla capacità di interpretazione del codice e all’analisi dettagliata, questi modelli avanzati miglioreranno la nostra capacità di analizzare e rispondere alle minacce, scalando l’analisi dei malware con maggiore velocità e accuratezza.
Considera il caso del modello Gemini 1.5 che viene attualmente usato per rilevare malware in file enormi. Pur senza un training specifico in cybersecurity, può risolvere compiti pertinenti tramite prompt engineering, in-context learning e chain-of-thought.
Stiamo anche intravedendo quel futuro tramite il fine-tuning di LLM a pesi aperti, tra cui Llama, per attività legate alla cybersecurity come Hackmentor.
In questo blog, abbiamo esaminato come gli strumenti di cybersecurity basati su AI e ML siano utili per affrontare la natura dinamica e complessa delle minacce informatiche moderne. Questi strumenti sono efficaci nel rilevare, rispondere e mitigare i rischi attraverso applicazioni mirate nel rilevamento delle minacce, nel vulnerability management e nell’incident response.
Tuttavia, dobbiamo anche considerare le sfide significative e le implicazioni etiche associate allo sviluppo e al deployment di soluzioni di cybersecurity basate su AI.
Nonostante queste sfide, il continuo avanzamento delle tecnologie AI e ML promette molto bene per rafforzare le nostre difese contro le minacce informatiche in evoluzione.
Approfondisci la sicurezza dei dati!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



