Hadoop e Spark sono due dei framework più importanti nel mondo dei big data, ma gestiscono l’elaborazione di dati su larga scala in modi molto diversi. Se da un lato a Hadoop va il merito di aver reso accessibile il paradigma del calcolo distribuito grazie a un solido sistema di archiviazione chiamato HDFS e a un modello computazionale chiamato MapReduce, Spark sta cambiando le carte in tavola con la sua architettura in-memory e un modello di programmazione flessibile.
Questo tutorial analizza in profondità le differenze tra Hadoop e Spark, incluse architettura, prestazioni, considerazioni sui costi e integrazioni. Alla fine avrai una chiara comprensione dei pro e contro di ciascuno e dei tipi di casi d’uso in cui ogni framework eccelle; questa comprensione ti aiuterà a prendere decisioni strategiche mentre costruisci le tue soluzioni big data.
Capire Hadoop e Spark
Prima di entrare nei dettagli, vediamo i concetti fondamentali e le origini di Hadoop e Spark, per capire come questi potenti framework affrontano le sfide dei big data.
Che cos’è Hadoop?
Hadoop è un framework open-source progettato per archiviare ed elaborare grandi dataset su cluster di computer. Dal 2006, Hadoop ha permesso alle organizzazioni di gestire volumi di dati enormi che metterebbero in crisi una singola macchina. Distribuendo i dati su più nodi, non solo migliora la capacità di elaborazione, ma offre anche ridondanza, garantendo l’affidabilità del sistema anche in caso di guasti di singole macchine.
I componenti chiave del framework Hadoop includono:
- Hadoop Distributed File System (HDFS): funge da base di archiviazione, suddividendo i file in blocchi e distribuendoli nel cluster.
- MapReduce: gestisce l’elaborazione suddividendo i compiti computazionali in unità più piccole che vengono eseguite in parallelo nel cluster.
- YARN (Yet Another Resource Negotiator): gestisce in modo efficiente le risorse allocando potenza di calcolo e pianificando i task tra le macchine disponibili.
Uno dei principali vantaggi di Hadoop è la convenienza economica: consente alle organizzazioni di usare hardware standard e a basso costo, invece di costose apparecchiature specializzate. Questo approccio pratico si riflette anche nella sua filosofia di elaborazione.
Il design orientato ai batch di Hadoop eccelle in scenari in cui conta più il throughput complessivo che la velocità pura, risultando particolarmente utile per l’analisi di dati storici e le operazioni ETL (Extract, Transform, Load) complesse che non richiedono risultati immediati.
Che cos’è Apache Spark?
Apache Spark è nato nel 2010 come risposta ai limiti dell’approccio di Hadoop all’elaborazione dei big data. Sviluppato inizialmente alla UC Berkeley prima di diventare un progetto Apache, Spark ha affrontato la forte dipendenza di Hadoop MapReduce dalle operazioni su disco. La sua innovazione decisiva è stata l’implementazione del calcolo in-memory, che riduce drasticamente i tempi di elaborazione per molti carichi di lavoro, minimizzando la necessità di leggere e scrivere su disco.
Spark offre una piattaforma unificata con diversi componenti strettamente integrati attorno al suo motore di elaborazione principale:
- Spark SQL: per lavorare con dati strutturati
- MLlib: per implementare algoritmi di machine learning
- GraphX: per l’elaborazione di dati a grafo
- Spark Streaming: per analizzare dati in tempo reale
Questo design coerente consente ai team di affrontare diverse sfide sui dati usando un unico framework, invece di destreggiarsi tra più strumenti specializzati.
Nonostante le differenze, Spark e Hadoop spesso lavorano insieme come tecnologie complementari, più che come concorrenti. Poiché Spark non include un proprio sistema di archiviazione, si affida comunemente a HDFS di Hadoop per l’archiviazione persistente dei dati.
Inoltre, Spark può operare sul gestore di risorse YARN di Hadoop, rendendo semplice per le organizzazioni potenziare gli ambienti Hadoop esistenti con la potenza di elaborazione di Spark. Questa compatibilità crea un percorso di aggiornamento pratico che consente alle aziende di adottare i vantaggi di Spark senza abbandonare gli investimenti nell’infrastruttura Hadoop.
Confronto delle prestazioni tra Hadoop e Spark
Quando si valutano i framework big data, le prestazioni diventano spesso un fattore decisivo per le organizzazioni con esigenze di elaborazione sensibili al tempo.
Velocità di elaborazione
Il MapReduce di Hadoop opera come un sistema di elaborazione basato su disco: legge i dati dal disco, li elabora e scrive i risultati nuovamente su disco tra ogni fase di calcolo. Questo I/O su disco crea una latenza significativa, soprattutto per gli algoritmi iterativi che richiedono più passaggi sugli stessi dati.
Pur essendo efficace per l’elaborazione batch di dataset enormi, questo approccio sacrifica la velocità a favore dell’affidabilità e del throughput.
Spark, al contrario, esegue le computazioni principalmente in memoria, riducendo drasticamente la necessità di operazioni su disco. Per molti carichi di lavoro, in particolare per gli algoritmi iterativi come quelli usati nel machine learning, Spark può eseguire i task fino a 100 volte più velocemente di Hadoop MapReduce.
Questo vantaggio prestazionale diventa particolarmente evidente quando l’elaborazione deve avvenire in quasi tempo reale o quando gli algoritmi richiedono più passaggi sullo stesso dataset.
Utilizzo della memoria
Il design di Hadoop presuppone una disponibilità limitata di memoria, risultando efficiente in termini di RAM ma più lento. Si affida fortemente allo storage su disco, il che gli consente di elaborare dataset molto più grandi della RAM disponibile, scambiando costantemente dati tra memoria e disco.
Questo approccio rende Hadoop adatto a elaborare dataset estremamente grandi su cluster con risorse di memoria limitate.
I vantaggi prestazionali di Spark derivano dal suo uso aggressivo della memoria. Memorizzando nella RAM i dati tra le varie fasi di elaborazione, Spark elimina le costose operazioni su disco. Tuttavia, questo richiede risorse di memoria sufficienti per contenere i dataset di lavoro.
Quando sorgono vincoli di memoria, il vantaggio di Spark si riduce poiché inizia a riversare i dati su disco; ciononostante, la sua gestione intelligente della memoria in genere supera ancora l’approccio “disk-first” di Hadoop.
Considerazioni sulle prestazioni nel mondo reale
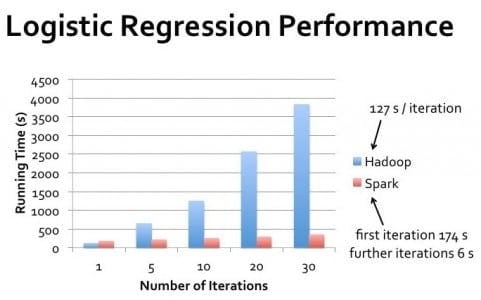
Il divario di prestazioni tra Hadoop e Spark nel mondo reale varia notevolmente in base ai casi d’uso specifici. Per l’elaborazione batch a singolo passaggio di dataset enormi, in cui i dati superano ampiamente la memoria disponibile, le prestazioni di Hadoop possono avvicinarsi a quelle di Spark.
Tuttavia, per l’elaborazione iterativa, le query interattive e lo stream processing, Spark offre costantemente prestazioni superiori.
Vale la pena notare che le prestazioni non riguardano solo la velocità pura. Hadoop eccelle in scenari che richiedono un’elevata tolleranza ai guasti e in cui l’elaborazione può avvenire in finestre batch ben definite.
Spark dà il meglio quando servono risultati rapidi, come nell’esplorazione interattiva dei dati, nelle analisi in tempo reale e nelle applicazioni di machine learning, in cui gli algoritmi effettuano più passaggi sui dataset.
Gestione del cluster: cluster Hadoop vs cluster Spark
Sia Hadoop che Spark si basano su cluster per elaborare in modo efficiente grandi volumi di dati, ma gestiscono queste risorse in modo diverso, con impatti su prestazioni e amministrazione.
Cos’è il clustering e perché serve
Un cluster è un insieme di computer interconnessi (nodi) che lavorano insieme come un unico sistema. Nell’elaborazione dei big data, il clustering diventa necessario quando i volumi di dati superano ciò che una singola macchina può gestire in modo efficiente. Distribuendo i carichi di lavoro computazionali su più macchine, i cluster permettono di elaborare petabyte di dati altrimenti ingestibili.
Il clustering offre anche tolleranza ai guasti e alta disponibilità. Se una macchina si guasta, le altre nel cluster possono subentrarne al carico, garantendo la continuità operativa. Questa resilienza è cruciale in ambienti di produzione in cui i tempi di inattività possono essere costosi.
Inoltre, il clustering consente lo scaling orizzontale — aggiungere più macchine per aumentare la potenza di elaborazione — spesso più conveniente rispetto all’upgrade dei singoli sistemi.
Per chi aspira a lavorare in questo campo, comprendere il clustering è una competenza fondamentale nell’ ingegneria dei dati.
Architettura di un cluster Hadoop
I cluster Hadoop seguono un’architettura master-slave con ruoli specializzati per nodi diversi. Il NameNode funge da master per HDFS, mantenendo i metadati su posizioni e permessi dei file. I DataNode archiviano i blocchi di dati reali e riportano lo stato al NameNode.
Per l’elaborazione, il ResourceManager alloca le risorse del cluster, mentre i NodeManager sulle singole macchine eseguono i task.
HDFS replica i dati su più DataNode, mantenendo in genere tre copie di ogni blocco. Questa strategia assicura la disponibilità dei dati anche in caso di guasti ai singoli nodi, sebbene richieda capacità di storage aggiuntiva.
Il design del cluster Hadoop enfatizza la località dei dati, cercando di pianificare i task computazionali sugli stessi nodi in cui risiedono i dati, per minimizzare i trasferimenti di rete.
L’amministrazione dei cluster Hadoop ha tradizionalmente richiesto competenze significative (i professionisti spesso si preparano con domande di colloquio su Hadoop per dimostrare questa conoscenza), anche se le distribuzioni moderne includono strumenti di gestione per semplificare configurazione e monitoraggio.
Scalare un cluster Hadoop comporta l’aggiunta di nuovi nodi e il ribilanciamento dei dati sull’infrastruttura ampliata, un processo che può essere manuale e richiedere un’attenta pianificazione.
Architettura di un cluster Spark
Spark può operare in varie configurazioni di cluster, tra cui modalità standalone, su Hadoop YARN, Apache Mesos o Kubernetes. In tutte le distribuzioni, Spark segue un modello driver-executor. Il programma driver contiene la funzione principale dell’applicazione e crea uno SparkContext che coordina con il cluster manager per allocare le risorse.
Una volta allocate le risorse, gli executor di Spark vengono avviati sui nodi worker. Questi executor sono processi JVM che eseguono i task e archiviano i dati in memoria o su disco. A differenza di Hadoop, che mantiene una presenza persistente sui nodi del cluster, gli executor di Spark possono essere allocati e rilasciati dinamicamente in base alle esigenze dell’applicazione, migliorando potenzialmente l’utilizzo delle risorse.
Chi è interessato può approfondire le funzionalità di Spark con tutorial pratici come Apache Spark per il Machine Learning.
Spark non include un proprio sistema di archiviazione distribuita, ma sfrutta soluzioni esistenti come HDFS, Amazon S3 o altri sistemi compatibili. Questa separazione tra calcolo e storage offre flessibilità, ma richiede una configurazione accurata per garantire pattern di accesso ai dati ottimali.
Strumenti come Spark SQL e sparklyr offrono modi comodi per interagire con questa architettura.
Differenze chiave nella gestione del cluster
L’approccio di Hadoop alla gestione del cluster è più incentrato sull’infrastruttura, con un’allocazione delle risorse relativamente statica e un focus sulla località dei dati. Questo design funziona bene per job batch di lunga durata su cluster stabili in cui i nodi cambiano raramente.
Tuttavia, può essere meno reattivo a carichi di lavoro variabili e richiede più interventi manuali in fase di scalabilità.
Spark offre una gestione delle risorse più dinamica, soprattutto quando gira su piattaforme di orchestrazione moderne come Kubernetes. Può regolare l’allocazione delle risorse in base alla domanda corrente e rilasciarle quando non servono.
Questa elasticità è preziosa per le organizzazioni con carichi di lavoro fluttuanti o infrastrutture condivise che servono più applicazioni.
Capire queste differenze è cruciale per i professionisti che puntano a una certificazione da Data Engineer o si preparano per domande di colloquio su Spark.
Per le organizzazioni che stanno iniziando con i big data, le opzioni di deployment più flessibili di Spark e il suo modello di programmazione più semplice spesso rendono più facile partire.
Tuttavia, in ambienti con volumi di dati estremamente grandi in cui la gestione dello storage è la preoccupazione principale, l’ecosistema maturo di HDFS offre ancora vantaggi che completano le capacità di elaborazione di Spark. Per un confronto tra Spark e altre tecnologie di streaming, potrebbe essere utile una comparazione come Flink vs. Spark.
Hadoop MapReduce vs modello di elaborazione di Spark
Sebbene le sezioni precedenti abbiano discusso le implicazioni sulle prestazioni, comprendere i modelli di elaborazione fondamentali di ciascun framework aiuta a spiegare perché sono progettati in modo così diverso.
Framework Hadoop MapReduce
MapReduce segue un paradigma di programmazione rigido con due fasi principali: map e reduce. La fase di map applica una funzione a ciascun record in parallelo, generando coppie chiave-valore intermedie.
Queste coppie attraversano una fase obbligatoria di shuffle e sort, in cui i dati con le stesse chiavi vengono raggruppati.
Infine, la fase di reduce aggrega questi valori raggruppati per produrre gli output finali. Questo approccio strutturato implica che le operazioni complesse richiedono la concatenazione di più job MapReduce.
Sviluppare applicazioni MapReduce in genere comporta la scrittura di codice di basso livello che definisce esplicitamente le funzioni di mapping e reducing.
Sebbene framework come Apache Pig e Apache Hive forniscano astrazioni di livello superiore, l’esecuzione sottostante segue comunque il rigido pattern MapReduce, che impone limitazioni sulla progettazione degli algoritmi e sulle opportunità di ottimizzazione.
Il modello di elaborazione dei dati di Spark
Spark ha introdotto i Resilient Distributed Datasets (RDD) come astrazione di base — collezioni immutabili e partizionate che tracciano la propria genealogia per il ripristino. A differenza di MapReduce, Spark non impone un pattern di elaborazione rigido, ma offre due tipi di operazioni: trasformazioni (che creano nuovi RDD) e azioni (che restituiscono valori).
Questa flessibilità consente pattern di elaborazione diversificati oltre il paradigma map-reduce.
Spark è evoluto oltre gli RDD, offrendo astrazioni di livello superiore come DataFrame e Dataset, che forniscono elaborazione consapevole dello schema con ottimizzazioni simili ai database relazionali. Queste astrazioni, unite a librerie specializzate per streaming, SQL, machine learning e grafi, permettono agli sviluppatori di esprimere workflow complessi con molto meno codice rispetto alle implementazioni equivalenti in MapReduce, mantenendo un modello di programmazione unificato tra paradigmi di elaborazione diversi.
Considerazioni sui costi: Spark vs Hadoop
Quando si valutano i framework big data, le organizzazioni devono considerare non solo le capacità tecniche, ma anche le implicazioni finanziarie di deployment e operatività.
Requisiti hardware e implicazioni
Hadoop e Spark hanno preferenze hardware fondamentalmente diverse che impattano i costi infrastrutturali. Hadoop è stato progettato per privilegiare lo storage su disco rispetto alla memoria, risultando adatto a hardware economico con RAM limitata ma ampia capacità di disco.
Questa architettura può ridurre l’investimento hardware iniziale, specialmente quando si elaborano dataset estremamente grandi per cui soluzioni basate sulla memoria sarebbero proibitive.
Il modello di elaborazione in-memory di Spark offre benefici prestazionali ma richiede molta più RAM per nodo. Un cluster Spark configurato correttamente richiede tipicamente server con configurazioni di memoria sostanziose — spesso da 16 GB a 256 GB per nodo, a seconda dei carichi di lavoro.
Sebbene i costi della memoria siano diminuiti nel tempo, questo requisito può comunque aumentare le spese hardware rispetto a deployment Hadoop incentrati sul disco.
Spese operative
I costi operativi vanno oltre l’acquisizione dell’hardware e includono manutenzione continua, elettricità, raffreddamento e spazio nel data center. I cluster Hadoop tendono ad avere un ingombro fisico maggiore a causa della dipendenza da numerosi server economici con storage esteso.
Questo ingombro maggiore si traduce in costi più alti per alimentazione, raffreddamento e spazio rack.
I cluster Spark a volte possono raggiungere le stesse capacità di elaborazione con meno nodi grazie all’uso più efficiente delle risorse di calcolo, riducendo potenzialmente l’ingombro nel data center e i costi associati. Tuttavia, le macchine con specifiche più elevate richieste possono consumare più energia per nodo, compensando in parte questi risparmi.
Costi di sviluppo e personale
La complessità di implementazione e manutenzione può incidere significativamente sul costo totale di proprietà. L’ecosistema Hadoop ha tradizionalmente richiesto competenze specialistiche nella programmazione Java e nell’amministrazione Unix, con cicli di sviluppo che potevano essere lunghi a causa della natura prolissa della programmazione MapReduce.
Spark offre API più accessibili in Python, Scala, R e Java, riducendo potenzialmente i tempi di sviluppo e i relativi costi di personale.
Il modello di programmazione più intuitivo può ridurre sia la curva di apprendimento sia i tempi di sviluppo, permettendo alle organizzazioni di implementare soluzioni più rapidamente con personale meno specializzato.
Strategie di ottimizzazione dei costi
Per le organizzazioni sensibili ai costi, gli approcci ibridi offrono spesso il miglior valore. Usare HDFS per lo storage e Spark per l’elaborazione può combinare l’archiviazione conveniente di Hadoop con l’efficienza di elaborazione di Spark. I deployment nel cloud su servizi come AWS EMR, Azure HDInsight o Google Dataproc consentono di pagare solo le risorse utilizzate, senza ingenti spese in conto capitale iniziali.
Le organizzazioni dovrebbero considerare anche i costi di scalabilità. Hadoop tradizionalmente richiede interventi manuali per scalare, aumentando l’overhead operativo. La compatibilità di Spark con piattaforme di orchestrazione dei container come Kubernetes abilita uno scaling elastico e più automatizzato che può allineare meglio il provisioning delle risorse alla domanda reale, riducendo potenzialmente la capacità sprecata.
Tabella di confronto tra Hadoop e Spark
Ecco una tabella di confronto che riassume le differenze:
|
Caratteristica
|
Hadoop
|
Spark
|
|
Modello di elaborazione
|
Elaborazione batch tramite MapReduce
|
Elaborazione in-memory tramite RDD, DataFrame e Dataset
|
|
Prestazioni
|
Più lento a causa dell’I/O su disco tra le fasi
|
Fino a 100x più veloce per carichi iterativi e in-memory
|
|
Uso della memoria
|
Incentrato sul disco, requisiti di memoria bassi
|
Intensivo in memoria, requisiti RAM elevati
|
|
Facilità di sviluppo
|
Prolisso; richiede di scrivere esplicitamente la logica di map & reduce
|
API di alto livello in Python, Scala, R, Java; meno boilerplate
|
|
Tolleranza ai guasti
|
Replica dei dati tramite HDFS
|
La lineage degli RDD abilita il ricalcolo in caso di errore
|
|
Elaborazione in tempo reale
|
Non ideale; solo batch
|
Supporta l’elaborazione in tempo reale tramite Spark Streaming
|
|
Gestore di cluster
|
YARN
|
Standalone, YARN, Mesos o Kubernetes
|
|
Storage
|
Include HDFS
|
Dipende da storage esterno (es. HDFS, S3, GCS)
|
|
Costo
|
Costo hardware più basso (macchine economiche, basate su disco)
|
Costo della memoria più alto ma migliore utilizzo delle risorse per carico
|
|
Ideale per
|
Job batch, storage su scala massiva, analisi di dati storici
|
Machine learning, stream processing, analytics interattive
|
|
Integrazione
|
Ecosistema Hadoop solido (Hive, Pig, ecc.)
|
API unificate per SQL, MLlib, GraphX e Streaming su un’unica piattaforma
|
Conclusione
Hadoop e Spark rappresentano approcci complementari all’elaborazione dei big data, più che concorrenti diretti. Hadoop eccelle con il suo sistema di archiviazione conveniente (HDFS) e l’elaborazione orientata ai batch per dataset enormi in cui conta più il throughput della velocità.
Spark brilla con le sue capacità di elaborazione in-memory che offrono prestazioni superiori per algoritmi iterativi, analytics interattive e necessità di elaborazione in tempo reale.
DataCamp offre diverse risorse se vuoi approfondire queste due tecnologie:





Hadoop e Spark sono due dei framework più importanti nel mondo dei big data, ma gestiscono l’elaborazione di dati su larga scala in modi molto diversi. Se da un lato a Hadoop va il merito di aver reso accessibile il paradigma del calcolo distribuito grazie a un solido sistema di archiviazione chiamato HDFS e a un modello computazionale chiamato MapReduce, Spark sta cambiando le carte in tavola con la sua architettura in-memory e un modello di programmazione flessibile.
Questo tutorial analizza in profondità le differenze tra Hadoop e Spark, incluse architettura, prestazioni, considerazioni sui costi e integrazioni. Alla fine avrai una chiara comprensione dei pro e contro di ciascuno e dei tipi di casi d’uso in cui ogni framework eccelle; questa comprensione ti aiuterà a prendere decisioni strategiche mentre costruisci le tue soluzioni big data.
Capire Hadoop e Spark
Prima di entrare nei dettagli, vediamo i concetti fondamentali e le origini di Hadoop e Spark, per capire come questi potenti framework affrontano le sfide dei big data.
Che cos’è Hadoop?
Hadoop è un framework open-source progettato per archiviare ed elaborare grandi dataset su cluster di computer. Dal 2006, Hadoop ha permesso alle organizzazioni di gestire volumi di dati enormi che metterebbero in crisi una singola macchina. Distribuendo i dati su più nodi, non solo migliora la capacità di elaborazione, ma offre anche ridondanza, garantendo l’affidabilità del sistema anche in caso di guasti di singole macchine.
I componenti chiave del framework Hadoop includono:
Uno dei principali vantaggi di Hadoop è la convenienza economica: consente alle organizzazioni di usare hardware standard e a basso costo, invece di costose apparecchiature specializzate. Questo approccio pratico si riflette anche nella sua filosofia di elaborazione.
Il design orientato ai batch di Hadoop eccelle in scenari in cui conta più il throughput complessivo che la velocità pura, risultando particolarmente utile per l’analisi di dati storici e le operazioni ETL (Extract, Transform, Load) complesse che non richiedono risultati immediati.
Che cos’è Apache Spark?
Apache Spark è nato nel 2010 come risposta ai limiti dell’approccio di Hadoop all’elaborazione dei big data. Sviluppato inizialmente alla UC Berkeley prima di diventare un progetto Apache, Spark ha affrontato la forte dipendenza di Hadoop MapReduce dalle operazioni su disco. La sua innovazione decisiva è stata l’implementazione del calcolo in-memory, che riduce drasticamente i tempi di elaborazione per molti carichi di lavoro, minimizzando la necessità di leggere e scrivere su disco.
Spark offre una piattaforma unificata con diversi componenti strettamente integrati attorno al suo motore di elaborazione principale:
Questo design coerente consente ai team di affrontare diverse sfide sui dati usando un unico framework, invece di destreggiarsi tra più strumenti specializzati.
Nonostante le differenze, Spark e Hadoop spesso lavorano insieme come tecnologie complementari, più che come concorrenti. Poiché Spark non include un proprio sistema di archiviazione, si affida comunemente a HDFS di Hadoop per l’archiviazione persistente dei dati.
Inoltre, Spark può operare sul gestore di risorse YARN di Hadoop, rendendo semplice per le organizzazioni potenziare gli ambienti Hadoop esistenti con la potenza di elaborazione di Spark. Questa compatibilità crea un percorso di aggiornamento pratico che consente alle aziende di adottare i vantaggi di Spark senza abbandonare gli investimenti nell’infrastruttura Hadoop.
Confronto delle prestazioni tra Hadoop e Spark
Quando si valutano i framework big data, le prestazioni diventano spesso un fattore decisivo per le organizzazioni con esigenze di elaborazione sensibili al tempo.
Velocità di elaborazione
Il MapReduce di Hadoop opera come un sistema di elaborazione basato su disco: legge i dati dal disco, li elabora e scrive i risultati nuovamente su disco tra ogni fase di calcolo. Questo I/O su disco crea una latenza significativa, soprattutto per gli algoritmi iterativi che richiedono più passaggi sugli stessi dati.
Pur essendo efficace per l’elaborazione batch di dataset enormi, questo approccio sacrifica la velocità a favore dell’affidabilità e del throughput.
Spark, al contrario, esegue le computazioni principalmente in memoria, riducendo drasticamente la necessità di operazioni su disco. Per molti carichi di lavoro, in particolare per gli algoritmi iterativi come quelli usati nel machine learning, Spark può eseguire i task fino a 100 volte più velocemente di Hadoop MapReduce.
Questo vantaggio prestazionale diventa particolarmente evidente quando l’elaborazione deve avvenire in quasi tempo reale o quando gli algoritmi richiedono più passaggi sullo stesso dataset.
Utilizzo della memoria
Il design di Hadoop presuppone una disponibilità limitata di memoria, risultando efficiente in termini di RAM ma più lento. Si affida fortemente allo storage su disco, il che gli consente di elaborare dataset molto più grandi della RAM disponibile, scambiando costantemente dati tra memoria e disco.
Questo approccio rende Hadoop adatto a elaborare dataset estremamente grandi su cluster con risorse di memoria limitate.
I vantaggi prestazionali di Spark derivano dal suo uso aggressivo della memoria. Memorizzando nella RAM i dati tra le varie fasi di elaborazione, Spark elimina le costose operazioni su disco. Tuttavia, questo richiede risorse di memoria sufficienti per contenere i dataset di lavoro.
Quando sorgono vincoli di memoria, il vantaggio di Spark si riduce poiché inizia a riversare i dati su disco; ciononostante, la sua gestione intelligente della memoria in genere supera ancora l’approccio “disk-first” di Hadoop.
Considerazioni sulle prestazioni nel mondo reale
Il divario di prestazioni tra Hadoop e Spark nel mondo reale varia notevolmente in base ai casi d’uso specifici. Per l’elaborazione batch a singolo passaggio di dataset enormi, in cui i dati superano ampiamente la memoria disponibile, le prestazioni di Hadoop possono avvicinarsi a quelle di Spark.
Tuttavia, per l’elaborazione iterativa, le query interattive e lo stream processing, Spark offre costantemente prestazioni superiori.
Vale la pena notare che le prestazioni non riguardano solo la velocità pura. Hadoop eccelle in scenari che richiedono un’elevata tolleranza ai guasti e in cui l’elaborazione può avvenire in finestre batch ben definite.
Spark dà il meglio quando servono risultati rapidi, come nell’esplorazione interattiva dei dati, nelle analisi in tempo reale e nelle applicazioni di machine learning, in cui gli algoritmi effettuano più passaggi sui dataset.
Gestione del cluster: cluster Hadoop vs cluster Spark
Sia Hadoop che Spark si basano su cluster per elaborare in modo efficiente grandi volumi di dati, ma gestiscono queste risorse in modo diverso, con impatti su prestazioni e amministrazione.
Cos’è il clustering e perché serve
Un cluster è un insieme di computer interconnessi (nodi) che lavorano insieme come un unico sistema. Nell’elaborazione dei big data, il clustering diventa necessario quando i volumi di dati superano ciò che una singola macchina può gestire in modo efficiente. Distribuendo i carichi di lavoro computazionali su più macchine, i cluster permettono di elaborare petabyte di dati altrimenti ingestibili.
Il clustering offre anche tolleranza ai guasti e alta disponibilità. Se una macchina si guasta, le altre nel cluster possono subentrarne al carico, garantendo la continuità operativa. Questa resilienza è cruciale in ambienti di produzione in cui i tempi di inattività possono essere costosi.
Inoltre, il clustering consente lo scaling orizzontale — aggiungere più macchine per aumentare la potenza di elaborazione — spesso più conveniente rispetto all’upgrade dei singoli sistemi.
Per chi aspira a lavorare in questo campo, comprendere il clustering è una competenza fondamentale nell’ ingegneria dei dati.
Architettura di un cluster Hadoop
I cluster Hadoop seguono un’architettura master-slave con ruoli specializzati per nodi diversi. Il NameNode funge da master per HDFS, mantenendo i metadati su posizioni e permessi dei file. I DataNode archiviano i blocchi di dati reali e riportano lo stato al NameNode.
Per l’elaborazione, il ResourceManager alloca le risorse del cluster, mentre i NodeManager sulle singole macchine eseguono i task.
HDFS replica i dati su più DataNode, mantenendo in genere tre copie di ogni blocco. Questa strategia assicura la disponibilità dei dati anche in caso di guasti ai singoli nodi, sebbene richieda capacità di storage aggiuntiva.
Il design del cluster Hadoop enfatizza la località dei dati, cercando di pianificare i task computazionali sugli stessi nodi in cui risiedono i dati, per minimizzare i trasferimenti di rete.
L’amministrazione dei cluster Hadoop ha tradizionalmente richiesto competenze significative (i professionisti spesso si preparano con domande di colloquio su Hadoop per dimostrare questa conoscenza), anche se le distribuzioni moderne includono strumenti di gestione per semplificare configurazione e monitoraggio.
Scalare un cluster Hadoop comporta l’aggiunta di nuovi nodi e il ribilanciamento dei dati sull’infrastruttura ampliata, un processo che può essere manuale e richiedere un’attenta pianificazione.
Architettura di un cluster Spark
Spark può operare in varie configurazioni di cluster, tra cui modalità standalone, su Hadoop YARN, Apache Mesos o Kubernetes. In tutte le distribuzioni, Spark segue un modello driver-executor. Il programma driver contiene la funzione principale dell’applicazione e crea uno SparkContext che coordina con il cluster manager per allocare le risorse.
Una volta allocate le risorse, gli executor di Spark vengono avviati sui nodi worker. Questi executor sono processi JVM che eseguono i task e archiviano i dati in memoria o su disco. A differenza di Hadoop, che mantiene una presenza persistente sui nodi del cluster, gli executor di Spark possono essere allocati e rilasciati dinamicamente in base alle esigenze dell’applicazione, migliorando potenzialmente l’utilizzo delle risorse.
Chi è interessato può approfondire le funzionalità di Spark con tutorial pratici come Apache Spark per il Machine Learning.
Spark non include un proprio sistema di archiviazione distribuita, ma sfrutta soluzioni esistenti come HDFS, Amazon S3 o altri sistemi compatibili. Questa separazione tra calcolo e storage offre flessibilità, ma richiede una configurazione accurata per garantire pattern di accesso ai dati ottimali.
Strumenti come Spark SQL e sparklyr offrono modi comodi per interagire con questa architettura.
Differenze chiave nella gestione del cluster
L’approccio di Hadoop alla gestione del cluster è più incentrato sull’infrastruttura, con un’allocazione delle risorse relativamente statica e un focus sulla località dei dati. Questo design funziona bene per job batch di lunga durata su cluster stabili in cui i nodi cambiano raramente.
Tuttavia, può essere meno reattivo a carichi di lavoro variabili e richiede più interventi manuali in fase di scalabilità.
Spark offre una gestione delle risorse più dinamica, soprattutto quando gira su piattaforme di orchestrazione moderne come Kubernetes. Può regolare l’allocazione delle risorse in base alla domanda corrente e rilasciarle quando non servono.
Questa elasticità è preziosa per le organizzazioni con carichi di lavoro fluttuanti o infrastrutture condivise che servono più applicazioni.
Capire queste differenze è cruciale per i professionisti che puntano a una certificazione da Data Engineer o si preparano per domande di colloquio su Spark.
Per le organizzazioni che stanno iniziando con i big data, le opzioni di deployment più flessibili di Spark e il suo modello di programmazione più semplice spesso rendono più facile partire.
Tuttavia, in ambienti con volumi di dati estremamente grandi in cui la gestione dello storage è la preoccupazione principale, l’ecosistema maturo di HDFS offre ancora vantaggi che completano le capacità di elaborazione di Spark. Per un confronto tra Spark e altre tecnologie di streaming, potrebbe essere utile una comparazione come Flink vs. Spark.
Hadoop MapReduce vs modello di elaborazione di Spark
Sebbene le sezioni precedenti abbiano discusso le implicazioni sulle prestazioni, comprendere i modelli di elaborazione fondamentali di ciascun framework aiuta a spiegare perché sono progettati in modo così diverso.
Framework Hadoop MapReduce
MapReduce segue un paradigma di programmazione rigido con due fasi principali: map e reduce. La fase di map applica una funzione a ciascun record in parallelo, generando coppie chiave-valore intermedie.
Queste coppie attraversano una fase obbligatoria di shuffle e sort, in cui i dati con le stesse chiavi vengono raggruppati.
Infine, la fase di reduce aggrega questi valori raggruppati per produrre gli output finali. Questo approccio strutturato implica che le operazioni complesse richiedono la concatenazione di più job MapReduce.
Sviluppare applicazioni MapReduce in genere comporta la scrittura di codice di basso livello che definisce esplicitamente le funzioni di mapping e reducing.
Sebbene framework come Apache Pig e Apache Hive forniscano astrazioni di livello superiore, l’esecuzione sottostante segue comunque il rigido pattern MapReduce, che impone limitazioni sulla progettazione degli algoritmi e sulle opportunità di ottimizzazione.
Il modello di elaborazione dei dati di Spark
Spark ha introdotto i Resilient Distributed Datasets (RDD) come astrazione di base — collezioni immutabili e partizionate che tracciano la propria genealogia per il ripristino. A differenza di MapReduce, Spark non impone un pattern di elaborazione rigido, ma offre due tipi di operazioni: trasformazioni (che creano nuovi RDD) e azioni (che restituiscono valori).
Questa flessibilità consente pattern di elaborazione diversificati oltre il paradigma map-reduce.
Spark è evoluto oltre gli RDD, offrendo astrazioni di livello superiore come DataFrame e Dataset, che forniscono elaborazione consapevole dello schema con ottimizzazioni simili ai database relazionali. Queste astrazioni, unite a librerie specializzate per streaming, SQL, machine learning e grafi, permettono agli sviluppatori di esprimere workflow complessi con molto meno codice rispetto alle implementazioni equivalenti in MapReduce, mantenendo un modello di programmazione unificato tra paradigmi di elaborazione diversi.
Considerazioni sui costi: Spark vs Hadoop
Quando si valutano i framework big data, le organizzazioni devono considerare non solo le capacità tecniche, ma anche le implicazioni finanziarie di deployment e operatività.
Requisiti hardware e implicazioni
Hadoop e Spark hanno preferenze hardware fondamentalmente diverse che impattano i costi infrastrutturali. Hadoop è stato progettato per privilegiare lo storage su disco rispetto alla memoria, risultando adatto a hardware economico con RAM limitata ma ampia capacità di disco.
Questa architettura può ridurre l’investimento hardware iniziale, specialmente quando si elaborano dataset estremamente grandi per cui soluzioni basate sulla memoria sarebbero proibitive.
Il modello di elaborazione in-memory di Spark offre benefici prestazionali ma richiede molta più RAM per nodo. Un cluster Spark configurato correttamente richiede tipicamente server con configurazioni di memoria sostanziose — spesso da 16 GB a 256 GB per nodo, a seconda dei carichi di lavoro.
Sebbene i costi della memoria siano diminuiti nel tempo, questo requisito può comunque aumentare le spese hardware rispetto a deployment Hadoop incentrati sul disco.
Spese operative
I costi operativi vanno oltre l’acquisizione dell’hardware e includono manutenzione continua, elettricità, raffreddamento e spazio nel data center. I cluster Hadoop tendono ad avere un ingombro fisico maggiore a causa della dipendenza da numerosi server economici con storage esteso.
Questo ingombro maggiore si traduce in costi più alti per alimentazione, raffreddamento e spazio rack.
I cluster Spark a volte possono raggiungere le stesse capacità di elaborazione con meno nodi grazie all’uso più efficiente delle risorse di calcolo, riducendo potenzialmente l’ingombro nel data center e i costi associati. Tuttavia, le macchine con specifiche più elevate richieste possono consumare più energia per nodo, compensando in parte questi risparmi.
Costi di sviluppo e personale
La complessità di implementazione e manutenzione può incidere significativamente sul costo totale di proprietà. L’ecosistema Hadoop ha tradizionalmente richiesto competenze specialistiche nella programmazione Java e nell’amministrazione Unix, con cicli di sviluppo che potevano essere lunghi a causa della natura prolissa della programmazione MapReduce.
Spark offre API più accessibili in Python, Scala, R e Java, riducendo potenzialmente i tempi di sviluppo e i relativi costi di personale.
Il modello di programmazione più intuitivo può ridurre sia la curva di apprendimento sia i tempi di sviluppo, permettendo alle organizzazioni di implementare soluzioni più rapidamente con personale meno specializzato.
Strategie di ottimizzazione dei costi
Per le organizzazioni sensibili ai costi, gli approcci ibridi offrono spesso il miglior valore. Usare HDFS per lo storage e Spark per l’elaborazione può combinare l’archiviazione conveniente di Hadoop con l’efficienza di elaborazione di Spark. I deployment nel cloud su servizi come AWS EMR, Azure HDInsight o Google Dataproc consentono di pagare solo le risorse utilizzate, senza ingenti spese in conto capitale iniziali.
Le organizzazioni dovrebbero considerare anche i costi di scalabilità. Hadoop tradizionalmente richiede interventi manuali per scalare, aumentando l’overhead operativo. La compatibilità di Spark con piattaforme di orchestrazione dei container come Kubernetes abilita uno scaling elastico e più automatizzato che può allineare meglio il provisioning delle risorse alla domanda reale, riducendo potenzialmente la capacità sprecata.
Tabella di confronto tra Hadoop e Spark
Ecco una tabella di confronto che riassume le differenze:
Caratteristica
Hadoop
Spark
Modello di elaborazione
Elaborazione batch tramite MapReduce
Elaborazione in-memory tramite RDD, DataFrame e Dataset
Prestazioni
Più lento a causa dell’I/O su disco tra le fasi
Fino a 100x più veloce per carichi iterativi e in-memory
Uso della memoria
Incentrato sul disco, requisiti di memoria bassi
Intensivo in memoria, requisiti RAM elevati
Facilità di sviluppo
Prolisso; richiede di scrivere esplicitamente la logica di map & reduce
API di alto livello in Python, Scala, R, Java; meno boilerplate
Tolleranza ai guasti
Replica dei dati tramite HDFS
La lineage degli RDD abilita il ricalcolo in caso di errore
Elaborazione in tempo reale
Non ideale; solo batch
Supporta l’elaborazione in tempo reale tramite Spark Streaming
Gestore di cluster
YARN
Standalone, YARN, Mesos o Kubernetes
Storage
Include HDFS
Dipende da storage esterno (es. HDFS, S3, GCS)
Costo
Costo hardware più basso (macchine economiche, basate su disco)
Costo della memoria più alto ma migliore utilizzo delle risorse per carico
Ideale per
Job batch, storage su scala massiva, analisi di dati storici
Machine learning, stream processing, analytics interattive
Integrazione
Ecosistema Hadoop solido (Hive, Pig, ecc.)
API unificate per SQL, MLlib, GraphX e Streaming su un’unica piattaforma
Conclusione
Hadoop e Spark rappresentano approcci complementari all’elaborazione dei big data, più che concorrenti diretti. Hadoop eccelle con il suo sistema di archiviazione conveniente (HDFS) e l’elaborazione orientata ai batch per dataset enormi in cui conta più il throughput della velocità.
Spark brilla con le sue capacità di elaborazione in-memory che offrono prestazioni superiori per algoritmi iterativi, analytics interattive e necessità di elaborazione in tempo reale.
DataCamp offre diverse risorse se vuoi approfondire queste due tecnologie: