Hadoop en Spark zijn twee van de meest prominente frameworks in big data, maar ze verwerken grootschalige data op heel verschillende manieren. Waar Hadoop het gedistribueerde-computingparadigma toegankelijk maakte met een robuust opslagsysteem (HDFS) en een computationeel model (MapReduce), verandert Spark het speelveld met een in-memoryarchitectuur en een flexibel programmeermodel.
Deze tutorial gaat dieper in op de verschillen tussen Hadoop en Spark, waaronder hun architectuur, prestaties, kostenoverwegingen en integraties. Aan het einde heb je een helder beeld van de voor- en nadelen van elk framework en de soorten use cases waarin ze uitblinken; die kennis helpt je bij strategische keuzes terwijl je jouw bigdatasolutions opbouwt.
Hadoop en Spark begrijpen
Voordat we in de details duiken, bekijken we de basisconcepten en oorsprong van Hadoop en Spark om te begrijpen hoe deze krachtige frameworks bigdata-uitdagingen benaderen.
Wat is Hadoop?
Hadoop is een open-sourceframework dat is ontworpen om grote datasets op te slaan en te verwerken over clusters van computers. Sinds de ontwikkeling in 2006 stelt Hadoop organisaties in staat om enorme datavolumes te verwerken die een enkele machine zouden overbelasten. Door data te verdelen over meerdere nodes verbetert het niet alleen de verwerkingscapaciteit, maar zorgt het ook voor redundantie, zodat het systeem betrouwbaar blijft, zelfs als individuele machines uitvallen.
Belangrijke componenten van het Hadoop-framework zijn:
- Hadoop Distributed File System (HDFS): Vormt de opslagbasis, splitst bestanden in blokken en distribueert ze over het cluster.
- MapReduce: Verzorgt de verwerking door computationele taken op te delen in kleinere eenheden die parallel over het cluster draaien.
- YARN (Yet Another Resource Negotiator): Beheert resources efficiënt door rekenkracht toe te wijzen en taken te plannen over beschikbare machines.
Een van de grootste voordelen van Hadoop is de kostenefficiëntie, omdat organisaties standaard, commodityhardware kunnen gebruiken in plaats van dure, gespecialiseerde apparatuur. Die praktische insteek geldt ook voor de verwerkingsfilosofie.
Het batchgerichte ontwerp van Hadoop blinkt uit in situaties waarin totale throughput belangrijker is dan pure snelheid. Het is daardoor vooral waardevol voor historische data-analyse en complexe ETL (Extract, Transform, Load) operaties die geen directe resultaten vereisen.
Wat is Apache Spark?
Apache Spark ontstond in 2010 als antwoord op de beperkingen van Hadoop bij bigdataverwerking. Aanvankelijk ontwikkeld aan UC Berkeley en later een Apache-project geworden, pakte Spark de sterke afhankelijkheid van Hadoop MapReduce van schijfoperaties aan. De doorbraak was in-memory computation, waarmee de verwerkingstijd voor veel dataworkloads drastisch wordt verkort door minder vaak naar schijf te lezen en te schrijven.
Spark biedt een uniform platform met diverse sterk geïntegreerde componenten rond de kernengine:
- Spark SQL: Voor werken met gestructureerde data
- MLlib: Voor het implementeren van machinelearningalgoritmes
- GraphX: Voor verwerking van graafdata
- Spark Streaming: Voor realtimeanalyse
Dankzij dit samenhangende ontwerp kunnen teams uiteenlopende data-uitdagingen aanpakken met één framework, in plaats van meerdere gespecialiseerde tools te combineren.
Ondanks de verschillen werken Spark en Hadoop vaak samen als complementaire technologieën in plaats van concurrenten. Omdat Spark geen eigen opslagsysteem heeft, vertrouwt het vaak op HDFS van Hadoop voor persistente dataopslag.
Daarnaast kan Spark draaien op de YARN-resourcemanager van Hadoop, waardoor organisaties bestaande Hadoop-omgevingen eenvoudig kunnen versterken met de verwerkingskracht van Spark. Deze compatibiliteit creëert een praktisch upgradepad waarmee bedrijven de voordelen van Spark kunnen benutten zonder hun investering in Hadoop-infrastructuur op te geven.
Hadoop vs Spark: prestatievergelijking
Bij het evalueren van bigdataframeworks is performance vaak doorslaggevend voor organisaties met tijdkritische verwerkingsbehoeften.
Verwerkingssnelheid
Hadoops MapReduce werkt schijfgebaseerd: het leest data van schijf, verwerkt die en schrijft resultaten na elke stap terug naar schijf. Deze schijf-I/O veroorzaakt aanzienlijke latentie, vooral bij iteratieve algoritmes die meerdere passes over dezelfde data vereisen.
Deze aanpak is effectief voor batchverwerking van enorme datasets, maar levert snelheid in voor betrouwbaarheid en throughput.
Spark daarentegen voert berekeningen primair in het geheugen uit, wat de noodzaak voor schijfoperaties drastisch vermindert. Voor veel workloads, met name iteratieve algoritmes zoals gebruikt in machine learning, kan Spark taken tot 100 keer sneller uitvoeren dan Hadoop MapReduce.
Dit performancevoordeel komt vooral naar voren wanneer verwerking bijna realtime moet plaatsvinden of wanneer algoritmes meerdere passes door dezelfde dataset maken.
Geheugengebruik
Het ontwerp van Hadoop gaat uit van beperkte geheugencapaciteit, waardoor het geheugen-efficiënt maar trager is. Het leunt sterk op schijfopslag, zodat het datasets kan verwerken die veel groter zijn dan het beschikbare RAM door data voortdurend tussen geheugen en schijf te wisselen.
Deze aanpak maakt Hadoop geschikt voor extreem grote datasets op clusters met beperkte geheugenresources.
De performancevoordelen van Spark komen voort uit het agressieve geheugengebruik. Door data in RAM te cachen over verwerkingsstappen heen, elimineert Spark kostbare schijfoperaties. Dit vereist echter voldoende geheugen om werkende datasets te kunnen bevatten.
Als er geheugendruk ontstaat, neemt het voordeel van Spark af doordat het data naar schijf begint te spillen, al presteert het dankzij slimme geheugenbeheer doorgaans nog steeds beter dan de schijf-eerstaanpak van Hadoop.
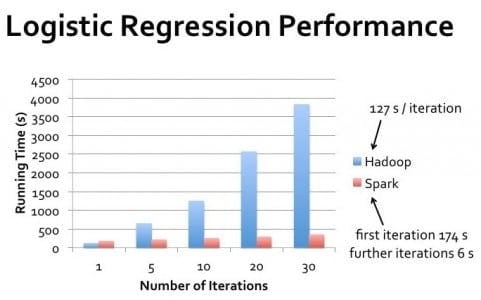
Het performanceverschil tussen Hadoop en Spark varieert sterk per use case. Bij single-pass batchverwerking van enorme datasets die het beschikbare geheugen ruim overstijgen, kan de performance van Hadoop in de buurt komen van Spark.
Voor iteratieve verwerking, interactieve queries en streamverwerking levert Spark echter consequent betere prestaties.
Let op dat performance niet alleen om pure snelheid draait. Hadoop blinkt uit in scenario’s met hoge fouttolerantie en waar verwerking in duidelijk afgebakende batchvensters kan plaatsvinden.
Spark presteert het best wanneer snelle resultaten nodig zijn, zoals interactieve data-exploratie, realtime analytics en machinelearningtoepassingen waarbij algoritmes meerdere passes door datasets maken.
Clusterbeheer: Hadoop-clusters vs Spark-clusters
Zowel Hadoop als Spark vertrouwen op clusters om grote datavolumes efficiënt te verwerken, maar ze beheren deze resources anders, wat impact heeft op zowel performance als beheer.
Wat is clusteren en waarom heb je het nodig
Een cluster is een verzameling onderling verbonden computers (nodes) die samenwerken als één systeem. In bigdataverwerking wordt clusteren noodzakelijk wanneer datavolumes groter worden dan wat één machine efficiënt kan afhandelen. Door workloads te verdelen over meerdere machines kunnen organisaties petabytes aan data verwerken die anders onhanteerbaar zouden zijn.
Clusteren biedt ook fouttolerantie en hoge beschikbaarheid. Als één machine uitvalt, kunnen andere in het cluster de workload overnemen zodat de operatie doorloopt. Deze veerkracht is cruciaal in productieomgevingen waar downtime kostbaar is.
Bovendien maakt clusteren horizontale schaalbaarheid mogelijk — extra machines toevoegen om rekenkracht te vergroten — wat vaak kostenefficiënter is dan individuele systemen upgraden.
Voor aankomende professionals is inzicht in clusteren een fundamentele vaardigheid in data engineering.
Hadoop-clusterarchitectuur
Hadoop-clusters volgen een master-slavearchitectuur met gespecialiseerde rollen voor verschillende nodes. De NameNode fungeert als master voor HDFS en beheert metadata over bestandslocaties en permissies. DataNodes slaan de daadwerkelijke datablocks op en rapporteren aan de NameNode.
Voor verwerking wijst de ResourceManager clusterresources toe, terwijl NodeManagers op individuele machines taken uitvoeren.
HDFS repliceert data over meerdere DataNodes, doorgaans met drie kopieën van elk datablock. Deze replicatie zorgt voor beschikbaarheid, zelfs als individuele nodes uitvallen, al vergt het extra opslagcapaciteit.
Het clusterontwerp van Hadoop legt de nadruk op datalocaliteit en probeert taken te plannen op de nodes waar de data zich bevindt om netwerkverkeer te minimaliseren.
Het beheer van Hadoop-clusters vereiste traditioneel veel expertise (professionals bereiden zich vaak voor op Hadoop-sollicitatievragen om die kennis te tonen), al bevatten moderne distributies beheertools die configuratie en monitoring vereenvoudigen.
Een Hadoop-cluster schalen houdt in dat je nodes toevoegt en data opnieuw balanceert over de uitgebreide infrastructuur, wat handmatig en zorgvuldig gepland moet gebeuren.
Spark-clusterarchitectuur
Spark kan in verschillende clusterconfiguraties draaien, waaronder standalone, op Hadoop YARN, Apache Mesos of Kubernetes. In alle deployments volgt Spark een driver-executormodel. Het driverprogramma bevat de main-functie van de applicatie en creëert een SparkContext die met de cluster manager samenwerkt om resources toe te wijzen.
Zodra resources zijn toegewezen, worden Spark-executors gestart op workernodes. Dit zijn JVM-processen die taken uitvoeren en data in geheugen of op schijf opslaan. In tegenstelling tot Hadoop, dat een persistente aanwezigheid op clusternodes behoudt, kunnen Spark-executors dynamisch worden toegewezen en vrijgegeven op basis van de behoeften van de applicatie, wat het resourcegebruik kan verbeteren.
Geïnteresseerde lezers kunnen de mogelijkheden van Spark verder verkennen met praktische tutorials zoals Apache Spark for Machine Learning.
Spark bevat geen eigen gedistribueerd opslagsysteem, maar maakt gebruik van bestaande oplossingen zoals HDFS, Amazon S3 of andere compatibele systemen. Deze scheiding tussen compute en storage biedt flexibiliteit, maar vereist zorgvuldige configuratie voor optimale data-toegangsprofielen.
Tools zoals Spark SQL en sparklyr bieden handige manieren om met deze architectuur te werken.
Belangrijkste verschillen in clusterbeheer
Hadoop’s benadering van clusterbeheer is meer infrastructuurgericht, met relatief statische resourceallocatie en een focus op datalocaliteit. Dit werkt goed voor langlopende batchjobs op stabiele clusters waar nodes zelden veranderen.
Maar het is minder responsief bij variërende workloads en vereist meer handmatig ingrijpen bij het schalen.
Spark biedt dynamischer resourcebeheer, vooral op moderne orkestratieplatforms zoals Kubernetes. Het kan resources aanpassen aan de actuele vraag en ze vrijgeven wanneer ze niet nodig zijn.
Die elasticiteit is waardevol voor organisaties met fluctuerende workloads of gedeelde infrastructuur voor meerdere applicaties.
Inzicht in deze verschillen is cruciaal voor professionals die een Data Engineer-certificering nastreven of zich voorbereiden op Spark-sollicitatievragen.
Voor organisaties die net beginnen met big data, maken de flexibelere deploymentopties en het eenvoudigere programmeermodel van Spark het vaak makkelijker om te starten.
Maar in omgevingen met extreem grote datavolumes, waar opslagbeheer de hoofdzaak is, biedt het volwassen HDFS-ecosysteem van Hadoop nog steeds voordelen die de verwerkingscapaciteiten van Spark aanvullen. Voor een vergelijking van Spark met andere streamingtechnologieën is een overzicht zoals Flink vs. Spark informatief.
Hadoop MapReduce vs. het verwerkingsmodel van Spark
Hoewel we eerder de performanceimplicaties bespraken, helpt inzicht in de fundamentele verwerkingsmodellen te verklaren waarom de architecturen zo verschillen.
Hadoop MapReduce-framework
MapReduce volgt een strikt programmeerparadigma met twee primaire fasen: map en reduce. In de mapfase wordt een functie parallel op elk record toegepast en ontstaan intermediaire key-valueparen.
Deze paren ondergaan verplicht shufflen en sorteren, waarbij data met dezelfde keys wordt gegroepeerd.
Tot slot aggregeert de reducefase deze gegroepeerde waarden om de uiteindelijke output te produceren. Door deze gestructureerde aanpak vereisen complexe operaties het aaneenrijgen van meerdere MapReduce-jobs.
Het ontwikkelen van MapReduce-applicaties betekent doorgaans low-level code schrijven waarin je de map- en reducefuncties expliciet definieert.
Hoewel frameworks zoals Apache Pig en Apache Hive hogere abstracties bieden, blijft de onderliggende uitvoering het strikte MapReduce-patroon volgen, wat beperkingen oplegt aan algoritmeontwerp en optimalisatiemogelijkheden.
Het dataverwerkingsmodel van Spark
Spark introduceerde Resilient Distributed Datasets (RDD’s) als kernabstractie — onveranderlijke, gepartitioneerde collecties die hun herkomst kunnen bijhouden voor herstel. In tegenstelling tot MapReduce dwingt Spark geen star patroon af, maar biedt het twee typen operaties: transformaties (maken nieuwe RDD’s) en acties (geven waarden terug).
Die flexibiliteit maakt uiteenlopende verwerkingspatronen mogelijk buiten het map-reduceparadigma.
Spark is verder geëvolueerd voorbij RDD’s met hogere abstracties zoals DataFrames en Datasets, die schema-bewuste verwerking bieden met optimalisaties vergelijkbaar met relationele databases. Deze abstracties, gecombineerd met gespecialiseerde libraries voor streaming, SQL, machine learning en graafverwerking, stellen developers in staat om complexe workflows met aanzienlijk minder code uit te drukken dan equivalente MapReduce-implementaties, terwijl één programmeermodel behouden blijft over verschillende verwerkingsparadigma’s.
Spark vs Hadoop: kostenoverwegingen
Bij het beoordelen van bigdataframeworks moeten organisaties niet alleen naar technische mogelijkheden kijken, maar ook naar de financiële implicaties van deployment en operatie.
Hardwarevereisten en implicaties
Hadoop en Spark hebben fundamenteel verschillende hardwarevoorkeuren die de infrastructuurkosten beïnvloeden. Hadoop is ontworpen met prioriteit voor schijfopslag boven geheugen, waardoor het goed past bij commodityhardware met beperkt RAM maar veel schijfruimte.
Deze architectuur kan de initiële hardware-investering verlagen, zeker bij verwerking van extreem grote datasets waarbij geheugenoplossingen onbetaalbaar zouden zijn.
Het in-memoryverwerkingsmodel van Spark levert performancewinst op, maar vereist aanzienlijk meer RAM per node. Een goed geconfigureerd Spark-cluster vraagt doorgaans om servers met veel geheugen — vaak 16GB tot 256GB per node, afhankelijk van de workload.
Hoewel geheugenkosten in de tijd zijn gedaald, kan deze eis de hardwarekosten nog steeds verhogen vergeleken met schijfgerichte Hadoop-deployments.
Operationele uitgaven
Operationele kosten gaan verder dan hardwareaanschaf en omvatten doorlopend onderhoud, elektriciteit, koeling en datacenterplek. Hadoop-clusters hebben vaak een grotere fysieke footprint door het gebruik van talrijke commodityservers met veel opslag.
Die grotere footprint vertaalt zich in hogere kosten voor stroom, koeling en rackruimte.
Spark-clusters kunnen soms dezelfde verwerkingscapaciteit behalen met minder nodes dankzij efficiënter gebruik van compute, wat de datacenterfootprint en bijbehorende kosten kan verlagen. De zwaardere machines per node kunnen echter meer stroom verbruiken, wat deze besparingen deels teniet kan doen.
Ontwikkelings- en personeelskosten
De complexiteit van implementatie en onderhoud kan de totale eigendomskosten sterk beïnvloeden. Het Hadoop-ecosysteem vroeg traditioneel om gespecialiseerde expertise in Java-programmering en Unix-beheer, met langere ontwikkelcycli door de breedsprakige aard van MapReduce-programmering.
Spark biedt toegankelijkere API’s in Python, Scala, R en Java, wat de ontwikkelingstijd en bijbehorende personeelskosten kan verlagen.
Het intuïtievere programmeermodel kan zowel de leercurve als de doorlooptijd verkleinen, waardoor organisaties sneller oplossingen implementeren met minder gespecialiseerde medewerkers.
Kostenoptimalisatiestrategieën
Voor kostenbewuste organisaties bieden hybride aanpakken vaak de beste waarde. HDFS gebruiken voor opslag en Spark voor verwerking combineert de kostenefficiënte opslag van Hadoop met de verwerkingskracht van Spark. Clouddeployments op diensten als AWS EMR, Azure HDInsight of Google Dataproc laten organisaties betalen naar gebruik zonder grote kapitaalsinvesteringen vooraf.
Organisaties moeten ook schaalbaarheidskosten meenemen. Hadoop vereist traditioneel handmatige interventie bij schalen, wat operationele overhead toevoegt. De compatibiliteit van Spark met containerorkestratieplatforms zoals Kubernetes maakt meer geautomatiseerde, elastische schaalbaarheid mogelijk die resourceprovisioning beter laat aansluiten op de werkelijke vraag, wat verspilde capaciteit kan verminderen.
Hadoop vs Spark: vergelijkingstabel
Hier is een vergelijkingstabel met de belangrijkste verschillen:
|
Kenmerk
|
Hadoop
|
Spark
|
|
Verwerkingsmodel
|
Batchverwerking met MapReduce
|
In-memoryverwerking met RDD’s, DataFrames en Datasets
|
|
Performance
|
Trager door schijf-I/O tussen stappen
|
Tot 100x sneller voor iteratieve en in-memory workloads
|
|
Geheugengebruik
|
Schijfgericht, lage geheugeneisen
|
Geheugenintensief, hoge RAM-eisen
|
|
Ontwikkelgemak
|
Breedsprakig; map- & reducelogica expliciet schrijven
|
High-level API’s in Python, Scala, R, Java; minder boilerplate
|
|
Fouttolerantie
|
Datareplicatie via HDFS
|
RDD-lineage maakt herberekening mogelijk bij falen
|
|
Realtimeverwerking
|
Niet ideaal; alleen batch
|
Ondersteunt realtimeverwerking via Spark Streaming
|
|
Clusterbeheer
|
YARN
|
Standalone, YARN, Mesos of Kubernetes
|
|
Opslag
|
Wordt geleverd met HDFS
|
Afhankelijk van externe opslag (bijv. HDFS, S3, GCS)
|
|
Kosten
|
Lagere hardwarekosten (commoditymachines, schijfgebaseerd)
|
Hogere geheugenkosten maar betere resourcebenutting per workload
|
|
Beste voor
|
Batchjobs, opslag op zeer grote schaal, historische data-analyse
|
Machine learning, streamverwerking, interactieve analytics
|
|
Integratie
|
Sterk Hadoop-ecosysteem (Hive, Pig, enz.)
|
Uniforme API’s voor SQL, MLlib, GraphX en Streaming in één platform
|
Conclusie
Hadoop en Spark zijn eerder complementaire benaderingen van bigdataverwerking dan strikte concurrenten. Hadoop blinkt uit met zijn kostenefficiënte opslagsysteem (HDFS) en batchgerichte verwerking voor enorme datasets waarbij throughput zwaarder weegt dan snelheid.
Spark schittert met in-memoryverwerking die superieure prestaties levert voor iteratieve algoritmes, interactieve analytics en realtimebehoeften.
DataCamp biedt diverse resources als je meer wilt leren over deze technologieën:



Hadoop en Spark zijn twee van de meest prominente frameworks in big data, maar ze verwerken grootschalige data op heel verschillende manieren. Waar Hadoop het gedistribueerde-computingparadigma toegankelijk maakte met een robuust opslagsysteem (HDFS) en een computationeel model (MapReduce), verandert Spark het speelveld met een in-memoryarchitectuur en een flexibel programmeermodel.
Deze tutorial gaat dieper in op de verschillen tussen Hadoop en Spark, waaronder hun architectuur, prestaties, kostenoverwegingen en integraties. Aan het einde heb je een helder beeld van de voor- en nadelen van elk framework en de soorten use cases waarin ze uitblinken; die kennis helpt je bij strategische keuzes terwijl je jouw bigdatasolutions opbouwt.
Hadoop en Spark begrijpen
Voordat we in de details duiken, bekijken we de basisconcepten en oorsprong van Hadoop en Spark om te begrijpen hoe deze krachtige frameworks bigdata-uitdagingen benaderen.
Wat is Hadoop?
Hadoop is een open-sourceframework dat is ontworpen om grote datasets op te slaan en te verwerken over clusters van computers. Sinds de ontwikkeling in 2006 stelt Hadoop organisaties in staat om enorme datavolumes te verwerken die een enkele machine zouden overbelasten. Door data te verdelen over meerdere nodes verbetert het niet alleen de verwerkingscapaciteit, maar zorgt het ook voor redundantie, zodat het systeem betrouwbaar blijft, zelfs als individuele machines uitvallen.
Belangrijke componenten van het Hadoop-framework zijn:
Een van de grootste voordelen van Hadoop is de kostenefficiëntie, omdat organisaties standaard, commodityhardware kunnen gebruiken in plaats van dure, gespecialiseerde apparatuur. Die praktische insteek geldt ook voor de verwerkingsfilosofie.
Het batchgerichte ontwerp van Hadoop blinkt uit in situaties waarin totale throughput belangrijker is dan pure snelheid. Het is daardoor vooral waardevol voor historische data-analyse en complexe ETL (Extract, Transform, Load) operaties die geen directe resultaten vereisen.
Wat is Apache Spark?
Apache Spark ontstond in 2010 als antwoord op de beperkingen van Hadoop bij bigdataverwerking. Aanvankelijk ontwikkeld aan UC Berkeley en later een Apache-project geworden, pakte Spark de sterke afhankelijkheid van Hadoop MapReduce van schijfoperaties aan. De doorbraak was in-memory computation, waarmee de verwerkingstijd voor veel dataworkloads drastisch wordt verkort door minder vaak naar schijf te lezen en te schrijven.
Spark biedt een uniform platform met diverse sterk geïntegreerde componenten rond de kernengine:
Dankzij dit samenhangende ontwerp kunnen teams uiteenlopende data-uitdagingen aanpakken met één framework, in plaats van meerdere gespecialiseerde tools te combineren.
Ondanks de verschillen werken Spark en Hadoop vaak samen als complementaire technologieën in plaats van concurrenten. Omdat Spark geen eigen opslagsysteem heeft, vertrouwt het vaak op HDFS van Hadoop voor persistente dataopslag.
Daarnaast kan Spark draaien op de YARN-resourcemanager van Hadoop, waardoor organisaties bestaande Hadoop-omgevingen eenvoudig kunnen versterken met de verwerkingskracht van Spark. Deze compatibiliteit creëert een praktisch upgradepad waarmee bedrijven de voordelen van Spark kunnen benutten zonder hun investering in Hadoop-infrastructuur op te geven.
Hadoop vs Spark: prestatievergelijking
Bij het evalueren van bigdataframeworks is performance vaak doorslaggevend voor organisaties met tijdkritische verwerkingsbehoeften.
Verwerkingssnelheid
Hadoops MapReduce werkt schijfgebaseerd: het leest data van schijf, verwerkt die en schrijft resultaten na elke stap terug naar schijf. Deze schijf-I/O veroorzaakt aanzienlijke latentie, vooral bij iteratieve algoritmes die meerdere passes over dezelfde data vereisen.
Deze aanpak is effectief voor batchverwerking van enorme datasets, maar levert snelheid in voor betrouwbaarheid en throughput.
Spark daarentegen voert berekeningen primair in het geheugen uit, wat de noodzaak voor schijfoperaties drastisch vermindert. Voor veel workloads, met name iteratieve algoritmes zoals gebruikt in machine learning, kan Spark taken tot 100 keer sneller uitvoeren dan Hadoop MapReduce.
Dit performancevoordeel komt vooral naar voren wanneer verwerking bijna realtime moet plaatsvinden of wanneer algoritmes meerdere passes door dezelfde dataset maken.
Geheugengebruik
Het ontwerp van Hadoop gaat uit van beperkte geheugencapaciteit, waardoor het geheugen-efficiënt maar trager is. Het leunt sterk op schijfopslag, zodat het datasets kan verwerken die veel groter zijn dan het beschikbare RAM door data voortdurend tussen geheugen en schijf te wisselen.
Deze aanpak maakt Hadoop geschikt voor extreem grote datasets op clusters met beperkte geheugenresources.
De performancevoordelen van Spark komen voort uit het agressieve geheugengebruik. Door data in RAM te cachen over verwerkingsstappen heen, elimineert Spark kostbare schijfoperaties. Dit vereist echter voldoende geheugen om werkende datasets te kunnen bevatten.
Als er geheugendruk ontstaat, neemt het voordeel van Spark af doordat het data naar schijf begint te spillen, al presteert het dankzij slimme geheugenbeheer doorgaans nog steeds beter dan de schijf-eerstaanpak van Hadoop.
Performance in de praktijk
Het performanceverschil tussen Hadoop en Spark varieert sterk per use case. Bij single-pass batchverwerking van enorme datasets die het beschikbare geheugen ruim overstijgen, kan de performance van Hadoop in de buurt komen van Spark.
Voor iteratieve verwerking, interactieve queries en streamverwerking levert Spark echter consequent betere prestaties.
Let op dat performance niet alleen om pure snelheid draait. Hadoop blinkt uit in scenario’s met hoge fouttolerantie en waar verwerking in duidelijk afgebakende batchvensters kan plaatsvinden.
Spark presteert het best wanneer snelle resultaten nodig zijn, zoals interactieve data-exploratie, realtime analytics en machinelearningtoepassingen waarbij algoritmes meerdere passes door datasets maken.
Clusterbeheer: Hadoop-clusters vs Spark-clusters
Zowel Hadoop als Spark vertrouwen op clusters om grote datavolumes efficiënt te verwerken, maar ze beheren deze resources anders, wat impact heeft op zowel performance als beheer.
Wat is clusteren en waarom heb je het nodig
Een cluster is een verzameling onderling verbonden computers (nodes) die samenwerken als één systeem. In bigdataverwerking wordt clusteren noodzakelijk wanneer datavolumes groter worden dan wat één machine efficiënt kan afhandelen. Door workloads te verdelen over meerdere machines kunnen organisaties petabytes aan data verwerken die anders onhanteerbaar zouden zijn.
Clusteren biedt ook fouttolerantie en hoge beschikbaarheid. Als één machine uitvalt, kunnen andere in het cluster de workload overnemen zodat de operatie doorloopt. Deze veerkracht is cruciaal in productieomgevingen waar downtime kostbaar is.
Bovendien maakt clusteren horizontale schaalbaarheid mogelijk — extra machines toevoegen om rekenkracht te vergroten — wat vaak kostenefficiënter is dan individuele systemen upgraden.
Voor aankomende professionals is inzicht in clusteren een fundamentele vaardigheid in data engineering.
Hadoop-clusterarchitectuur
Hadoop-clusters volgen een master-slavearchitectuur met gespecialiseerde rollen voor verschillende nodes. De NameNode fungeert als master voor HDFS en beheert metadata over bestandslocaties en permissies. DataNodes slaan de daadwerkelijke datablocks op en rapporteren aan de NameNode.
Voor verwerking wijst de ResourceManager clusterresources toe, terwijl NodeManagers op individuele machines taken uitvoeren.
HDFS repliceert data over meerdere DataNodes, doorgaans met drie kopieën van elk datablock. Deze replicatie zorgt voor beschikbaarheid, zelfs als individuele nodes uitvallen, al vergt het extra opslagcapaciteit.
Het clusterontwerp van Hadoop legt de nadruk op datalocaliteit en probeert taken te plannen op de nodes waar de data zich bevindt om netwerkverkeer te minimaliseren.
Het beheer van Hadoop-clusters vereiste traditioneel veel expertise (professionals bereiden zich vaak voor op Hadoop-sollicitatievragen om die kennis te tonen), al bevatten moderne distributies beheertools die configuratie en monitoring vereenvoudigen.
Een Hadoop-cluster schalen houdt in dat je nodes toevoegt en data opnieuw balanceert over de uitgebreide infrastructuur, wat handmatig en zorgvuldig gepland moet gebeuren.
Spark-clusterarchitectuur
Spark kan in verschillende clusterconfiguraties draaien, waaronder standalone, op Hadoop YARN, Apache Mesos of Kubernetes. In alle deployments volgt Spark een driver-executormodel. Het driverprogramma bevat de main-functie van de applicatie en creëert een SparkContext die met de cluster manager samenwerkt om resources toe te wijzen.
Zodra resources zijn toegewezen, worden Spark-executors gestart op workernodes. Dit zijn JVM-processen die taken uitvoeren en data in geheugen of op schijf opslaan. In tegenstelling tot Hadoop, dat een persistente aanwezigheid op clusternodes behoudt, kunnen Spark-executors dynamisch worden toegewezen en vrijgegeven op basis van de behoeften van de applicatie, wat het resourcegebruik kan verbeteren.
Geïnteresseerde lezers kunnen de mogelijkheden van Spark verder verkennen met praktische tutorials zoals Apache Spark for Machine Learning.
Spark bevat geen eigen gedistribueerd opslagsysteem, maar maakt gebruik van bestaande oplossingen zoals HDFS, Amazon S3 of andere compatibele systemen. Deze scheiding tussen compute en storage biedt flexibiliteit, maar vereist zorgvuldige configuratie voor optimale data-toegangsprofielen.
Tools zoals Spark SQL en sparklyr bieden handige manieren om met deze architectuur te werken.
Belangrijkste verschillen in clusterbeheer
Hadoop’s benadering van clusterbeheer is meer infrastructuurgericht, met relatief statische resourceallocatie en een focus op datalocaliteit. Dit werkt goed voor langlopende batchjobs op stabiele clusters waar nodes zelden veranderen.
Maar het is minder responsief bij variërende workloads en vereist meer handmatig ingrijpen bij het schalen.
Spark biedt dynamischer resourcebeheer, vooral op moderne orkestratieplatforms zoals Kubernetes. Het kan resources aanpassen aan de actuele vraag en ze vrijgeven wanneer ze niet nodig zijn.
Die elasticiteit is waardevol voor organisaties met fluctuerende workloads of gedeelde infrastructuur voor meerdere applicaties.
Inzicht in deze verschillen is cruciaal voor professionals die een Data Engineer-certificering nastreven of zich voorbereiden op Spark-sollicitatievragen.
Voor organisaties die net beginnen met big data, maken de flexibelere deploymentopties en het eenvoudigere programmeermodel van Spark het vaak makkelijker om te starten.
Maar in omgevingen met extreem grote datavolumes, waar opslagbeheer de hoofdzaak is, biedt het volwassen HDFS-ecosysteem van Hadoop nog steeds voordelen die de verwerkingscapaciteiten van Spark aanvullen. Voor een vergelijking van Spark met andere streamingtechnologieën is een overzicht zoals Flink vs. Spark informatief.
Hadoop MapReduce vs. het verwerkingsmodel van Spark
Hoewel we eerder de performanceimplicaties bespraken, helpt inzicht in de fundamentele verwerkingsmodellen te verklaren waarom de architecturen zo verschillen.
Hadoop MapReduce-framework
MapReduce volgt een strikt programmeerparadigma met twee primaire fasen: map en reduce. In de mapfase wordt een functie parallel op elk record toegepast en ontstaan intermediaire key-valueparen.
Deze paren ondergaan verplicht shufflen en sorteren, waarbij data met dezelfde keys wordt gegroepeerd.
Tot slot aggregeert de reducefase deze gegroepeerde waarden om de uiteindelijke output te produceren. Door deze gestructureerde aanpak vereisen complexe operaties het aaneenrijgen van meerdere MapReduce-jobs.
Het ontwikkelen van MapReduce-applicaties betekent doorgaans low-level code schrijven waarin je de map- en reducefuncties expliciet definieert.
Hoewel frameworks zoals Apache Pig en Apache Hive hogere abstracties bieden, blijft de onderliggende uitvoering het strikte MapReduce-patroon volgen, wat beperkingen oplegt aan algoritmeontwerp en optimalisatiemogelijkheden.
Het dataverwerkingsmodel van Spark
Spark introduceerde Resilient Distributed Datasets (RDD’s) als kernabstractie — onveranderlijke, gepartitioneerde collecties die hun herkomst kunnen bijhouden voor herstel. In tegenstelling tot MapReduce dwingt Spark geen star patroon af, maar biedt het twee typen operaties: transformaties (maken nieuwe RDD’s) en acties (geven waarden terug).
Die flexibiliteit maakt uiteenlopende verwerkingspatronen mogelijk buiten het map-reduceparadigma.
Spark is verder geëvolueerd voorbij RDD’s met hogere abstracties zoals DataFrames en Datasets, die schema-bewuste verwerking bieden met optimalisaties vergelijkbaar met relationele databases. Deze abstracties, gecombineerd met gespecialiseerde libraries voor streaming, SQL, machine learning en graafverwerking, stellen developers in staat om complexe workflows met aanzienlijk minder code uit te drukken dan equivalente MapReduce-implementaties, terwijl één programmeermodel behouden blijft over verschillende verwerkingsparadigma’s.
Spark vs Hadoop: kostenoverwegingen
Bij het beoordelen van bigdataframeworks moeten organisaties niet alleen naar technische mogelijkheden kijken, maar ook naar de financiële implicaties van deployment en operatie.
Hardwarevereisten en implicaties
Hadoop en Spark hebben fundamenteel verschillende hardwarevoorkeuren die de infrastructuurkosten beïnvloeden. Hadoop is ontworpen met prioriteit voor schijfopslag boven geheugen, waardoor het goed past bij commodityhardware met beperkt RAM maar veel schijfruimte.
Deze architectuur kan de initiële hardware-investering verlagen, zeker bij verwerking van extreem grote datasets waarbij geheugenoplossingen onbetaalbaar zouden zijn.
Het in-memoryverwerkingsmodel van Spark levert performancewinst op, maar vereist aanzienlijk meer RAM per node. Een goed geconfigureerd Spark-cluster vraagt doorgaans om servers met veel geheugen — vaak 16GB tot 256GB per node, afhankelijk van de workload.
Hoewel geheugenkosten in de tijd zijn gedaald, kan deze eis de hardwarekosten nog steeds verhogen vergeleken met schijfgerichte Hadoop-deployments.
Operationele uitgaven
Operationele kosten gaan verder dan hardwareaanschaf en omvatten doorlopend onderhoud, elektriciteit, koeling en datacenterplek. Hadoop-clusters hebben vaak een grotere fysieke footprint door het gebruik van talrijke commodityservers met veel opslag.
Die grotere footprint vertaalt zich in hogere kosten voor stroom, koeling en rackruimte.
Spark-clusters kunnen soms dezelfde verwerkingscapaciteit behalen met minder nodes dankzij efficiënter gebruik van compute, wat de datacenterfootprint en bijbehorende kosten kan verlagen. De zwaardere machines per node kunnen echter meer stroom verbruiken, wat deze besparingen deels teniet kan doen.
Ontwikkelings- en personeelskosten
De complexiteit van implementatie en onderhoud kan de totale eigendomskosten sterk beïnvloeden. Het Hadoop-ecosysteem vroeg traditioneel om gespecialiseerde expertise in Java-programmering en Unix-beheer, met langere ontwikkelcycli door de breedsprakige aard van MapReduce-programmering.
Spark biedt toegankelijkere API’s in Python, Scala, R en Java, wat de ontwikkelingstijd en bijbehorende personeelskosten kan verlagen.
Het intuïtievere programmeermodel kan zowel de leercurve als de doorlooptijd verkleinen, waardoor organisaties sneller oplossingen implementeren met minder gespecialiseerde medewerkers.
Kostenoptimalisatiestrategieën
Voor kostenbewuste organisaties bieden hybride aanpakken vaak de beste waarde. HDFS gebruiken voor opslag en Spark voor verwerking combineert de kostenefficiënte opslag van Hadoop met de verwerkingskracht van Spark. Clouddeployments op diensten als AWS EMR, Azure HDInsight of Google Dataproc laten organisaties betalen naar gebruik zonder grote kapitaalsinvesteringen vooraf.
Organisaties moeten ook schaalbaarheidskosten meenemen. Hadoop vereist traditioneel handmatige interventie bij schalen, wat operationele overhead toevoegt. De compatibiliteit van Spark met containerorkestratieplatforms zoals Kubernetes maakt meer geautomatiseerde, elastische schaalbaarheid mogelijk die resourceprovisioning beter laat aansluiten op de werkelijke vraag, wat verspilde capaciteit kan verminderen.
Hadoop vs Spark: vergelijkingstabel
Hier is een vergelijkingstabel met de belangrijkste verschillen:
Kenmerk
Hadoop
Spark
Verwerkingsmodel
Batchverwerking met MapReduce
In-memoryverwerking met RDD’s, DataFrames en Datasets
Performance
Trager door schijf-I/O tussen stappen
Tot 100x sneller voor iteratieve en in-memory workloads
Geheugengebruik
Schijfgericht, lage geheugeneisen
Geheugenintensief, hoge RAM-eisen
Ontwikkelgemak
Breedsprakig; map- & reducelogica expliciet schrijven
High-level API’s in Python, Scala, R, Java; minder boilerplate
Fouttolerantie
Datareplicatie via HDFS
RDD-lineage maakt herberekening mogelijk bij falen
Realtimeverwerking
Niet ideaal; alleen batch
Ondersteunt realtimeverwerking via Spark Streaming
Clusterbeheer
YARN
Standalone, YARN, Mesos of Kubernetes
Opslag
Wordt geleverd met HDFS
Afhankelijk van externe opslag (bijv. HDFS, S3, GCS)
Kosten
Lagere hardwarekosten (commoditymachines, schijfgebaseerd)
Hogere geheugenkosten maar betere resourcebenutting per workload
Beste voor
Batchjobs, opslag op zeer grote schaal, historische data-analyse
Machine learning, streamverwerking, interactieve analytics
Integratie
Sterk Hadoop-ecosysteem (Hive, Pig, enz.)
Uniforme API’s voor SQL, MLlib, GraphX en Streaming in één platform
Conclusie
Hadoop en Spark zijn eerder complementaire benaderingen van bigdataverwerking dan strikte concurrenten. Hadoop blinkt uit met zijn kostenefficiënte opslagsysteem (HDFS) en batchgerichte verwerking voor enorme datasets waarbij throughput zwaarder weegt dan snelheid.
Spark schittert met in-memoryverwerking die superieure prestaties levert voor iteratieve algoritmes, interactieve analytics en realtimebehoeften.
DataCamp biedt diverse resources als je meer wilt leren over deze technologieën: