Hadoop dan Spark adalah dua framework paling menonjol di ranah big data, namun keduanya menangani pemrosesan data skala besar dengan cara yang sangat berbeda. Jika Hadoop berjasa mendemokratisasi paradigma komputasi terdistribusi melalui sistem penyimpanan tangguh bernama HDFS dan model komputasi bernama MapReduce, Spark menghadirkan perubahan besar dengan arsitektur in-memory dan model pemrograman yang fleksibel.
Tutorial ini membahas secara mendalam perbedaan antara Hadoop dan Spark, termasuk arsitektur, performa, pertimbangan biaya, dan integrasinya. Pada akhirnya, pembaca akan memiliki pemahaman yang jelas tentang kelebihan dan kekurangan masing-masing, serta jenis use case di mana tiap framework unggul; pemahaman ini akan membantu Anda membuat keputusan strategis saat membangun solusi big data.
Memahami Hadoop dan Spark
Sebelum masuk ke detail spesifik, mari telusuri konsep dasar dan asal-usul Hadoop dan Spark untuk memahami bagaimana kedua framework tangguh ini menghadapi tantangan big data.
Apa itu Hadoop?
Hadoop adalah framework open-source yang dirancang untuk menyimpan dan memproses dataset besar di seluruh klaster komputer. Sejak dikembangkan pada 2006, Hadoop memungkinkan organisasi menangani volume data masif yang akan membebani satu mesin. Dengan mendistribusikan data ke banyak node, Hadoop tidak hanya meningkatkan kemampuan pemrosesan tetapi juga menyediakan redundansi, memastikan keandalan sistem bahkan saat mesin individual gagal.
Komponen utama dalam framework Hadoop meliputi:
- Hadoop Distributed File System (HDFS): Menjadi fondasi penyimpanan, membagi berkas menjadi blok dan mendistribusikannya ke seluruh klaster.
- MapReduce: Menangani pemrosesan dengan memecah tugas komputasi menjadi unit-unit kecil yang berjalan paralel di seluruh klaster.
- YARN (Yet Another Resource Negotiator): Mengelola sumber daya secara efisien dengan mengalokasikan daya komputasi dan menjadwalkan tugas di seluruh mesin yang tersedia.
Salah satu keunggulan utama Hadoop adalah efektivitas biayanya, karena memungkinkan organisasi menggunakan perangkat keras standar/komoditas alih-alih peralatan khusus yang mahal. Pendekatan praktis ini juga tercermin dalam filosofi pemrosesannya.
Desain Hadoop yang berorientasi batch unggul dalam skenario di mana throughput keseluruhan lebih penting daripada kecepatan pemrosesan mentah, sehingga sangat berharga untuk analisis data historis dan operasi ETL (Extract, Transform, Load) yang tidak memerlukan hasil langsung.
Apa itu Apache Spark?
Apache Spark muncul pada 2010 sebagai respons terhadap keterbatasan pendekatan Hadoop untuk pemrosesan big data. Awalnya dikembangkan di UC Berkeley sebelum menjadi proyek Apache, Spark mengatasi ketergantungan berat Hadoop MapReduce pada operasi disk. Inovasi terobosannya adalah menerapkan komputasi in-memory, yang secara drastis mengurangi waktu pemrosesan untuk banyak beban kerja data dengan meminimalkan kebutuhan baca/tulis ke disk.
Spark menyediakan platform terpadu dengan beberapa komponen yang terintegrasi erat di sekitar mesin pemrosesan intinya:
- Spark SQL: Untuk bekerja dengan data terstruktur
- MLlib: Untuk mengimplementasikan algoritma machine learning
- GraphX: Untuk memproses data graf
- Spark Streaming: Untuk menganalisis data secara real time
Desain yang kohesif ini memungkinkan tim mengatasi beragam tantangan data menggunakan satu framework alih-alih mengelola banyak alat khusus.
Meski berbeda, Spark dan Hadoop sering kali bekerja bersama sebagai teknologi yang saling melengkapi, bukan pesaing. Karena Spark tidak menyertakan sistem penyimpanannya sendiri, Spark lazim mengandalkan HDFS Hadoop untuk penyimpanan data persisten.
Selain itu, Spark dapat berjalan di pengelola sumber daya YARN milik Hadoop, sehingga memudahkan organisasi meningkatkan lingkungan Hadoop yang ada dengan daya pemrosesan Spark. Kompatibilitas ini menciptakan jalur peningkatan yang praktis, memungkinkan bisnis mengadopsi keunggulan Spark tanpa meninggalkan investasi infrastruktur Hadoop mereka.
Saat mengevaluasi framework big data, performa sering menjadi faktor penentu bagi organisasi dengan kebutuhan pemrosesan data yang sensitif terhadap waktu.
Kecepatan pemrosesan
MapReduce pada Hadoop beroperasi sebagai sistem pemrosesan berbasis disk: membaca data dari disk, memprosesnya, dan menulis hasil kembali ke disk di antara setiap tahap komputasi. I/O disk ini menciptakan latensi signifikan, terutama untuk algoritma iteratif yang membutuhkan banyak lintasan atas data yang sama.
Meskipun efektif untuk pemrosesan batch atas dataset masif, pendekatan ini mengorbankan kecepatan demi keandalan dan throughput.
Sebaliknya, Spark melakukan komputasi terutama di memori, sehingga secara drastis mengurangi kebutuhan operasi disk. Untuk banyak beban kerja, khususnya algoritma iteratif seperti yang digunakan dalam machine learning, Spark dapat mengeksekusi tugas hingga 100 kali lebih cepat dibanding Hadoop MapReduce.
Keunggulan performa ini semakin terasa ketika pemrosesan harus terjadi hampir real time atau ketika algoritma memerlukan banyak lintasan melalui dataset yang sama.
Pemanfaatan memori
Desain Hadoop mengasumsikan ketersediaan memori terbatas, menjadikannya hemat memori namun lebih lambat. Hadoop sangat bergantung pada penyimpanan disk, yang memungkinkannya memproses dataset yang jauh lebih besar daripada RAM yang tersedia dengan terus menukar data antara memori dan disk.
Pendekatan ini membuat Hadoop cocok untuk memproses dataset yang sangat besar pada klaster dengan sumber daya memori terbatas.
Keunggulan performa Spark berasal dari pemanfaatan memori yang agresif. Dengan melakukan caching data di RAM di seluruh tahap pemrosesan, Spark menghilangkan operasi disk yang mahal. Namun, ini memerlukan sumber daya memori yang cukup untuk menampung dataset kerja.
Saat muncul kendala memori, keunggulan performa Spark menurun karena mulai menumpahkan data ke disk, meskipun manajemen memorinya yang cerdas biasanya masih mengungguli pendekatan Hadoop yang mengutamakan disk.
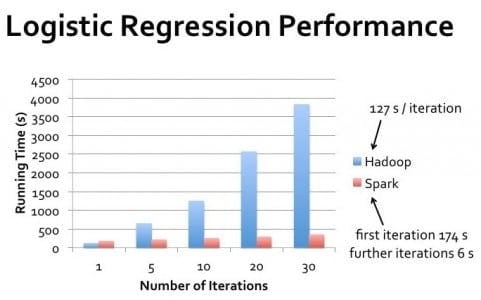
Kesenjangan performa di dunia nyata antara Hadoop dan Spark sangat bervariasi bergantung pada use case spesifik. Untuk pemrosesan batch satu lintasan atas dataset masif di mana data jauh melampaui memori yang tersedia, performa Hadoop dapat mendekati Spark.
Namun, untuk pemrosesan iteratif, kueri interaktif, dan pemrosesan aliran, Spark secara konsisten memberikan performa yang lebih unggul.
Perlu dicatat bahwa performa tidak semata-mata soal kecepatan mentah. Hadoop unggul dalam skenario yang memerlukan toleransi kesalahan tinggi dan di mana pemrosesan dapat dilakukan dalam jendela batch yang jelas.
Spark berkinerja terbaik saat hasil cepat dibutuhkan, seperti eksplorasi data interaktif, analitik real time, dan aplikasi machine learning di mana algoritma melakukan banyak lintasan atas dataset.
Manajemen Klaster: Klaster Hadoop vs Klaster Spark
Baik Hadoop maupun Spark bergantung pada klaster untuk memproses volume data besar secara efisien, tetapi keduanya mengelola sumber daya ini dengan cara yang berbeda, yang berdampak pada performa dan administrasi.
Apa itu clustering dan mengapa dibutuhkan
Klaster adalah kumpulan komputer (node) yang saling terhubung dan bekerja bersama sebagai satu sistem. Dalam pemrosesan big data, clustering menjadi perlu ketika volume data melampaui kemampuan yang dapat ditangani secara efisien oleh satu mesin. Dengan mendistribusikan beban kerja komputasi ke beberapa mesin, klaster memungkinkan organisasi memproses petabyte data yang sebaliknya mustahil untuk dikelola.
Clustering juga menyediakan toleransi kesalahan dan ketersediaan tinggi. Jika satu mesin gagal, mesin lain dalam klaster dapat mengambil alih beban kerjanya, memastikan operasi berkelanjutan. Ketahanan ini sangat penting untuk lingkungan produksi di mana downtime dapat mengakibatkan biaya besar.
Selain itu, clustering memungkinkan penskalaan horizontal—menambah lebih banyak mesin untuk meningkatkan daya pemrosesan—yang sering kali lebih hemat biaya dibanding meningkatkan spesifikasi tiap sistem secara individual.
Bagi calon profesional di bidang ini, memahami clustering adalah keterampilan fundamental dalam data engineering.
Arsitektur klaster Hadoop
Klaster Hadoop mengikuti arsitektur master-slave dengan peran khusus untuk setiap node. NameNode berfungsi sebagai master untuk HDFS, menjaga metadata tentang lokasi berkas dan izin. DataNode menyimpan blok data aktual dan melapor ke NameNode.
Untuk pemrosesan, ResourceManager mengalokasikan sumber daya klaster, sementara NodeManager pada masing-masing mesin mengeksekusi tugas.
HDFS mereplikasi data di beberapa DataNode, biasanya mempertahankan tiga salinan untuk setiap blok data. Strategi replikasi ini memastikan ketersediaan data bahkan jika node individual gagal, meski membutuhkan kapasitas penyimpanan tambahan.
Desain klaster Hadoop menekankan localitas data, berupaya menjadwalkan tugas komputasi pada node yang sama tempat data berada untuk meminimalkan transfer jaringan.
Administrasi klaster Hadoop secara tradisional memerlukan keahlian tinggi (para profesional kerap mempersiapkan pertanyaan wawancara Hadoop untuk menunjukkan pengetahuan ini), meski distribusi modern menyertakan alat manajemen untuk menyederhanakan konfigurasi dan pemantauan.
Menskalakan klaster Hadoop melibatkan penambahan node baru dan penyeimbangan ulang data di infrastruktur yang diperluas, yang bisa menjadi proses manual yang membutuhkan perencanaan matang.
Arsitektur klaster Spark
Spark dapat beroperasi dalam berbagai konfigurasi klaster, termasuk mode standalone, di Hadoop YARN, Apache Mesos, atau Kubernetes. Dalam semua penerapan, Spark mengikuti model driver-executor. Program driver berisi fungsi utama aplikasi dan membuat SparkContext yang berkoordinasi dengan pengelola klaster untuk mengalokasikan sumber daya.
Setelah sumber daya dialokasikan, executor Spark dijalankan pada worker node. Executor ini adalah proses JVM yang menjalankan tugas dan menyimpan data di memori atau disk. Berbeda dengan Hadoop, yang mempertahankan kehadiran persisten pada node klaster, executor Spark dapat dialokasikan dan dilepas secara dinamis sesuai kebutuhan aplikasi, berpotensi meningkatkan pemanfaatan sumber daya.
Pembaca yang tertarik dapat mengeksplorasi kapabilitas Spark lebih lanjut melalui tutorial praktis seperti Apache Spark for Machine Learning.
Spark tidak menyertakan sistem penyimpanan terdistribusi sendiri, melainkan memanfaatkan solusi yang ada seperti HDFS, Amazon S3, atau sistem penyimpanan kompatibel lainnya. Pemisahan arsitektur antara komputasi dan penyimpanan ini memberikan fleksibilitas namun memerlukan konfigurasi cermat untuk memastikan pola akses data yang optimal.
Alat seperti Spark SQL dan sparklyr menawarkan cara yang mudah untuk berinteraksi dengan arsitektur ini.
Perbedaan kunci dalam manajemen klaster
Pendekatan Hadoop terhadap manajemen klaster lebih berfokus pada infrastruktur, dengan alokasi sumber daya yang relatif statis dan fokus pada localitas data. Desain ini bekerja dengan baik untuk job batch jangka panjang pada klaster yang stabil di mana node jarang berubah.
Namun, pendekatan ini bisa kurang responsif terhadap beban kerja yang berfluktuasi dan memerlukan lebih banyak intervensi manual saat melakukan penskalaan.
Spark menawarkan manajemen sumber daya yang lebih dinamis, terutama saat berjalan di platform orkestrasi modern seperti Kubernetes. Spark dapat menyesuaikan alokasi sumber daya berdasarkan permintaan saat ini dan melepaskan sumber daya saat tidak dibutuhkan.
Elastisitas ini bernilai bagi organisasi dengan beban kerja yang berfluktuasi atau infrastruktur bersama yang melayani banyak aplikasi.
Memahami perbedaan ini penting bagi para profesional yang mengejar sertifikasi Data Engineer atau bersiap menghadapi pertanyaan wawancara Spark.
Bagi organisasi yang baru memulai dengan big data, opsi penerapan Spark yang lebih fleksibel dan model pemrograman yang lebih sederhana sering kali memudahkan untuk memulai.
Namun, di lingkungan dengan volume data yang sangat besar di mana manajemen penyimpanan menjadi perhatian utama, ekosistem HDFS Hadoop yang matang masih menawarkan keunggulan yang melengkapi kapabilitas pemrosesan Spark. Untuk perbandingan Spark dengan teknologi streaming lainnya, pembaca mungkin menemukan perbandingan seperti Flink vs. Spark bermanfaat.
Hadoop MapReduce vs. Model Pemrosesan Spark
Walau bagian sebelumnya membahas implikasi performa, memahami model pemrosesan fundamental dari masing-masing framework membantu menjelaskan mengapa arsitekturnya sangat berbeda.
Framework Hadoop MapReduce
MapReduce mengikuti paradigma pemrograman yang kaku dengan dua fase utama: map dan reduce. Fase map menerapkan fungsi pada setiap rekaman secara paralel, menghasilkan pasangan key-value perantara.
Pasangan ini menjalani fase pengacakan dan pengurutan wajib, di mana data dengan key yang sama dikelompokkan.
Terakhir, fase reduce mengagregasi nilai yang sudah dikelompokkan untuk menghasilkan output akhir. Pendekatan terstruktur ini membuat operasi kompleks memerlukan perangkaian beberapa job MapReduce.
Mengembangkan aplikasi MapReduce biasanya melibatkan penulisan kode tingkat rendah yang secara eksplisit mendefinisikan fungsi mapping dan reducing.
Meski framework seperti Apache Pig dan Apache Hive menyediakan abstraksi tingkat lebih tinggi, eksekusi mendasarnya tetap mengikuti pola MapReduce yang ketat, sehingga membatasi desain algoritma dan peluang optimasi.
Model pemrosesan data Spark
Spark memperkenalkan Resilient Distributed Datasets (RDD) sebagai abstraksi intinya—koleksi yang immutable dan terpartisi yang dapat melacak lineage untuk pemulihan. Berbeda dengan MapReduce, Spark tidak memberlakukan pola pemrosesan yang kaku, melainkan menawarkan dua jenis operasi: transformasi (yang membuat RDD baru) dan aksi (yang mengembalikan nilai).
Fleksibilitas ini memungkinkan pola pemrosesan yang beragam di luar paradigma map-reduce.
Spark telah berevolusi melampaui RDD dengan menawarkan abstraksi tingkat lebih tinggi seperti DataFrame dan Dataset, yang menyediakan pemrosesan berbasis skema dengan optimasi mirip database relasional. Abstraksi ini, dikombinasikan dengan pustaka khusus untuk streaming, SQL, machine learning, dan pemrosesan graf, memungkinkan pengembang mengekspresikan alur kerja kompleks dengan kode yang jauh lebih sedikit dibanding implementasi MapReduce setara, sembari mempertahankan model pemrograman terpadu di berbagai paradigma pemrosesan.
Pertimbangan Biaya Spark vs Hadoop
Saat mengevaluasi framework big data, organisasi harus mempertimbangkan bukan hanya kapabilitas teknis tetapi juga implikasi finansial dari penerapan dan operasionalnya.
Kebutuhan perangkat keras dan implikasinya
Hadoop dan Spark memiliki preferensi perangkat keras yang secara fundamental berbeda dan berdampak pada biaya infrastruktur. Hadoop dirancang untuk memprioritaskan penyimpanan disk dibanding memori, sehingga cocok untuk perangkat keras komoditas dengan RAM terbatas namun kapasitas hard drive besar.
Arsitektur ini dapat mengurangi investasi perangkat keras awal, terutama saat memproses dataset yang sangat besar di mana solusi berbasis memori akan sangat mahal.
Model pemrosesan in-memory Spark memberikan manfaat performa namun memerlukan RAM yang jauh lebih besar per node. Klaster Spark yang dikonfigurasi dengan baik umumnya menuntut server dengan konfigurasi memori besar—sering kali 16GB hingga 256GB per node tergantung karakteristik beban kerja.
Meskipun biaya memori telah menurun seiring waktu, kebutuhan ini tetap dapat meningkatkan biaya perangkat keras dibanding penerapan Hadoop yang berfokus pada disk.
Biaya operasional
Biaya operasional melampaui pengadaan perangkat keras hingga mencakup pemeliharaan berkelanjutan, listrik, pendinginan, dan ruang pusat data. Klaster Hadoop cenderung memiliki jejak fisik lebih besar karena ketergantungannya pada banyak server komoditas dengan penyimpanan luas.
Jejak yang lebih besar ini berujung pada biaya lebih tinggi untuk daya, pendinginan, dan ruang rak.
Klaster Spark terkadang dapat mencapai kapabilitas pemrosesan yang sama dengan lebih sedikit node karena pemanfaatan sumber daya komputasi yang lebih efisien, berpotensi mengurangi jejak pusat data dan biaya terkait. Namun, mesin dengan spesifikasi lebih tinggi yang dibutuhkan dapat mengonsumsi daya lebih besar per node, yang sebagian mengimbangi penghematan ini.
Biaya pengembangan dan personel
Kompleksitas implementasi dan pemeliharaan dapat berdampak signifikan pada total biaya kepemilikan. Ekosistem Hadoop secara tradisional memerlukan keahlian khusus dalam pemrograman Java dan administrasi Unix, dengan siklus pengembangan yang bisa panjang karena sifat MapReduce yang verbose.
Spark menawarkan API yang lebih mudah diakses dalam Python, Scala, R, dan Java, yang berpotensi mengurangi waktu pengembangan dan biaya personel terkait.
Model pemrograman yang lebih intuitif dapat menurunkan kurva pembelajaran dan waktu pengembangan, memungkinkan organisasi menerapkan solusi lebih cepat dengan personel yang kurang terspesialisasi.
Strategi optimasi biaya
Bagi organisasi yang sensitif terhadap biaya, pendekatan hibrida sering kali memberikan nilai terbaik. Menggunakan HDFS untuk penyimpanan sambil memanfaatkan Spark untuk pemrosesan dapat menggabungkan penyimpanan hemat biaya Hadoop dengan efisiensi pemrosesan Spark. Penerapan berbasis cloud pada layanan seperti AWS EMR, Azure HDInsight, atau Google Dataproc memungkinkan organisasi hanya membayar sumber daya yang digunakan tanpa belanja modal awal yang besar.
Organisasi juga harus mempertimbangkan biaya skalabilitas. Hadoop secara tradisional memerlukan intervensi manual untuk penskalaan, yang menambah overhead operasional. Kompatibilitas Spark dengan platform orkestrasi kontainer seperti Kubernetes memungkinkan penskalaan yang lebih otomatis dan elastis yang dapat lebih selaras antara penyediaan sumber daya dan permintaan aktual, sehingga berpotensi mengurangi kapasitas yang terbuang.
Tabel Perbandingan Hadoop vs Spark
Berikut tabel perbandingan yang merangkum perbedaannya:
|
Fitur
|
Hadoop
|
Spark
|
|
Model Pemrosesan
|
Pemrosesan batch menggunakan MapReduce
|
Pemrosesan in-memory menggunakan RDD, DataFrame, dan Dataset
|
|
Performa
|
Lebih lambat karena I/O disk antar tahap
|
Hingga 100x lebih cepat untuk beban kerja iteratif dan in-memory
|
|
Penggunaan Memori
|
Berbasis disk, kebutuhan memori rendah
|
Intensif memori, kebutuhan RAM tinggi
|
|
Kemudahan Pengembangan
|
Verbose; perlu menulis logika map & reduce secara eksplisit
|
API tingkat tinggi di Python, Scala, R, Java; lebih sedikit boilerplate
|
|
Toleransi Kesalahan
|
Replikasi data melalui HDFS
|
Lineage RDD memungkinkan perhitungan ulang saat kegagalan
|
|
Pemrosesan Real-time
|
Tidak ideal; hanya batch
|
Mendukung pemrosesan real-time melalui Spark Streaming
|
|
Pengelola Klaster
|
YARN
|
Standalone, YARN, Mesos, atau Kubernetes
|
|
Penyimpanan
|
Disertai HDFS
|
Bergantung pada penyimpanan eksternal (mis., HDFS, S3, GCS)
|
|
Biaya
|
Biaya perangkat keras lebih rendah (mesin komoditas, berbasis disk)
|
Biaya memori lebih tinggi namun pemanfaatan sumber daya per beban kerja lebih baik
|
|
Terbaik Untuk
|
Job batch, penyimpanan skala masif, analisis data historis
|
Machine learning, pemrosesan stream, analitik interaktif
|
|
Integrasi
|
Ekosistem Hadoop yang kuat (Hive, Pig, dll.)
|
API terpadu untuk SQL, MLlib, GraphX, dan Streaming dalam satu platform
|
Kesimpulan
Hadoop dan Spark merepresentasikan pendekatan yang saling melengkapi terhadap pemrosesan big data, bukan pesaing ketat. Hadoop unggul dengan sistem penyimpanan hemat biayanya (HDFS) dan pemrosesan berorientasi batch untuk dataset masif di mana throughput lebih penting daripada kecepatan.
Spark hebat dengan kapabilitas pemrosesan in-memory yang memberikan performa unggul untuk algoritma iteratif, analitik interaktif, dan kebutuhan pemrosesan real time.
DataCamp menawarkan berbagai sumber daya jika Anda ingin mempelajari lebih lanjut tentang kedua teknologi ini:




Hadoop dan Spark adalah dua framework paling menonjol di ranah big data, namun keduanya menangani pemrosesan data skala besar dengan cara yang sangat berbeda. Jika Hadoop berjasa mendemokratisasi paradigma komputasi terdistribusi melalui sistem penyimpanan tangguh bernama HDFS dan model komputasi bernama MapReduce, Spark menghadirkan perubahan besar dengan arsitektur in-memory dan model pemrograman yang fleksibel.
Tutorial ini membahas secara mendalam perbedaan antara Hadoop dan Spark, termasuk arsitektur, performa, pertimbangan biaya, dan integrasinya. Pada akhirnya, pembaca akan memiliki pemahaman yang jelas tentang kelebihan dan kekurangan masing-masing, serta jenis use case di mana tiap framework unggul; pemahaman ini akan membantu Anda membuat keputusan strategis saat membangun solusi big data.
Memahami Hadoop dan Spark
Sebelum masuk ke detail spesifik, mari telusuri konsep dasar dan asal-usul Hadoop dan Spark untuk memahami bagaimana kedua framework tangguh ini menghadapi tantangan big data.
Apa itu Hadoop?
Hadoop adalah framework open-source yang dirancang untuk menyimpan dan memproses dataset besar di seluruh klaster komputer. Sejak dikembangkan pada 2006, Hadoop memungkinkan organisasi menangani volume data masif yang akan membebani satu mesin. Dengan mendistribusikan data ke banyak node, Hadoop tidak hanya meningkatkan kemampuan pemrosesan tetapi juga menyediakan redundansi, memastikan keandalan sistem bahkan saat mesin individual gagal.
Komponen utama dalam framework Hadoop meliputi:
Salah satu keunggulan utama Hadoop adalah efektivitas biayanya, karena memungkinkan organisasi menggunakan perangkat keras standar/komoditas alih-alih peralatan khusus yang mahal. Pendekatan praktis ini juga tercermin dalam filosofi pemrosesannya.
Desain Hadoop yang berorientasi batch unggul dalam skenario di mana throughput keseluruhan lebih penting daripada kecepatan pemrosesan mentah, sehingga sangat berharga untuk analisis data historis dan operasi ETL (Extract, Transform, Load) yang tidak memerlukan hasil langsung.
Apa itu Apache Spark?
Apache Spark muncul pada 2010 sebagai respons terhadap keterbatasan pendekatan Hadoop untuk pemrosesan big data. Awalnya dikembangkan di UC Berkeley sebelum menjadi proyek Apache, Spark mengatasi ketergantungan berat Hadoop MapReduce pada operasi disk. Inovasi terobosannya adalah menerapkan komputasi in-memory, yang secara drastis mengurangi waktu pemrosesan untuk banyak beban kerja data dengan meminimalkan kebutuhan baca/tulis ke disk.
Spark menyediakan platform terpadu dengan beberapa komponen yang terintegrasi erat di sekitar mesin pemrosesan intinya:
Desain yang kohesif ini memungkinkan tim mengatasi beragam tantangan data menggunakan satu framework alih-alih mengelola banyak alat khusus.
Meski berbeda, Spark dan Hadoop sering kali bekerja bersama sebagai teknologi yang saling melengkapi, bukan pesaing. Karena Spark tidak menyertakan sistem penyimpanannya sendiri, Spark lazim mengandalkan HDFS Hadoop untuk penyimpanan data persisten.
Selain itu, Spark dapat berjalan di pengelola sumber daya YARN milik Hadoop, sehingga memudahkan organisasi meningkatkan lingkungan Hadoop yang ada dengan daya pemrosesan Spark. Kompatibilitas ini menciptakan jalur peningkatan yang praktis, memungkinkan bisnis mengadopsi keunggulan Spark tanpa meninggalkan investasi infrastruktur Hadoop mereka.
Perbandingan Performa Hadoop vs Spark
Saat mengevaluasi framework big data, performa sering menjadi faktor penentu bagi organisasi dengan kebutuhan pemrosesan data yang sensitif terhadap waktu.
Kecepatan pemrosesan
MapReduce pada Hadoop beroperasi sebagai sistem pemrosesan berbasis disk: membaca data dari disk, memprosesnya, dan menulis hasil kembali ke disk di antara setiap tahap komputasi. I/O disk ini menciptakan latensi signifikan, terutama untuk algoritma iteratif yang membutuhkan banyak lintasan atas data yang sama.
Meskipun efektif untuk pemrosesan batch atas dataset masif, pendekatan ini mengorbankan kecepatan demi keandalan dan throughput.
Sebaliknya, Spark melakukan komputasi terutama di memori, sehingga secara drastis mengurangi kebutuhan operasi disk. Untuk banyak beban kerja, khususnya algoritma iteratif seperti yang digunakan dalam machine learning, Spark dapat mengeksekusi tugas hingga 100 kali lebih cepat dibanding Hadoop MapReduce.
Keunggulan performa ini semakin terasa ketika pemrosesan harus terjadi hampir real time atau ketika algoritma memerlukan banyak lintasan melalui dataset yang sama.
Pemanfaatan memori
Desain Hadoop mengasumsikan ketersediaan memori terbatas, menjadikannya hemat memori namun lebih lambat. Hadoop sangat bergantung pada penyimpanan disk, yang memungkinkannya memproses dataset yang jauh lebih besar daripada RAM yang tersedia dengan terus menukar data antara memori dan disk.
Pendekatan ini membuat Hadoop cocok untuk memproses dataset yang sangat besar pada klaster dengan sumber daya memori terbatas.
Keunggulan performa Spark berasal dari pemanfaatan memori yang agresif. Dengan melakukan caching data di RAM di seluruh tahap pemrosesan, Spark menghilangkan operasi disk yang mahal. Namun, ini memerlukan sumber daya memori yang cukup untuk menampung dataset kerja.
Saat muncul kendala memori, keunggulan performa Spark menurun karena mulai menumpahkan data ke disk, meskipun manajemen memorinya yang cerdas biasanya masih mengungguli pendekatan Hadoop yang mengutamakan disk.
Pertimbangan performa di dunia nyata
Kesenjangan performa di dunia nyata antara Hadoop dan Spark sangat bervariasi bergantung pada use case spesifik. Untuk pemrosesan batch satu lintasan atas dataset masif di mana data jauh melampaui memori yang tersedia, performa Hadoop dapat mendekati Spark.
Namun, untuk pemrosesan iteratif, kueri interaktif, dan pemrosesan aliran, Spark secara konsisten memberikan performa yang lebih unggul.
Perlu dicatat bahwa performa tidak semata-mata soal kecepatan mentah. Hadoop unggul dalam skenario yang memerlukan toleransi kesalahan tinggi dan di mana pemrosesan dapat dilakukan dalam jendela batch yang jelas.
Spark berkinerja terbaik saat hasil cepat dibutuhkan, seperti eksplorasi data interaktif, analitik real time, dan aplikasi machine learning di mana algoritma melakukan banyak lintasan atas dataset.
Manajemen Klaster: Klaster Hadoop vs Klaster Spark
Baik Hadoop maupun Spark bergantung pada klaster untuk memproses volume data besar secara efisien, tetapi keduanya mengelola sumber daya ini dengan cara yang berbeda, yang berdampak pada performa dan administrasi.
Apa itu clustering dan mengapa dibutuhkan
Klaster adalah kumpulan komputer (node) yang saling terhubung dan bekerja bersama sebagai satu sistem. Dalam pemrosesan big data, clustering menjadi perlu ketika volume data melampaui kemampuan yang dapat ditangani secara efisien oleh satu mesin. Dengan mendistribusikan beban kerja komputasi ke beberapa mesin, klaster memungkinkan organisasi memproses petabyte data yang sebaliknya mustahil untuk dikelola.
Clustering juga menyediakan toleransi kesalahan dan ketersediaan tinggi. Jika satu mesin gagal, mesin lain dalam klaster dapat mengambil alih beban kerjanya, memastikan operasi berkelanjutan. Ketahanan ini sangat penting untuk lingkungan produksi di mana downtime dapat mengakibatkan biaya besar.
Selain itu, clustering memungkinkan penskalaan horizontal—menambah lebih banyak mesin untuk meningkatkan daya pemrosesan—yang sering kali lebih hemat biaya dibanding meningkatkan spesifikasi tiap sistem secara individual.
Bagi calon profesional di bidang ini, memahami clustering adalah keterampilan fundamental dalam data engineering.
Arsitektur klaster Hadoop
Klaster Hadoop mengikuti arsitektur master-slave dengan peran khusus untuk setiap node. NameNode berfungsi sebagai master untuk HDFS, menjaga metadata tentang lokasi berkas dan izin. DataNode menyimpan blok data aktual dan melapor ke NameNode.
Untuk pemrosesan, ResourceManager mengalokasikan sumber daya klaster, sementara NodeManager pada masing-masing mesin mengeksekusi tugas.
HDFS mereplikasi data di beberapa DataNode, biasanya mempertahankan tiga salinan untuk setiap blok data. Strategi replikasi ini memastikan ketersediaan data bahkan jika node individual gagal, meski membutuhkan kapasitas penyimpanan tambahan.
Desain klaster Hadoop menekankan localitas data, berupaya menjadwalkan tugas komputasi pada node yang sama tempat data berada untuk meminimalkan transfer jaringan.
Administrasi klaster Hadoop secara tradisional memerlukan keahlian tinggi (para profesional kerap mempersiapkan pertanyaan wawancara Hadoop untuk menunjukkan pengetahuan ini), meski distribusi modern menyertakan alat manajemen untuk menyederhanakan konfigurasi dan pemantauan.
Menskalakan klaster Hadoop melibatkan penambahan node baru dan penyeimbangan ulang data di infrastruktur yang diperluas, yang bisa menjadi proses manual yang membutuhkan perencanaan matang.
Arsitektur klaster Spark
Spark dapat beroperasi dalam berbagai konfigurasi klaster, termasuk mode standalone, di Hadoop YARN, Apache Mesos, atau Kubernetes. Dalam semua penerapan, Spark mengikuti model driver-executor. Program driver berisi fungsi utama aplikasi dan membuat SparkContext yang berkoordinasi dengan pengelola klaster untuk mengalokasikan sumber daya.
Setelah sumber daya dialokasikan, executor Spark dijalankan pada worker node. Executor ini adalah proses JVM yang menjalankan tugas dan menyimpan data di memori atau disk. Berbeda dengan Hadoop, yang mempertahankan kehadiran persisten pada node klaster, executor Spark dapat dialokasikan dan dilepas secara dinamis sesuai kebutuhan aplikasi, berpotensi meningkatkan pemanfaatan sumber daya.
Pembaca yang tertarik dapat mengeksplorasi kapabilitas Spark lebih lanjut melalui tutorial praktis seperti Apache Spark for Machine Learning.
Spark tidak menyertakan sistem penyimpanan terdistribusi sendiri, melainkan memanfaatkan solusi yang ada seperti HDFS, Amazon S3, atau sistem penyimpanan kompatibel lainnya. Pemisahan arsitektur antara komputasi dan penyimpanan ini memberikan fleksibilitas namun memerlukan konfigurasi cermat untuk memastikan pola akses data yang optimal.
Alat seperti Spark SQL dan sparklyr menawarkan cara yang mudah untuk berinteraksi dengan arsitektur ini.
Perbedaan kunci dalam manajemen klaster
Pendekatan Hadoop terhadap manajemen klaster lebih berfokus pada infrastruktur, dengan alokasi sumber daya yang relatif statis dan fokus pada localitas data. Desain ini bekerja dengan baik untuk job batch jangka panjang pada klaster yang stabil di mana node jarang berubah.
Namun, pendekatan ini bisa kurang responsif terhadap beban kerja yang berfluktuasi dan memerlukan lebih banyak intervensi manual saat melakukan penskalaan.
Spark menawarkan manajemen sumber daya yang lebih dinamis, terutama saat berjalan di platform orkestrasi modern seperti Kubernetes. Spark dapat menyesuaikan alokasi sumber daya berdasarkan permintaan saat ini dan melepaskan sumber daya saat tidak dibutuhkan.
Elastisitas ini bernilai bagi organisasi dengan beban kerja yang berfluktuasi atau infrastruktur bersama yang melayani banyak aplikasi.
Memahami perbedaan ini penting bagi para profesional yang mengejar sertifikasi Data Engineer atau bersiap menghadapi pertanyaan wawancara Spark.
Bagi organisasi yang baru memulai dengan big data, opsi penerapan Spark yang lebih fleksibel dan model pemrograman yang lebih sederhana sering kali memudahkan untuk memulai.
Namun, di lingkungan dengan volume data yang sangat besar di mana manajemen penyimpanan menjadi perhatian utama, ekosistem HDFS Hadoop yang matang masih menawarkan keunggulan yang melengkapi kapabilitas pemrosesan Spark. Untuk perbandingan Spark dengan teknologi streaming lainnya, pembaca mungkin menemukan perbandingan seperti Flink vs. Spark bermanfaat.
Hadoop MapReduce vs. Model Pemrosesan Spark
Walau bagian sebelumnya membahas implikasi performa, memahami model pemrosesan fundamental dari masing-masing framework membantu menjelaskan mengapa arsitekturnya sangat berbeda.
Framework Hadoop MapReduce
MapReduce mengikuti paradigma pemrograman yang kaku dengan dua fase utama: map dan reduce. Fase map menerapkan fungsi pada setiap rekaman secara paralel, menghasilkan pasangan key-value perantara.
Pasangan ini menjalani fase pengacakan dan pengurutan wajib, di mana data dengan key yang sama dikelompokkan.
Terakhir, fase reduce mengagregasi nilai yang sudah dikelompokkan untuk menghasilkan output akhir. Pendekatan terstruktur ini membuat operasi kompleks memerlukan perangkaian beberapa job MapReduce.
Mengembangkan aplikasi MapReduce biasanya melibatkan penulisan kode tingkat rendah yang secara eksplisit mendefinisikan fungsi mapping dan reducing.
Meski framework seperti Apache Pig dan Apache Hive menyediakan abstraksi tingkat lebih tinggi, eksekusi mendasarnya tetap mengikuti pola MapReduce yang ketat, sehingga membatasi desain algoritma dan peluang optimasi.
Model pemrosesan data Spark
Spark memperkenalkan Resilient Distributed Datasets (RDD) sebagai abstraksi intinya—koleksi yang immutable dan terpartisi yang dapat melacak lineage untuk pemulihan. Berbeda dengan MapReduce, Spark tidak memberlakukan pola pemrosesan yang kaku, melainkan menawarkan dua jenis operasi: transformasi (yang membuat RDD baru) dan aksi (yang mengembalikan nilai).
Fleksibilitas ini memungkinkan pola pemrosesan yang beragam di luar paradigma map-reduce.
Spark telah berevolusi melampaui RDD dengan menawarkan abstraksi tingkat lebih tinggi seperti DataFrame dan Dataset, yang menyediakan pemrosesan berbasis skema dengan optimasi mirip database relasional. Abstraksi ini, dikombinasikan dengan pustaka khusus untuk streaming, SQL, machine learning, dan pemrosesan graf, memungkinkan pengembang mengekspresikan alur kerja kompleks dengan kode yang jauh lebih sedikit dibanding implementasi MapReduce setara, sembari mempertahankan model pemrograman terpadu di berbagai paradigma pemrosesan.
Pertimbangan Biaya Spark vs Hadoop
Saat mengevaluasi framework big data, organisasi harus mempertimbangkan bukan hanya kapabilitas teknis tetapi juga implikasi finansial dari penerapan dan operasionalnya.
Kebutuhan perangkat keras dan implikasinya
Hadoop dan Spark memiliki preferensi perangkat keras yang secara fundamental berbeda dan berdampak pada biaya infrastruktur. Hadoop dirancang untuk memprioritaskan penyimpanan disk dibanding memori, sehingga cocok untuk perangkat keras komoditas dengan RAM terbatas namun kapasitas hard drive besar.
Arsitektur ini dapat mengurangi investasi perangkat keras awal, terutama saat memproses dataset yang sangat besar di mana solusi berbasis memori akan sangat mahal.
Model pemrosesan in-memory Spark memberikan manfaat performa namun memerlukan RAM yang jauh lebih besar per node. Klaster Spark yang dikonfigurasi dengan baik umumnya menuntut server dengan konfigurasi memori besar—sering kali 16GB hingga 256GB per node tergantung karakteristik beban kerja.
Meskipun biaya memori telah menurun seiring waktu, kebutuhan ini tetap dapat meningkatkan biaya perangkat keras dibanding penerapan Hadoop yang berfokus pada disk.
Biaya operasional
Biaya operasional melampaui pengadaan perangkat keras hingga mencakup pemeliharaan berkelanjutan, listrik, pendinginan, dan ruang pusat data. Klaster Hadoop cenderung memiliki jejak fisik lebih besar karena ketergantungannya pada banyak server komoditas dengan penyimpanan luas.
Jejak yang lebih besar ini berujung pada biaya lebih tinggi untuk daya, pendinginan, dan ruang rak.
Klaster Spark terkadang dapat mencapai kapabilitas pemrosesan yang sama dengan lebih sedikit node karena pemanfaatan sumber daya komputasi yang lebih efisien, berpotensi mengurangi jejak pusat data dan biaya terkait. Namun, mesin dengan spesifikasi lebih tinggi yang dibutuhkan dapat mengonsumsi daya lebih besar per node, yang sebagian mengimbangi penghematan ini.
Biaya pengembangan dan personel
Kompleksitas implementasi dan pemeliharaan dapat berdampak signifikan pada total biaya kepemilikan. Ekosistem Hadoop secara tradisional memerlukan keahlian khusus dalam pemrograman Java dan administrasi Unix, dengan siklus pengembangan yang bisa panjang karena sifat MapReduce yang verbose.
Spark menawarkan API yang lebih mudah diakses dalam Python, Scala, R, dan Java, yang berpotensi mengurangi waktu pengembangan dan biaya personel terkait.
Model pemrograman yang lebih intuitif dapat menurunkan kurva pembelajaran dan waktu pengembangan, memungkinkan organisasi menerapkan solusi lebih cepat dengan personel yang kurang terspesialisasi.
Strategi optimasi biaya
Bagi organisasi yang sensitif terhadap biaya, pendekatan hibrida sering kali memberikan nilai terbaik. Menggunakan HDFS untuk penyimpanan sambil memanfaatkan Spark untuk pemrosesan dapat menggabungkan penyimpanan hemat biaya Hadoop dengan efisiensi pemrosesan Spark. Penerapan berbasis cloud pada layanan seperti AWS EMR, Azure HDInsight, atau Google Dataproc memungkinkan organisasi hanya membayar sumber daya yang digunakan tanpa belanja modal awal yang besar.
Organisasi juga harus mempertimbangkan biaya skalabilitas. Hadoop secara tradisional memerlukan intervensi manual untuk penskalaan, yang menambah overhead operasional. Kompatibilitas Spark dengan platform orkestrasi kontainer seperti Kubernetes memungkinkan penskalaan yang lebih otomatis dan elastis yang dapat lebih selaras antara penyediaan sumber daya dan permintaan aktual, sehingga berpotensi mengurangi kapasitas yang terbuang.
Tabel Perbandingan Hadoop vs Spark
Berikut tabel perbandingan yang merangkum perbedaannya:
Fitur
Hadoop
Spark
Model Pemrosesan
Pemrosesan batch menggunakan MapReduce
Pemrosesan in-memory menggunakan RDD, DataFrame, dan Dataset
Performa
Lebih lambat karena I/O disk antar tahap
Hingga 100x lebih cepat untuk beban kerja iteratif dan in-memory
Penggunaan Memori
Berbasis disk, kebutuhan memori rendah
Intensif memori, kebutuhan RAM tinggi
Kemudahan Pengembangan
Verbose; perlu menulis logika map & reduce secara eksplisit
API tingkat tinggi di Python, Scala, R, Java; lebih sedikit boilerplate
Toleransi Kesalahan
Replikasi data melalui HDFS
Lineage RDD memungkinkan perhitungan ulang saat kegagalan
Pemrosesan Real-time
Tidak ideal; hanya batch
Mendukung pemrosesan real-time melalui Spark Streaming
Pengelola Klaster
YARN
Standalone, YARN, Mesos, atau Kubernetes
Penyimpanan
Disertai HDFS
Bergantung pada penyimpanan eksternal (mis., HDFS, S3, GCS)
Biaya
Biaya perangkat keras lebih rendah (mesin komoditas, berbasis disk)
Biaya memori lebih tinggi namun pemanfaatan sumber daya per beban kerja lebih baik
Terbaik Untuk
Job batch, penyimpanan skala masif, analisis data historis
Machine learning, pemrosesan stream, analitik interaktif
Integrasi
Ekosistem Hadoop yang kuat (Hive, Pig, dll.)
API terpadu untuk SQL, MLlib, GraphX, dan Streaming dalam satu platform
Kesimpulan
Hadoop dan Spark merepresentasikan pendekatan yang saling melengkapi terhadap pemrosesan big data, bukan pesaing ketat. Hadoop unggul dengan sistem penyimpanan hemat biayanya (HDFS) dan pemrosesan berorientasi batch untuk dataset masif di mana throughput lebih penting daripada kecepatan.
Spark hebat dengan kapabilitas pemrosesan in-memory yang memberikan performa unggul untuk algoritma iteratif, analitik interaktif, dan kebutuhan pemrosesan real time.
DataCamp menawarkan berbagai sumber daya jika Anda ingin mempelajari lebih lanjut tentang kedua teknologi ini: