Hadoop ve Spark, büyük veri alanındaki en öne çıkan iki framework’tür ve büyük ölçekli veriyi çok farklı şekillerde işlerler. Hadoop, HDFS adlı sağlam bir depolama sistemi ve MapReduce adlı bir hesaplama modeliyle dağıtık bilişim paradigmasını demokratikleştirmesiyle öne çıkarken, Spark bellekiçi mimarisi ve esnek programlama modeliyle oyunun kurallarını değiştiriyor.
Bu eğitimde Hadoop ve Spark arasındaki mimari, performans, maliyet ve entegrasyon farklarını derinlemesine ele alıyoruz. Sonunda, her birinin avantaj ve dezavantajlarını ve hangi kullanım senaryolarında öne çıktıklarını net bir şekilde anlayacaksınız; bu anlayış, büyük veri çözümlerinizi oluştururken stratejik kararlar almanıza yardımcı olacaktır.
Hadoop ve Spark’ı Anlamak
Özel ayrıntılara girmeden önce, bu güçlü framework’lerin büyük veri zorluklarına nasıl yaklaştıklarını anlamak için Hadoop ve Spark’ın temel kavramlarını ve kökenlerini inceleyelim.
Hadoop nedir?
Hadoop, büyük veri kümelerini bilgisayar kümeleri arasında depolamak ve işlemek için tasarlanmış açık kaynaklı bir framework’tür. 2006’dan bu yana Hadoop, tek bir makinenin altından kalkamayacağı kadar büyük veri hacimlerini kuruluşların yönetmesini mümkün kıldı. Veriyi birden çok düğüme dağıtarak yalnızca işlem kapasitesini artırmakla kalmaz, aynı zamanda yedeklilik sağlayarak bireysel makineler arızalansa bile sistem güvenilirliğini korur.
Hadoop framework’ünün temel bileşenleri şunlardır:
- Hadoop Distributed File System (HDFS): Depolama temelini oluşturur; dosyaları bloklara ayırır ve küme genelinde dağıtır.
- MapReduce: Hesaplama görevlerini küçük birimlere bölerek küme genelinde paralel olarak çalıştırır.
- YARN (Yet Another Resource Negotiator): Kaynakları verimli biçimde yönetir; kullanılabilir makineler arasında işlem gücü tahsis eder ve görevleri zamanlar.
Hadoop’un başlıca avantajlarından biri maliyet etkinliğidir; pahalı, özel donanımlar yerine standart, sıradan donanımların kullanılmasına olanak tanır. Bu pragmatik yaklaşım, işlem felsefesine de yansır.
Hadoop’un toplu iş odaklı tasarımı, ham işlem hızından çok toplam verimliliğin önemli olduğu durumlarda üstünlük sağlar; bu da özellikle geçmiş veri analizi ve anında sonuç gerektirmeyen karmaşık ETL (Extract, Transform, Load) işlemleri için değerlidir.
Apache Spark nedir?
Apache Spark, 2010’da Hadoop’un büyük veri işleme yaklaşımındaki sınırlamalara bir yanıt olarak ortaya çıktı. İlk olarak UC Berkeley’de geliştirilen ve sonrasında bir Apache projesi olan Spark, Hadoop MapReduce’un disk işlemlerine ağır bağımlılığını ele aldı. Çığır açan yeniliği, bellekiçi hesaplamayı uygulayarak, veriyi diskten okuma ve diske yazma ihtiyacını en aza indirip birçok iş yükünde işlem süresini dramatik biçimde azaltmasıdır.
Spark, çekirdek işlem motoru etrafında sıkı biçimde entegre edilmiş çeşitli bileşenlerle birleşik bir platform sunar:
- Spark SQL: Yapılandırılmış verilerle çalışmak için
- MLlib: Makine öğrenimi algoritmalarını uygulamak için
- GraphX: Grafik verisini işlemek için
- Spark Streaming: Gerçek zamanlı veri analizi için
Bu uyumlu tasarım, ekiplerin birden fazla uzman aracı dengelemek yerine tek bir framework ile çeşitli veri zorluklarını ele almalarını sağlar.
Farklılıklarına rağmen Spark ve Hadoop, rakip olmaktan çok birbirini tamamlayan teknolojiler olarak sıklıkla birlikte çalışır. Spark kendi depolama sistemiyle gelmediğinden, kalıcı veri depolaması için yaygın olarak Hadoop’un HDFS’ine dayanır.
Ayrıca Spark, Hadoop’un YARN kaynak yöneticisi üzerinde çalışabilir; bu da kuruluşların mevcut Hadoop ortamlarını Spark’ın işlem gücüyle kolayca güçlendirmesini sağlar. Bu uyumluluk, işletmelerin Hadoop altyapısına yaptıkları yatırımdan vazgeçmeden Spark’ın avantajlarını benimseyebilecekleri pratik bir yükseltme yolu sunar.
Büyük veri framework’lerini değerlendirirken, zamana duyarlı veri işleme ihtiyaçları olan kuruluşlar için performans sıklıkla belirleyici bir faktör olur.
İşleme hızı
Hadoop’un MapReduce’u, her hesaplama aşaması arasında veriyi diskten okuyup işleyen ve sonuçları tekrar diske yazan disk tabanlı bir işlem sistemidir. Bu disk G/Ç’si, özellikle aynı veri üzerinde birden çok geçiş gerektiren yinelemeli algoritmalar için önemli gecikme yaratır.
Bu yaklaşım, çok büyük veri kümelerinin toplu işlenmesinde etkili olsa da hızdan ziyade güvenilirlik ve verimlilik uğruna ödün verir.
Buna karşılık Spark, hesaplamaları ağırlıklı olarak bellekte gerçekleştirir ve disk işlemlerine olan ihtiyacı büyük ölçüde azaltır. Özellikle makine öğreniminde kullanılanlar gibi yinelemeli algoritmalar için Spark, görevleri Hadoop MapReduce’a göre 100 kata kadar daha hızlı yürütebilir.
Bu performans avantajı, işlemenin neredeyse gerçek zamanlı gerçekleşmesi gerektiğinde veya algoritmaların aynı veri kümesi üzerinden birden çok geçiş yapması gerektiğinde özellikle belirginleşir.
Bellek kullanımı
Hadoop’un tasarımı sınırlı bellek mevcudiyetini varsayar; bu da onu bellek açısından verimli ancak daha yavaş kılar. Belleğe ağır biçimde disk depolamayı ikame eder; böylece veriyi bellek ve disk arasında sürekli takas ederek mevcut RAM’i aşan veri kümelerini işleyebilir.
Bu yaklaşım, sınırlı bellek kaynaklarına sahip kümelerde son derece büyük veri kümelerinin işlenmesi için Hadoop’u uygun kılar.
Spark’ın performans avantajları, belleği agresif kullanmasından gelir. Veriyi işlem aşamaları boyunca RAM’de önbelleğe alarak, maliyetli disk işlemlerini ortadan kaldırır. Ancak bu, çalışma veri kümelerini tutmak için yeterli bellek kaynakları gerektirir.
Bellek kısıtları ortaya çıktığında Spark’ın performans avantajı, veriyi diske dökmeye başladıkça azalır; yine de akıllı bellek yönetimi, genellikle Hadoop’un disk-öncelikli yaklaşımından daha iyi sonuç verir.
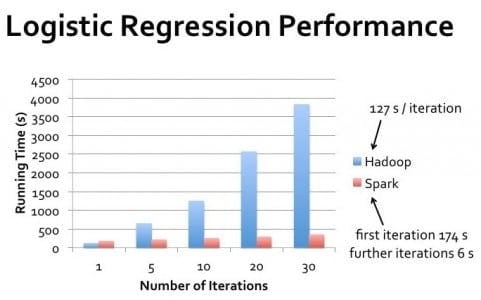
Gerçek dünyada Hadoop ile Spark arasındaki performans farkı, belirli kullanım durumlarına göre önemli ölçüde değişir. Verinin mevcut belleği büyük ölçüde aştığı, tek geçişli toplu işleme senaryolarında Hadoop’un performansı Spark’a yaklaşabilir.
Buna karşın yinelemeli işlem, etkileşimli sorgular ve akış işleme için Spark sürekli olarak üstün performans sunar.
Performansın yalnızca ham hızla ilgili olmadığını unutmamak gerekir. Hadoop, yüksek hata toleransı gerektiren ve işlemenin net biçimde tanımlanmış toplu iş pencerelerinde yapılabildiği senaryolarda başarılıdır.
Spark, hızlı sonuçların gerektiği durumlarda en iyi performansı gösterir; örneğin etkileşimli veri keşfi, gerçek zamanlı analitik ve algoritmaların veri kümeleri üzerinden birden çok geçiş yaptığı makine öğrenimi uygulamaları.
Küme Yönetimi: Hadoop Kümeleri vs Spark Kümeleri
Hem Hadoop hem de Spark, büyük veri hacimlerini verimli şekilde işlemek için kümelere dayanır; ancak bu kaynakları farklı şekilde yönetirler ve bu da performans ve yönetimi etkiler.
Kümeleme nedir ve neden gereklidir
Küme, tek bir sistem gibi birlikte çalışan birbirine bağlı bilgisayarların (düğümlerin) bir koleksiyonudur. Büyük veri işlemekte, veri hacimleri tek bir makinenin verimli şekilde işleyebileceğini aştığında kümeleme gerekli hale gelir. Hesaplama iş yüklerini birden fazla makineye dağıtarak, kümeler kuruluşların aksi halde yönetilmesi imkansız olacak petabaytlarca veriyi işlemesini sağlar.
Kümeleme aynı zamanda hata toleransı ve yüksek erişilebilirlik sağlar. Bir makine arızalanırsa, kümedeki diğerleri iş yükünü devralarak kesintisiz çalışmayı garanti eder. Bu dayanıklılık, kesinti süresinin maliyetli olabildiği üretim ortamları için kritik önemdedir.
Ayrıca kümeleme yatay ölçeklemeye olanak tanır — işlem gücünü artırmak için daha fazla makine eklemek — ki bu, tek tek sistemleri yükseltmekten çoğu zaman daha maliyet etkindir.
Bu alanda uzmanlaşmak isteyenler için kümelemeyi anlamak, veri mühendisliği için temel bir beceridir.
Hadoop küme mimarisi
Hadoop kümeleri, farklı düğümler için özelleşmiş rollerin bulunduğu bir ana-köle mimarisini izler. NameNode, HDFS için ana düğüm olarak görev yapar; dosya konumları ve izinlerine dair metaveriyi tutar. DataNode’lar gerçek veri bloklarını saklar ve NameNode’a rapor verir.
İşleme için, ResourceManager küme kaynaklarını tahsis ederken, bireysel makinelerdeki NodeManager’lar görevleri yürütür.
HDFS veriyi birden çok DataNode’a çoğaltır; genellikle her veri bloğunun üç kopyasını tutar. Bu çoğaltma stratejisi, bireysel düğümler arızalansa bile veri erişilebilirliğini sağlar; ancak ilave depolama kapasitesi gerektirir.
Hadoop’un küme tasarımı, ağ aktarımını en aza indirmek için verinin bulunduğu düğümlerde hesaplama görevlerini zamanlamaya çalışarak veri yerliliğini vurgular.
Hadoop kümelerinin yönetimi geleneksel olarak ciddi uzmanlık gerektirirdi (profesyoneller bu bilgiyi göstermek için sıklıkla Hadoop mülakat sorularına hazırlanır), ancak modern dağıtımlar yapılandırma ve izlemeyi basitleştiren yönetim araçları içerir.
Bir Hadoop kümesini ölçeklemek, yeni düğümler eklemeyi ve veriyi genişleyen altyapı genelinde yeniden dengelemeyi içerir; bu, dikkatli planlama gerektiren, genellikle manuel bir süreçtir.
Spark küme mimarisi
Spark, bağımsız mod, Hadoop YARN, Apache Mesos veya Kubernetes dahil olmak üzere çeşitli küme yapılandırmalarında çalışabilir. Tüm dağıtımlarda Spark, sürücü-yürütücü (driver-executor) modelini izler. Sürücü programı uygulamanın ana fonksiyonunu içerir ve kaynak tahsisini koordine eden bir SparkContext oluşturur.
Kaynaklar tahsis edildikten sonra Spark yürütücüler (executor) işçi düğümler üzerinde başlatılır. Bu yürütücüler, görevleri çalıştıran ve veriyi bellek veya diskte depolayan JVM süreçleridir. Hadoop’tan farklı olarak Spark yürütücüleri, uygulama ihtiyaçlarına göre dinamik olarak tahsis edilip serbest bırakılabilir; bu da kaynak kullanımını potansiyel olarak iyileştirir.
İlgilenen okuyucular, Makine Öğrenimi için Apache Spark gibi pratik eğitimlerle Spark’ın yeteneklerini daha fazla keşfedebilir.
Spark, kendi dağıtık depolama sistemiyle gelmez; bunun yerine HDFS, Amazon S3 veya diğer uyumlu depolama çözümlerinden yararlanır. Hesaplama ve depolamanın bu mimari ayrımı esneklik sunar ancak en iyi veri erişim desenleri için dikkatli yapılandırma gerektirir.
Spark SQL ve sparklyr gibi araçlar bu mimariyle etkileşim kurmanın kullanışlı yollarını sunar.
Küme yönetimindeki temel farklar
Hadoop’un küme yönetimine yaklaşımı daha fazla altyapı odaklıdır; nispeten statik kaynak tahsisi ve veri yerliliğine vurgu yapar. Bu tasarım, düğümlerin nadiren değiştiği, uzun süreli toplu işler için iyi çalışır.
Ancak değişken iş yüklerine daha az duyarlıdır ve ölçeklemede daha fazla manuel müdahale gerektirir.
Spark, özellikle Kubernetes gibi modern orkestrasyon platformlarında çalışırken daha dinamik kaynak yönetimi sunar. Mevcut talebe göre kaynak tahsisini ayarlayabilir ve ihtiyaç olmadığında kaynakları serbest bırakabilir.
Bu esneklik, dalgalı iş yükleri olan veya birden çok uygulamaya hizmet veren paylaşımlı altyapılara sahip kuruluşlar için değerlidir.
Bu farklılıkları anlamak, Veri Mühendisi sertifikasyonu peşinde olan veya Spark mülakat sorularına hazırlanan profesyoneller için kritiktir.
Büyük veriye yeni başlayan kuruluşlar için Spark’ın daha esnek dağıtım seçenekleri ve daha basit programlama modeli genellikle başlamayı kolaylaştırır.
Buna karşın, depolama yönetiminin birincil endişe olduğu, son derece büyük veri hacimlerine sahip ortamlarda Hadoop’un olgun HDFS ekosistemi hâlâ Spark’ın işlem yeteneklerini tamamlayan avantajlar sunar. Spark’ın diğer akış teknolojileriyle karşılaştırması için, Flink vs. Spark gibi karşılaştırmalar bilgilendirici olabilir.
Hadoop MapReduce vs. Spark’ın İşleme Modeli
Önceki bölümler performans etkilerini tartışırken, her framework’ün temel işleme modellerini anlamak, neden bu kadar farklı şekilde tasarlandıklarını açıklamaya yardımcı olur.
Hadoop MapReduce framework’ü
MapReduce, iki ana aşamalı katı bir programlama paradigmasını izler: map ve reduce. Map aşaması, her bir kayda paralel olarak bir fonksiyon uygular ve ara anahtar-değer çiftleri üretir.
Bu çiftler, aynı anahtara sahip verilerin gruplandığı zorunlu bir karıştırma ve sıralama aşamasından geçer.
Son olarak reduce aşaması, bu gruplandırılmış değerleri birleştirerek nihai çıktıları üretir. Bu yapılandırılmış yaklaşım, karmaşık işlemler için birden fazla MapReduce işinin ardışık bağlanmasını gerektirir.
MapReduce uygulamaları geliştirmek genellikle map ve reduce fonksiyonlarını açıkça tanımlayan düşük seviyeli kod yazmayı içerir.
Apache Pig ve Apache Hive gibi framework’ler daha üst düzey soyutlamalar sunsa da, alttaki yürütme hâlâ katı MapReduce desenini izler; bu da algoritma tasarımı ve optimizasyon fırsatlarında sınırlamalar getirir.
Spark’ın veri işleme modeli
Spark, çekirdek soyutlaması olarak Resilient Distributed Datasets (RDD)’leri tanıttı — kurtarma için soy ağacını (lineage) izleyebilen, değiştirilemeyen ve bölümlenmiş koleksiyonlar. MapReduce’un aksine Spark, katı bir işlem deseni dayatmaz; bunun yerine iki tür işlem sunar: dönüşümler (yeni RDD’ler oluşturur) ve eylemler (değer döndürür).
Bu esneklik, map-reduce paradigmasının ötesinde çeşitli işleme desenlerine olanak tanır.
Spark, RDD’lerin ötesine geçerek DataFrame ve Dataset gibi daha üst düzey soyutlamalar sunar; bunlar ilişkisel veritabanlarına benzer optimizasyonlarla şema farkındalığı olan işlem sağlar. Bu soyutlamalar, akış, SQL, makine öğrenimi ve grafik işleme için uzman kütüphanelerle birleştiğinde, geliştiricilerin eşdeğer MapReduce uygulamalarına kıyasla önemli ölçüde daha az kodla karmaşık iş akışlarını ifade etmelerine olanak tanır; bunu yaparken farklı işleme paradigmaları arasında birleşik bir programlama modeli sağlar.
Spark ve Hadoop Maliyet Değerlendirmeleri
Büyük veri framework’lerini değerlendirirken kuruluşlar, yalnızca teknik yetenekleri değil, aynı zamanda dağıtım ve işletimin finansal etkilerini de göz önünde bulundurmalıdır.
Donanım gereksinimleri ve etkileri
Hadoop ve Spark’ın, altyapı maliyetlerini etkileyen temelde farklı donanım tercihleri vardır. Hadoop, belleğe kıyasla disk depolamayı önceliklendirecek şekilde tasarlanmıştır; bu da onu sınırlı RAM’e ancak yüksek disk kapasitesine sahip sıradan donanımlar için uygun kılar.
Bu mimari, özellikle bellek tabanlı çözümlerin maliyetinin yasaklayıcı olacağı kadar büyük veri kümeleri işlenirken, ilk donanım yatırımını azaltabilir.
Spark’ın bellekiçi işleme modeli performans avantajları sunar; ancak düğüm başına önemli ölçüde daha fazla RAM gerektirir. Doğru yapılandırılmış bir Spark kümesi, iş yüküne bağlı olarak genellikle düğüm başına 16 GB ile 256 GB arasında önemli bellek yapılandırmaları talep eder.
Bellek maliyetleri zamanla düşmüş olsa da, bu gereksinim disk merkezli Hadoop kurulumlarına kıyasla donanım giderlerini hâlâ artırabilir.
Operasyonel giderler
Operasyonel maliyetler, donanım ediniminin ötesinde devam eden bakım, elektrik, soğutma ve veri merkezi alanını da kapsar. Hadoop kümeleri, kapsamlı depolamaya sahip çok sayıda sıradan sunucuya dayanması nedeniyle genellikle daha büyük fiziksel alana ihtiyaç duyar.
Bu daha büyük ayak izi, güç, soğutma ve raf alanı maliyetlerini artırır.
Spark kümeleri, hesaplama kaynaklarını daha verimli kullanmaları sayesinde bazen aynı işlem yeteneklerini daha az düğümle sağlayabilir; bu da veri merkezi ayak izini ve ilişkili maliyetleri potansiyel olarak azaltır. Ancak gerek duyulan daha yüksek özellikli makineler, düğüm başına daha fazla güç tüketebilir ve bu tasarrufları kısmen dengeleyebilir.
Geliştirme ve personel maliyetleri
Uygulama ve bakımın karmaşıklığı, toplam sahip olma maliyetini önemli ölçüde etkileyebilir. Hadoop ekosistemi, geleneksel olarak Java programlama ve Unix yönetiminde uzmanlık gerektirirdi; MapReduce programlamasının ayrıntılı yapısı nedeniyle geliştirme döngüleri uzun sürebilirdi.
Spark, Python, Scala, R ve Java’da daha erişilebilir API’ler sunar; bu da geliştirme süresini ve ilgili personel maliyetlerini azaltabilir.
Daha sezgisel programlama modeli, öğrenme eğrisini ve geliştirme süresini düşürerek kuruluşların daha az uzman personelle daha hızlı çözümler uygulamasını sağlar.
Maliyet optimizasyon stratejileri
Maliyet hassas kuruluşlar için hibrit yaklaşımlar çoğu zaman en iyi değeri sunar. Depolama için HDFS’i kullanırken işlem için Spark’tan yararlanmak, Hadoop’un maliyet etkin depolamasını Spark’ın işleme verimliliğiyle birleştirebilir. AWS EMR, Azure HDInsight veya Google Dataproc gibi bulut tabanlı dağıtımlar, kuruluşların büyük peşin sermaye harcamaları olmadan yalnızca kullandıkları kaynaklar için ödeme yapmalarına olanak tanır.
Kuruluşlar, ölçeklenebilirlik maliyetlerini de göz önünde bulundurmalıdır. Hadoop, geleneksel olarak ölçekleme için manuel müdahale gerektirir ve bu da operasyonel yükü artırır. Spark’ın Kubernetes gibi konteyner orkestrasyon platformlarıyla uyumluluğu, gerçek talep ile kaynak sağlama arasında daha iyi eşleşme sağlayan daha otomatik ve esnek ölçeklemeyi mümkün kılar; bu da boşa giden kapasiteyi potansiyel olarak azaltır.
Hadoop ve Spark Karşılaştırma Tablosu
İşte farklarını özetleyen bir karşılaştırma tablosu:
|
Özellik
|
Hadoop
|
Spark
|
|
İşleme Modeli
|
MapReduce kullanarak toplu işleme
|
RDD, DataFrame ve Dataset kullanarak bellekiçi işleme
|
|
Performans
|
Aşamalar arası disk G/Ç nedeniyle daha yavaş
|
Yinelemeli ve bellekiçi iş yüklerinde 100x’e kadar daha hızlı
|
|
Bellek Kullanımı
|
Disk merkezli, düşük bellek gereksinimi
|
Bellek yoğun, yüksek RAM gereksinimi
|
|
Geliştirme Kolaylığı
|
Ayrıntılı; map ve reduce mantığını açıkça yazmayı gerektirir
|
Python, Scala, R, Java’da üst düzey API’ler; daha az şablon kod
|
|
Hata Toleransı
|
HDFS aracılığıyla veri çoğaltma
|
RDD soy ağacı, hata durumunda yeniden hesaplamayı sağlar
|
|
Gerçek Zamanlı İşleme
|
Uygun değil; yalnızca toplu iş
|
Spark Streaming ile gerçek zamanlı işlemeyi destekler
|
|
Küme Yöneticisi
|
YARN
|
Bağımsız, YARN, Mesos veya Kubernetes
|
|
Depolama
|
HDFS ile birlikte gelir
|
Harici depolamaya bağlıdır (ör. HDFS, S3, GCS)
|
|
Maliyet
|
Daha düşük donanım maliyeti (sıradan makineler, disk tabanlı)
|
Daha yüksek bellek maliyeti ancak iş yükü başına daha iyi kaynak kullanımı
|
|
En Uygun Olduğu
|
Toplu işler, devasa ölçekli depolama, geçmiş veri analizi
|
Makine öğrenimi, akış işleme, etkileşimli analitik
|
|
Entegrasyon
|
Güçlü Hadoop ekosistemi (Hive, Pig, vb.)
|
Tek platformda SQL, MLlib, GraphX ve Streaming için birleşik API’ler
|
Sonuç
Hadoop ve Spark, katı rakiplerden ziyade büyük veri işlemeye tamamlayıcı yaklaşımlar sunar. Hadoop, maliyet etkin depolama sistemi (HDFS) ve hızdan çok verimliliğin önemli olduğu devasa veri kümeleri için toplu iş odaklı işlemede öne çıkar.
Spark ise yinelemeli algoritmalar, etkileşimli analitik ve gerçek zamanlı ihtiyaçlar için üstün performans sağlayan bellekiçi işleme yetenekleriyle parlıyor.
Bu iki teknoloji hakkında daha fazla bilgi edinmek isterseniz DataCamp çeşitli kaynaklar sunuyor:




Hadoop ve Spark, büyük veri alanındaki en öne çıkan iki framework’tür ve büyük ölçekli veriyi çok farklı şekillerde işlerler. Hadoop, HDFS adlı sağlam bir depolama sistemi ve MapReduce adlı bir hesaplama modeliyle dağıtık bilişim paradigmasını demokratikleştirmesiyle öne çıkarken, Spark bellekiçi mimarisi ve esnek programlama modeliyle oyunun kurallarını değiştiriyor.
Bu eğitimde Hadoop ve Spark arasındaki mimari, performans, maliyet ve entegrasyon farklarını derinlemesine ele alıyoruz. Sonunda, her birinin avantaj ve dezavantajlarını ve hangi kullanım senaryolarında öne çıktıklarını net bir şekilde anlayacaksınız; bu anlayış, büyük veri çözümlerinizi oluştururken stratejik kararlar almanıza yardımcı olacaktır.
Hadoop ve Spark’ı Anlamak
Özel ayrıntılara girmeden önce, bu güçlü framework’lerin büyük veri zorluklarına nasıl yaklaştıklarını anlamak için Hadoop ve Spark’ın temel kavramlarını ve kökenlerini inceleyelim.
Hadoop nedir?
Hadoop, büyük veri kümelerini bilgisayar kümeleri arasında depolamak ve işlemek için tasarlanmış açık kaynaklı bir framework’tür. 2006’dan bu yana Hadoop, tek bir makinenin altından kalkamayacağı kadar büyük veri hacimlerini kuruluşların yönetmesini mümkün kıldı. Veriyi birden çok düğüme dağıtarak yalnızca işlem kapasitesini artırmakla kalmaz, aynı zamanda yedeklilik sağlayarak bireysel makineler arızalansa bile sistem güvenilirliğini korur.
Hadoop framework’ünün temel bileşenleri şunlardır:
Hadoop’un başlıca avantajlarından biri maliyet etkinliğidir; pahalı, özel donanımlar yerine standart, sıradan donanımların kullanılmasına olanak tanır. Bu pragmatik yaklaşım, işlem felsefesine de yansır.
Hadoop’un toplu iş odaklı tasarımı, ham işlem hızından çok toplam verimliliğin önemli olduğu durumlarda üstünlük sağlar; bu da özellikle geçmiş veri analizi ve anında sonuç gerektirmeyen karmaşık ETL (Extract, Transform, Load) işlemleri için değerlidir.
Apache Spark nedir?
Apache Spark, 2010’da Hadoop’un büyük veri işleme yaklaşımındaki sınırlamalara bir yanıt olarak ortaya çıktı. İlk olarak UC Berkeley’de geliştirilen ve sonrasında bir Apache projesi olan Spark, Hadoop MapReduce’un disk işlemlerine ağır bağımlılığını ele aldı. Çığır açan yeniliği, bellekiçi hesaplamayı uygulayarak, veriyi diskten okuma ve diske yazma ihtiyacını en aza indirip birçok iş yükünde işlem süresini dramatik biçimde azaltmasıdır.
Spark, çekirdek işlem motoru etrafında sıkı biçimde entegre edilmiş çeşitli bileşenlerle birleşik bir platform sunar:
Bu uyumlu tasarım, ekiplerin birden fazla uzman aracı dengelemek yerine tek bir framework ile çeşitli veri zorluklarını ele almalarını sağlar.
Farklılıklarına rağmen Spark ve Hadoop, rakip olmaktan çok birbirini tamamlayan teknolojiler olarak sıklıkla birlikte çalışır. Spark kendi depolama sistemiyle gelmediğinden, kalıcı veri depolaması için yaygın olarak Hadoop’un HDFS’ine dayanır.
Ayrıca Spark, Hadoop’un YARN kaynak yöneticisi üzerinde çalışabilir; bu da kuruluşların mevcut Hadoop ortamlarını Spark’ın işlem gücüyle kolayca güçlendirmesini sağlar. Bu uyumluluk, işletmelerin Hadoop altyapısına yaptıkları yatırımdan vazgeçmeden Spark’ın avantajlarını benimseyebilecekleri pratik bir yükseltme yolu sunar.
Hadoop ve Spark Performans Karşılaştırması
Büyük veri framework’lerini değerlendirirken, zamana duyarlı veri işleme ihtiyaçları olan kuruluşlar için performans sıklıkla belirleyici bir faktör olur.
İşleme hızı
Hadoop’un MapReduce’u, her hesaplama aşaması arasında veriyi diskten okuyup işleyen ve sonuçları tekrar diske yazan disk tabanlı bir işlem sistemidir. Bu disk G/Ç’si, özellikle aynı veri üzerinde birden çok geçiş gerektiren yinelemeli algoritmalar için önemli gecikme yaratır.
Bu yaklaşım, çok büyük veri kümelerinin toplu işlenmesinde etkili olsa da hızdan ziyade güvenilirlik ve verimlilik uğruna ödün verir.
Buna karşılık Spark, hesaplamaları ağırlıklı olarak bellekte gerçekleştirir ve disk işlemlerine olan ihtiyacı büyük ölçüde azaltır. Özellikle makine öğreniminde kullanılanlar gibi yinelemeli algoritmalar için Spark, görevleri Hadoop MapReduce’a göre 100 kata kadar daha hızlı yürütebilir.
Bu performans avantajı, işlemenin neredeyse gerçek zamanlı gerçekleşmesi gerektiğinde veya algoritmaların aynı veri kümesi üzerinden birden çok geçiş yapması gerektiğinde özellikle belirginleşir.
Bellek kullanımı
Hadoop’un tasarımı sınırlı bellek mevcudiyetini varsayar; bu da onu bellek açısından verimli ancak daha yavaş kılar. Belleğe ağır biçimde disk depolamayı ikame eder; böylece veriyi bellek ve disk arasında sürekli takas ederek mevcut RAM’i aşan veri kümelerini işleyebilir.
Bu yaklaşım, sınırlı bellek kaynaklarına sahip kümelerde son derece büyük veri kümelerinin işlenmesi için Hadoop’u uygun kılar.
Spark’ın performans avantajları, belleği agresif kullanmasından gelir. Veriyi işlem aşamaları boyunca RAM’de önbelleğe alarak, maliyetli disk işlemlerini ortadan kaldırır. Ancak bu, çalışma veri kümelerini tutmak için yeterli bellek kaynakları gerektirir.
Bellek kısıtları ortaya çıktığında Spark’ın performans avantajı, veriyi diske dökmeye başladıkça azalır; yine de akıllı bellek yönetimi, genellikle Hadoop’un disk-öncelikli yaklaşımından daha iyi sonuç verir.
Gerçek dünyada performans değerlendirmeleri
Gerçek dünyada Hadoop ile Spark arasındaki performans farkı, belirli kullanım durumlarına göre önemli ölçüde değişir. Verinin mevcut belleği büyük ölçüde aştığı, tek geçişli toplu işleme senaryolarında Hadoop’un performansı Spark’a yaklaşabilir.
Buna karşın yinelemeli işlem, etkileşimli sorgular ve akış işleme için Spark sürekli olarak üstün performans sunar.
Performansın yalnızca ham hızla ilgili olmadığını unutmamak gerekir. Hadoop, yüksek hata toleransı gerektiren ve işlemenin net biçimde tanımlanmış toplu iş pencerelerinde yapılabildiği senaryolarda başarılıdır.
Spark, hızlı sonuçların gerektiği durumlarda en iyi performansı gösterir; örneğin etkileşimli veri keşfi, gerçek zamanlı analitik ve algoritmaların veri kümeleri üzerinden birden çok geçiş yaptığı makine öğrenimi uygulamaları.
Küme Yönetimi: Hadoop Kümeleri vs Spark Kümeleri
Hem Hadoop hem de Spark, büyük veri hacimlerini verimli şekilde işlemek için kümelere dayanır; ancak bu kaynakları farklı şekilde yönetirler ve bu da performans ve yönetimi etkiler.
Kümeleme nedir ve neden gereklidir
Küme, tek bir sistem gibi birlikte çalışan birbirine bağlı bilgisayarların (düğümlerin) bir koleksiyonudur. Büyük veri işlemekte, veri hacimleri tek bir makinenin verimli şekilde işleyebileceğini aştığında kümeleme gerekli hale gelir. Hesaplama iş yüklerini birden fazla makineye dağıtarak, kümeler kuruluşların aksi halde yönetilmesi imkansız olacak petabaytlarca veriyi işlemesini sağlar.
Kümeleme aynı zamanda hata toleransı ve yüksek erişilebilirlik sağlar. Bir makine arızalanırsa, kümedeki diğerleri iş yükünü devralarak kesintisiz çalışmayı garanti eder. Bu dayanıklılık, kesinti süresinin maliyetli olabildiği üretim ortamları için kritik önemdedir.
Ayrıca kümeleme yatay ölçeklemeye olanak tanır — işlem gücünü artırmak için daha fazla makine eklemek — ki bu, tek tek sistemleri yükseltmekten çoğu zaman daha maliyet etkindir.
Bu alanda uzmanlaşmak isteyenler için kümelemeyi anlamak, veri mühendisliği için temel bir beceridir.
Hadoop küme mimarisi
Hadoop kümeleri, farklı düğümler için özelleşmiş rollerin bulunduğu bir ana-köle mimarisini izler. NameNode, HDFS için ana düğüm olarak görev yapar; dosya konumları ve izinlerine dair metaveriyi tutar. DataNode’lar gerçek veri bloklarını saklar ve NameNode’a rapor verir.
İşleme için, ResourceManager küme kaynaklarını tahsis ederken, bireysel makinelerdeki NodeManager’lar görevleri yürütür.
HDFS veriyi birden çok DataNode’a çoğaltır; genellikle her veri bloğunun üç kopyasını tutar. Bu çoğaltma stratejisi, bireysel düğümler arızalansa bile veri erişilebilirliğini sağlar; ancak ilave depolama kapasitesi gerektirir.
Hadoop’un küme tasarımı, ağ aktarımını en aza indirmek için verinin bulunduğu düğümlerde hesaplama görevlerini zamanlamaya çalışarak veri yerliliğini vurgular.
Hadoop kümelerinin yönetimi geleneksel olarak ciddi uzmanlık gerektirirdi (profesyoneller bu bilgiyi göstermek için sıklıkla Hadoop mülakat sorularına hazırlanır), ancak modern dağıtımlar yapılandırma ve izlemeyi basitleştiren yönetim araçları içerir.
Bir Hadoop kümesini ölçeklemek, yeni düğümler eklemeyi ve veriyi genişleyen altyapı genelinde yeniden dengelemeyi içerir; bu, dikkatli planlama gerektiren, genellikle manuel bir süreçtir.
Spark küme mimarisi
Spark, bağımsız mod, Hadoop YARN, Apache Mesos veya Kubernetes dahil olmak üzere çeşitli küme yapılandırmalarında çalışabilir. Tüm dağıtımlarda Spark, sürücü-yürütücü (driver-executor) modelini izler. Sürücü programı uygulamanın ana fonksiyonunu içerir ve kaynak tahsisini koordine eden bir SparkContext oluşturur.
Kaynaklar tahsis edildikten sonra Spark yürütücüler (executor) işçi düğümler üzerinde başlatılır. Bu yürütücüler, görevleri çalıştıran ve veriyi bellek veya diskte depolayan JVM süreçleridir. Hadoop’tan farklı olarak Spark yürütücüleri, uygulama ihtiyaçlarına göre dinamik olarak tahsis edilip serbest bırakılabilir; bu da kaynak kullanımını potansiyel olarak iyileştirir.
İlgilenen okuyucular, Makine Öğrenimi için Apache Spark gibi pratik eğitimlerle Spark’ın yeteneklerini daha fazla keşfedebilir.
Spark, kendi dağıtık depolama sistemiyle gelmez; bunun yerine HDFS, Amazon S3 veya diğer uyumlu depolama çözümlerinden yararlanır. Hesaplama ve depolamanın bu mimari ayrımı esneklik sunar ancak en iyi veri erişim desenleri için dikkatli yapılandırma gerektirir.
Spark SQL ve sparklyr gibi araçlar bu mimariyle etkileşim kurmanın kullanışlı yollarını sunar.
Küme yönetimindeki temel farklar
Hadoop’un küme yönetimine yaklaşımı daha fazla altyapı odaklıdır; nispeten statik kaynak tahsisi ve veri yerliliğine vurgu yapar. Bu tasarım, düğümlerin nadiren değiştiği, uzun süreli toplu işler için iyi çalışır.
Ancak değişken iş yüklerine daha az duyarlıdır ve ölçeklemede daha fazla manuel müdahale gerektirir.
Spark, özellikle Kubernetes gibi modern orkestrasyon platformlarında çalışırken daha dinamik kaynak yönetimi sunar. Mevcut talebe göre kaynak tahsisini ayarlayabilir ve ihtiyaç olmadığında kaynakları serbest bırakabilir.
Bu esneklik, dalgalı iş yükleri olan veya birden çok uygulamaya hizmet veren paylaşımlı altyapılara sahip kuruluşlar için değerlidir.
Bu farklılıkları anlamak, Veri Mühendisi sertifikasyonu peşinde olan veya Spark mülakat sorularına hazırlanan profesyoneller için kritiktir.
Büyük veriye yeni başlayan kuruluşlar için Spark’ın daha esnek dağıtım seçenekleri ve daha basit programlama modeli genellikle başlamayı kolaylaştırır.
Buna karşın, depolama yönetiminin birincil endişe olduğu, son derece büyük veri hacimlerine sahip ortamlarda Hadoop’un olgun HDFS ekosistemi hâlâ Spark’ın işlem yeteneklerini tamamlayan avantajlar sunar. Spark’ın diğer akış teknolojileriyle karşılaştırması için, Flink vs. Spark gibi karşılaştırmalar bilgilendirici olabilir.
Hadoop MapReduce vs. Spark’ın İşleme Modeli
Önceki bölümler performans etkilerini tartışırken, her framework’ün temel işleme modellerini anlamak, neden bu kadar farklı şekilde tasarlandıklarını açıklamaya yardımcı olur.
Hadoop MapReduce framework’ü
MapReduce, iki ana aşamalı katı bir programlama paradigmasını izler: map ve reduce. Map aşaması, her bir kayda paralel olarak bir fonksiyon uygular ve ara anahtar-değer çiftleri üretir.
Bu çiftler, aynı anahtara sahip verilerin gruplandığı zorunlu bir karıştırma ve sıralama aşamasından geçer.
Son olarak reduce aşaması, bu gruplandırılmış değerleri birleştirerek nihai çıktıları üretir. Bu yapılandırılmış yaklaşım, karmaşık işlemler için birden fazla MapReduce işinin ardışık bağlanmasını gerektirir.
MapReduce uygulamaları geliştirmek genellikle map ve reduce fonksiyonlarını açıkça tanımlayan düşük seviyeli kod yazmayı içerir.
Apache Pig ve Apache Hive gibi framework’ler daha üst düzey soyutlamalar sunsa da, alttaki yürütme hâlâ katı MapReduce desenini izler; bu da algoritma tasarımı ve optimizasyon fırsatlarında sınırlamalar getirir.
Spark’ın veri işleme modeli
Spark, çekirdek soyutlaması olarak Resilient Distributed Datasets (RDD)’leri tanıttı — kurtarma için soy ağacını (lineage) izleyebilen, değiştirilemeyen ve bölümlenmiş koleksiyonlar. MapReduce’un aksine Spark, katı bir işlem deseni dayatmaz; bunun yerine iki tür işlem sunar: dönüşümler (yeni RDD’ler oluşturur) ve eylemler (değer döndürür).
Bu esneklik, map-reduce paradigmasının ötesinde çeşitli işleme desenlerine olanak tanır.
Spark, RDD’lerin ötesine geçerek DataFrame ve Dataset gibi daha üst düzey soyutlamalar sunar; bunlar ilişkisel veritabanlarına benzer optimizasyonlarla şema farkındalığı olan işlem sağlar. Bu soyutlamalar, akış, SQL, makine öğrenimi ve grafik işleme için uzman kütüphanelerle birleştiğinde, geliştiricilerin eşdeğer MapReduce uygulamalarına kıyasla önemli ölçüde daha az kodla karmaşık iş akışlarını ifade etmelerine olanak tanır; bunu yaparken farklı işleme paradigmaları arasında birleşik bir programlama modeli sağlar.
Spark ve Hadoop Maliyet Değerlendirmeleri
Büyük veri framework’lerini değerlendirirken kuruluşlar, yalnızca teknik yetenekleri değil, aynı zamanda dağıtım ve işletimin finansal etkilerini de göz önünde bulundurmalıdır.
Donanım gereksinimleri ve etkileri
Hadoop ve Spark’ın, altyapı maliyetlerini etkileyen temelde farklı donanım tercihleri vardır. Hadoop, belleğe kıyasla disk depolamayı önceliklendirecek şekilde tasarlanmıştır; bu da onu sınırlı RAM’e ancak yüksek disk kapasitesine sahip sıradan donanımlar için uygun kılar.
Bu mimari, özellikle bellek tabanlı çözümlerin maliyetinin yasaklayıcı olacağı kadar büyük veri kümeleri işlenirken, ilk donanım yatırımını azaltabilir.
Spark’ın bellekiçi işleme modeli performans avantajları sunar; ancak düğüm başına önemli ölçüde daha fazla RAM gerektirir. Doğru yapılandırılmış bir Spark kümesi, iş yüküne bağlı olarak genellikle düğüm başına 16 GB ile 256 GB arasında önemli bellek yapılandırmaları talep eder.
Bellek maliyetleri zamanla düşmüş olsa da, bu gereksinim disk merkezli Hadoop kurulumlarına kıyasla donanım giderlerini hâlâ artırabilir.
Operasyonel giderler
Operasyonel maliyetler, donanım ediniminin ötesinde devam eden bakım, elektrik, soğutma ve veri merkezi alanını da kapsar. Hadoop kümeleri, kapsamlı depolamaya sahip çok sayıda sıradan sunucuya dayanması nedeniyle genellikle daha büyük fiziksel alana ihtiyaç duyar.
Bu daha büyük ayak izi, güç, soğutma ve raf alanı maliyetlerini artırır.
Spark kümeleri, hesaplama kaynaklarını daha verimli kullanmaları sayesinde bazen aynı işlem yeteneklerini daha az düğümle sağlayabilir; bu da veri merkezi ayak izini ve ilişkili maliyetleri potansiyel olarak azaltır. Ancak gerek duyulan daha yüksek özellikli makineler, düğüm başına daha fazla güç tüketebilir ve bu tasarrufları kısmen dengeleyebilir.
Geliştirme ve personel maliyetleri
Uygulama ve bakımın karmaşıklığı, toplam sahip olma maliyetini önemli ölçüde etkileyebilir. Hadoop ekosistemi, geleneksel olarak Java programlama ve Unix yönetiminde uzmanlık gerektirirdi; MapReduce programlamasının ayrıntılı yapısı nedeniyle geliştirme döngüleri uzun sürebilirdi.
Spark, Python, Scala, R ve Java’da daha erişilebilir API’ler sunar; bu da geliştirme süresini ve ilgili personel maliyetlerini azaltabilir.
Daha sezgisel programlama modeli, öğrenme eğrisini ve geliştirme süresini düşürerek kuruluşların daha az uzman personelle daha hızlı çözümler uygulamasını sağlar.
Maliyet optimizasyon stratejileri
Maliyet hassas kuruluşlar için hibrit yaklaşımlar çoğu zaman en iyi değeri sunar. Depolama için HDFS’i kullanırken işlem için Spark’tan yararlanmak, Hadoop’un maliyet etkin depolamasını Spark’ın işleme verimliliğiyle birleştirebilir. AWS EMR, Azure HDInsight veya Google Dataproc gibi bulut tabanlı dağıtımlar, kuruluşların büyük peşin sermaye harcamaları olmadan yalnızca kullandıkları kaynaklar için ödeme yapmalarına olanak tanır.
Kuruluşlar, ölçeklenebilirlik maliyetlerini de göz önünde bulundurmalıdır. Hadoop, geleneksel olarak ölçekleme için manuel müdahale gerektirir ve bu da operasyonel yükü artırır. Spark’ın Kubernetes gibi konteyner orkestrasyon platformlarıyla uyumluluğu, gerçek talep ile kaynak sağlama arasında daha iyi eşleşme sağlayan daha otomatik ve esnek ölçeklemeyi mümkün kılar; bu da boşa giden kapasiteyi potansiyel olarak azaltır.
Hadoop ve Spark Karşılaştırma Tablosu
İşte farklarını özetleyen bir karşılaştırma tablosu:
Özellik
Hadoop
Spark
İşleme Modeli
MapReduce kullanarak toplu işleme
RDD, DataFrame ve Dataset kullanarak bellekiçi işleme
Performans
Aşamalar arası disk G/Ç nedeniyle daha yavaş
Yinelemeli ve bellekiçi iş yüklerinde 100x’e kadar daha hızlı
Bellek Kullanımı
Disk merkezli, düşük bellek gereksinimi
Bellek yoğun, yüksek RAM gereksinimi
Geliştirme Kolaylığı
Ayrıntılı; map ve reduce mantığını açıkça yazmayı gerektirir
Python, Scala, R, Java’da üst düzey API’ler; daha az şablon kod
Hata Toleransı
HDFS aracılığıyla veri çoğaltma
RDD soy ağacı, hata durumunda yeniden hesaplamayı sağlar
Gerçek Zamanlı İşleme
Uygun değil; yalnızca toplu iş
Spark Streaming ile gerçek zamanlı işlemeyi destekler
Küme Yöneticisi
YARN
Bağımsız, YARN, Mesos veya Kubernetes
Depolama
HDFS ile birlikte gelir
Harici depolamaya bağlıdır (ör. HDFS, S3, GCS)
Maliyet
Daha düşük donanım maliyeti (sıradan makineler, disk tabanlı)
Daha yüksek bellek maliyeti ancak iş yükü başına daha iyi kaynak kullanımı
En Uygun Olduğu
Toplu işler, devasa ölçekli depolama, geçmiş veri analizi
Makine öğrenimi, akış işleme, etkileşimli analitik
Entegrasyon
Güçlü Hadoop ekosistemi (Hive, Pig, vb.)
Tek platformda SQL, MLlib, GraphX ve Streaming için birleşik API’ler
Sonuç
Hadoop ve Spark, katı rakiplerden ziyade büyük veri işlemeye tamamlayıcı yaklaşımlar sunar. Hadoop, maliyet etkin depolama sistemi (HDFS) ve hızdan çok verimliliğin önemli olduğu devasa veri kümeleri için toplu iş odaklı işlemede öne çıkar.
Spark ise yinelemeli algoritmalar, etkileşimli analitik ve gerçek zamanlı ihtiyaçlar için üstün performans sağlayan bellekiçi işleme yetenekleriyle parlıyor.
Bu iki teknoloji hakkında daha fazla bilgi edinmek isterseniz DataCamp çeşitli kaynaklar sunuyor: