Hadoop và Spark là hai khung nổi bật trong lĩnh vực big data, nhưng cách chúng xử lý dữ liệu quy mô lớn lại rất khác nhau. Nếu như Hadoop góp phần dân chủ hóa mô hình tính toán phân tán nhờ hệ thống lưu trữ vững chắc HDFS và mô hình tính toán MapReduce, thì Spark đang thay đổi cuộc chơi với kiến trúc xử lý trong bộ nhớ và mô hình lập trình linh hoạt.
Hướng dẫn này đi sâu vào những khác biệt giữa Hadoop và Spark, bao gồm kiến trúc, hiệu năng, cân nhắc chi phí và khả năng tích hợp. Đến cuối bài, bạn sẽ hiểu rõ ưu nhược điểm của từng công nghệ và những trường hợp sử dụng mà mỗi khung phát huy thế mạnh; từ đó hỗ trợ bạn đưa ra quyết định chiến lược khi xây dựng giải pháp big data.
Tìm hiểu về Hadoop và Spark
Trước khi đi vào chi tiết, hãy cùng điểm qua các khái niệm nền tảng và nguồn gốc của Hadoop và Spark để hiểu cách những khung mạnh mẽ này tiếp cận các thách thức big data.
Hadoop là gì?
Hadoop là một khung mã nguồn mở được thiết kế để lưu trữ và xử lý các bộ dữ liệu lớn trên các cụm máy tính. Kể từ khi phát triển vào năm 2006, Hadoop đã giúp các tổ chức xử lý khối lượng dữ liệu khổng lồ mà một máy đơn lẻ không thể gánh nổi. Bằng cách phân tán dữ liệu qua nhiều nút, Hadoop không chỉ tăng khả năng xử lý mà còn cung cấp tính dự phòng, đảm bảo độ tin cậy của hệ thống ngay cả khi một số máy gặp sự cố.
Các thành phần chính của Hadoop bao gồm:
- Hadoop Distributed File System (HDFS): Nền tảng lưu trữ, chia tệp thành các khối và phân phối trên toàn cụm.
- MapReduce: Xử lý bằng cách chia nhỏ nhiệm vụ tính toán thành các đơn vị chạy song song trên cụm.
- YARN (Yet Another Resource Negotiator): Quản lý tài nguyên hiệu quả bằng cách phân bổ năng lực tính toán và lập lịch tác vụ trên các máy sẵn có.
Một trong những ưu điểm lớn của Hadoop là hiệu quả chi phí, cho phép tổ chức dùng phần cứng phổ thông thay vì thiết bị chuyên dụng đắt tiền. Triết lý xử lý của nó cũng mang tính thực dụng như vậy.
Thiết kế theo lô (batch) của Hadoop phát huy ở các kịch bản chú trọng thông lượng tổng thể hơn là tốc độ thuần túy, đặc biệt giá trị cho phân tích dữ liệu lịch sử và các thao tác ETL (Extract, Transform, Load) không đòi hỏi kết quả tức thời.
Apache Spark là gì?
Apache Spark ra đời năm 2010 nhằm khắc phục những hạn chế trong cách tiếp cận xử lý big data của Hadoop. Ban đầu được phát triển tại UC Berkeley trước khi trở thành dự án Apache, Spark giải quyết sự phụ thuộc nặng nề của Hadoop MapReduce vào hoạt động đĩa. Đột phá của Spark là tính toán trong bộ nhớ, giúp giảm đáng kể thời gian xử lý cho nhiều khối lượng công việc bằng cách tối thiểu hóa việc đọc/ghi đĩa.
Spark cung cấp một nền tảng thống nhất với nhiều thành phần tích hợp chặt chẽ xoay quanh lõi xử lý:
- Spark SQL: Làm việc với dữ liệu có cấu trúc
- MLlib: Triển khai các thuật toán học máy
- GraphX: Xử lý dữ liệu đồ thị
- Spark Streaming: Phân tích dữ liệu theo thời gian thực
Thiết kế đồng bộ này giúp đội ngũ giải quyết nhiều thách thức dữ liệu bằng một khung duy nhất thay vì phải xoay sở với nhiều công cụ chuyên biệt.
Dù khác biệt, Spark và Hadoop thường kết hợp như công nghệ bổ trợ thay vì cạnh tranh. Do Spark không bao gồm hệ thống lưu trữ riêng, nó thường dựa vào HDFS của Hadoop để lưu trữ dữ liệu lâu dài.
Ngoài ra, Spark có thể chạy trên bộ quản lý tài nguyên YARN của Hadoop, giúp các tổ chức dễ dàng tăng cường môi trường Hadoop hiện có bằng sức mạnh xử lý của Spark. Tính tương thích này tạo lộ trình nâng cấp thực tế, cho phép doanh nghiệp hưởng lợi từ Spark mà không phải từ bỏ đầu tư vào hạ tầng Hadoop.
So sánh hiệu năng Hadoop và Spark
Khi đánh giá các khung big data, hiệu năng thường là yếu tố quyết định cho các tổ chức có nhu cầu xử lý dữ liệu nhạy thời gian.
Tốc độ xử lý
MapReduce của Hadoop hoạt động dựa trên đĩa: đọc dữ liệu từ đĩa, xử lý, rồi ghi kết quả trở lại đĩa giữa mỗi giai đoạn tính toán. Hoạt động I/O đĩa này tạo độ trễ đáng kể, đặc biệt với các thuật toán lặp cần nhiều lần quét cùng dữ liệu.
Cách tiếp cận này hiệu quả cho xử lý theo lô các bộ dữ liệu khổng lồ, nhưng đánh đổi tốc độ để lấy độ tin cậy và thông lượng.
Ngược lại, Spark tính toán chủ yếu trong bộ nhớ, giảm mạnh nhu cầu thao tác với đĩa. Với nhiều khối lượng công việc, đặc biệt các thuật toán lặp như trong học máy, Spark có thể chạy nhanh hơn MapReduce của Hadoop tới 100 lần.
Ưu thế hiệu năng này càng rõ khi cần xử lý gần thời gian thực hoặc khi thuật toán phải đi qua dữ liệu nhiều lần.
Khai thác bộ nhớ
Thiết kế của Hadoop giả định bộ nhớ hạn chế, nên tiết kiệm bộ nhớ nhưng chậm hơn. Nó phụ thuộc nhiều vào lưu trữ đĩa, cho phép xử lý các bộ dữ liệu lớn hơn nhiều so với RAM sẵn có bằng cách liên tục hoán đổi dữ liệu giữa bộ nhớ và đĩa.
Cách này phù hợp để xử lý bộ dữ liệu cực lớn trên các cụm có tài nguyên bộ nhớ hạn chế.
Ưu thế của Spark đến từ việc tận dụng mạnh mẽ bộ nhớ. Bằng cách lưu đệm dữ liệu trong RAM xuyên suốt các giai đoạn xử lý, Spark loại bỏ nhiều thao tác đĩa tốn kém. Tuy nhiên, điều này đòi hỏi đủ bộ nhớ để chứa tập dữ liệu làm việc.
Khi bị giới hạn bộ nhớ, ưu thế của Spark giảm đi do bắt đầu tràn dữ liệu ra đĩa, dù cơ chế quản lý bộ nhớ thông minh của nó vẫn thường vượt trội so với cách tiếp cận ưu tiên đĩa của Hadoop.
Cân nhắc hiệu năng trong thực tế
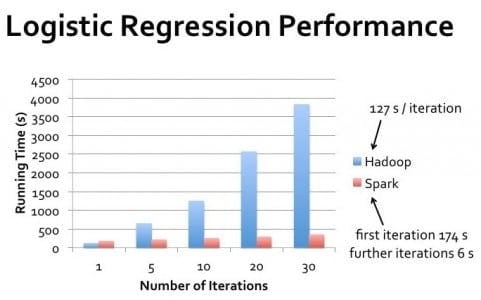
Khoảng cách hiệu năng giữa Hadoop và Spark trong thực tế thay đổi đáng kể theo từng trường hợp sử dụng. Với xử lý theo lô một lượt trên bộ dữ liệu khổng lồ vượt xa bộ nhớ sẵn có, hiệu năng của Hadoop có thể tiệm cận Spark.
Tuy nhiên, với xử lý lặp, truy vấn tương tác và xử lý luồng, Spark thường cho hiệu năng vượt trội.
Cũng cần lưu ý hiệu năng không chỉ là tốc độ thuần. Hadoop vượt trội trong các kịch bản cần khả năng chịu lỗi cao và xử lý diễn ra theo các cửa sổ batch xác định rõ.
Spark phát huy tốt nhất khi cần kết quả nhanh, như khám phá dữ liệu tương tác, phân tích thời gian thực và các ứng dụng học máy nơi thuật toán đi qua tập dữ liệu nhiều lần.
Quản lý cụm: Cụm Hadoop so với cụm Spark
Cả Hadoop và Spark đều dựa vào cụm để xử lý hiệu quả khối lượng dữ liệu lớn, nhưng chúng quản lý tài nguyên theo cách khác nhau, ảnh hưởng đến cả hiệu năng và quản trị.
Clustering là gì và vì sao cần thiết
Cụm là tập hợp các máy tính (nút) kết nối với nhau và hoạt động như một hệ thống duy nhất. Trong xử lý big data, clustering trở nên cần thiết khi khối lượng dữ liệu vượt quá khả năng xử lý hiệu quả của một máy đơn. Bằng cách phân phối tác vụ tính toán qua nhiều máy, cụm cho phép tổ chức xử lý petabyte dữ liệu mà nếu không sẽ bất khả thi.
Clustering cũng cung cấp khả năng chịu lỗi và sẵn sàng cao. Nếu một máy hỏng, các máy khác có thể tiếp quản khối lượng công việc, đảm bảo vận hành liên tục. Tính bền bỉ này rất quan trọng với môi trường sản xuất, nơi thời gian chết có thể tốn kém.
Ngoài ra, clustering cho phép mở rộng ngang — thêm máy để tăng năng lực xử lý — thường tiết kiệm chi phí hơn so với nâng cấp từng hệ thống.
Với những người muốn theo đuổi lĩnh vực này, hiểu về clustering là kỹ năng nền tảng trong kỹ thuật dữ liệu (data engineering).
Kiến trúc cụm Hadoop
Cụm Hadoop theo kiến trúc chủ - tớ với vai trò chuyên biệt cho từng nút. NameNode đóng vai trò chủ cho HDFS, duy trì siêu dữ liệu về vị trí tệp và quyền truy cập. DataNode lưu trữ các khối dữ liệu thực và báo cáo lại cho NameNode.
Đối với xử lý, ResourceManager phân bổ tài nguyên cụm, còn NodeManager trên từng máy thực thi tác vụ.
HDFS sao chép dữ liệu qua nhiều DataNode, thường duy trì ba bản của mỗi khối dữ liệu. Chiến lược sao chép này đảm bảo tính sẵn sàng dữ liệu ngay cả khi một số nút hỏng, dù đòi hỏi thêm dung lượng lưu trữ.
Thiết kế cụm Hadoop nhấn mạnh tính địa phương dữ liệu, cố gắng lập lịch tác vụ tính toán ngay trên các nút lưu dữ liệu nhằm giảm truyền tải qua mạng.
Quản trị cụm Hadoop truyền thống cần chuyên môn sâu (nhiều chuyên gia chuẩn bị câu hỏi phỏng vấn Hadoop để thể hiện hiểu biết này), dù các bản phân phối hiện đại đã có công cụ giúp đơn giản hóa cấu hình và giám sát.
Mở rộng cụm Hadoop gồm thêm nút mới và cân bằng lại dữ liệu trên hạ tầng mở rộng, có thể là quy trình thủ công đòi hỏi lập kế hoạch cẩn thận.
Kiến trúc cụm Spark
Spark có thể vận hành ở nhiều cấu hình cụm, gồm chế độ độc lập (standalone), trên Hadoop YARN, Apache Mesos hoặc Kubernetes. Ở mọi môi trường, Spark theo mô hình driver - executor. Chương trình driver chứa hàm chính của ứng dụng và tạo SparkContext để phối hợp với trình quản lý cụm nhằm phân bổ tài nguyên.
Khi tài nguyên được phân bổ, các executor của Spark được khởi chạy trên nút worker. Đây là các tiến trình JVM chạy tác vụ và lưu trữ dữ liệu trong bộ nhớ hoặc đĩa. Không giống Hadoop duy trì hiện diện thường trực trên các nút cụm, executor của Spark có thể được cấp phát và giải phóng động theo nhu cầu ứng dụng, giúp cải thiện sử dụng tài nguyên.
Bạn đọc quan tâm có thể khám phá thêm năng lực của Spark qua các hướng dẫn thực hành như Apache Spark cho Học máy.
Spark không bao gồm hệ thống lưu trữ phân tán riêng, mà tận dụng các giải pháp sẵn có như HDFS, Amazon S3 hoặc hệ thống tương thích khác. Việc tách biệt giữa tính toán và lưu trữ mang lại sự linh hoạt nhưng đòi hỏi cấu hình cẩn trọng để tối ưu mẫu truy cập dữ liệu.
Các công cụ như Spark SQL và sparklyr mang lại cách thức thuận tiện để tương tác với kiến trúc này.
Khác biệt chính trong quản lý cụm
Cách tiếp cận quản lý cụm của Hadoop thiên về hạ tầng, với phân bổ tài nguyên tương đối tĩnh và tập trung vào tính địa phương dữ liệu. Thiết kế này phù hợp cho các job batch chạy lâu trên cụm ổn định nơi các nút ít thay đổi.
Tuy nhiên, nó kém linh hoạt trước biến động tải công việc và đòi hỏi can thiệp thủ công nhiều hơn khi mở rộng.
Spark cung cấp quản lý tài nguyên linh hoạt hơn, đặc biệt khi chạy trên các nền tảng điều phối hiện đại như Kubernetes. Nó có thể điều chỉnh phân bổ tài nguyên theo nhu cầu hiện tại và giải phóng khi không cần.
Tính đàn hồi này hữu ích cho các tổ chức có tải công việc biến động hoặc hạ tầng dùng chung cho nhiều ứng dụng.
Hiểu những khác biệt này rất quan trọng cho các chuyên gia đang theo đuổi chứng chỉ Data Engineer hoặc chuẩn bị cho câu hỏi phỏng vấn Spark.
Với các tổ chức mới bắt đầu với big data, lựa chọn triển khai linh hoạt hơn và mô hình lập trình đơn giản hơn của Spark thường giúp khởi đầu dễ dàng.
Tuy vậy, trong môi trường có khối lượng dữ liệu cực lớn, nơi quản lý lưu trữ là mối quan tâm chính, hệ sinh thái HDFS trưởng thành của Hadoop vẫn có lợi thế bổ trợ tốt cho năng lực xử lý của Spark. Để so sánh Spark với công nghệ streaming khác, bạn có thể tham khảo bài như Flink vs. Spark.
MapReduce của Hadoop so với mô hình xử lý của Spark
Dù các phần trước đã bàn về hệ quả hiệu năng, việc hiểu mô hình xử lý nền tảng của mỗi khung sẽ giải thích vì sao kiến trúc của chúng khác nhau đến vậy.
Khung Hadoop MapReduce
MapReduce tuân theo mô hình lập trình chặt chẽ với hai pha chính: map và reduce. Pha map áp dụng hàm lên từng bản ghi song song, tạo ra các cặp khóa - giá trị trung gian.
Các cặp này trải qua pha xáo trộn và sắp xếp bắt buộc, nơi dữ liệu có cùng khóa được nhóm lại.
Cuối cùng, pha reduce tổng hợp các giá trị đã nhóm để tạo đầu ra cuối cùng. Cách tiếp cận cấu trúc này khiến các thao tác phức tạp phải xâu chuỗi nhiều job MapReduce với nhau.
Phát triển ứng dụng MapReduce thường đòi hỏi viết mã mức thấp để định nghĩa tường minh các hàm map và reduce.
Dù các khung như Apache Pig và Apache Hive cung cấp trừu tượng cấp cao hơn, phần thực thi bên dưới vẫn theo khuôn mẫu MapReduce nghiêm ngặt, áp đặt giới hạn cho thiết kế thuật toán và cơ hội tối ưu.
Mô hình xử lý dữ liệu của Spark
Spark giới thiệu Resilient Distributed Datasets (RDD) làm trừu tượng cốt lõi — các tập hợp bất biến, được phân mảnh có thể theo dõi phả hệ để khôi phục. Khác với MapReduce, Spark không ép theo khuôn xử lý cứng nhắc mà cung cấp hai loại thao tác: transformation (tạo RDD mới) và action (trả về giá trị).
Sự linh hoạt này cho phép các mẫu xử lý đa dạng vượt ra ngoài mô hình map-reduce.
Spark đã vượt qua RDD để cung cấp các trừu tượng cấp cao như DataFrame và Dataset, cung cấp xử lý theo lược đồ với tối ưu hóa tương tự cơ sở dữ liệu quan hệ. Các trừu tượng này, kết hợp thư viện chuyên biệt cho streaming, SQL, học máy và xử lý đồ thị, cho phép nhà phát triển biểu đạt quy trình phức tạp với ít mã hơn đáng kể so với MapReduce tương đương, đồng thời duy trì mô hình lập trình thống nhất cho nhiều dạng xử lý.
Cân nhắc chi phí: Spark so với Hadoop
Khi đánh giá các khung big data, tổ chức cần cân nhắc không chỉ năng lực kỹ thuật mà cả tác động tài chính khi triển khai và vận hành.
Yêu cầu phần cứng và hệ quả
Hadoop và Spark có ưu tiên phần cứng khác nhau, ảnh hưởng đến chi phí hạ tầng. Hadoop ưu tiên lưu trữ đĩa hơn bộ nhớ, phù hợp với phần cứng phổ thông có RAM hạn chế nhưng dung lượng đĩa lớn.
Kiến trúc này có thể giảm đầu tư phần cứng ban đầu, nhất là khi xử lý bộ dữ liệu cực lớn mà giải pháp dựa trên bộ nhớ sẽ quá tốn kém.
Mô hình xử lý trong bộ nhớ của Spark đem lại lợi thế hiệu năng nhưng yêu cầu nhiều RAM hơn đáng kể trên mỗi nút. Một cụm Spark cấu hình đúng thường đòi hỏi máy chủ có cấu hình bộ nhớ lớn — thường từ 16GB đến 256GB mỗi nút tùy đặc thù tải công việc.
Dù chi phí bộ nhớ đã giảm theo thời gian, yêu cầu này vẫn có thể làm tăng chi phí phần cứng so với triển khai Hadoop thiên về đĩa.
Chi phí vận hành
Chi phí vận hành không chỉ gồm mua sắm phần cứng mà còn bảo trì, điện năng, làm mát và không gian trung tâm dữ liệu. Cụm Hadoop thường có “dấu chân” vật lý lớn hơn do dựa vào nhiều máy phổ thông với lưu trữ lớn.
Dấu chân lớn hơn đồng nghĩa chi phí điện, làm mát và không gian giá đỡ cao hơn.
Cụm Spark đôi khi có thể đạt cùng năng lực xử lý với ít nút hơn do sử dụng tài nguyên tính toán hiệu quả hơn, tiềm năng giảm dấu chân trung tâm dữ liệu và chi phí liên quan. Tuy nhiên, các máy cấu hình cao hơn có thể tiêu thụ nhiều điện trên mỗi nút, phần nào bù trừ khoản tiết kiệm này.
Chi phí phát triển và nhân sự
Độ phức tạp khi triển khai và bảo trì có thể ảnh hưởng lớn đến tổng chi phí sở hữu. Hệ sinh thái Hadoop truyền thống đòi hỏi chuyên môn chuyên sâu về lập trình Java và quản trị Unix, với vòng đời phát triển có thể kéo dài do tính dài dòng của lập trình MapReduce.
Spark cung cấp API dễ tiếp cận hơn bằng Python, Scala, R và Java, giúp rút ngắn thời gian phát triển và chi phí nhân sự liên quan.
Mô hình lập trình trực quan hơn có thể giảm đường cong học tập và thời gian phát triển, cho phép tổ chức triển khai giải pháp nhanh hơn với ít nhân sự chuyên biệt hơn.
Chiến lược tối ưu chi phí
Với tổ chức nhạy cảm về chi phí, cách tiếp cận lai thường mang lại giá trị tốt nhất. Dùng HDFS cho lưu trữ trong khi tận dụng Spark cho xử lý có thể kết hợp lưu trữ tiết kiệm chi phí của Hadoop với hiệu quả xử lý của Spark. Triển khai trên đám mây như AWS EMR, Azure HDInsight hoặc Google Dataproc cho phép trả tiền theo mức sử dụng, không cần chi phí vốn lớn ban đầu.
Các tổ chức cũng nên cân nhắc chi phí mở rộng. Hadoop truyền thống cần can thiệp thủ công khi mở rộng, làm tăng chi phí vận hành. Khả năng tương thích của Spark với nền tảng điều phối container như Kubernetes cho phép mở rộng đàn hồi, tự động hóa hơn, có thể khớp việc cấp phát tài nguyên với nhu cầu thực, giảm công suất lãng phí.
Bảng so sánh Hadoop và Spark
Dưới đây là bảng so sánh tóm tắt các khác biệt:
|
Tính năng
|
Hadoop
|
Spark
|
|
Mô hình xử lý
|
Xử lý theo lô bằng MapReduce
|
Xử lý trong bộ nhớ bằng RDD, DataFrame và Dataset
|
|
Hiệu năng
|
Chậm hơn do I/O đĩa giữa các giai đoạn
|
Nhanh hơn tới 100x với tác vụ lặp và khối lượng làm việc trong bộ nhớ
|
|
Sử dụng bộ nhớ
|
Thiên về đĩa, yêu cầu bộ nhớ thấp
|
Tiêu tốn bộ nhớ, yêu cầu RAM cao
|
|
Dễ phát triển
|
Dài dòng; phải viết tường minh logic map & reduce
|
API cấp cao bằng Python, Scala, R, Java; ít mã lặp khuôn
|
|
Chịu lỗi
|
Sao chép dữ liệu qua HDFS
|
Phả hệ RDD cho phép tính toán lại khi lỗi
|
|
Xử lý thời gian thực
|
Không lý tưởng; chỉ theo lô
|
Hỗ trợ xử lý thời gian thực qua Spark Streaming
|
|
Trình quản lý cụm
|
YARN
|
Standalone, YARN, Mesos hoặc Kubernetes
|
|
Lưu trữ
|
Đi kèm HDFS
|
Phụ thuộc lưu trữ bên ngoài (ví dụ: HDFS, S3, GCS)
|
|
Chi phí
|
Chi phí phần cứng thấp (máy phổ thông, dựa trên đĩa)
|
Chi phí bộ nhớ cao hơn nhưng sử dụng tài nguyên tốt hơn theo tải công việc
|
|
Phù hợp nhất cho
|
Job batch, lưu trữ quy mô cực lớn, phân tích dữ liệu lịch sử
|
Học máy, xử lý luồng, phân tích tương tác
|
|
Tích hợp
|
Hệ sinh thái Hadoop mạnh (Hive, Pig, v.v.)
|
API thống nhất cho SQL, MLlib, GraphX và Streaming trên một nền tảng
|
Kết luận
Hadoop và Spark là những cách tiếp cận bổ trợ cho xử lý big data hơn là đối thủ trực tiếp. Hadoop nổi bật với hệ thống lưu trữ tiết kiệm chi phí (HDFS) và xử lý theo lô cho bộ dữ liệu khổng lồ nơi thông lượng quan trọng hơn tốc độ.
Spark tỏa sáng với khả năng xử lý trong bộ nhớ, mang lại hiệu năng vượt trội cho thuật toán lặp, phân tích tương tác và nhu cầu xử lý thời gian thực.
DataCamp cung cấp nhiều tài nguyên nếu bạn muốn tìm hiểu thêm về hai công nghệ này:


Hadoop và Spark là hai khung nổi bật trong lĩnh vực big data, nhưng cách chúng xử lý dữ liệu quy mô lớn lại rất khác nhau. Nếu như Hadoop góp phần dân chủ hóa mô hình tính toán phân tán nhờ hệ thống lưu trữ vững chắc HDFS và mô hình tính toán MapReduce, thì Spark đang thay đổi cuộc chơi với kiến trúc xử lý trong bộ nhớ và mô hình lập trình linh hoạt.
Hướng dẫn này đi sâu vào những khác biệt giữa Hadoop và Spark, bao gồm kiến trúc, hiệu năng, cân nhắc chi phí và khả năng tích hợp. Đến cuối bài, bạn sẽ hiểu rõ ưu nhược điểm của từng công nghệ và những trường hợp sử dụng mà mỗi khung phát huy thế mạnh; từ đó hỗ trợ bạn đưa ra quyết định chiến lược khi xây dựng giải pháp big data.
Tìm hiểu về Hadoop và Spark
Trước khi đi vào chi tiết, hãy cùng điểm qua các khái niệm nền tảng và nguồn gốc của Hadoop và Spark để hiểu cách những khung mạnh mẽ này tiếp cận các thách thức big data.
Hadoop là gì?
Hadoop là một khung mã nguồn mở được thiết kế để lưu trữ và xử lý các bộ dữ liệu lớn trên các cụm máy tính. Kể từ khi phát triển vào năm 2006, Hadoop đã giúp các tổ chức xử lý khối lượng dữ liệu khổng lồ mà một máy đơn lẻ không thể gánh nổi. Bằng cách phân tán dữ liệu qua nhiều nút, Hadoop không chỉ tăng khả năng xử lý mà còn cung cấp tính dự phòng, đảm bảo độ tin cậy của hệ thống ngay cả khi một số máy gặp sự cố.
Các thành phần chính của Hadoop bao gồm:
Một trong những ưu điểm lớn của Hadoop là hiệu quả chi phí, cho phép tổ chức dùng phần cứng phổ thông thay vì thiết bị chuyên dụng đắt tiền. Triết lý xử lý của nó cũng mang tính thực dụng như vậy.
Thiết kế theo lô (batch) của Hadoop phát huy ở các kịch bản chú trọng thông lượng tổng thể hơn là tốc độ thuần túy, đặc biệt giá trị cho phân tích dữ liệu lịch sử và các thao tác ETL (Extract, Transform, Load) không đòi hỏi kết quả tức thời.
Apache Spark là gì?
Apache Spark ra đời năm 2010 nhằm khắc phục những hạn chế trong cách tiếp cận xử lý big data của Hadoop. Ban đầu được phát triển tại UC Berkeley trước khi trở thành dự án Apache, Spark giải quyết sự phụ thuộc nặng nề của Hadoop MapReduce vào hoạt động đĩa. Đột phá của Spark là tính toán trong bộ nhớ, giúp giảm đáng kể thời gian xử lý cho nhiều khối lượng công việc bằng cách tối thiểu hóa việc đọc/ghi đĩa.
Spark cung cấp một nền tảng thống nhất với nhiều thành phần tích hợp chặt chẽ xoay quanh lõi xử lý:
Thiết kế đồng bộ này giúp đội ngũ giải quyết nhiều thách thức dữ liệu bằng một khung duy nhất thay vì phải xoay sở với nhiều công cụ chuyên biệt.
Dù khác biệt, Spark và Hadoop thường kết hợp như công nghệ bổ trợ thay vì cạnh tranh. Do Spark không bao gồm hệ thống lưu trữ riêng, nó thường dựa vào HDFS của Hadoop để lưu trữ dữ liệu lâu dài.
Ngoài ra, Spark có thể chạy trên bộ quản lý tài nguyên YARN của Hadoop, giúp các tổ chức dễ dàng tăng cường môi trường Hadoop hiện có bằng sức mạnh xử lý của Spark. Tính tương thích này tạo lộ trình nâng cấp thực tế, cho phép doanh nghiệp hưởng lợi từ Spark mà không phải từ bỏ đầu tư vào hạ tầng Hadoop.
So sánh hiệu năng Hadoop và Spark
Khi đánh giá các khung big data, hiệu năng thường là yếu tố quyết định cho các tổ chức có nhu cầu xử lý dữ liệu nhạy thời gian.
Tốc độ xử lý
MapReduce của Hadoop hoạt động dựa trên đĩa: đọc dữ liệu từ đĩa, xử lý, rồi ghi kết quả trở lại đĩa giữa mỗi giai đoạn tính toán. Hoạt động I/O đĩa này tạo độ trễ đáng kể, đặc biệt với các thuật toán lặp cần nhiều lần quét cùng dữ liệu.
Cách tiếp cận này hiệu quả cho xử lý theo lô các bộ dữ liệu khổng lồ, nhưng đánh đổi tốc độ để lấy độ tin cậy và thông lượng.
Ngược lại, Spark tính toán chủ yếu trong bộ nhớ, giảm mạnh nhu cầu thao tác với đĩa. Với nhiều khối lượng công việc, đặc biệt các thuật toán lặp như trong học máy, Spark có thể chạy nhanh hơn MapReduce của Hadoop tới 100 lần.
Ưu thế hiệu năng này càng rõ khi cần xử lý gần thời gian thực hoặc khi thuật toán phải đi qua dữ liệu nhiều lần.
Khai thác bộ nhớ
Thiết kế của Hadoop giả định bộ nhớ hạn chế, nên tiết kiệm bộ nhớ nhưng chậm hơn. Nó phụ thuộc nhiều vào lưu trữ đĩa, cho phép xử lý các bộ dữ liệu lớn hơn nhiều so với RAM sẵn có bằng cách liên tục hoán đổi dữ liệu giữa bộ nhớ và đĩa.
Cách này phù hợp để xử lý bộ dữ liệu cực lớn trên các cụm có tài nguyên bộ nhớ hạn chế.
Ưu thế của Spark đến từ việc tận dụng mạnh mẽ bộ nhớ. Bằng cách lưu đệm dữ liệu trong RAM xuyên suốt các giai đoạn xử lý, Spark loại bỏ nhiều thao tác đĩa tốn kém. Tuy nhiên, điều này đòi hỏi đủ bộ nhớ để chứa tập dữ liệu làm việc.
Khi bị giới hạn bộ nhớ, ưu thế của Spark giảm đi do bắt đầu tràn dữ liệu ra đĩa, dù cơ chế quản lý bộ nhớ thông minh của nó vẫn thường vượt trội so với cách tiếp cận ưu tiên đĩa của Hadoop.
Cân nhắc hiệu năng trong thực tế
Khoảng cách hiệu năng giữa Hadoop và Spark trong thực tế thay đổi đáng kể theo từng trường hợp sử dụng. Với xử lý theo lô một lượt trên bộ dữ liệu khổng lồ vượt xa bộ nhớ sẵn có, hiệu năng của Hadoop có thể tiệm cận Spark.
Tuy nhiên, với xử lý lặp, truy vấn tương tác và xử lý luồng, Spark thường cho hiệu năng vượt trội.
Cũng cần lưu ý hiệu năng không chỉ là tốc độ thuần. Hadoop vượt trội trong các kịch bản cần khả năng chịu lỗi cao và xử lý diễn ra theo các cửa sổ batch xác định rõ.
Spark phát huy tốt nhất khi cần kết quả nhanh, như khám phá dữ liệu tương tác, phân tích thời gian thực và các ứng dụng học máy nơi thuật toán đi qua tập dữ liệu nhiều lần.
Quản lý cụm: Cụm Hadoop so với cụm Spark
Cả Hadoop và Spark đều dựa vào cụm để xử lý hiệu quả khối lượng dữ liệu lớn, nhưng chúng quản lý tài nguyên theo cách khác nhau, ảnh hưởng đến cả hiệu năng và quản trị.
Clustering là gì và vì sao cần thiết
Cụm là tập hợp các máy tính (nút) kết nối với nhau và hoạt động như một hệ thống duy nhất. Trong xử lý big data, clustering trở nên cần thiết khi khối lượng dữ liệu vượt quá khả năng xử lý hiệu quả của một máy đơn. Bằng cách phân phối tác vụ tính toán qua nhiều máy, cụm cho phép tổ chức xử lý petabyte dữ liệu mà nếu không sẽ bất khả thi.
Clustering cũng cung cấp khả năng chịu lỗi và sẵn sàng cao. Nếu một máy hỏng, các máy khác có thể tiếp quản khối lượng công việc, đảm bảo vận hành liên tục. Tính bền bỉ này rất quan trọng với môi trường sản xuất, nơi thời gian chết có thể tốn kém.
Ngoài ra, clustering cho phép mở rộng ngang — thêm máy để tăng năng lực xử lý — thường tiết kiệm chi phí hơn so với nâng cấp từng hệ thống.
Với những người muốn theo đuổi lĩnh vực này, hiểu về clustering là kỹ năng nền tảng trong kỹ thuật dữ liệu (data engineering).
Kiến trúc cụm Hadoop
Cụm Hadoop theo kiến trúc chủ - tớ với vai trò chuyên biệt cho từng nút. NameNode đóng vai trò chủ cho HDFS, duy trì siêu dữ liệu về vị trí tệp và quyền truy cập. DataNode lưu trữ các khối dữ liệu thực và báo cáo lại cho NameNode.
Đối với xử lý, ResourceManager phân bổ tài nguyên cụm, còn NodeManager trên từng máy thực thi tác vụ.
HDFS sao chép dữ liệu qua nhiều DataNode, thường duy trì ba bản của mỗi khối dữ liệu. Chiến lược sao chép này đảm bảo tính sẵn sàng dữ liệu ngay cả khi một số nút hỏng, dù đòi hỏi thêm dung lượng lưu trữ.
Thiết kế cụm Hadoop nhấn mạnh tính địa phương dữ liệu, cố gắng lập lịch tác vụ tính toán ngay trên các nút lưu dữ liệu nhằm giảm truyền tải qua mạng.
Quản trị cụm Hadoop truyền thống cần chuyên môn sâu (nhiều chuyên gia chuẩn bị câu hỏi phỏng vấn Hadoop để thể hiện hiểu biết này), dù các bản phân phối hiện đại đã có công cụ giúp đơn giản hóa cấu hình và giám sát.
Mở rộng cụm Hadoop gồm thêm nút mới và cân bằng lại dữ liệu trên hạ tầng mở rộng, có thể là quy trình thủ công đòi hỏi lập kế hoạch cẩn thận.
Kiến trúc cụm Spark
Spark có thể vận hành ở nhiều cấu hình cụm, gồm chế độ độc lập (standalone), trên Hadoop YARN, Apache Mesos hoặc Kubernetes. Ở mọi môi trường, Spark theo mô hình driver - executor. Chương trình driver chứa hàm chính của ứng dụng và tạo SparkContext để phối hợp với trình quản lý cụm nhằm phân bổ tài nguyên.
Khi tài nguyên được phân bổ, các executor của Spark được khởi chạy trên nút worker. Đây là các tiến trình JVM chạy tác vụ và lưu trữ dữ liệu trong bộ nhớ hoặc đĩa. Không giống Hadoop duy trì hiện diện thường trực trên các nút cụm, executor của Spark có thể được cấp phát và giải phóng động theo nhu cầu ứng dụng, giúp cải thiện sử dụng tài nguyên.
Bạn đọc quan tâm có thể khám phá thêm năng lực của Spark qua các hướng dẫn thực hành như Apache Spark cho Học máy.
Spark không bao gồm hệ thống lưu trữ phân tán riêng, mà tận dụng các giải pháp sẵn có như HDFS, Amazon S3 hoặc hệ thống tương thích khác. Việc tách biệt giữa tính toán và lưu trữ mang lại sự linh hoạt nhưng đòi hỏi cấu hình cẩn trọng để tối ưu mẫu truy cập dữ liệu.
Các công cụ như Spark SQL và sparklyr mang lại cách thức thuận tiện để tương tác với kiến trúc này.
Khác biệt chính trong quản lý cụm
Cách tiếp cận quản lý cụm của Hadoop thiên về hạ tầng, với phân bổ tài nguyên tương đối tĩnh và tập trung vào tính địa phương dữ liệu. Thiết kế này phù hợp cho các job batch chạy lâu trên cụm ổn định nơi các nút ít thay đổi.
Tuy nhiên, nó kém linh hoạt trước biến động tải công việc và đòi hỏi can thiệp thủ công nhiều hơn khi mở rộng.
Spark cung cấp quản lý tài nguyên linh hoạt hơn, đặc biệt khi chạy trên các nền tảng điều phối hiện đại như Kubernetes. Nó có thể điều chỉnh phân bổ tài nguyên theo nhu cầu hiện tại và giải phóng khi không cần.
Tính đàn hồi này hữu ích cho các tổ chức có tải công việc biến động hoặc hạ tầng dùng chung cho nhiều ứng dụng.
Hiểu những khác biệt này rất quan trọng cho các chuyên gia đang theo đuổi chứng chỉ Data Engineer hoặc chuẩn bị cho câu hỏi phỏng vấn Spark.
Với các tổ chức mới bắt đầu với big data, lựa chọn triển khai linh hoạt hơn và mô hình lập trình đơn giản hơn của Spark thường giúp khởi đầu dễ dàng.
Tuy vậy, trong môi trường có khối lượng dữ liệu cực lớn, nơi quản lý lưu trữ là mối quan tâm chính, hệ sinh thái HDFS trưởng thành của Hadoop vẫn có lợi thế bổ trợ tốt cho năng lực xử lý của Spark. Để so sánh Spark với công nghệ streaming khác, bạn có thể tham khảo bài như Flink vs. Spark.
MapReduce của Hadoop so với mô hình xử lý của Spark
Dù các phần trước đã bàn về hệ quả hiệu năng, việc hiểu mô hình xử lý nền tảng của mỗi khung sẽ giải thích vì sao kiến trúc của chúng khác nhau đến vậy.
Khung Hadoop MapReduce
MapReduce tuân theo mô hình lập trình chặt chẽ với hai pha chính: map và reduce. Pha map áp dụng hàm lên từng bản ghi song song, tạo ra các cặp khóa - giá trị trung gian.
Các cặp này trải qua pha xáo trộn và sắp xếp bắt buộc, nơi dữ liệu có cùng khóa được nhóm lại.
Cuối cùng, pha reduce tổng hợp các giá trị đã nhóm để tạo đầu ra cuối cùng. Cách tiếp cận cấu trúc này khiến các thao tác phức tạp phải xâu chuỗi nhiều job MapReduce với nhau.
Phát triển ứng dụng MapReduce thường đòi hỏi viết mã mức thấp để định nghĩa tường minh các hàm map và reduce.
Dù các khung như Apache Pig và Apache Hive cung cấp trừu tượng cấp cao hơn, phần thực thi bên dưới vẫn theo khuôn mẫu MapReduce nghiêm ngặt, áp đặt giới hạn cho thiết kế thuật toán và cơ hội tối ưu.
Mô hình xử lý dữ liệu của Spark
Spark giới thiệu Resilient Distributed Datasets (RDD) làm trừu tượng cốt lõi — các tập hợp bất biến, được phân mảnh có thể theo dõi phả hệ để khôi phục. Khác với MapReduce, Spark không ép theo khuôn xử lý cứng nhắc mà cung cấp hai loại thao tác: transformation (tạo RDD mới) và action (trả về giá trị).
Sự linh hoạt này cho phép các mẫu xử lý đa dạng vượt ra ngoài mô hình map-reduce.
Spark đã vượt qua RDD để cung cấp các trừu tượng cấp cao như DataFrame và Dataset, cung cấp xử lý theo lược đồ với tối ưu hóa tương tự cơ sở dữ liệu quan hệ. Các trừu tượng này, kết hợp thư viện chuyên biệt cho streaming, SQL, học máy và xử lý đồ thị, cho phép nhà phát triển biểu đạt quy trình phức tạp với ít mã hơn đáng kể so với MapReduce tương đương, đồng thời duy trì mô hình lập trình thống nhất cho nhiều dạng xử lý.
Cân nhắc chi phí: Spark so với Hadoop
Khi đánh giá các khung big data, tổ chức cần cân nhắc không chỉ năng lực kỹ thuật mà cả tác động tài chính khi triển khai và vận hành.
Yêu cầu phần cứng và hệ quả
Hadoop và Spark có ưu tiên phần cứng khác nhau, ảnh hưởng đến chi phí hạ tầng. Hadoop ưu tiên lưu trữ đĩa hơn bộ nhớ, phù hợp với phần cứng phổ thông có RAM hạn chế nhưng dung lượng đĩa lớn.
Kiến trúc này có thể giảm đầu tư phần cứng ban đầu, nhất là khi xử lý bộ dữ liệu cực lớn mà giải pháp dựa trên bộ nhớ sẽ quá tốn kém.
Mô hình xử lý trong bộ nhớ của Spark đem lại lợi thế hiệu năng nhưng yêu cầu nhiều RAM hơn đáng kể trên mỗi nút. Một cụm Spark cấu hình đúng thường đòi hỏi máy chủ có cấu hình bộ nhớ lớn — thường từ 16GB đến 256GB mỗi nút tùy đặc thù tải công việc.
Dù chi phí bộ nhớ đã giảm theo thời gian, yêu cầu này vẫn có thể làm tăng chi phí phần cứng so với triển khai Hadoop thiên về đĩa.
Chi phí vận hành
Chi phí vận hành không chỉ gồm mua sắm phần cứng mà còn bảo trì, điện năng, làm mát và không gian trung tâm dữ liệu. Cụm Hadoop thường có “dấu chân” vật lý lớn hơn do dựa vào nhiều máy phổ thông với lưu trữ lớn.
Dấu chân lớn hơn đồng nghĩa chi phí điện, làm mát và không gian giá đỡ cao hơn.
Cụm Spark đôi khi có thể đạt cùng năng lực xử lý với ít nút hơn do sử dụng tài nguyên tính toán hiệu quả hơn, tiềm năng giảm dấu chân trung tâm dữ liệu và chi phí liên quan. Tuy nhiên, các máy cấu hình cao hơn có thể tiêu thụ nhiều điện trên mỗi nút, phần nào bù trừ khoản tiết kiệm này.
Chi phí phát triển và nhân sự
Độ phức tạp khi triển khai và bảo trì có thể ảnh hưởng lớn đến tổng chi phí sở hữu. Hệ sinh thái Hadoop truyền thống đòi hỏi chuyên môn chuyên sâu về lập trình Java và quản trị Unix, với vòng đời phát triển có thể kéo dài do tính dài dòng của lập trình MapReduce.
Spark cung cấp API dễ tiếp cận hơn bằng Python, Scala, R và Java, giúp rút ngắn thời gian phát triển và chi phí nhân sự liên quan.
Mô hình lập trình trực quan hơn có thể giảm đường cong học tập và thời gian phát triển, cho phép tổ chức triển khai giải pháp nhanh hơn với ít nhân sự chuyên biệt hơn.
Chiến lược tối ưu chi phí
Với tổ chức nhạy cảm về chi phí, cách tiếp cận lai thường mang lại giá trị tốt nhất. Dùng HDFS cho lưu trữ trong khi tận dụng Spark cho xử lý có thể kết hợp lưu trữ tiết kiệm chi phí của Hadoop với hiệu quả xử lý của Spark. Triển khai trên đám mây như AWS EMR, Azure HDInsight hoặc Google Dataproc cho phép trả tiền theo mức sử dụng, không cần chi phí vốn lớn ban đầu.
Các tổ chức cũng nên cân nhắc chi phí mở rộng. Hadoop truyền thống cần can thiệp thủ công khi mở rộng, làm tăng chi phí vận hành. Khả năng tương thích của Spark với nền tảng điều phối container như Kubernetes cho phép mở rộng đàn hồi, tự động hóa hơn, có thể khớp việc cấp phát tài nguyên với nhu cầu thực, giảm công suất lãng phí.
Bảng so sánh Hadoop và Spark
Dưới đây là bảng so sánh tóm tắt các khác biệt:
Tính năng
Hadoop
Spark
Mô hình xử lý
Xử lý theo lô bằng MapReduce
Xử lý trong bộ nhớ bằng RDD, DataFrame và Dataset
Hiệu năng
Chậm hơn do I/O đĩa giữa các giai đoạn
Nhanh hơn tới 100x với tác vụ lặp và khối lượng làm việc trong bộ nhớ
Sử dụng bộ nhớ
Thiên về đĩa, yêu cầu bộ nhớ thấp
Tiêu tốn bộ nhớ, yêu cầu RAM cao
Dễ phát triển
Dài dòng; phải viết tường minh logic map & reduce
API cấp cao bằng Python, Scala, R, Java; ít mã lặp khuôn
Chịu lỗi
Sao chép dữ liệu qua HDFS
Phả hệ RDD cho phép tính toán lại khi lỗi
Xử lý thời gian thực
Không lý tưởng; chỉ theo lô
Hỗ trợ xử lý thời gian thực qua Spark Streaming
Trình quản lý cụm
YARN
Standalone, YARN, Mesos hoặc Kubernetes
Lưu trữ
Đi kèm HDFS
Phụ thuộc lưu trữ bên ngoài (ví dụ: HDFS, S3, GCS)
Chi phí
Chi phí phần cứng thấp (máy phổ thông, dựa trên đĩa)
Chi phí bộ nhớ cao hơn nhưng sử dụng tài nguyên tốt hơn theo tải công việc
Phù hợp nhất cho
Job batch, lưu trữ quy mô cực lớn, phân tích dữ liệu lịch sử
Học máy, xử lý luồng, phân tích tương tác
Tích hợp
Hệ sinh thái Hadoop mạnh (Hive, Pig, v.v.)
API thống nhất cho SQL, MLlib, GraphX và Streaming trên một nền tảng
Kết luận
Hadoop và Spark là những cách tiếp cận bổ trợ cho xử lý big data hơn là đối thủ trực tiếp. Hadoop nổi bật với hệ thống lưu trữ tiết kiệm chi phí (HDFS) và xử lý theo lô cho bộ dữ liệu khổng lồ nơi thông lượng quan trọng hơn tốc độ.
Spark tỏa sáng với khả năng xử lý trong bộ nhớ, mang lại hiệu năng vượt trội cho thuật toán lặp, phân tích tương tác và nhu cầu xử lý thời gian thực.
DataCamp cung cấp nhiều tài nguyên nếu bạn muốn tìm hiểu thêm về hai công nghệ này: