Hadoop और Spark बिग डेटा के दो सबसे प्रमुख फ़्रेमवर्क हैं—और बड़े पैमाने के डेटा को प्रोसेस करने के उनके तरीके काफी अलग हैं। जहाँ Hadoop ने HDFS नामक मज़बूत स्टोरेज सिस्टम और MapReduce नामक संगणनात्मक मॉडल के जरिए वितरित कंप्यूटिंग के पैरेडाइम को लोकप्रिय बनाया, वहीं Spark अपनी इन-मेमाेरी आर्किटेक्चर और लचीले प्रोग्रामिंग मॉडल से खेल बदल रहा है।
यह ट्यूटोरियल Hadoop और Spark के बीच अंतर—उनकी आर्किटेक्चर, प्रदर्शन, लागत संबंधी पहलू और इंटीग्रेशन—पर गहराई से चर्चा करता है। अंत तक, पाठक को प्रत्येक के फायदे-नुकसान और वे उपयोग‑मामले जहाँ हर फ़्रेमवर्क उत्कृष्ट है, का स्पष्ट समझ मिल जाएगी; यह समझ आपको अपने बिग डेटा समाधानों के लिए रणनीतिक निर्णय लेने में मदद करेगी।
Hadoop और Spark को समझना
विशिष्ट विवरणों में जाने से पहले, आइए Hadoop और Spark की बुनियादी अवधारणाएँ और उत्पत्ति जानें ताकि समझ सकें कि ये शक्तिशाली फ़्रेमवर्क बिग डेटा चुनौतियों का सामना कैसे करते हैं।
Hadoop क्या है?
Hadoop एक ओपन‑सोर्स फ़्रेमवर्क है जिसे कंप्यूटरों के क्लस्टर पर बड़े डेटासेट को संग्रहीत करने और प्रोसेस करने के लिए बनाया गया है। 2006 में विकसित होने के बाद से, Hadoop ने संगठनों को ऐसे भारी डेटा वॉल्यूम संभालने में सक्षम बनाया है जो एकल मशीन को अभिभूत कर दें। डेटा को कई नोड्स में वितरित करके, यह न केवल प्रोसेसिंग क्षमता बढ़ाता है बल्कि अधिशेष प्रतियों के जरिए विश्वसनीयता भी सुनिश्चित करता है, ताकि किसी एक मशीन के फेल होने पर भी सिस्टम चलता रहे।
Hadoop फ़्रेमवर्क के प्रमुख घटक हैं:
- Hadoop Distributed File System (HDFS): स्टोरेज की बुनियाद के रूप में काम करता है, फ़ाइलों को ब्लॉक्स में बाँटकर क्लस्टर में वितरित करता है।
- MapReduce: कंप्यूटेशनल कार्यों को छोटे-छोटे भागों में विभाजित करके क्लस्टर में समानांतर चलाने से प्रोसेसिंग संभालता है।
- YARN (Yet Another Resource Negotiator): उपलब्ध मशीनों में कंप्यूटिंग क्षमता आवंटित कर और कार्यों की शेड्यूलिंग कर संसाधनों का कुशल प्रबंधन करता है।
Hadoop का एक बड़ा लाभ इसकी किफ़ायती प्रकृति है—यह संगठनों को महंगे विशेषीकृत उपकरणों की बजाय मानक, कम लागत वाले हार्डवेयर का उपयोग करने की अनुमति देता है। यह व्यावहारिकता इसकी प्रोसेसिंग फिलॉसफ़ी में भी झलकती है।
Hadoop का बैच‑उन्मुख डिज़ाइन उन परिदृश्यों में उत्कृष्ट है जहाँ कच्ची गति से अधिक समग्र थ्रूपुट मायने रखता है—खासकर ऐतिहासिक डेटा विश्लेषण और जटिल ETL (Extract, Transform, Load) कार्यों के लिए जहाँ तात्कालिक परिणाम आवश्यक नहीं होते।
Apache Spark क्या है?
Apache Spark 2010 में Hadoop के बिग डेटा प्रोसेसिंग दृष्टिकोण की सीमाओं के उत्तर के रूप में सामने आया। UC Berkeley में प्रारंभिक विकास के बाद Apache प्रोजेक्ट बनने वाले Spark ने Hadoop MapReduce की डिस्क ऑपरेशनों पर भारी निर्भरता को संबोधित किया। इसका ब्रेकथ्रू नवाचार इन‑मेमाेरी कम्प्यूटेशन था, जिसने डिस्क से पढ़ने/लिखने की आवश्यकता कम करके कई डेटा वर्कलोड्स के लिए प्रोसेसिंग समय को नाटकीय रूप से घटा दिया।
Spark अपने कोर प्रोसेसिंग इंजन के इर्द‑गिर्द कड़े रूप से एकीकृत कई घटकों के साथ एक एकीकृत प्लेटफ़ॉर्म प्रदान करता है:
- Spark SQL: संरचित डेटा पर काम करने के लिए
- MLlib: मशीन लर्निंग एल्गोरिद्म लागू करने के लिए
- GraphX: ग्राफ़ डेटा प्रोसेसिंग के लिए
- Spark Streaming: रियल‑टाइम डेटा विश्लेषण के लिए
यह सुसंगत डिज़ाइन टीमों को कई विशिष्ट टूल सँभालने की बजाय एक ही फ़्रेमवर्क से अलग‑अलग डेटा चुनौतियों का समाधान करने देता है।
अंतर होने के बावजूद, Spark और Hadoop अक्सर प्रतिस्पर्धी नहीं बल्कि परस्पर पूरक तकनीकों के रूप में साथ काम करते हैं। Spark में अपना स्टोरेज सिस्टम नहीं है, इसलिए यह स्थायी डेटा स्टोरेज के लिए प्रायः Hadoop के HDFS पर निर्भर करता है।
इसके अतिरिक्त, Spark Hadoop के YARN रिसोर्स मैनेजर पर चल सकता है, जिससे संगठनों के लिए मौजूदा Hadoop वातावरण में Spark की प्रोसेसिंग शक्ति जोड़ना सरल हो जाता है। यह संगतता एक व्यावहारिक अपग्रेड पथ बनाती है, जो व्यवसायों को Hadoop इंफ्रास्ट्रक्चर में किए निवेश को बरकरार रखते हुए Spark के लाभ अपनाने देती है।
Hadoop बनाम Spark प्रदर्शन तुलना
बिग डेटा फ़्रेमवर्क का मूल्यांकन करते समय, समय‑संवेदी प्रोसेसिंग आवश्यकताओं वाले संगठनों के लिए प्रदर्शन अक्सर निर्णायक कारक बन जाता है।
प्रोसेसिंग गति
Hadoop का MapReduce एक डिस्क‑आधारित प्रोसेसिंग सिस्टम के रूप में काम करता है—यह हर कंप्यूटेशन चरण के बीच डेटा को डिस्क से पढ़ता है, प्रोसेस करता है और फिर परिणामों को डिस्क पर लिखता है। यह डिस्क I/O विशेष रूप से उन आवर्तक (इटरेटिव) एल्गोरिद्म के लिए महत्वपूर्ण विलंबता पैदा करता है जिन्हें एक ही डेटा पर कई बार पास चाहिए।
यह तरीका भारी डेटासेट के बैच प्रोसेसिंग में प्रभावी है, लेकिन गति की कीमत पर विश्वसनीयता और थ्रूपुट को प्राथमिकता देता है।
इसके विपरीत, Spark मुख्यतः मेमोरी में ही कम्प्यूटेशन करता है, जिससे डिस्क ऑपरेशनों की ज़रूरत बहुत कम हो जाती है। कई वर्कलोड्स—खासकर मशीन लर्निंग जैसे आवर्तक एल्गोरिद्म—के लिए Spark Hadoop MapReduce की तुलना में कार्यों को 100 गुना तक तेज़ी से चला सकता है।
यह प्रदर्शन लाभ तब और अधिक स्पष्ट होता है जब प्रोसेसिंग लगभग रियल‑टाइम में चाहिए या एल्गोरिद्म को एक ही डेटासेट पर कई पास चाहिए।
मेमोरी का उपयोग
Hadoop का डिज़ाइन सीमित मेमोरी उपलब्धता मानकर चलता है—यह मेमोरी‑कुशल है पर धीमा। यह डिस्क स्टोरेज पर भारी निर्भर करता है, जिससे यह उपलब्ध RAM से कहीं बड़े डेटासेट को मेमोरी और डिस्क के बीच लगातार अदला‑बदली करके प्रोसेस कर सकता है।
यह तरीका सीमित मेमोरी संसाधनों वाले क्लस्टरों पर अत्यंत बड़े डेटासेट प्रोसेस करने के लिए उपयुक्त है।
Spark के प्रदर्शन लाभ आक्रामक मेमोरी उपयोग से आते हैं। प्रोसेसिंग चरणों के बीच डेटा को RAM में कैश करके, Spark महंगे डिस्क ऑपरेशनों को समाप्त करता है। हालाँकि, इसके लिए पर्याप्त मेमोरी संसाधनों की आवश्यकता होती है ताकि वर्किंग डेटासेट समा सकें।
जब मेमोरी सीमाएँ आ जाती हैं, Spark का लाभ घटने लगता है क्योंकि वह डेटा को डिस्क पर स्पिल करना शुरू करता है—फिर भी इसका बुद्धिमान मेमोरी प्रबंधन आमतौर पर Hadoop के डिस्क‑प्रथम दृष्टिकोण से बेहतर प्रदर्शन देता है।
वास्तविक दुनिया के प्रदर्शन पहलू
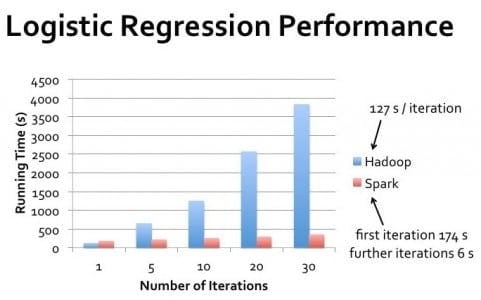
Hadoop और Spark के बीच वास्तविक दुनिया का प्रदर्शन अंतर विशिष्ट उपयोग‑मामलों पर काफी निर्भर करता है। अत्यधिक बड़े डेटासेट के सिंगल‑पास बैच प्रोसेसिंग में—जहाँ डेटा उपलब्ध मेमोरी से बहुत अधिक होता है—Hadoop का प्रदर्शन Spark के करीब आ सकता है।
लेकिन आवर्तक प्रोसेसिंग, इंटरैक्टिव क्वेरीज़ और स्ट्रीम प्रोसेसिंग के लिए Spark लगातार बेहतर प्रदर्शन देता है।
यह ध्यान रखना महत्वपूर्ण है कि प्रदर्शन केवल कच्ची गति नहीं है। Hadoop उन परिदृश्यों में उत्कृष्ट है जहाँ उच्च फॉल्ट टॉलरेंस आवश्यक है और जहाँ प्रोसेसिंग स्पष्ट बैच विंडो में हो सकती है।
Spark तब सबसे अच्छा प्रदर्शन करता है जब त्वरित परिणाम चाहिए—जैसे इंटरैक्टिव डेटा एक्सप्लोरेशन, रियल‑टाइम एनालिटिक्स और वे मशीन लर्निंग एप्लिकेशन जहाँ एल्गोरिद्म डेटासेट पर कई बार पास लेते हैं।
क्लस्टर प्रबंधन: Hadoop क्लस्टर बनाम Spark क्लस्टर
Hadoop और Spark दोनों ही बड़े पैमाने के डेटा को कुशलता से प्रोसेस करने के लिए क्लस्टर पर निर्भर हैं, पर ये संसाधनों का प्रबंधन अलग तरीके से करते हैं—जिसका असर प्रदर्शन और प्रशासन दोनों पर पड़ता है।
क्लस्टरिंग क्या है और इसकी ज़रूरत क्यों है
क्लस्टर परस्पर जुड़े कंप्यूटरों (नोड्स) का समूह है जो एकल सिस्टम की तरह काम करता है। बिग डेटा प्रोसेसिंग में क्लस्टरिंग तब आवश्यक हो जाती है जब डेटा वॉल्यूम एकल मशीन की कुशल क्षमता से अधिक हो। कई मशीनों में वर्कलोड बाँटकर, क्लस्टर ऐसे पेटाबाइट‑स्तरीय डेटा को प्रोसेस करने में सक्षम बनाते हैं जिन्हें अन्यथा संभालना असंभव होता।
क्लस्टरिंग फॉल्ट टॉलरेंस और उच्च उपलब्धता भी प्रदान करती है। यदि एक मशीन विफल हो जाए, तो क्लस्टर की अन्य मशीनें उसका कार्यभार संभाल सकती हैं, जिससे निरंतर संचालन सुनिश्चित होता है। उत्पादन वातावरणों में, जहाँ डाउनटाइम महँगा पड़ सकता है, यह लचीलापन अत्यंत महत्वपूर्ण है।
साथ ही, क्लस्टरिंग क्षैतिज स्केलिंग की अनुमति देती है—यानी प्रोसेसिंग शक्ति बढ़ाने के लिए और मशीनें जोड़ना—जो अक्सर व्यक्तिगत सिस्टम अपग्रेड करने से अधिक किफ़ायती होता है।
इस क्षेत्र में आगे बढ़ने के इच्छुक पेशेवरों के लिए, क्लस्टरिंग को समझना डेटा इंजीनियरिंग की एक बुनियादी कौशल है।
Hadoop क्लस्टर आर्किटेक्चर
Hadoop क्लस्टर मास्टर‑स्लेव आर्किटेक्चर का पालन करते हैं जहाँ अलग‑अलग नोड्स की विशिष्ट भूमिकाएँ होती हैं। NameNode HDFS के लिए मास्टर का काम करता है, फ़ाइल लोकेशन और अनुमतियों के बारे में मेटाडेटा बनाए रखता है। DataNodes वास्तविक डेटा ब्लॉक्स को स्टोर करते हैं और NameNode को रिपोर्ट करते हैं।
प्रोसेसिंग के लिए, ResourceManager क्लस्टर संसाधन आवंटित करता है, जबकि व्यक्तिगत मशीनों पर NodeManagers कार्य निष्पादित करते हैं।
HDFS कई DataNodes में डेटा की प्रतिकृति बनाता है—आमतौर पर प्रत्येक ब्लॉक की तीन कॉपी रखता है। यह प्रतिकृति रणनीति व्यक्तिगत नोड के फेल होने पर भी डेटा उपलब्धता सुनिश्चित करती है, हालाँकि यह अतिरिक्त स्टोरेज क्षमता मांगती है।
Hadoop का क्लस्टर डिज़ाइन डेटा लोकैलिटी पर ज़ोर देता है—नेटवर्क ट्रांसफ़र को न्यूनतम करने के लिए प्रयास करता है कि कम्प्यूटेशन उन्हीं नोड्स पर शेड्यूल हों जहाँ डेटा मौजूद है।
Hadoop क्लस्टरों का प्रशासन परंपरागत रूप से पर्याप्त विशेषज्ञता मांगता था (पेशेवर प्रायः Hadoop इंटरव्यू प्रश्न की तैयारी इसी ज्ञान को दर्शाने के लिए करते हैं), हालाँकि आधुनिक डिस्ट्रीब्यूशंस में कॉन्फ़िगरेशन और मॉनिटरिंग सरल करने के लिए प्रबंधन उपकरण शामिल हैं।
Hadoop क्लस्टर को स्केल करना नए नोड्स जोड़ने और विस्तारित इन्फ्रास्ट्रक्चर में डेटा को फिर से संतुलित करने को शामिल करता है—जो एक मैनुअल प्रक्रिया हो सकती है और सावधानीपूर्वक योजना मांगती है।
Spark क्लस्टर आर्किटेक्चर
Spark विभिन्न क्लस्टर कॉन्फ़िगरेशन में काम कर सकता है—स्टैंडअलोन मोड, Hadoop YARN, Apache Mesos या Kubernetes पर। सभी डिप्लॉयमेंट में, Spark ड्राइवर‑एग्ज़ीक्यूटर मॉडल का पालन करता है। ड्राइवर प्रोग्राम में एप्लिकेशन का मुख्य फ़ंक्शन होता है और यह SparkContext बनाता है जो संसाधन आवंटन के लिए क्लस्टर मैनेजर से समन्वय करता है।
संसाधन आवंटित होने के बाद, वर्कर नोड्स पर Spark executors लॉन्च होते हैं। ये JVM प्रॉसेसेज़ होते हैं जो टास्क चलाते हैं और डेटा को मेमोरी या डिस्क में स्टोर करते हैं। Hadoop के विपरीत, जो क्लस्टर नोड्स पर स्थायी उपस्थिति बनाए रखता है, Spark executors एप्लिकेशन की ज़रूरत के आधार पर डायनेमिक रूप से आवंटित और रिलीज़ किए जा सकते हैं, जिससे संसाधन उपयोग बेहतर हो सकता है।
रुचि रखने वाले पाठक मशीन लर्निंग के लिए Apache Spark जैसे प्रायोगिक ट्यूटोरियल से Spark की क्षमताएँ और गहराई से जान सकते हैं।
Spark अपने साथ कोई वितरित स्टोरेज सिस्टम नहीं लाता—यह HDFS, Amazon S3 या अन्य संगत स्टोरेज सिस्टम का लाभ उठाता है। कंप्यूट और स्टोरेज के बीच यह आर्किटेक्चरल पृथक्करण लचीलापन देता है, पर इष्टतम डेटा एक्सेस पैटर्न सुनिश्चित करने के लिए सावधानीपूर्वक कॉन्फ़िगरेशन मांगता है।
जैसे उपकरण Spark SQL और sparklyr इस आर्किटेक्चर के साथ इंटरैक्ट करने के सुविधाजनक तरीके प्रदान करते हैं।
क्लस्टर प्रबंधन में मुख्य अंतर
Hadoop का क्लस्टर प्रबंधन दृष्टिकोण अधिक इन्फ्रास्ट्रक्चर‑केंद्रित है—तुलनात्मक रूप से स्थिर संसाधन आवंटन और डेटा लोकैलिटी पर फोकस के साथ। यह डिज़ाइन स्थिर क्लस्टरों पर लंबे समय तक चलने वाले बैच जॉब्स के लिए अच्छा काम करता है जहाँ नोड्स में कम परिवर्तन होते हैं।
हालाँकि, यह बदलते वर्कलोड्स के प्रति कम उत्तरदायी हो सकता है और स्केलिंग के समय अधिक मैनुअल दखल की आवश्यकता पड़ती है।
Spark अधिक डायनेमिक संसाधन प्रबंधन प्रदान करता है—खासकर जब इसे Kubernetes जैसे आधुनिक ऑर्केस्ट्रेशन प्लेटफ़ॉर्म पर चलाया जाए। यह वर्तमान मांग के आधार पर संसाधन आवंटन समायोजित कर सकता है और ज़रूरत न होने पर संसाधन रिलीज़ कर सकता है।
यह इलास्टिसिटी उन संगठनों के लिए मूल्यवान है जिनके वर्कलोड्स उतार‑चढ़ाव वाले हों या साझा इन्फ्रास्ट्रक्चर में कई एप्लिकेशन सेवित होते हों।
इन अंतरों को समझना Data Engineer प्रमाणन पाने या Spark इंटरव्यू प्रश्न की तैयारी करते समय महत्वपूर्ण है।
बिग डेटा की शुरुआत कर रहे संगठनों के लिए, Spark के अधिक लचीले डिप्लॉयमेंट विकल्प और सरल प्रोग्रामिंग मॉडल के कारण शुरुआत करना अक्सर आसान होता है।
हालाँकि, ऐसे वातावरणों में जहाँ डेटा वॉल्यूम अत्यधिक बड़े हैं और स्टोरेज प्रबंधन प्राथमिक चिंता है, Hadoop का परिपक्व HDFS इकोसिस्टम अब भी ऐसे फायदे देता है जो Spark की प्रोसेसिंग क्षमताओं का पूरक हैं। Spark की अन्य स्ट्रीमिंग तकनीकों से तुलना के लिए, पाठकों को Flink बनाम Spark जैसी तुलनाएँ उपयोगी लग सकती हैं।
Hadoop MapReduce बनाम Spark का प्रोसेसिंग मॉडल
हालाँकि पिछले अनुभागों में प्रदर्शन के निहितार्थों पर चर्चा हुई, प्रत्येक फ़्रेमवर्क के बुनियादी प्रोसेसिंग मॉडल को समझना बताता है कि उनकी आर्किटेक्चर इतनी भिन्न क्यों है।
Hadoop MapReduce फ़्रेमवर्क
MapReduce दो प्राथमिक चरणों—मैप और रिड्यूस—के साथ एक कठोर प्रोग्रामिंग पैराडाइम का पालन करता है। मैप चरण प्रत्येक रिकॉर्ड पर समानांतर में एक फ़ंक्शन लागू करके मध्यवर्ती की‑वैल्यू पेयर्स उत्पन्न करता है।
इन पेयर्स पर अनिवार्य शफ़लिंग और सॉर्टिंग चरण होता है, जहाँ समान की वाले डेटा को समूहित किया जाता है।
अंततः, रिड्यूस चरण इन समूहित मानों को एकत्रित कर अंतिम आउटपुट पैदा करता है। इस संरचित दृष्टिकोण का मतलब है कि जटिल ऑपरेशनों के लिए कई MapReduce जॉब्स को एक‑दूसरे से जोड़ना पड़ता है।
MapReduce एप्लिकेशन विकसित करना आमतौर पर लो‑लेवल कोड लिखना शामिल करता है जो स्पष्ट रूप से मैप और रिड्यूस फ़ंक्शन्स को परिभाषित करता है।
हालाँकि Apache Pig और Apache Hive उच्च‑स्तरीय एब्स्ट्रैक्शन देते हैं, लेकिन अंतर्निहित निष्पादन अब भी सख्त MapReduce पैटर्न का पालन करता है—जो एल्गोरिद्म डिज़ाइन और ऑप्टिमाइज़ेशन के अवसरों पर सीमाएँ लगाता है।
Spark का डेटा प्रोसेसिंग मॉडल
Spark ने अपने कोर एब्स्ट्रैक्शन के रूप में Resilient Distributed Datasets (RDDs) पेश किए—अपरिवर्तनीय, विभाजित कलेक्शन्स जो रिकवरी के लिए अपनी लीनिएज ट्रैक कर सकते हैं। MapReduce के विपरीत, Spark कोई कठोर प्रोसेसिंग पैटर्न लागू नहीं करता, बल्कि दो प्रकार के ऑपरेशन देता है: ट्रांसफॉर्मेशन (जो नए RDDs बनाते हैं) और एक्शंस (जो मान लौटाते हैं)।
यह लचीलापन मैप‑रिड्यूस पैरेडाइम से परे विविध प्रोसेसिंग पैटर्न की अनुमति देता है।
Spark RDDs से आगे बढ़कर DataFrames और Datasets जैसे उच्च‑स्तरीय एब्स्ट्रैक्शन उपलब्ध कराता है, जो रिलेशनल डेटाबेस के समान ऑप्टिमाइज़ेशन के साथ स्कीमा‑अवेयर प्रोसेसिंग देते हैं। ये एब्स्ट्रैक्शन—स्ट्रीमिंग, SQL, मशीन लर्निंग और ग्राफ़ प्रोसेसिंग के विशेषीकृत लाइब्रेरीज़ के साथ—डेवलपर्स को समकक्ष MapReduce इम्प्लीमेंटेशंस की तुलना में काफी कम कोड में जटिल वर्कफ़्लोज़ व्यक्त करने देते हैं, और भिन्न प्रोसेसिंग पैरेडाइम्स में एकीकृत प्रोग्रामिंग मॉडल बनाए रखते हैं।
Spark बनाम Hadoop: लागत संबंधी विचार
बिग डेटा फ़्रेमवर्क का मूल्यांकन करते समय, संगठनों को केवल तकनीकी क्षमताएँ ही नहीं बल्कि डिप्लॉयमेंट और संचालन के वित्तीय प्रभाव भी देखने चाहिए।
हार्डवेयर आवश्यकताएँ और निहितार्थ
Hadoop और Spark की हार्डवेयर प्राथमिकताएँ मौलिक रूप से भिन्न हैं, जिनका इन्फ्रास्ट्रक्चर लागत पर असर पड़ता है। Hadoop को मेमोरी की तुलना में डिस्क स्टोरेज को प्राथमिकता देते हुए डिज़ाइन किया गया है—यह सीमित RAM परंतु पर्याप्त हार्ड ड्राइव क्षमता वाले कम लागत हार्डवेयर के लिए उपयुक्त है।
यह आर्किटेक्चर प्रारंभिक हार्डवेयर निवेश घटा सकता है—खासकर तब जब डेटासेट इतने बड़े हों कि मेमोरी‑आधारित समाधान अत्यधिक महँगे पड़ें।
Spark का इन‑मेमाेरी प्रोसेसिंग मॉडल प्रदर्शन लाभ देता है, लेकिन प्रति नोड काफी अधिक RAM मांगता है। उपयुक्त रूप से कॉन्फ़िगर किया गया Spark क्लस्टर प्रायः उच्च मेमोरी वाले सर्वर माँगता है—वर्कलोड के अनुसार प्रति नोड 16GB से 256GB तक।
हालाँकि मेमोरी की लागत समय के साथ घटी है, फिर भी यह आवश्यकता डिस्क‑केंद्रित Hadoop डिप्लॉयमेंट की तुलना में हार्डवेयर खर्च बढ़ा सकती है।
संचालन व्यय
ऑपरेशनल लागत में हार्डवेयर अधिग्रहण से आगे बढ़कर रखरखाव, बिजली, कूलिंग और डेटा सेंटर स्पेस शामिल हैं। Hadoop क्लस्टर अनेक कम लागत सर्वरों और व्यापक स्टोरेज पर निर्भरता के कारण भौतिक रूप से बड़े होते हैं।
यह बड़ा फ़ुटप्रिंट पावर, कूलिंग और रैक स्पेस की अधिक लागत में बदलता है।
Spark क्लस्टर कभी‑कभी कम नोड्स के साथ समान प्रोसेसिंग क्षमता हासिल कर लेते हैं—कंप्यूटिंग संसाधनों के अधिक कुशल उपयोग के कारण—जिससे डेटा सेंटर फ़ुटप्रिंट और संबंधित लागत घट सकती है। हालाँकि, आवश्यक उच्च‑विशिष्टता वाली मशीनें प्रति नोड अधिक पावर खपत कर सकती हैं, जिससे ये बचत आंशिक रूप से संतुलित हो सकती है।
डेवलपमेंट और कार्मिक लागत
इम्प्लीमेंटेशन और रखरखाव की जटिलता कुल स्वामित्व लागत पर महत्वपूर्ण प्रभाव डाल सकती है। Hadoop इकोसिस्टम पारंपरिक रूप से Java प्रोग्रामिंग और Unix प्रशासन में विशेष विशेषज्ञता मांगता रहा है, और MapReduce प्रोग्रामिंग के विस्तृत स्वभाव के कारण डेवलपमेंट चक्र लंबे हो सकते हैं।
Spark Python, Scala, R और Java में अधिक सुलभ API देता है, जिससे डेवलपमेंट समय और संबद्ध कार्मिक लागत घट सकती है।
अधिक सहज प्रोग्रामिंग मॉडल सीखने की वक्र और डेवलपमेंट समय दोनों घटा सकता है, जिससे संगठन कम विशेषीकृत कार्मिकों के साथ तेज़ी से समाधान लागू कर पाते हैं।
लागत अनुकूलन रणनीतियाँ
लागत‑संवेदी संगठनों के लिए, हाइब्रिड दृष्टिकोण अक्सर सर्वोत्तम मूल्य देते हैं। स्टोरेज के लिए HDFS का उपयोग करते हुए प्रोसेसिंग के लिए Spark का लाभ उठाना—Hadoop के किफ़ायती स्टोरेज को Spark की प्रोसेसिंग दक्षता से जोड़ सकता है। AWS EMR, Azure HDInsight या Google Dataproc जैसी सेवाओं पर क्लाउड‑आधारित डिप्लॉयमेंट संगठनों को केवल उपयोग किए संसाधनों के लिए भुगतान करने देते हैं—बड़े अग्रिम पूँजीगत खर्च के बिना।
संगठनों को स्केलेबिलिटी लागत भी देखनी चाहिए। Hadoop में परंपरागत रूप से स्केलिंग के लिए मैनुअल हस्तक्षेप चाहिए होता है—जो ऑपरेशनल ओवरहेड बढ़ाता है। वहीं, Kubernetes जैसे कंटेनर ऑर्केस्ट्रेशन प्लेटफ़ॉर्म के साथ Spark की संगतता अधिक स्वचालित, इलास्टिक स्केलिंग सक्षम करती है—जो वास्तविक मांग के अनुरूप संसाधन प्रावधान बेहतर ढंग से मिलान कर सकती है और संभावित रूप से बेकार क्षमता घटा सकती है।
Hadoop बनाम Spark तुलना तालिका
यहाँ उनके अंतरों को संक्षेप में प्रस्तुत करने वाली एक तुलना तालिका है:
|
फ़ीचर
|
Hadoop
|
Spark
|
|
प्रोसेसिंग मॉडल
|
MapReduce का उपयोग करके बैच प्रोसेसिंग
|
RDDs, DataFrames और Datasets का उपयोग कर इन‑मेमाेरी प्रोसेसिंग
|
|
प्रदर्शन
|
चरणों के बीच डिस्क I/O के कारण धीमा
|
आवर्तक और इन‑मेमाेरी वर्कलोड्स के लिए 100x तक तेज़
|
|
मेमोरी उपयोग
|
डिस्क‑केंद्रित, कम मेमोरी आवश्यकताएँ
|
मेमोरी‑गहन, उच्च RAM आवश्यकताएँ
|
|
डेवलपमेंट की सहजता
|
विस्तृत; मैप और रिड्यूस लॉजिक स्पष्ट रूप से लिखना पड़ता है
|
Python, Scala, R, Java में उच्च‑स्तरीय APIs; कम बोयलरप्लेट
|
|
फॉल्ट टॉलरेंस
|
HDFS के माध्यम से डेटा प्रतिकृति
|
असफलता पर पुनर्गणना हेतु RDD लीनिएज
|
|
रियल‑टाइम प्रोसेसिंग
|
उपयुक्त नहीं; केवल बैच
|
Spark Streaming के माध्यम से रियल‑टाइम प्रोसेसिंग समर्थन
|
|
क्लस्टर मैनेजर
|
YARN
|
स्टैंडअलोन, YARN, Mesos या Kubernetes
|
|
स्टोरेज
|
HDFS के साथ आता है
|
बाहरी स्टोरेज पर निर्भर (जैसे HDFS, S3, GCS)
|
|
लागत
|
कम हार्डवेयर लागत (कम लागत मशीनें, डिस्क‑आधारित)
|
उच्च मेमोरी लागत, पर प्रति वर्कलोड बेहतर संसाधन उपयोग
|
|
सबसे उपयुक्त
|
बैच जॉब्स, बड़े‑पैमाने का स्टोरेज, ऐतिहासिक डेटा विश्लेषण
|
मशीन लर्निंग, स्ट्रीम प्रोसेसिंग, इंटरैक्टिव एनालिटिक्स
|
|
इंटीग्रेशन
|
मजबूत Hadoop इकोसिस्टम (Hive, Pig, आदि)
|
एक ही प्लेटफ़ॉर्म में SQL, MLlib, GraphX और Streaming के लिए एकीकृत APIs
|
निष्कर्ष
Hadoop और Spark कड़े प्रतिद्वंद्वी नहीं बल्कि बिग डेटा प्रोसेसिंग के परस्पर पूरक दृष्टिकोण हैं। Hadoop अपने किफ़ायती स्टोरेज सिस्टम (HDFS) और बैच‑उन्मुख प्रोसेसिंग के साथ उन विशाल डेटासेट के लिए उत्कृष्ट है जहाँ गति से अधिक थ्रूपुट मायने रखता है।
Spark अपनी इन‑मेमाेरी प्रोसेसिंग क्षमताओं के साथ चमकता है—जो आवर्तक एल्गोरिद्म, इंटरैक्टिव एनालिटिक्स और रियल‑टाइम प्रोसेसिंग जरूरतों के लिए श्रेष्ठ प्रदर्शन देता है।
यदि आप इन दोनों तकनीकों के बारे में और सीखना चाहते हैं, तो DataCamp विभिन्न संसाधन प्रदान करता है:

Hadoop और Spark बिग डेटा के दो सबसे प्रमुख फ़्रेमवर्क हैं—और बड़े पैमाने के डेटा को प्रोसेस करने के उनके तरीके काफी अलग हैं। जहाँ Hadoop ने HDFS नामक मज़बूत स्टोरेज सिस्टम और MapReduce नामक संगणनात्मक मॉडल के जरिए वितरित कंप्यूटिंग के पैरेडाइम को लोकप्रिय बनाया, वहीं Spark अपनी इन-मेमाेरी आर्किटेक्चर और लचीले प्रोग्रामिंग मॉडल से खेल बदल रहा है।
यह ट्यूटोरियल Hadoop और Spark के बीच अंतर—उनकी आर्किटेक्चर, प्रदर्शन, लागत संबंधी पहलू और इंटीग्रेशन—पर गहराई से चर्चा करता है। अंत तक, पाठक को प्रत्येक के फायदे-नुकसान और वे उपयोग‑मामले जहाँ हर फ़्रेमवर्क उत्कृष्ट है, का स्पष्ट समझ मिल जाएगी; यह समझ आपको अपने बिग डेटा समाधानों के लिए रणनीतिक निर्णय लेने में मदद करेगी।
Hadoop और Spark को समझना
विशिष्ट विवरणों में जाने से पहले, आइए Hadoop और Spark की बुनियादी अवधारणाएँ और उत्पत्ति जानें ताकि समझ सकें कि ये शक्तिशाली फ़्रेमवर्क बिग डेटा चुनौतियों का सामना कैसे करते हैं।
Hadoop क्या है?
Hadoop एक ओपन‑सोर्स फ़्रेमवर्क है जिसे कंप्यूटरों के क्लस्टर पर बड़े डेटासेट को संग्रहीत करने और प्रोसेस करने के लिए बनाया गया है। 2006 में विकसित होने के बाद से, Hadoop ने संगठनों को ऐसे भारी डेटा वॉल्यूम संभालने में सक्षम बनाया है जो एकल मशीन को अभिभूत कर दें। डेटा को कई नोड्स में वितरित करके, यह न केवल प्रोसेसिंग क्षमता बढ़ाता है बल्कि अधिशेष प्रतियों के जरिए विश्वसनीयता भी सुनिश्चित करता है, ताकि किसी एक मशीन के फेल होने पर भी सिस्टम चलता रहे।
Hadoop फ़्रेमवर्क के प्रमुख घटक हैं:
Hadoop का एक बड़ा लाभ इसकी किफ़ायती प्रकृति है—यह संगठनों को महंगे विशेषीकृत उपकरणों की बजाय मानक, कम लागत वाले हार्डवेयर का उपयोग करने की अनुमति देता है। यह व्यावहारिकता इसकी प्रोसेसिंग फिलॉसफ़ी में भी झलकती है।
Hadoop का बैच‑उन्मुख डिज़ाइन उन परिदृश्यों में उत्कृष्ट है जहाँ कच्ची गति से अधिक समग्र थ्रूपुट मायने रखता है—खासकर ऐतिहासिक डेटा विश्लेषण और जटिल ETL (Extract, Transform, Load) कार्यों के लिए जहाँ तात्कालिक परिणाम आवश्यक नहीं होते।
Apache Spark क्या है?
Apache Spark 2010 में Hadoop के बिग डेटा प्रोसेसिंग दृष्टिकोण की सीमाओं के उत्तर के रूप में सामने आया। UC Berkeley में प्रारंभिक विकास के बाद Apache प्रोजेक्ट बनने वाले Spark ने Hadoop MapReduce की डिस्क ऑपरेशनों पर भारी निर्भरता को संबोधित किया। इसका ब्रेकथ्रू नवाचार इन‑मेमाेरी कम्प्यूटेशन था, जिसने डिस्क से पढ़ने/लिखने की आवश्यकता कम करके कई डेटा वर्कलोड्स के लिए प्रोसेसिंग समय को नाटकीय रूप से घटा दिया।
Spark अपने कोर प्रोसेसिंग इंजन के इर्द‑गिर्द कड़े रूप से एकीकृत कई घटकों के साथ एक एकीकृत प्लेटफ़ॉर्म प्रदान करता है:
यह सुसंगत डिज़ाइन टीमों को कई विशिष्ट टूल सँभालने की बजाय एक ही फ़्रेमवर्क से अलग‑अलग डेटा चुनौतियों का समाधान करने देता है।
अंतर होने के बावजूद, Spark और Hadoop अक्सर प्रतिस्पर्धी नहीं बल्कि परस्पर पूरक तकनीकों के रूप में साथ काम करते हैं। Spark में अपना स्टोरेज सिस्टम नहीं है, इसलिए यह स्थायी डेटा स्टोरेज के लिए प्रायः Hadoop के HDFS पर निर्भर करता है।
इसके अतिरिक्त, Spark Hadoop के YARN रिसोर्स मैनेजर पर चल सकता है, जिससे संगठनों के लिए मौजूदा Hadoop वातावरण में Spark की प्रोसेसिंग शक्ति जोड़ना सरल हो जाता है। यह संगतता एक व्यावहारिक अपग्रेड पथ बनाती है, जो व्यवसायों को Hadoop इंफ्रास्ट्रक्चर में किए निवेश को बरकरार रखते हुए Spark के लाभ अपनाने देती है।
Hadoop बनाम Spark प्रदर्शन तुलना
बिग डेटा फ़्रेमवर्क का मूल्यांकन करते समय, समय‑संवेदी प्रोसेसिंग आवश्यकताओं वाले संगठनों के लिए प्रदर्शन अक्सर निर्णायक कारक बन जाता है।
प्रोसेसिंग गति
Hadoop का MapReduce एक डिस्क‑आधारित प्रोसेसिंग सिस्टम के रूप में काम करता है—यह हर कंप्यूटेशन चरण के बीच डेटा को डिस्क से पढ़ता है, प्रोसेस करता है और फिर परिणामों को डिस्क पर लिखता है। यह डिस्क I/O विशेष रूप से उन आवर्तक (इटरेटिव) एल्गोरिद्म के लिए महत्वपूर्ण विलंबता पैदा करता है जिन्हें एक ही डेटा पर कई बार पास चाहिए।
यह तरीका भारी डेटासेट के बैच प्रोसेसिंग में प्रभावी है, लेकिन गति की कीमत पर विश्वसनीयता और थ्रूपुट को प्राथमिकता देता है।
इसके विपरीत, Spark मुख्यतः मेमोरी में ही कम्प्यूटेशन करता है, जिससे डिस्क ऑपरेशनों की ज़रूरत बहुत कम हो जाती है। कई वर्कलोड्स—खासकर मशीन लर्निंग जैसे आवर्तक एल्गोरिद्म—के लिए Spark Hadoop MapReduce की तुलना में कार्यों को 100 गुना तक तेज़ी से चला सकता है।
यह प्रदर्शन लाभ तब और अधिक स्पष्ट होता है जब प्रोसेसिंग लगभग रियल‑टाइम में चाहिए या एल्गोरिद्म को एक ही डेटासेट पर कई पास चाहिए।
मेमोरी का उपयोग
Hadoop का डिज़ाइन सीमित मेमोरी उपलब्धता मानकर चलता है—यह मेमोरी‑कुशल है पर धीमा। यह डिस्क स्टोरेज पर भारी निर्भर करता है, जिससे यह उपलब्ध RAM से कहीं बड़े डेटासेट को मेमोरी और डिस्क के बीच लगातार अदला‑बदली करके प्रोसेस कर सकता है।
यह तरीका सीमित मेमोरी संसाधनों वाले क्लस्टरों पर अत्यंत बड़े डेटासेट प्रोसेस करने के लिए उपयुक्त है।
Spark के प्रदर्शन लाभ आक्रामक मेमोरी उपयोग से आते हैं। प्रोसेसिंग चरणों के बीच डेटा को RAM में कैश करके, Spark महंगे डिस्क ऑपरेशनों को समाप्त करता है। हालाँकि, इसके लिए पर्याप्त मेमोरी संसाधनों की आवश्यकता होती है ताकि वर्किंग डेटासेट समा सकें।
जब मेमोरी सीमाएँ आ जाती हैं, Spark का लाभ घटने लगता है क्योंकि वह डेटा को डिस्क पर स्पिल करना शुरू करता है—फिर भी इसका बुद्धिमान मेमोरी प्रबंधन आमतौर पर Hadoop के डिस्क‑प्रथम दृष्टिकोण से बेहतर प्रदर्शन देता है।
वास्तविक दुनिया के प्रदर्शन पहलू
Hadoop और Spark के बीच वास्तविक दुनिया का प्रदर्शन अंतर विशिष्ट उपयोग‑मामलों पर काफी निर्भर करता है। अत्यधिक बड़े डेटासेट के सिंगल‑पास बैच प्रोसेसिंग में—जहाँ डेटा उपलब्ध मेमोरी से बहुत अधिक होता है—Hadoop का प्रदर्शन Spark के करीब आ सकता है।
लेकिन आवर्तक प्रोसेसिंग, इंटरैक्टिव क्वेरीज़ और स्ट्रीम प्रोसेसिंग के लिए Spark लगातार बेहतर प्रदर्शन देता है।
यह ध्यान रखना महत्वपूर्ण है कि प्रदर्शन केवल कच्ची गति नहीं है। Hadoop उन परिदृश्यों में उत्कृष्ट है जहाँ उच्च फॉल्ट टॉलरेंस आवश्यक है और जहाँ प्रोसेसिंग स्पष्ट बैच विंडो में हो सकती है।
Spark तब सबसे अच्छा प्रदर्शन करता है जब त्वरित परिणाम चाहिए—जैसे इंटरैक्टिव डेटा एक्सप्लोरेशन, रियल‑टाइम एनालिटिक्स और वे मशीन लर्निंग एप्लिकेशन जहाँ एल्गोरिद्म डेटासेट पर कई बार पास लेते हैं।
क्लस्टर प्रबंधन: Hadoop क्लस्टर बनाम Spark क्लस्टर
Hadoop और Spark दोनों ही बड़े पैमाने के डेटा को कुशलता से प्रोसेस करने के लिए क्लस्टर पर निर्भर हैं, पर ये संसाधनों का प्रबंधन अलग तरीके से करते हैं—जिसका असर प्रदर्शन और प्रशासन दोनों पर पड़ता है।
क्लस्टरिंग क्या है और इसकी ज़रूरत क्यों है
क्लस्टर परस्पर जुड़े कंप्यूटरों (नोड्स) का समूह है जो एकल सिस्टम की तरह काम करता है। बिग डेटा प्रोसेसिंग में क्लस्टरिंग तब आवश्यक हो जाती है जब डेटा वॉल्यूम एकल मशीन की कुशल क्षमता से अधिक हो। कई मशीनों में वर्कलोड बाँटकर, क्लस्टर ऐसे पेटाबाइट‑स्तरीय डेटा को प्रोसेस करने में सक्षम बनाते हैं जिन्हें अन्यथा संभालना असंभव होता।
क्लस्टरिंग फॉल्ट टॉलरेंस और उच्च उपलब्धता भी प्रदान करती है। यदि एक मशीन विफल हो जाए, तो क्लस्टर की अन्य मशीनें उसका कार्यभार संभाल सकती हैं, जिससे निरंतर संचालन सुनिश्चित होता है। उत्पादन वातावरणों में, जहाँ डाउनटाइम महँगा पड़ सकता है, यह लचीलापन अत्यंत महत्वपूर्ण है।
साथ ही, क्लस्टरिंग क्षैतिज स्केलिंग की अनुमति देती है—यानी प्रोसेसिंग शक्ति बढ़ाने के लिए और मशीनें जोड़ना—जो अक्सर व्यक्तिगत सिस्टम अपग्रेड करने से अधिक किफ़ायती होता है।
इस क्षेत्र में आगे बढ़ने के इच्छुक पेशेवरों के लिए, क्लस्टरिंग को समझना डेटा इंजीनियरिंग की एक बुनियादी कौशल है।
Hadoop क्लस्टर आर्किटेक्चर
Hadoop क्लस्टर मास्टर‑स्लेव आर्किटेक्चर का पालन करते हैं जहाँ अलग‑अलग नोड्स की विशिष्ट भूमिकाएँ होती हैं। NameNode HDFS के लिए मास्टर का काम करता है, फ़ाइल लोकेशन और अनुमतियों के बारे में मेटाडेटा बनाए रखता है। DataNodes वास्तविक डेटा ब्लॉक्स को स्टोर करते हैं और NameNode को रिपोर्ट करते हैं।
प्रोसेसिंग के लिए, ResourceManager क्लस्टर संसाधन आवंटित करता है, जबकि व्यक्तिगत मशीनों पर NodeManagers कार्य निष्पादित करते हैं।
HDFS कई DataNodes में डेटा की प्रतिकृति बनाता है—आमतौर पर प्रत्येक ब्लॉक की तीन कॉपी रखता है। यह प्रतिकृति रणनीति व्यक्तिगत नोड के फेल होने पर भी डेटा उपलब्धता सुनिश्चित करती है, हालाँकि यह अतिरिक्त स्टोरेज क्षमता मांगती है।
Hadoop का क्लस्टर डिज़ाइन डेटा लोकैलिटी पर ज़ोर देता है—नेटवर्क ट्रांसफ़र को न्यूनतम करने के लिए प्रयास करता है कि कम्प्यूटेशन उन्हीं नोड्स पर शेड्यूल हों जहाँ डेटा मौजूद है।
Hadoop क्लस्टरों का प्रशासन परंपरागत रूप से पर्याप्त विशेषज्ञता मांगता था (पेशेवर प्रायः Hadoop इंटरव्यू प्रश्न की तैयारी इसी ज्ञान को दर्शाने के लिए करते हैं), हालाँकि आधुनिक डिस्ट्रीब्यूशंस में कॉन्फ़िगरेशन और मॉनिटरिंग सरल करने के लिए प्रबंधन उपकरण शामिल हैं।
Hadoop क्लस्टर को स्केल करना नए नोड्स जोड़ने और विस्तारित इन्फ्रास्ट्रक्चर में डेटा को फिर से संतुलित करने को शामिल करता है—जो एक मैनुअल प्रक्रिया हो सकती है और सावधानीपूर्वक योजना मांगती है।
Spark क्लस्टर आर्किटेक्चर
Spark विभिन्न क्लस्टर कॉन्फ़िगरेशन में काम कर सकता है—स्टैंडअलोन मोड, Hadoop YARN, Apache Mesos या Kubernetes पर। सभी डिप्लॉयमेंट में, Spark ड्राइवर‑एग्ज़ीक्यूटर मॉडल का पालन करता है। ड्राइवर प्रोग्राम में एप्लिकेशन का मुख्य फ़ंक्शन होता है और यह SparkContext बनाता है जो संसाधन आवंटन के लिए क्लस्टर मैनेजर से समन्वय करता है।
संसाधन आवंटित होने के बाद, वर्कर नोड्स पर Spark executors लॉन्च होते हैं। ये JVM प्रॉसेसेज़ होते हैं जो टास्क चलाते हैं और डेटा को मेमोरी या डिस्क में स्टोर करते हैं। Hadoop के विपरीत, जो क्लस्टर नोड्स पर स्थायी उपस्थिति बनाए रखता है, Spark executors एप्लिकेशन की ज़रूरत के आधार पर डायनेमिक रूप से आवंटित और रिलीज़ किए जा सकते हैं, जिससे संसाधन उपयोग बेहतर हो सकता है।
रुचि रखने वाले पाठक मशीन लर्निंग के लिए Apache Spark जैसे प्रायोगिक ट्यूटोरियल से Spark की क्षमताएँ और गहराई से जान सकते हैं।
Spark अपने साथ कोई वितरित स्टोरेज सिस्टम नहीं लाता—यह HDFS, Amazon S3 या अन्य संगत स्टोरेज सिस्टम का लाभ उठाता है। कंप्यूट और स्टोरेज के बीच यह आर्किटेक्चरल पृथक्करण लचीलापन देता है, पर इष्टतम डेटा एक्सेस पैटर्न सुनिश्चित करने के लिए सावधानीपूर्वक कॉन्फ़िगरेशन मांगता है।
जैसे उपकरण Spark SQL और sparklyr इस आर्किटेक्चर के साथ इंटरैक्ट करने के सुविधाजनक तरीके प्रदान करते हैं।
क्लस्टर प्रबंधन में मुख्य अंतर
Hadoop का क्लस्टर प्रबंधन दृष्टिकोण अधिक इन्फ्रास्ट्रक्चर‑केंद्रित है—तुलनात्मक रूप से स्थिर संसाधन आवंटन और डेटा लोकैलिटी पर फोकस के साथ। यह डिज़ाइन स्थिर क्लस्टरों पर लंबे समय तक चलने वाले बैच जॉब्स के लिए अच्छा काम करता है जहाँ नोड्स में कम परिवर्तन होते हैं।
हालाँकि, यह बदलते वर्कलोड्स के प्रति कम उत्तरदायी हो सकता है और स्केलिंग के समय अधिक मैनुअल दखल की आवश्यकता पड़ती है।
Spark अधिक डायनेमिक संसाधन प्रबंधन प्रदान करता है—खासकर जब इसे Kubernetes जैसे आधुनिक ऑर्केस्ट्रेशन प्लेटफ़ॉर्म पर चलाया जाए। यह वर्तमान मांग के आधार पर संसाधन आवंटन समायोजित कर सकता है और ज़रूरत न होने पर संसाधन रिलीज़ कर सकता है।
यह इलास्टिसिटी उन संगठनों के लिए मूल्यवान है जिनके वर्कलोड्स उतार‑चढ़ाव वाले हों या साझा इन्फ्रास्ट्रक्चर में कई एप्लिकेशन सेवित होते हों।
इन अंतरों को समझना Data Engineer प्रमाणन पाने या Spark इंटरव्यू प्रश्न की तैयारी करते समय महत्वपूर्ण है।
बिग डेटा की शुरुआत कर रहे संगठनों के लिए, Spark के अधिक लचीले डिप्लॉयमेंट विकल्प और सरल प्रोग्रामिंग मॉडल के कारण शुरुआत करना अक्सर आसान होता है।
हालाँकि, ऐसे वातावरणों में जहाँ डेटा वॉल्यूम अत्यधिक बड़े हैं और स्टोरेज प्रबंधन प्राथमिक चिंता है, Hadoop का परिपक्व HDFS इकोसिस्टम अब भी ऐसे फायदे देता है जो Spark की प्रोसेसिंग क्षमताओं का पूरक हैं। Spark की अन्य स्ट्रीमिंग तकनीकों से तुलना के लिए, पाठकों को Flink बनाम Spark जैसी तुलनाएँ उपयोगी लग सकती हैं।
Hadoop MapReduce बनाम Spark का प्रोसेसिंग मॉडल
हालाँकि पिछले अनुभागों में प्रदर्शन के निहितार्थों पर चर्चा हुई, प्रत्येक फ़्रेमवर्क के बुनियादी प्रोसेसिंग मॉडल को समझना बताता है कि उनकी आर्किटेक्चर इतनी भिन्न क्यों है।
Hadoop MapReduce फ़्रेमवर्क
MapReduce दो प्राथमिक चरणों—मैप और रिड्यूस—के साथ एक कठोर प्रोग्रामिंग पैराडाइम का पालन करता है। मैप चरण प्रत्येक रिकॉर्ड पर समानांतर में एक फ़ंक्शन लागू करके मध्यवर्ती की‑वैल्यू पेयर्स उत्पन्न करता है।
इन पेयर्स पर अनिवार्य शफ़लिंग और सॉर्टिंग चरण होता है, जहाँ समान की वाले डेटा को समूहित किया जाता है।
अंततः, रिड्यूस चरण इन समूहित मानों को एकत्रित कर अंतिम आउटपुट पैदा करता है। इस संरचित दृष्टिकोण का मतलब है कि जटिल ऑपरेशनों के लिए कई MapReduce जॉब्स को एक‑दूसरे से जोड़ना पड़ता है।
MapReduce एप्लिकेशन विकसित करना आमतौर पर लो‑लेवल कोड लिखना शामिल करता है जो स्पष्ट रूप से मैप और रिड्यूस फ़ंक्शन्स को परिभाषित करता है।
हालाँकि Apache Pig और Apache Hive उच्च‑स्तरीय एब्स्ट्रैक्शन देते हैं, लेकिन अंतर्निहित निष्पादन अब भी सख्त MapReduce पैटर्न का पालन करता है—जो एल्गोरिद्म डिज़ाइन और ऑप्टिमाइज़ेशन के अवसरों पर सीमाएँ लगाता है।
Spark का डेटा प्रोसेसिंग मॉडल
Spark ने अपने कोर एब्स्ट्रैक्शन के रूप में Resilient Distributed Datasets (RDDs) पेश किए—अपरिवर्तनीय, विभाजित कलेक्शन्स जो रिकवरी के लिए अपनी लीनिएज ट्रैक कर सकते हैं। MapReduce के विपरीत, Spark कोई कठोर प्रोसेसिंग पैटर्न लागू नहीं करता, बल्कि दो प्रकार के ऑपरेशन देता है: ट्रांसफॉर्मेशन (जो नए RDDs बनाते हैं) और एक्शंस (जो मान लौटाते हैं)।
यह लचीलापन मैप‑रिड्यूस पैरेडाइम से परे विविध प्रोसेसिंग पैटर्न की अनुमति देता है।
Spark RDDs से आगे बढ़कर DataFrames और Datasets जैसे उच्च‑स्तरीय एब्स्ट्रैक्शन उपलब्ध कराता है, जो रिलेशनल डेटाबेस के समान ऑप्टिमाइज़ेशन के साथ स्कीमा‑अवेयर प्रोसेसिंग देते हैं। ये एब्स्ट्रैक्शन—स्ट्रीमिंग, SQL, मशीन लर्निंग और ग्राफ़ प्रोसेसिंग के विशेषीकृत लाइब्रेरीज़ के साथ—डेवलपर्स को समकक्ष MapReduce इम्प्लीमेंटेशंस की तुलना में काफी कम कोड में जटिल वर्कफ़्लोज़ व्यक्त करने देते हैं, और भिन्न प्रोसेसिंग पैरेडाइम्स में एकीकृत प्रोग्रामिंग मॉडल बनाए रखते हैं।
Spark बनाम Hadoop: लागत संबंधी विचार
बिग डेटा फ़्रेमवर्क का मूल्यांकन करते समय, संगठनों को केवल तकनीकी क्षमताएँ ही नहीं बल्कि डिप्लॉयमेंट और संचालन के वित्तीय प्रभाव भी देखने चाहिए।
हार्डवेयर आवश्यकताएँ और निहितार्थ
Hadoop और Spark की हार्डवेयर प्राथमिकताएँ मौलिक रूप से भिन्न हैं, जिनका इन्फ्रास्ट्रक्चर लागत पर असर पड़ता है। Hadoop को मेमोरी की तुलना में डिस्क स्टोरेज को प्राथमिकता देते हुए डिज़ाइन किया गया है—यह सीमित RAM परंतु पर्याप्त हार्ड ड्राइव क्षमता वाले कम लागत हार्डवेयर के लिए उपयुक्त है।
यह आर्किटेक्चर प्रारंभिक हार्डवेयर निवेश घटा सकता है—खासकर तब जब डेटासेट इतने बड़े हों कि मेमोरी‑आधारित समाधान अत्यधिक महँगे पड़ें।
Spark का इन‑मेमाेरी प्रोसेसिंग मॉडल प्रदर्शन लाभ देता है, लेकिन प्रति नोड काफी अधिक RAM मांगता है। उपयुक्त रूप से कॉन्फ़िगर किया गया Spark क्लस्टर प्रायः उच्च मेमोरी वाले सर्वर माँगता है—वर्कलोड के अनुसार प्रति नोड 16GB से 256GB तक।
हालाँकि मेमोरी की लागत समय के साथ घटी है, फिर भी यह आवश्यकता डिस्क‑केंद्रित Hadoop डिप्लॉयमेंट की तुलना में हार्डवेयर खर्च बढ़ा सकती है।
संचालन व्यय
ऑपरेशनल लागत में हार्डवेयर अधिग्रहण से आगे बढ़कर रखरखाव, बिजली, कूलिंग और डेटा सेंटर स्पेस शामिल हैं। Hadoop क्लस्टर अनेक कम लागत सर्वरों और व्यापक स्टोरेज पर निर्भरता के कारण भौतिक रूप से बड़े होते हैं।
यह बड़ा फ़ुटप्रिंट पावर, कूलिंग और रैक स्पेस की अधिक लागत में बदलता है।
Spark क्लस्टर कभी‑कभी कम नोड्स के साथ समान प्रोसेसिंग क्षमता हासिल कर लेते हैं—कंप्यूटिंग संसाधनों के अधिक कुशल उपयोग के कारण—जिससे डेटा सेंटर फ़ुटप्रिंट और संबंधित लागत घट सकती है। हालाँकि, आवश्यक उच्च‑विशिष्टता वाली मशीनें प्रति नोड अधिक पावर खपत कर सकती हैं, जिससे ये बचत आंशिक रूप से संतुलित हो सकती है।
डेवलपमेंट और कार्मिक लागत
इम्प्लीमेंटेशन और रखरखाव की जटिलता कुल स्वामित्व लागत पर महत्वपूर्ण प्रभाव डाल सकती है। Hadoop इकोसिस्टम पारंपरिक रूप से Java प्रोग्रामिंग और Unix प्रशासन में विशेष विशेषज्ञता मांगता रहा है, और MapReduce प्रोग्रामिंग के विस्तृत स्वभाव के कारण डेवलपमेंट चक्र लंबे हो सकते हैं।
Spark Python, Scala, R और Java में अधिक सुलभ API देता है, जिससे डेवलपमेंट समय और संबद्ध कार्मिक लागत घट सकती है।
अधिक सहज प्रोग्रामिंग मॉडल सीखने की वक्र और डेवलपमेंट समय दोनों घटा सकता है, जिससे संगठन कम विशेषीकृत कार्मिकों के साथ तेज़ी से समाधान लागू कर पाते हैं।
लागत अनुकूलन रणनीतियाँ
लागत‑संवेदी संगठनों के लिए, हाइब्रिड दृष्टिकोण अक्सर सर्वोत्तम मूल्य देते हैं। स्टोरेज के लिए HDFS का उपयोग करते हुए प्रोसेसिंग के लिए Spark का लाभ उठाना—Hadoop के किफ़ायती स्टोरेज को Spark की प्रोसेसिंग दक्षता से जोड़ सकता है। AWS EMR, Azure HDInsight या Google Dataproc जैसी सेवाओं पर क्लाउड‑आधारित डिप्लॉयमेंट संगठनों को केवल उपयोग किए संसाधनों के लिए भुगतान करने देते हैं—बड़े अग्रिम पूँजीगत खर्च के बिना।
संगठनों को स्केलेबिलिटी लागत भी देखनी चाहिए। Hadoop में परंपरागत रूप से स्केलिंग के लिए मैनुअल हस्तक्षेप चाहिए होता है—जो ऑपरेशनल ओवरहेड बढ़ाता है। वहीं, Kubernetes जैसे कंटेनर ऑर्केस्ट्रेशन प्लेटफ़ॉर्म के साथ Spark की संगतता अधिक स्वचालित, इलास्टिक स्केलिंग सक्षम करती है—जो वास्तविक मांग के अनुरूप संसाधन प्रावधान बेहतर ढंग से मिलान कर सकती है और संभावित रूप से बेकार क्षमता घटा सकती है।
Hadoop बनाम Spark तुलना तालिका
यहाँ उनके अंतरों को संक्षेप में प्रस्तुत करने वाली एक तुलना तालिका है:
फ़ीचर
Hadoop
Spark
प्रोसेसिंग मॉडल
MapReduce का उपयोग करके बैच प्रोसेसिंग
RDDs, DataFrames और Datasets का उपयोग कर इन‑मेमाेरी प्रोसेसिंग
प्रदर्शन
चरणों के बीच डिस्क I/O के कारण धीमा
आवर्तक और इन‑मेमाेरी वर्कलोड्स के लिए 100x तक तेज़
मेमोरी उपयोग
डिस्क‑केंद्रित, कम मेमोरी आवश्यकताएँ
मेमोरी‑गहन, उच्च RAM आवश्यकताएँ
डेवलपमेंट की सहजता
विस्तृत; मैप और रिड्यूस लॉजिक स्पष्ट रूप से लिखना पड़ता है
Python, Scala, R, Java में उच्च‑स्तरीय APIs; कम बोयलरप्लेट
फॉल्ट टॉलरेंस
HDFS के माध्यम से डेटा प्रतिकृति
असफलता पर पुनर्गणना हेतु RDD लीनिएज
रियल‑टाइम प्रोसेसिंग
उपयुक्त नहीं; केवल बैच
Spark Streaming के माध्यम से रियल‑टाइम प्रोसेसिंग समर्थन
क्लस्टर मैनेजर
YARN
स्टैंडअलोन, YARN, Mesos या Kubernetes
स्टोरेज
HDFS के साथ आता है
बाहरी स्टोरेज पर निर्भर (जैसे HDFS, S3, GCS)
लागत
कम हार्डवेयर लागत (कम लागत मशीनें, डिस्क‑आधारित)
उच्च मेमोरी लागत, पर प्रति वर्कलोड बेहतर संसाधन उपयोग
सबसे उपयुक्त
बैच जॉब्स, बड़े‑पैमाने का स्टोरेज, ऐतिहासिक डेटा विश्लेषण
मशीन लर्निंग, स्ट्रीम प्रोसेसिंग, इंटरैक्टिव एनालिटिक्स
इंटीग्रेशन
मजबूत Hadoop इकोसिस्टम (Hive, Pig, आदि)
एक ही प्लेटफ़ॉर्म में SQL, MLlib, GraphX और Streaming के लिए एकीकृत APIs
निष्कर्ष
Hadoop और Spark कड़े प्रतिद्वंद्वी नहीं बल्कि बिग डेटा प्रोसेसिंग के परस्पर पूरक दृष्टिकोण हैं। Hadoop अपने किफ़ायती स्टोरेज सिस्टम (HDFS) और बैच‑उन्मुख प्रोसेसिंग के साथ उन विशाल डेटासेट के लिए उत्कृष्ट है जहाँ गति से अधिक थ्रूपुट मायने रखता है।
Spark अपनी इन‑मेमाेरी प्रोसेसिंग क्षमताओं के साथ चमकता है—जो आवर्तक एल्गोरिद्म, इंटरैक्टिव एनालिटिक्स और रियल‑टाइम प्रोसेसिंग जरूरतों के लिए श्रेष्ठ प्रदर्शन देता है।
यदि आप इन दोनों तकनीकों के बारे में और सीखना चाहते हैं, तो DataCamp विभिन्न संसाधन प्रदान करता है: