
Last chance! 50% off DataCamp Premium
Sale ends in
Puoi accedere al codice completo di questa demo qui.
Nemotron 3 Super è il modello open di NVIDIA per il reasoning in workflow agentici e con contesti lunghi. Usa un'architettura ibrida Mamba-Transformer Latent MoE con 120B parametri totali e 12B attivi, include la multi-token prediction (MTP) ed è progettato per task con forte componente di ragionamento come coding, uso di tool e analisi di contesti lunghi.
NVIDIA lo posiziona specificamente per applicazioni multi-agente complesse e reasoning sull'intero codebase.
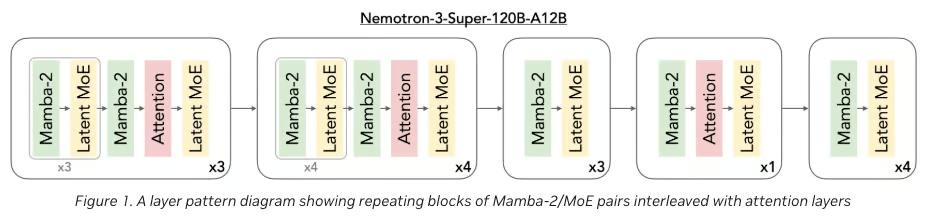
Figura 1: Architettura di Nemotron 3 Super (NVIDIA Blog)
Alcune idee chiave dietro Nemotron 3 Super includono:
Per questo tutorial useremo il free endpoint ospitato su OpenRouter, dato che sia la variante completa sia quella quantizzata del modello richiedono tipicamente almeno una GPU H100 per inferenza pratica. L'endpoint ospitato supporta attualmente una finestra di contesto da 262K token (invece dell'intero 1M), comunque sufficiente per analizzare repository di medie dimensioni in questa demo.
La famiglia Nemotron 3 di NVIDIA è stata introdotta come una famiglia di modelli open per sistemi di AI agentica, con diverse dimensioni mirate a differenti esigenze di deployment e reasoning, denominate livelli Nano, Super e Ultra.
A livello pratico, puoi pensare alla famiglia così:
Quindi, Nemotron 3 Super è la scelta giusta qui perché vogliamo un modello che sappia ragionare su un intero repository in una volta sola, non solo risolvere sotto-task di coding isolati.
In questa sezione costruiremo un analizzatore di repo usando Nemotron 3 Super con interfaccia Gradio. A grandi linee, ecco cosa fa l'app finale:
Costruiamola passo dopo passo.
Prima di costruire l'analizzatore di repo, ci serve un ambiente minimale che gestisca tre responsabilità chiave: rendering della UI, elaborazione del repository e interazione con il modello. Dato che non eseguiamo Nemotron in locale, il setup resta leggero e mirato.
Installa tutto eseguendo:
!pip -q install gradio openai tiktoken gitpython orjson pandasIn questo progetto useremo:
openai per interagire con l'API di OpenRouter (endpoint Nemotron)gradio per costruire la UI interattivatiktoken per stimare l'uso di token prima di inviare i promptorjson per il parsing JSON veloce degli output del modellopandas per rendere i risultati strutturati come tabellegitpython per clonare e lavorare con i repositoryA differenza dei setup LLM locali (che richiedono CUDA, vLLM o quantizzazione), questo approccio evita del tutto dipendenze GPU e mantiene l'ambiente adatto a Colab.
In questo passo configuriamo Nemotron 3 Super via OpenRouter e definiamo alcune costanti chiave che controllano come vengono processati i repository. Poiché non eseguiamo il modello in locale, questo client diventa l'interfaccia centrale per inviare prompt di grandi dimensioni impacchettati e ricevere output di analisi strutturati.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
A questo stadio, l'applicazione comunica con Nemotron 3 Super tramite OpenRouter usando il client Python openai configurato con una base_url personalizzata e una chiave API memorizzata in OPENROUTER_API_KEY.
Il modello selezionato punta all'endpoint ospitato su OpenRouter, che ci consente di eseguire un modello molto grande senza necessitare di infrastruttura GPU locale.
Per gestire la dimensione del contesto, inizializziamo un tokenizer (tiktoken con cl100k_base) così da stimare quanti token consumerà il repository impacchettato prima di inviarlo al modello. Questo perché il modello ha una finestra di contesto finita.
Alcune considerazioni pratiche:
Ora ci servono due salvaguardie: filtraggio dei file e ancoraggio del prompt.
La prima impedisce di sprecare contesto su artefatti irrilevanti come output di build, notebook, immagini o file binari.
La seconda assicura che, una volta impacchettato il repository, il modello rimanga ancorato al codice reale invece di scivolare in consigli software generici.
Insieme, queste regole rendono l'analisi del repo più efficiente.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
Le tre variabili di filtraggio seguenti controllano il preprocessing del repository:
BASE_IGNORE_DIRS esclude directory irrilevanti per l'analisi del codice o troppo rumorose per essere utili, come .git, node_modules, cartelle di build e cache specifiche dell'editor. IGNORE_SUFFIXES filtra tipi di file generalmente poco utili per il reasoning sul repo, incluse immagini, archivi, video, checkpoint di modelli e altri artefatti. MAX_FILE_BYTES aggiunge un ulteriore controllo di sicurezza saltando i file troppo grandi, aiutando a mantenere il repository impacchettato entro un budget di contesto pratico.Il SYSTEM_PROMPT è importante quanto i filtri dei file.
Poiché il modello vede il repository come un unico lungo prompt, dobbiamo fornire vincoli comportamentali chiari per evitare di inventare moduli, fraintendere astrazioni o dare raccomandazioni troppo generiche.
Queste istruzioni impongono esplicitamente al modello di restare ancorato al repository fornito, citare i percorsi dei file per le affermazioni importanti e separare le evidenze dirette dal giudizio generale.
Ora che abbiamo il filtraggio dei file e un system prompt, il passo successivo è definire un set di task a livello di repository, ciascuno associato a uno schema JSON strutturato.
Questo ci dà due vantaggi principali: il modello sa esattamente che tipo di output produrre e l'app può fare parsing e renderizzare in modo affidabile i risultati in tabelle specifiche per task.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
Il dizionario TASK_DEFS funge da registro centrale per tutte le modalità di analisi supportate dall'app.
Ogni task contiene una descrizione in linguaggio naturale che dice al modello cosa fare e uno schema rigoroso che definisce l'output JSON atteso.
È questo che permette allo stesso repository impacchettato di supportare forme di reasoning molto diverse, come mappatura dell'architettura, analisi delle duplicazioni, guida all'onboarding o rilevamento di lacune nei test.
Per esempio, Architecture Overview chiede al modello di identificare:
Altri task nel codice completo includono:
Code Duplication, incentrato sulla logica ripetuta e le opportunità di refactor correlate,Improvement Opportunities che identifica guadagni di manutenibilità e modularità,Testing Gaps che evidenzia aree sotto-testate,Onboarding Guide che spiega come un nuovo ingegnere dovrebbe approcciare il codebase,Library Modernization che fa emergere librerie obsolete o sovrapposte,Code Quality Hotspots che indica aree fragili o inclini ai bug,Security o Config Hygiene che segnala impostazioni rischiose o problemi operativi.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()La lista FULL_REVIEW_TASKS definisce una revisione multi-step in bundle.
Invece di eseguire ogni possibile task, avvia un sottoinsieme curato che dà una visione ingegneristica ampia del repository. TASK_CHOICES è poi usato direttamente nel menu a discesa di Gradio così che l'utente possa scegliere un singolo task o la revisione in bundle.
L'ultima parte, safe_str(), risolve un problema di stabilità sorprendentemente importante. Durante lo sviluppo, una modalità di errore comune era:
'NoneType' object has no attribute 'strip'Questo può accadere quando:
None,Normalizzando tutti questi valori tramite la funzione safe_str(), rendiamo l'app molto più robusta.
Prima di poter inviare qualcosa al modello, dobbiamo trasformare un repository GitHub in un unico prompt strutturato.
Questo passo gestisce l'intera pipeline di ingestione: clonazione del repo, filtraggio dei file irrilevanti, estrazione del solo testo utilizzabile e impacchettamento di tutto in un formato che il modello possa consumare in un'unica passata.
A differenza delle pipeline RAG tradizionali, qui non facciamo chunking o embedding. Stiamo invece comprimendo l'intero repository in un unico input a contesto lungo, quindi essere selettivi e strutturati in questa fase è fondamentale sia per le prestazioni sia per la qualità.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Questo passo definisce l'intera pipeline di ingestione e impacchettamento del repository, ma ogni funzione ha una responsabilità specifica:
funzione clone_repo(): clona un repository GitHub in una directory di lavoro temporanea usando un clone superficiale (--depth 1) per evitare di scaricare l'intera cronologia. Input come URL del repo e branch sono normalizzati con safe_str() per prevenire errori a runtime. L'output è un percorso locale (WORKDIR) su cui opera il resto della pipeline.funzione iter_repo_files(): agisce come livello principale di filtraggio. Scansiona ricorsivamente il repository e restituisce solo file ad alto segnale. Esclude directory di sistema, tipi di file non supportati, file troppo grandi e, opzionalmente, filtra test, documentazione e notebook. funzione is_probably_text(): è un controllo di sicurezza leggero usato durante il filtraggio. Legge un piccolo chunk di ogni file e verifica l'assenza di byte null (che di solito indicano contenuto binario) e la decodifica UTF-8 riuscita. Solo i file che superano questo controllo sono considerati testo valido e inclusi nel dataset finale.funzione repo_tree_string(): costruisce una rappresentazione in stringa della struttura del repository. Crea un albero di directory (applicando le stesse regole di filtraggio) e produce un elenco di directory e file usato nel prompt così che il modello ottenga una comprensione di alto livello del layout del codebase prima di leggere i contenuti dei file.funzione pack_repo(): è la funzione di impacchettamento principale. Itera su tutti i file filtrati, ne legge i contenuti e avvolge ciascun file tra marcatori espliciti come === FILE START === e === FILE END ===. Stima anche l'uso dei token con tiktoken e accumula un conteggio totale.funzione build_repo_context(): combina tutto in un unico prompt strutturato. Inserisce prima l'albero del repo, seguito da tutti i contenuti dei file. Il modello comprende prima la struttura, poi legge i dettagli di implementazione.L'effetto complessivo è un repository GitHub grezzo trasformato in un unico input strutturato a contesto lungo.
Ora che il repository è stato filtrato e impacchettato in un unico input a contesto lungo, il passo successivo è dire al modello che tipo di analisi eseguire e come formattare il risultato.
Invece di inviare la stessa istruzione generica per ogni caso d'uso, generiamo un prompt specifico per il task che include il nome del task scelto, la sua descrizione e l'esatto schema JSON atteso nella risposta.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
Il frammento di codice sopra definisce due funzioni strettamente correlate che fanno da ponte tra il repository impacchettato e l'output di analisi specifico per task.
funzione build_task_prompt() : crea il prompt finale inviato al modello. Normalizza innanzitutto il nome del task con safe_str() così che un input vuoto non rompa la pipeline. Valida poi che il task esista in TASK_DEFS, prevenendo l'invio di task non supportati o scritti male. Una volta validato, recupera la descrizione e lo schema JSON del task e li inserisce nel prompt finale insieme al contesto completo del repository impacchettato.funzione try_parse_json(): gestisce l'output del modello dopo l'inferenza. In pratica, i modelli a contesto lungo a volte avvolgono il JSON con testo extra, artefatti di formattazione o contenuto esplicativo parziale. Per rendere l'app più robusta, la funzione tenta prima il parsing diretto con orjson.loads(). Combinando prompting rigoroso con un parsing tollerante, l'app risulta molto più stabile.Nel prossimo passo, collegheremo questa logica di prompting alla chiamata al modello e inizieremo a generare risultati strutturati di analisi del repository.
A questo punto eseguiamo l'analisi inviando il prompt a Nemotron 3 Super tramite OpenRouter.
Invece di spezzettare o recuperare parti del repo, inviamo l'intero codebase filtrato in un'unica richiesta e lasciamo che il modello ragioni globalmente tra file, moduli e dipendenze.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
La funzione call_model() è responsabile dell'esecuzione effettiva della chiamata al modello ed estrazione della risposta. Ecco la pipeline completa:
0.2 per mantenere output deterministici e il parametro max_tokens limita la dimensione della risposta, assicurando che il modello si concentri su output strutturato.Infine, possiamo passare alla parte di inferenza del modello e capire come eseguire l'analisi tramite il modello ospitato su OpenRouter.
Ora servono alcune piccole funzioni di supporto che rendono facile la gestione della UI e degli output.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Questo passo definisce un piccolo set di funzioni helper che, insieme, gestiscono gran parte della logica di presentazione dell'app.
funzione to_df(): converte gli output del modello in un DataFrame pandas così da renderli pulitamente nelle tabelle di Gradio. funzione get_tasks_to_run(): decide se l'app deve eseguire un singolo task o il bundle Full Review. Se il task selezionato è "Full Review", lo espande nella lista predefinita di task di revisione. Altrimenti, restituisce semplicemente una lista a un elemento con il task selezionato. funzione visible_for_task(): controlla quali tabelle del report mostrare effettivamente nella UI. Ad esempio, se l'utente seleziona Onboarding Guide, non ha senso mostrare tabelle di duplicazione o sicurezza. funzione render_markdown_summary(): invece di scaricare direttamente il JSON grezzo, genera un riepilogo leggibile con metadati del repository, conteggio token ed evidenze per task.funzioni hidden_update() e visible_update(): piccoli helper di Gradio usati per controllare lo stato dei componenti. hidden_update() pulisce una tabella e la nasconde, mentre visible_update() riempie una tabella con dati e la rende visibile. Questo pattern è importante perché Gradio si aspetta un valore di ritorno per ogni componente di output e, senza reset espliciti, la UI può mantenere stati obsoleti.funzione empty_outputs(): gestisce uscite anticipate e stati di errore. Se il repo è troppo grande, il task non è valido o qualcos'altro fallisce, l'app deve comunque restituire output validi per ogni componente della UI. Insieme, queste funzioni helper non cambiano la logica core del modello, ma compongono un'app usabile.
Questa funzione orchestra l'intero workflow. Valida gli input, prepara il repository, esegue uno o più task di analisi e restituisce output strutturati alla UI di Gradio.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Questa funzione orchestra l'intera pipeline, dal repo grezzo all'output strutturato.
results.to_df() e mappati ai componenti della UI. La visibilità è controllata tramite visible_for_task(), così da mostrare solo le tabelle rilevanti per il task selezionato.empty_outputs() per mantenere stabile la UI.Infine, avvolgiamo tutto in una semplice interfaccia Gradio.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
Il contenitore gr.Blocks() definisce il layout complessivo dell'app, mentre il Markdown di alto livello imposta titolo e contesto. L'interfaccia è suddivisa in tre tab per mantenere il workflow strutturato.
Questo collega gli input dell'utente direttamente alla funzione analyze_repo() e mappa i suoi output ai componenti della UI. L'ordinamento degli output è cruciale qui, poiché ogni valore di ritorno è instradato a uno specifico elemento della UI.
Infine, l'app viene avviata usando:
demo.launch(debug=True, share=True)Il flag debug=True aiuta a far emergere errori a runtime durante lo sviluppo, mentre share=True crea un link pubblico, rendendo semplice condividere l'app senza deployment.
In questo tutorial ho mostrato come costruire un analizzatore di codebase di repo usando NVIDIA Nemotron 3 Super, OpenRouter e Gradio.
Invece di fare affidamento su chunking, embedding e retrieval, l'app clona un repository GitHub pubblico, filtra e impacchetta il codebase in un unico prompt e chiede al modello di ragionare sull'intero repository in una volta sola.
Questo approccio a contesto completo è utile per task che richiedono una visione globale del codebase, come spiegazione dell'architettura, guida all'onboarding, analisi delle lacune nei test, opportunità di miglioramento e pianificazione del refactor.
Da qui, puoi estendere il progetto in vari modi:
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




