
Corso
Apprendimento supervisionato con scikit-learn
4 ore
309.1K
Pratica and corso your progress.
Continua Con GoogleNVIDIA cuML è una libreria di machine learning accelerata da GPU che fa parte dell’ecosistema RAPIDS AI. E ora, in open beta, cuML 25.02 rende possibile avere l’accelerazione GPU in scikit-learn, UMAP e HDBSCAN senza cambiare il tuo codice Python. Questa è una notizia molto interessante per ingegneri di machine learning in Python, data e research scientist, sviluppatori e molti altri professionisti che desiderano vedere un aumento delle prestazioni dei propri modelli.
Niente panico se non sei aggiornato su cuML o persino sul concetto di accelerazione GPU. Ti farò da guida e, alla fine di questo articolo, saprai usare l’accelerazione GPU per i tuoi problemi di regressione, classificazione, riduzione della dimensionalità o clustering.
Facciamo un attimo d’ordine per mettere tutti i pezzi al posto giusto.
NVIDIA sviluppa tecnologie all’avanguardia che alimentano l’high-performance computing, l’AI e la data science. Forse ricorderai che è finita spesso sulle prime pagine quando Deepseek ha rilasciato Deepseek-R1 e molti si chiedevano se Deepseek usasse chip NVIDIA.
Bene, NVIDIA torna alla ribalta, questa volta per le innovazioni nel suo ecosistema RAPIDS AI. RAPIDS AI, se non lo conosci, è una suite open-source di librerie accelerate da GPU pensata per velocizzare i flussi di lavoro di data science e machine learning. RAPIDS è costruita su CUDA (Compute Unified Device Architecture), una piattaforma di calcolo parallelo e un modello di API, sviluppati anch’essi da NVIDIA. Le librerie accelerate da GPU di RAPIDS includono:
Passando a cuML: cuML offre implementazioni altamente ottimizzate di algoritmi classici di machine learning. Poiché NVIDIA ha i migliori chip per l’AI, questi algoritmi, che girano sulle GPU NVIDIA, ottengono un notevole aumento di velocità. Le GPU, a differenza delle CPU, eccellono nell’elaborazione parallela, il che significa praticamente che possono gestire migliaia di calcoli contemporaneamente, rendendole ideali per attività come (l’hai indovinato) deep learning e machine learning.
Se non conosci scikit-learn e fai sul serio con il machine learning e la data science, dovresti assolutamente iscriverti al nostro corso Supervised Learning with scikit-learn. Lo dico perché scikit-learn è la libreria numero uno per i dati tabellari nel linguaggio di programmazione più popolare per il machine learning. Inoltre, scikit-learn è piuttosto semplice da imparare, ha un’API facile e si integra bene con pandas e NumPy. Non sorprende quindi che il team RAPIDS AI si stia concentrando sugli algoritmi di scikit-learn come scelta strategica e naturale.
NVIDIA e cuML offrono ora a scikit-learn, e anche a UMAP e HDBSCAN, una grande innovazione: un enorme aumento della velocità di esecuzione. Secondo il team RAPIDS AI, questo significa fino a 50x di velocità con scikit-learn, 60x per UMAP e 175x per HDBSCAN.
Facendo due conti al volo, un algoritmo che potrebbe impiegare cinque minuti per essere eseguito con scikit-learn potrebbe teoricamente essere ridotto fino a sei secondi. È una gran differenza. Tornerò su questo punto quando vedremo i benchmark qui sotto.
Se tutto questo ti sembra complesso, non preoccuparti. RAPIDS AI punta a richiedere zero modifiche al codice dell’API di scikit-learn. Davvero, ti basta caricare l’estensione, così:
%load_ext cuml.accel
$ python -m cuml.accel script.pyNon è un grande cambiamento rispetto al flusso di lavoro a cui sei abituato, ed è proprio questo il punto. A volte, magari, dovrai riavviare il kernel e ricaricare l’estensione.
Secondo me, questo aspetto delle “zero modifiche al codice” è, a prima vista, davvero entusiasmante. L’idea è che tu non debba cambiare gli script scikit-learn che hai già scritto: non la prima volta, ma neppure in seguito. cuML accelererà automaticamente i componenti compatibili sulle GPU NVIDIA; se invece nel tuo codice c’è qualcosa che non è compatibile con le GPU NVIDIA, lo script farà fallback alla normale esecuzione su CPU. Tu, come sviluppatore, vedrai semplicemente il risultato e non dovrai preoccuparti della gestione degli errori o di altro.
Detto questo, mi aspetterei comunque casi limite che potrebbero richiedere qualche aggiustamento. Nel codice le cose possono andare storte, e niente è mai facile come sembra. La documentazione di riferimento riporta aspetti che quasi smentiscono l’affermazione “nessuna modifica al codice”, o quantomeno aggiungono un po’ di frizione. Devi convertire le liste in array NumPy o Pandas DataFrame, e le etichette stringa non sono supportate, quindi gli utenti devono pre-codificare le etichette categoriche. Probabilmente lo faresti comunque, ma il punto è che, oltre a caricare l’estensione, ci sono altre abitudini da adottare.
Se stessi facendo pratica di statistica di base eseguendo una semplice regressione lineare sul dataset mtcars, non avrebbe molto senso usare l’accelerazione GPU per trovare pendenza e intercetta appena un po’ più in fretta. Risparmiare frazioni di secondo non varrebbe nemmeno la pena di caricare l’estensione, davvero. Ma se invece stessi eseguendo un algoritmo più complesso, il tempo risparmiato conta eccome, per due motivi principali.
Per prima cosa, il tempo risparmiato è significativo per molti flussi di lavoro. Ho detto che fino a 50x di boost potrebbe, ipoteticamente, ridurre un tempo di training di cinque minuti a sei secondi. Sono quasi cinque minuti risparmiati. Ma pensa al flusso di lavoro dell’ingegnere di machine learning, dove il modello potrebbe dover essere eseguito più volte per essere messo a punto. Sommandoli, parlare di risparmio a ogni esecuzione significa parlare della produttività complessiva di un data scientist.
In secondo luogo, e correlato, lo scienziato o l’ingegnere potrebbe iniziare a provare modelli più complessi. Nell’esempio precedente, assumiamo una velocità maggiore a parità di accuratezza. Ma cosa succede se pensi di ottenere in realtà un’accuratezza più alta con un modello più complesso? Immagina di fare una grid search di diversi parametri del modello e di addestrarlo. (Qui sotto provo un mio mini esempio.) Le permutazioni crescono esponenzialmente, rendendo il costo computazionale proibitivo su CPU. Ma non è un gran problema se hai un boost di velocità di 50x.
Questi benefici vanno di pari passo. Se imposti bene il progetto, potresti avere un modello più accurato prodotto anche più velocemente o, come potrebbe pensare un ML engineer, un’architettura più sofisticata senza tempi di training eccessivi.
NVIDIA ci tiene a sottolineare che le GPU produrranno risultati numericamente equivalenti. È positivo, perché significa che i benefici non comportano svantaggi in termini di accuratezza del modello.
Ma questo mi ha anche fatto riflettere: perché i risultati sono numericamente equivalenti e non identici? Probabilmente, a causa dell’elaborazione parallela, ci sono piccole differenze nell’output, oppure differenze nella stabilità numerica di un certo metodo. Magari, nel caso di UMAP, la proiezione UMAP è leggermente diversa. Lo dico nel caso tu notassi differenze sottili nell’output tra esecuzione su CPU e su GPU. NVIDIA sembra suggerire che dovresti aspettartelo e che sia normale.
Detto ciò, se ti metti davvero alla prova ed esegui un modello su GPU perché è abbastanza complesso da non essere praticabile su CPU, allora confrontare l’output di quel modello con un equivalente su CPU diventa difficile.
Ho accennato prima che in questa release cuML 25.02 c’è supporto per scikit-learn, UMAP e HDBSCAN. Ma se conosci scikit-learn, sai che ci sono molti algoritmi diversi. Al momento, RAPIDS AI supporta alcune librerie, ma non tutte. Ecco le principali menzioni, secondo il team:
In questo elenco, sarei particolarmente entusiasta di un boost di velocità su k-Nearest Neighbors, noto per essere molto oneroso dal punto di vista computazionale perché devi calcolare le distanze tra tutti i punti dati.
La seguente tabella mostra gli stimatori eseguiti in gran parte o interamente con cuML.
| Algoritmo | Libreria / Nome funzione | Categoria |
|---|---|---|
| UMAP | umap.UMAP |
Riduzione della dimensionalità |
| PCA (Principal Component Analysis) | sklearn.decomposition.PCA |
Riduzione della dimensionalità |
| SVD troncata | sklearn.decomposition.TruncatedSVD |
Riduzione della dimensionalità |
| t-SNE | sklearn.manifold.TSNE |
Riduzione della dimensionalità |
| HDBSCAN | hdbscan.HDBSCAN |
Clustering |
| K-Means | sklearn.cluster.KMeans |
Clustering |
| DBSCAN | sklearn.cluster.DBSCAN |
Clustering |
| Random Forest Classifier | sklearn.ensemble.RandomForestClassifier |
Classificazione |
| Logistic Regression | sklearn.linear_model.LogisticRegression |
Classificazione |
| K-Nearest Neighbors Classifier | sklearn.neighbors.KNeighborsClassifier |
Classificazione |
| Random Forest Regressor | sklearn.ensemble.RandomForestRegressor |
Regressione |
| Linear Regression | sklearn.linear_model.LinearRegression |
Regressione |
| Elastic Net | sklearn.linear_model.ElasticNet |
Regressione |
| Ridge Regression | sklearn.linear_model.Ridge |
Regressione |
| Lasso Regression | sklearn.linear_model.Lasso |
Regressione |
| Kernel Ridge Regression | sklearn.kernel_ridge.KernelRidge |
Regressione |
| K-Nearest Neighbors Regressor | sklearn.neighbors.KNeighborsRegressor |
Regressione |
| Nearest Neighbors Search | sklearn.neighbors.NearestNeighbors |
Ricerca dei vicini più prossimi |
Un elenco completo dei metodi supportati è disponibile nella documentazione RAPIDS AI. Ci aspettiamo che presto vengano aggiunti altri algoritmi. (Puoi anche inviare feedback per aiutare il team a stabilire le priorità.) Alcuni che ho notato mancanti: support vector regressor (sklearn.svm.SVR), Theil-Sen Regressor (sklearn.linear_model.TheilSenRegressor), clustering mean shift (sklearn.cluster.MeanShift) e scaling multidimensionale (sklearn.manifold.MDS).
Potresti chiederti come funzioni tutto questo. A grandi linee, sappi che sempre più librerie moderne sono progettate per rilevare e usare automaticamente l’hardware migliore disponibile, che sia CPU o GPU. Vediamo ora che, quando una funzione viene chiamata in scikit-learn (con cuml.accel abilitato), il software verifica se è disponibile una GPU compatibile e reindirizza l’esecuzione a una versione accelerata su GPU se c’è.
RAPIDS AI descrive questo meccanismo in cui cuml.accel si comporta come sklearn come un livello di compatibilità. In questo caso, il livello di compatibilità di cuML consente al codice scikit-learn di girare su GPU NVIDIA senza modifiche. È costruito come un drop-in replacement, funge da proxy, intercetta le chiamate di funzione a scikit-learn e le reindirizza a cuML.
Il team RAPIDS AI di NVIDIA condivide anche un grafico utile che riporto qui:
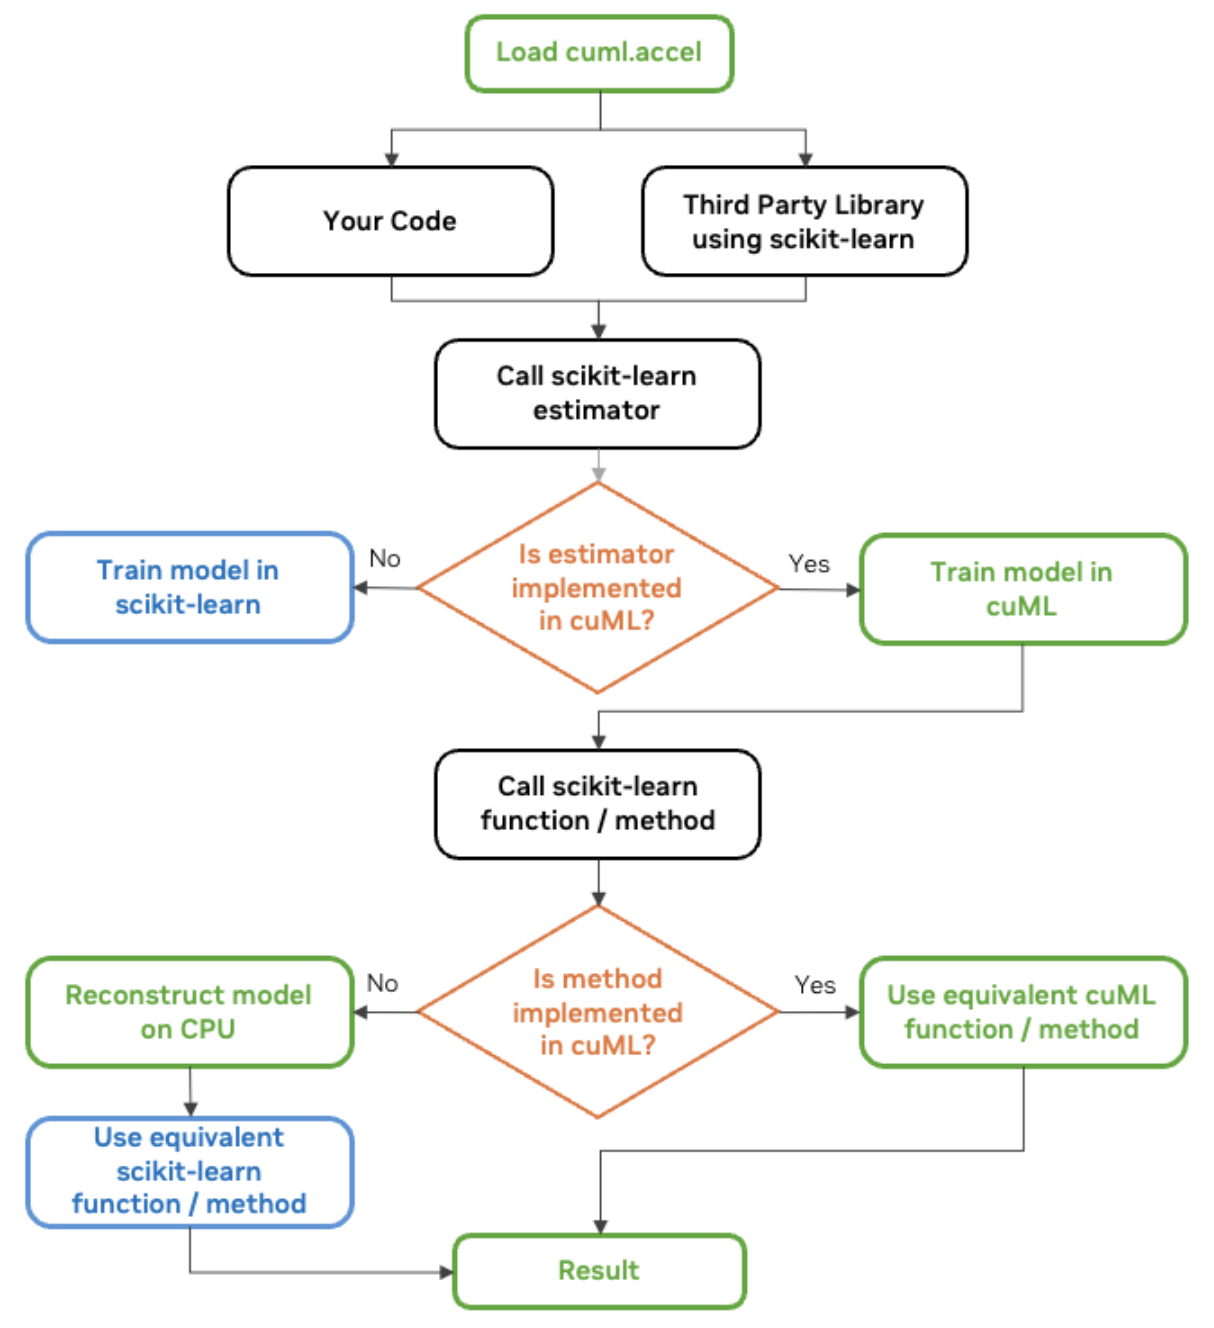
Diagramma del workflow cuML scikit-learn. Fonte: NVIDIA
cuML è già preinstallato su Google Colab, ma se usi un notebook Jupyter, attivalo con questo comando prima di importare scikit-learn:
%load_ext cuml.accel
import sklearn
Ora, il nostro codice Python che usa sklearn apparirà familiare, che è proprio l’obiettivo. Ecco un esempio di regressione OLS.
# Import necessary libraries
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# Generate synthetic regression data
X, y = make_regression(n_samples=500000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Create and train an OLS regression model
ols = LinearRegression()
ols.fit(X_train, y_train)
Se voglio vedere quali parti sono state eseguite su GPU invece che su CPU, posso usare il logger.
%load_ext cuml.accel

from cuml.common import logger;
logger.set_level(logger.level_enum.debug)
cuML: Installed accelerator for sklearn.
cuML: Successfully initialized accelerator.
cuML: Performing fit in GPUHai capito l’idea. Ora proviamo un esempio più convincente. La regressione lineare non è particolarmente parallelizzabile, dato che risolvere la normal equation o la decomposizione QR comporta alcune operazioni sequenziali.
Un’estensione più complessa della regressione OLS è la ridge regression. Quando usi la ridge regression in Python, chiamare Ridge() applica iperparametri predefiniti che potrebbero non essere ottimali. Il valore di alpha controlla quanto è forte la regolarizzazione. Troppo piccolo e il modello overfitta; troppo grande e underfitta.
%load_ext cuml.accel
import sklearn

from sklearn.linear_model import Ridge
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Generate synthetic data
X, y = make_regression(n_samples=100000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Train a Ridge Regression model with default settings
ridge_default = Ridge()
ridge_default.fit(X_train, y_train)

# Make predictions and evaluate
y_pred_default = ridge_default.predict(X_test)
mse_default = mean_squared_error(y_test, y_pred_default)
Il codice sopra addestra un unico modello, usando un singolo valore di alpha e un solver. (Credo che di default sia 'auto'.) Quindi, pur funzionando, non ottimizza l’intensità della regolarizzazione né la scelta del solver.
Invece di affidarci ai default, possiamo provare altro. Possiamo creare una grid search che testi più combinazioni di iperparametri e selezioni la migliore.
from sklearn.model_selection import GridSearchCV

# Define Ridge Regression model
ridge = Ridge()

# Define a grid of hyperparameters to search
param_grid = {
    'alpha': [0.01, 0.1, 1.0, 10.0, 100.0],  # Different regularization strengths
    'solver': ['auto', 'svd', 'cholesky', 'lsqr', 'saga']  # Test multiple solvers
}

# Perform Grid Search with cross-validation
grid_search = GridSearchCV(ridge, param_grid, scoring='neg_mean_squared_error', cv=2, n_jobs=-1)
grid_search.fit(X_train, y_train)

# Get the best model from the search
best_ridge = grid_search.best_estimator_

# Make predictions and evaluate
y_pred_best = best_ridge.predict(X_test)
mse_best = mean_squared_error(y_test, y_pred_best)
La nostra grid search qui testa tutte le possibili combinazioni di iperparametri. Se definiamo 5 valori per alpha ([0.01, 0.1, 1.0, 10.0, 100.0]), 5 opzioni di solver (['auto', 'svd', 'cholesky', 'lsqr', 'saga']) e usiamo una cross-validation a 2 fold, il numero totale di training richiesti è 5x5x2, cioè 50. Questo significa che invece di addestrare un modello, ne addestriamo 50. È molto, molto più complesso, ed è per questo che le GPU saranno ottime da usare, perché sono molto, molto più veloci. Poiché sklearn ha (fino a) 50x di aumento di velocità, addestrare questi 50 modelli potrebbe richiedere lo stesso tempo di uno solo. (Ho scelto questi numeri apposta per illustrare il punto. Riconosco che non tutti i modelli avranno lo stesso incremento.)
NVIDIA ha confrontato le prestazioni degli algoritmi di scikit-learn in esecuzione su CPU Intel con quelle su GPU NVIDIA. Hanno considerato diversi carichi di lavoro di machine learning, inclusi classificazione e regressione.
La conclusione è che modelli semplici come le random forest sono passati da minuti di training su CPU a secondi su GPU, e modelli più complessi come il clustering sono scesi da ore a minuti. I workflow sono risultati più veloci in ogni caso, ma per i modelli computazionalmente pesanti con dati ad alta dimensionalità i benefici sono stati ancora più evidenti. Questo è il punto di forza delle GPU, perché sfruttano l’elaborazione parallela, che fa una grande differenza nei modelli che richiedono ampie operazioni su matrici, calcoli di distanza o ottimizzazione eseguita in modo iterativo.
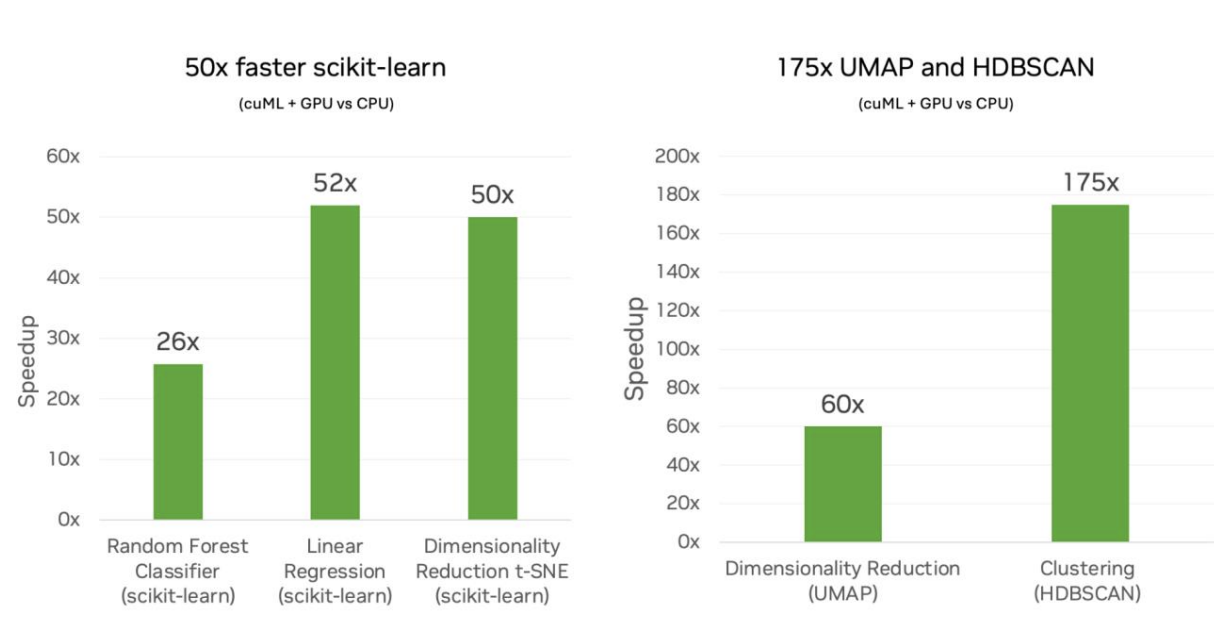
cuML scikit-learn su GPU vs scikit-learn su CPU. Fonte: NVIDIA
Nel precedente esempio di codice ero passato oltre la regressione lineare perché pensavo di dover mostrare altro per evidenziare la potenza. Ma qui vedo un’accelerazione 52x per la regressione lineare. Lo ammetto, sono sorpreso perché sembra un moltiplicatore importante. È un buon promemoria del fatto che NVIDIA fa anche altro a livello avanzato, come assicurarsi che i diversi step possano essere interlacciati così che la GPU non resti inattiva.
Grazie a cuML versione 25.02, eseguire un algoritmo di scikit-learn con GPU ora non è troppo difficile. Devi solo caricare l’estensione, come mostrato prima. Tuttavia, se sei più in profondità nel flusso di lavoro e vuoi sfruttare al massimo l’accelerazione GPU, dovrai considerare aspetti molto specifici.
NVIDIA consiglia di minimizzare i trasferimenti di dati tra CPU e GPU all’interno della pipeline. In altre parole, esegui su GPU i passaggi di preprocessing, training e inferenza prima di riportare i risultati nella memoria dell’host. Non mescolare i passaggi facendo preprocessing su CPU e poi inferenza su GPU.
Inoltre, per massimizzare l’efficienza, dovresti considerare CUDA-X, una raccolta di librerie accelerate da GPU sviluppate da NVIDIA. Per le random forest, ad esempio, potresti usare la forest inference library di cuML invece di quella di scikit-learn.
Quello che sta facendo il team RAPIDS AI è complesso, quindi qualche problema ci sarà. Per fortuna, la documentazione delle limitazioni note è ben curata. Non voglio necessariamente elencare qui tutte o anche solo alcune limitazioni, perché molti problemi sono piuttosto specifici dei singoli algoritmi. Inoltre, gli aggiornamenti e le patch si susseguono rapidamente. Preferisco darti le categorie generali di aspetti da considerare.
Ci sono alcune restrizioni che si applicano all’intero cuML, non solo a specifici algoritmi. Qui rientrano, ad esempio, vincoli sui formati di input dei dati (qualche problema con le liste Python), compatibilità tra versioni e gestione della memoria.
Ci sono vincoli unici per singoli algoritmi di machine learning. Queste differenze possono influenzare il modo in cui i modelli sono addestrati, il comportamento dei parametri o come vengono calcolati i risultati. Per esempio, l’algoritmo random forest in cuML usa un metodo diverso per la scelta delle soglie di split, portando a strutture degli alberi leggermente diverse.
Ci sono differenze nei parametri, nei solver e nei metodi di inizializzazione supportati. Ad esempio, PCA supporta i solver SVD "full" e "auto", ma non "randomized". E KNN supporta le metriche di Minkowski, ma non la Mahalanobis.
Talvolta i risultati possono differire leggermente a causa del parallelismo o di differenze nei solver. L’ho già menzionato. Ad esempio, le embedding UMAP potrebbero non essere identiche, ma il punteggio di trustworthiness dovrebbe restare alto. In altri casi, i segni delle componenti PCA possono invertirsi, richiedendo la normalizzazione. Anche qui si tratta di aspetti specifici: fai riferimento alla documentazione aggiornata quando esegui un algoritmo particolare.
Sono entusiasta della prospettiva di un’accelerazione GPU facilissima da usare per gli algoritmi più noti nelle librerie Python più comuni per il machine learning. Farà una grande differenza sull’accuratezza dei modelli, ed è comoda e non difficile da implementare.
Resta aggiornato sulle ultime novità del machine learning. Segui il nostro career track Machine Learning Scientist in Python per familiarizzare con le tecniche giuste. Così potrai sfruttare al meglio i progressi più recenti. Inoltre, iscriviti al nostro podcast DataFramed. Abbiamo anche un’episodio con Jean-Francois Puget, Distinguished Engineer presso NVIDIA & Chris Deotte, Senior Data Scientist presso NVIDIA, che discutono, tra le altre cose, dell’impatto dell’accelerazione GPU.
Impara Python e scikit-learn con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



