

Corso
Lavorare con Llama 3
2 ore
15.7K
Pratica and corso your progress.
Continua Con GoogleMeta ha appena annunciato la suite di modelli Llama 4, che include due modelli già rilasciati—Llama 4 Scout e Llama 4 Maverick—e un terzo ancora in addestramento: Llama 4 Behemoth.
Le varianti Scout e Maverick sono disponibili ora, rilasciate apertamente sotto la tipica licenza open-weight di Meta—con un’importante clausola: se i tuoi servizi superano i 700 milioni di utenti attivi mensili, devi ottenere una licenza separata da Meta, che può concederla o meno a sua discrezione.
Llama Scout supporta una finestra di contesto da 10 milioni di token, la più ampia tra tutti i modelli pubblicamente rilasciati. Llama Maverick è un modello generalista e punta a competere con GPT-4o, Gemini 2.0 Flash e DeepSeek-V3. Llama Behemoth, ancora in addestramento, funge da modello insegnante ad alta capacità.
In questo blog introduttivo ti darò una panoramica della suite Llama 4. Il nostro team ha già testato il modello e ti consiglio questi tutorial se vuoi approfondire:
Aggiornamento: Dopo circa un anno di silenzio, Meta ha rilasciato il suo nuovo LLM. Per una panoramica, dai un’occhiata alla nostra guida su Muse Spark.
Teniamo aggiornati i nostri lettori sulle ultime novità in ambito AI con The Median, la nostra newsletter gratuita del venerdì che riassume le notizie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
Llama 4 è la nuova famiglia di modelli linguistici di grandi dimensioni di Meta. Il rilascio include due modelli già disponibili—Llama 4 Scout e Llama 4 Maverick—e un terzo, Llama 4 Behemoth, ancora in addestramento.
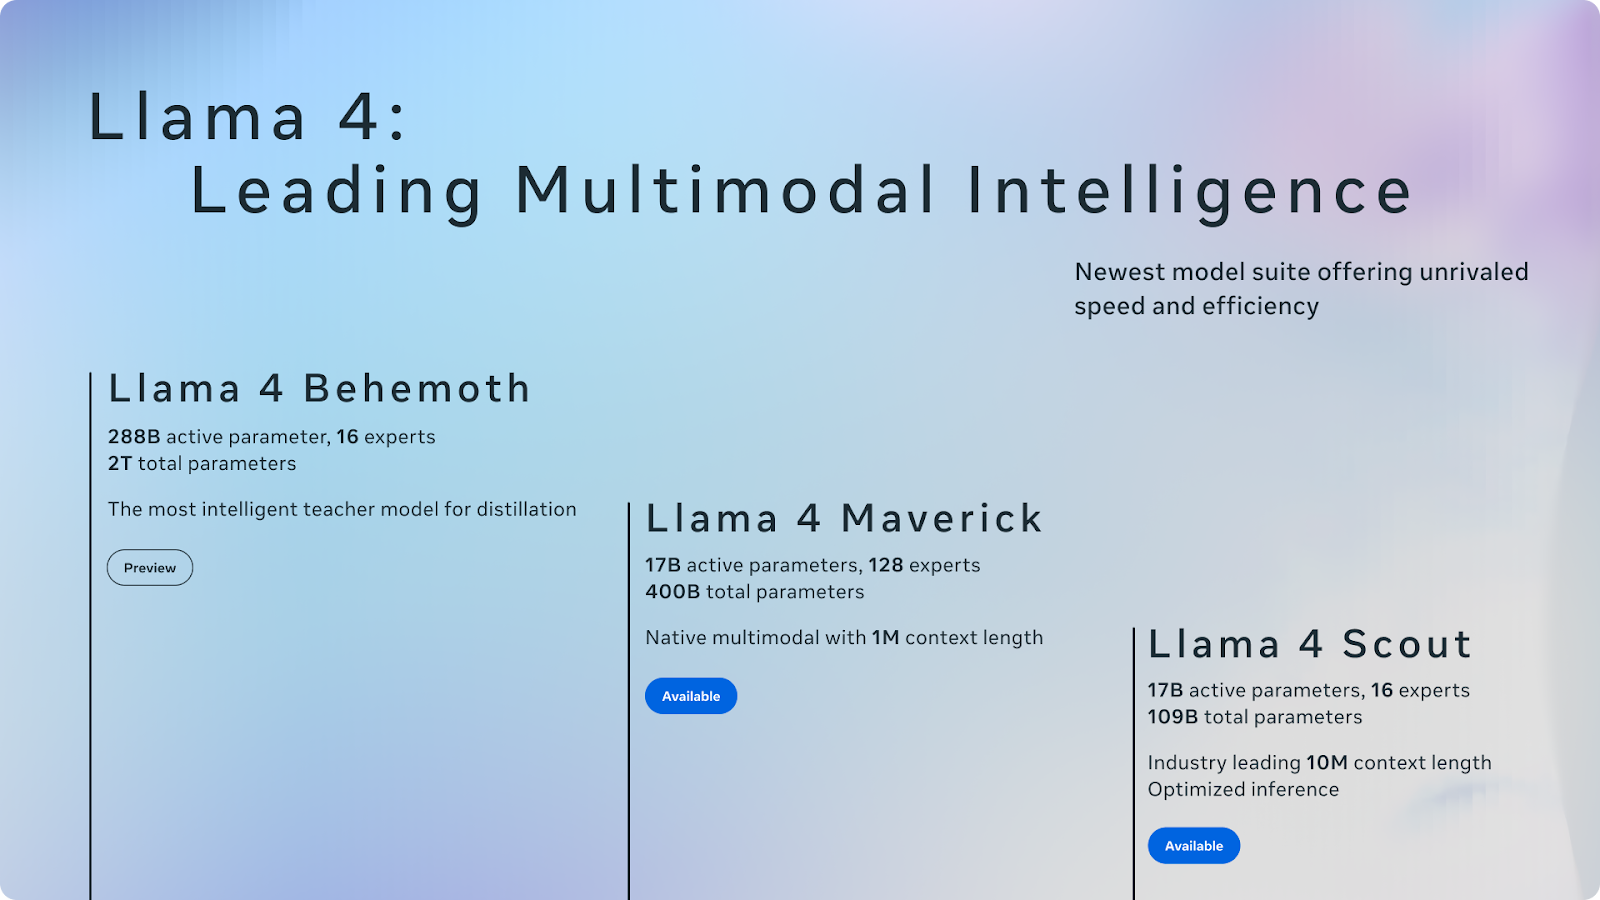
Fonte: Meta AI
Llama 4 introduce miglioramenti sostanziali. In particolare, incorpora un’architettura a mixture-of-experts (MoE), pensata per migliorare efficienza e prestazioni attivando solo i componenti necessari per compiti specifici (ne parleremo tra poco). Questo design rappresenta un passaggio verso modelli di AI più scalabili e specializzati.
Llama 4 prosegue la strategia di Meta di rilasciare modelli open-weight—ma con una clausola. Se la tua azienda gestisce servizi con più di 700 milioni di utenti attivi mensili, dovrai ottenere una licenza separata da Meta, che potrebbe essere concessa o meno. A parte questo limite, il rilascio sembra comunque un evento importante nello spazio open-weight, anche se il panorama è cambiato rapidamente negli ultimi mesi.
Se Llama 2 e 3 hanno definito la categoria, Llama 4 entra ora in un campo molto più competitivo. DeepSeek è arrivato con forti capacità di ragionamento. La serie Qwen di Alibaba ha ottenuto buoni risultati su benchmark multilingue e di coding. I modelli Gemma di Google si stanno spingendo nello stesso spazio con architetture più piccole ed efficienti. E pochi giorni fa, OpenAI ha annunciato l’intenzione di rilasciare un modello open-weight, una svolta che un anno fa sarebbe sembrata improbabile.
Vediamo più nel dettaglio ciascun modello.
Llama 4 Scout è il modello più leggero della nuova suite, ma probabilmente è il più interessante. Funziona su una singola GPU H100 e supporta una finestra di contesto da 10 milioni di token. Questo rende Scout il modello open-weight più affamato di contesto rilasciato finora e potenzialmente il più utile per attività come il riassunto multi-documento, il ragionamento su codice di lunga durata e l’analisi di attività.
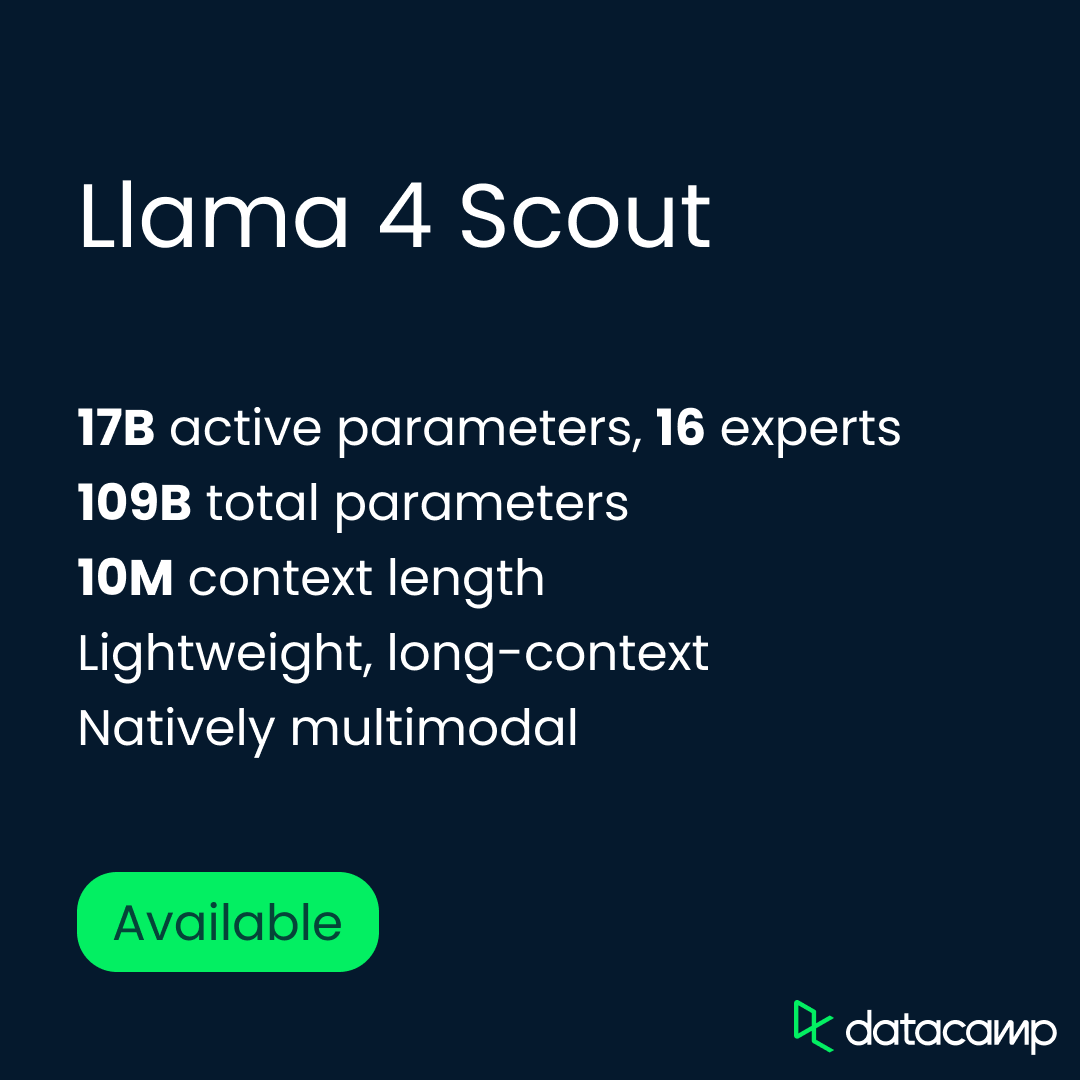
Scout ha 17 miliardi di parametri attivi, organizzati tramite 16 expert, per un totale di 109 miliardi di parametri. È stato pre-addestrato e post-addestrato con una finestra di contesto da 256K, ma Meta afferma che generalizza bene anche molto oltre (affermazione da verificare). In pratica, apre la strada a flussi di lavoro che coinvolgono interi codebase, cronologie di sessione o documenti legali—il tutto elaborato in una singola forward pass.
A livello architetturale, Scout è costruito usando il framework mixture-of-experts (MoE) di Meta, in cui solo un sottoinsieme di parametri si attiva per token—al contrario dei modelli densi come GPT-4o, dove si attivano tutti i parametri. Questo significa che è sia efficiente in termini di calcolo sia altamente scalabile.
Oltre all’architettura di base, Meta ha sottolineato le capacità multimodali di Scout. È stato pre-addestrato su dati di testo, immagini e video usando l’early fusion, che gli consente di gestire nativamente combinazioni di prompt testuali e visivi. In compiti ricchi di immagini come visual grounding e VQA (visual question answering), Scout va meglio di qualsiasi precedente modello Llama—e tiene testa a sistemi molto più grandi.
In breve, Scout è costruito per ampiezza e scala. È progettato per girare in modo efficiente, gestire più input di qualsiasi precedente modello open e lavorare bene sia su compiti testuali che di immagine. Metteremo presto alla prova quel limite di 10M di contesto—e ti aggiorneremo.
Llama 4 Maverick è il generalista della linea—un modello multimodale a piena scala pensato per offrire prestazioni in chat, ragionamento, comprensione di immagini e codice. Mentre Scout spinge al limite la lunghezza del contesto, Maverick punta su output bilanciati e di alta qualità in tutti i compiti. È la risposta di Meta a GPT-4o, DeepSeek-V3 e Gemini 2.0 Flash.
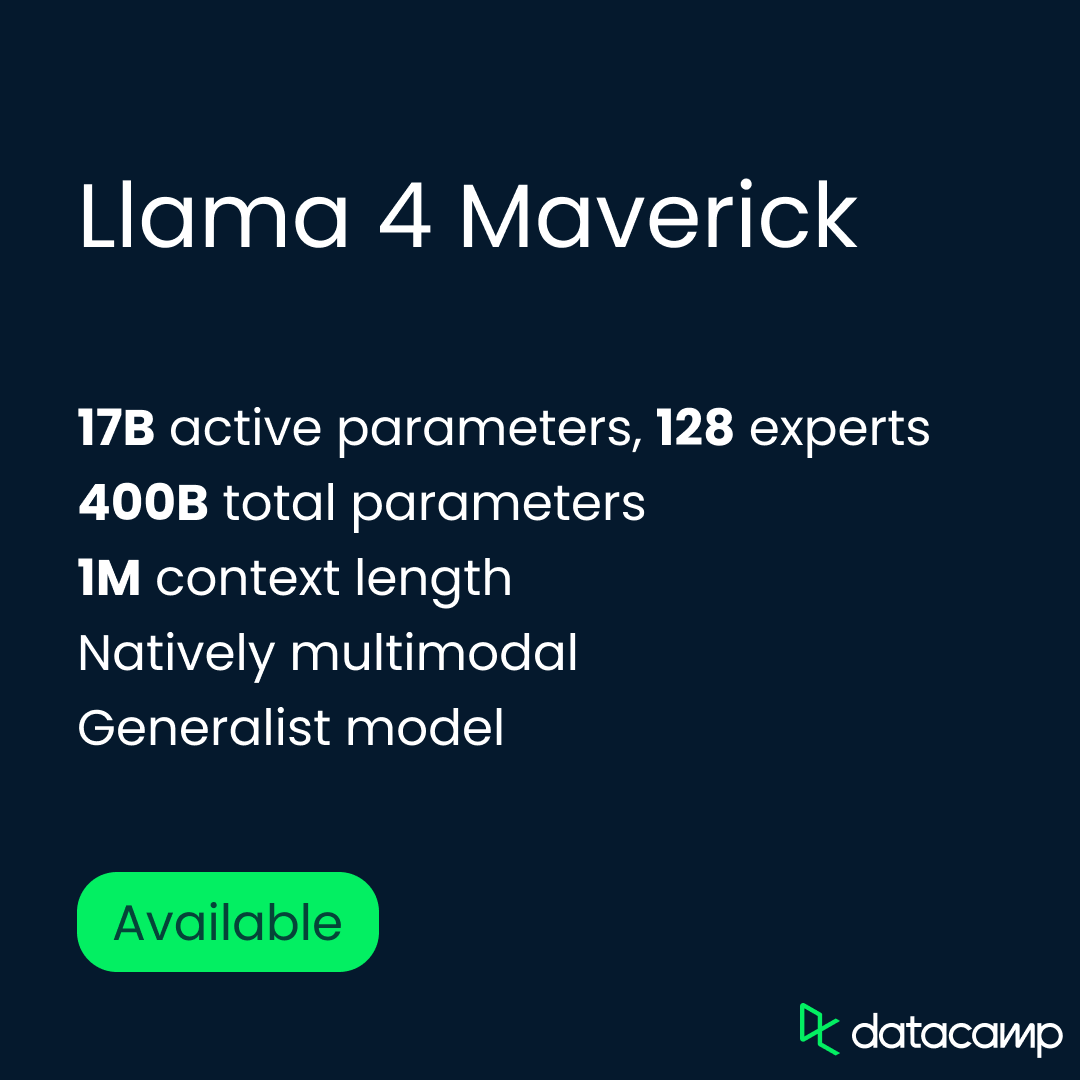
Maverick ha gli stessi 17 miliardi di parametri attivi di Scout, ma con una configurazione MoE più ampia: 128 expert e un totale di 400 miliardi di parametri. Come Scout, usa un’architettura mixture-of-experts, che attiva solo parte del modello per token—riducendo i costi di inferenza mentre aumenta la capacità. Il modello gira su un singolo host H100 DGX, ma può anche essere distribuito con inferenza distribuita per applicazioni su più larga scala.
Meta ha adottato un approccio diverso al post-addestramento, usando un mix di fine-tuning supervisionato leggero, reinforcement learning online e direct preference optimization. L’obiettivo era affinare le prestazioni su prompt difficili senza irrigidire troppo il modello. A tal fine, Meta ha filtrato oltre il 50% degli esempi di training etichettati come “facili” dai precedenti modelli Llama e ha costruito un curriculum che enfatizzasse compiti più impegnativi di ragionamento, coding e multimodali.
Maverick è stato anche co-distillato da Llama 4 Behemoth, il modello interno di Meta molto più grande, che ha contribuito a incrementare le prestazioni senza aggiungere costi di addestramento. Secondo Meta, questa pipeline di distillazione ha prodotto un netto salto nella qualità del ragionamento e della chat.
Llama 4 Behemoth è il modello più potente e grande di Meta fino ad oggi—ma non è ancora disponibile. Ancora in addestramento, Behemoth non è un modello di ragionamento nello stesso senso di DeepSeek-R1 o o3 di OpenAI, che sono costruiti e ottimizzati per compiti multi-step con chain-of-thought.
In base a quanto sappiamo finora, non sembra nemmeno progettato come prodotto per l’uso diretto. Piuttosto, agisce come modello insegnante, usato per distillare e plasmare sia Scout che Maverick. Una volta rilasciato, potrebbe consentire anche ad altri di distillare i propri modelli.
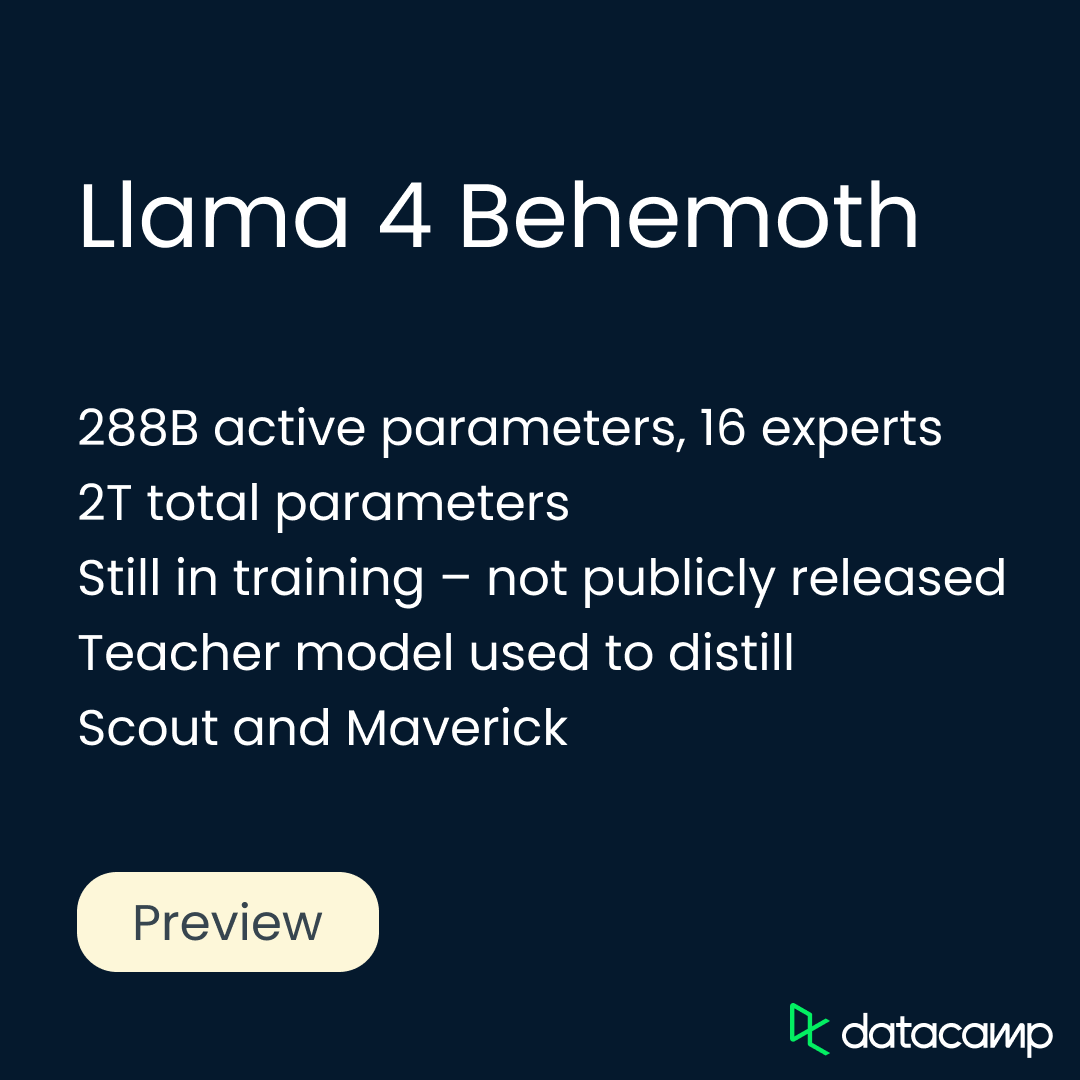
Behemoth ha 288 miliardi di parametri attivi, organizzati tramite 16 expert, con un conteggio totale vicino ai 2 trilioni di parametri. Meta ha costruito un’infrastruttura di training completamente nuova per supportare Behemoth a questa scala. Ha introdotto reinforcement learning asincrono, campionamento del curriculum basato sulla difficoltà dei prompt e una nuova funzione di perdita per la distillazione che bilancia dinamicamente target soft e hard.
Anche il post-addestramento di Behemoth ha richiesto una ricetta diversa. Meta ha scartato oltre il 95% degli esempi SFT per concentrarsi su prompt difficili e ha focalizzato il reinforcement learning su ragionamento complesso, coding e scenari multilingue. Il campionamento da istruzioni di sistema variegate ha aiutato il modello a generalizzare, mentre il filtraggio dinamico ha rimosso i prompt a basso valore durante l’RL training.
Meta ha pubblicato risultati di benchmark interni per ciascuno dei modelli Llama 4, confrontandoli sia con le precedenti varianti Llama sia con diversi modelli open-weight concorrenti e di frontiera.
In questa sezione ti guiderò attraverso i punti salienti dei benchmark per Scout, Maverick e Behemoth, usando i numeri di Meta. Come sempre, invito alla cautela con i benchmark auto-riportati—ma questi punteggi offrono un primo sguardo utile su come ciascun modello si comporta in diversi compiti e dove si colloca nell’attuale panorama. Partiamo da Scout.
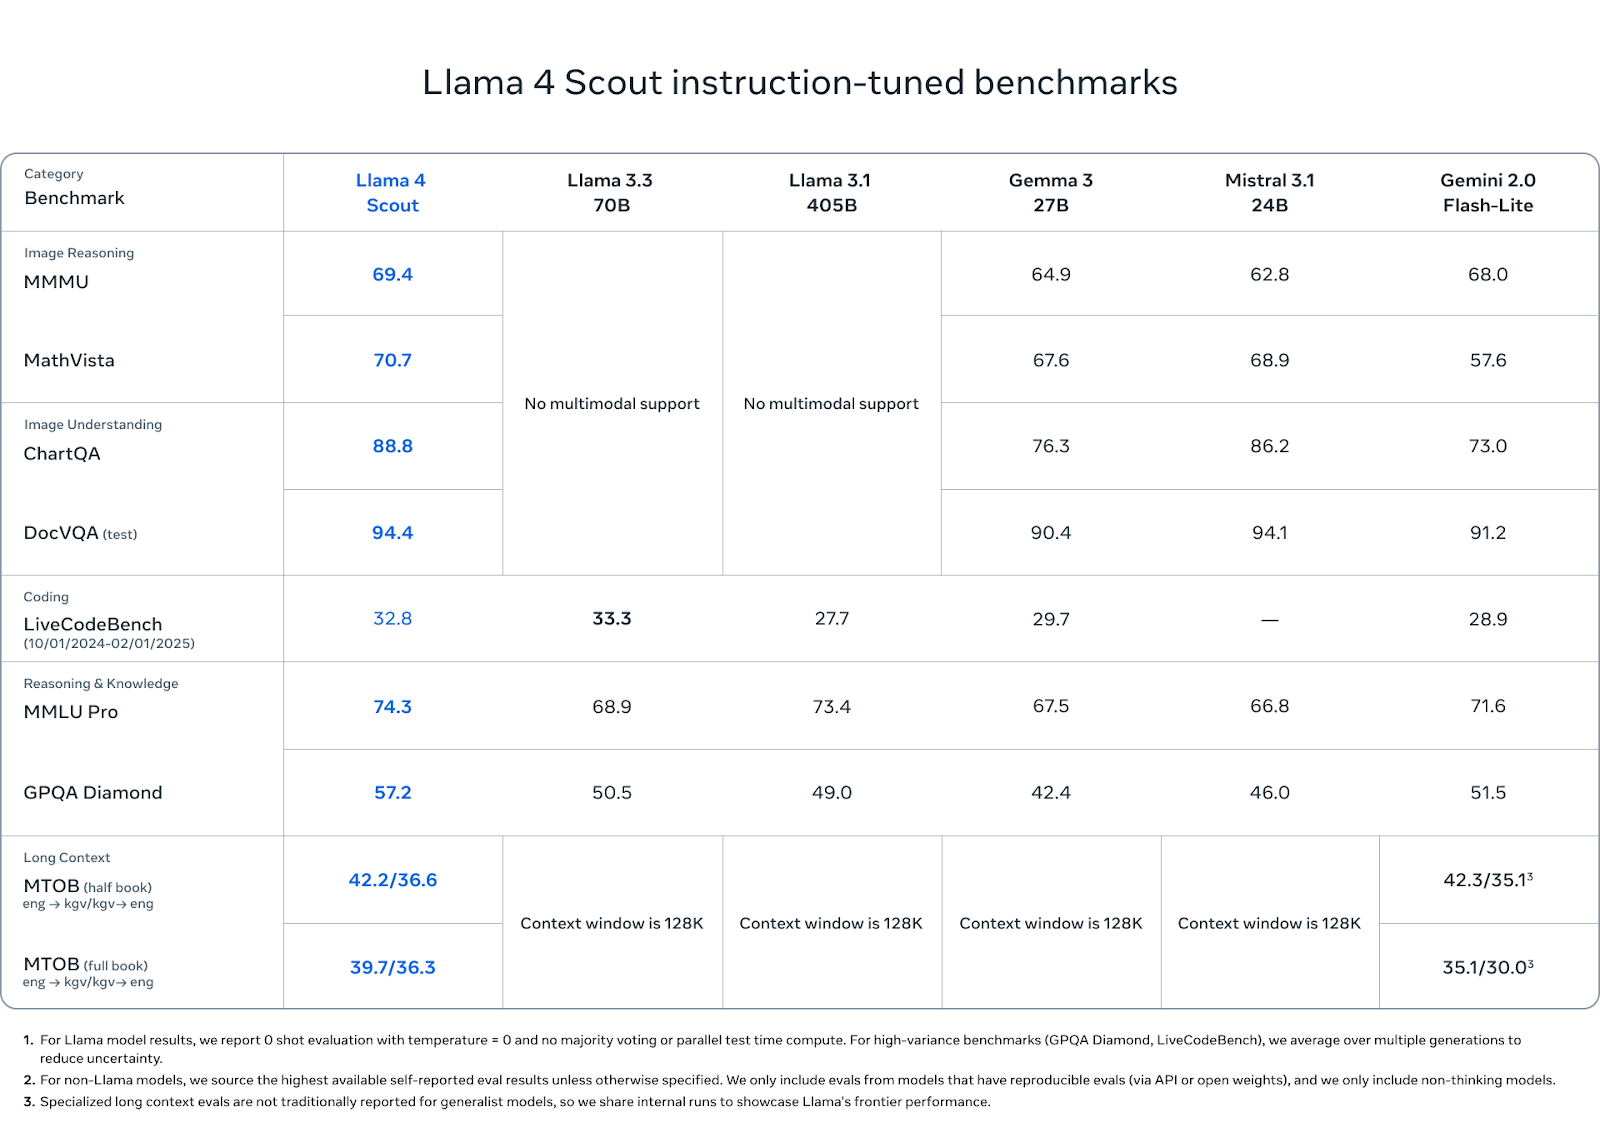
Llama 4 Scout si comporta bene su un mix di benchmark di ragionamento, coding e multimodali—soprattutto considerando il suo minor numero di parametri attivi e l’impronta su una singola GPU.
Fonte: MetaAI
Nella comprensione delle immagini, Scout supera i concorrenti: segna 88,8 su ChartQA e 94,4 su DocVQA (test), meglio di Gemini 2.0 Flash-Lite (73,0 e 91,2 rispettivamente) e in linea o leggermente sopra Mistral 3.1 e Gemma 3 27B.
Nei benchmark di ragionamento visivo come MMMU (69,4) e MathVista (70,7), guida anche il gruppo open-weight, superando Gemma 3 (64,9; 67,6), Mistral 3.1 (62,8; 68,9) e Gemini Flash-Lite (68,0; 57,6).
Nel coding, Scout ottiene 32,8 su LiveCodeBench, davanti a Gemini Flash-Lite (28,9) e Gemma 3 27B (29,7), anche se leggermente dietro ai 33,3 di Llama 3.3. Non è un modello incentrato sul coding, ma si difende bene.
Su conoscenza e ragionamento, Scout raggiunge 74,3 su MMLU Pro e 57,2 su GPQA Diamond, superando qualsiasi altro modello open-weight in entrambi. Questi benchmark favoriscono il ragionamento multi-step di lungo periodo, quindi le buone prestazioni di Scout qui sono notevoli, soprattutto a questa scala.
Infine, le capacità di lungo contesto di Scout mostrano un potenziale reale. Su MTOB (Massive Textual Overlap Benchmark), che testa la capacità del modello di tradurre tra inglese e KGV, una lingua a basse risorse, ottiene 42,2/36,6 nel test half-book e 39,7/36,3 nel test full-book. Nel test half-book, Gemini 2.0 Flash-Lite lo supera di poco con 42,3, ma Scout colma il divario nel full-book, superando i 35,1/30,0 di Gemini.
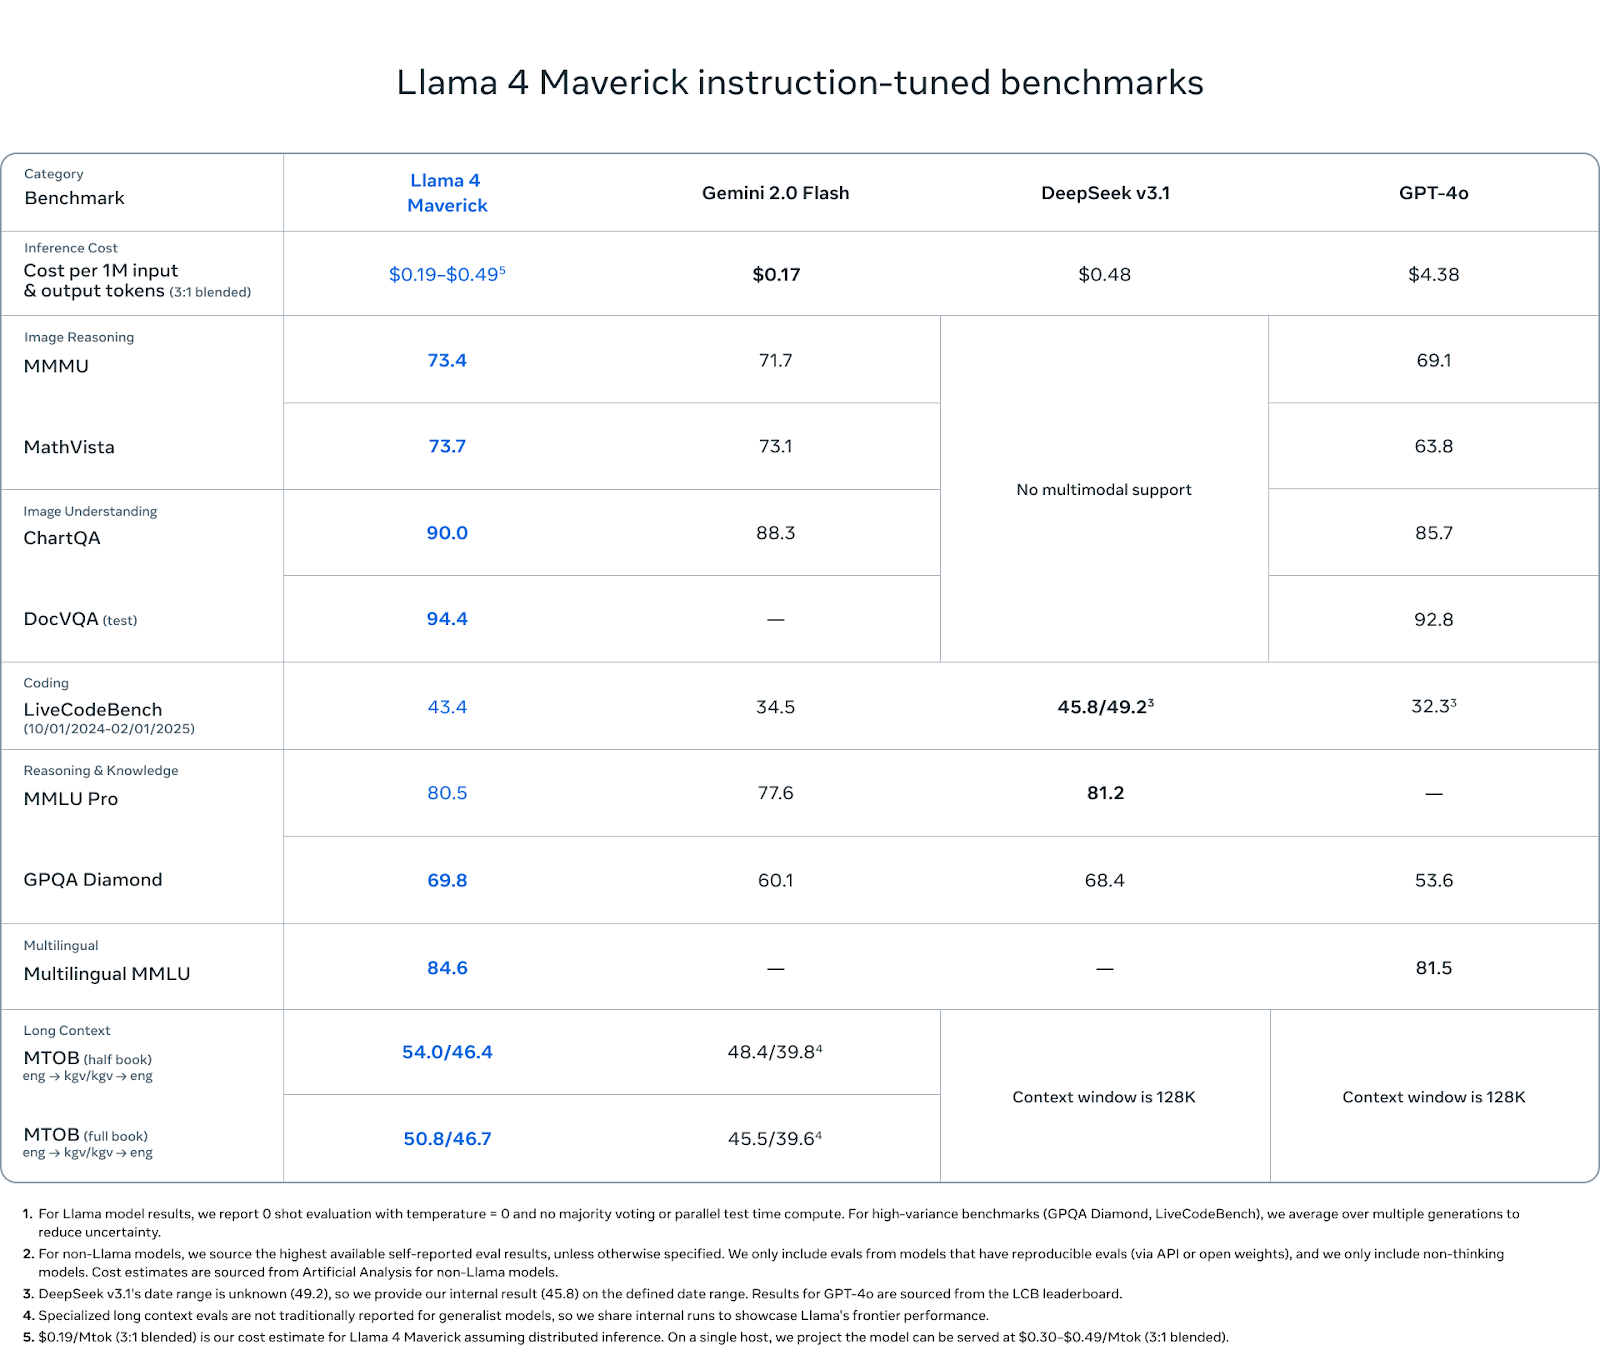
Maverick è il modello più equilibrato della linea Llama 4—e i risultati dei benchmark lo confermano. Pur non puntando agli estremi della lunghezza del contesto di Scout o alla scala bruta di Behemoth, si comporta in modo costante in tutte le categorie che contano: ragionamento multimodale, coding, comprensione linguistica e mantenimento del lungo contesto.
Fonte: MetaAI
Nel ragionamento su immagini, Maverick ottiene 73,4 su MMMU e 73,7 su MathVista, superando Gemini 2.0 Flash (71,7 e 73,1) e GPT-4o (69,1 e 63,8). Su ChartQA (comprensione di immagini) segna 90,0, leggermente sopra gli 88,3 di Gemini e ben sopra gli 85,7 di GPT-4o. In DocVQA, Maverick arriva a 94,4, come Scout, e supera i 92,8 di GPT-4o.
Nel coding, Maverick ottiene 43,4 su LiveCodeBench, sopra GPT-4o (32,3), Gemini Flash (34,5) e vicino ai 45,8 di DeepSeek v3.1.
Su ragionamento e conoscenza, Maverick ottiene 80,5 su MMLU Pro e 69,8 su GPQA Diamond, superando ancora Gemini Flash (77,6 e 60,1) e GPT-4o (nessun MMLU Pro riportato, 53,6 su GPQA). DeepSeek v3.1 lo precede di 0,7 su MMLU Pro.
Maverick va bene anche nella comprensione multilingue, con 84,6 su Multilingual MMLU, leggermente sopra gli 81,5 di Gemini. Questo gli dà un vantaggio per gli sviluppatori che lavorano su più lingue o aree geografiche.
Nelle valutazioni di lungo contesto (MTOB), Maverick ottiene 54,0/46,4 nel test half-book e 50,8/46,7 nel full-book—significativamente avanti rispetto ai 48,4/39,8 e 45,5/39,6 di Gemini, rispettivamente. Questi punteggi suggeriscono che, pur non pubblicizzando la sua lunghezza di contesto quanto Scout, beneficia comunque in modo significativo della sua finestra estesa.
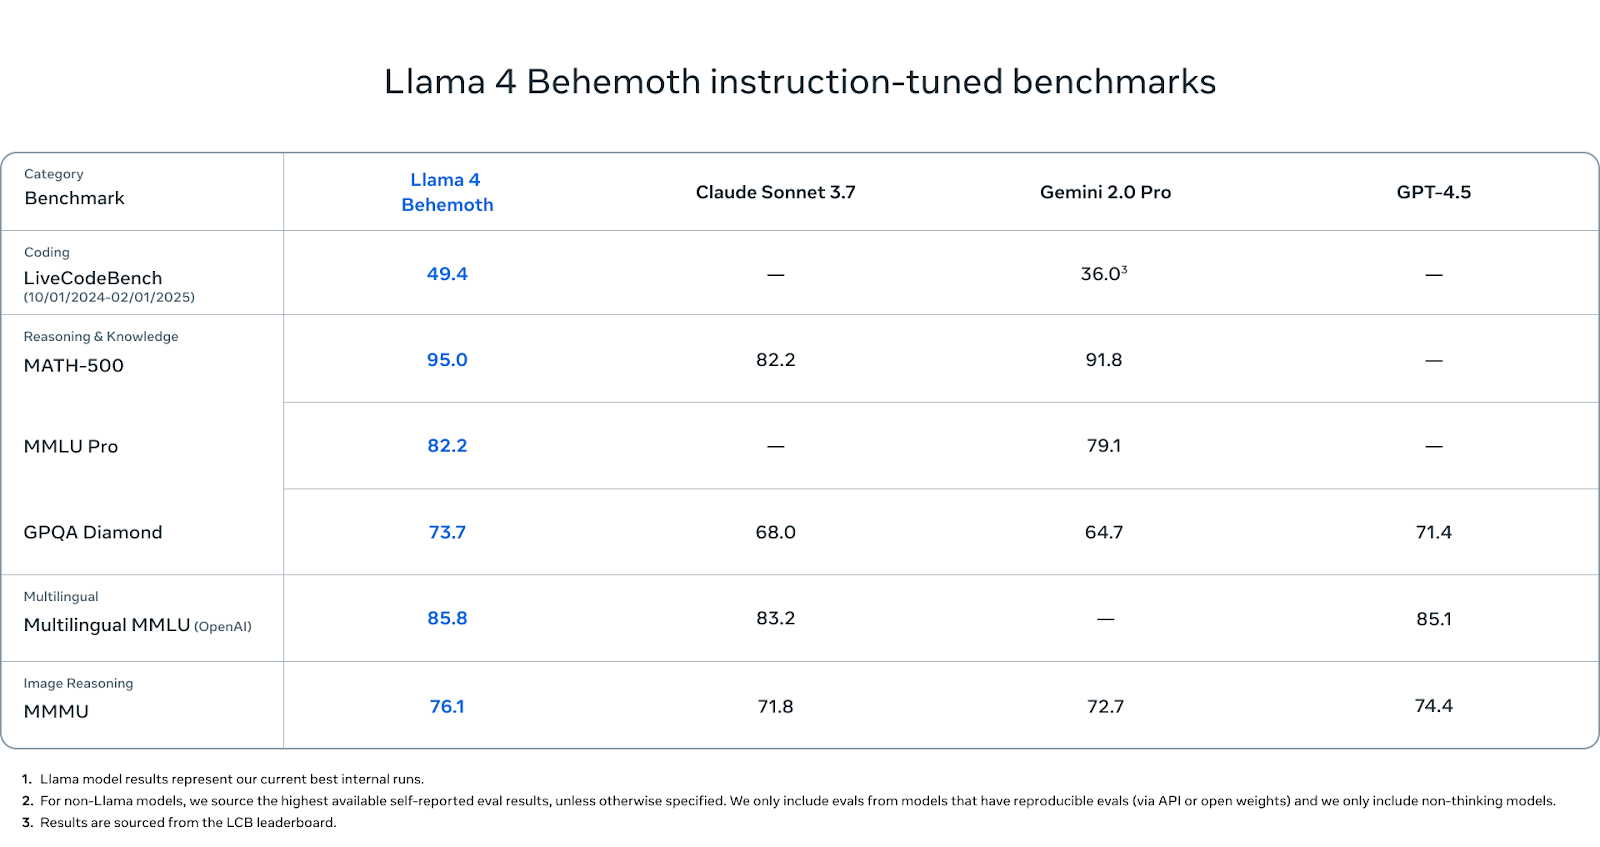
Behemoth non è ancora stato rilasciato, ma i suoi numeri nei benchmark meritano attenzione.
Fonte: MetaAI
Sui benchmark ad alto contenuto STEM, Behemoth si comporta eccezionalmente bene. Ottiene 95,0 su MATH-500—più alto di Gemini 2.0 Pro (91,8) e significativamente sopra Claude Sonnet 3.7 (82,2). Su MMLU Pro, Behemoth segna 82,2, mentre Gemini Pro arriva a 79,1 (Claude non ha un punteggio riportato). E su GPQA Diamond, un altro benchmark che premia profondità e precisione fattuale, Behemoth raggiunge 73,7, davanti a Claude (68,0), Gemini (64,7) e GPT-4.5 (71,4).
Nella comprensione multilingue, Behemoth ottiene 85,8 su Multilingual MMLU, leggermente sopra Claude Sonnet (83,2) e GPT-4.5 (85,1). Questi punteggi contano per gli sviluppatori globali che lavorano al di fuori dell’inglese, e Behemoth al momento guida questa categoria.
Nel ragionamento su immagini, Behemoth arriva a 76,1 su MMMU, superando Gemini (71,8), Claude (72,7) e GPT-4.5 (74,4). Pur non essendo il suo focus principale, si comporta comunque in modo competitivo con i principali modelli multimodali.
Nella generazione di codice, Behemoth ottiene 49,4 su LiveCodeBench. Un risultato ben al di sopra di Gemini 2.0 Pro (36,0).
Sia Llama 4 Scout che Llama 4 Maverick sono disponibili ora con la licenza open-weight di Meta. Puoi scaricarli direttamente dal sito di Llama ufficiale o tramite Hugging Face.
Per accedere ai modelli tramite i servizi di Meta, puoi interagire con Meta AI su diverse piattaforme: WhatsApp, Messenger, Instagram e Facebook. L’accesso al momento richiede l’accesso con un account Meta e non esiste un endpoint API standalone per Meta AI—almeno per ora.
Se stai pianificando di integrare i modelli nelle tue applicazioni o infrastrutture, tieni a mente la clausola di licenza: se il tuo prodotto o servizio supera i 700 milioni di utenti attivi mensili, dovrai ottenere un permesso separato da Meta. I modelli sono altrimenti utilizzabili per ricerca, sperimentazione e per la maggior parte dei casi d’uso commerciali.
Scout introduce una lunghezza di contesto senza precedenti su una singola GPU. Maverick tiene testa a modelli più grandi in ragionamento, codice e compiti multimodali. E Behemoth, ancora in addestramento, offre uno sguardo su come i modelli insegnanti possano plasmare varianti più efficienti e distribuibili.
Lo spazio open-weight è più competitivo che mai. DeepSeek, Qwen, Gemma e presto anche OpenAI stanno avanzando con rilasci solidi. Llama 4 arriva come continuazione dello sforzo di Meta di offrire modelli scalabili e apertamente disponibili per una vasta gamma di casi d’uso.
Impara l’AI con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



