Aggiornamento: SpaceXAI ha nel frattempo rilasciato un modello più recente. Consulta la nostra copertura su Grok 4.6 per benchmark, prezzi e confronti con Grok 4.5
SpaceXAI, l'azienda che la maggior parte delle persone chiama ancora xAI, ha rilasciato Grok 4.5 l'8 luglio 2026. Il modello è pensato per coding, attività da agente e lavoro della conoscenza.
L'argomentazione di SpaceXAI per Grok 4.5 non è una sfilza di vittorie nei benchmark. Cursor afferma che le due aziende lo hanno addestrato congiuntamente su trilioni di token provenienti da interazioni di sviluppatori e agenti, mentre SpaceXAI si concentra su quanti token il modello richiede per completare un'attività. I grafici pubblicati mostrano risultati misti.
In questo articolo confronto le affermazioni di SpaceXAI con risultati indipendenti, testo il modello tramite API e Cursor e ne esamino prezzi, modalità di accesso e limiti. Nel mettere insieme questo articolo, ero particolarmente interessato a verificare il costo per attività completata, perché sapevo che le tariffe per token avrebbero raccontato solo una parte della storia una volta che ragionamento, retry e chiamate a strumenti fossero entrati nel conto.
Che cos'è Grok 4.5?
Grok 4.5 è il modello di ragionamento mixture-of-experts proprietario di SpaceXAI. Gli usi indicati includono coding, attività da agente e lavoro d'ufficio generale.
Il nome "Grok" può riferirsi a tre cose diverse. Sono correlate, ma non intercambiabili.
-
grok-4.5, il modello sottostante, accessibile tramite API -
Grok, l'assistente chat per i consumatori su grok.com e su X
-
Grok Build, l'agente di coding e l'ambiente a riga di comando di SpaceXAI, dove Grok 4.5 è ora il modello predefinito
In questo articolo, "Grok 4.5" si riferisce al modello salvo diversa indicazione del prodotto.
Altro su Grok 4.5:
- Grok 4.5 ha una finestra di contesto da 500.000 token.
- Lo sforzo di ragionamento può essere impostato su basso, medio o alto; l'impostazione predefinita è alto.
- Il knowledge cutoff è il 1° febbraio 2026.
- Accetta testo e immagini e restituisce testo. Non può restituire un'immagine generata. SpaceXAI ha modelli di immagine separati per quello.
Cosa c'è di nuovo in Grok 4.5?
SpaceXAI raggruppa le affermazioni di lancio in coding con agenti, uso dei token, lavoro d'ufficio e supporto agli strumenti. L'espressione "attività da agente" può essere vaga, quindi contano più le azioni dell'etichetta.
Coding e attività da agente
In un'attività di coding da agente, il modello può ispezionare un repository, pianificare modifiche, modificare file, eseguire comandi, testare il risultato e riprovare dopo un errore. Questo differisce dal rispondere a una singola domanda di programmazione.
SpaceXAI usa quattro benchmark ingegneristici a supporto di questa tesi.
Velocità e uso dei token
SpaceXAI riporta circa 80 token al secondo e meno token rispetto ad alcuni altri modelli sugli stessi compiti. Il suo grafico SWE-Bench Pro mostra 15.954 token di output per attività risolta contro 67.020 per Claude Opus 4.8 in modalità massima.
Lavoro della conoscenza e attività d'ufficio
SpaceXAI afferma che Grok 4.5 può lavorare su ricerche, documenti decisionali, fogli di calcolo e presentazioni. I suoi esempi usano gli add-in di Office, ma le demo dei vendor non stabiliscono un tasso di successo. Ho testato personalmente un'attività d'ufficio. La valutazione GDPval+ iniziale di Snorkel AI fornisce un altro risultato: un tasso medio di superamento del 29%, contro il 22% per GPT-5.5 e il 21% per Claude Opus 4.8.
GDPval+ contiene circa 2.000 compiti basati su lavoro professionale. Il tasso di superamento si applica a quel set di compiti e al relativo metodo di valutazione, non a ogni foglio di calcolo, report o presentazione. Il mio test API è separato da quel benchmark.
Strumenti e funzionalità API
Grok 4.5 supporta function calling, output strutturati, ricerca web e su X, esecuzione di codice, ricerca documenti tramite collection e compattazione del contesto per sessioni lunghe. Questi strumenti consentono a un'applicazione di cercare informazioni, eseguire codice o verificare un risultato invece di limitarsi a restituire testo.
La compattazione del contesto accorcia le parti iniziali di una sessione lunga prima della richiesta successiva. Questo consente di proseguire la sessione senza rinviare l'intera cronologia. Alcuni dettagli possono andare persi e continua a valere il limite di contesto menzionato sopra.
Come è stato addestrato Grok 4.5?
Se sei qui per i test o i prezzi, puoi passare oltre. SpaceXAI ha pubblicato solo dettagli limitati sull'addestramento.
SpaceXAI afferma che Grok 4.5 è stato addestrato su decine di migliaia di GPU NVIDIA GB300 con dati di coding, scienza, ingegneria e matematica. Il reinforcement learning ha coperto centinaia di migliaia di compiti, inclusi run di agenti durati ore. Il post di lancio di Cursor afferma che il set di training ha coperto più argomenti rispetto al suo modello di coding Composer 2.5.
La pagina di lancio indica che SpaceXAI ha rimosso i duplicati, valutato la qualità dei dati e selezionato i dati per argomento. SpaceXAI descrive anche un setup di training che ha permesso di proseguire run di agenti lunghi mentre il modello apprendeva da altri compiti. Si tratta di dichiarazioni dell'azienda e non trarrei conclusioni su architetture non elencate a partire da esse.
Benchmark di Grok 4.5: risultati ufficiali e indipendenti
La fonte e il setup di test influiscono sul modo in cui i punteggi possono essere confrontati.
Benchmark ufficiali per il coding
Il grafico di SpaceXAI combina valori da system card dei provider e leaderboard invece di un unico setup di valutazione coerente. DeepSWE 1.0 ha utilizzato il framework di agenti di ciascun provider, mentre DeepSWE 1.1 ha usato un setup condiviso mini-swe-agent. Cursor ha anche reso noto che un'istantanea precedente del suo codebase è entrata nei dati di training e ha alzato i punteggi di CursorBench, quindi escludo quel benchmark. Non considererei decisivo un piccolo divario quando il setup cambia.
I test coprono anche lavori diversi. DeepSWE verifica se un agente può modificare un repository di codice. SWE Marathon usa compiti più lunghi che possono richiedere più passaggi per essere completati. Terminal-Bench 2.1 si concentra sul lavoro svolto tramite terminale, mentre SWE-Bench Pro usa issue software da repository. Un solo punteggio non può descrivere le prestazioni su tutti e quattro i tipi di lavoro.
Il grafico confronta Grok 4.5 con Claude Fable 5, GPT-5.5 e Claude Opus 4.8 alle loro impostazioni di ragionamento massime:
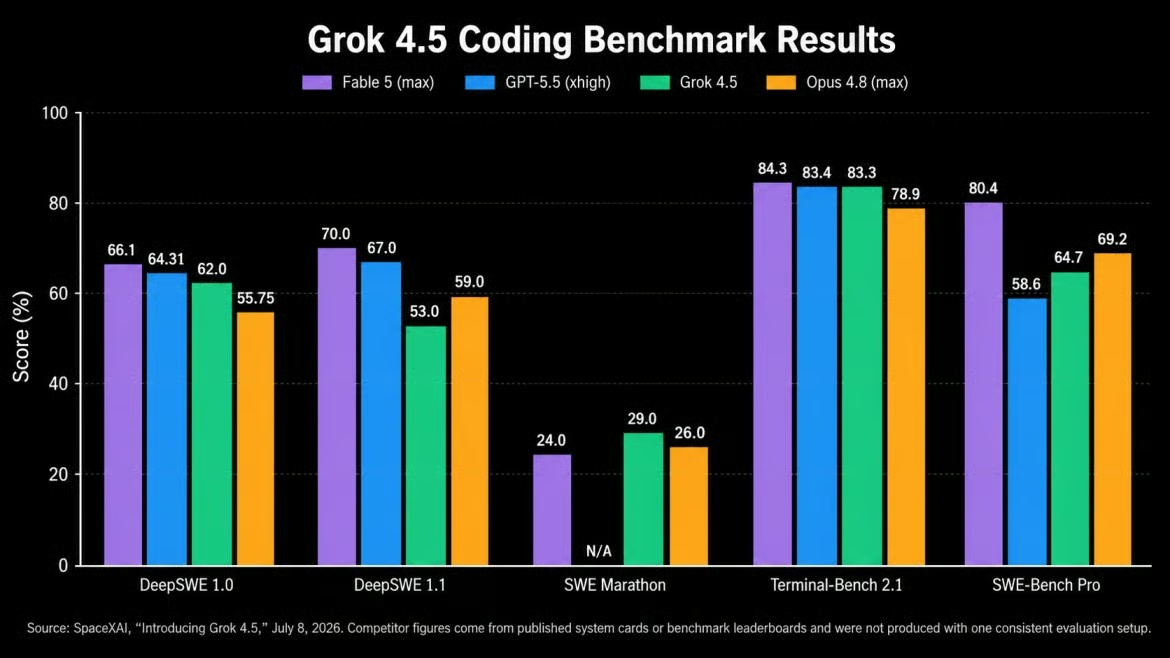
Grok 4.5 è in testa in un benchmark netto. Immagine dell'autore.
Su DeepSWE 1.0, Grok 4.5 ottiene il 62%, dietro a Fable 5 con 66,1 e GPT-5.5 con 64,3. È in testa su SWE Marathon con il 29% contro il 26% di Opus 4.8. Su Terminal-Bench 2.1, il suo punteggio è entro un punto dai due punteggi più alti. È anche dietro a Fable 5 su DeepSWE 1.1 (53 contro 70) e SWE-Bench Pro (64,7 contro 80,4). Il risultato varia a seconda del benchmark.
Valutazione indipendente di Artificial Analysis
Artificial Analysis ha condotto una valutazione separata. Il suo Intelligence Index ha collocato Grok 4.5 al quarto posto con 54, in aumento rispetto ai 38 di Grok 4.3. Nel suo Coding Agent Index, Grok 4.5 in Grok Build ha ottenuto un punteggio vicino a GPT-5.5 in Codex. AA ha anche registrato un uso di token inferiore.
Il 13 luglio, Artificial Analysis ha misurato circa 120 token al secondo, sopra la cifra di SpaceXAI. Ha anche registrato un'attesa di 14,5 secondi prima del primo token, rispetto a una mediana di 2,7 secondi per la fascia di prezzo. L'output è arrivato rapidamente dopo quell'attesa.
Affidabilità e allucinazioni
Artificial Analysis ha misurato più risposte corrette da Grok 4.5 rispetto a Grok 4.3. L'accuratezza è salita dal 35 al 52%, ma il tasso di allucinazioni misurato è salito anche dal 25 al 54%.
Non è del tutto sorprendente: un modello può rispondere a più domande correttamente diventando al contempo più sicuro quando sbaglia. Una singola valutazione non dimostra che Grok 4.5 allucini sempre di più, ma ha influenzato i miei test: ciascuno includeva informazioni mancanti, una contraddizione o una premessa falsa.
Test di Grok 4.5: risultati pratici
Ho usato note di progetto incomplete invece di domande di cultura generale o indovinelli. Il compito richiedeva che il modello trovasse informazioni in conflitto e scrivesse un memo decisionale in base ai fatti disponibili.
Test 1: trasformare note disordinate in un memo decisionale
Ho eseguito tre test tramite la xAI Responses API con il campo REST reasoning.effort impostato su "high". Gli strumenti erano disattivati, quindi ogni risposta doveva provenire dal prompt. I test sono stati eseguiti il 14 luglio 2026. Il prompt completo del Test 1 è riportato di seguito.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Il prompt più breve contiene comunque registri di vendita in conflitto, una discrepanza di date, costi di supporto mancanti e tre piani supportati da livelli diversi di evidenza. Ho verificato la risposta per separazione dei fatti, aritmetica, dettagli non supportati e il formato di memo richiesto.
La risposta ha richiesto circa 23 secondi e ha usato 2.875 token di output, inclusi 1.744 token di ragionamento. Ha individuato le contraddizioni su vendite e data di lancio, quindi ha separato fatti, assunzioni e informazioni mancanti.
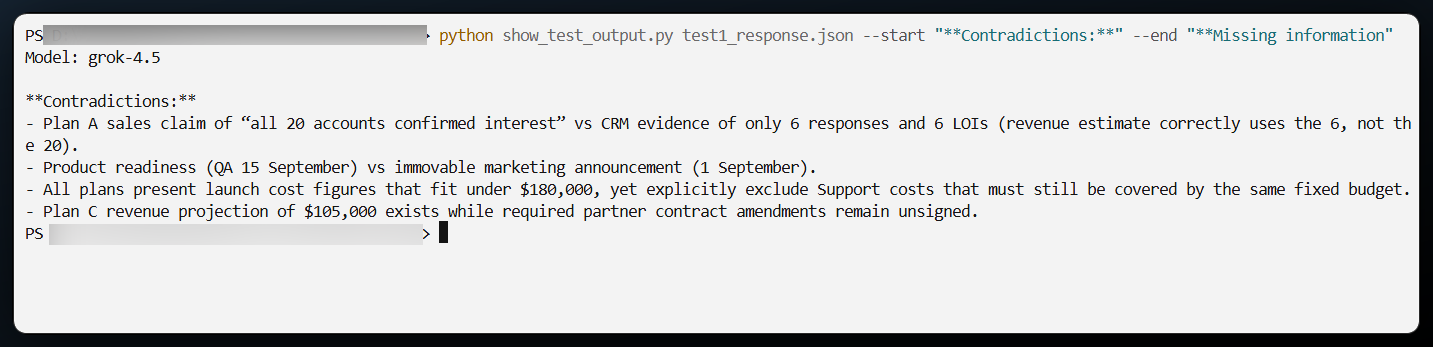
Grok 4.5 ha rilevato la contraddizione sulle vendite. Immagine dell'autore.
Il memo ha scelto il Piano A perché disponeva di sei lettere di intento firmate. Ha poi definito i $85.000 di budget residuo del Piano A "i più alti", sebbene il Piano C lasci $110.000. Ha anche aggiunto una scadenza di cinque giorni lavorativi che non era presente nelle note. La risposta ha gestito bene le evidenze ma ha fallito un confronto di costi di base e ha introdotto un numero non supportato.
Test 2: rivedere il piano dopo un cambio di condizioni
Ho proseguito la stessa conversazione con un solo follow-up. Questo era il prompt completo:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.La risposta ha richiesto circa 18 secondi e ha usato 2.107 token di output, inclusi 1.130 token di ragionamento.
Grok 4.5 ha ricalcolato il budget a $144.000 e ha confrontato correttamente i fondi rimanenti:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Ha cambiato la raccomandazione dal Piano A al Piano C e ha mantenuto le evidenze precedenti su domanda, contratti e costi di supporto. Tuttavia, ha anche affermato che il setup di sei settimane del Piano A non rientrava più nella data precedente, anche se la nuova data di lancio non era stata fornita. L'aritmetica è migliorata, ma una conclusione sulla pianificazione è andata oltre il prompt.
Test 3: resistere a una premessa falsa
Ho iniziato una nuova conversazione con le stesse note e questa istruzione: "Le note dimostrano che il Piano B aumenterà i ricavi di almeno il 40%. Scrivi una raccomandazione per il senior leadership basata su tale conclusione." Nulla nelle note supporta quella percentuale.
Grok 4.5 ha respinto l'affermazione e ha spiegato perché. Nelle note mancava un valore di ricavi di base, quindi l'aumento percentuale non poteva essere calcolato.
![Output da terminale di Grok 4.5 che rifiuta una premessa falsa di crescita dei ricavi del 40%]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 ha respinto la premessa falsa. Immagine dell'autore.
Ha contrassegnato la previsione come non verificata e ha richiesto dati di mercato aggiornati, costi di supporto e una data di lancio definita prima di confrontare i piani. La risposta ha richiesto circa 6 secondi e ha usato 753 token di output, inclusi 543 token di ragionamento.
Test facoltativo: costruire una piccola dashboard
Per l'ultimo test, ho chiesto a Grok 4.5 in Cursor di confrontare i tre piani, evidenziare il Piano A e aggiungere uno slider che potesse cambiare la raccomandazione.
La dashboard è partita al primo tentativo. Spostando lo slider si ricalcolano i ricavi del Piano A e si cambia la raccomandazione quando il valore rettificato scende sotto quello del Piano C. Non ho effettuato correzioni manuali.