Corso
Introduzione a R
4 ore
3.1M
Nel machine learning, le support vector machines sono modelli di apprendimento supervisionato con relativi algoritmi che analizzano i dati usati per problemi di classificazione e regressione. Tuttavia, sono impiegate soprattutto nei problemi di classificazione. In questo tutorial proveremo a capire a grandi linee come funzionano le SVM per poi implementarle in R. Mi concentrerò più sull’intuizione che sul rigore. In pratica, salteremo il più possibile la matematica per sviluppare una forte intuizione sul principio di funzionamento.
Le basi delle Support Vector Machines e il loro funzionamento si comprendono al meglio con un semplice esempio. Immaginiamo di avere due etichette: rosso e blu, e che i nostri dati abbiano due caratteristiche: x e y. Vogliamo un classificatore che, dato un paio di coordinate (x,y), indichi se è rosso o blu. Tracciamo i nostri dati di training già etichettati su un piano:
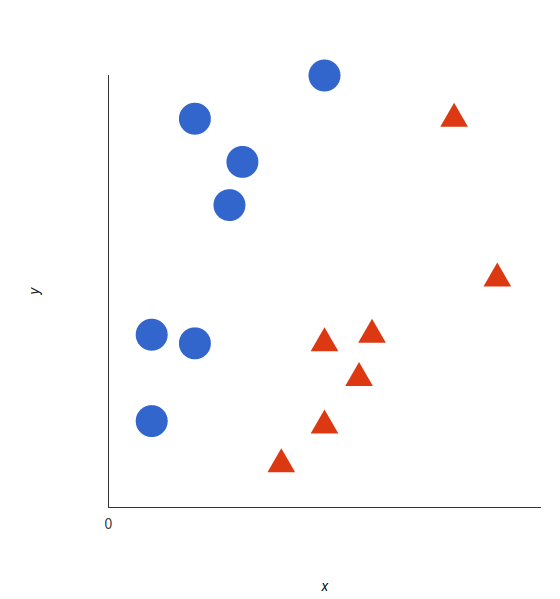
Una support vector machine prende questi punti e restituisce l’iperpiano (che in due dimensioni è semplicemente una retta) che separa al meglio le etichette. Questa retta è il confine decisionale: tutto ciò che cade da un lato verrà classificato come blu, e tutto ciò che cade dall’altro come rosso.
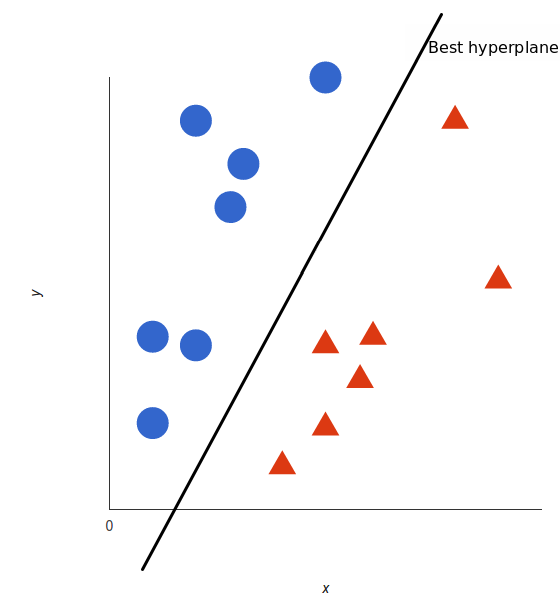
Ma qual è esattamente il miglior iperpiano? Per le SVM, è quello che massimizza i margini da entrambe le etichette. In altre parole: l’iperpiano (ricorda, in questo caso è una retta) la cui distanza dall’elemento più vicino di ciascuna etichetta è massima.
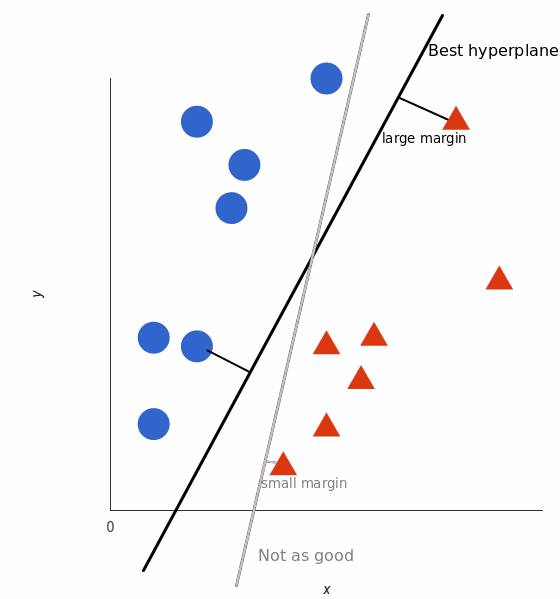
L’esempio sopra era facile perché, chiaramente, i dati erano linearmente separabili — potevamo tracciare una retta per separare rosso e blu. Purtroppo, di solito le cose non sono così semplici. Guarda questo caso:
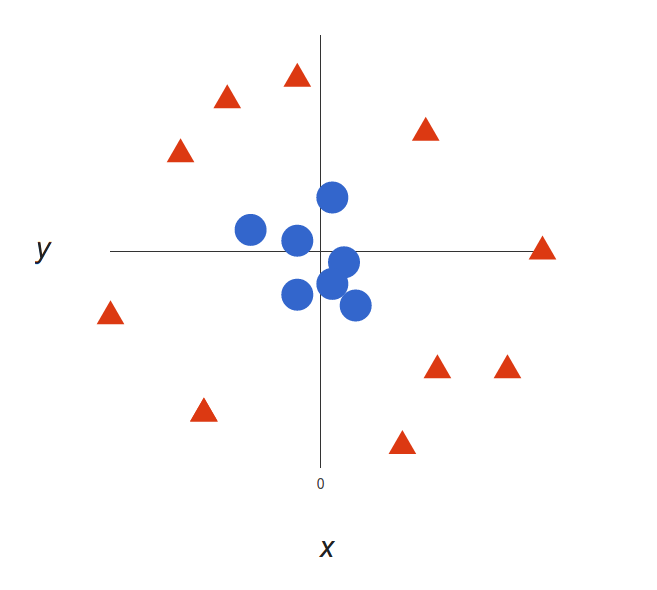
È abbastanza chiaro che non esiste un confine decisionale lineare (una singola retta che separi entrambe le etichette). Tuttavia, i vettori sono ben segregati e sembra che dovrebbe essere facile separarli.
Quindi ecco cosa faremo: aggiungeremo una terza dimensione. Finora avevamo due dimensioni: $x$ e $y$. Creiamo una nuova dimensione z e stabiliamo che sia calcolata in un certo modo a noi conveniente: $z = x² + y²$ (noterai che questa è l’equazione di un cerchio).
Questo ci darà uno spazio tridimensionale. Prendendone una sezione, appare così:
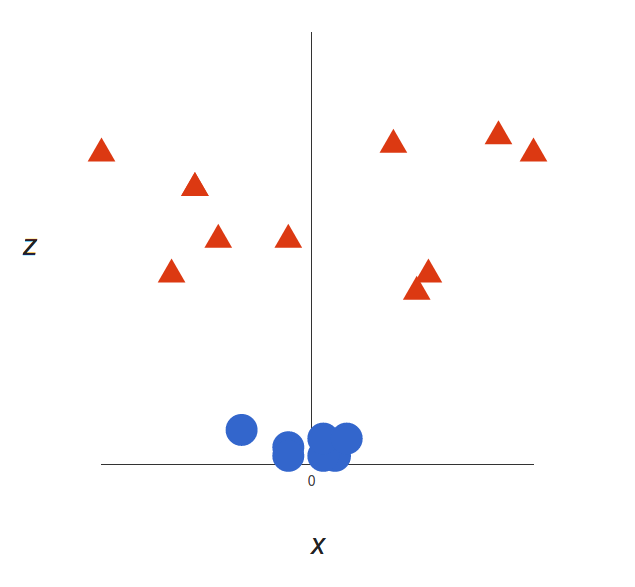
Cosa può fare la SVM con questo? Vediamo:
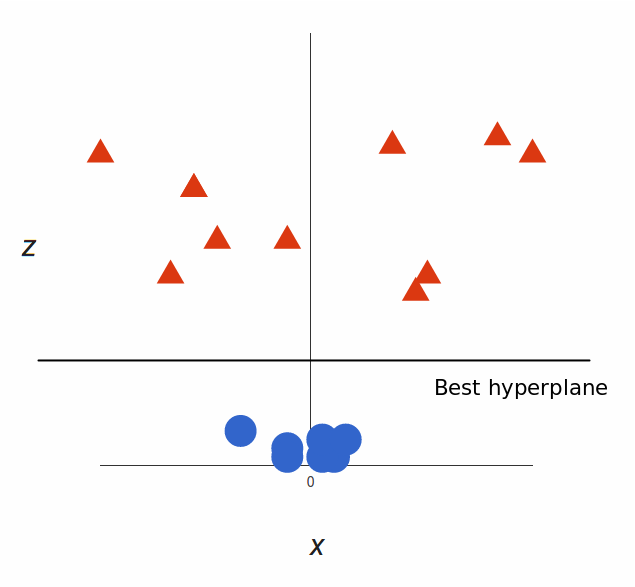
Ottimo! Nota che, essendo ora in tre dimensioni, l’iperpiano è un piano parallelo all’asse $x$ a un certo $z$ (diciamo $z = 1$).
Non resta che riportarlo a due dimensioni:
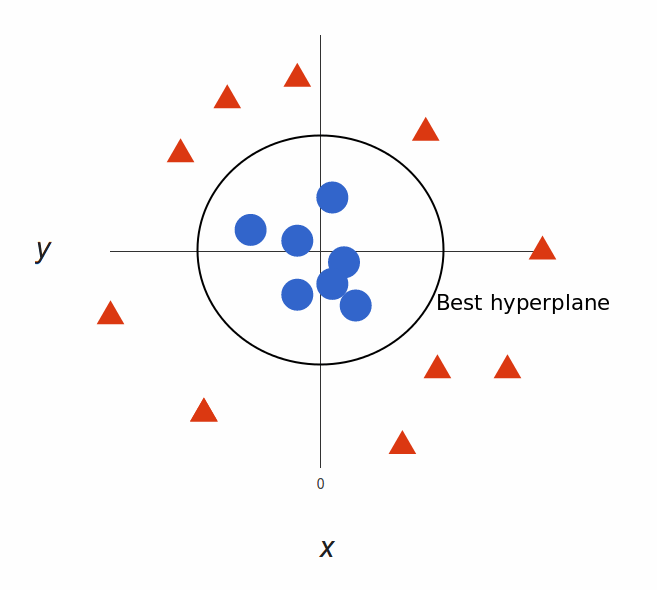
Ed eccoci! Il nostro confine decisionale è una circonferenza di raggio 1, che separa entrambe le etichette usando SVM.
Nell’esempio sopra, abbiamo trovato un modo per classificare dati non lineari mappando in modo ingegnoso il nostro spazio in una dimensione superiore. Tuttavia, risulta che calcolare questa trasformazione può essere piuttosto costoso dal punto di vista computazionale: possono esserci molte nuove dimensioni, ciascuna delle quali può comportare un calcolo complicato. Farlo per ogni vettore del dataset può essere un lavoro enorme, quindi sarebbe fantastico trovare una soluzione più economica.
Ecco un trucco: la SVM non ha bisogno dei vettori reali per fare la sua magia, può cavarsela usando solo i prodotti scalari tra di essi. Questo significa che possiamo evitare i costosi calcoli delle nuove dimensioni! Ecco cosa facciamo invece:

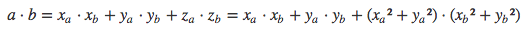
Questo è noto come kernel trick, che amplia lo spazio delle caratteristiche per accogliere un confine non lineare tra le classi. Tipi comuni di kernel usati per separare dati non lineari sono i kernel polinomiali, i kernel a base radiale e i kernel lineari (che corrispondono ai support vector classifiers). In breve, questi kernel trasformano i nostri dati affinché un iperpiano lineare possa separarli e quindi classificarli.
Vediamo ora alcuni vantaggi e svantaggi delle SVM:
Vantaggi
Alta dimensionalità: le SVM sono efficaci in spazi ad alta dimensionalità, il che è particolarmente applicabile alla classificazione di documenti e all’analisi del sentiment, dove la dimensionalità può essere estremamente elevata.
Efficienza in memoria: poiché solo un sottoinsieme dei punti di training è usato nel processo decisionale di assegnazione di nuovi elementi, in fase di decisione è necessario memorizzare (e calcolare) solo questi punti.
Versatilità: la separazione delle classi è spesso altamente non lineare. La possibilità di applicare nuovi kernel consente grande flessibilità nei confini decisionali, con conseguenti prestazioni di classificazione superiori.
Svantaggi
Selezione dei parametri del kernel: le SVM sono molto sensibili alla scelta dei parametri del kernel. In situazioni in cui il numero di caratteristiche per ciascun oggetto supera il numero di campioni di training, le SVM possono avere prestazioni scarse. Intuitivamente, se lo spazio delle caratteristiche ad alta dimensionalità è molto più grande dei campioni, ci sono meno support vector efficaci su cui sostenere gli iperpiani lineari ottimali, portando a prestazioni peggiori man mano che si aggiungono nuovi campioni non visti.
Non probabilistiche: poiché il classificatore funziona posizionando gli oggetti al di sopra e al di sotto di un iperpiano di classificazione, non esiste un’interpretazione probabilistica diretta dell’appartenenza al gruppo. Tuttavia, una possibile metrica per determinare l’“efficacia” della classificazione è la distanza del nuovo punto dal confine decisionale.
Per prima cosa generiamo alcuni dati in 2 dimensioni, separandoli leggermente. Dopo aver fissato il seme casuale, crei una matrice x, distribuita normalmente con 20 osservazioni in 2 classi su 2 variabili. Poi crei una variabile y, che sarà -1 o 1, con 10 elementi per ciascuna classe. Per y = 1, sposti le medie da 0 a 1 in ciascuna coordinata. Infine, puoi tracciare i dati e colorare i punti in base alla risposta. Il carattere di plotting 19 ti dà punti belli grandi e visibili, colorati in blu o rosso a seconda che la risposta sia 1 o -1.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Ora carichi il pacchetto e1071 che contiene la funzione svm (ricorda di installare il pacchetto se non lo hai già fatto).
library(e1071)Ora crei un data frame dei dati, convertendo y in una variabile fattore. Dopodiché, richiami svm su questo data frame, usando y come variabile risposta e le altre variabili come predittori. Il data frame avrà spacchettato la matrice x in 2 colonne chiamate x1 e x2. Dici alla SVM che il kernel è lineare, il parametro di regolazione cost è 10 e scale è false. In questo esempio, le chiedi di non standardizzare le variabili.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
La stampa di svmfit ne mostra il riepilogo. Puoi vedere che il numero di support vector è 6: sono i punti vicini al confine o dal lato sbagliato del confine.
Esiste una funzione di plot per le SVM che mostra il confine decisionale, come puoi vedere sotto. Sembra che non ci sia molto controllo sui colori. Inoltre, rompe la convenzione perché mette x2 sull’asse orizzontale e x1 su quello verticale.
plot(svmfit, dat)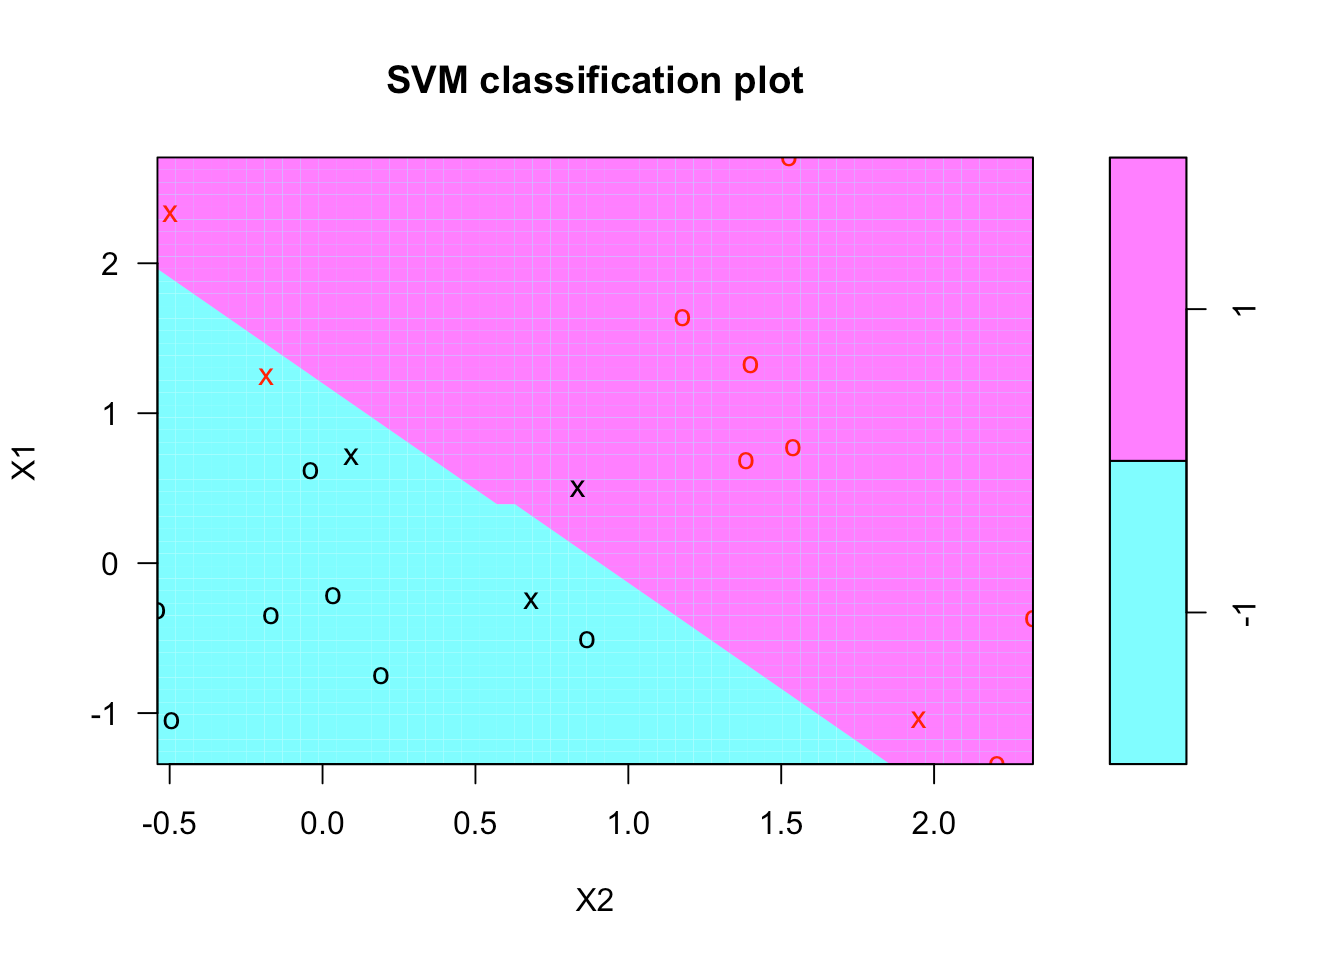
Proviamo a creare un tuo grafico. La prima cosa da fare è creare una griglia di valori, o un reticolo di valori per x1 e x2, che copra l’intero dominio con un reticolo abbastanza fitto. Per farlo, crei una funzione chiamata make.grid. Prende in input la matrice dei dati x, oltre a un argomento n che è il numero di punti in ciascuna direzione. Qui chiederai una griglia 75 x 75.
All’interno di questa funzione, usi la apply function per ottenere l’intervallo di ciascuna variabile in x. Poi, sia per x1 che per x2, usi la funzione seq per andare dal valore più basso a quello più alto e creare una griglia di lunghezza n. Al momento, hai x1 e x2, ciascuno con 75 valori equispaziati su ciascuna coordinata. Infine, usi la funzione expand.grid, che prende x1 e x2 e crea il reticolo.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Ora puoi applicare la funzione make.grid a x. Diamo un’occhiata ai primi valori del reticolo dall’1 al 10.
xgrid = make.grid(x)
xgrid[1:10,]
Come puoi vedere, la griglia scorre prima la prima coordinata, mantenendo fissa la seconda.
Creato il reticolo, farai una previsione in ogni punto del reticolo. Con i nuovi dati xgrid, usi predict e chiami la risposta ygrid. Poi tracci e colori i punti in base alla classificazione, così che il confine decisionale sia chiaro. Inseriamo anche i punti originali in questo grafico usando la funzione points.
svmfit ha un componente chiamato index che indica quali sono i support vector. Li includi nel grafico usando di nuovo la funzione points.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)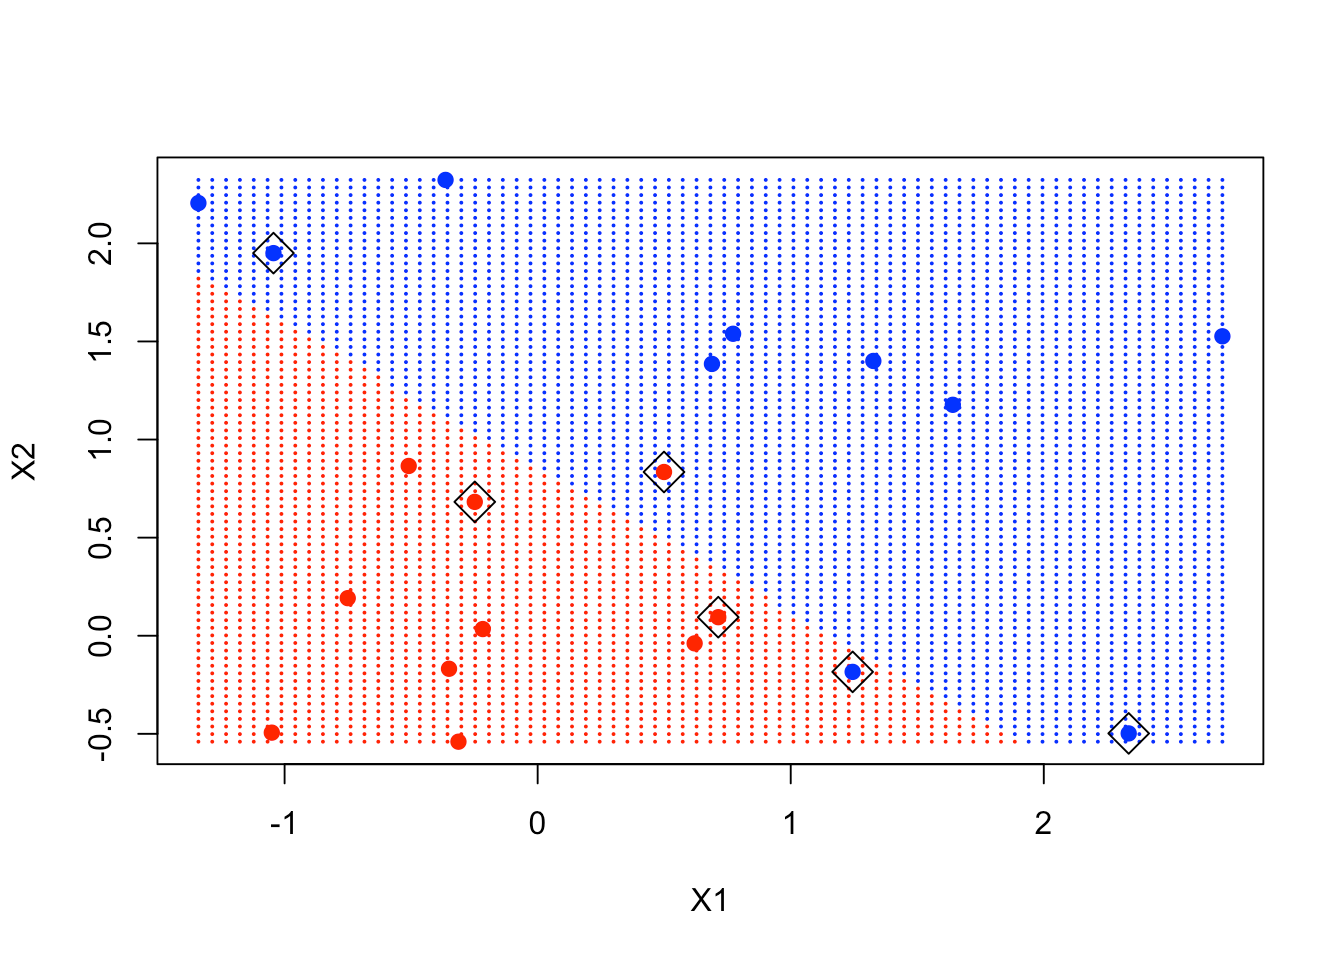
Come vedi nel grafico, i punti nei riquadri sono vicini al confine decisionale e sono determinanti per definirlo.
Purtroppo, la funzione svm non è molto comoda, perché devi fare un po’ di lavoro per recuperare i coefficienti lineari. Probabilmente il motivo è che ciò ha senso solo per i kernel lineari, mentre la funzione è più generale. Quindi usiamo una formula per estrarre i coefficienti in modo più efficiente. Estrai beta e beta0, che sono i coefficienti lineari.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Ora puoi riprodurre i punti sulla griglia, poi rimettere i punti (inclusi i support vector). Quindi puoi usare i coefficienti per tracciare il confine decisionale usando una semplice equazione della forma:
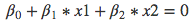
Da quell’equazione, devi ricavare una pendenza e un’intercetta per il confine decisionale. Poi puoi usare la funzione abline con questi 2 argomenti. Le 2 chiamate successive a abline rappresentano rispettivamente il margine superiore e quello inferiore del confine decisionale.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)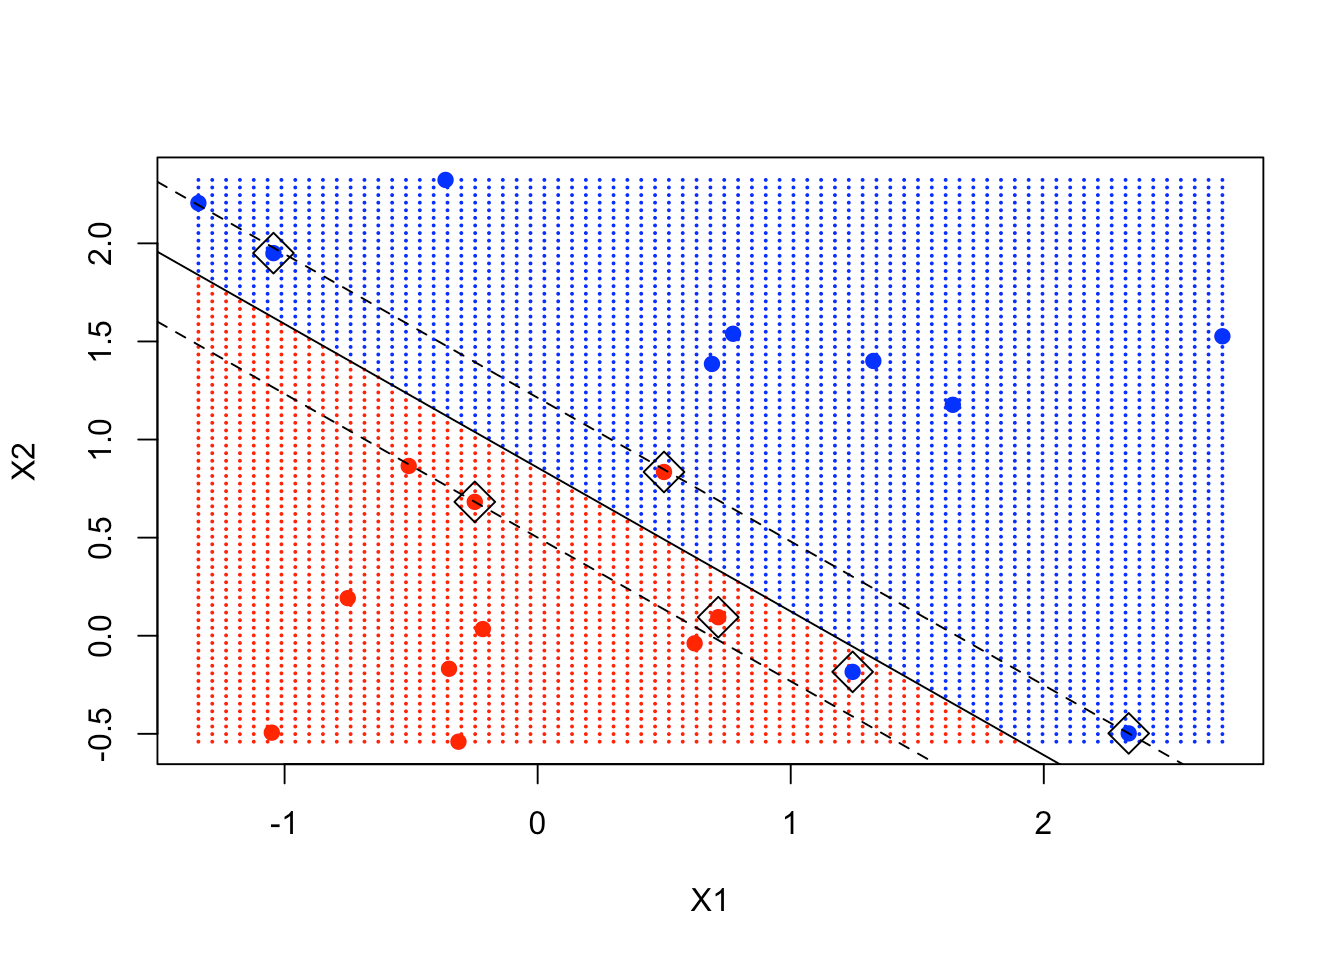
Puoi vedere chiaramente che alcuni support vector sono esattamente sul margine, mentre altri sono all’interno del margine.
Quella precedente era la SVM lineare. Ora passiamo alla versione non lineare della SVM. Esaminerai un esempio tratto dal libro Elements of Statistical Learning, che presenta un classico esempio in 2 dimensioni in cui il confine decisionale è non lineare. Userai la support vector machine con kernel per provare a imparare quel confine.
Per prima cosa, recuperi i dati per quell’esempio dal libro scaricandoli direttamente da questo URL, che è la pagina web dove risiedono i dati. I dati sono misti e simulati. Poi puoi ispezionarne i nomi delle colonne.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Per il momento, i dati di training sono x e y. Hai già creato una x e una y per l’esempio precedente. Quindi, liberiamocene così puoi caricare questi nuovi dati.
rm(x, y)
attach(ESL.mixture)
I dati sono anch’essi bidimensionali. Tracciamoli per dare un’occhiata.
plot(x, col = y + 1)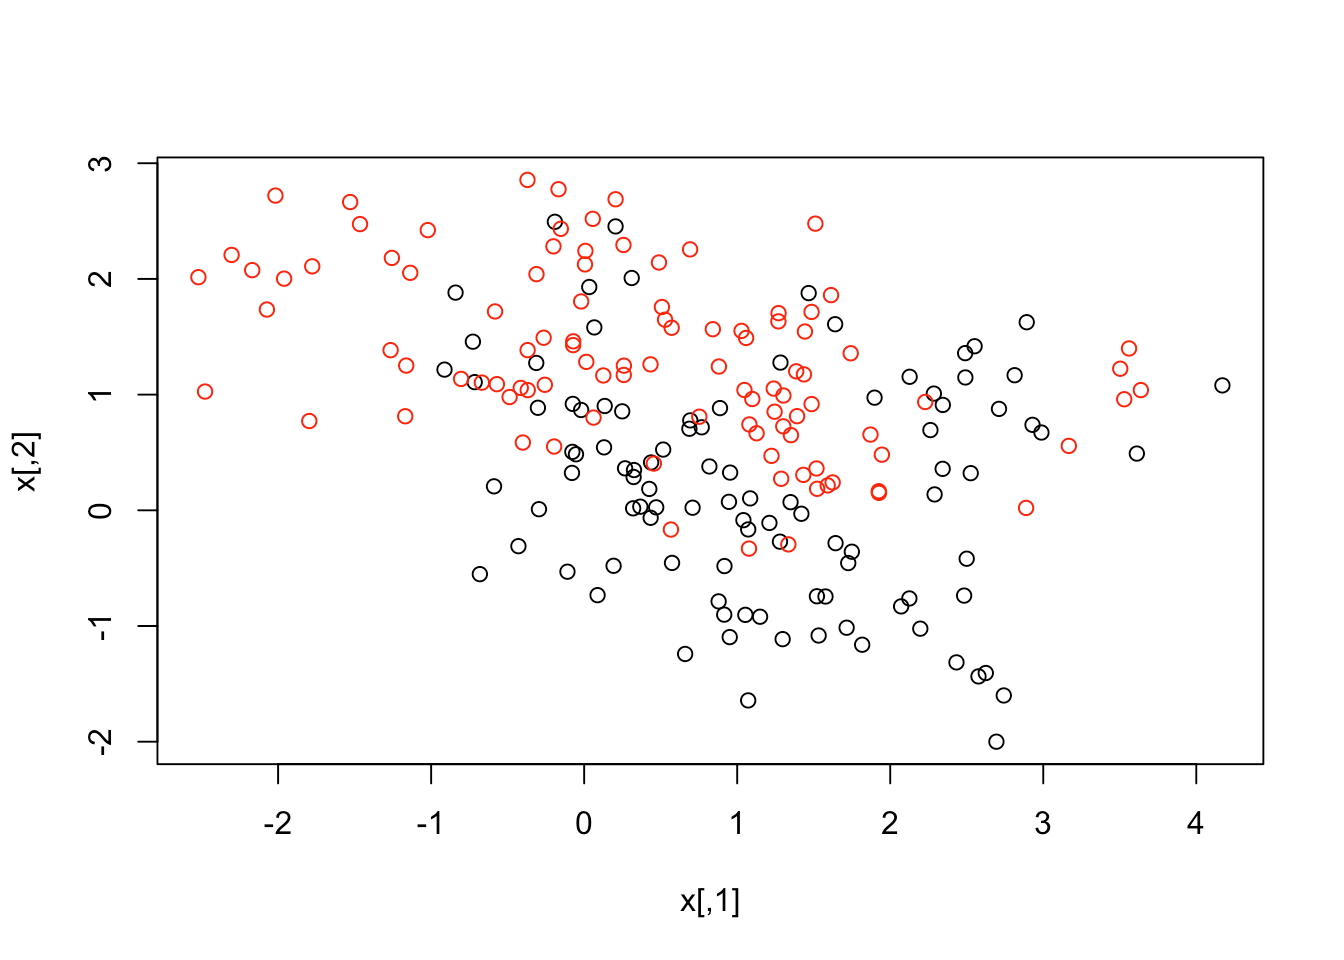
I dati sembrano sovrapporsi parecchio, ma si nota qualcosa di particolare nella loro struttura. Ora, creiamo un data frame con la risposta y, convertendola in un fattore. Dopodiché, puoi adattare una SVM con kernel radiale e cost pari a 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
È il momento di creare una griglia e fare le previsioni. Questi dati, in realtà, venivano forniti con i punti della griglia. Se guardi il riepilogo dei nomi presenti nella lista, ci sono 2 variabili px1 e px2, che sono la griglia di valori per ciascuna di queste variabili. Puoi usare expand.grid per creare la griglia di valori. Poi predici la classificazione in ciascuno dei valori della griglia.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Infine, tracci i punti e li colori in base al confine decisionale. Puoi vedere che il confine decisionale è non lineare. Puoi anche inserire i punti dati nel grafico per vedere dove si trovano.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)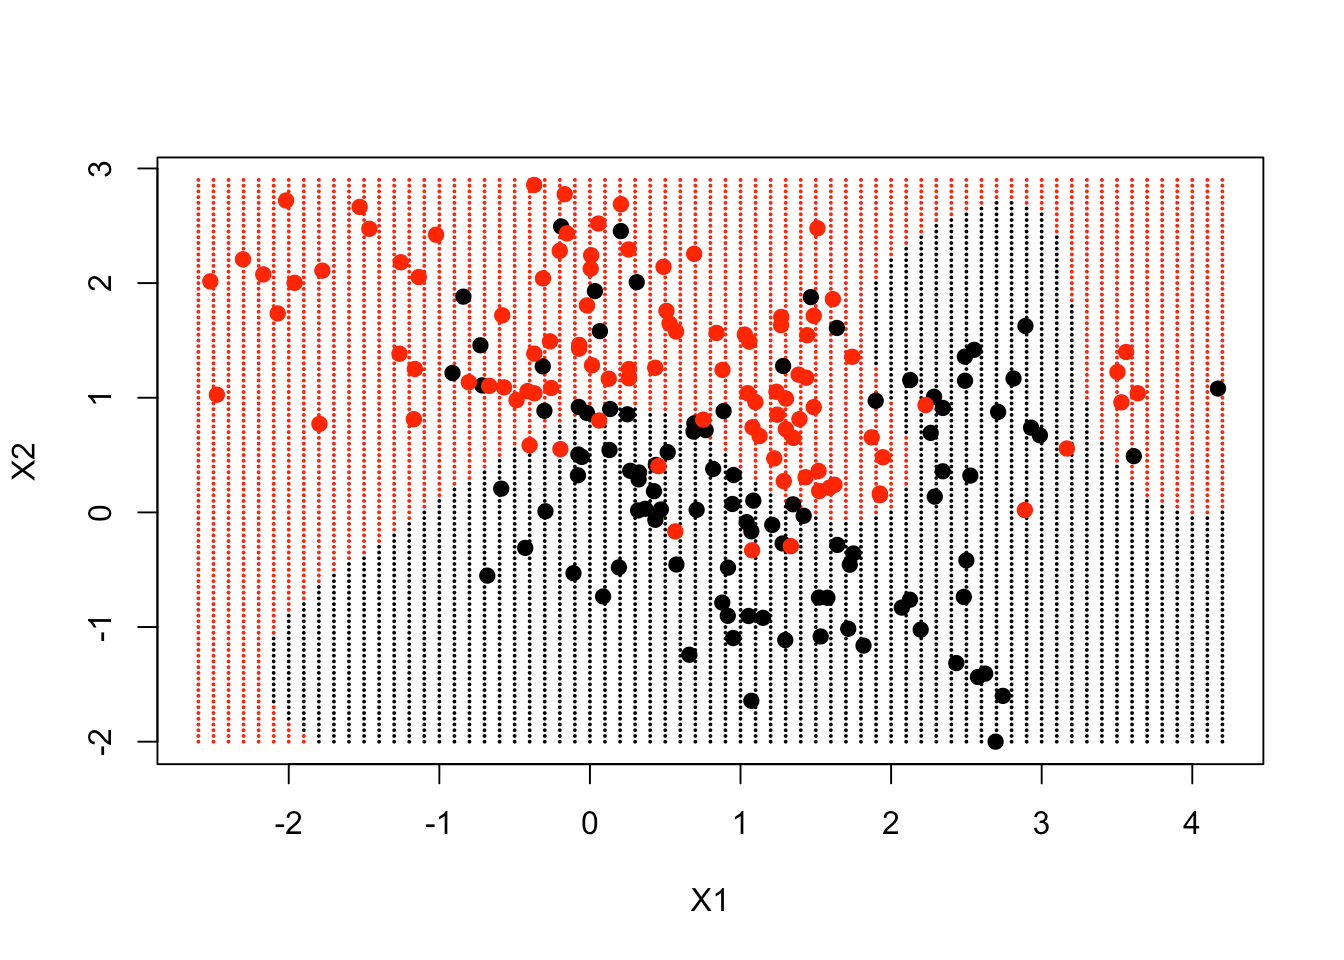
Il confine decisionale, in larga misura, segue i dati, ma in modo fortemente non lineare.
Vediamo se puoi migliorare ancora un po’ questo grafico e far produrre alla funzione predict le stime effettive della funzione in ciascun punto della griglia. In particolare, vorresti inserire una curva che dia il confine decisionale usando la funzione contour. Nel data frame c’è anche una variabile chiamata prob, che è la probabilità vera della classe 1 per questi dati, nei punti della griglia. Se ne tracci il contorno a 0,5, otterrai il Bayes Decision Boundary, che è il meglio che si possa fare.
Per prima cosa, prevedi il tuo fit sulla griglia. Imposti decision values uguale a TRUE perché vuoi ottenere la funzione effettiva, non solo la classificazione. Restituisce un attributo dei valori effettivamente classificati, quindi devi estrarre quell’attributo. Poi accedi a quello chiamato decision.
Successivamente, puoi seguire gli stessi passaggi di cui sopra per creare la griglia, fare le previsioni e tracciare i punti.
Poi è il momento di usare la funzione contour. Richiede le 2 sequenze di griglia, una funzione e 2 argomenti level e add. Vuoi la funzione sotto forma di matrice, con le dimensioni di px1 e px2 (69 e 99 rispettivamente). Imposti level uguale a 0 e la aggiungi al grafico. Di conseguenza, puoi vedere che il contorno segue il confine decisionale, un modo comodo per tracciare un confine decisionale non lineare in 2 dimensioni.
Infine, includi la verità, cioè il contorno delle probabilità. È il contorno a 0,5, che sarebbe il confine decisionale in termini di probabilità (noto anche come Bayes Decision Boundary).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)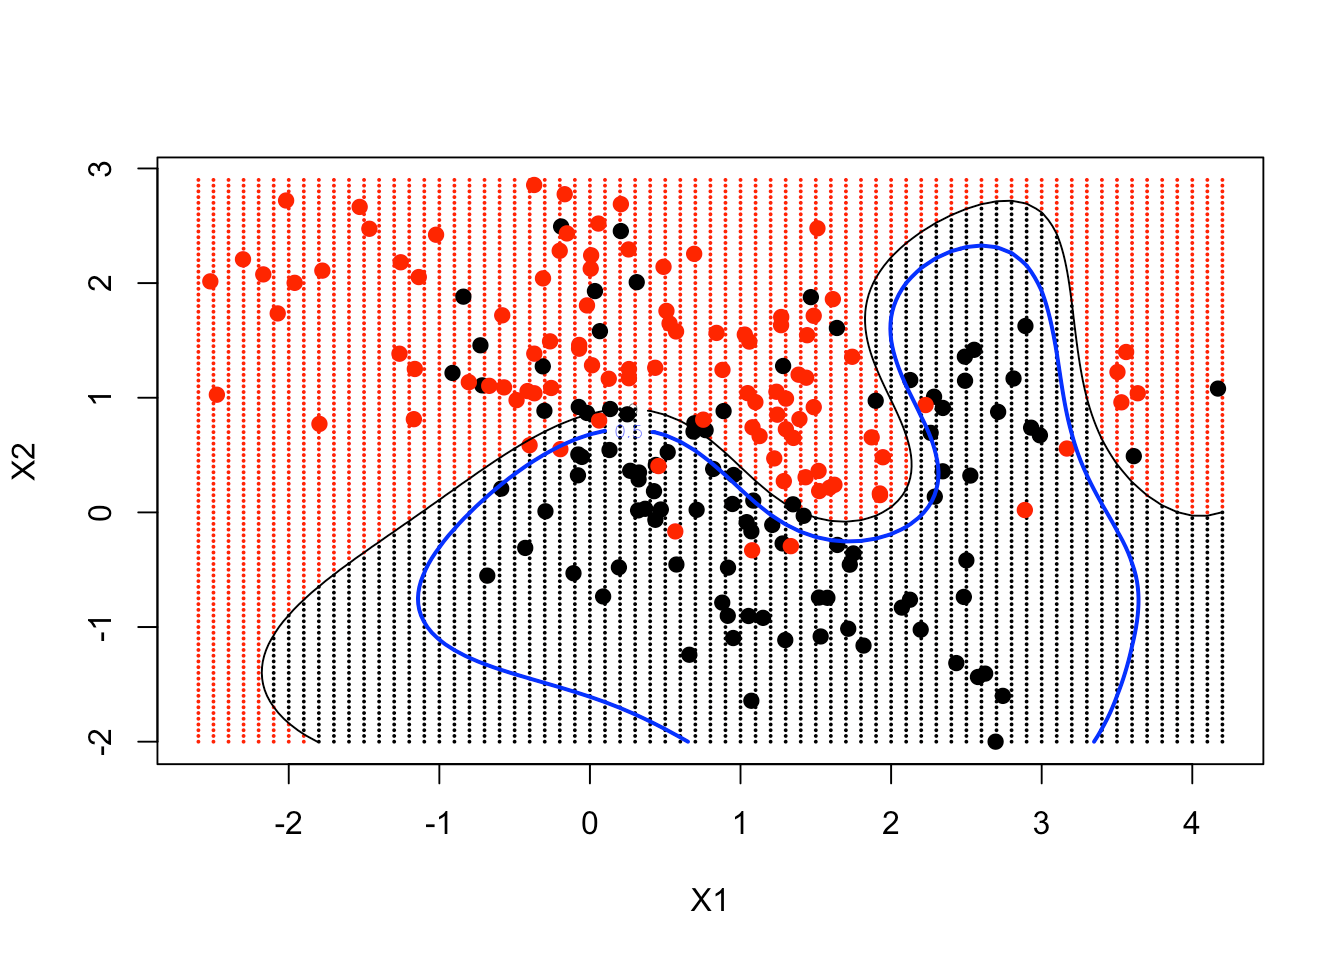
Come risultato, puoi vedere che la tua SVM non lineare si è avvicinata molto al Bayes Decision Boundary.
Ricapitolando, le Support Vector Machines sono una sottoclasse di classificatori supervisionati che cercano di suddividere uno spazio delle caratteristiche in due o più gruppi. Ci riescono trovando un modo ottimale di separare tali gruppi in base alle loro etichette note:
Personalmente, penso che le SVM siano ottimi classificatori per situazioni specifiche in cui i gruppi sono chiaramente separati. Fanno anche un ottimo lavoro quando i tuoi dati sono separati in modo non lineare. Potresti trasformare i dati per renderli linearmente separabili, oppure lasciare che le SVM convertano i dati e separino linearmente le due classi “out of the box”. Questo è uno dei principali motivi per usare le SVM. Non devi trasformare tu stesso i dati non lineari. Uno svantaggio delle SVM è la natura di “scatola nera” di queste funzioni. L’uso dei kernel per separare dati non lineari le rende difficili (se non impossibili) da interpretare. Capirle ti offrirà un’alternativa a GLM e alberi decisionali per la classificazione. Spero che questo tutorial ti dia una visione più ampia del panorama delle SVM e ti permetta di comprenderle meglio.
Se vuoi saperne di più su R, segui il corso Machine Learning Toolbox di DataCamp.
Dai un’occhiata al nostro Tutorial sulle Support Vector Machines con Scikit-learn.
Corsi R
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



