Kurs
R’ye Giriş
4 sa
3.1M
Makine öğreniminde, destek vektör makineleri, sınıflandırma ve regresyon analizinde kullanılan verileri inceleyen, ilişkili öğrenme algoritmalarına sahip denetimli öğrenme modelleridir. Ancak, çoğunlukla sınıflandırma problemlerinde kullanılırlar. Bu eğitimde, SVM’lerin nasıl çalıştığına dair yüksek seviyede bir anlayış kazanmaya ve ardından bunları R kullanarak uygulamaya çalışacağız. Katılıktan çok sezgi geliştirmeye odaklanacağım. Bunun anlamı, mümkün olduğunca matematiği atlayıp çalışma prensibine dair güçlü bir sezgi geliştirmektir.
Destek Vektör Makinelerinin temelleri ve nasıl çalıştıkları basit bir örnekle en iyi şekilde anlaşılır. İki etiketimiz olduğunu hayal edelim: kırmızı ve mavi, ve verilerimizin iki özelliği var: x ve y. (x,y) koordinat çifti verildiğinde bunun kırmızı mı yoksa mavi mi olduğunu çıktılayan bir sınıflandırıcı istiyoruz. Halihazırda etiketlenmiş eğitim verilerimizi bir düzlem üzerine çizelim:
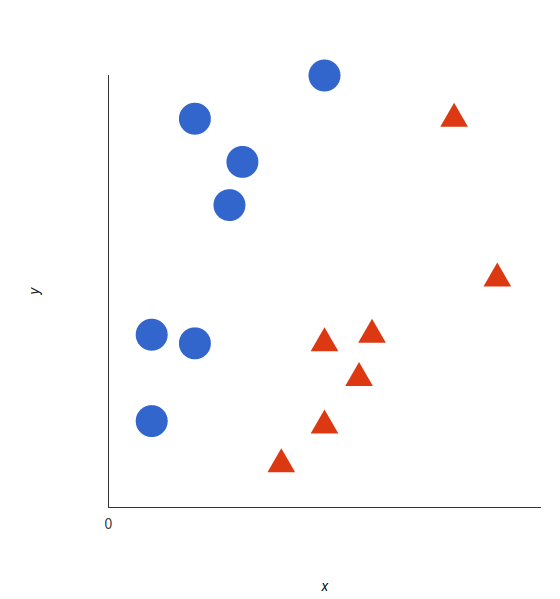
Bir destek vektör makinesi bu veri noktalarını alır ve etiketleri en iyi ayıran hiper düzlemi (iki boyutta bu basitçe bir çizgidir) üretir. Bu çizgi karar sınırıdır: bunun bir tarafına düşen her şeyi mavi, diğer tarafına düşen her şeyi ise kırmızı olarak sınıflandıracağız.
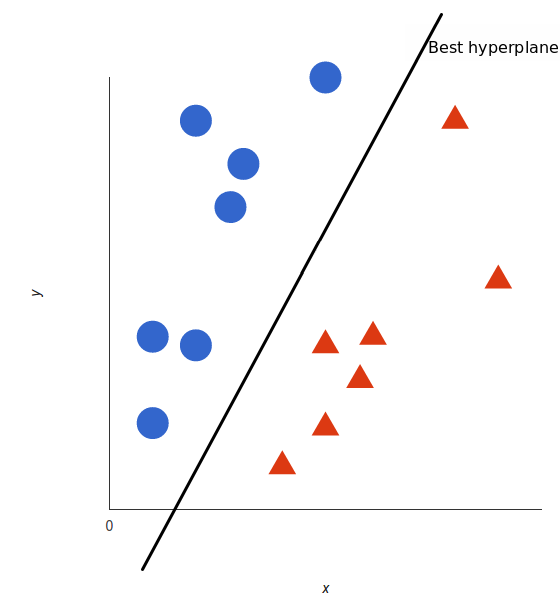
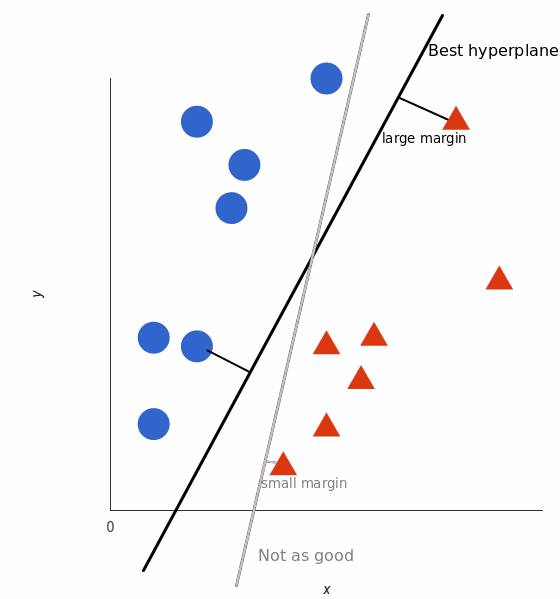
Peki, en iyi hiper düzlem tam olarak nedir? SVM için bu, her iki etiketten de marjları en çok artıranıdır. Başka bir deyişle: hiper düzlem (bu durumda bir çizgi olduğunu unutmayın) her bir etiketin en yakın öğesine olan uzaklığın en büyük olduğu çizgidir.
Yukarıdaki örnek kolaydı çünkü veriler açıkça doğrusal olarak ayrılabiliyordu — kırmızı ve maviyi ayırmak için düz bir çizgi çizebildik. Ne yazık ki, genelde işler bu kadar basit değildir. Şu duruma bakın:
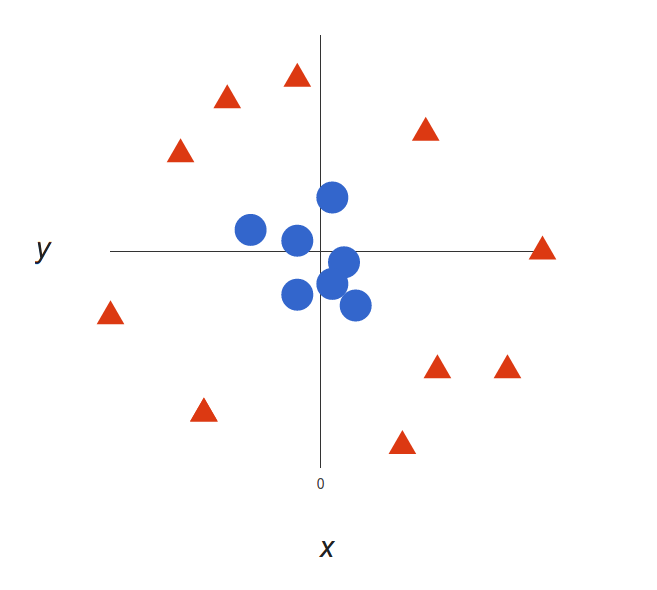
Doğrusal bir karar sınırı olmadığı (her iki etiketi ayıran tek bir düz çizgi) oldukça açık. Ancak, vektörler çok net bir şekilde ayrılmış durumda ve sanki bunları ayırmak kolay olmalıymış gibi görünüyor.
O hâlde şöyle yapacağız: üçüncü bir boyut ekleyeceğiz. Şimdiye kadar iki boyutumuz vardı: $x$ ve $y$. Yeni bir z boyutu oluşturuyoruz ve bizim için uygun olacak şekilde şu kuralla hesaplanmasını istiyoruz: $z = x² + y²$ (bunun bir çember denklemi olduğunu fark edeceksiniz).
Bu bize üç boyutlu bir uzay verecek. Bu uzayın bir kesitini aldığımızda şöyle görünüyor:
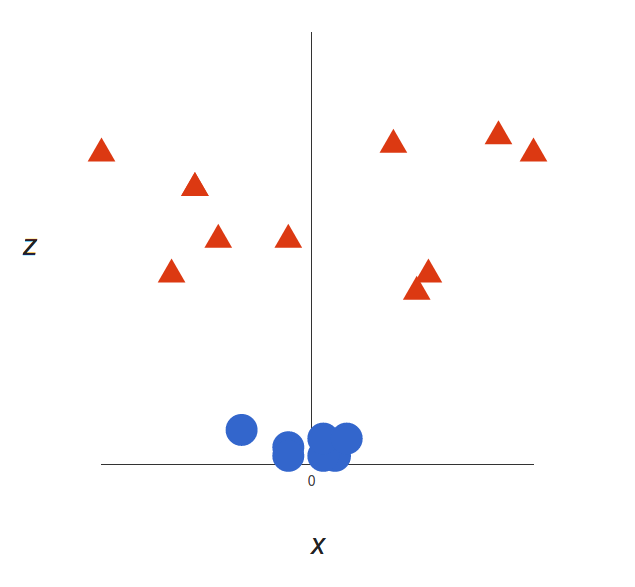
SVM bununla ne yapabilir? Bakalım:
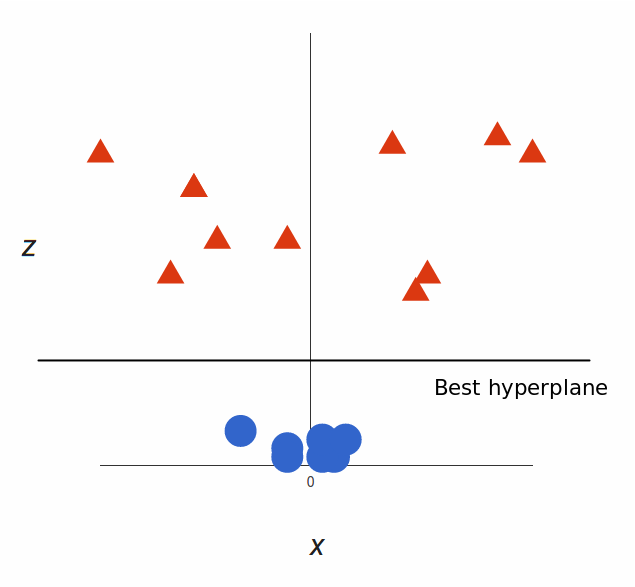
Harika! Artık üç boyutta olduğumuza dikkat edin; hiper düzlem, belirli bir $z$ değerinde $x$ eksenine paralel bir düzlemdir (örneğin $z = 1$ diyelim).
Geriye kalan bunu iki boyuta geri yansıtmaktır:
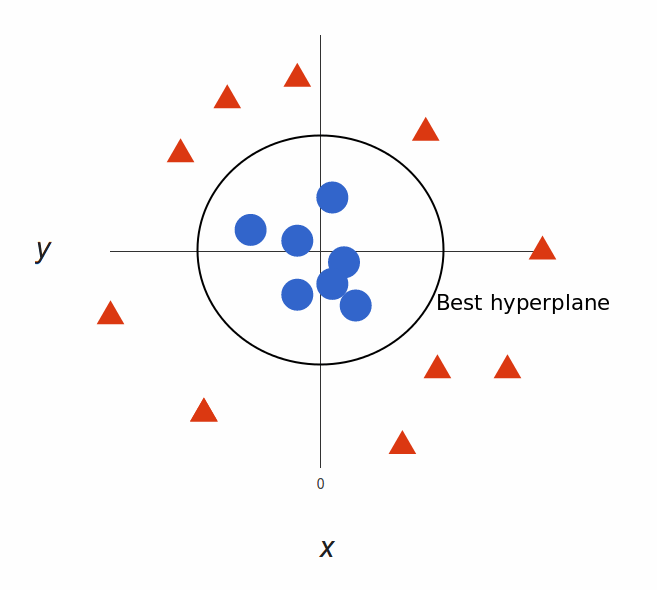
Ve işte bu kadar! Karar sınırımız, SVM kullanarak her iki etiketi ayıran yarıçapı 1 olan bir çemberdir.
Yukarıdaki örnekte, uzayımızı daha yüksek bir boyuta akıllıca eşleyerek doğrusal olmayan verileri sınıflandırmanın bir yolunu bulduk. Ancak, bu dönüşümü hesaplamanın oldukça maliyetli olabileceği ortaya çıkıyor: çok sayıda yeni boyut olabilir ve her biri karmaşık bir hesaplama gerektirebilir. Bunu veri kümesindeki her vektör için yapmak çok iş olabilir; dolayısıyla daha ucuz bir çözüm bulabilsek harika olurdu.
İşte bir numara: SVM sihrini gerçekleştirmek için aslında gerçek vektörlere ihtiyaç duymaz, yalnızca aralarındaki nokta çarpımlarıyla da idare edebilir. Bu, yeni boyutların pahalı hesaplamalarını atlayabileceğimiz anlamına gelir! Bunun yerine şunu yapıyoruz:

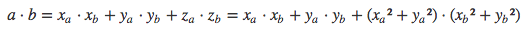
Bu, sınıflar arasında doğrusal olmayan bir sınırı barındırmak için özellik uzayını genişleten çekirdek hilesi olarak bilinir. Doğrusal olmayan verileri ayırmak için yaygın olarak kullanılan çekirdek türleri polinom çekirdekler, radyal tabanlı çekirdekler ve doğrusal çekirdeklerdir (ki bunlar destek vektör sınıflandırıcılarıyla aynıdır). Basitçe, bu çekirdekler verimizi, doğrusal bir hiper düzlemin geçebileceği şekilde dönüştürür ve böylece verimizi sınıflandırır.
Şimdi SVM’in bazı avantaj ve dezavantajlarına bakalım:
Avantajlar
Yüksek Boyutluluk: SVM, özellikle boyutluluğun son derece yüksek olabildiği doküman sınıflandırma ve duygu analizi gibi alanlarda, yüksek boyutlu uzaylarda etkili bir araçtır.
Bellek Verimliliği: Yeni üyelerin atanmasına ilişkin karar sürecinde yalnızca eğitim noktalarının bir alt kümesi kullanıldığından, karar verirken bellekte yalnızca bu noktaların saklanması (ve hesaplanması) gerekir.
Çok Yönlülük: Sınıf ayrımı çoğu zaman oldukça doğrusal değildir. Yeni çekirdekler uygulayabilme yeteneği, karar sınırlarında önemli bir esneklik sağlar ve bu da daha yüksek sınıflandırma performansına yol açar.
Dezavantajlar
Çekirdek Parametrelerinin Seçimi: SVM’ler çekirdek parametrelerinin seçimine karşı çok hassastır. Her bir nesne için özellik sayısının eğitim örneği sayısını aştığı durumlarda SVM’ler zayıf performans gösterebilir. Bunu sezgisel olarak şöyle görebilirsiniz: yüksek boyutlu özellik uzayı örneklerden çok daha büyükse, optimal doğrusal hiper düzlemleri destekleyecek daha az etkili destek vektörü bulunur; bu da yeni, görülmemiş örnekler eklendikçe daha düşük sınıflandırma performansına yol açar.
Olasılıksal Olmama: Sınıflandırıcı, nesneleri bir sınıflandırıcı hiper düzlemin üstüne ve altına yerleştirerek çalıştığı için grup üyeliği için doğrudan olasılıksal bir yorum yoktur. Ancak, sınıflandırmanın “etkililiğini” belirlemek için potansiyel bir ölçüt, yeni noktanın karar sınırına olan uzaklığıdır.
Önce 2 boyutta biraz ayrık olacak şekilde bazı veriler oluşturalım. Rastgele tohum ayarını yaptıktan sonra, 2 değişkende 2 sınıfta 20 gözlemden oluşan, normal dağılımlı bir x matrisi oluşturursunuz. Ardından, her sınıfta 10 olacak şekilde -1 veya 1’den oluşan bir y değişkeni yaparsınız. y = 1 için, ortalamaları her bir koordinatta 0’dan 1’e kaydırırsınız. Son olarak verileri çizebilir ve noktaları yanıtlarına göre renklendirebilirsiniz. 19 numaralı çizim karakteri, yanıtın 1 veya -1 olmasına göre mavi ya da kırmızı kodlanan, güzel, büyük ve görünür noktalar verir.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Şimdi svm fonksiyonunu içeren e1071 paketini yüklüyorsunuz (paketi henüz kurmadıysanız kurmayı unutmayın).
library(e1071)Şimdi verilerden bir veri çerçevesi oluşturuyor, y’yi faktör değişkene çeviriyorsunuz. Ardından bu veri çerçevesinde svm çağrısı yapıyor, y’yi yanıt değişkeni ve diğer değişkenleri yordayıcılar olarak kullanıyorsunuz. Veri çerçevesi, x matrisini x1 ve x2 adlı 2 sütuna açacaktır. SVM’ye çekirdeğin lineer olduğunu, ayar parametresi cost’un 10 olduğunu ve scale’in false olduğunu söylüyorsunuz. Bu örnekte, değişkenlerin standartlaştırılmamasını istiyorsunuz.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)svmfit’i yazdırmak özetini verir. Destek vektörlerinin sayısının 6 olduğunu görebilirsiniz — bunlar sınıra yakın olan veya sınırın yanlış tarafında bulunan noktalardır.
Aşağıda görebileceğiniz gibi, SVM için karar sınırını gösteren bir çizim fonksiyonu vardır. Renkler üzerinde pek kontrol yok gibi görünüyor. Alışılmışın dışına çıkarak x2’yi yatay eksene, x1’i dikey eksene yerleştiriyor.
plot(svmfit, dat)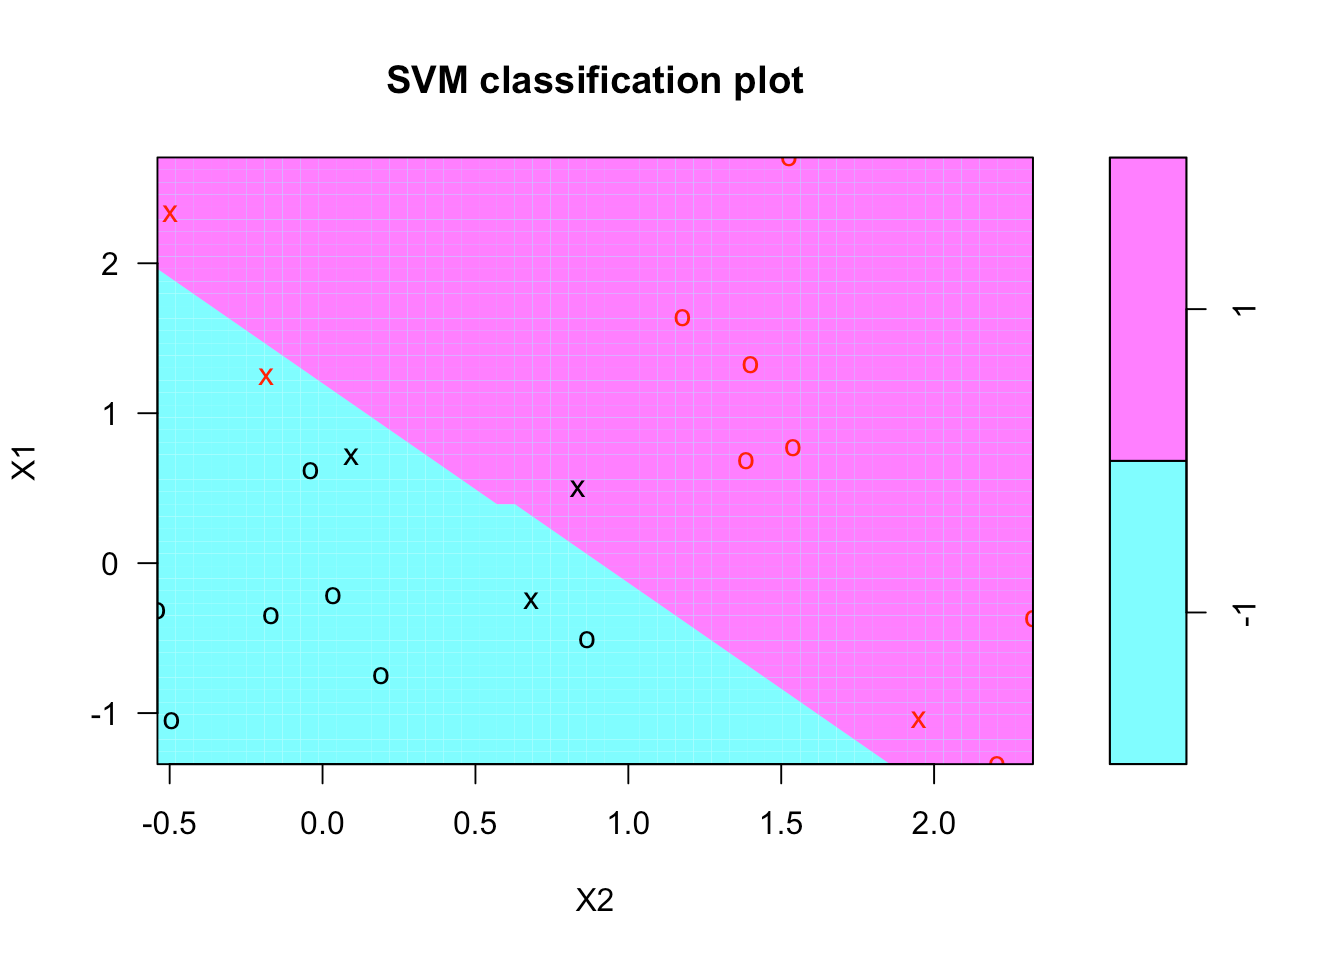
Hadi kendi grafiğinizi yapmayı deneyelim. Yapılacak ilk şey, tüm alanı nispeten ince bir kafes üzerinde kapsayacak şekilde x1 ve x2 için bir değerler ızgarası veya kafesi oluşturmaktır. Bunu yapmak için make.grid adlı bir fonksiyon yazıyorsunuz. Bu fonksiyon, veri matrisi x’i ve her yöndeki nokta sayısı olan n argümanını alır. Burada 75 x 75’lik bir ızgara isteyeceksiniz.
Bu fonksiyon içinde, x’teki değişkenlerin her biri için aralığı elde etmek üzere apply fonksiyonunu kullanırsınız. Ardından hem x1 hem de x2 için, en düşük değerden en yüksek değere kadar seq fonksiyonunu kullanarak uzunluğu n olan bir ızgara oluşturursunuz. Şu anda, her bir koordinatta 75 eşit aralıklı değere sahip x1 ve x2’ye sahipsiniz. Son olarak, x1 ve x2’yi alıp kafes oluşturan expand.grid fonksiyonunu kullanırsınız.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Şimdi make.grid fonksiyonunu x üzerinde uygulayabilirsiniz. 1’den 10’a kadar kafesin ilk birkaç değerine bakalım.
xgrid = make.grid(x)
xgrid[1:10,]
Gördüğünüz gibi, ızgara önce birinci koordinat boyunca ilerlerken ikinci koordinatı sabit tutuyor.
Kafesi oluşturduğunuza göre, kafesteki her noktada bir tahmin yapacaksınız. Yeni veri xgrid ile predict kullanıp yanıtı ygrid olarak adlandırıyorsunuz. Ardından, karar sınırı net olsun diye noktaları sınıflandırmaya göre çizip renklendiriyorsunuz. points fonksiyonunu kullanarak orijinal noktaları da bu grafiğe ekleyelim.
svmfit’in, hangi noktaların destek noktaları olduğunu söyleyen index adlı bir bileşeni vardır. Bunları da yine points fonksiyonunu kullanarak grafiğe dahil edersiniz.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)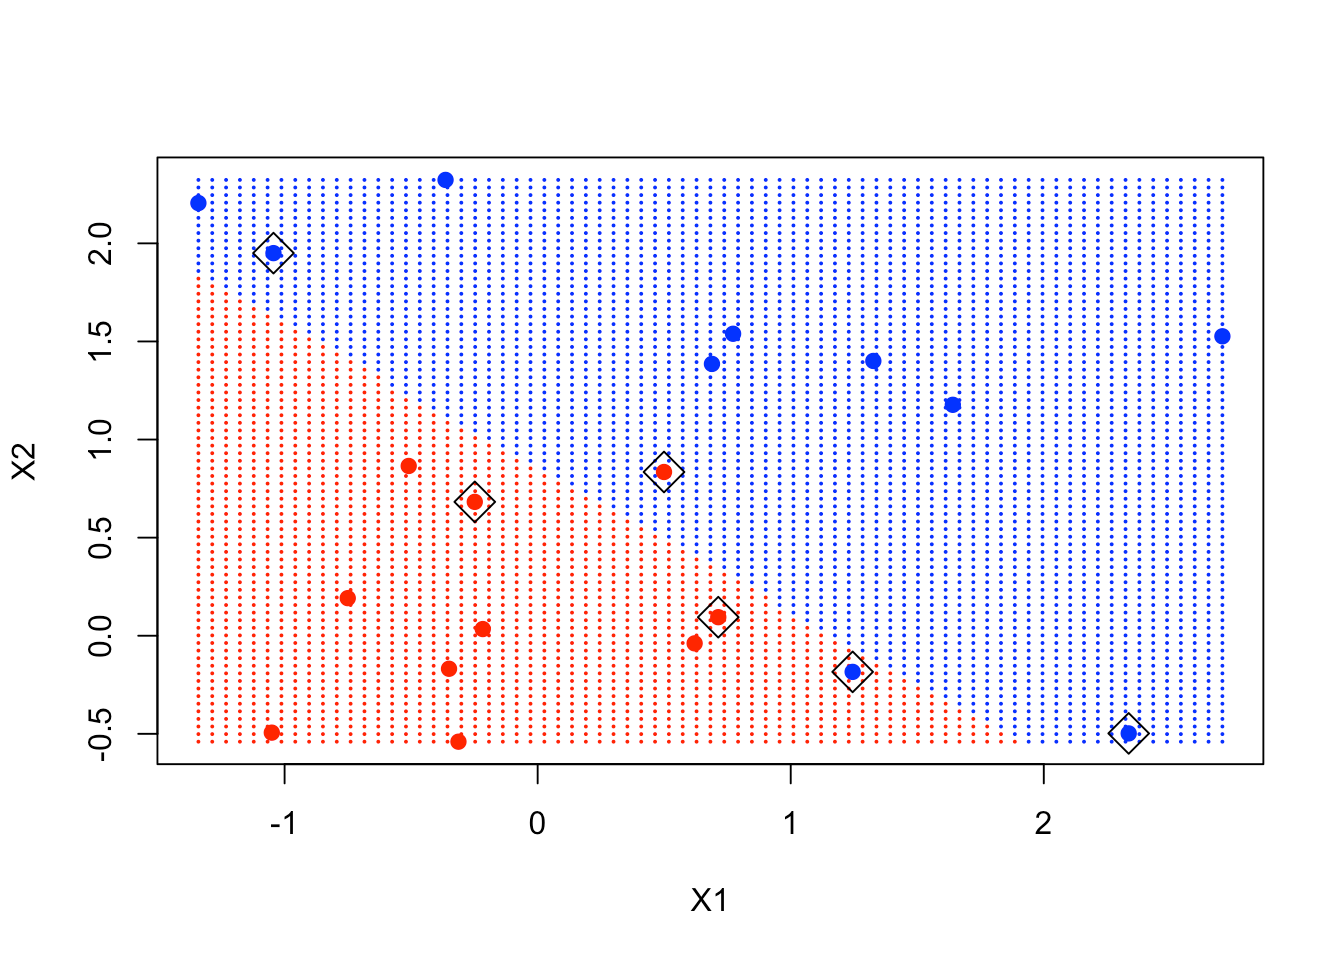
Grafikte görüldüğü gibi, kutulardaki noktalar karar sınırına yakındır ve bu sınırın belirlenmesinde etkilidir.
Ne yazık ki, svm fonksiyonu o kadar da kullanıcı dostu değildir; doğrusal katsayıları geri almak için biraz uğraşmanız gerekir. Muhtemelen nedeni, bunun yalnızca doğrusal çekirdekler için anlamlı olması ve fonksiyonun daha genel olmasıdır. O hâlde katsayıları daha verimli çıkarmak için bir formül kullanalım. Doğrusal katsayılar olan beta ve beta0’ı çıkarıyorsunuz.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Şimdi noktaları ızgara üzerinde yeniden çizebilir, sonra noktaları (destek vektör noktaları dahil) tekrar ekleyebilirsiniz. Ardından aşağıdaki biçimde basit bir denklem kullanarak karar sınırını çizmek için katsayıları kullanabilirsiniz:
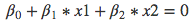
Bu denklemden, karar sınırı için bir eğim ve bir kesişim bulmanız gerekir. Daha sonra bu iki argümanla abline fonksiyonunu kullanabilirsiniz. Bunu izleyen 2 abline çağrısı sırasıyla karar sınırının üst marjını ve alt marjını temsil eder.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)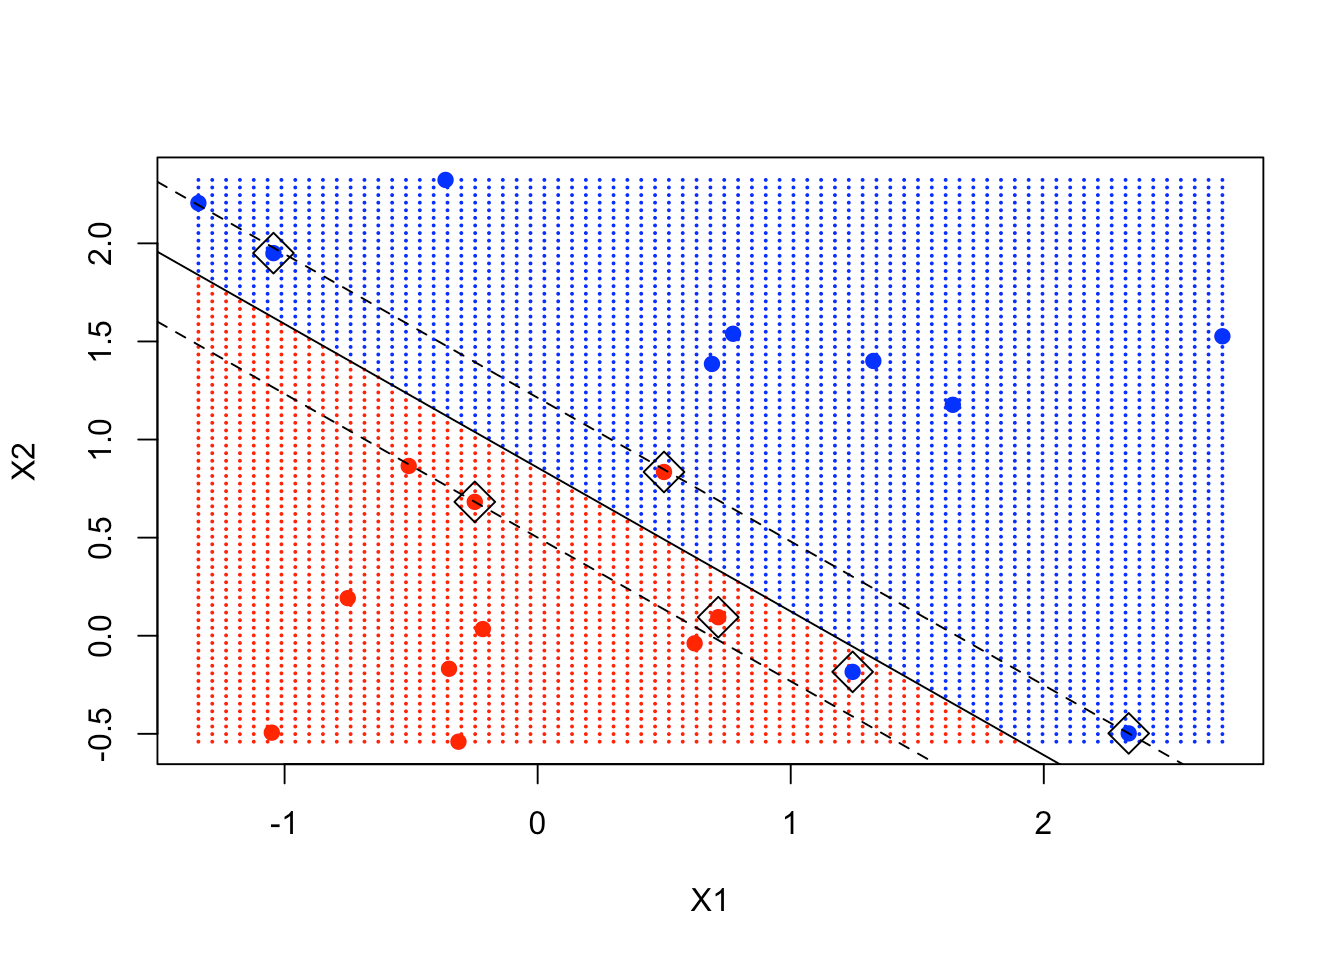
Bazı destek noktalarının tam olarak marj üzerinde, bazılarının ise marjın içinde olduğunu açıkça görebilirsiniz.
Önceki bölümde doğrusal SVM’i görmüştük. Şimdi SVM’in doğrusal olmayan sürümüne geçelim. Elements of Statistical Learning kitabından, karar sınırının doğrusal olmadığı, 2 boyutta kanonik bir örneğe bakacaksınız. Bu sınırı öğrenmeye çalışmak için çekirdek destek vektör makinesini kullanacaksınız.
Öncelikle, verileri doğrudan bu URL’den indirerek kitaptaki örneğe ait verileri alırsınız; bu, verilerin bulunduğu web sayfasıdır. Veriler karışık ve simüle edilmiştir. Sonra sütun adlarını inceleyebilirsiniz.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Şimdilik, eğitim verileri x ve y’dir. Önceki örnek için zaten x ve y oluşturmuştunuz. Dolayısıyla, bu yeni verileri ekleyebilmeniz için onları kaldıralım.
rm(x, y)
attach(ESL.mixture)
Veriler de 2 boyutludur. İyi bir görünüm elde etmek için bunları çizelim.
plot(x, col = y + 1)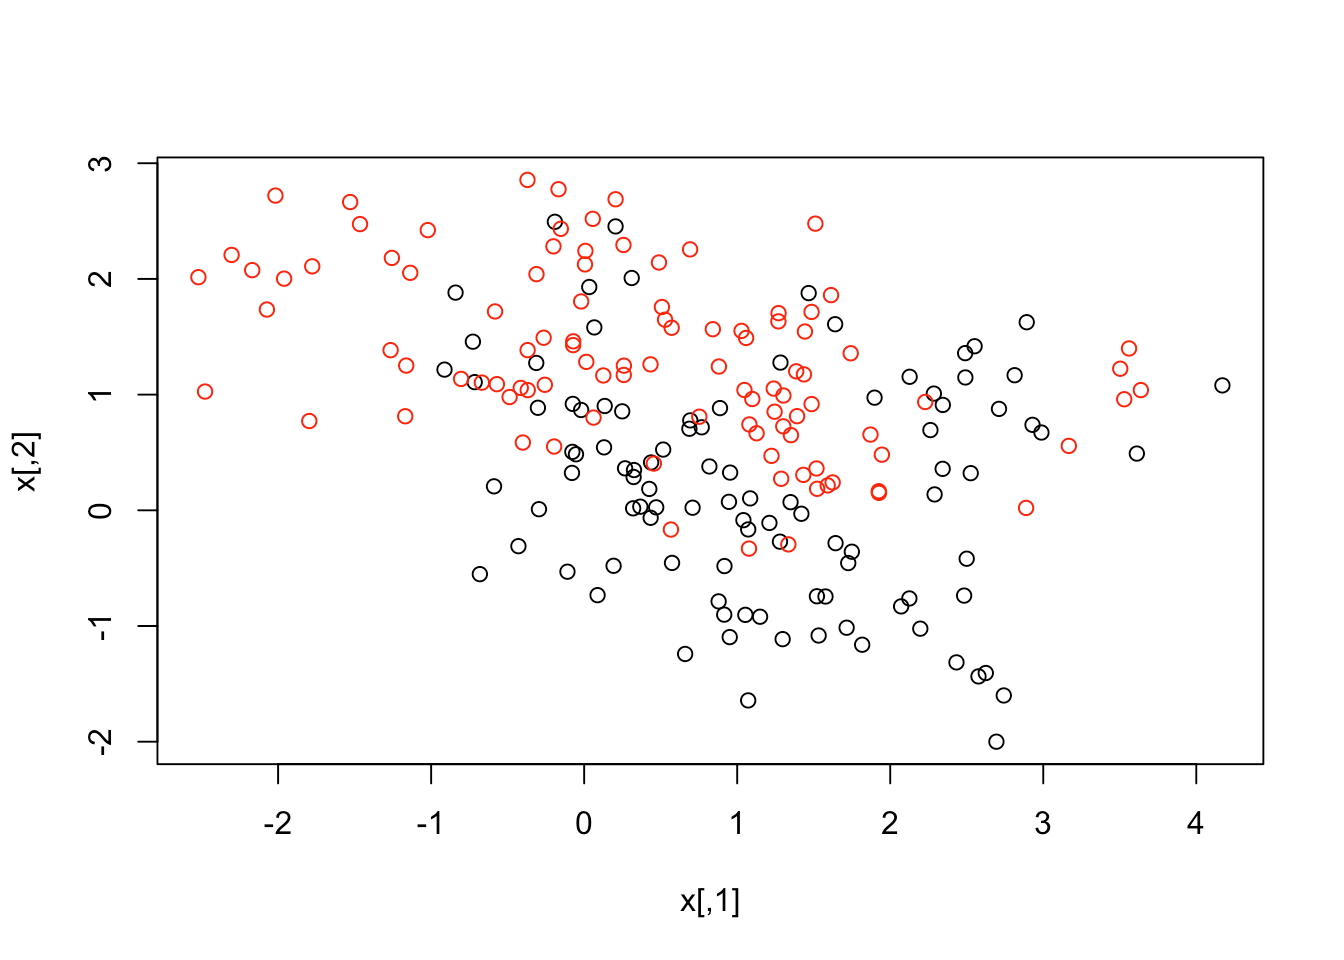
Veriler bir hayli örtüşüyor gibi görünüyor, ancak yapısında özel bir şeyler olduğunu görebilirsiniz. Şimdi yanıt y ile bir veri çerçevesi oluşturalım ve onu faktöre çevirelim. Ardından, radyal çekirdekli ve cost’u 5 olan bir SVM uyarlayabilirsiniz.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Şimdi bir ızgara oluşturma ve tahminlerinizi yapma zamanı. Bu veriler aslında ızgara noktalarıyla birlikte geldi. Listedeki adların özetine baktığınızda, her bir değişken için değer ızgarasını oluşturan px1 ve px2 adlı 2 değişken olduğunu görürsünüz. Değer ızgarasını oluşturmak için expand.grid kullanabilirsiniz. Sonra, ızgaradaki her değerde sınıflandırmayı tahmin edersiniz.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Son olarak, noktaları çizer ve karar sınırına göre renklendirirsiniz. Karar sınırının doğrusal olmadığını görebilirsiniz. Noktaların nerede yer aldığını görmek için veri noktalarını da grafiğe koyabilirsiniz.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)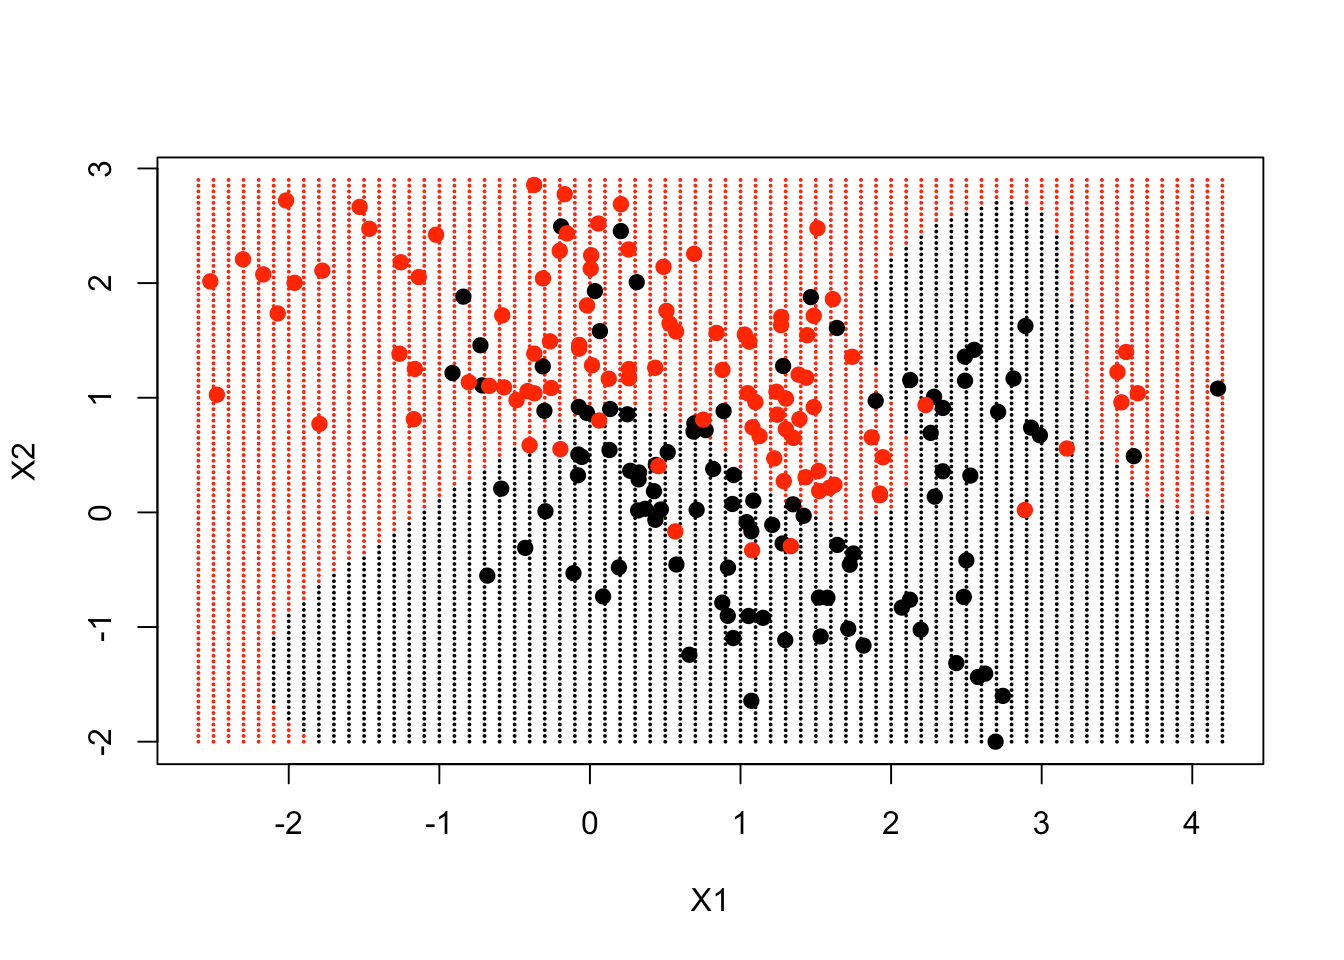
Karar sınırı, büyük ölçüde verilerin bulunduğu yerleri takip ediyor ama oldukça doğrusal olmayan bir şekilde.
Bu grafiği biraz daha iyileştirip predict fonksiyonunun ızgara noktalarımızın her birinde gerçek fonksiyon tahminlerini üretmesini sağlayabilir miyiz, görelim. Özellikle, contour fonksiyonundan yararlanarak karar sınırını veren bir eğri eklemek istiyorsunuz. Veri çerçevesinde, bu veriler için ızgara noktalarında sınıf 1’in gerçek olasılığı olan prob adlı bir değişken de var. 0,5 konturunu çizerseniz bu, en iyi yapılabilecek olan Bayes Karar Sınırını verir.
İlk olarak, ızgara üzerinde uyumunuzu tahmin edersiniz. Sadece sınıflandırmayı değil, gerçek fonksiyonu almak istediğiniz için decision values’ı TRUE olarak belirtirsiniz. Dönen nesne, gerçek sınıflandırılmış değerlerin bir özniteliğidir; bu nedenle o özniteliği ayıklamanız gerekir. Ardından decision adlı olanına erişirsiniz.
Sonra, ızgarayı oluşturmak, tahminleri yapmak ve noktaları çizmek için yukarıdaki adımların aynısını izleyebilirsiniz.
Ardından sıra contour fonksiyonunu kullanmaya gelir. Bu fonksiyon 2 ızgara dizisini, bir fonksiyonu ve level ile add adlı 2 argümanı gerektirir. Fonksiyonu, px1 ve px2’nin boyutlarında (sırasıyla 69 ve 99) bir matris biçiminde istiyorsunuz. Level’ı 0’a ayarlayıp grafiğe eklersiniz. Sonuç olarak, konturun karar sınırını takip ettiğini, 2 boyutta doğrusal olmayan bir karar sınırını çizmenin kullanışlı bir yolunu görebilirsiniz.
Son olarak, gerçeği, yani olasılıkların konturunu eklersiniz. Bu, olasılıklar açısından karar sınırı olacak 0,5 konturudur (diğer adıyla Bayes Karar Sınırı).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)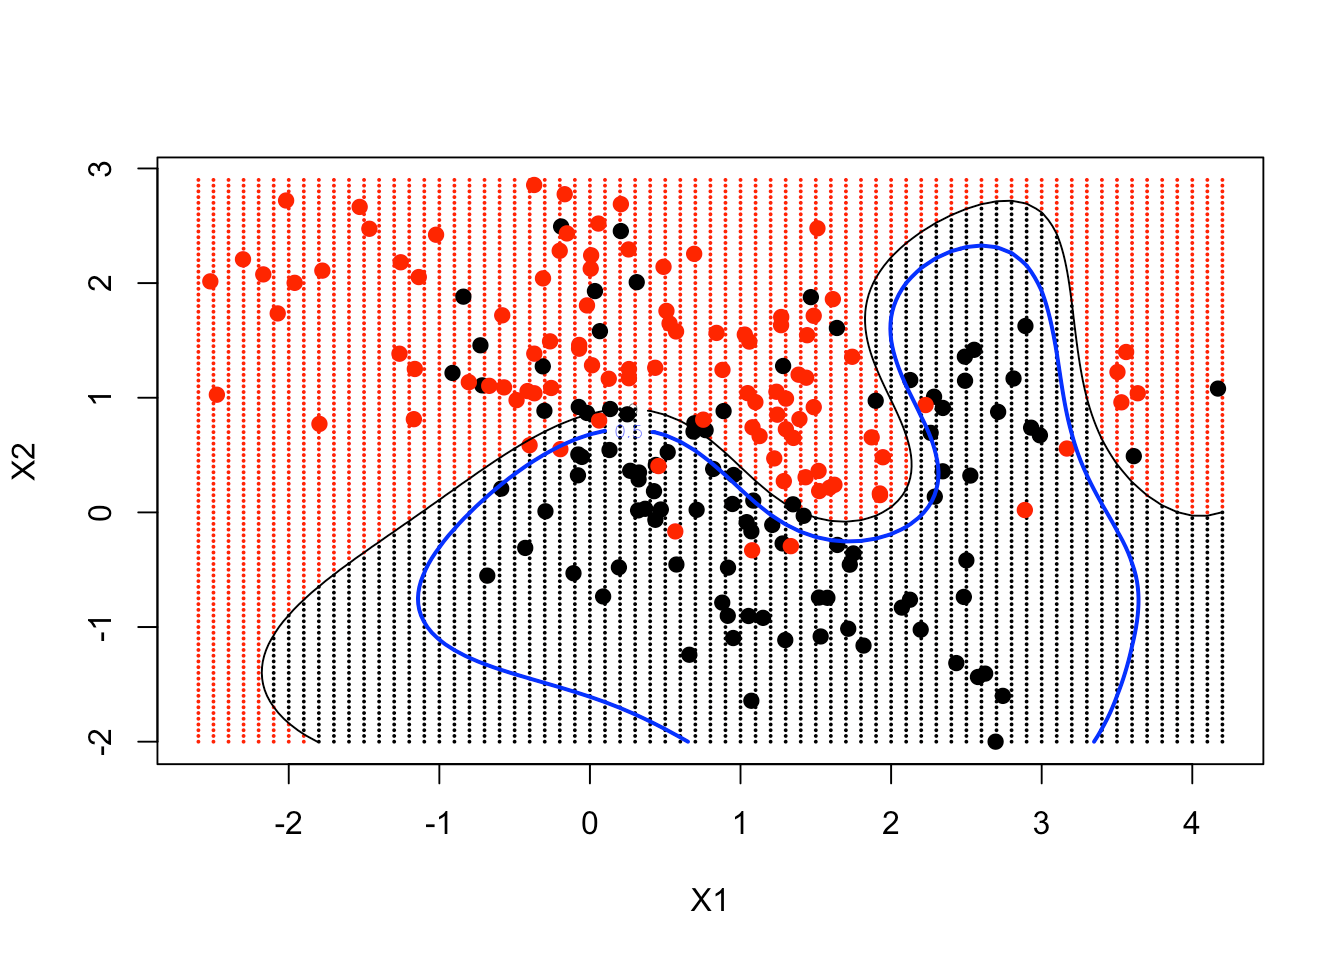
Sonuç olarak, doğrusal olmayan SVM’inizin Bayes Karar Sınırına oldukça yaklaştığını görebilirsiniz.
Özetle, Destek Vektör Makineleri, bir özellik uzayını iki veya daha fazla gruba ayırmaya çalışan denetimli sınıflandırıcıların bir alt sınıfıdır. Bunu, bilinen sınıf etiketlerine dayanarak bu grupları ayırmanın en iyi yolunu bularak başarırlar:
Şahsen, gruplar net bir şekilde ayrıldığında SVM’lerin belirli durumlar için harika sınıflandırıcılar olduğunu düşünüyorum. Veriniz doğrusal olmayan şekilde ayrıldığında da çok iyi iş çıkarırlar. Verileri doğrusal olarak ayırmak için dönüştürebilir veya SVM’lerin veriyi dönüştürüp iki sınıfı doğrudan kutudan çıktığı gibi doğrusal olarak ayırmasını sağlayabilirsiniz. SVM kullanmanın başlıca nedenlerinden biri budur. Doğrusal olmayan verileri kendiniz dönüştürmek zorunda kalmazsınız. SVM’lerin bir dezavantajı, bu fonksiyonların kara kutu doğasıdır. Doğrusal olmayan verileri ayırmak için çekirdek kullanımı onları yorumlamayı zor (hatta imkânsız) kılar. Onları anlamak, sınıflandırma için GLM’lere ve karar ağaçlarına alternatif sunacaktır. Umarım bu eğitim, SVM panoramasına daha geniş bir bakış açısı kazandırır ve bu makineleri daha iyi anlamanızı sağlar.
R hakkında daha fazla bilgi edinmek isterseniz, DataCamp’in Makine Öğrenimi Araç Kutusu kursunu alın.
Scikit-learn ile Destek Vektör Makineleri Eğitimimize göz atın.
R Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




