Cours
Introduction à R
4 h
3.1M
En apprentissage automatique, les machines à vecteurs de support (SVM) sont des modèles d'apprentissage supervisé, assortis d'algorithmes, qui analysent des données pour la classification et la régression. Elles sont toutefois surtout utilisées pour des problèmes de classification. Dans ce tutoriel, nous allons chercher à comprendre, de manière générale, le fonctionnement des SVM avant de les implémenter en R. Je mettrai l'accent sur l'intuition plutôt que sur la rigueur formelle. Concrètement, nous éviterons autant que possible les détails mathématiques pour développer une bonne intuition du principe de fonctionnement.
Les bases des SVM et leur fonctionnement s'expliquent mieux avec un exemple simple. Imaginons deux étiquettes : rouge et bleu, et des données avec deux variables : x et y. Nous voulons un classificateur qui, pour une paire de coordonnées (x, y), indique si c'est rouge ou bleu. Nous traçons nos données d'entraînement déjà étiquetées sur un plan :
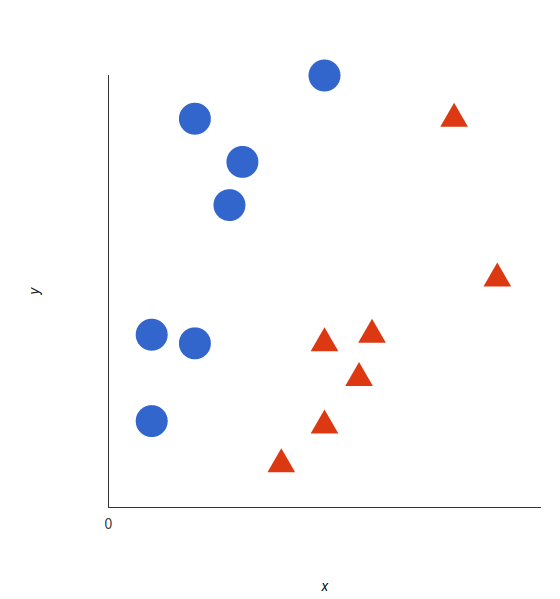
Un SVM prend ces points et renvoie l'hyperplan (en deux dimensions, c'est simplement une droite) qui sépare au mieux les étiquettes. Cette droite est la frontière de décision : tout ce qui tombe d'un côté sera classé bleu, et de l'autre rouge.
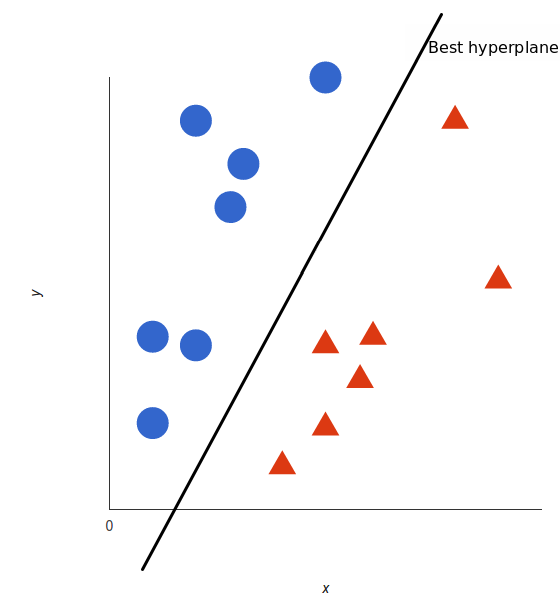
Mais qu'est-ce que le « meilleur » hyperplan ? Pour un SVM, c'est celui qui maximise les marges par rapport aux deux étiquettes. Autrement dit : l'hyperplan (ici une droite) dont la distance au point le plus proche de chaque étiquette est la plus grande.
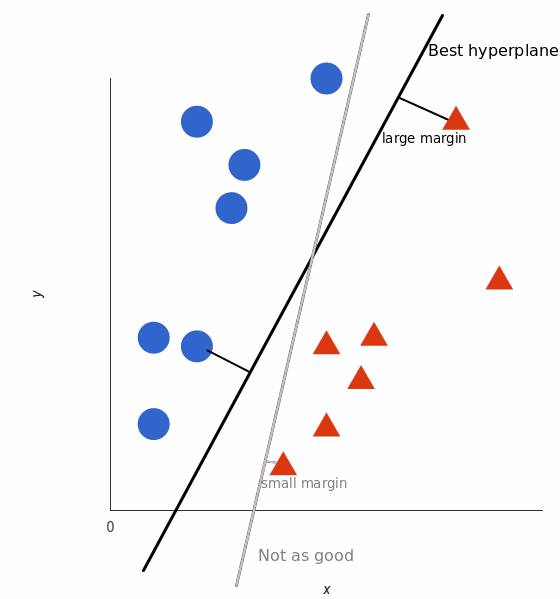
Dans l'exemple ci‑dessus, c'était simple car les données étaient linéairement séparables : on pouvait tracer une droite pour séparer rouge et bleu. Malheureusement, ce n'est pas toujours aussi facile. Regardez ce cas :
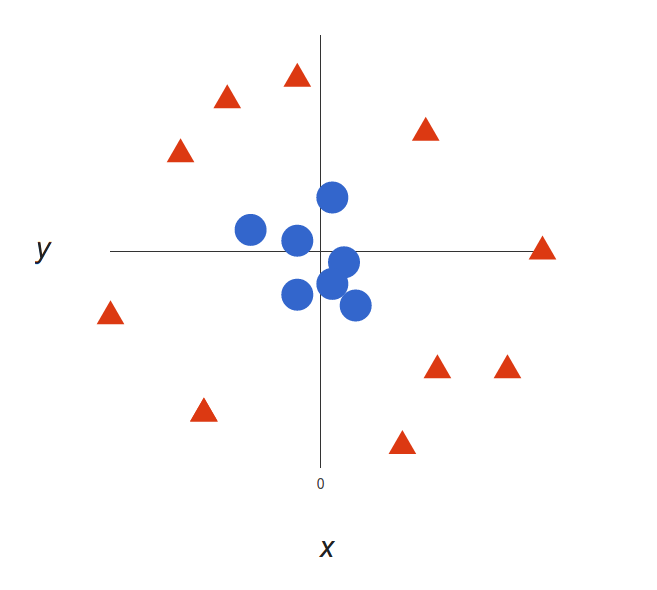
Il est clair qu'il n'existe pas de frontière de décision linéaire (une seule droite qui sépare les deux étiquettes). Pourtant, les vecteurs sont bien distincts, et on a l'impression qu'il devrait être facile de les séparer.
Voici ce que nous allons faire : ajouter une troisième dimension. Jusqu'ici, nous avions deux dimensions : $x$ et $y$. Nous créons une nouvelle dimension z, définie de manière commode pour nous : $z = x² + y²$ (vous remarquerez que c'est l'équation d'un cercle).
On obtient ainsi un espace tridimensionnel. Si l'on en prend une coupe, cela ressemble à ceci :
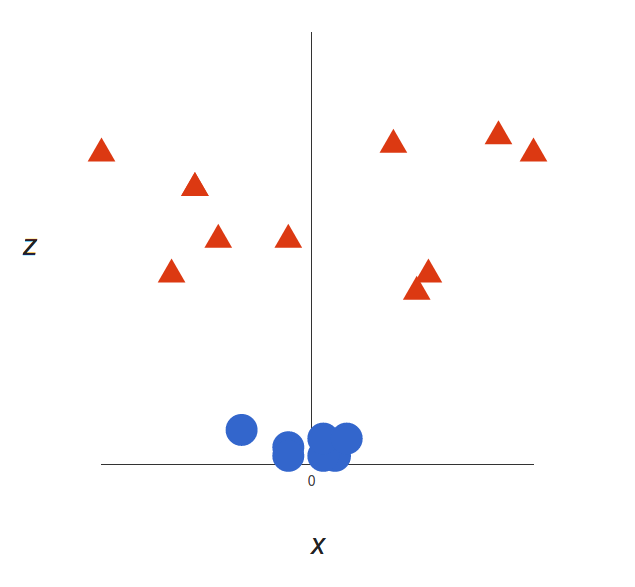
Que peut faire un SVM avec cela ? Voyons :
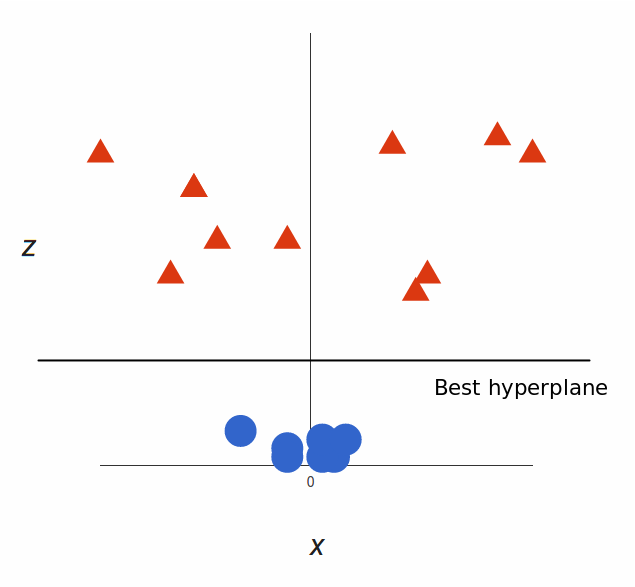
Parfait ! Notez que, comme nous sommes désormais en trois dimensions, l'hyperplan est un plan parallèle à l'axe $x$ pour une certaine valeur de $z$ (disons $z = 1$).
Il ne reste plus qu'à le ramener en deux dimensions :
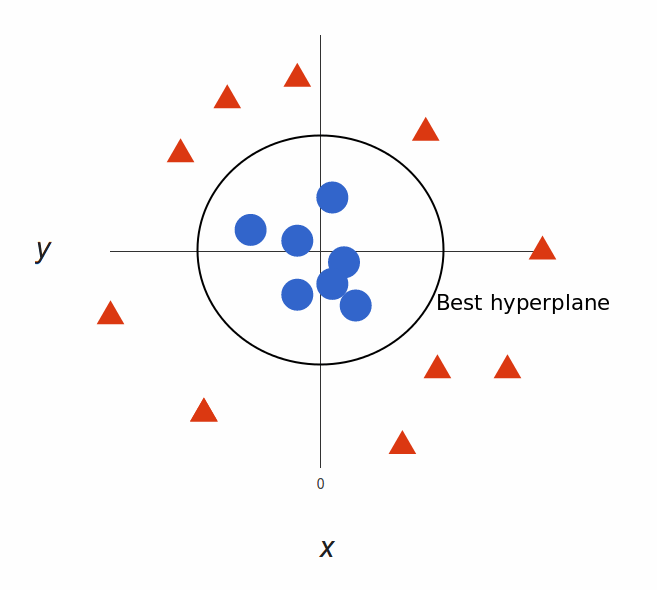
Et voilà ! Notre frontière de décision est une circonférence de rayon 1, qui sépare les deux étiquettes via un SVM.
Dans l'exemple ci‑dessus, nous avons réussi à classer des données non linéaires en projetant astucieusement l'espace dans une dimension supérieure. Cependant, calculer explicitement cette transformation peut devenir très coûteux en calcul : il peut y avoir de nombreuses nouvelles dimensions, chacune impliquant des calculs compliqués. Le faire pour chaque vecteur du jeu de données représente beaucoup de travail. Une solution moins coûteuse serait donc idéale.
L'astuce est la suivante : un SVM n'a pas besoin des vecteurs eux‑mêmes pour fonctionner, il peut se contenter de leurs produits scalaires. Cela signifie que nous pouvons contourner les calculs onéreux des nouvelles dimensions ! Voici la démarche :


C'est ce que l'on appelle l'astuce du noyau : elle enrichit l'espace des variables pour rendre possible une frontière non linéaire entre classes. Les noyaux les plus courants pour séparer des données non linéaires sont les noyaux polynomiaux, à base radiale (RBF) et linéaires (équivalents aux classificateurs à vecteurs de support). En pratique, ces noyaux transforment les données pour qu'un hyperplan linéaire puisse les séparer, et ainsi les classer.
Voyons maintenant quelques avantages et inconvénients des SVM :
Avantages
Haute dimension : les SVM sont efficaces dans des espaces de grande dimension, ce qui s'applique particulièrement à la classification de documents et à l'analyse de sentiments, où la dimensionnalité peut être très élevée.
Efficacité mémoire : comme seul un sous‑ensemble des points d'entraînement intervient dans la décision finale d'assignation, seuls ces points doivent être conservés (et utilisés dans les calculs) lors de la prédiction.
Polyvalence : la séparation entre classes est souvent nettement non linéaire. La possibilité d'appliquer différents noyaux offre une grande souplesse sur la forme de la frontière de décision, ce qui peut améliorer la performance de classification.
Inconvénients
Choix des paramètres de noyau : les SVM sont très sensibles au choix des paramètres du noyau. Lorsque le nombre de variables par observation dépasse le nombre d'exemples d'entraînement, les SVM peuvent mal se comporter. Intuitivement, si l'espace de caractéristiques de grande dimension est bien plus vaste que l'échantillon, il y a moins de vecteurs de support efficaces pour soutenir l'hyperplan optimal, ce qui dégrade la performance lorsque de nouveaux exemples sont ajoutés.
Non probabiliste : le classificateur sépare les objets de part et d'autre d'un hyperplan, sans fournir directement de probabilité d'appartenance. Un indicateur possible de « l'efficacité » de la classification est toutefois la distance au bord de décision pour un nouveau point.
Commençons par générer des données en 2 dimensions, légèrement séparées. Après avoir fixé la graine aléatoire, vous créez une matrice x issue d'une loi normale, avec 20 observations, 2 variables et 2 classes. Puis vous créez une variable y, valant -1 ou 1, avec 10 éléments dans chaque classe. Pour y = 1, vous déplacez les moyennes de 0 à 1 sur chacune des coordonnées. Enfin, vous tracez les données et colorez les points selon leur réponse. Le symbole de tracé 19 produit de gros points bien visibles, en bleu ou rouge selon que la réponse est 1 ou -1.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Chargez ensuite le package e1071 qui contient la fonction svm (pensez à l'installer si nécessaire).
library(e1071)Créez maintenant un data frame à partir des données, en transformant y en variable factorielle. Appelez ensuite svm sur ce data frame, avec y comme variable réponse et les autres variables comme prédicteurs. Le data frame aura déballé la matrice x en 2 colonnes nommées x1 et x2. Indiquez au SVM un noyau linéaire, un paramètre de coût égal à 10, et scale = FALSE. Dans cet exemple, vous demandez donc à ne pas standardiser les variables.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
Afficher svmfit donne un résumé. Vous pouvez voir que le nombre de vecteurs de support est 6 : ce sont les points proches de la frontière ou de son mauvais côté.
Il existe une fonction de tracé pour SVM qui montre la frontière de décision, comme ci‑dessous. Le contrôle des couleurs est limité. Elle rompt avec l'usage en mettant x2 en abscisse et x1 en ordonnée.
plot(svmfit, dat)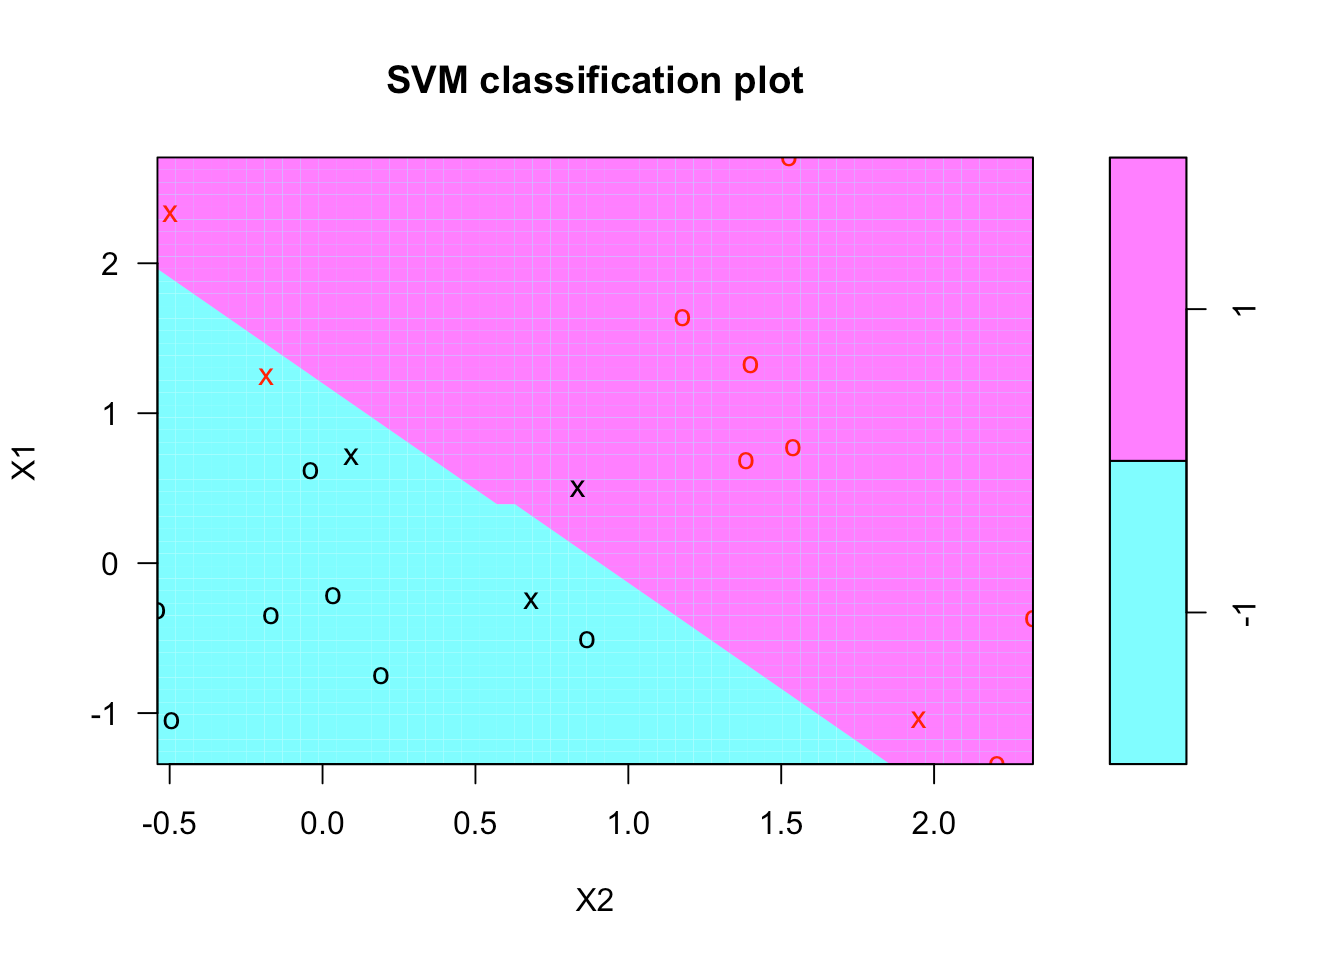
Essayons de réaliser notre propre tracé. Commencez par créer une grille (ou treillis) de valeurs pour x1 et x2 qui couvre tout le domaine avec une maille assez fine. Pour cela, définissez une fonction make.grid. Elle prend la matrice x et un argument n, le nombre de points par direction. Ici, nous demanderons une grille 75 × 75.
Dans cette fonction, utilisez la fonction apply pour obtenir l'intervalle de chaque variable de x. Pour x1 et x2, utilisez ensuite seq pour aller de la valeur minimale à la maximale et construire une grille de longueur n. Vous obtenez ainsi x1 et x2, chacun de longueur 75 avec des valeurs régulièrement espacées. Enfin, la fonction expand.grid construit le treillis à partir de x1 et x2.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Vous pouvez à présent appliquer make.grid à x. Observons les 10 premières lignes du treillis.
xgrid = make.grid(x)
xgrid[1:10,]
Comme vous le voyez, la grille parcourt d'abord la 1re coordonnée, en gardant la 2e fixe.
Une fois le treillis construit, effectuez une prédiction à chaque point de la grille. Avec les nouvelles données xgrid, utilisez predict et appelez la réponse ygrid. Tracez ensuite et colorez les points selon la classe prédite pour faire apparaître clairement la frontière de décision. Ajoutez aussi les points d'origine avec la fonction points.
svmfit possède un composant index qui indique quels sont les vecteurs de support. Incluez‑les dans le tracé en réutilisant points.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)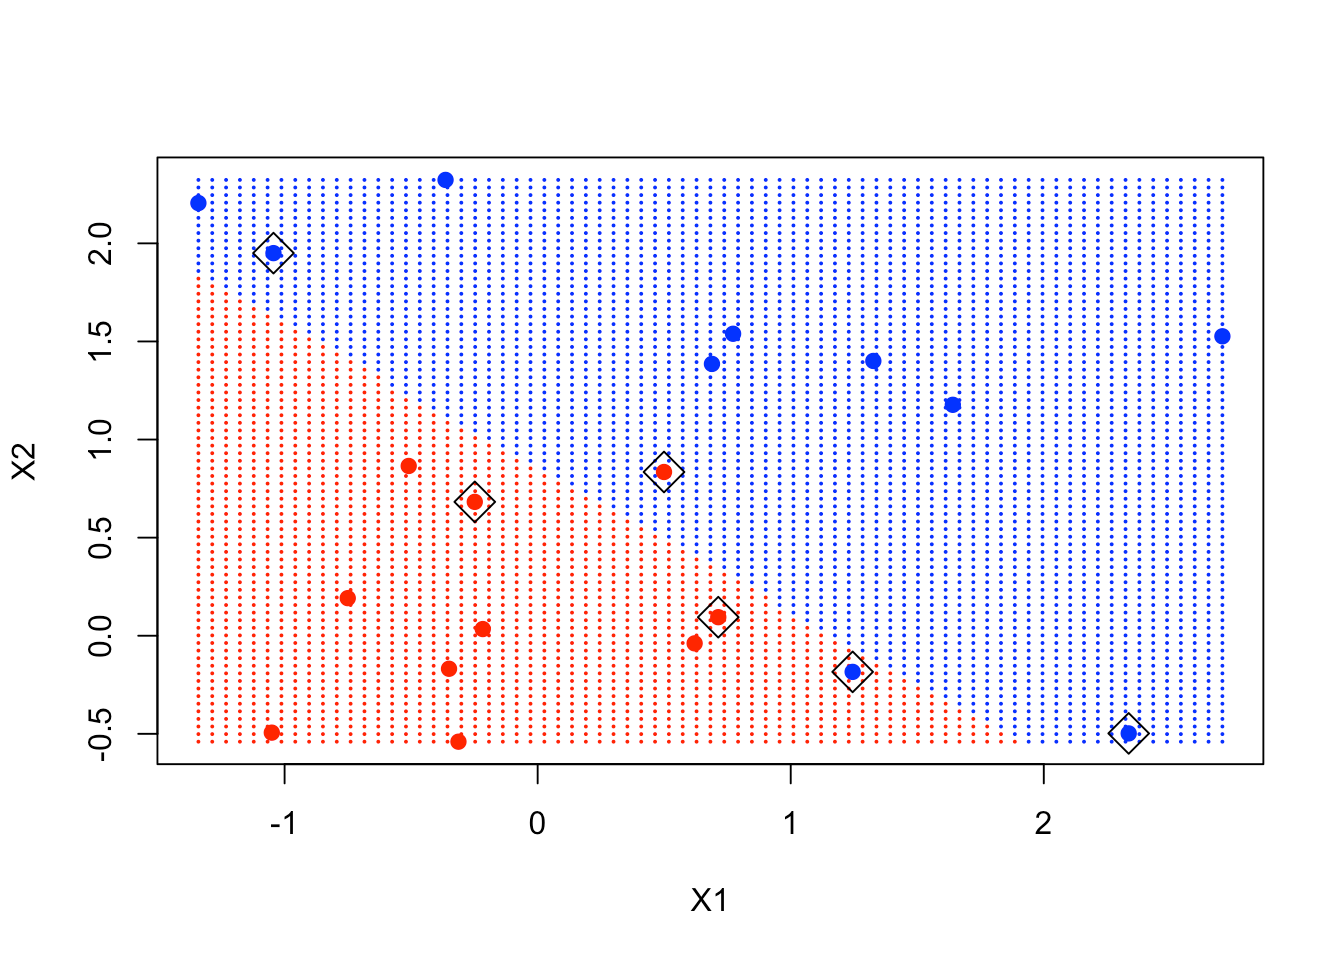
Comme le montre la figure, les points entourés sont proches de la frontière de décision et jouent un rôle déterminant pour la définir.
Malheureusement, la fonction svm n'est pas très commode pour récupérer les coefficients linéaires. Sans doute parce que cela n'a de sens que pour les noyaux linéaires, alors que la fonction est plus générale. Utilisons donc une formule pour extraire efficacement les coefficients. Vous extrayez beta et beta0, les coefficients linéaires.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Vous pouvez maintenant re‑tracer les points de la grille, puis ré‑ajouter les points (y compris les vecteurs de support). Ensuite, utilisez les coefficients pour dessiner la frontière de décision via une équation simple de la forme :
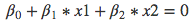
À partir de cette équation, déduisez la pente et l'ordonnée à l'origine de la frontière. Utilisez ensuite abline avec ces deux paramètres. Les deux appels suivants à abline représentent respectivement la marge supérieure et la marge inférieure de la frontière.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)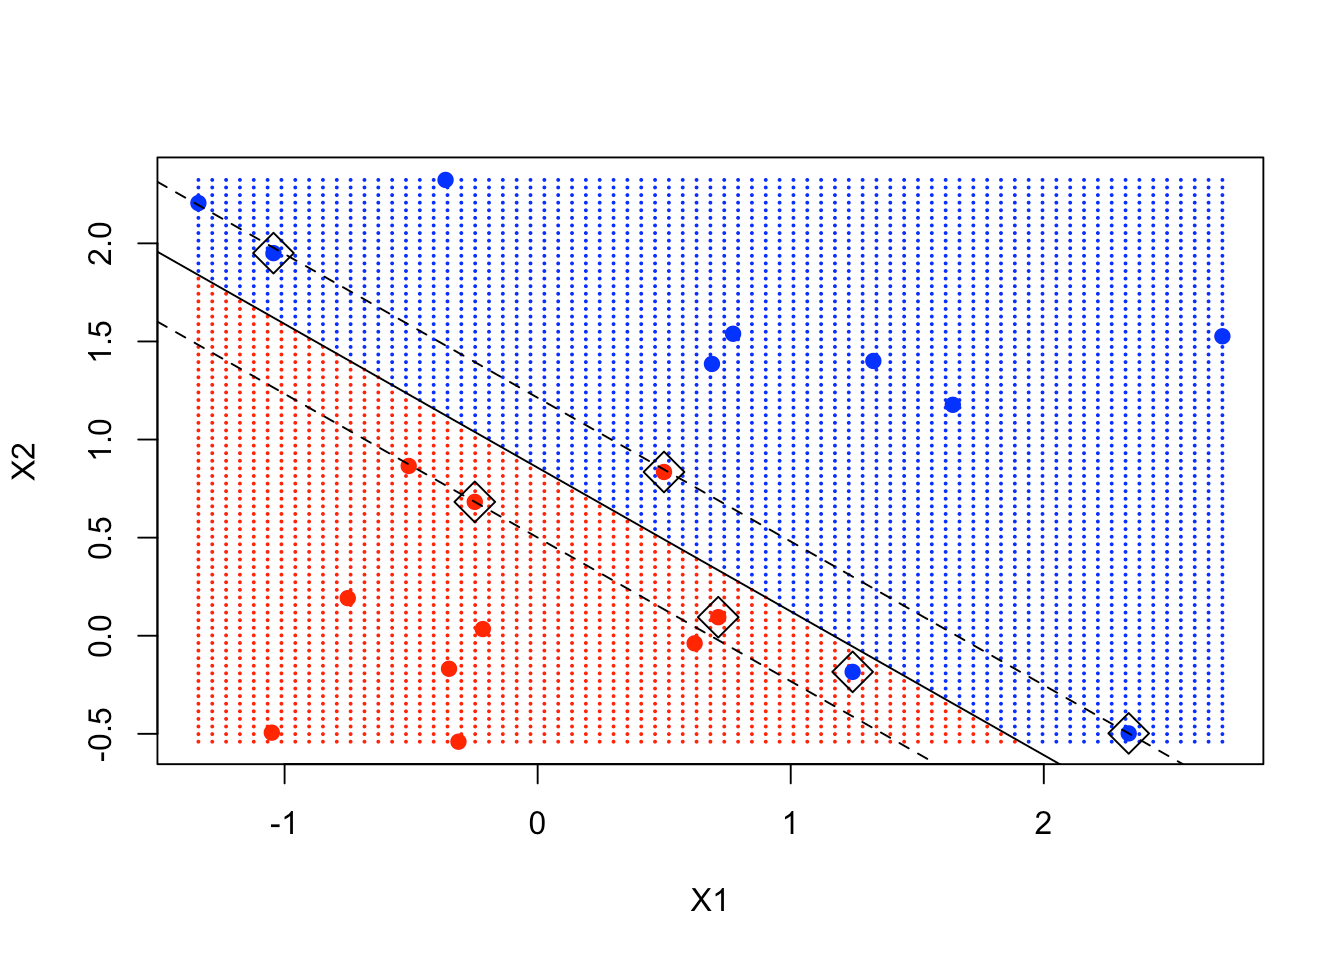
On voit clairement que certains vecteurs de support sont exactement sur la marge, tandis que d'autres sont à l'intérieur.
Nous avons vu la version linéaire. Passons maintenant au SVM non linéaire. Examinons un exemple tiré de l'ouvrage Elements of Statistical Learning, qui propose un exemple canonique en 2D où la frontière de décision est non linéaire. Nous allons utiliser un SVM à noyau pour apprendre cette frontière.
Commencez par récupérer les données de cet exemple directement depuis cette URL, la page où elles résident. Les données sont mélangées et simulées. Vous pouvez ensuite inspecter les noms de colonnes.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Pour l'instant, les données d'entraînement sont x et y. Vous avez déjà créé un x et un y dans l'exemple précédent. Supprimons‑les pour pouvoir attacher ce nouvel objet.
rm(x, y)
attach(ESL.mixture)
Les données sont également bidimensionnelles. Traçons‑les pour y voir clair.
plot(x, col = y + 1)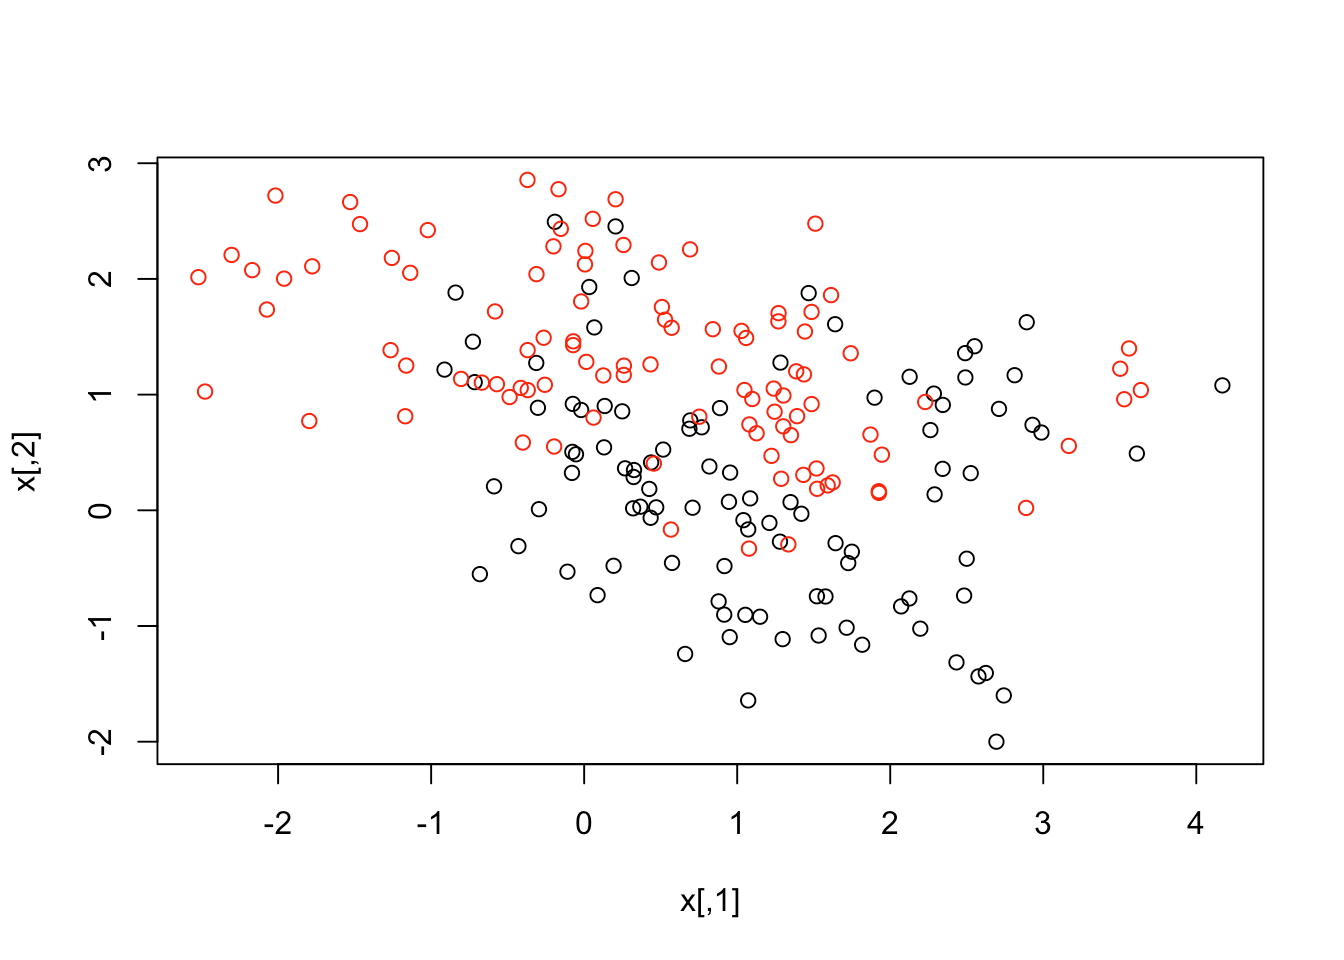
Les données semblent assez superposées, mais leur structure a quelque chose de particulier. Créons maintenant un data frame avec la réponse y, transformée en facteur. Puis ajustons un SVM avec noyau radial et un coût de 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Il est temps de créer une grille et de faire des prédictions. Ces données sont fournies avec des points de grille. Si vous regardez la liste de variables, vous verrez px1 et px2, qui forment la grille de valeurs pour chacune des variables. Vous pouvez utiliser expand.grid pour créer la grille, puis prédire la classe en chaque point.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Enfin, tracez les points en les colorant selon la frontière de décision. Vous constaterez que la frontière est non linéaire. Ajoutez aussi les points de données pour voir où ils se situent.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)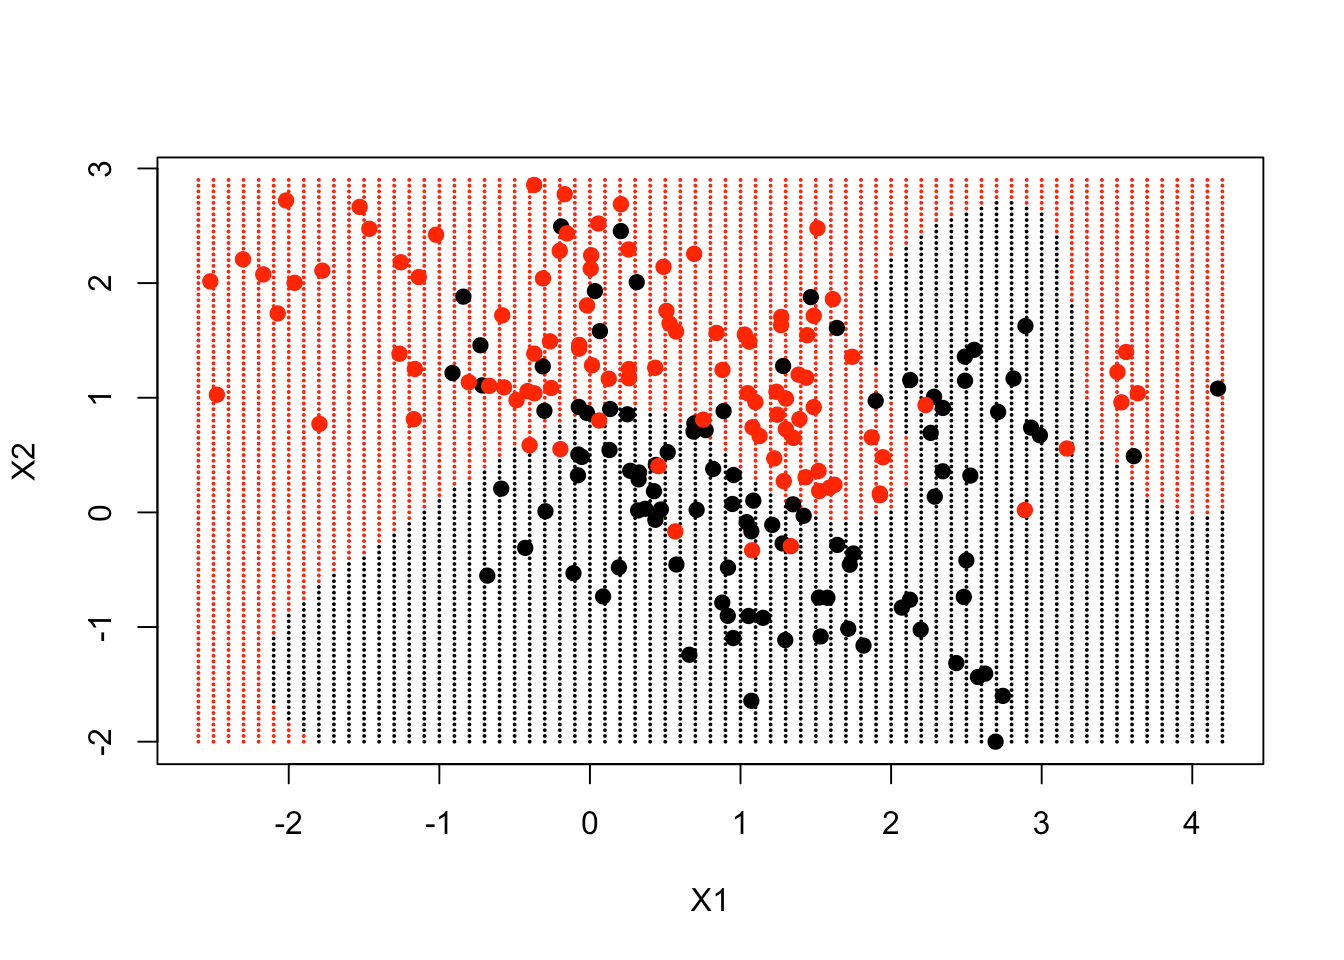
La frontière de décision suit largement la répartition des données, mais de façon très non linéaire.
Voyons si nous pouvons améliorer ce tracé et demander à la fonction de prédiction de renvoyer les valeurs de fonction aux points de la grille. En particulier, nous souhaitons ajouter une courbe représentant la frontière de décision à l'aide de contour. Dans le data frame, il y a aussi une variable prob, la probabilité vraie de la classe 1 pour ces données, aux points de la grille. Si vous tracez sa courbe de niveau 0,5, vous obtenez la frontière de décision de Bayes, c'est‑à‑dire la meilleure possible.
Commencez par prédire sur la grille avec decision.values = TRUE pour obtenir la fonction de décision, pas seulement la classe. La valeur renvoyée contient un attribut avec ces valeurs, que vous extrayez sous le nom decision.
Ensuite, reprenez les mêmes étapes : créer la grille, faire les prédictions et tracer les points.
Il est temps d'utiliser contour. Elle requiert les deux séquences de grille, une fonction et deux arguments level et add. Vous voulez la fonction sous forme de matrice, de dimensions px1 et px2 (69 et 99 respectivement). Fixez level = 0 et ajoutez‑la au tracé. Vous verrez que la courbe suit la frontière de décision, un moyen pratique de tracer une frontière non linéaire en 2D.
Enfin, ajoutez la vérité de terrain : la courbe de niveau des probabilités. C'est la courbe 0,5, qui serait la frontière de décision en termes de probabilités (également appelée frontière de décision de Bayes).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)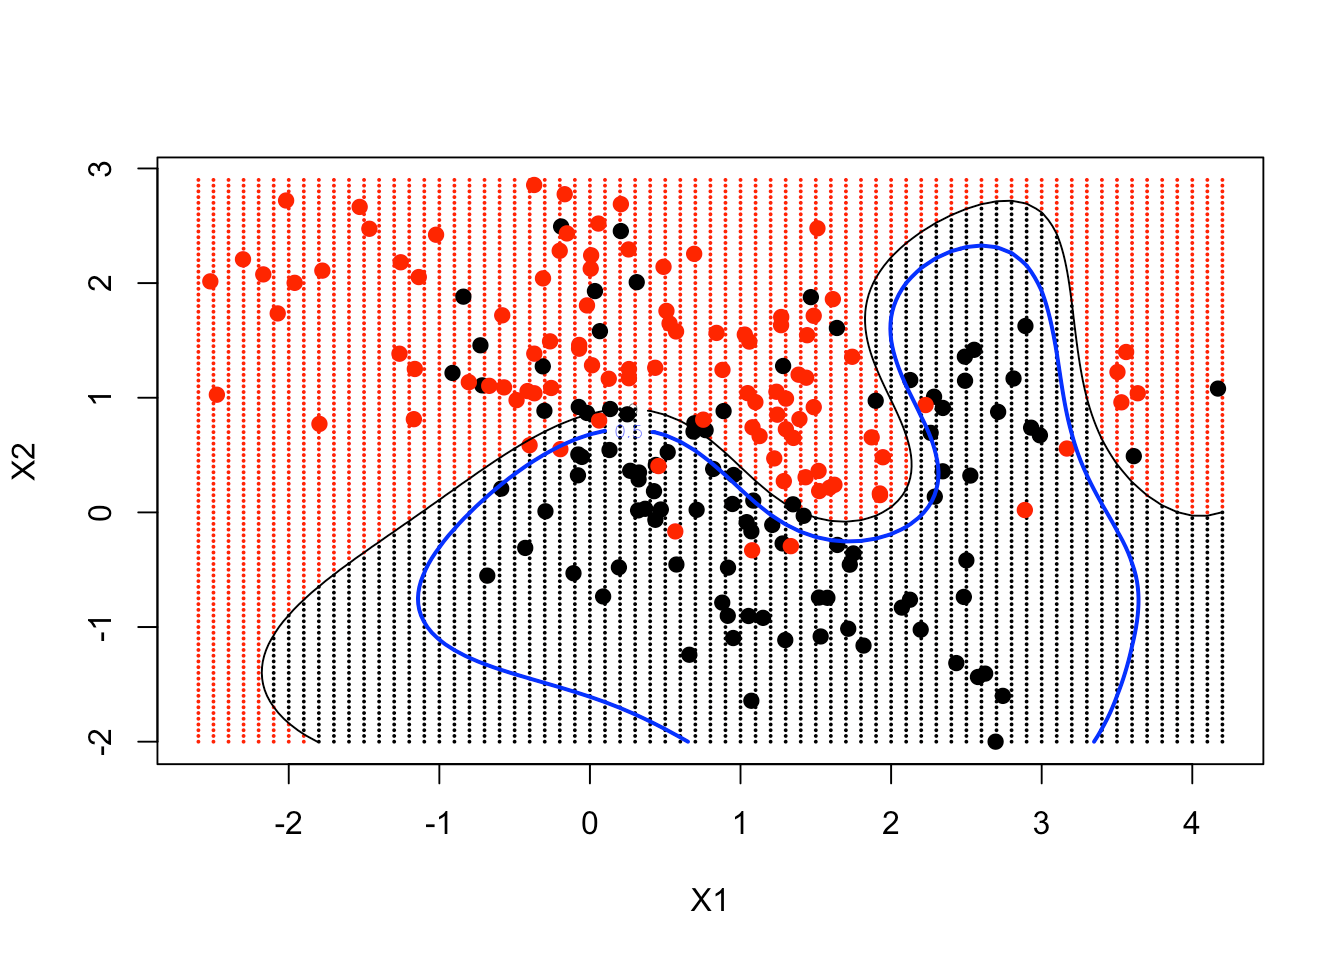
Vous pouvez constater que votre SVM non linéaire s'approche fortement de la frontière de décision de Bayes.
En résumé, les machines à vecteurs de support sont une sous‑catégorie de classificateurs supervisés qui cherchent à partitionner l'espace des variables en deux (ou plusieurs) groupes. Elles y parviennent en trouvant le meilleur moyen de séparer ces groupes à partir de leurs étiquettes connues :
À titre personnel, je trouve les SVM excellents lorsque les groupes sont nettement séparés. Ils fonctionnent aussi très bien quand la séparation est non linéaire. Vous pouvez soit transformer vos données pour obtenir une séparation linéaire, soit laisser les SVM convertir les données et séparer linéairement les deux classes dès le départ. C'est l'une des principales raisons d'utiliser des SVM : vous n'avez pas à transformer vous‑même des données non linéaires. Un inconvénient reste leur côté « boîte noire ». L'utilisation de noyaux pour séparer des données non linéaires les rend difficiles (voire impossibles) à interpréter. Les comprendre vous offrira une alternative aux GLM et aux arbres de décision pour la classification. J'espère que ce tutoriel vous donne une vision plus large du panorama des SVM et vous aidera à mieux les appréhender.
Pour aller plus loin avec R, suivez le cours Machine Learning Toolbox de DataCamp.
Découvrez aussi notre tutoriel SVM avec Scikit-learn.
Cours R
Cours
Cours
Cours