Kurs
Einführung in R
4 Std.
3.1M
Im maschinellen Lernen sind Support Vector Machines überwachtes Lernen mit zugehörigen Algorithmen, die Daten für Klassifikation und Regression analysieren. Meist werden sie jedoch für Klassifikationsaufgaben eingesetzt. In diesem Tutorial schauen wir uns an, wie SVMs grundsätzlich funktionieren, und implementieren sie anschließend in R. Der Fokus liegt auf Intuition statt Strenge. Heißt konkret: Wir lassen so viel Mathematik wie möglich weg und bauen ein starkes Bauchgefühl für das Funktionsprinzip auf.
Die Grundlagen von Support Vector Machines versteht man am besten an einem einfachen Beispiel. Stell dir vor, wir haben zwei Klassen: rot und blau, und unsere Daten haben zwei Merkmale: x und y. Wir wollen einen Klassifikator, der für ein Paar aus (x,y)-Koordinaten ausgibt, ob es rot oder blau ist. Wir zeichnen unsere bereits gelabelten Trainingsdaten in eine Ebene:
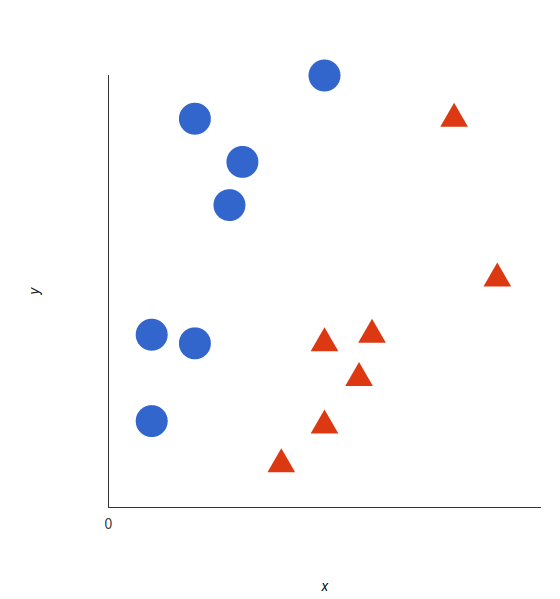
Eine Support Vector Machine nimmt diese Punkte und liefert die Hyperebene (in zwei Dimensionen ist das einfach eine Linie), die die Klassen am besten trennt. Diese Linie ist die Entscheidungsgrenze: Alles auf der einen Seite klassifizieren wir als blau, alles auf der anderen als rot.
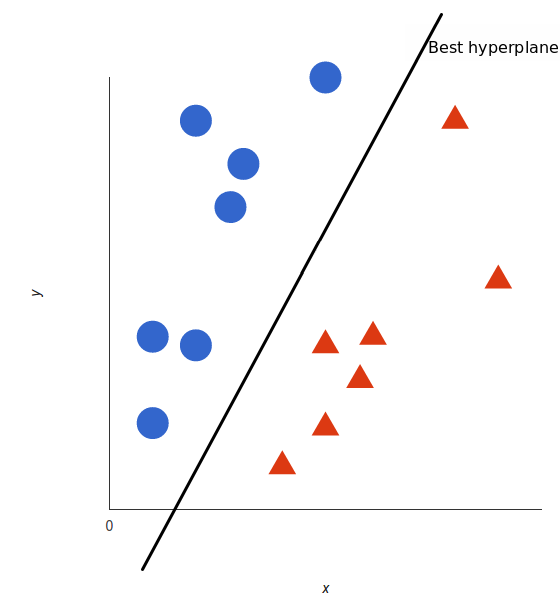
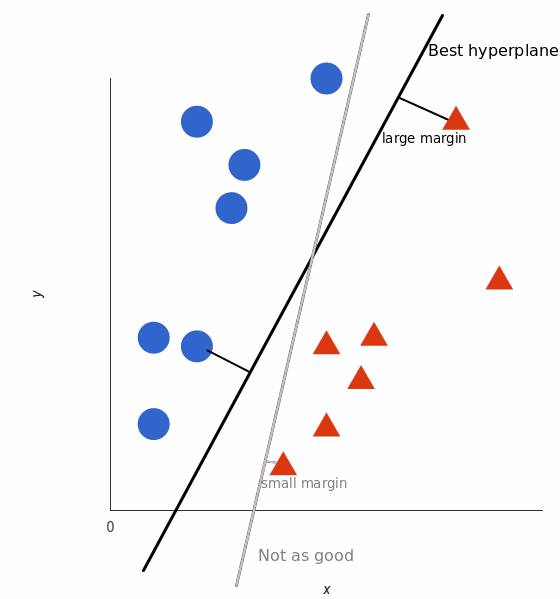
Aber was genau ist die beste Hyperebene? Für SVM ist es diejenige, die die Abstände zu beiden Klassen maximiert. Anders gesagt: die Hyperebene (hier also die Linie), deren Abstand zum jeweils nächsten Punkt beider Klassen am größten ist.
Das Beispiel oben war einfach, weil die Daten klar linear trennbar waren — eine gerade Linie konnte rot und blau separieren. In der Praxis ist es leider oft nicht so simpel. Schau dir diesen Fall an:
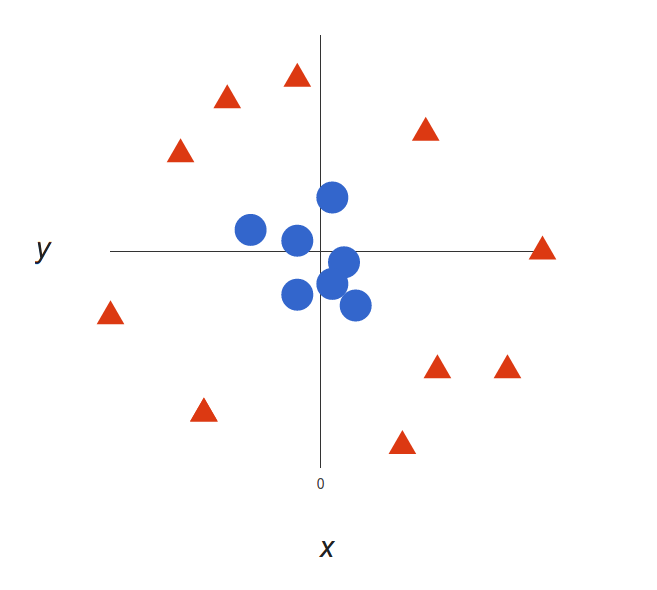
Es ist ziemlich klar, dass es hier keine lineare Entscheidungsgrenze gibt (keine einzelne gerade Linie, die beide Klassen trennt). Trotzdem sind die Vektoren deutlich getrennt, und es wirkt, als ließe sich das gut separieren.
Was tun wir also? Wir fügen eine dritte Dimension hinzu. Bisher hatten wir zwei Dimensionen: $x$ und $y$. Wir erzeugen eine neue z-Dimension und definieren sie auf eine für uns bequeme Weise: $z = x² + y²$ (du erkennst die Gleichung eines Kreises).
Damit erhalten wir einen dreidimensionalen Raum. Ein Schnitt durch diesen Raum sieht so aus:
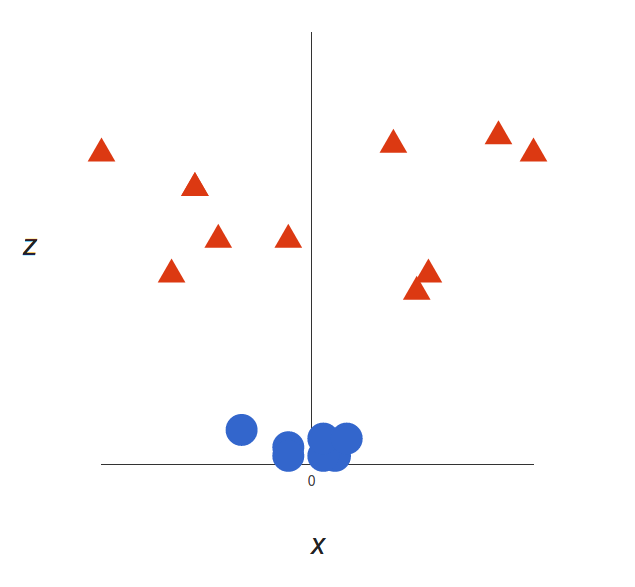
Was kann SVM damit anfangen? Schauen wir es uns an:
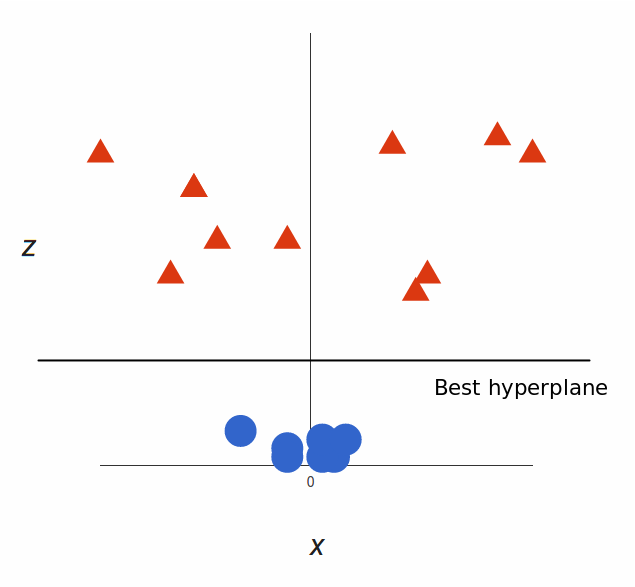
Großartig! Da wir nun in drei Dimensionen sind, ist die Hyperebene eine Ebene parallel zur $x$-Achse bei einem bestimmten $z$ (zum Beispiel $z = 1$).
Jetzt müssen wir nur noch zurück in zwei Dimensionen abbilden:
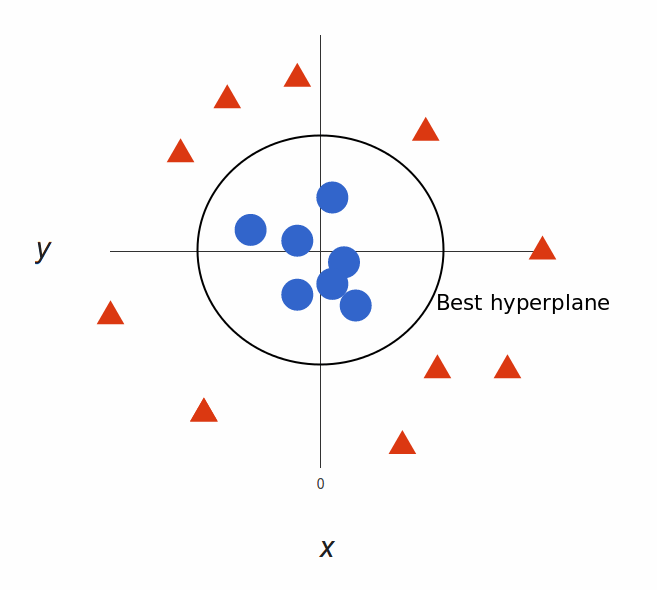
Und da ist sie! Unsere Entscheidungsgrenze ist ein Kreis mit Radius 1, der die beiden Klassen per SVM trennt.
Im obigen Beispiel konnten wir nichtlineare Daten klassifizieren, indem wir den Raum geschickt in eine höhere Dimension abgebildet haben. Diese Transformation zu berechnen kann allerdings sehr rechenintensiv werden: Es können viele neue Dimensionen entstehen, die jeweils komplizierte Berechnungen erfordern. Das für jeden Vektor im Datensatz zu tun, ist aufwendig — eine günstigere Lösung wäre also willkommen.
Hier kommt der Trick: SVM braucht für seine Magie nicht die eigentlichen Vektoren, sondern kommt mit ihren Skalarprodukten aus. Das bedeutet, wir können die teuren Berechnungen der neuen Dimensionen umgehen! Stattdessen machen wir Folgendes:


Das ist der Kernel-Trick: Er vergrößert den Merkmalsraum, um eine nichtlineare Grenze zwischen den Klassen zu ermöglichen. Häufige Kernel-Typen für nichtlineare Daten sind polynomiale Kernel, Radial-Basis-Kernel und lineare Kernel (entsprechen Support Vector Classifiers). Kurz gesagt transformieren diese Kernel unsere Daten so, dass eine lineare Hyperebene möglich wird und wir dadurch klassifizieren können.
Schauen wir uns nun einige Vorteile und Nachteile von SVM an:
Vorteile
Hohe Dimensionalität: SVM ist in hochdimensionalen Räumen sehr effektiv, was besonders für Dokumentklassifikation und Sentiment-Analyse gilt, wo die Dimensionalität extrem groß sein kann.
Speichereffizienz: Da nur ein Teil der Trainingspunkte für die eigentliche Entscheidung herangezogen wird, müssen beim Vorhersagen lediglich diese Punkte im Speicher gehalten und berechnet werden.
Vielseitigkeit: Klassengrenzen sind oft stark nichtlinear. Durch die Wahl unterschiedlicher Kernel lassen sich Entscheidungsgrenzen flexibel anpassen, was die Klassifikationsleistung verbessert.
Nachteile
Wahl der Kernel-Parameter: SVMs reagieren sehr empfindlich auf die Wahl der Kernel-Parameter. Wenn die Anzahl der Merkmale pro Objekt die Zahl der Trainingsbeispiele übersteigt, kann SVM schlecht abschneiden. Intuitiv: Ist der hochdimensionale Merkmalsraum viel größer als die Stichprobe, gibt es weniger effektive Support-Vektoren, um die optimalen linearen Hyperebenen zu stützen — mit sinkender Leistung, sobald neue, unbekannte Beispiele hinzukommen.
Nicht-probabilistisch: Da der Klassifikator Objekte ober- oder unterhalb einer Hyperebene platziert, gibt es keine direkte probabilistische Interpretation der Klassenzugehörigkeit. Ein mögliches Maß für die „Stärke“ der Zuordnung ist jedoch der Abstand des neuen Punkts zur Entscheidungsgrenze.
Erzeugen wir zunächst in zwei Dimensionen einige Daten und trennen sie leicht. Nach dem Setzen des Zufallssamens erstellst du die Matrix x mit normalverteilten Werten: 20 Beobachtungen in 2 Klassen auf 2 Variablen. Dann erzeugst du eine Variable y, die entweder -1 oder 1 ist, mit je 10 pro Klasse. Für y = 1 verschiebst du die Mittelwerte in beiden Koordinaten von 0 auf 1. Abschließend plottest du die Daten und färbst die Punkte nach ihrer Klasse ein. Das Plot-Symbol 19 liefert große, gut sichtbare Punkte, blau oder rot, je nachdem ob die Antwort -1 oder 1 ist.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Nun lädst du das Paket e1071, das die Funktion svm enthält (denk daran, das Paket vorher zu installieren, falls noch nicht geschehen).
library(e1071)Jetzt erstellst du ein Data Frame aus den Daten und wandelst y in einen Faktor um. Danach rufst du svm auf diesem Data Frame auf, wobei y die Zielvariable ist und die übrigen Variablen die Prädiktoren sind. Das Data Frame entpackt die Matrix x in zwei Spalten namens x1 und x2. Du gibst SVM an, dass der Kernel linear ist, der Tuning-Parameter cost 10 beträgt und scale gleich false ist. In diesem Beispiel lässt du die Variablen also unstandardisiert.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
Das Ausdrucken von svmfit liefert die Zusammenfassung. Du siehst, dass die Anzahl der Support-Vektoren 6 beträgt — das sind die Punkte nahe der Grenze oder auf der falschen Seite der Grenze.
Es gibt eine Plot-Funktion für SVM, die die Entscheidungsgrenze zeigt, wie unten zu sehen. Viel Kontrolle über die Farben scheint es nicht zu geben. Zudem weicht sie von der Konvention ab, da sie x2 auf die horizontale und x1 auf die vertikale Achse legt.
plot(svmfit, dat)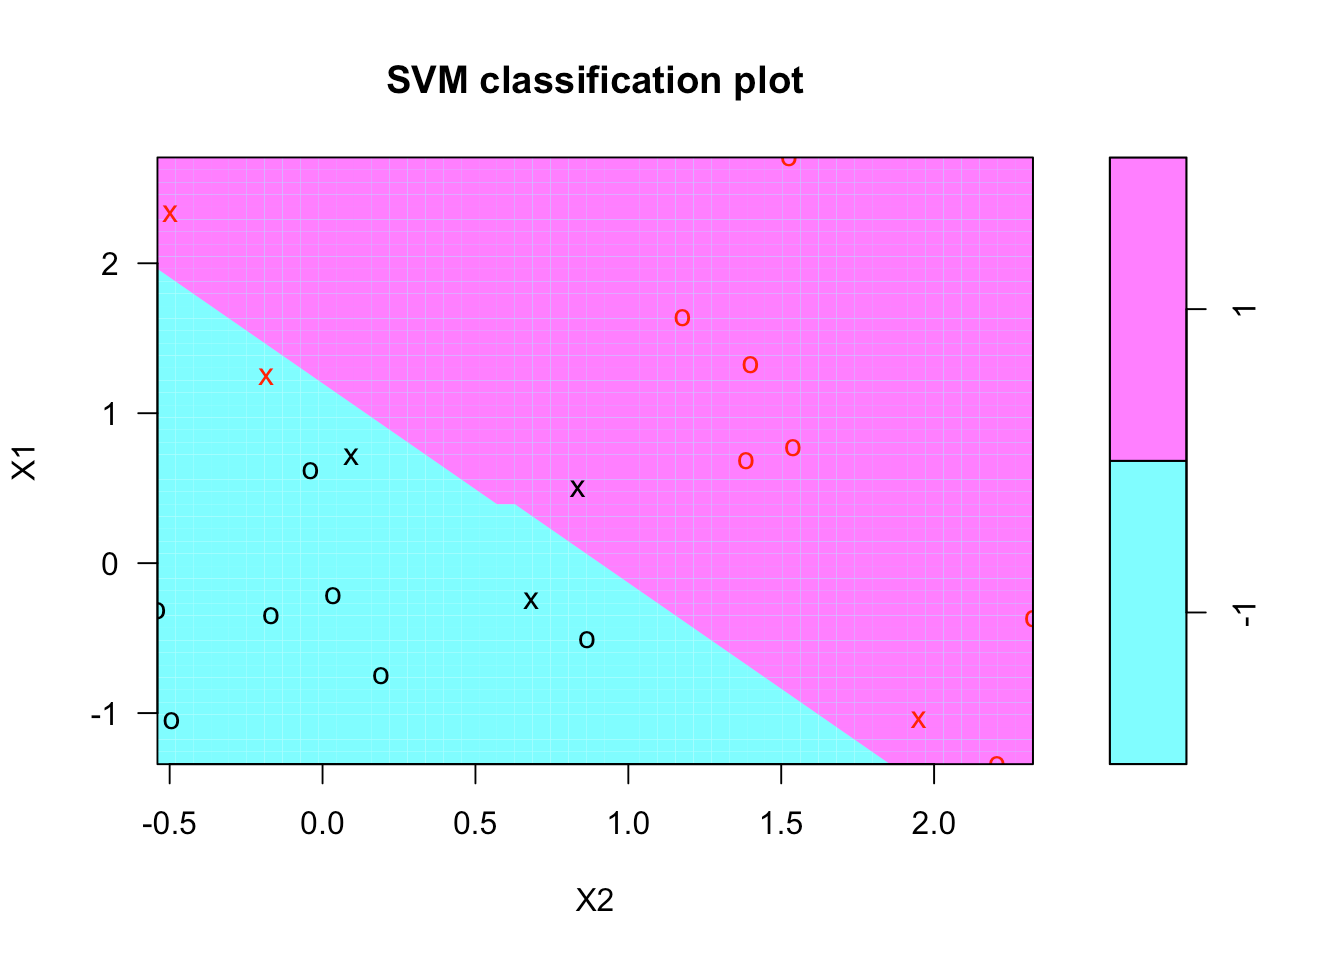
Versuchen wir, den Plot selbst zu erstellen. Zuerst erzeugen wir ein Gitter von Werten (Lattice) für x1 und x2, das den gesamten Bereich relativ fein abdeckt. Dazu schreiben wir eine Funktion make.grid. Sie nimmt die Datenmatrix x und ein Argument n, die Anzahl der Punkte je Richtung. Hier verwenden wir ein 75 x 75 Gitter.
In der Funktion nutzt du die apply-Funktion, um den Wertebereich jeder Variablen in x zu bestimmen. Für x1 und x2 erzeugst du dann mit seq jeweils Sequenzen vom Minimum bis zum Maximum der Länge n. Damit hast du für x1 und x2 jeweils 75 gleichmäßig verteilte Werte. Abschließend nutzt du expand.grid, das aus x1 und x2 das Lattice erzeugt.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Jetzt kannst du make.grid auf x anwenden. Schauen wir uns die ersten zehn Gitterpunkte an.
xgrid = make.grid(x)
xgrid[1:10,]
Wie du siehst, läuft das Gitter zuerst die 1. Koordinate durch, während die 2. fixiert bleibt.
Mit dem Lattice triffst du nun an jedem Gitterpunkt eine Vorhersage. Mit den neuen Daten xgrid nutzt du predict und nennst die Antwort ygrid. Anschließend plottest und färbst du die Punkte nach der Klassifikation, sodass die Entscheidungsgrenze sichtbar wird. Die Originalpunkte fügen wir mit points hinzu.
svmfit hat eine Komponente index, die anzeigt, welche Punkte Support-Vektoren sind. Diese fügen wir per points ebenfalls hinzu.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)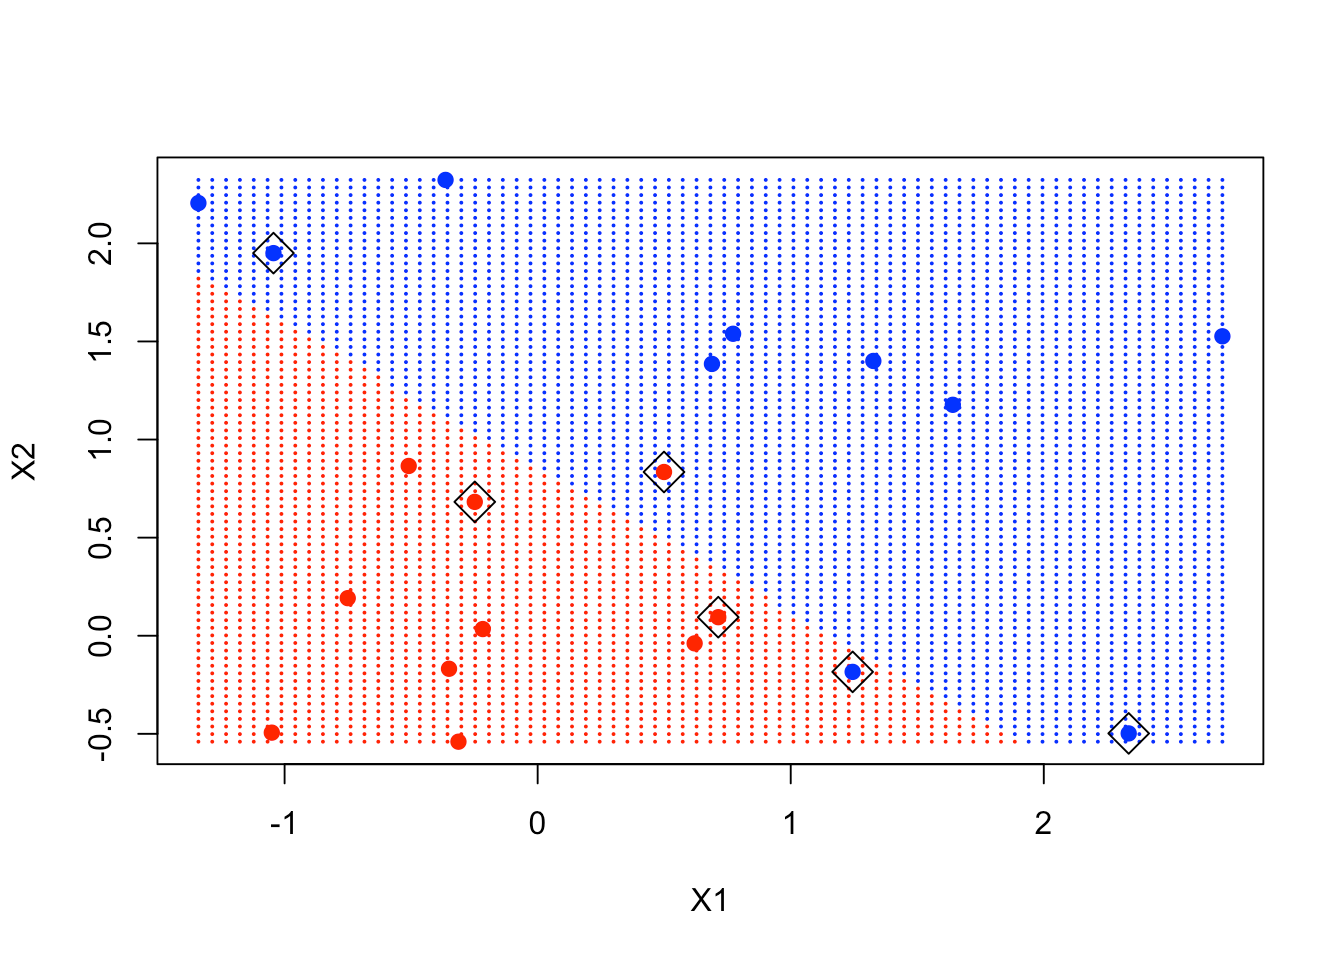
Wie du im Plot siehst, liegen die Punkte in den Kästchen nahe an der Entscheidungsgrenze und sind maßgeblich für deren Verlauf.
Leider ist die Funktion svm nicht besonders komfortabel, wenn man die linearen Koeffizienten zurückhaben möchte. Vermutlich, weil das nur für lineare Kernel sinnvoll ist und die Funktion allgemeiner gehalten ist. Also nutzen wir eine Formel, um die Koeffizienten effizienter zu extrahieren. Wir holen uns beta und beta0, die linearen Koeffizienten.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Jetzt können wir die Punkte im Gitter erneut plotten, dann die Originalpunkte (inklusive Support-Vektoren) darüberlegen. Anschließend zeichnen wir mit den Koeffizienten die Entscheidungsgrenze anhand einer einfachen Gleichung der Form:
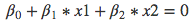
Aus der Gleichung leitest du Steigung und Achsenabschnitt der Entscheidungsgrenze ab. Dann nutzt du abline mit diesen beiden Argumenten. Die zwei folgenden abline-Aufrufe zeichnen die obere und untere Margin der Entscheidungsgrenze.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)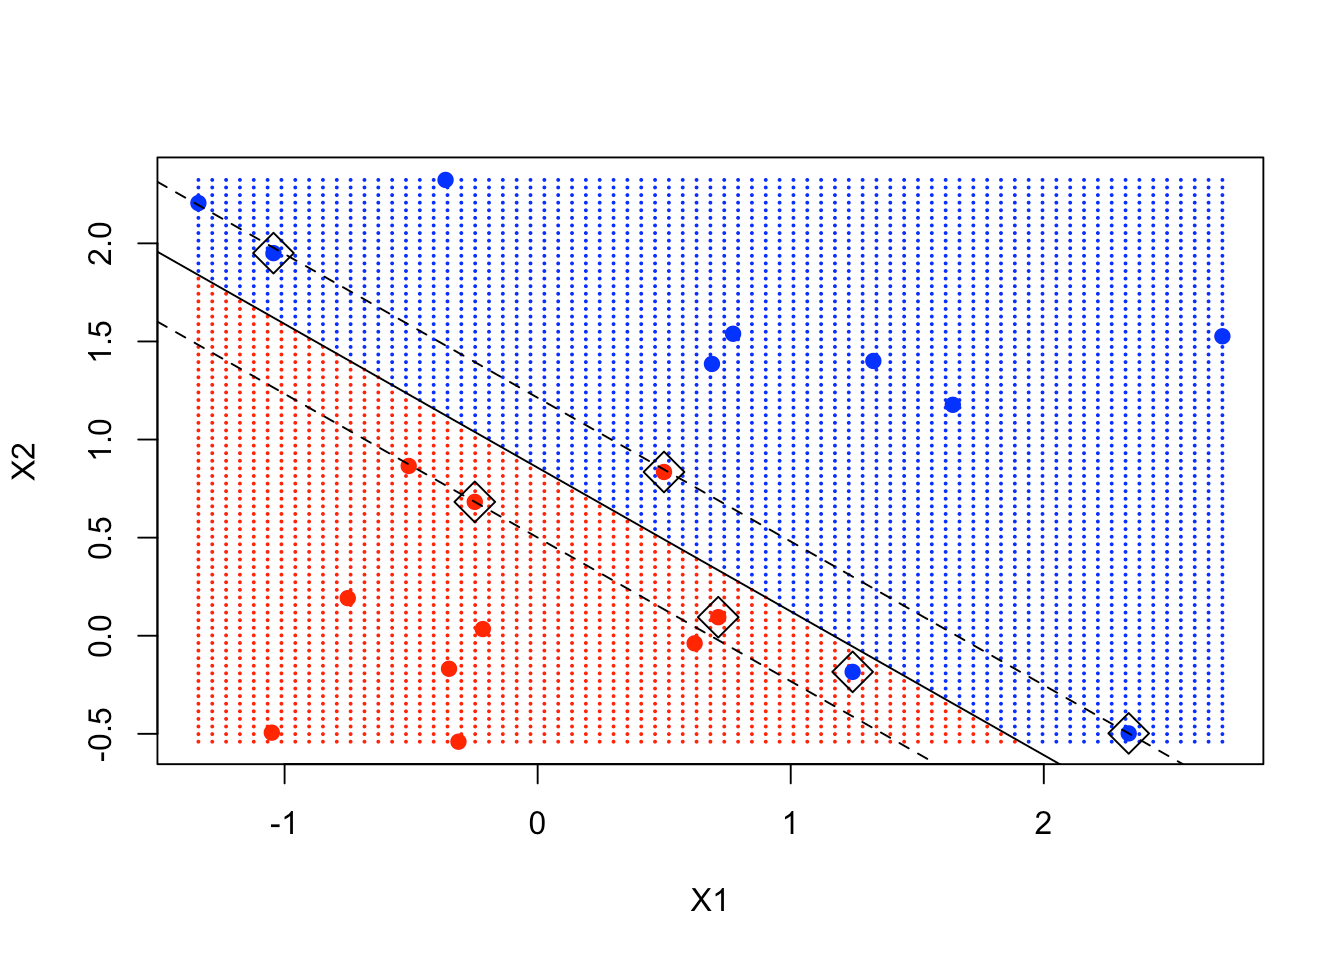
Deutlich zu sehen: Einige Support-Vektoren liegen genau auf der Margin, andere innerhalb der Margin.
Das war der lineare SVM im vorigen Abschnitt. Jetzt gehen wir zur nichtlinearen Variante über. Wir betrachten ein Beispiel aus dem Lehrbuch Elements of Statistical Learning mit einem kanonischen 2D-Beispiel, in dem die Entscheidungsgrenze nichtlinear ist. Wir nutzen die Kernel-SVM, um diese Grenze zu lernen.
Zuerst lädst du die Daten aus dem Lehrbuch direkt von dieser URL, der Webseite, auf der sie liegen. Die Daten sind gemischt und simuliert. Danach kannst du dir die Spaltennamen ansehen.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Momentan heißen die Trainingsdaten x und y. Du hast bereits ein x und y aus dem vorherigen Beispiel im Workspace. Also entfernen wir diese, damit wir die neuen Daten anhängen können.
rm(x, y)
attach(ESL.mixture)
Die Daten sind ebenfalls zweidimensional. Plotten wir sie, um einen Eindruck zu bekommen.
plot(x, col = y + 1)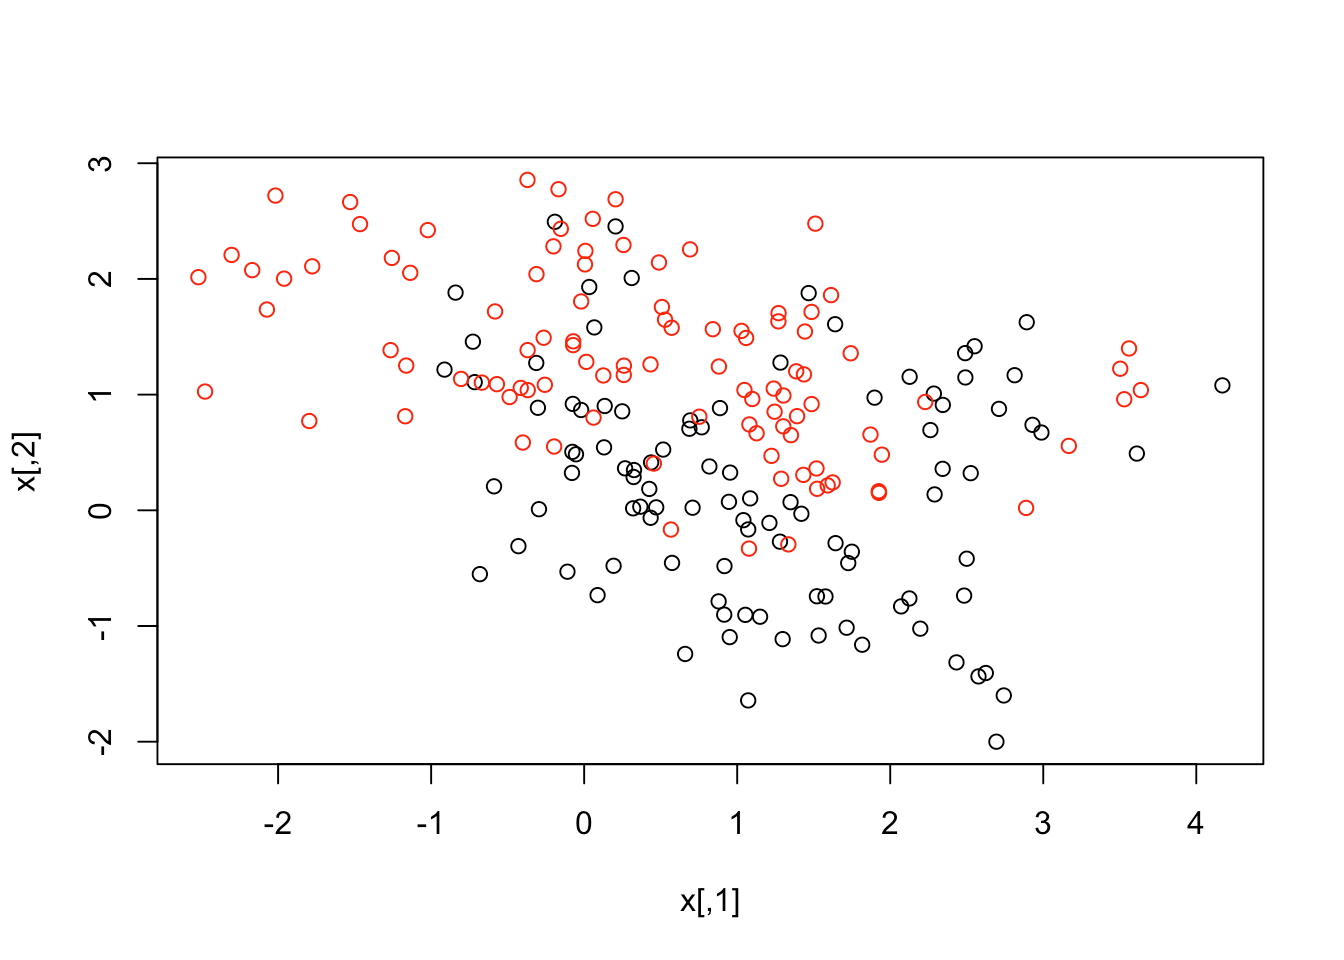
Die Daten überlappen sich recht stark, aber man erkennt eine besondere Struktur. Erstellen wir nun ein Data Frame mit der Antwort y und wandeln sie in einen Faktor um. Danach fitten wir eine SVM mit radialem Kernel und cost = 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Jetzt erzeugen wir ein Gitter und machen Vorhersagen. Diese Daten bringen bereits Gitterpunkte mit. In der Liste siehst du die Variablen px1 und px2, die Gitterwerte für die beiden Merkmale. Mit expand.grid erzeugst du das Gitter und sagst dann die Klasse an jedem Gitterpunkt voraus.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Zum Schluss plottest du die Punkte und färbst sie entsprechend der Entscheidungsgrenze ein. Du erkennst deutlich, dass die Grenze nichtlinear ist. Lege zusätzlich die Originaldaten in den Plot, um zu sehen, wo sie liegen.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)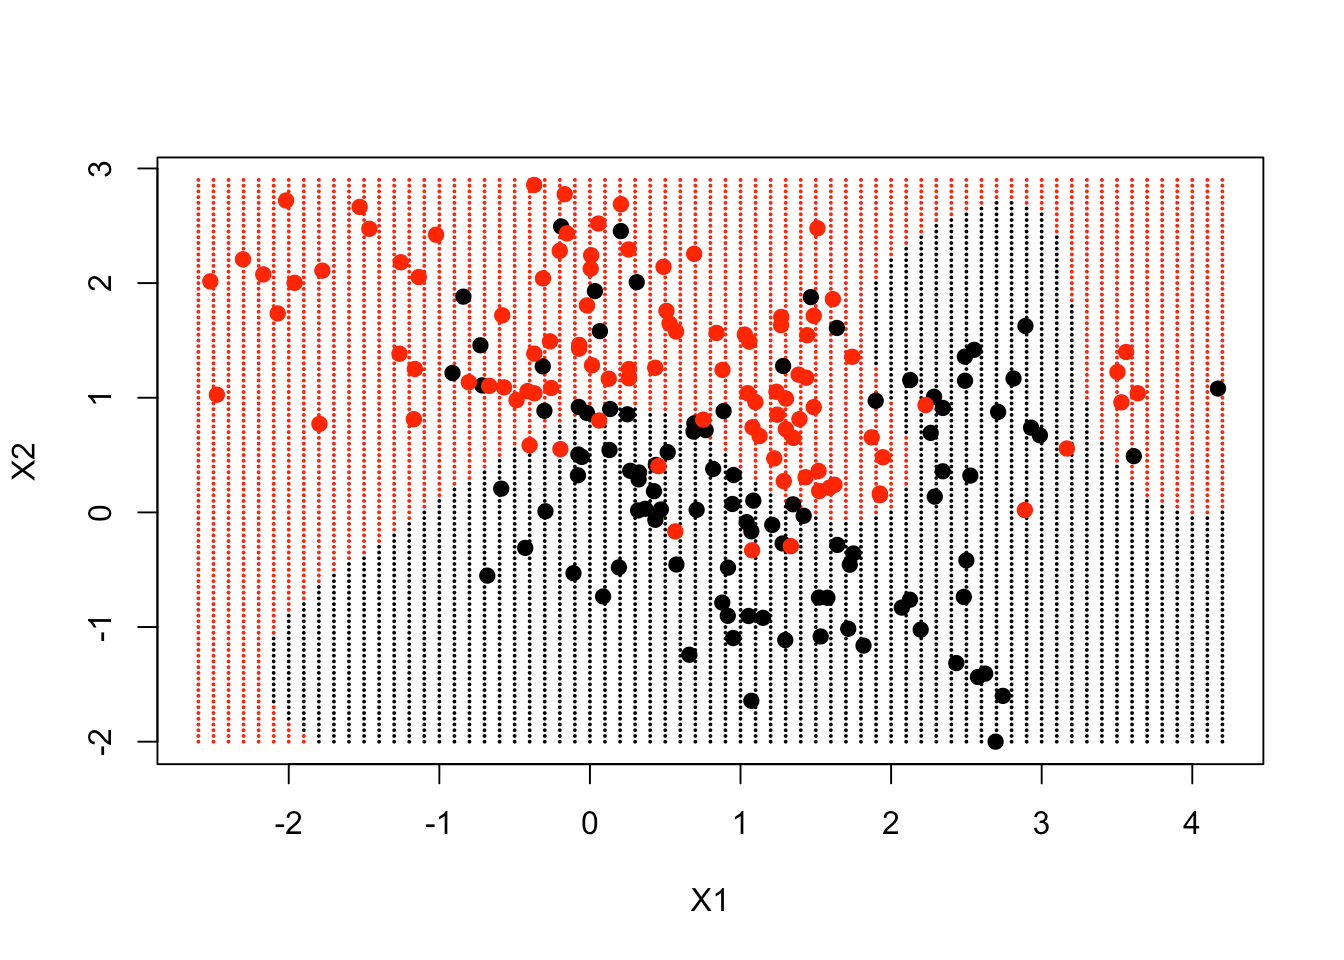
Die Entscheidungsgrenze folgt weitgehend der Datenstruktur — allerdings auf sehr nichtlineare Weise.
Schauen wir, ob wir den Plot weiter verbessern können, indem die Predict-Funktion die eigentlichen Funktionswerte an den Gitterpunkten liefert. Wir wollen insbesondere eine Kurve der Entscheidungsgrenze mit der Funktion contour einzeichnen. Im Data Frame gibt es außerdem die Variable prob, die die wahre Wahrscheinlichkeit für Klasse 1 an den Gitterpunkten enthält. Zeichnest du deren 0,5-Kontur, erhältst du die Bayes-Entscheidungsgrenze — die bestmögliche Grenze.
Zuerst sagst du dein Fit auf dem Gitter voraus. Mit decision.values = TRUE bittest du um die eigentlichen Funktionswerte, nicht nur die Klassen. Diese werden als Attribut der klassifizierten Werte zurückgegeben, also musst du dieses Attribut abgreifen. Dann greifst du auf „decision“ zu.
Anschließend wiederholst du die Schritte: Gitter erzeugen, Vorhersagen treffen und Punkte plotten.
Jetzt kommt contour zum Einsatz. Die Funktion benötigt die beiden Gittersequenzen, eine Matrix der Funktionswerte sowie die Argumente level und add. Du brauchst die Funktionswerte als Matrix mit den Dimensionen von px1 und px2 (69 bzw. 99). Setze level = 0 und füge die Kontur dem Plot hinzu. Du siehst, wie die Kontur die Entscheidungsgrenze nachzeichnet — eine praktische Art, eine nichtlineare Grenze in 2D zu visualisieren.
Zum Schluss fügen wir die „Wahrheit“ hinzu: die Kontur der Wahrscheinlichkeiten. Das ist die 0,5-Kontur, also die Entscheidungsgrenze im Sinne der Wahrscheinlichkeiten (auch Bayes-Entscheidungsgrenze genannt).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)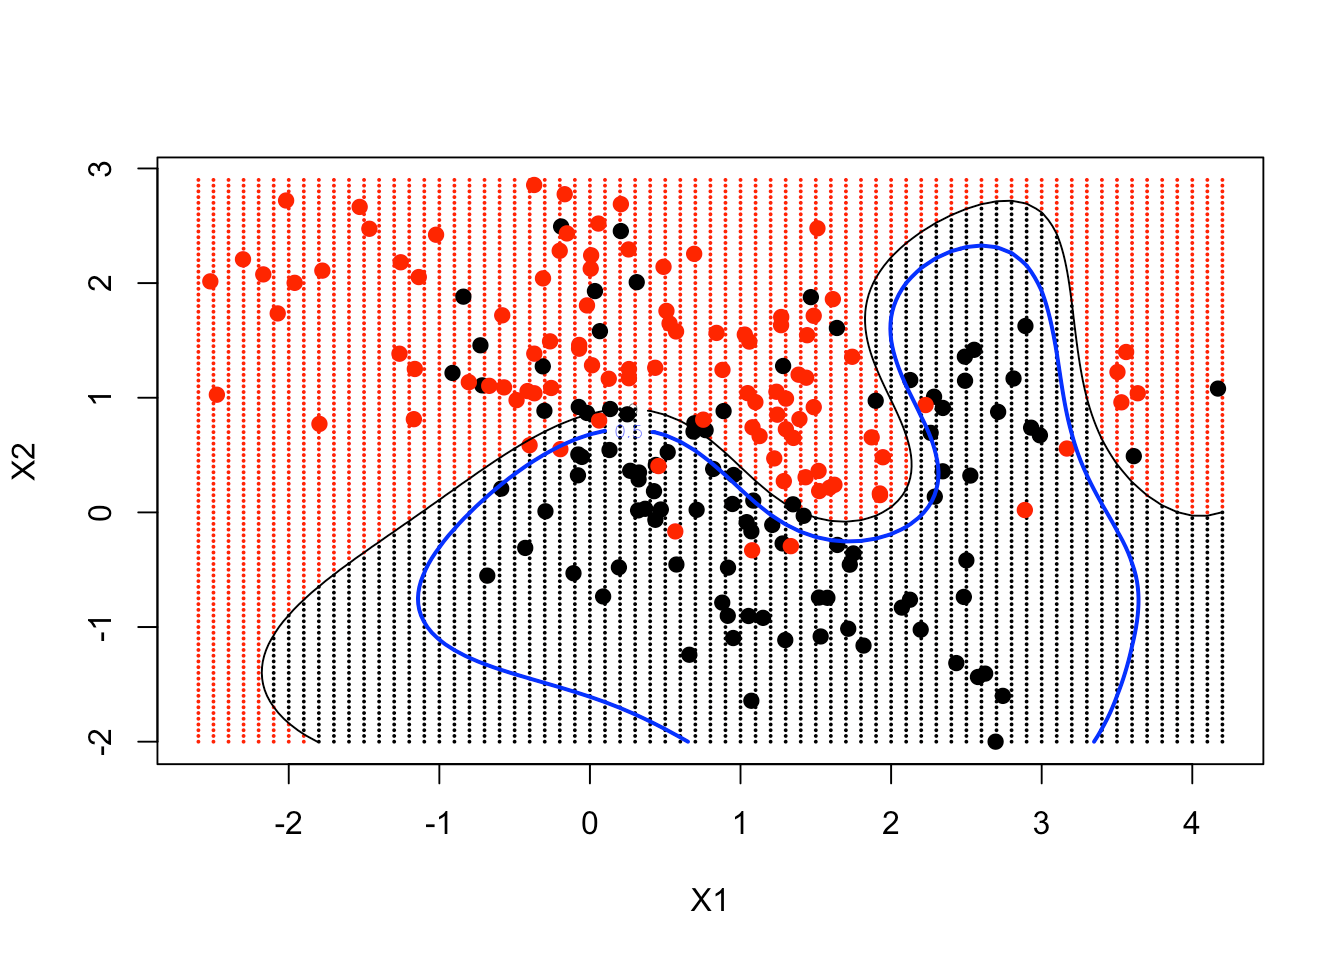
Ergebnis: Deine nichtlineare SVM liegt sehr nah an der Bayes-Entscheidungsgrenze.
Zusammengefasst sind Support Vector Machines eine Klasse überwachter Klassifikatoren, die den Merkmalsraum in zwei oder mehr Gruppen unterteilen. Sie tun dies, indem sie eine optimale Trennung anhand der bekannten Klassenlabels finden:
Ich finde, SVMs sind hervorragende Klassifikatoren für Szenarien, in denen die Gruppen klar getrennt sind. Auch bei nichtlinear getrennten Daten liefern sie starke Ergebnisse. Du kannst die Daten selbst transformieren, um sie linear trennbar zu machen, oder SVMs übernehmen diese Transformation per Kernel und trennen die Klassen direkt. Das ist einer der Hauptgründe für SVMs: Du musst nicht selbst nichtlineare Daten transformieren. Ein Nachteil ist die Black-Box-Natur. Durch die Kernel wird die Interpretation schwierig bis unmöglich. Wenn du SVMs verstehst, hast du eine starke Alternative zu GLMs und Entscheidungsbäumen für Klassifikationsaufgaben. Ich hoffe, dieses Tutorial erweitert deinen Blick auf das SVM-Universum und hilft dir, diese Modelle besser zu verstehen.
Wenn du mehr über R lernen möchtest, schau dir den DataCamp-Kurs Machine Learning Toolbox an.
Sieh dir auch unser Support Vector Machines mit Scikit-learn Tutorial an.
R-Kurse
Kurs
Kurs
Kurs