Curso
Introducción a R
4 h
3.1M
En aprendizaje automático, las máquinas de vectores de soporte (SVM) son modelos supervisados con algoritmos asociados que analizan datos para tareas de clasificación y regresión. No obstante, su uso más habitual es la clasificación. En este tutorial, vamos a comprender a alto nivel cómo funcionan las SVM y luego las implementaremos en R. Me centraré en construir intuición más que rigor. Es decir, evitaremos todo el álgebra posible y nos quedaremos con una intuición sólida del principio de funcionamiento.
Lo básico de las SVM y su funcionamiento se entiende mejor con un ejemplo sencillo. Imagina que tenemos dos etiquetas: rojo y azul, y que nuestros datos tienen dos variables: x e y. Queremos un clasificador que, dado un par de coordenadas (x,y), indique si es rojo o azul. Representamos en un plano nuestros datos de entrenamiento ya etiquetados:
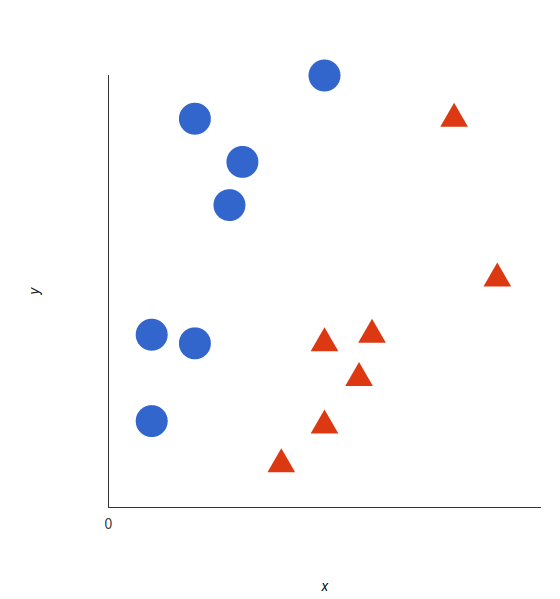
Una SVM toma estos puntos y devuelve el hiperplano (en dos dimensiones, una línea) que mejor separa las etiquetas. Esta línea es la frontera de decisión: todo lo que caiga a un lado lo clasificaremos como azul y al otro como rojo.
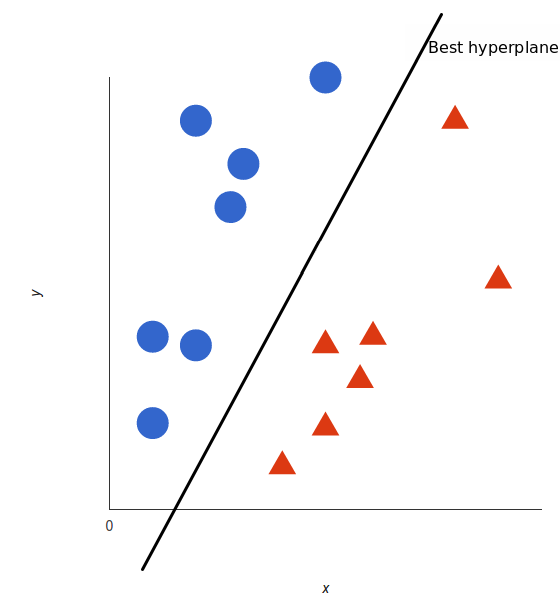
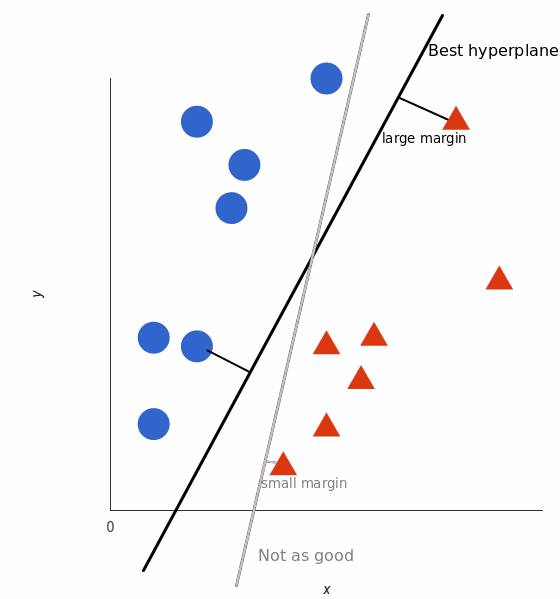
Pero, ¿cuál es exactamente el mejor hiperplano? Para una SVM, es el que maximiza los márgenes de ambas etiquetas. En otras palabras: el hiperplano (recuerda, aquí es una línea) cuya distancia al elemento más cercano de cada etiqueta es lo más grande posible.
El ejemplo anterior era fácil porque, claramente, los datos eran linealmente separables: podíamos trazar una línea recta para separar rojo y azul. Por desgracia, no suele ser tan simple. Mira este caso:
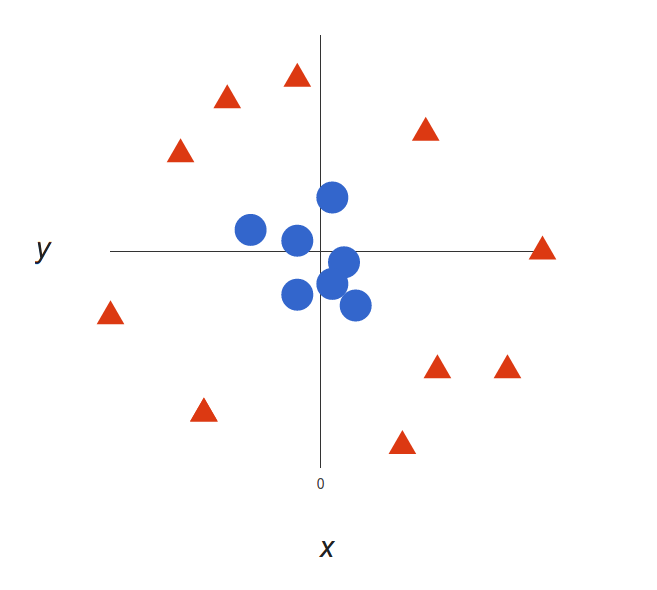
Está bastante claro que no hay una frontera de decisión lineal (una única línea recta que separe ambas etiquetas). Sin embargo, los vectores están muy bien diferenciados y parece que debería ser fácil separarlos.
¿Qué hacemos entonces? Añadimos una tercera dimensión. Hasta ahora teníamos dos dimensiones: $x$ e $y$. Creamos una nueva dimensión z y decidimos calcularla de una forma que nos convenga: $z = x² + y²$ (verás que es la ecuación de una circunferencia).
Esto nos da un espacio tridimensional. Si tomamos un corte de ese espacio, se ve así:
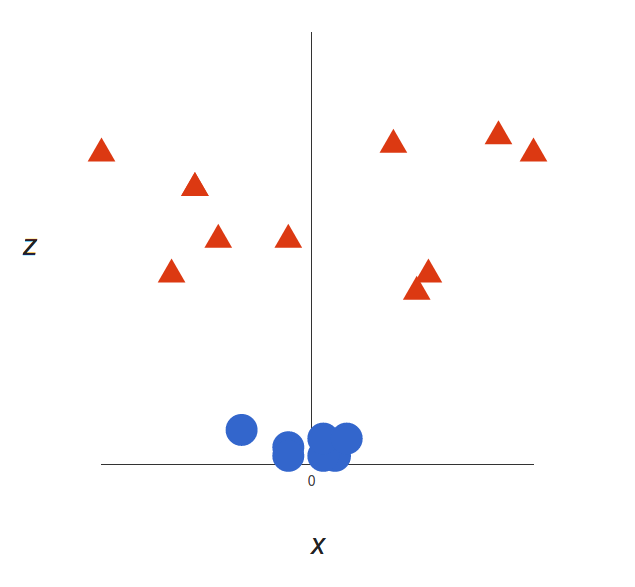
¿Qué puede hacer una SVM con esto? Veámoslo:
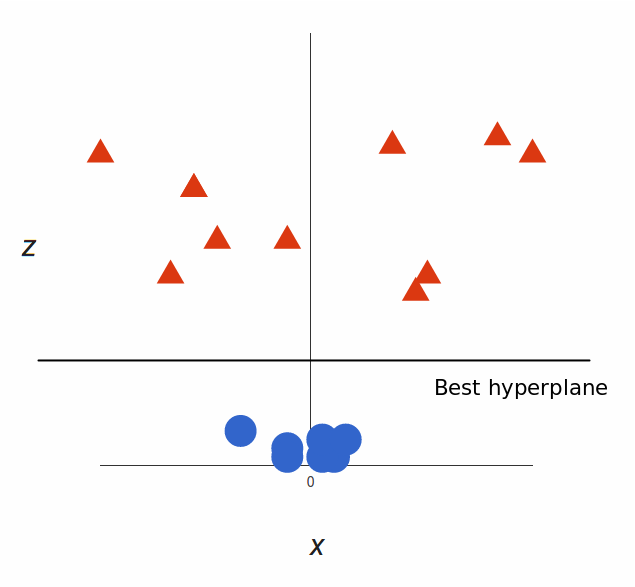
¡Genial! Observa que, como ahora estamos en tres dimensiones, el hiperplano es un plano paralelo al eje $x$ a cierta altura $z$ (digamos $z = 1$).
Solo queda volver a mapearlo a dos dimensiones:
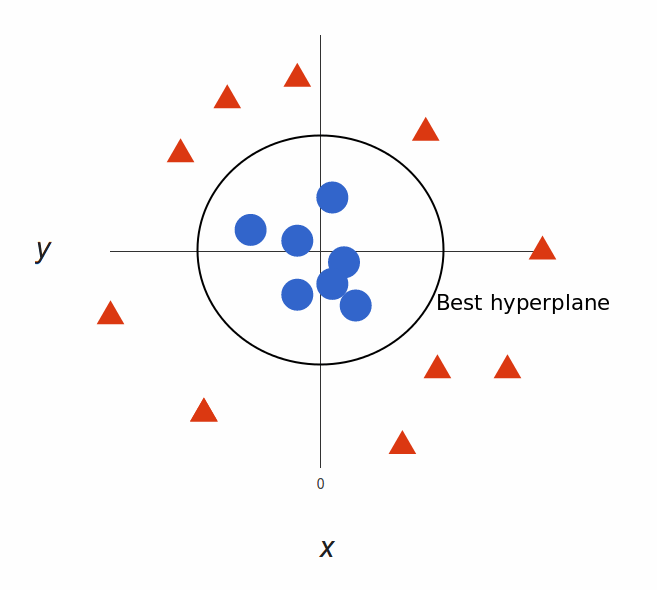
¡Y listo! Nuestra frontera de decisión es una circunferencia de radio 1 que separa ambas etiquetas con SVM.
En el ejemplo anterior, encontramos una forma de clasificar datos no lineales mapeando el espacio a una dimensión superior. Sin embargo, calcular esa transformación puede ser muy costoso computacionalmente: puede haber muchas dimensiones nuevas y cada una implicar cálculos complicados. Hacerlo para cada vector del conjunto puede ser caro, así que sería ideal una solución más barata.
Aquí va un truco: la SVM no necesita los vectores originales para obrar su magia; le basta con los productos escalares entre ellos. Esto significa que podemos evitar los cálculos costosos de las nuevas dimensiones. En su lugar, hacemos lo siguiente:


Esto se conoce como el truco del kernel, que amplía el espacio de características para permitir una frontera no lineal entre clases. Los kernels habituales para separar datos no lineales son los polinómicos, los de base radial y los lineales (equivalentes a los clasificadores de vectores de soporte). En pocas palabras, estos kernels transforman los datos para que un hiperplano lineal pueda separarlos.
Veamos ahora algunas ventajas y desventajas de las SVM:
Ventajas
Alta dimensionalidad: las SVM funcionan muy bien en espacios de gran dimensión, algo especialmente útil en la clasificación de documentos y el análisis de sentimiento, donde la dimensionalidad puede ser enorme.
Eficiencia de memoria: como solo se usa un subconjunto de los puntos de entrenamiento en la decisión final al clasificar nuevos casos, basta con almacenar (y calcular) esos puntos al tomar decisiones.
Versatilidad: la separación entre clases suele ser muy no lineal. La posibilidad de aplicar kernels ofrece mucha flexibilidad en las fronteras de decisión y suele mejorar el rendimiento de la clasificación.
Desventajas
Selección de parámetros del kernel: las SVM son muy sensibles a la elección de los parámetros del kernel. En situaciones donde el número de características por objeto supera al de muestras de entrenamiento, las SVM pueden rendir mal. Intuitivamente, si el espacio de características de alta dimensión es mucho mayor que las muestras, habrá menos vectores de soporte efectivos para sostener los hiperplanos lineales óptimos, lo que empeora la clasificación a medida que se añaden muestras no vistas.
No probabilísticas: como el clasificador decide colocando objetos a un lado u otro de un hiperplano, no hay una interpretación probabilística directa de la pertenencia a grupo. Aun así, una métrica útil para medir la "firmeza" de la clasificación es cuán lejos del límite de decisión cae el nuevo punto.
Primero vamos a generar algunos datos en 2 dimensiones y a separarlos un poco. Tras fijar la semilla aleatoria, creas una matriz x con distribución normal con 20 observaciones en 2 clases y 2 variables. Luego creas una variable y, que será -1 o 1, con 10 en cada clase. Para y = 1, desplazas las medias de 0 a 1 en cada coordenada. Por último, representas los datos y coloreas los puntos según su respuesta. El carácter de trazado 19 produce puntos grandes y visibles en azul o rojo según si la respuesta es 1 o -1.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Ahora cargas el paquete e1071, que contiene la función svm (recuerda instalarlo si aún no lo tienes).
library(e1071)A continuación, creas un dataframe con los datos, convirtiendo y en un factor. Después llamas a svm sobre ese dataframe, usando y como variable respuesta y el resto como predictores. El dataframe desempaqueta la matriz x en 2 columnas llamadas x1 y x2. Indicas a SVM que el kernel es lineal, el parámetro de coste es 10 y scale es false. En este ejemplo, le pides que no estandarice las variables.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
Al imprimir svmfit verás su resumen. Observa que el número de vectores de soporte es 6: son los puntos cercanos a la frontera o al lado equivocado de la frontera.
Existe una función de trazado para SVM que muestra la frontera de decisión, como ves abajo. Parece que no hay mucho control sobre los colores. Además rompe la convención porque pone x2 en el eje horizontal y x1 en el vertical.
plot(svmfit, dat)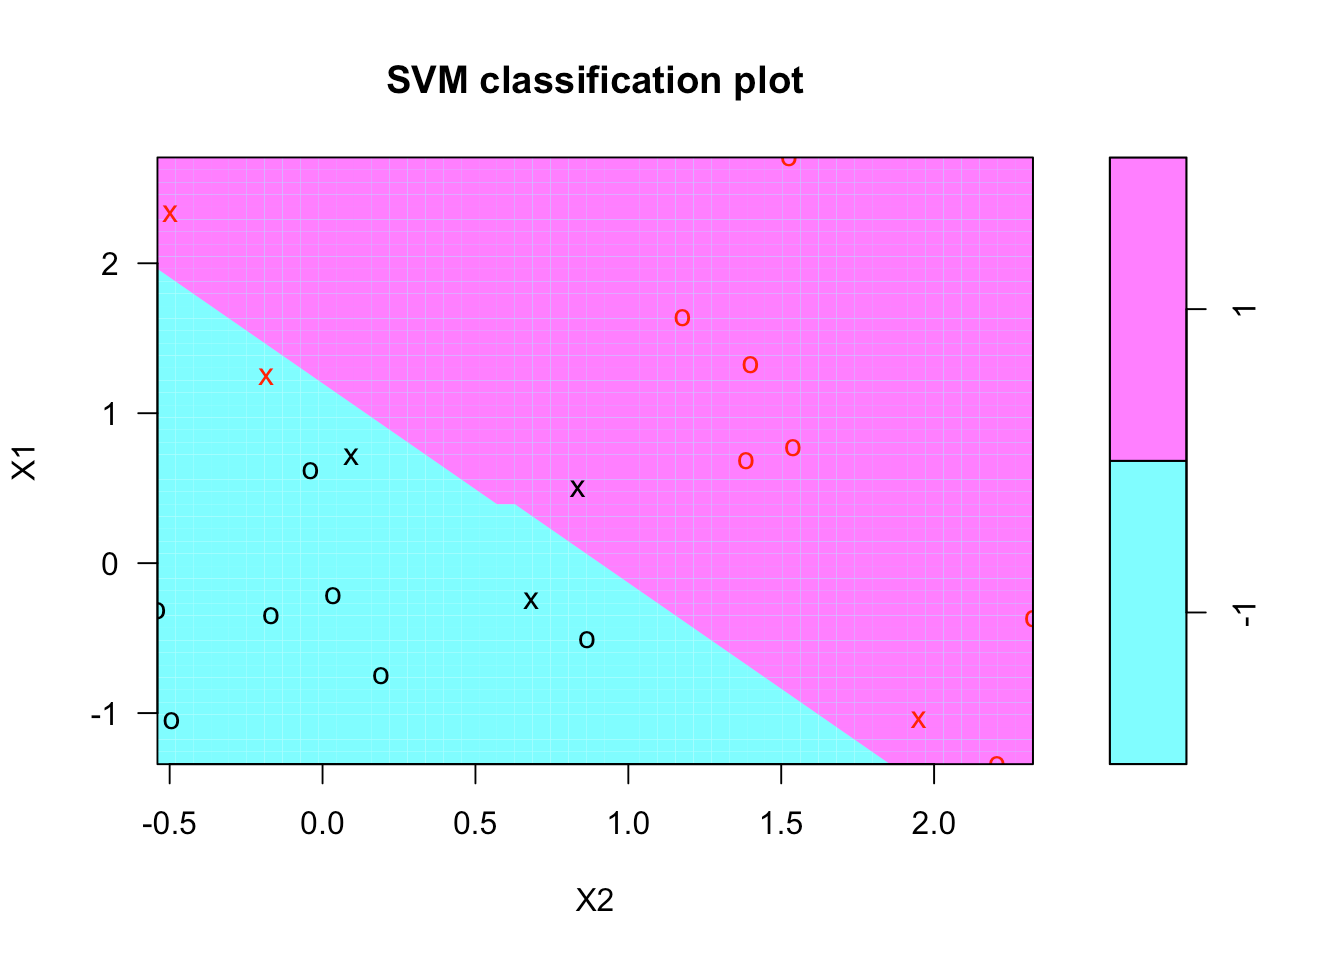
Intentemos crear nuestro propio gráfico. Lo primero es crear una rejilla o malla de valores para x1 y x2 que cubra todo el dominio con una malla bastante fina. Para ello, defines una función llamada make.grid. Recibe la matriz de datos x y un argumento n, el número de puntos en cada dirección. Aquí pedimos una malla de 75 x 75.
Dentro de esta función, usas la función apply para obtener el rango de cada variable en x. Luego, para x1 y x2, usas seq para ir del valor mínimo al máximo y crear una secuencia de longitud n. Ahora tienes x1 y x2, cada uno con 75 valores uniformemente espaciados. Por último, usas expand.grid, que toma x1 y x2 y construye la rejilla.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Ahora puedes aplicar make.grid a x. Echemos un vistazo a los primeros valores de la rejilla del 1 al 10.
xgrid = make.grid(x)
xgrid[1:10,]
Como ves, la rejilla recorre primero la 1.ª coordenada, manteniendo fija la 2.ª.
Con la malla creada, harás una predicción en cada punto. Con los nuevos datos xgrid, usas predict y llamas ygrid a la respuesta. Luego trazas y coloreas los puntos según la clasificación para que la frontera de decisión quede clara. También añadimos los puntos originales con la función points.
svmfit tiene un componente llamado index que indica cuáles son los vectores de soporte. Los incluimos en el gráfico usando de nuevo points.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)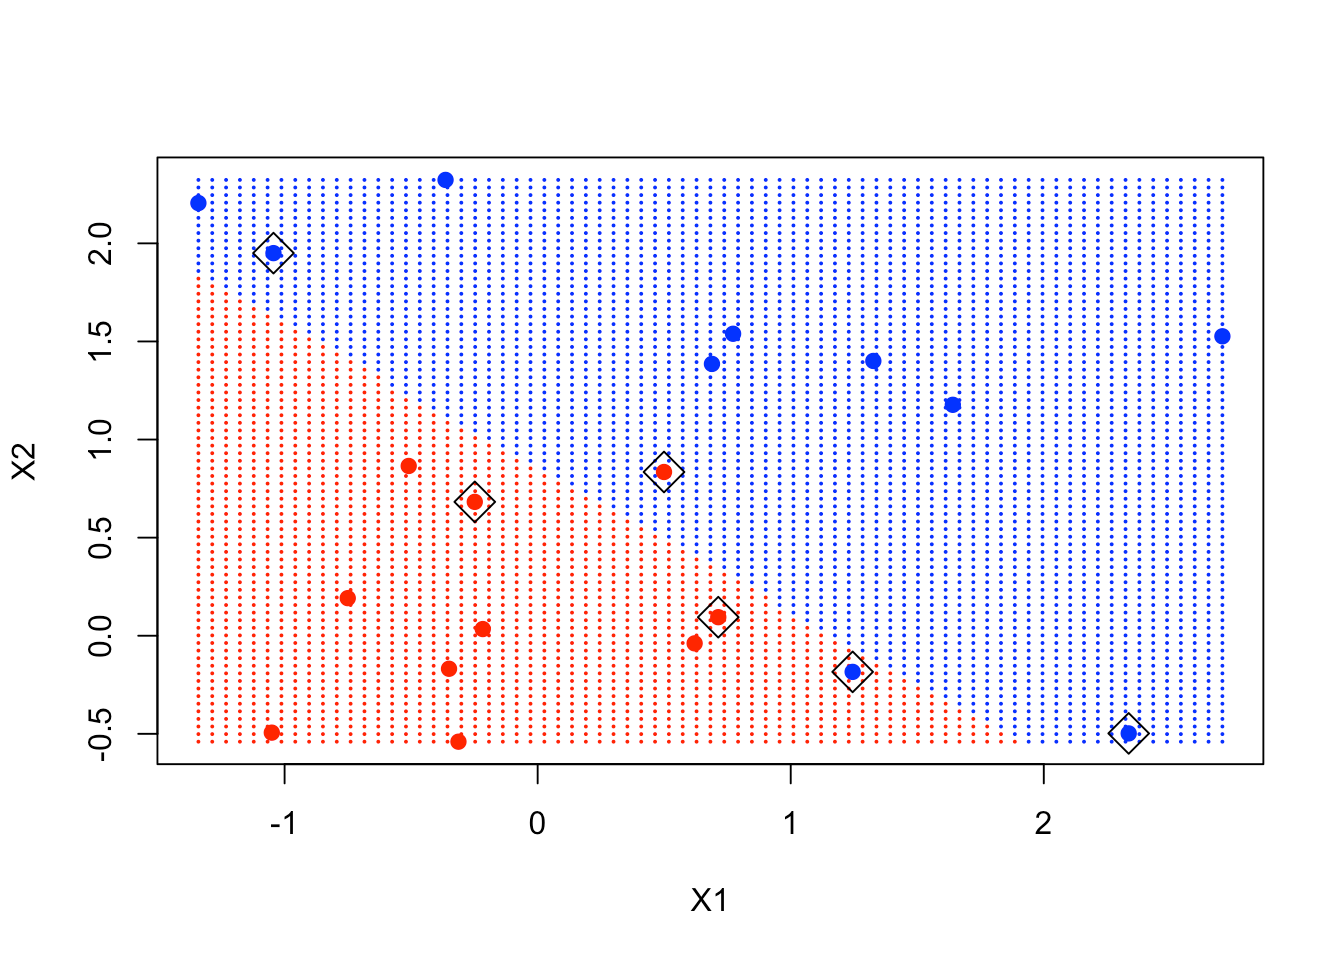
Como ves en el gráfico, los puntos enmarcados están cerca de la frontera de decisión y son clave para determinarla.
Por desgracia, la función svm no es muy cómoda a la hora de recuperar los coeficientes lineales. Probablemente porque esto solo tiene sentido para kernels lineales y la función es más general. Usemos una fórmula para extraer los coeficientes de forma eficiente. Extraes beta y beta0, los coeficientes lineales.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Ahora puedes volver a representar los puntos de la rejilla y, después, añadir los puntos originales (incluidos los vectores de soporte). Luego usas los coeficientes para dibujar la frontera de decisión con una ecuación simple de la forma:
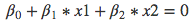
A partir de esa ecuación, calculas la pendiente y la ordenada en el origen de la frontera de decisión. Después usas abline con esos dos argumentos. Las dos llamadas siguientes a abline representan el margen superior e inferior de la frontera, respectivamente.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)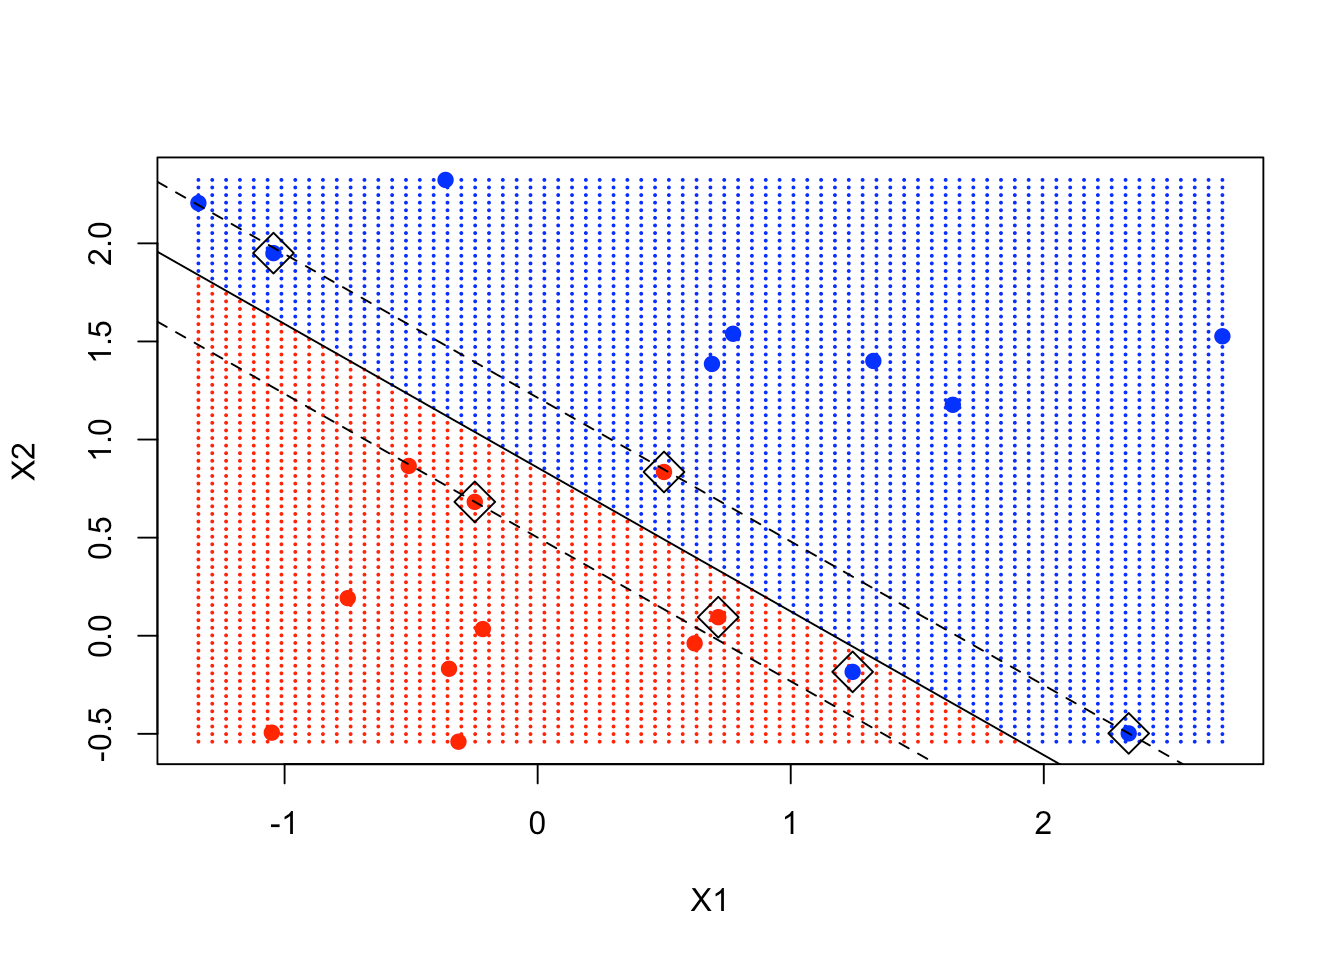
Se ve claramente que algunos vectores de soporte están exactamente en el margen, mientras que otros quedan dentro del margen.
Hasta aquí, la SVM lineal. Pasemos ahora a la versión no lineal. Vamos a ver un ejemplo del libro Elements of Statistical Learning, con un caso canónico en 2 dimensiones donde la frontera de decisión es no lineal. Usaremos una SVM con kernel para intentar aprender esa frontera.
Primero, obtenemos los datos de ese ejemplo descargándolos directamente de esta URL, que es donde residen. Los datos son simulados y mezclados. Luego puedes inspeccionar sus nombres de columna.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
De momento, los datos de entrenamiento son x e y. Ya creaste una x y una y en el ejemplo anterior. Así que eliminémoslas para poder adjuntar estos nuevos datos.
rm(x, y)
attach(ESL.mixture)
Los datos también son bidimensionales. Vamos a representarlos para verlos bien.
plot(x, col = y + 1)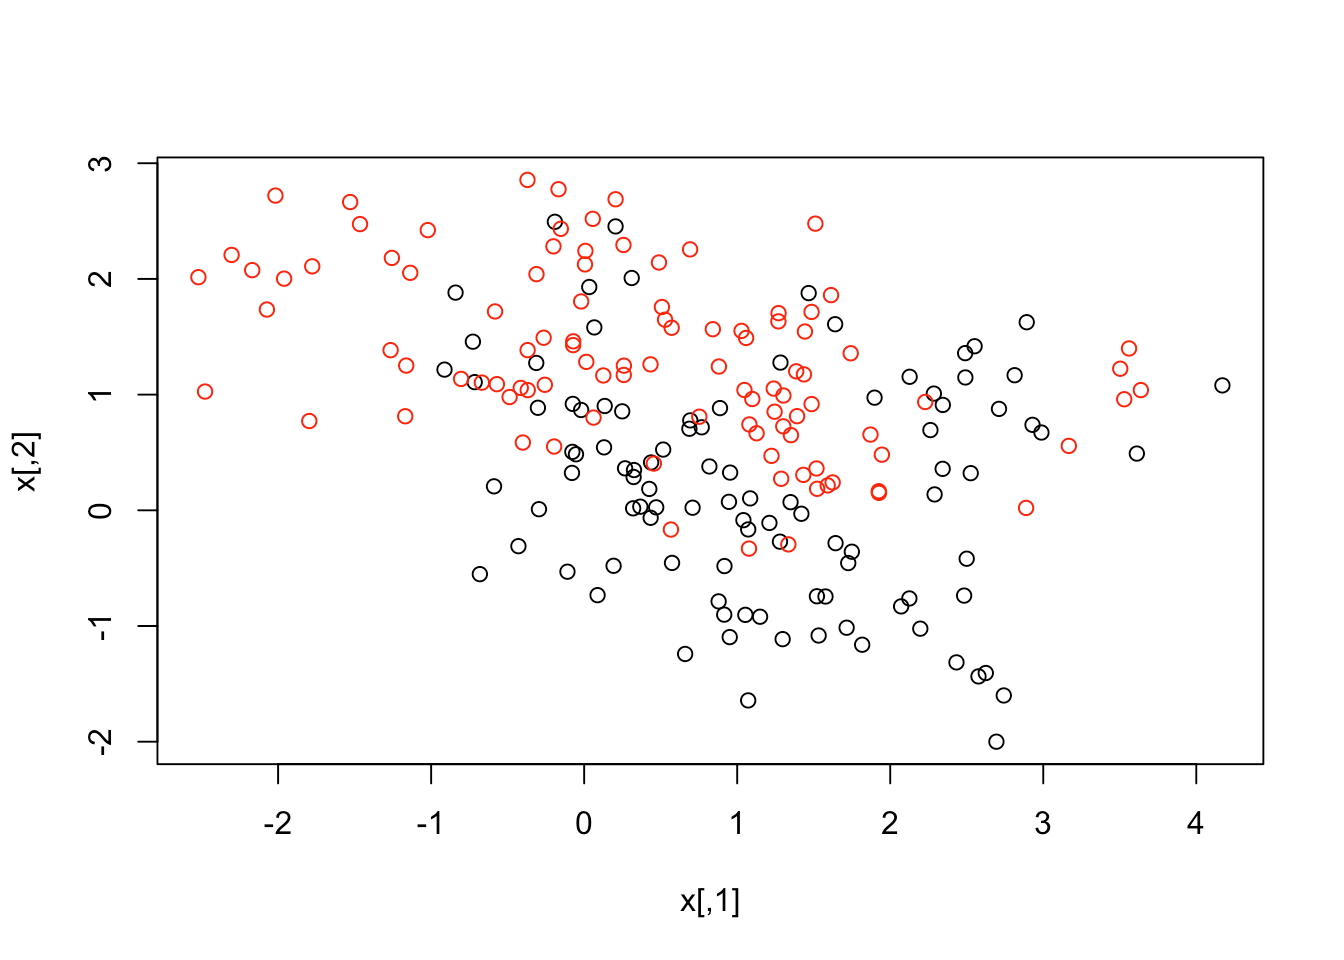
Parece que hay bastante solapamiento, pero se aprecia cierta estructura particular. Ahora creamos un data frame con la respuesta y, y la convertimos en factor. Después ajustas una SVM con kernel radial y coste 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Es hora de crear una rejilla y hacer predicciones. Estos datos incluyen puntos de rejilla suministrados. Si revisas el resumen de nombres de la lista, hay 2 variables, px1 y px2, que son las rejillas de valores para cada variable. Puedes usar expand.grid para crear la rejilla. Luego predices la clase en cada punto de la rejilla.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Por último, trazas los puntos y los coloreas según la frontera de decisión. Verás que la frontera es no lineal. También puedes añadir los datos originales para ver dónde caen.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)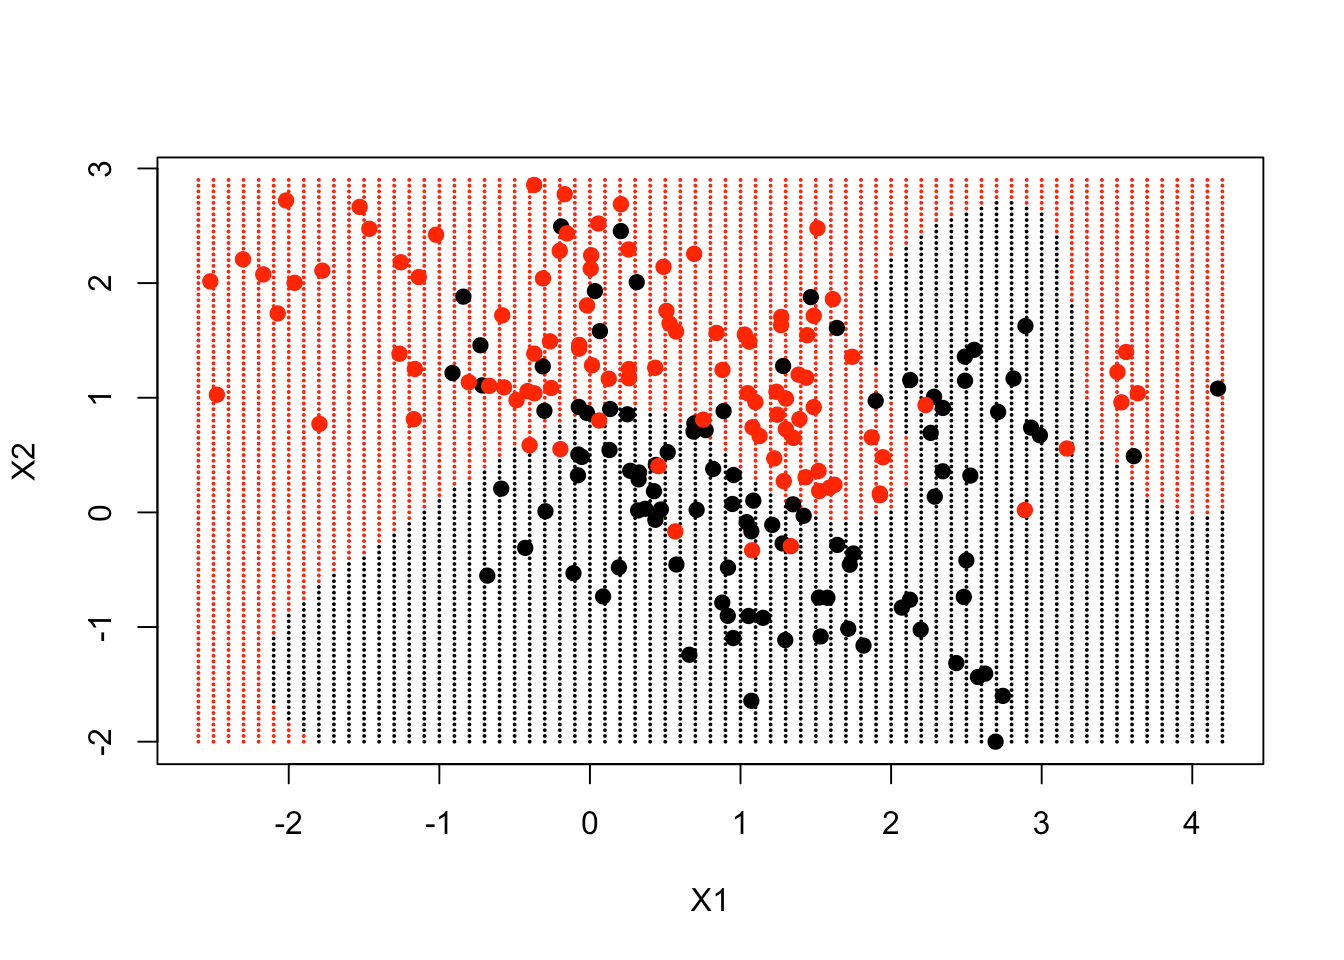
La frontera de decisión, en gran medida, sigue la distribución de los datos, pero de forma muy no lineal.
Vamos a mejorar un poco el gráfico y hacer que la función predict devuelva las estimaciones de la función en cada punto de la rejilla. En particular, queremos dibujar una curva que marque la frontera de decisión usando la función contour. En el dataframe hay también una variable llamada prob, que es la probabilidad real de clase 1 para estos datos en los puntos de la rejilla. Si dibujas su contorno 0.5, obtendrás la frontera de decisión de Bayes, que es lo mejor que se puede lograr.
Primero, predices tu ajuste en la rejilla. Le indicas decision values igual a TRUE porque quieres la función real, no solo la clase. Devuelve un atributo de los valores clasificados, así que hay que extraer ese atributo y acceder al llamado decision.
Después, sigues los mismos pasos que antes para crear la rejilla, hacer las predicciones y trazar los puntos.
Luego usas contour. Requiere las 2 secuencias de la rejilla, una función y dos argumentos, level y add. Queremos la función en forma de matriz, con las dimensiones de px1 y px2 (69 y 99, respectivamente). Fijamos level a 0 y la añadimos al gráfico. Verás que el contorno sigue la frontera de decisión: una forma muy práctica de trazar una frontera no lineal en 2D.
Finalmente, añadimos la verdad del modelo subyacente, que es el contorno de las probabilidades. Es el contorno 0.5, que sería la frontera de decisión en términos probabilísticos (también conocida como frontera de decisión de Bayes).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)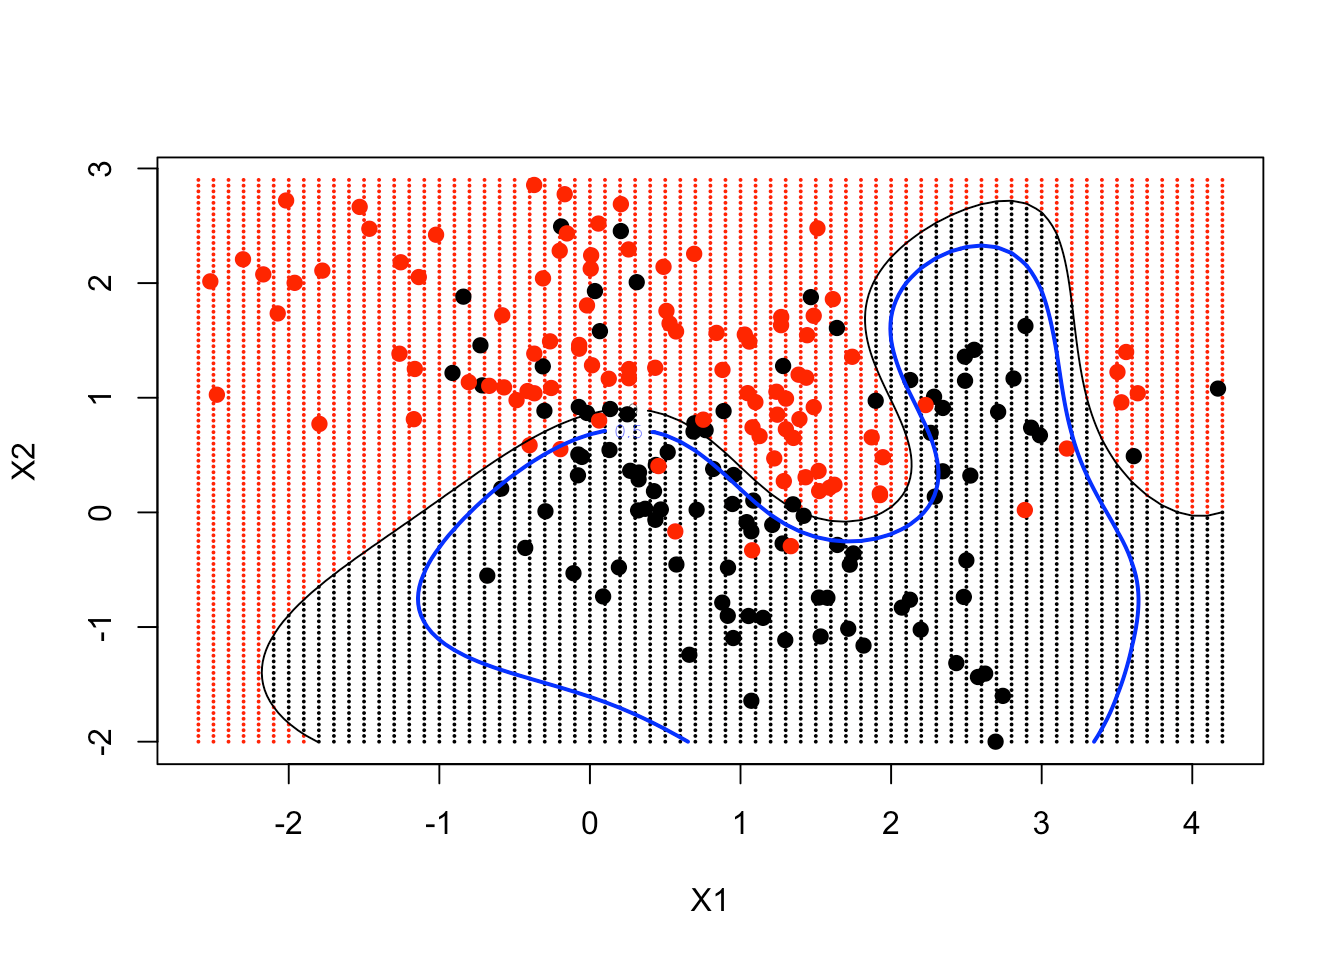
Como resultado, tu SVM no lineal se aproxima bastante a la frontera de decisión de Bayes.
Resumiendo, las máquinas de vectores de soporte son una subclase de clasificadores supervisados que intentan particionar un espacio de características en dos o más grupos. Lo logran encontrando la mejor forma de separar dichos grupos en función de sus etiquetas conocidas:
En mi opinión, las SVM son grandes clasificadores para situaciones en las que los grupos están claramente separados. También funcionan muy bien cuando los datos no son linealmente separables. Puedes transformar los datos para separarlos linealmente, o dejar que una SVM los transforme y separe las dos clases de forma directa. Esta es una de las principales razones para usar SVM: no tienes que transformar tú mismo los datos no lineales. Un inconveniente es su naturaleza de caja negra. El uso de kernels para separar datos no lineales dificulta (cuando no imposibilita) su interpretación. Entenderlas te dará una alternativa a los GLM y a los árboles de decisión para clasificación. Espero que este tutorial te haya dado una visión más amplia del panorama de las SVM y te ayude a comprender mejor estas máquinas.
Si quieres aprender más sobre R, echa un vistazo al curso Machine Learning Toolbox de DataCamp.
Consulta nuestro tutorial de máquinas de vectores de soporte con Scikit-learn.
Cursos de R
Curso
Curso
Curso
Tutorial
Avinash Navlani
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Eugenia Anello
8 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
10 min



