Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Trong học máy, support vector machine là các mô hình học có giám sát với những thuật toán liên quan để phân tích dữ liệu dùng cho phân loại và hồi quy. Tuy nhiên, chúng chủ yếu được dùng cho các bài toán phân loại. Trong hướng dẫn này, chúng ta sẽ cố gắng nắm hiểu ở mức khái quát cách SVM hoạt động rồi triển khai bằng R. Tôi sẽ tập trung vào trực giác thay vì tính chặt chẽ. Điều đó có nghĩa là chúng ta sẽ lược bớt tối đa phần toán học và xây dựng trực giác vững về nguyên lý hoạt động.
Nền tảng của Support Vector Machines và cách hoạt động của nó được hiểu rõ nhất qua một ví dụ đơn giản. Hãy tưởng tượng ta có hai nhãn: đỏ và xanh, và dữ liệu có hai đặc trưng: x và y. Ta muốn một bộ phân loại mà, với một cặp tọa độ (x,y), sẽ cho biết đó là đỏ hay xanh. Ta vẽ dữ liệu huấn luyện đã được gán nhãn lên mặt phẳng:
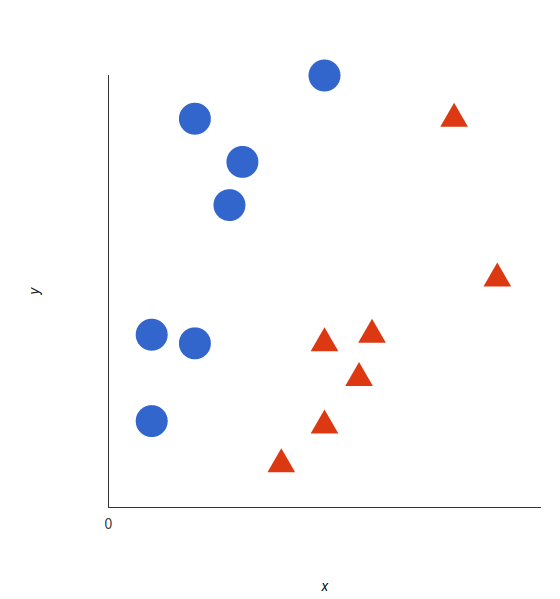
Một support vector machine nhận các điểm dữ liệu này và đưa ra siêu phẳng (trong không gian hai chiều thì đơn giản là một đường thẳng) phân tách các nhãn tốt nhất. Đường này là biên quyết định: mọi điểm nằm về một phía sẽ được phân loại là xanh, và phía còn lại là đỏ.
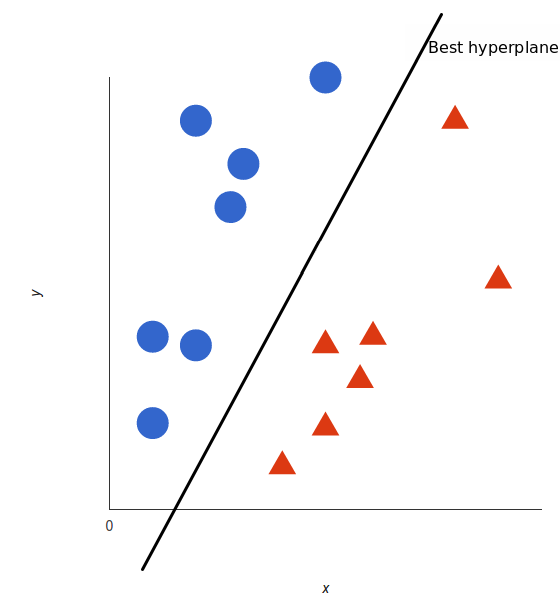
Nhưng thế nào là siêu phẳng tốt nhất? Với SVM, đó là siêu phẳng tối đa hóa khoảng cách lề từ cả hai nhãn. Nói cách khác: siêu phẳng (hãy nhớ trong trường hợp này là một đường thẳng) có khoảng cách tới phần tử gần nhất của mỗi nhãn là lớn nhất.
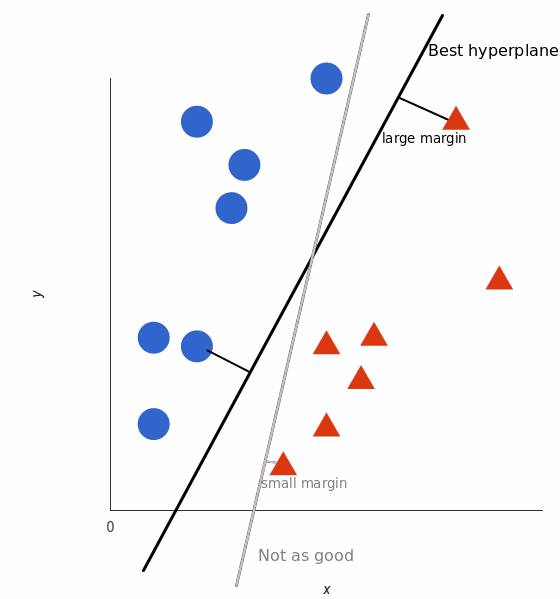
Ví dụ trên khá dễ vì dữ liệu tách tuyến tính — ta có thể vẽ một đường thẳng để tách đỏ và xanh. Tiếc rằng thường thì mọi thứ không đơn giản vậy. Hãy xem trường hợp này:
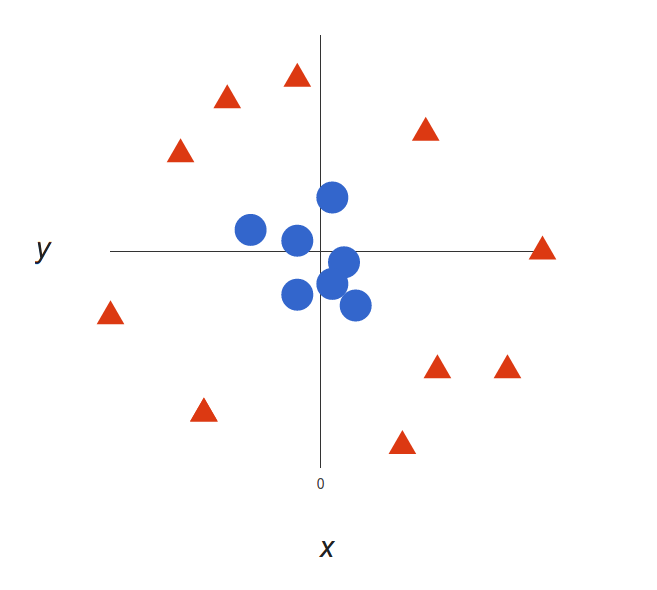
Rõ ràng là không có biên quyết định tuyến tính (một đường thẳng đơn lẻ tách hai nhãn). Tuy nhiên, các vector lại tách biệt khá rõ, và có vẻ như việc phân tách chúng phải là dễ.
Vậy ta sẽ làm như sau: thêm một chiều thứ ba. Đến giờ ta có hai chiều: $x$ và $y$. Ta tạo thêm chiều z mới, và quy định nó được tính theo một cách thuận tiện: $z = x² + y²$ (bạn sẽ nhận ra đó là phương trình đường tròn).
Điều này tạo cho ta một không gian ba chiều. Lấy một lát cắt của không gian đó, trông sẽ như thế này:
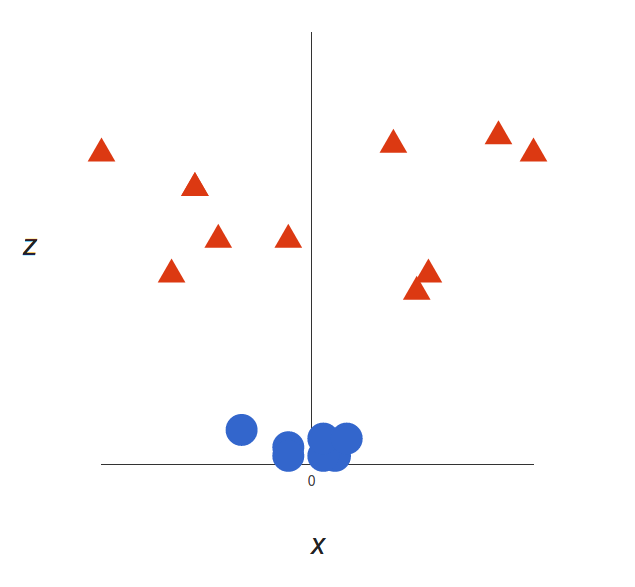
SVM có thể làm gì với điều này? Hãy xem:
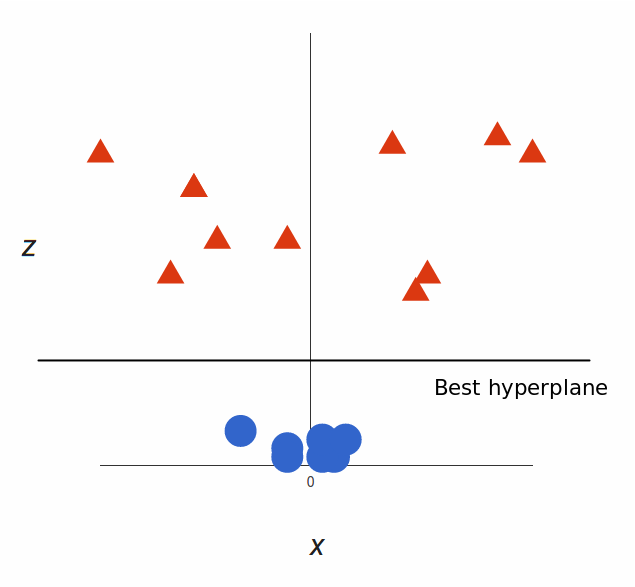
Tuyệt vời! Lưu ý rằng vì giờ ta ở trong không gian ba chiều, siêu phẳng là một mặt phẳng song song với trục $x$ tại một mức $z$ nào đó (giả sử $z = 1$).
Phần còn lại là ánh xạ nó trở về hai chiều:
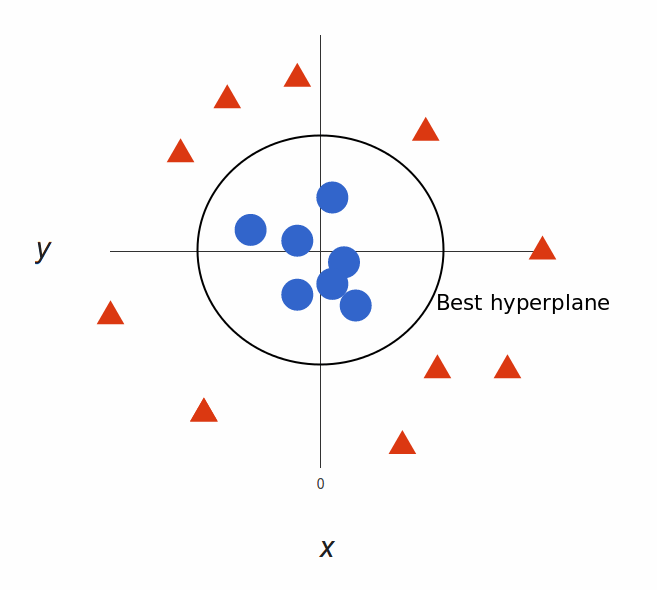
Và xong! Biên quyết định của ta là một đường tròn bán kính 1, tách hai nhãn bằng SVM.
Trong ví dụ trên, ta đã tìm ra cách phân loại dữ liệu phi tuyến bằng cách khéo léo ánh xạ không gian sang chiều cao hơn. Tuy nhiên, việc tính toán phép biến đổi này có thể rất tốn kém: có thể có rất nhiều chiều mới, mỗi chiều lại có thể liên quan tới phép tính phức tạp. Làm việc này cho mọi vector trong tập dữ liệu sẽ rất nặng, nên sẽ thật tuyệt nếu có cách rẻ hơn.
Mẹo là thế này: SVM không cần các vector thực để hoạt động, thực tế nó chỉ cần tích vô hướng giữa chúng. Điều này có nghĩa ta có thể né được các phép tính đắt đỏ của những chiều mới! Thay vào đó ta làm như sau:

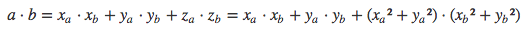
Đây được biết đến là kernel trick, tức mở rộng không gian đặc trưng để chứa được một biên phi tuyến giữa các lớp. Các loại kernel thường dùng để tách dữ liệu phi tuyến gồm kernel đa thức, kernel cơ sở xuyên tâm, và kernel tuyến tính (tương đương với bộ phân loại vector hỗ trợ). Nói đơn giản, các kernel này biến đổi dữ liệu của ta để đi qua một siêu phẳng tuyến tính và nhờ đó phân loại dữ liệu.
Giờ hãy xem một số ưu và nhược điểm của SVM:
Ưu điểm
Chiều cao: SVM là công cụ hiệu quả trong không gian có số chiều lớn, đặc biệt phù hợp với phân loại tài liệu và phân tích cảm xúc nơi số chiều có thể cực lớn.
Hiệu quả bộ nhớ: Vì chỉ một tập con các điểm huấn luyện được dùng trong quá trình quyết định gán nhãn các phần tử mới, chỉ cần lưu các điểm này trong bộ nhớ (và tính toán trên chúng) khi ra quyết định.
Tính linh hoạt: Ranh giới giữa các lớp thường rất phi tuyến. Khả năng áp dụng các kernel mới cho phép biên quyết định linh hoạt hơn nhiều, dẫn đến hiệu năng phân loại tốt hơn.
Nhược điểm
Chọn tham số kernel: SVM rất nhạy với lựa chọn tham số kernel. Trong các tình huống số đặc trưng của mỗi đối tượng vượt quá số mẫu dữ liệu huấn luyện, SVM có thể hoạt động kém. Trực giác là nếu không gian đặc trưng có số chiều cao lớn hơn nhiều so với số mẫu, sẽ có ít vector hỗ trợ hiệu quả để chống đỡ các siêu phẳng tuyến tính tối ưu, dẫn đến hiệu năng phân loại kém hơn khi thêm các mẫu chưa thấy.
Không xác suất: Vì bộ phân loại hoạt động bằng cách đặt các đối tượng ở phía trên và dưới một siêu phẳng phân loại, không có diễn giải xác suất trực tiếp cho tư cách nhóm. Tuy vậy, một chỉ số tiềm năng để xác định mức "hiệu quả" của phân loại là khoảng cách từ điểm mới tới biên quyết định.
Trước hết hãy tạo một ít dữ liệu trong 2 chiều và tách chúng một chút. Sau khi đặt hạt giống ngẫu nhiên, bạn tạo ma trận x, phân phối chuẩn với 20 quan sát trong 2 lớp trên 2 biến. Sau đó bạn tạo biến y, nhận giá trị -1 hoặc 1, mỗi lớp 10 giá trị. Với y = 1, bạn dời trung bình từ 0 lên 1 ở mỗi tọa độ. Cuối cùng bạn có thể vẽ dữ liệu và tô màu các điểm theo phản hồi. Ký hiệu vẽ 19 cho các chấm to, dễ nhìn, mã màu xanh hoặc đỏ tùy phản hồi là 1 hay -1.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Giờ bạn nạp gói e1071 chứa hàm svm (hãy nhớ cài đặt gói nếu bạn chưa cài).
library(e1071)Giờ bạn tạo một dataframe từ dữ liệu, chuyển y thành biến factor. Sau đó, bạn gọi svm trên dataframe này, dùng y làm biến phản hồi và các biến khác làm biến dự đoán. Dataframe sẽ bung ma trận x thành 2 cột tên x1 và x2. Bạn báo với SVM rằng kernel là tuyến tính, tham số cost là 10, và scale bằng false. Trong ví dụ này, bạn yêu cầu không chuẩn hóa các biến.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
In svmfit sẽ cho tóm tắt. Bạn có thể thấy số lượng vector hỗ trợ là 6 - đó là các điểm nằm gần biên hoặc ở phía sai của biên.
Có một hàm vẽ cho SVM hiển thị biên quyết định, như bạn thấy bên dưới. Có vẻ không có nhiều điều khiển về màu sắc. Nó cũng trái với quy ước khi đặt x2 trên trục hoành và x1 trên trục tung.
plot(svmfit, dat)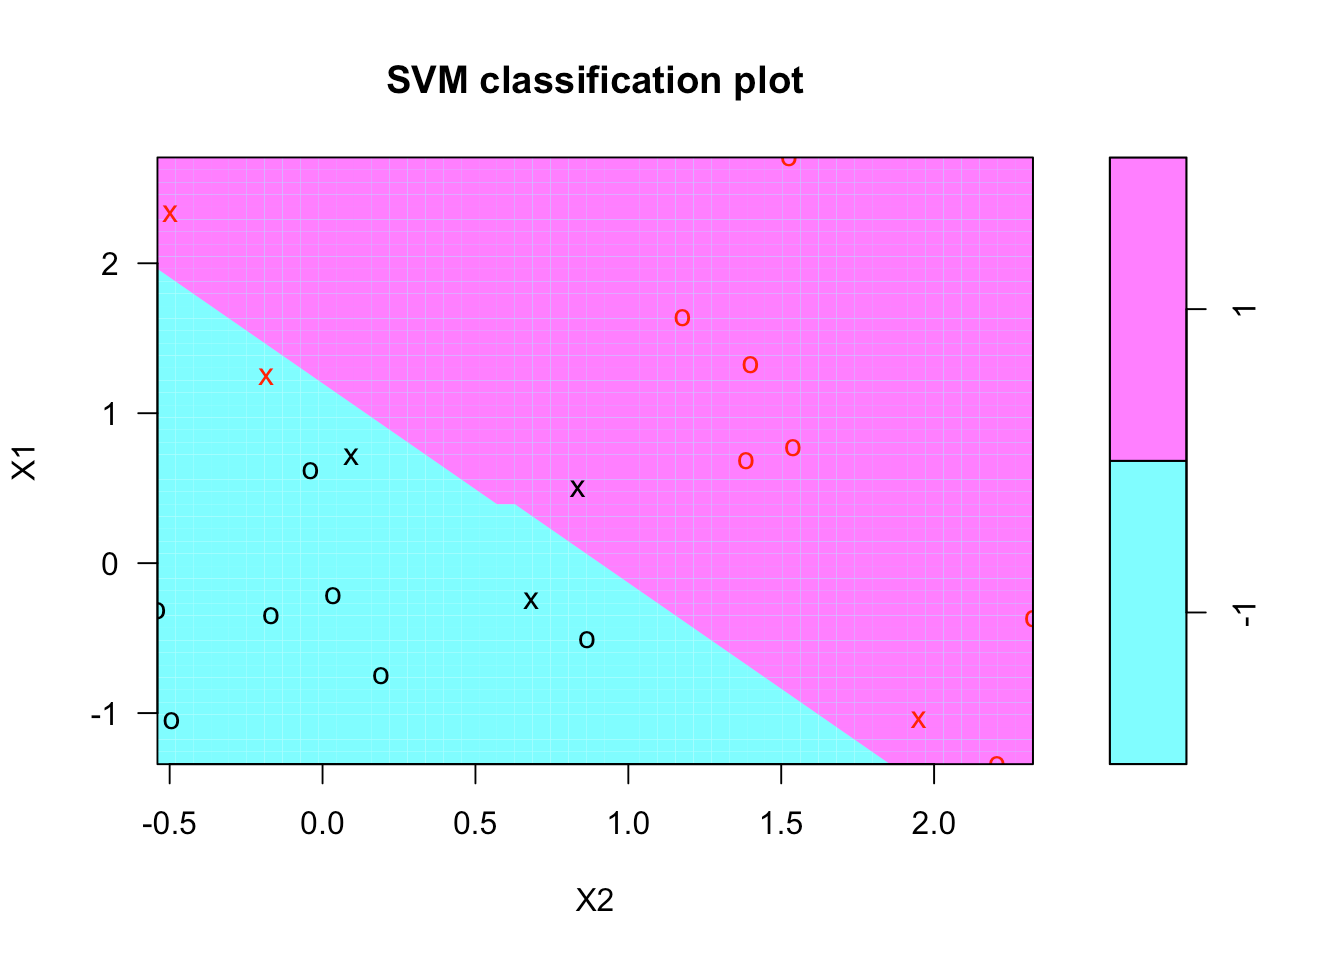
Hãy thử tự vẽ. Việc đầu tiên là tạo một lưới giá trị hay mạng giá trị cho x1 và x2 bao phủ toàn bộ miền với một mạng khá mịn. Để làm vậy, bạn viết một hàm tên make.grid. Nó nhận ma trận dữ liệu x, cũng như tham số n là số điểm theo mỗi hướng. Ở đây bạn sẽ yêu cầu một lưới 75 x 75.
Bên trong hàm này, bạn dùng apply function để lấy miền giá trị của mỗi biến trong x. Sau đó cho cả x1 và x2, bạn dùng hàm seq để đi từ giá trị thấp nhất đến giá trị cao nhất tạo một dãy có độ dài n. Đến lúc này, bạn có x1 và x2, mỗi cái có 75 giá trị cách đều theo mỗi tọa độ. Cuối cùng, bạn dùng hàm expand.grid để lấy x1 và x2 và tạo mạng lưới.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Giờ bạn có thể áp dụng hàm make.grid lên x. Hãy xem vài giá trị đầu của mạng từ 1 đến 10.
xgrid = make.grid(x)
xgrid[1:10,]
Như bạn thấy, lưới đi qua tọa độ thứ nhất trước, giữ cố định tọa độ thứ hai.
Sau khi tạo mạng, bạn sẽ dự đoán tại mỗi điểm trên mạng. Với dữ liệu mới xgrid, bạn dùng predict và gọi phản hồi là ygrid. Sau đó bạn vẽ và mã màu các điểm theo phân loại để biên quyết định rõ ràng. Hãy đặt cả các điểm gốc lên đồ thị này bằng hàm points.
svmfit có một thành phần tên index cho biết đâu là các điểm hỗ trợ. Bạn đưa chúng vào đồ thị bằng cách lại dùng hàm points.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)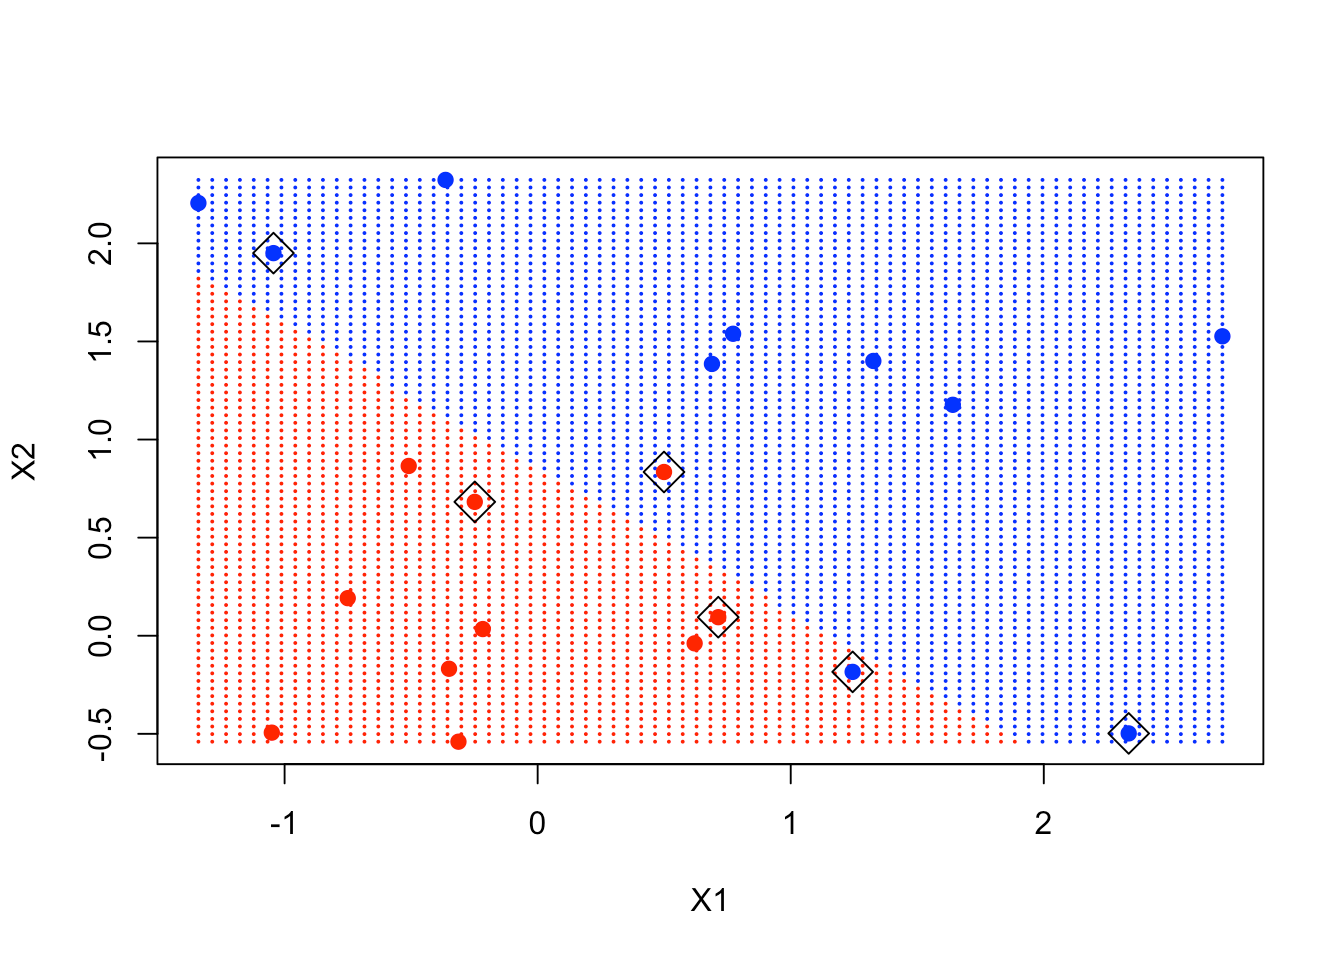
Như bạn thấy trên đồ thị, các điểm trong khung hộp nằm gần biên quyết định và đóng vai trò then chốt trong việc xác định biên đó.
Đáng tiếc, hàm svm không quá thân thiện, bạn phải làm thêm một chút để lấy lại các hệ số tuyến tính. Lý do có lẽ vì điều này chỉ có ý nghĩa với kernel tuyến tính, còn hàm thì tổng quát hơn. Vậy hãy dùng một công thức để trích xuất hệ số hiệu quả hơn. Bạn trích beta và beta0, là các hệ số tuyến tính.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Giờ bạn có thể vẽ lại các điểm trên lưới, sau đó đặt lại các điểm (gồm cả các điểm vector hỗ trợ). Rồi bạn dùng các hệ số để vẽ biên quyết định bằng một phương trình đơn giản dạng:
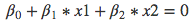
Từ phương trình đó, bạn phải xác định độ dốc và giao điểm cho biên quyết định. Rồi bạn có thể dùng hàm abline với hai đối số đó. Hai lệnh abline tiếp theo lần lượt biểu diễn lề trên và lề dưới của biên quyết định.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)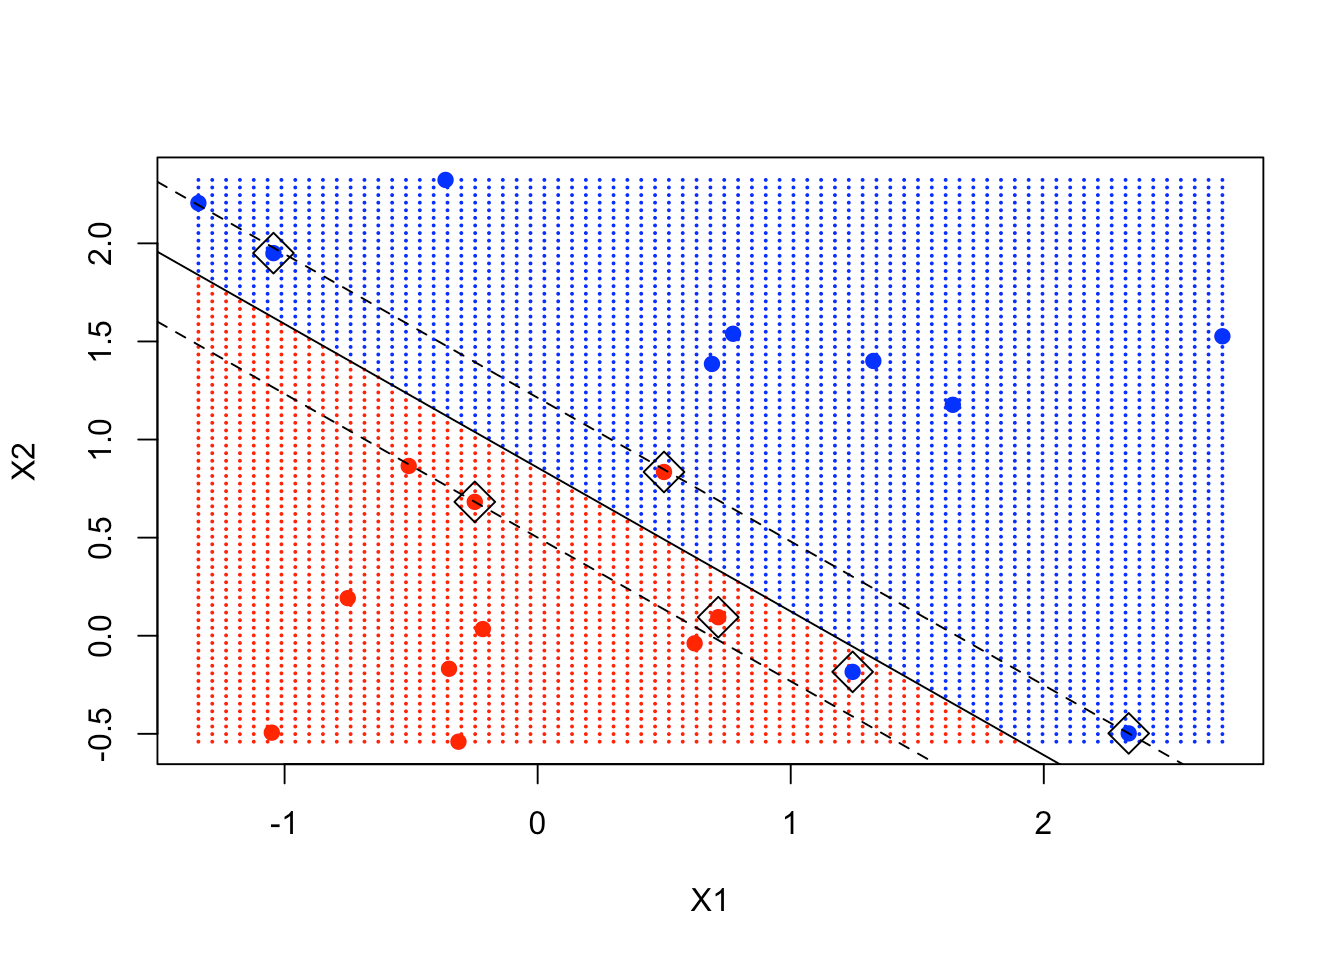
Bạn có thể thấy rõ một số điểm hỗ trợ nằm đúng trên lề, trong khi một số nằm bên trong lề.
Phần trước là SVM tuyến tính. Giờ hãy chuyển sang phiên bản phi tuyến của SVM. Bạn sẽ xem một ví dụ từ giáo trình Elements of Statistical Learning, có một ví dụ kinh điển trong 2 chiều với biên quyết định phi tuyến. Bạn sẽ dùng kernel support vector machine để cố gắng học biên đó.
Trước hết, bạn lấy dữ liệu cho ví dụ đó từ giáo trình bằng cách tải trực tiếp từ URL này, là trang nơi dữ liệu được lưu. Dữ liệu là hỗn hợp và mô phỏng. Sau đó bạn có thể xem tên các cột của nó.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Tạm thời, dữ liệu huấn luyện là x và y. Bạn đã tạo x và y cho ví dụ trước. Vậy hãy bỏ chúng đi để bạn có thể đính kèm dữ liệu mới này.
rm(x, y)
attach(ESL.mixture)
Dữ liệu cũng là 2 chiều. Hãy vẽ chúng để quan sát kỹ.
plot(x, col = y + 1)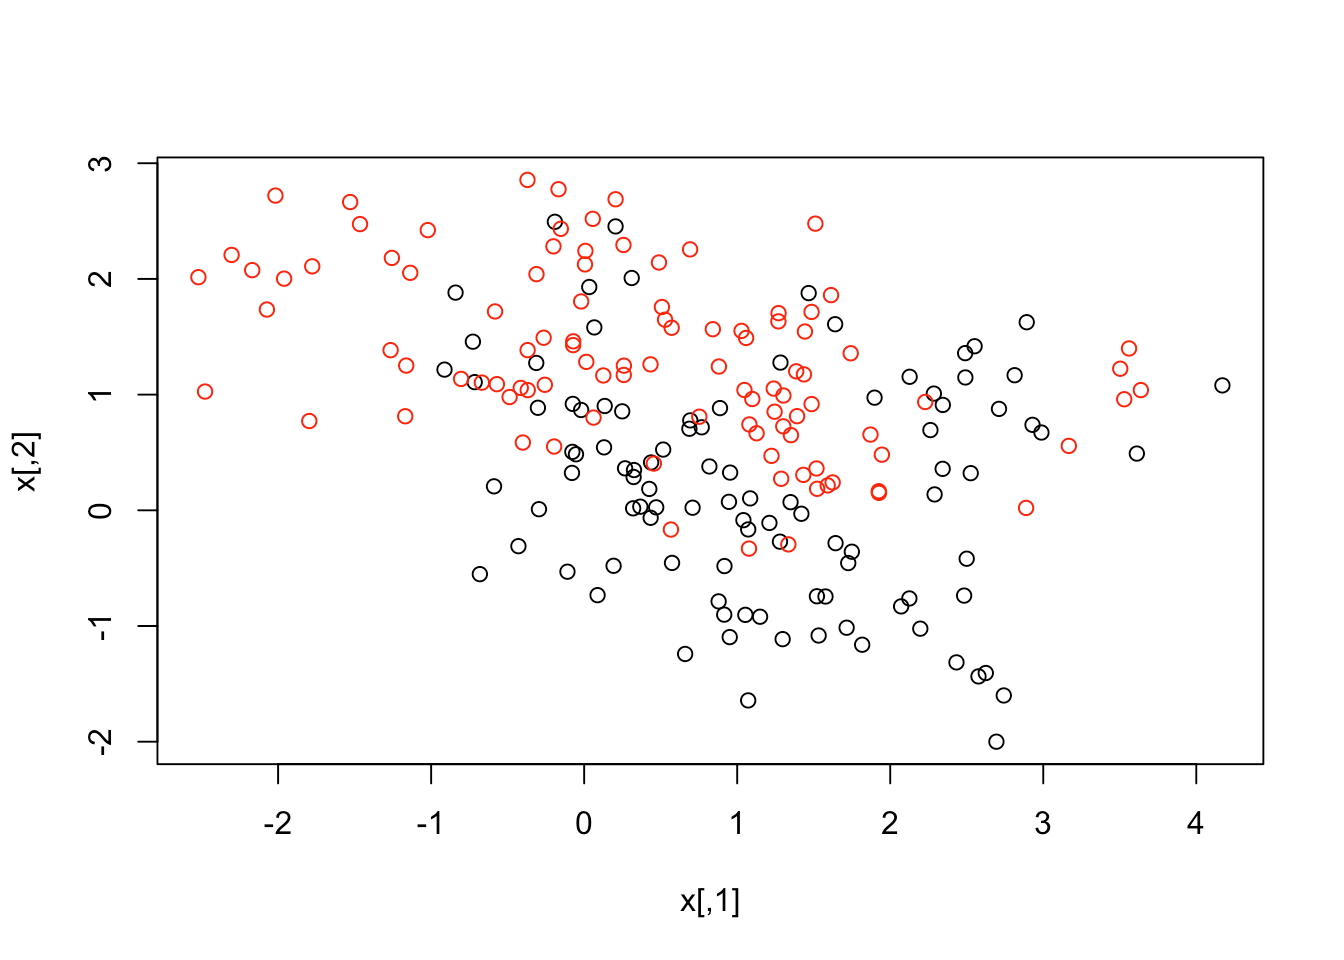
Dữ liệu có vẻ chồng lấn khá nhiều, nhưng bạn có thể thấy có điều gì đó đặc biệt trong cấu trúc của chúng. Giờ hãy tạo một data frame với phản hồi y, và chuyển nó thành factor. Sau đó, bạn có thể khớp một SVM với kernel xuyên tâm và cost là 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Đến lúc tạo lưới và đưa ra dự đoán. Dữ liệu này thực ra đi kèm sẵn các điểm lưới. Nếu bạn xem tóm tắt tên các phần tử trong danh sách, có 2 biến px1 và px2, là lưới giá trị cho từng biến. Bạn có thể dùng expand.grid để tạo lưới giá trị. Sau đó bạn dự đoán phân loại tại mỗi giá trị trên lưới.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Cuối cùng, bạn vẽ các điểm và tô màu chúng theo biên quyết định. Bạn có thể thấy biên quyết định là phi tuyến. Bạn cũng có thể đặt các điểm dữ liệu lên đồ thị để xem chúng nằm ở đâu.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)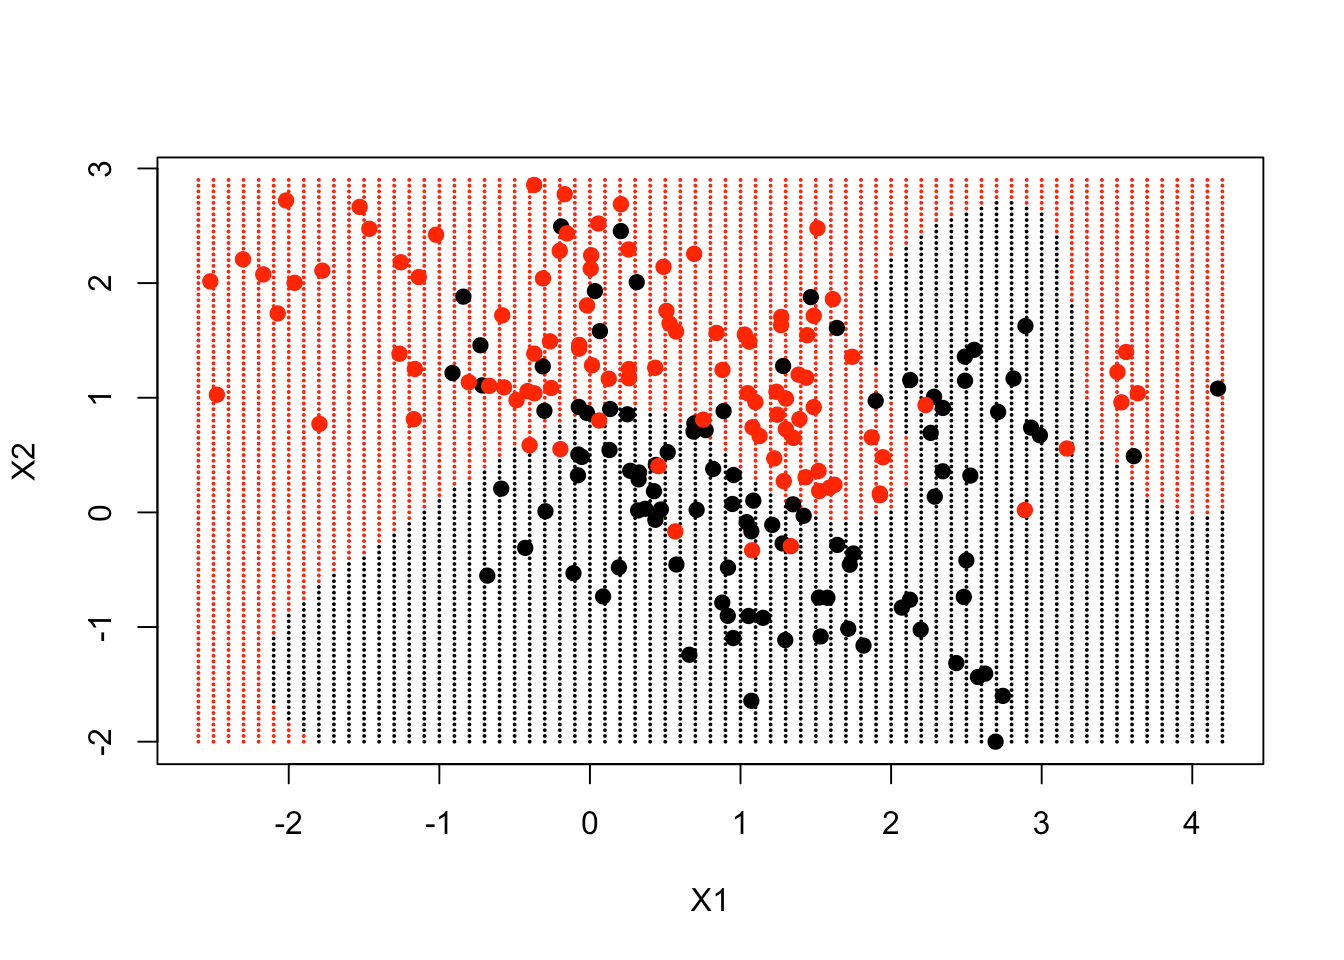
Biên quyết định, ở mức độ lớn, bám theo nơi dữ liệu nằm, nhưng theo cách rất phi tuyến.
Xem liệu bạn có thể cải thiện đồ thị này thêm một chút và để hàm predict tạo ra các ước lượng hàm thực tại mỗi điểm lưới. Cụ thể, bạn muốn vẽ một đường cong biểu diễn biên quyết định bằng cách dùng hàm contour. Trên data frame còn có biến prob, là xác suất thật của lớp 1 cho dữ liệu này, tại các điểm lưới. Nếu bạn vẽ đường đồng mức 0.5 của nó, đó sẽ là Biên quyết định Bayes, là biên tốt nhất có thể đạt được.
Trước tiên, bạn dự đoán mô hình của mình trên lưới. Bạn yêu cầu decision values bằng TRUE vì bạn muốn nhận hàm thực, không chỉ phân loại. Nó trả về một thuộc tính của các giá trị đã phân loại, nên bạn phải trích thuộc tính đó. Sau đó truy cập thuộc tính tên là decision.
Tiếp theo, bạn có thể lặp lại các bước như trên để tạo lưới, đưa ra dự đoán và vẽ các điểm.
Rồi đến lúc dùng hàm contour. Nó cần hai dãy lưới, một hàm, và hai đối số level và add. Bạn muốn hàm ở dạng ma trận, với kích thước của px1 và px2 (lần lượt là 69 và 99). Bạn đặt level bằng 0 và thêm nó vào đồ thị. Kết quả là bạn có thể thấy đường đồng mức bám theo biên quyết định, một cách tiện lợi để vẽ biên quyết định phi tuyến trong 2 chiều.
Cuối cùng, bạn thêm sự thật, tức là đường đồng mức của các xác suất. Đó là đồng mức 0.5, sẽ là biên quyết định theo nghĩa xác suất (còn gọi là Biên quyết định Bayes).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)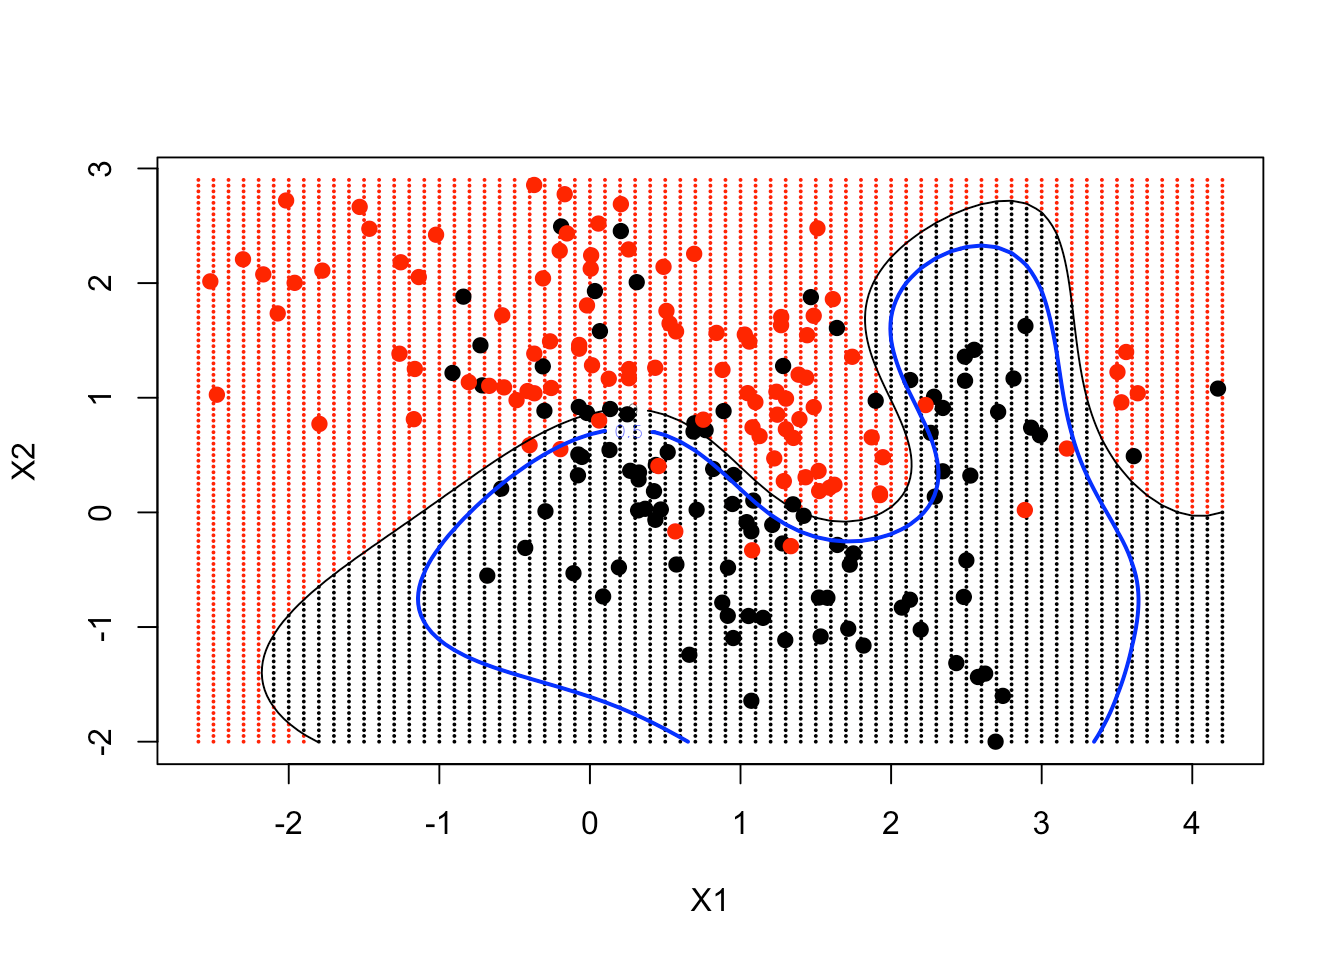
Kết quả cho thấy SVM phi tuyến của bạn đã tiến khá gần tới Biên quyết định Bayes.
Tóm lại, Support Vector Machines là một phân lớp của các bộ phân loại có giám sát, cố gắng chia không gian đặc trưng thành hai hoặc nhiều nhóm. Chúng đạt được điều này bằng cách tìm cách tối ưu để tách các nhóm dựa trên nhãn lớp đã biết:
Cá nhân tôi cho rằng SVM là bộ phân loại tuyệt vời cho những tình huống cụ thể khi các nhóm tách biệt rõ. Chúng cũng làm rất tốt khi dữ liệu của bạn tách phi tuyến. Bạn có thể biến đổi dữ liệu để tách tuyến tính, hoặc để SVM tự chuyển đổi dữ liệu và tách tuyến tính hai lớp ngay lập tức. Đây là một trong những lý do chính để dùng SVM. Bạn không phải tự biến đổi dữ liệu phi tuyến. Một điểm trừ của SVM là tính hộp đen của các hàm này. Việc dùng kernel để tách dữ liệu phi tuyến khiến chúng khó (nếu không muốn nói là không thể) diễn giải. Hiểu chúng sẽ mang lại cho bạn một lựa chọn thay thế GLM và cây quyết định cho bài toán phân loại. Hy vọng hướng dẫn này mang đến cho bạn cái nhìn rộng hơn về bức tranh SVM và giúp bạn hiểu rõ hơn về các mô hình này.
Nếu bạn muốn học thêm về R, hãy tham gia khóa Machine Learning Toolbox của DataCamp.
Hãy xem Hướng dẫn Support Vector Machines với Scikit-learn của chúng tôi.
Khóa học R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
