つい先週、OpenAI の GPT-Realtime-2 が GPT-5 クラスの推論と 128K コンテキストウィンドウを備えて登場し、音声 AI の水準を引き上げました。これに対し、Mira Murati 率いる Thinking Machines Lab は別の主張をしています。応答性と知性は、音声活動検知や対話管理コンポーネントを後付けで組み合わせるのではなく、最初から同じモデルに学習させるべきだ、というものです。
同ラボはこの新しいタイプのモデルを「インタラクションモデル」と呼んでいます。
研究プレビューである TML-Interaction-Small は、このアプローチの最初の成果です。2760 億パラメータの Mixture-of-Experts モデルで、同時に有効なパラメータは 120 億。音声・映像・テキストを 200ms の連続するマイクロターンで処理し、話し手が話し終えるのを待つのではなく、知覚と応答を同時に行います。
本記事では、TML-Interaction-Small の概要、主要なアーキテクチャの特徴を解説し、直接 GPT-Realtime-2 と比較し、ベンチマーク結果を詳しく見ていきます。
インタラクションモデルとは?
Thinking Machines Lab は、インタラクションモデルを「インタラクティビティ(対話性)が周辺のハーネスではなく、モデル自体に組み込まれているシステム」と説明しています。中核となる原則は、応答性と知性を、テキストベースのモデルに後付けするのではなく、連続的な音声・映像ストリームで最初から一緒に学習させるべきだという点です。
既存のリアルタイム音声 AI の多くは、音声活動検知、個別のエンコーダ、対話管理レイヤーを継ぎ合わせて応答性を再現します。Thinking Machines Lab は、このやり方では、インタラクションをネイティブに扱うモデルには常に遅れを取ると主張します。人工的なターン境界が、非インタラクティブなモデルの能力を制限してしまうからです。
ユーザー入力を逐次的に受け取ってから完全な応答を生成するのではなく、同ラボのインタラクションモデルは人間の知覚に近づくよう設計されています。入力トークンと出力トークンの両方をストリームとして扱い、両者を 200 ミリ秒のマイクロターンごとにインタリーブします。
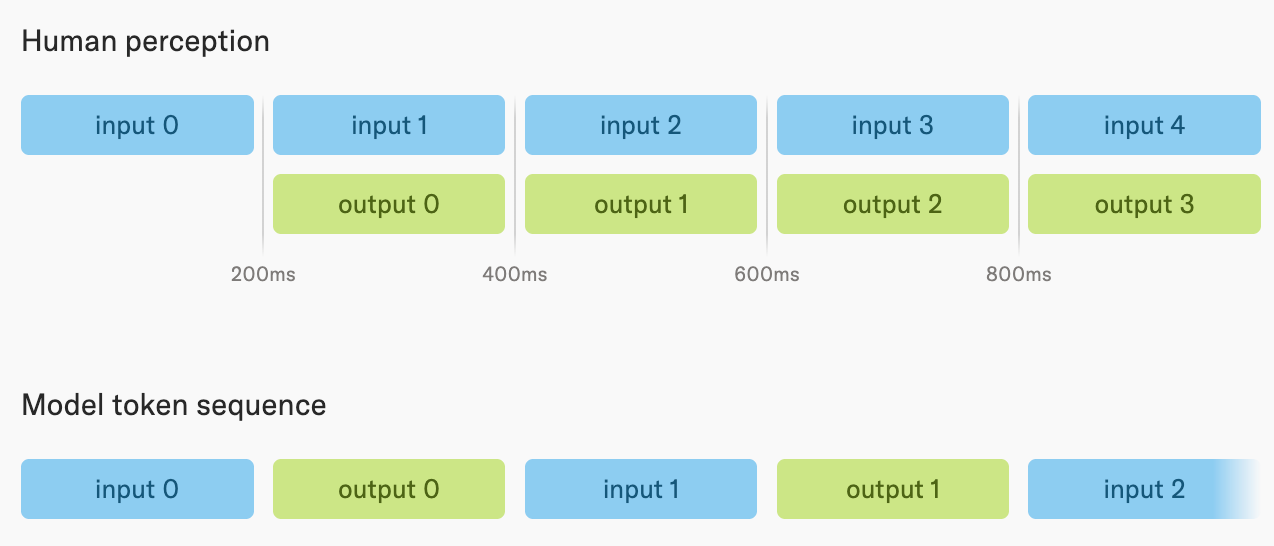 その結果、インタラクションモデルは話者が話し終わるのを待たず、入力と出力を並列処理して同時に知覚し応答します。これにより、次のような便利な能力が可能になります。
- 聞きながら話す
- 促されなくても視覚的な合図に反応する
- 経過時間を直接トラッキングする
これらは、外部ハーネスを用いるターン制のモデルでは、どれほど推論能力が高くても再現できないものです。
TML-Interaction-Small とは?
TML-Interaction-Small は、Thinking Machines Lab による初の一般公開モデルであり、同ラボのインタラクションモデル・アーキテクチャの最初の実装です。
これは 2760 億パラメータの Mixture-of-Experts モデルで、同時に有効なパラメータは 120 億。前述のマルチストリーム・マイクロターン設計を用い、連続する音声・映像ストリームでゼロから学習され、入力と出力を 200ms のチャンクで処理します。
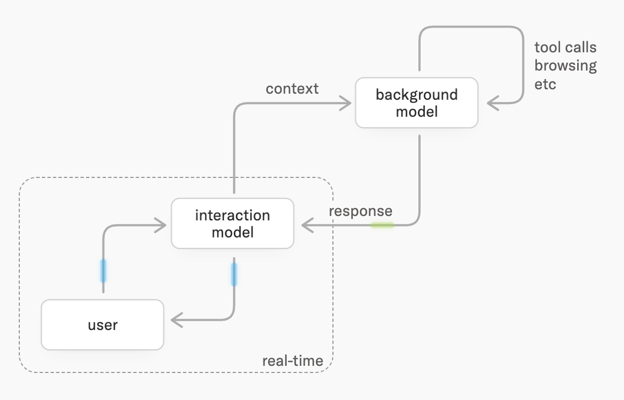
共有コンテキストを持つ 2 つのモデルを組み合わせることで、応答性と知性の両方を実現します。ユーザーはインタラクションモデルからリアルタイムに回答を受け取りつつ、計画、ツール使用、より深い推論はバックグラウンドモデルに非同期で委ねられます。
インタラクションモデルは、会話から離脱することなく、バックグラウンドの結果を到着次第、自然に会話へ織り込みます。
TML-Interaction-Small の機能
既存の音声 AI は「あなたが話し、相手が応答する」というターン制ですが、TML-Interaction-Small はより人間の会話相手に近い動作をします。差別化する 4 つの能力を紹介します。
同時に話し、同時に聞く
TML-Interaction-Small は、ユーザーが話している最中でも音声を生成できます。これにより同時通訳が可能になります。つまり、片方の言語で話すと、文を言い終える前から翻訳を開始します。また、誤りに気づいた瞬間に文の途中で割り込んだり、説明中に「了解です」「続けてください」といった合いの手を口頭で入れたりもできます。
これは、特定のイベントがトリガーされたときに、カスタムのリアルタイム応答を行う場面でも有用です。たとえばリリースノートのクリップでは、ユーザーが支払いに言及するたびに、モデルが EUR 金額を USD に換算して口頭で伝える様子が示されています。
頼まれなくても映像を見て反応する
TML-Interaction-Small は音声と並行して映像を処理し、口頭でのプロンプトがなくても目にした内容に基づいて発話を開始できます。
カメラの前で腕立て伏せをしていれば、回数をその場で数えてくれます。映像ストリームに関連する物体が現れれば、見えた瞬間にそれを指摘できます。ただし、この機能はまだ改善の余地があり、内部ベンチマークの RepCount-A では、約 3 分の 1(33.4%)しか正解の±1 回以内に収まりませんでした。
リリースのクリップのひとつ(やや風変わりに見えますが)では、ユーザーの姿勢に注意するよう指示すると、ノート PC に向かって猫背になった瞬間にそれを検知し、正すよう注意喚起する様子が示されています。
既存の商用リアルタイム API は音声専用です。発話ターンには応答できますが、視覚的な変化に能動的に反応する術はありません。これは、現時点の GPT-Realtime-2 や Gemini Live にはない能力です。
割り込みや自己修正を自然に処理
話し始めてから考えを変え、途中で言い直しても、TML-Interaction-Small はその修正を追跡し、意図した内容に応答します。バックチャネル(モデルが話している間に「うんうん」「なるほど」と相槌を打つ)を処理し、自分に話しかけているのか、同室の別の相手に話しているのかを区別します。
これらはターン制モデルがしばしば破綻する場面です。不適切に話すのをやめてしまったり、発言の不適切な部分に応答してしまったりします。TML-Interaction-Small が、デモ動画だけでなく日常の状況でも同様に扱えるかは、今後注目すべき点です。
会話に留まりながら重い処理をバックグラウンドで実行
インタラクションモデルを高速かつ知的にしているのがバックグラウンドモデルです。バックグラウンド処理の最中でも、追質問を続けたり、話題を変えたりできます。結果が準備できたら、ぶつ切りのコンテキスト切り替えで割り込むのではなく、自然なタイミングで会話に織り込みます。
つまり、会話のテンポを崩さない素早い応答と、通常なら数秒の沈黙を要する複数ステップのタスク処理を両立できます。クイズのデモクリップでは、3 人が高速で雑学クイズを出しても、モデルは概ねそのスピードについていけていました。
TML-Interaction-Small のベンチマーク
Thinking Machines は、インタラクティビティを測るストリーミング系ベンチマークと、知性を測るターン制ベンチマークの 2 つのカテゴリで結果を報告しています。アーキテクチャの特性が最も直接的に試されるストリーミング系で、最も好成績が出ています。
インタラクティビティ
FD-bench v1.5 は、事前録音の音声を与え、次の 4 つのシナリオでの挙動を測定します。
- ユーザーによる割り込み
- ユーザーのバックチャネル
- 周囲の他者との会話
- 背後の話し声
TML-Interaction-Small のスコアは 77.8。最小設定の Gemini-3.1-flash-live-preview は 54.3、最小設定の GPT-Realtime-2.0 は 46.8。GPT-Realtime-2.0 を最高推論設定(xhigh)にしても 47.8 にとどまります。
これは、Thinking Machines が目指すものを最も直接的に測るベンチマークです。最も近い競合に 30 ポイント差を付けるのは、僅差ではありません。もっとも、FD-bench v1.5 が実務上重要なインタラクティビティの全範囲を捉えているかは未解決の研究課題であると、Thinking Machines 自身も認めています。
ターン取得のレイテンシ
TML-Interaction-Small は FD-bench v1 で 0.40 秒というターン取得レイテンシを達成し、比較対象の中で最速です。次点は Gemini-3.1-flash-live-preview の 0.57 秒。GPT-Realtime-2.0 は最小設定でも約 3 倍(1.18 秒)、xhigh では 1.63 秒です。
レイテンシはテキストよりも音声で重要です。ユーザーが話し終えてからモデルが応答を開始するまで 1.2 秒の差があると、知覚できるどころか、会話の流れを損ないます。0.40 秒という結果は、人間の会話に近い反応時間に位置づけられます。
知性と指示追従
Audio MultiChallenge は、音声における知性と指示追従を測ります。TML-Interaction-Small は 43.4% を記録し、GPT-Realtime-1.5(34.7%)や Gemini-3.1-flash-live-preview(26.8%)を上回る一方で、GPT-Realtime-2.0 の xhigh(48.5%)には及びません。ここに知性とインタラクティビティのトレードオフが見て取れます。
TML-Interaction-Small と GPT-Realtime-2.0(xhigh)の差は 5.1 ポイントです。無視できないが決定的でもない差であり、しかも GPT-Realtime-2.0 側はレイテンシが大きく増えます(1.63 秒対 0.40 秒)。どちらを選ぶべきかはユースケース次第です。
応答品質とツール使用
FD-bench v3 は、音声+ツールのシナリオで応答品質とツール呼び出しの正確さを測ります。バックグラウンドエージェント有効時、TML-Interaction-Small は応答品質 82.8%、pass@1 が 68.0%。これに対し、GPT-Realtime-2.0 は最小設定で 80.0% / 52.0%、xhigh で 81.0% / 58.0% です。
ここで最も意味のある数値は pass@1(68.0% 対 58.0%)で、ツールに依存するタスクを実際に正しく完了できたかを測ります。ユーザーとのやり取りとツール呼び出しを分離する二層アーキテクチャの効果が出ているようです。
新しいインタラクティビティ系ベンチマーク:TimeSpeak、CueSpeak、視覚プロアクティビティ
Thinking Machines は、インタラクティビティを直接測るために、社内ベンチマークを 2 つ作成し、利用例の少ない 3 つを適用しました。競合モデルがいずれでも有意な成績を出せていないため、注意深く見る価値があります。
- TimeSpeak(タイミング制御された発話開始):TML-Interaction-Small は macro-accuracy 64.7%。
- CueSpeak(言語的合図での発話トリガー):macro-accuracy 81.7%。
- RepCount-A(視覚的アクションの回数カウント):±1 精度 33.4%。
- ProactiveVideoQA(視覚合図での発話トリガー):PAUC 31.5(無応答ベースライン = 25.0%)。
- Charades temporal localization(視覚アクションのタイミング特定):mIoU 30.4。
これら新ベンチマークの多くで、GPT Realtime-2.0 はほぼゼロ、あるいはゼロに近い結果しか出せていません(動画中の適切なタイミングで「開始」「停止」と発話する必要がある Charades では特に顕著)。
これらは新規で、独立検証もまだのため、どれほど意味のある差か断言はしにくいものの、アーキテクチャの違いと他のベンチマークの傾向に整合的ではあります。
TML-Interaction-Small の価格と提供状況
TML-Interaction-Small は現在、限定的な研究プレビュー段階で、価格は未発表です。Thinking Machines は 2026 年中にアクセス範囲の拡大を予定しています。関心のある研究者・開発者は [email protected] まで連絡するとアクセス申請できます。
参考までに、GPT-Realtime-2 は音声入力トークン 100 万あたり $32、音声出力トークン 100 万あたり $64 に設定されています。詳細は GPT-Realtime-2 の概要で扱いました。TML-Interaction-Small の価格は、一般提供とあわせて発表される見込みです。
お気づきのとおり、モデル名には「-Small」という接尾辞が付いており、Thinking Machines がより大型のモデルを続けて出すであろうことが示唆されています。現時点では提供が遅すぎますが、2026 年後半にリリースが予定されています。
TML-Interaction-Small と GPT-Realtime-2 の比較
両モデルの差でより興味深いのは、インタラクティビティ系ベンチマークです。ユーザーの割り込み、バックチャネル、周囲の他者との会話、背景音声を測る FD-bench v1.5 では、TML-Interaction-Small が 77.8。GPT-Realtime-2.0 は最小設定で 46.8、最高推論設定(xhigh)でも 47.8 です。Thinking Machines の最適化目標を最も直接測る指標で 30 ポイント差がついています。
知性面ではトレードオフがありますが、その差はインタラクティビティほど大きくはありません。Audio MultiChallenge では GPT-Realtime-2.0(xhigh)が 48.5%、TML-Interaction-Small は 43.4%。BigBench Audio では GPT-Realtime-2.0(high)が 96.6%、TML-Interaction-Small は 75.7%(ただしバックグラウンドエージェント有効時は 96.5%)。
総じて、TML-Interaction-Small は応答性とインタラクティビティで先行し、GPT-Realtime-2.0 は高い推論設定で生の知性ベンチマークに強みがある、という構図が浮かび上がります。
| ベンチマーク | TML-Interaction-Small | GPT-Realtime-2.0(最小) | GPT-Realtime-2.0(xhigh) | Gemini-3.1-flash-live(最小) |
|---|
| FD-bench v1 ターン取得レイテンシ(秒) | 0.40 | 1.18 | 1.63 | 0.57 |
| FD-bench v1.5 平均 | 77.8 | 46.8 | 47.8 | 54.3 |
| FD-bench v3 応答品質(%) | 82.8* | 80.0 | 81.0 | 68.5 |
| Audio MultiChallenge APR(%) | 43.4 | 37.6 | 48.5 | 26.8 |
| BigBench Audio 正解率(%) | 75.7 / 96.5* | 71.8 | 96.6 | 71.3 |
| IFEval(VoiceBench)正解率(%) | 82.1 | 81.7 | 83.2 | 67.6 |
| IFEval テキスト正解率(%) | 89.7 | 89.6 | 95.2 | 85.8 |
* バックグラウンドエージェント有効時。
OpenAI の音声モデル群を実際に試すには、GPT-Realtime-2 API チュートリアルをご覧ください。
まとめ
TML-Interaction-Small は有望です。リリースノートの主張どおりであれば、短いレイテンシでインタラクティビティが大幅に向上し、応答品質や推論力を犠牲にしません。話しながら聞き、視覚的な合図にも同時に反応できる能力は現時点で独自性が高く、可能性が広がります。一般提供時の価格設定にも注目したいところです。
GPT-Realtime-2 との知性の差は確かにありますが、インタラクティビティの差ほど広くはありません。会話を自然に感じさせることが重要な用途では、レイテンシの差のほうが知性の差より重大です。一方、難度の高い推論タスクにおける正確性を最優先するなら、GPT-Realtime-2.0 の高推論設定に分があります。
より広い AI モデルの動向や効果的な使い方を素早くキャッチアップしたい方は、まずは AI Fundamentals スキルトラックから始めるのがおすすめです。
つい先週、OpenAI の GPT-Realtime-2 が GPT-5 クラスの推論と 128K コンテキストウィンドウを備えて登場し、音声 AI の水準を引き上げました。これに対し、Mira Murati 率いる Thinking Machines Lab は別の主張をしています。応答性と知性は、音声活動検知や対話管理コンポーネントを後付けで組み合わせるのではなく、最初から同じモデルに学習させるべきだ、というものです。
同ラボはこの新しいタイプのモデルを「インタラクションモデル」と呼んでいます。
研究プレビューである TML-Interaction-Small は、このアプローチの最初の成果です。2760 億パラメータの Mixture-of-Experts モデルで、同時に有効なパラメータは 120 億。音声・映像・テキストを 200ms の連続するマイクロターンで処理し、話し手が話し終えるのを待つのではなく、知覚と応答を同時に行います。
本記事では、TML-Interaction-Small の概要、主要なアーキテクチャの特徴を解説し、直接 GPT-Realtime-2 と比較し、ベンチマーク結果を詳しく見ていきます。
インタラクションモデルとは?
Thinking Machines Lab は、インタラクションモデルを「インタラクティビティ(対話性)が周辺のハーネスではなく、モデル自体に組み込まれているシステム」と説明しています。中核となる原則は、応答性と知性を、テキストベースのモデルに後付けするのではなく、連続的な音声・映像ストリームで最初から一緒に学習させるべきだという点です。
既存のリアルタイム音声 AI の多くは、音声活動検知、個別のエンコーダ、対話管理レイヤーを継ぎ合わせて応答性を再現します。Thinking Machines Lab は、このやり方では、インタラクションをネイティブに扱うモデルには常に遅れを取ると主張します。人工的なターン境界が、非インタラクティブなモデルの能力を制限してしまうからです。
ユーザー入力を逐次的に受け取ってから完全な応答を生成するのではなく、同ラボのインタラクションモデルは人間の知覚に近づくよう設計されています。入力トークンと出力トークンの両方をストリームとして扱い、両者を 200 ミリ秒のマイクロターンごとにインタリーブします。
これらは、外部ハーネスを用いるターン制のモデルでは、どれほど推論能力が高くても再現できないものです。
TML-Interaction-Small とは?
TML-Interaction-Small は、Thinking Machines Lab による初の一般公開モデルであり、同ラボのインタラクションモデル・アーキテクチャの最初の実装です。
これは 2760 億パラメータの Mixture-of-Experts モデルで、同時に有効なパラメータは 120 億。前述のマルチストリーム・マイクロターン設計を用い、連続する音声・映像ストリームでゼロから学習され、入力と出力を 200ms のチャンクで処理します。
共有コンテキストを持つ 2 つのモデルを組み合わせることで、応答性と知性の両方を実現します。ユーザーはインタラクションモデルからリアルタイムに回答を受け取りつつ、計画、ツール使用、より深い推論はバックグラウンドモデルに非同期で委ねられます。
インタラクションモデルは、会話から離脱することなく、バックグラウンドの結果を到着次第、自然に会話へ織り込みます。
TML-Interaction-Small の機能
既存の音声 AI は「あなたが話し、相手が応答する」というターン制ですが、TML-Interaction-Small はより人間の会話相手に近い動作をします。差別化する 4 つの能力を紹介します。
同時に話し、同時に聞く
TML-Interaction-Small は、ユーザーが話している最中でも音声を生成できます。これにより同時通訳が可能になります。つまり、片方の言語で話すと、文を言い終える前から翻訳を開始します。また、誤りに気づいた瞬間に文の途中で割り込んだり、説明中に「了解です」「続けてください」といった合いの手を口頭で入れたりもできます。
これは、特定のイベントがトリガーされたときに、カスタムのリアルタイム応答を行う場面でも有用です。たとえばリリースノートのクリップでは、ユーザーが支払いに言及するたびに、モデルが EUR 金額を USD に換算して口頭で伝える様子が示されています。
頼まれなくても映像を見て反応する
TML-Interaction-Small は音声と並行して映像を処理し、口頭でのプロンプトがなくても目にした内容に基づいて発話を開始できます。
カメラの前で腕立て伏せをしていれば、回数をその場で数えてくれます。映像ストリームに関連する物体が現れれば、見えた瞬間にそれを指摘できます。ただし、この機能はまだ改善の余地があり、内部ベンチマークの RepCount-A では、約 3 分の 1(33.4%)しか正解の±1 回以内に収まりませんでした。
リリースのクリップのひとつ(やや風変わりに見えますが)では、ユーザーの姿勢に注意するよう指示すると、ノート PC に向かって猫背になった瞬間にそれを検知し、正すよう注意喚起する様子が示されています。
既存の商用リアルタイム API は音声専用です。発話ターンには応答できますが、視覚的な変化に能動的に反応する術はありません。これは、現時点の GPT-Realtime-2 や Gemini Live にはない能力です。
割り込みや自己修正を自然に処理
話し始めてから考えを変え、途中で言い直しても、TML-Interaction-Small はその修正を追跡し、意図した内容に応答します。バックチャネル(モデルが話している間に「うんうん」「なるほど」と相槌を打つ)を処理し、自分に話しかけているのか、同室の別の相手に話しているのかを区別します。
これらはターン制モデルがしばしば破綻する場面です。不適切に話すのをやめてしまったり、発言の不適切な部分に応答してしまったりします。TML-Interaction-Small が、デモ動画だけでなく日常の状況でも同様に扱えるかは、今後注目すべき点です。
会話に留まりながら重い処理をバックグラウンドで実行
インタラクションモデルを高速かつ知的にしているのがバックグラウンドモデルです。バックグラウンド処理の最中でも、追質問を続けたり、話題を変えたりできます。結果が準備できたら、ぶつ切りのコンテキスト切り替えで割り込むのではなく、自然なタイミングで会話に織り込みます。
つまり、会話のテンポを崩さない素早い応答と、通常なら数秒の沈黙を要する複数ステップのタスク処理を両立できます。クイズのデモクリップでは、3 人が高速で雑学クイズを出しても、モデルは概ねそのスピードについていけていました。
TML-Interaction-Small のベンチマーク
Thinking Machines は、インタラクティビティを測るストリーミング系ベンチマークと、知性を測るターン制ベンチマークの 2 つのカテゴリで結果を報告しています。アーキテクチャの特性が最も直接的に試されるストリーミング系で、最も好成績が出ています。
インタラクティビティ
FD-bench v1.5 は、事前録音の音声を与え、次の 4 つのシナリオでの挙動を測定します。
TML-Interaction-Small のスコアは 77.8。最小設定の Gemini-3.1-flash-live-preview は 54.3、最小設定の GPT-Realtime-2.0 は 46.8。GPT-Realtime-2.0 を最高推論設定(xhigh)にしても 47.8 にとどまります。
これは、Thinking Machines が目指すものを最も直接的に測るベンチマークです。最も近い競合に 30 ポイント差を付けるのは、僅差ではありません。もっとも、FD-bench v1.5 が実務上重要なインタラクティビティの全範囲を捉えているかは未解決の研究課題であると、Thinking Machines 自身も認めています。
ターン取得のレイテンシ
TML-Interaction-Small は FD-bench v1 で 0.40 秒というターン取得レイテンシを達成し、比較対象の中で最速です。次点は Gemini-3.1-flash-live-preview の 0.57 秒。GPT-Realtime-2.0 は最小設定でも約 3 倍(1.18 秒)、xhigh では 1.63 秒です。
レイテンシはテキストよりも音声で重要です。ユーザーが話し終えてからモデルが応答を開始するまで 1.2 秒の差があると、知覚できるどころか、会話の流れを損ないます。0.40 秒という結果は、人間の会話に近い反応時間に位置づけられます。
知性と指示追従
Audio MultiChallenge は、音声における知性と指示追従を測ります。TML-Interaction-Small は 43.4% を記録し、GPT-Realtime-1.5(34.7%)や Gemini-3.1-flash-live-preview(26.8%)を上回る一方で、GPT-Realtime-2.0 の xhigh(48.5%)には及びません。ここに知性とインタラクティビティのトレードオフが見て取れます。
TML-Interaction-Small と GPT-Realtime-2.0(xhigh)の差は 5.1 ポイントです。無視できないが決定的でもない差であり、しかも GPT-Realtime-2.0 側はレイテンシが大きく増えます(1.63 秒対 0.40 秒)。どちらを選ぶべきかはユースケース次第です。
応答品質とツール使用
FD-bench v3 は、音声+ツールのシナリオで応答品質とツール呼び出しの正確さを測ります。バックグラウンドエージェント有効時、TML-Interaction-Small は応答品質 82.8%、pass@1 が 68.0%。これに対し、GPT-Realtime-2.0 は最小設定で 80.0% / 52.0%、xhigh で 81.0% / 58.0% です。
ここで最も意味のある数値は pass@1(68.0% 対 58.0%)で、ツールに依存するタスクを実際に正しく完了できたかを測ります。ユーザーとのやり取りとツール呼び出しを分離する二層アーキテクチャの効果が出ているようです。
新しいインタラクティビティ系ベンチマーク:TimeSpeak、CueSpeak、視覚プロアクティビティ
Thinking Machines は、インタラクティビティを直接測るために、社内ベンチマークを 2 つ作成し、利用例の少ない 3 つを適用しました。競合モデルがいずれでも有意な成績を出せていないため、注意深く見る価値があります。
これら新ベンチマークの多くで、GPT Realtime-2.0 はほぼゼロ、あるいはゼロに近い結果しか出せていません(動画中の適切なタイミングで「開始」「停止」と発話する必要がある Charades では特に顕著)。
これらは新規で、独立検証もまだのため、どれほど意味のある差か断言はしにくいものの、アーキテクチャの違いと他のベンチマークの傾向に整合的ではあります。
TML-Interaction-Small の価格と提供状況
TML-Interaction-Small は現在、限定的な研究プレビュー段階で、価格は未発表です。Thinking Machines は 2026 年中にアクセス範囲の拡大を予定しています。関心のある研究者・開発者は [email protected] まで連絡するとアクセス申請できます。
参考までに、GPT-Realtime-2 は音声入力トークン 100 万あたり $32、音声出力トークン 100 万あたり $64 に設定されています。詳細は GPT-Realtime-2 の概要で扱いました。TML-Interaction-Small の価格は、一般提供とあわせて発表される見込みです。
お気づきのとおり、モデル名には「-Small」という接尾辞が付いており、Thinking Machines がより大型のモデルを続けて出すであろうことが示唆されています。現時点では提供が遅すぎますが、2026 年後半にリリースが予定されています。
TML-Interaction-Small と GPT-Realtime-2 の比較
両モデルの差でより興味深いのは、インタラクティビティ系ベンチマークです。ユーザーの割り込み、バックチャネル、周囲の他者との会話、背景音声を測る FD-bench v1.5 では、TML-Interaction-Small が 77.8。GPT-Realtime-2.0 は最小設定で 46.8、最高推論設定(xhigh)でも 47.8 です。Thinking Machines の最適化目標を最も直接測る指標で 30 ポイント差がついています。
知性面ではトレードオフがありますが、その差はインタラクティビティほど大きくはありません。Audio MultiChallenge では GPT-Realtime-2.0(xhigh)が 48.5%、TML-Interaction-Small は 43.4%。BigBench Audio では GPT-Realtime-2.0(high)が 96.6%、TML-Interaction-Small は 75.7%(ただしバックグラウンドエージェント有効時は 96.5%)。
総じて、TML-Interaction-Small は応答性とインタラクティビティで先行し、GPT-Realtime-2.0 は高い推論設定で生の知性ベンチマークに強みがある、という構図が浮かび上がります。
* バックグラウンドエージェント有効時。
OpenAI の音声モデル群を実際に試すには、GPT-Realtime-2 API チュートリアルをご覧ください。
まとめ
TML-Interaction-Small は有望です。リリースノートの主張どおりであれば、短いレイテンシでインタラクティビティが大幅に向上し、応答品質や推論力を犠牲にしません。話しながら聞き、視覚的な合図にも同時に反応できる能力は現時点で独自性が高く、可能性が広がります。一般提供時の価格設定にも注目したいところです。
GPT-Realtime-2 との知性の差は確かにありますが、インタラクティビティの差ほど広くはありません。会話を自然に感じさせることが重要な用途では、レイテンシの差のほうが知性の差より重大です。一方、難度の高い推論タスクにおける正確性を最優先するなら、GPT-Realtime-2.0 の高推論設定に分があります。
より広い AI モデルの動向や効果的な使い方を素早くキャッチアップしたい方は、まずは AI Fundamentals スキルトラックから始めるのがおすすめです。