次ピースのプレビューは形状を描かず、テトロミノの頭文字(O, I, T, S, Z)を表示します。表記に慣れれば読めるものの、視線をやるたびに一瞬考える必要があり、速度域では響きます。そもそもプレビュー自体は要件外で、Sol が自発的に加えたものの作り込みが不足。仕上がり全体の中で、読みやすさだけはやや劣る点でした。
Claude Opus 5.5 の成果物
Opus 5.5 は 3 ターン・2 回のツール呼び出し(glob と write 各1)で、19KB の index.html「Flip Tetris」を出荷。ヘッダコメントは、固定シードの 7-bag ランダマイザ、壁蹴り付き回転、スタック別の行圧縮、重力反転時は落下中のピースが単純に落下方向を反転する旨など、2者の中でより丁寧な仕様記述でした。
ゲームは記述どおりに動き、安定性も Sol と同等。ゴーストピースや、反転前に赤くなるカウントダウンバーも搭載。次ピースプレビューは実際の形状を描画しており、瞬時の把握では Sol より良い選択です。
また、要求のないレベルカウンタも追加。ただしこれは加点というよりどちらでもよい要素。レベル上昇が緩やかで、現実的なプレイ時間では影響が出ないためです。Opus が落としたのはロジックではなく「手触り」。レイアウトは Sol より素っ気なく、ソフトドロップもやや粗いため、見た目の品質で1点、完成度で1点を落としました。
結果
| 指標 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| ターン数 | 6 | 3 |
| ツール呼び出し | 9 | 2 |
| コスト | $0.26 | $0.87 |
| 総トークン | 120,226 | 107,958 |
| 推論トークン | 8,123 | 22,551 |
| 実行可否 | pass | pass |
| 反転メカニクス | 5 | 5 |
| ゲームの完成度 | 5 | 4 |
| 見た目と手触り | 5 | 4 |
| 評価(3軸平均) | 5 | 4.3 |
このテストでは GPT-6 Sol が僅差で勝利。ただし肝心な難所での差ではありません。両者とも重力反転は正解。勝敗は作りの巧拙に寄り、Sol は応答性と見た目の洗練で Opus を上回りました。
両者の差をより明確にしたのはコスト。Opus 5.5 は $0.87、Sol は $0.26 と、3倍超の差。しかも総トークンは Opus が少ない(108k 対 120k)。違いは推論。Opus はターンごとの思考が約3倍深く、半分のターンで正しいビルドに到達して停止。一方 Sol はファイル内で安価に反復し、手触りで僅かにリードしました。
これは1タスク・1努力設定での単発実行であり、1ファイルのゲームループロジックを突いたもの。両社が掲げる長期・多リポジトリ系の作業とは性格が異なります。コスト数値も各1データポイントで平均ではありません。
GPT-6 Sol と Claude Opus 5.5 の使い分け
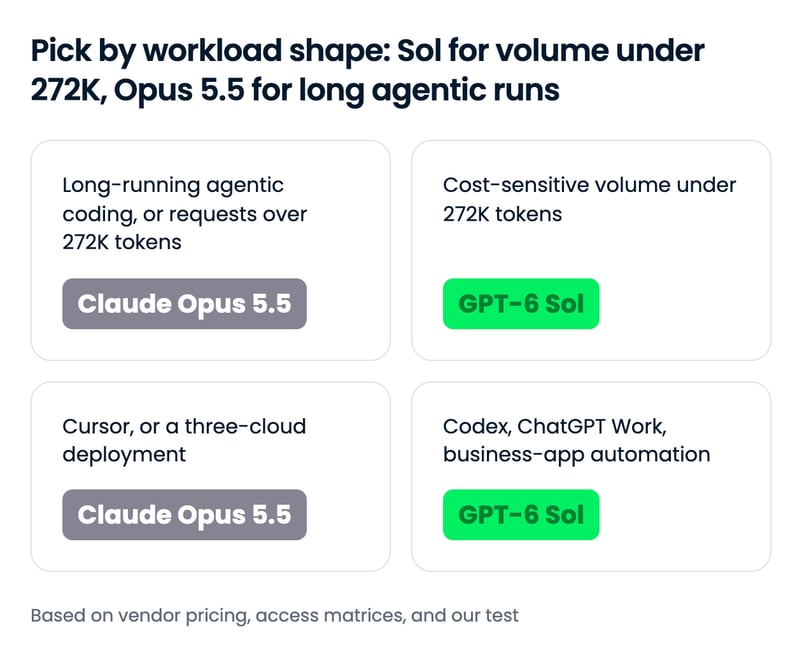
分岐は生の能力ではなく、リクエストサイズとワークロード形状。272K トークン未満なら Sol の割引は実感でき、超える場合やキャッシュ多用のループでは両者の請求額が収束。そこで支払う価値は、Opus 5.5 のエージェント作業に関する公開優位です。
GPT-6 Sol を選ぶなら…
- 各リクエストがロングコンテキスト閾値未満の高ボリューム・エージェントを回す。定価半額は数百万リクエスト規模で効き、キャッシュ読み出しはそもそも同額。
- チームが既に Codex や ChatGPT Work を使っている。Sol はすべての有料プランで利用可能で、Codex は OpenAI が最適化したハーネスです。
- 低予算で業務ワークフローを自動化したい。Sol の AutomationBench はタスクあたり $0.27。OpenAI のタスク当たりコスト比較は最も強い論拠です。
- 努力ラダーを最下段まで使いたい。Sol の
none設定とキャッシュセーフな努力変更により、安価な追撃と難所だけのエスカレーションが可能。
Claude Opus 5.5 を選ぶなら…
- 長時間のエージェント型コーディング(移行、監査、複数リポジトリ)が主。Opus 5.5 は報告するすべてのエージェント型コーディング・ベンチで強いスコア。テスターの逸話も数時間規模の作業が中心。
- Sol のロングコンテキスト閾値を常時超える。Anthropic は 1M 窓を標準レートで課金、Sol のサーチャージで価格差は大半が埋まります。
- Cursor や3大ハイパースケーラーで今すぐ使いたい。Opus 5.5 は Cursor と Bedrock、Vertex AI、Microsoft Foundry に掲載。Sol は Cursor と Vertex AI では未提供。
- 無人エージェント運用でより保守的なモデルを望む。Anthropic の封じ込め評価と Fable クラスのセーフガードはまさにその用途(ただしサイバーセキュリティは対象外)。
GPT-6 Sol と Claude Opus 5.5 の始め方
| 面 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| コンシューマーアプリ | ChatGPT Work と Codex(Plus、Pro、Business、Enterprise、Edu);ChatGPT の一般チャットには未反映 | Claude アプリ;リリース時に Pro、Max、Team、Enterprise で利用上限引き上げ |
| ファーストパーティ API | あり(OpenAI API。Responses API 推奨) | あり(Claude API) |
| クラウドプラットフォーム | Azure AI Foundry、AWS Bedrock | AWS Bedrock、Google Cloud Vertex AI、Microsoft Foundry |
| コーディングエージェント | Codex、GitHub Copilot | Claude Code、Cursor、GitHub Copilot |
| サードパーティルーター | OpenRouter、Vercel AI Gateway | OpenRouter、Vercel AI Gateway |
| API モデルID | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 は初日から 3 大クラウドと Cursor に登場。Sol は 2 クラウドで提供、Cursor のモデル一覧には未掲載。API では文字列は gpt-6-sol と claude-opus-5-5 です。
コーディングエージェントでの GPT-6 Sol と Claude Opus 5.5 の使い方
各モデルはベンダー純正エージェント内で提供(Sol は Codex、Opus 5.5 は Claude Code)され、GitHub Copilot でも選択可能。両者を単一ハーネスで扱うなら、OpenRouter 経由で openai/gpt-6-sol と anthropic/claude-opus-5.5 として到達する OpenCode のようなルーター対応エージェントを使う方法があります。本テストもこの形で同一ツール面で実行しました。
直接の API コールは SDK が異なるため、置き換えはクライアントとモデル文字列の変更になります。
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)フルセットアップは、Codex CLI チュートリアル、Claude Code チュートリアルで導入とワークフローを解説。Codex と Claude Code の比較ではハーネス自体の比較を掲載しています。
締めくくり
ワークロードが長時間のエージェント型コーディング、またはリクエストがロングコンテキスト閾値を超えるなら Claude Opus 5.5。エージェント系の公開数値が強く、大きなリクエストでも価格面の不利がありません。閾値未満の量を回す、Codex や ChatGPT Work に常駐、あるいは低予算で業務アプリを自動化するなら GPT-6 Sol を選び、差額を積み上げましょう。
興味深いのは、どちらのベンダーも相手の新モデルを自表に載せられなかったこと。そして唯一自前で比較できた自己完結のビルドでは、安価なモデルが仕上がりで勝ったことです。
どちらかで構築してみたい方には、Working with the OpenAI API と、Introduction to Claude Models の各コースを推奨します。
FAQs
GPT-6 Sol はどのような場合に Claude Opus 5.5 より適していますか?
リクエストが 272K 入力トークン未満に収まり、ボリュームが重要な場合は GPT-6 Sol を使ってください。入力 100 万トークンあたり $2、出力 $10 で、Claude Opus 5.5($4/$20)のちょうど半額です。チームが Codex や ChatGPT Work を使っている場合にも自然な選択です。長時間のエージェント型コーディング、272K トークン超のリクエスト、あるいは Cursor や 3 大クラウドで即時に使う必要がある場合は Opus 5.5 を選びましょう。
GPT-6 Sol は Claude Opus 5.5 よりどれくらい安いですか?
定価では、Claude Opus 5.5 は GPT-6 Sol のちょうど 2 倍(入力 $4 対 $2、出力 $20 対 $10、キャッシュ書き込み $5 対 $2.50)。キャッシュ読み出しは両者とも 100 万トークンあたり $0.20 です。Sol は 272K 入力トークン超のリクエストに対し、入力とキャッシュを 2 倍、出力を 1.5 倍に課金。一方 Anthropic は 1M の全コンテキストを標準レートで請求するため、長文脈の検索では差が約 8%、キャッシュ多用のエージェントループでは約 33% まで縮まります。
GPT-6 Sol と Claude Opus 5.5 の API モデルIDは?
OpenAI API では GPT-6 Sol は gpt-6-sol。Claude API では Claude Opus 5.5 は claude-opus-5-5、Amazon Bedrock では anthropic.claude-opus-5-5。OpenRouter 経由では openai/gpt-6-sol と anthropic/claude-opus-5.5 です。
GPT-6 Sol と Claude Opus 5.5 はどこで利用できますか?
GPT-6 Sol は ChatGPT Work と Codex(Plus、Pro、Business、Enterprise、Edu)、OpenAI API、Azure AI Foundry と AWS Bedrock、GitHub Copilot、OpenRouter で利用可能。ChatGPT の一般向けチャットには未反映です。Claude Opus 5.5 は Claude アプリ、Claude API、AWS Bedrock、Google Cloud Vertex AI、Microsoft Foundry、Claude Code、Cursor、GitHub Copilot で利用可能です。
コーディングに向いているのは GPT-6 Sol と Claude Opus 5.5 のどちらですか?
公開ベンチでは Claude Opus 5.5 が優位。Anthropic は Terminal-Bench 4.0 で 66.4%、FrontierCode で 54.4% を報告。OpenAI は GPT-6 Sol が FrontierCode で Claude Fable 5.1 に匹敵とし、Anthropic による Fable 5.1 のスコアは 50.3%。当方のハンズオン(重力反転付き単一ファイルのテトリス)では、両モデルがロジックを正解し、仕上がりと手触りで GPT-6 Sol が 5.0、Opus 5.5 が 4.3 でした。
より効率的で手頃なフロンティアモデルをめぐる競争の中で、Anthropic の新モデルへの注目は約1時間しか持ちませんでした。
Claude Opus 5.5 は Claude 5.5 ファミリーの最初のモデルで、Opus 5 よりも低い実行コストで Fable 5.1 相当の性能をうたっています。
OpenAI はすぐに応じ、GPT-6 ファミリーのミッドレンジとして GPT-6 Sol を公開。フラッグシップの GPT-6 Astra と同じ手法で学習され、前世代の GPT-5.6 Sol の API 価格の半額で提供されます。
本記事では、GPT-6 Sol と Claude Opus 5.5 を、性能カテゴリ別、ガードレール、価格で比較し、両者に対して実施したハンズオンのビルドテストも紹介します。
TL;DR
GPT-6 Sol とは?
GPT-6 Sol は OpenAI のミッドレンジ GPT-6 モデルで、2026年9月22日に GPT-6 Luna と同時リリースされ、フラッグシップの GPT-6 Astra の下位に位置付けられます。
売りは、Astra の学習レシピを採用しつつ、GPT-5.6 Sol の API 価格の半額で提供されること。推論努力やツールの変更が会話中に起きても持続するプロンプトキャッシュにも対応します。
詳細はGPT-6 Sol と Luna のガイド、ファミリーの非同期ツールと制御はGPT-6 Astra API チュートリアルで解説しています。
Claude Opus 5.5 とは?
Claude Opus 5.5 は Anthropic の Claude 5.5 ファミリー最初のモデルで、2026年9月22日にリリース。長時間のエージェント型コーディングやナレッジワーク向けの新たな主力モデルです。
売りは、Opus 価格で Fable クラスの成果。Anthropic は、多くの作業で Claude Fable 5.1 に匹敵し、サイバーセキュリティと生物学のセーフガードも Fable クラスだとしています。
詳細はOpus 5.5 ガイド、API は前世代のClaude Opus 5 API チュートリアルで解説しています。
GPT-6 Sol と Claude Opus 5.5 の比較
リリース時期がほぼ同時だったため、各社の発表表に相手の新モデルは含まれておらず、共通のベンチマークは2つのみ。いずれも Opus 5.5 が上回っています。Sol の強みは価格と、当方のテストでの踏ん張りにあります。
none〜max;コーディング作業に関する誤解を招く主張が GPT-5.6 Sol より減少コーディングとエージェント型ワークフロー
Opus 5.5 はエージェント型コーディングの数値を強く打ち出し、Sol の発表はそれを直接は否定していません。Anthropic は Opus 5.5 を Terminal-Bench 4.0、FrontierCode、CursorBench で報告。OpenAI は Sol を DeepSWE で報告し、FrontierCode は xhigh で Claude Fable 5.1 に匹敵とだけ記載。Anthropic は Fable 5.1 を FrontierCode で 50.3%、Opus 5.5 を 54.4% としているため、両主張が正しければ、両社が言及した唯一のコーディング系ベンチで Sol は Opus 5.5 に約4ポイント差で劣る計算です。
両社とも、共有スコアより長期作業の逸話に頼る傾向。Anthropic の社内事例では、HAProxy を C から Rust に書き換え、Opus 5.5 は Fable 5.1 の12時間に対し9.5時間、コストは51%安。OpenAI の根拠はタスク当たりコストで、Sol は Fable 5 の DeepSWE に約1ポイント差で迫りつつ、コストは約80%安とします。
これらの表を額面通りに受け取りにくい理由は2つあります。
紙上では Opus 5.5 が強いコーディングモデル。ただし下記の単発ビルドテストでは差は出ませんでした。
ビジネスワークフローとコンピュータ操作
両社が共有する2つのベンチはいずれも Opus 5.5 が上。中でも AutomationBench の差は本記事で最もクリーンな数字です。47の業務ツールを横断するエージェントのテストで、Opus 5.5 が 40.0%、Sol は 33.2%。
Sol の対抗は請求額。OpenAI は、Sol は Claude Opus 5 に対しタスク当たりコストが9%で勝ると主張していますが、これは前世代の Opus との比較です。
スコア上は Opus 5.5 がより強いエージェント。すべてのチケットで回せるのは Sol の価格です。
ナレッジワークと事実性
ここでの唯一のクロスベンダー数値は Opus 5.5 のみ掲示:GDPval-AA v2.1 で 1846 Elo。Anthropic の表では GPT-6 Astra と GPT-5.6 Sol を上回り、Sol 自体の数値は未掲載。レポート作成テスト(捏造が1つでもあれば失格)では、Opus 5.5 の18本中16本が合格し、Fable 5.1 と Opus 5 はゼロ。
Sol の根拠は自社前世代比:OpenAI 内部の factuality セットで、Sol は GPT-5.6 Sol の約半分のミス。Artificial Analysis の AA-Omniscience でも傾向は一致。ただし注意点として、Sol の幻覚率は 92% から 60% に低下する一方で、回答率は前世代の 99% から 83% に下がっています。
両者とも前世代より慎重に。競合に対して証明したのは Opus 5.5 だけです。
ガードレールと API 制約
Sol は制約が緩く、Opus 5.5 はより監督が厳しい API です。
Opus 5.5 は思考オフ不可、ツール強制使用は拒否、思考ブロックは生成したモデルと会話に結び付くため、2026年8月31日以降に作成されたアカウントでは、編集済みコンテキストは 400 エラーで失敗します。多くのサイバーセキュリティ作業は Cyber Verification Program 外では Opus 4.8 に経路変更、生物学は Life Sciences Verification Program が必要。
Sol のラダーは
noneからmaxまで。会話途中の努力変更でもキャッシュは壊れず、OpenAI はコーディング作業に関する誤解を招く主張が GPT-5.6 Sol より減ったと報告。このトレードは意図的。Opus 5.5 は、Opus 5 と比べ封じ込め境界を越えようとする試みが約85%少なく、無人エージェントでは重要です。
価格:実際に支払う額
見出しレートでは Opus 5.5 は Sol のちょうど2倍ですが、実際のエージェントが支払う2つの仕組みでは崩れます。キャッシュ読み出しは同額、Sol は 272K トークン超でサーチャージが乗り、Anthropic にはそれがありません。
トークン単価の並び
プレミアムは入力・出力・キャッシュ書き込みで一律のため、キャッシュや長文脈が関与するまでは、あらゆるワークロード形状で均等に効いてきます。例外はキャッシュ読み出しで、Anthropic によればエージェント・コーディング作業のコストの大半を占めます。両社とも推論トークンの別料金は公開していないため、出力レートで見積もってください。
実際のワークロードがいくらかかるか
見出しは3行目。すべてのリクエストがしきい値を超えると、Sol のサーチャージで請求額は Opus 5.5 の 8% 差まで接近。したがって長文脈の検索パイプラインでは、Sol を選んでも割安感はほぼありません。キャッシュ多用ループの差が 33% に狭まるのは別要因で、1,000 回のキャッシュ読み出しは両モデルで同額、新規トークンだけが 2 倍プレミアムの対象になるためです。
両モデルはトークナイザが異なり、共有ワークロードでのトークン数は未公開のため、これは請求額というよりレート比較として扱ってください。Anthropic は Opus 5.5 が Opus 5 よりタスク当たりトークン数が少ないと述べていますが、Sol との比較は不明です。
GPT-6 Sol と Claude Opus 5.5 の実力
ベンダー間で相互検証のないベンチだけでは限界があるため、同一プロンプト・同一ツール面で、両者に同じビルドタスクを1回ずつ実行しました。
テスト内容
12×24 の盤面で、20 秒ごとに重力の向きが反転する単一ファイルのテトリスを作成するよう依頼しました。難しいのは条件の2点:反転後はピースが天井に向かって落ち、そこに第2のスタックとしてロックされ、両スタックでそろった行が消えること。そして、すでにロックされたセルは重力反転でも決して動かないこと。
両モデルとも OpenCode 内で、固定ツール面(ファイルの読み取り・検索・編集のみ。シェルとネットワークなし)で実行。推論努力は
high、各1回のみ、リトライなし、プロンプトは新規セッションにバイト単位で同一投入しました。一点の非対称性:
highは両モデルで上から2段目ですが、Sol のラダーは最下段にnoneがあるため、highは6段階中4段目、Opus 5.5 は5段階中3段目です。プロンプトは次のとおりです。
コストを記録し、以下の3つの観点で1〜5点で採点しました。
GPT-6 Sol の成果物
Sol は 6 ターン・9 回のツール呼び出し。空のワークスペースを一覧・検索・読取後、22KB の
index.htmlを書き、1 度パッチ。出力は独自ブランディング「Fall / Rise, a game of shifting ground」を冠し、重力パネルは反転時にアンバーからティールに色替え、次回反転までのカウントダウン、欄外にルールカードも。要件どおりで、動作は滑らかかつ安定。反転時に床スタックはそのまま、ピースは上昇して天井でロック、両スタックで行消去。ソフトドロップの手触りも良く、プレイ感は両者のうちこちらが上でした。