강의
Claude 모델 입문
3시간
14.7K
Claude Sonnet 5.5는 Anthropic의 Claude 5.5 제품군에 속합니다. 이 프로젝트를 시작할 무렵 막 공개되었고, API 모델 ID는 claude-sonnet-5-5입니다. 모델 개요(model overview)에 따르면, 100만 토큰 컨텍스트 윈도우, 최대 128K 출력 토큰, 기본 활성화된 적응형 사고(adaptive thinking), API 기본 effort는 high입니다. 표준 요금은 입력 토큰 백만 개당 $2, 출력 토큰 백만 개당 $10입니다.
저희의 Claude Sonnet 5.5 개요에서는 벤치마크, 요금 비교, 접근 방법을 다룹니다. 이 릴리스에서 새로 추가된 API 기능이 세 가지 있으며, Rivermark는 이 모두를 사용합니다.
Claude Sonnet 5.5는 대화 도중에도 흐름을 바꿀 수 있는 세 가지 방법을 추가합니다. What's new in Claude Sonnet 5.5에 따르면, 이 기능은 Claude Sonnet 5에서는 사용할 수 없습니다:
Rivermark 에이전트는 두 가지 권한 수준을 가진 단일 Messages API 대화를 중심으로 하는 Python 애플리케이션입니다. 조사 단계에서는 Claude가 주문, 환불, 프로세서 거래, 마감 정책, Rivermark의 조정 검사를 읽을 수 있습니다. 승인 후에는 승인된 조정만 기록할 수 있습니다.
Rivermark는 Claude Agent SDK 대신 사용자 지정 Messages API 루프를 사용합니다. 승인 게이트가 Claude의 도구 호출과 실제 실행 사이에 위치해야 하기 때문입니다.
전체 코드와 샘플 데이터는 Rivermark GitHub 저장소에 있습니다.
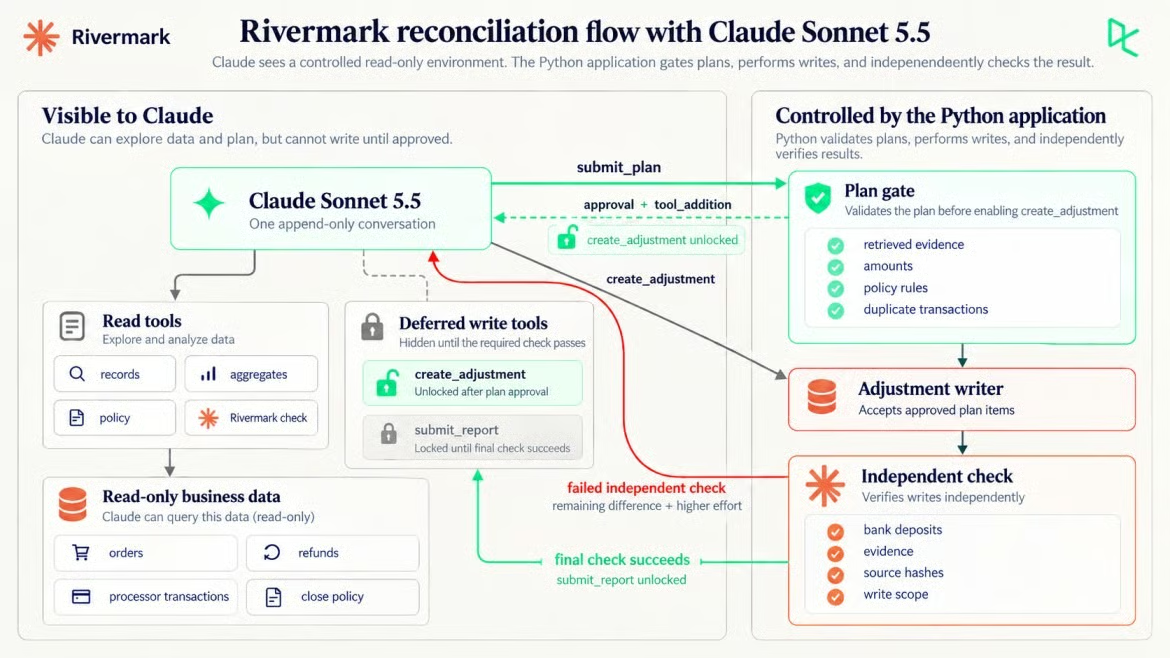
제안은 Claude가, 쓰기 권한 부여는 Python이. 이미지: 필자
Rivermark의 검사는 예상 지급액 $3,400.14와 계산된 프로세서 합계 $3,251.14를 보고하며, 둘의 차이는 $149.00입니다. Claude는 숨겨진 두 가지 원인을 보지 못한 채 기록 간 차이를 설명해야 합니다.
Rivermark는 월 구독 세 가지를 판매합니다: Starter $29, Team $79, Business $149. 샘플에는 9월 주문 58건, 환불 기록 7건, 9월 프로세서 거래 65건이 들어 있습니다. 각 프로세서 기록에는 금액, 수수료, 순액(net)이 있습니다.
조정 완료 여부는 Claude가 아니라 Python이 결정합니다:
해당 월은 프로세서 정산일 기준 2026년 9월입니다.
9월 은행 예금 총액은 실험의 독립적인 정산 목표입니다.
균형(Balanced)이란 예상 지급액에 조정을 더한 값이 예금액과 1센트 단위까지 일치함을 뜻합니다.
모든 조정은 Claude가 조회한 프로세서 txn_ids를 인용하고, 그 금액은 해당 항목들의 순액과 같아야 합니다.
Claude는 승인된 조정 추가와 최종 보고서 제출만 할 수 있습니다.
원시 내보내기 파일은 처리 전 해시하고, 처리 후에도 일치해야 합니다.
초기 조사 동안 Claude는 은행 기록이나 목표 합계를 들여다볼 수 없습니다. 검증이 실패하면, Python은 은행 기록 자체가 아니라 예상 지급액, 총 예금 합계, 남은 차액만 공개합니다.
Python 3.10 이상이 필요하며, Python SDK에서 요구합니다. 또한 Anthropic API 키와 anthropic 1.9.0이 필요합니다. 아래 PowerShell 명령은 프로젝트를 클론하고 환경을 만들며 샘플 데이터를 빌드합니다:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
macOS 또는 Linux에서는 source .venv/bin/activate 및 cp .env.example .env를 사용한 뒤, .env에 키를 넣으세요. 저희 환경 변수 가이드가 패턴을 설명합니다.
streamlit run app_streamlit.py는 조정 과정의 각 단계를 실시간으로 보여주는 웹 인터페이스를 엽니다. 저희 Streamlit 튜토리얼이 설정 방법을 다룹니다.
API 키가 이미 동작한다면, 다음 요청은 건너뛰고 adaptive thinking으로 넘어가세요.
API 요청과 응답 객체가 처음이라면 저희 Python API 가이드에서 기본을 확인하세요. 키를 확인하고 반환된 콘텐츠 블록을 살펴보는 데에는 환불 관련 질문 하나면 충분합니다:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
제 실행에서는 응답이 thinking 블록으로 시작했습니다. response.content[0]을 읽기보다 type으로 블록을 선택하세요. thinking 토큰은 출력으로 과금됩니다.
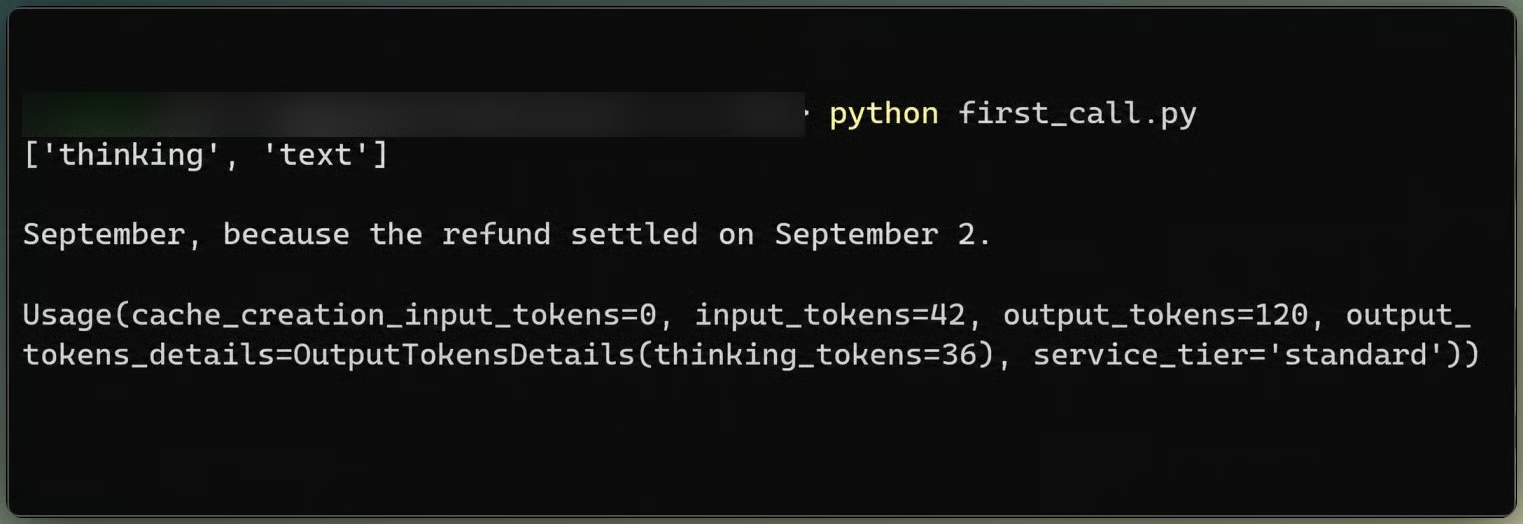
첫 응답은 thinking과 text를 분리합니다. 이미지: 필자
모든 요청은 동일한 상위 설정을 보내며, messages만 증가합니다:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
API의 기본값이 high임에도, 이 워크플로는 medium에서 시작합니다. Anthropic의 effort 가이드는 이렇게 말합니다. "에이전트식 코딩과 다단계 도구 사용에는, 작업이 명확히 정의되었으면 medium에서 시작하고 더 어렵거나 길면 high로 이동하세요."
추후 effort 변경에 의존하므로 thinking은 계속 adaptive로 둡니다. display: "updates"(베타, thinking-display-updates-2026-08-18)는 Claude가 도구 호출 사이에 남기는 메모를 반환합니다. 이 설정이 없으면 thinking 블록은 비어 있습니다.
상위 수준의 cache_control은 자동 프롬프트 캐싱을 켜며, 대화가 길어질수록 캐시 분기점이 앞으로 이동합니다. 첫 요청은 2,080 토큰을 캐시에 기록했는데, 이는 Claude Sonnet 5.5의 최소치인 512 토큰을 훨씬 웃돕니다.
읽기 전용 조사 에이전트는 Claude가 근거를 요청할 수 있게 하되, 쓰기 도구는 노출하지 않습니다. Rivermark는 승인되지 않은 쓰기 호출을 Python에서 거부합니다.
Claude는 strict: true가 설정된 다섯 개의 읽기 도구와 하나의 제안 도구를 받습니다. 설명에는 각 도구가 반환하는 내용만 적고, 어디서 찾아야 하는지는 언급하지 않습니다:
list_sources는 소스, 컬럼, 행 수를 반환합니다.
query_records는 한 소스에서 최대 40개의 행을 선택적으로 필터와 날짜 범위를 적용해 반환합니다.
aggregate_records는 임의의 컬럼 기준으로 행 수와 amount_cents 합계를 계산합니다.
read_policy는 마감 정책을 반환합니다.
run_reconciliation_check는 버그를 포함한 Rivermark의 기존 내부 로직을 실행합니다.
submit_plan은 진단과 제안된 조정을 Python으로 보내 검증만 하고, 아무것도 쓰지 않습니다.
두 개 도구가 같은 tools 배열에 있지만, defer_loading: true로 인해 지금은 Claude에게 보이지 않습니다. 이들이 나중에 어떻게 등장하는지 살펴봅니다:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
쓰기 도구의 스키마는 첫 요청 시점에 이미 알려져 있으므로, 도구는 미리 선언합니다. 지정 도구나 any 도구 선택은 400 오류를 반환하므로, 프롬프트에 submit_plan의 적용 시점을 명시합니다.
저희 에이전트 하니스 엔지니어링 가이드는 Python이 더 긴 에이전트 루프를 관리하는 방법을 설명합니다. Rivermark의 루프는 대화를 전송하고, Python에서 tool_use 블록을 실행한 뒤, 결과를 이어붙입니다. 읽기 도구가 반환하는 모든 레코드 ID는 나중에 계획 게이트가 확인하는 observed 집합에 들어갑니다:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
어시스턴트 턴은 받은 그대로, 비어 있는 thinking 블록까지 포함해 되돌려 보냅니다. 마이그레이션 가이드에 따르면 Claude Sonnet 5.5는 thinking 블록을 이전 메시지에 결합하므로, 그 이력을 편집하면 400 오류가 날 수 있습니다.
medium에서 조사는 6회 API 호출과 9회 읽기 도구 호출로 진행됐습니다. Claude는 환불을 가져오고 프로세서 라인을 reporting_category로 그룹화했습니다. 이어 RF-1043, 8월 31일 주문에 대한 $149.00 환불이 9월 2일에 정산된 것을 찾았습니다. 정책 규정 POL-3에 따라 9월에 반영됩니다.
그다음 분쟁 라인 두 건을 모두 열어봤습니다. TXN-50036에는 -$149.00 원금, $15.00 수수료, -$164.00 순현금 효과가 있습니다. TXN-50052는 수수료 없이 $149.00 원금을 되돌려줍니다. Claude는 이렇게 썼습니다. "DSP-0077의 합계는 0이고 $15 수수료는 이미 올바르게 장부에 반영되어 있으므로, RF-1043만으로 변동을 완전히 설명할 수 있습니다."
Claude는 수수료를 뺀 원금 반환과 실제 현금 효과를 혼동했습니다:
게이트는 Claude의 첫 계획을, 조회하지 않은 주문 ORD-20813을 인용했다는 이유로 거절했습니다. Claude는 해당 주문을 가져온 뒤 다시 제출했고, PLAN-1은 하나의 조정으로 통과했습니다.
쓰기 도구를 노출하기 전에, 게이트는 근거의 출처와 계획이 바꾸려는 내용을 검사합니다.
계획의 각 조정은 프로세서 txn_id를 인용합니다. 게이트는 해당 라인이 모두 이 대화의 읽기 도구에서 되돌아온 것이고, 그 합계가 제안 금액과 일치할 때만 승인합니다:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
분쟁 차감 라인만 인용한 $15.00 조정은 해당 라인의 순액이 -$164.00이므로 실패합니다. 반대 처리(리버설)도 함께 인용해야 합니다.
게이트는 정책 규정과 중복 거래도 확인합니다. 다음 항목 중 하나라도 해당되면 계획은 거절되며, 쓰기 권한은 계속 잠겨 있습니다:
거절은 submit_plan 도구 결과로 돌아가므로, Claude는 추가로 조사하고 다시 제출할 수 있습니다. 게이트는 4건 중 2건을 거절했으며, Claude는 각 건을 다음 호출에서 수정했습니다. 승인 후에도 create_adjustment는 승인 항목과 정확히 일치하는 입력만 받습니다.
계획이 승인되면, Python은 role: "system" 메시지를 tool_addition 블록과 함께 추가합니다. 이 변경에는 inline-tools-2026-09-15 베타 헤더가 필요합니다. tools 배열과 그 이전 메시지는 변경되지 않으므로 캐시된 접두부는 그대로 유지됩니다. 지시 텍스트는 Claude가 아니라 Python에서 제공합니다:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
내용이 있는 시스템 메시지는 user 턴 다음에 와야 합니다(tool_result 블록이 있는 경우 포함). tool_use 블록과 그 결과 사이에는 둘 수 없습니다. 시스템 메시지는 우선순위가 더 높으므로, Claude의 계획 텍스트나 도구 출력, 데이터를 절대 시스템 메시지에 넣지 마세요. tool_addition 블록은 create_adjustment를 참조로 지정하며, 이 도구는 계획 통과 후에만 보입니다.
도구 변경 후에도 캐싱은 계속되었습니다. 해당 요청은 캐시 밖 입력 토큰 231개를 처리하고, 캐시에서 6,883개를 읽었습니다.
첫 조정은 옳았지만, 그럼에도 작업은 끝나지 않았습니다. Claude는 POL-3에 따른 -$149.00의 ADJ-001을 기록하고 완료로 보고했습니다. Rivermark 내부 검사는 $0.00 변동으로 동의했을 것입니다. 그럴듯해 보이지만, 아직 끝난 게 아닙니다.
독립적인 Python 검사는 은행 예금과 비교합니다. 조정 후 예상 지급액은 $3,251.14, 예금은 $3,236.14로 $15.00이 남았습니다.
이 격차 때문에, 완료 검사는 Claude의 최종 메시지가 아니라 Python에 위치합니다.
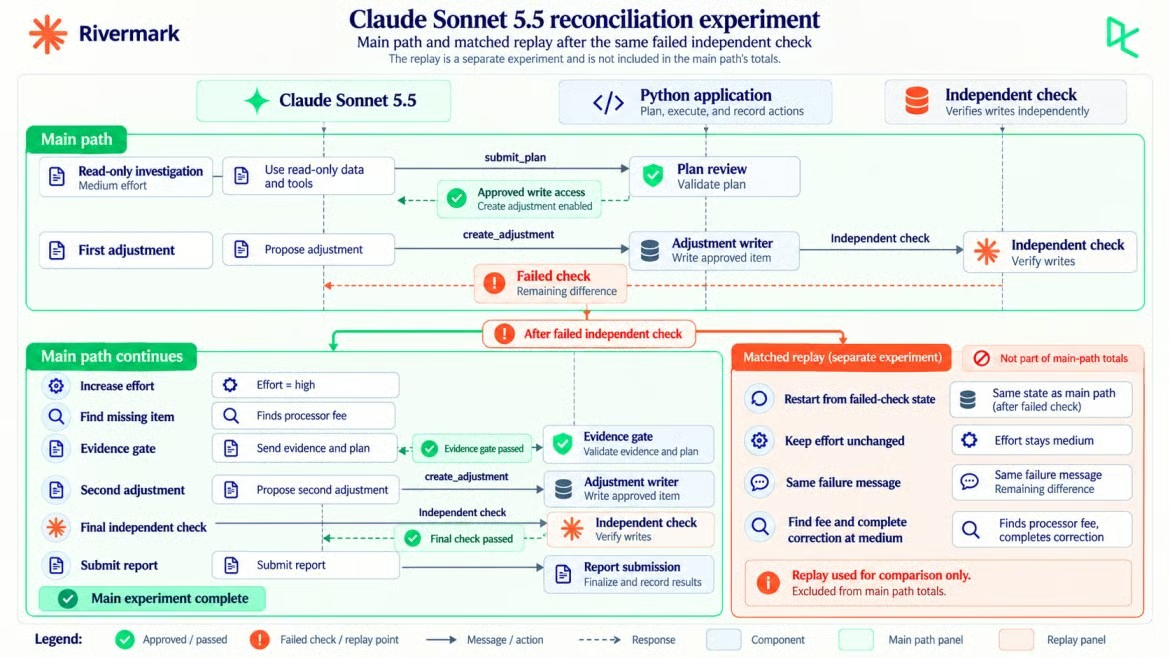
검증 실패 지점에서 분기한 대응 재실행. 이미지: 필자
Claude Sonnet 5.5에서 대화 중간 effort 변경은 빈 content의 시스템 메시지와 새 output_config.effort를 추가하는 방식입니다. 새 수준은 다음 user 턴부터 적용되며, 그전의 내용은 계속 캐시에 남습니다.
메시지별 effort는 베타이며 mid-conversation-output-config-2026-07-01 헤더가 필요합니다. 또한 adaptive thinking이 필요합니다. between_tools 설정에서는 같은 변경이 400 오류를 냅니다. 독립 검사에 실패하면, Python은 다음 사용자 메시지 전에 새 effort 설정을 추가합니다:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
상위 수준 effort 변경은 요청의 프롬프트 접두부를 바꾸므로 캐시를 다시 시작합니다. 메시지별 형태는 그렇지 않습니다. 첫 high-effort 요청은 캐시에서 8,012 토큰을 읽고, 캐시 밖 4 토큰을 처리했습니다.
$15.00의 차액은 Claude에게 목표를 제공하지만, 수정의 근거는 아닙니다. 게이트는 여전히 Claude가 조회한 거래 ID를 요구하며, 해당 net_cents 합계가 -$15.00이어야 합니다. TXN-50036만 인용한 -$15.00 조정 제안은 해당 라인의 순액이 -$164.00이므로 여전히 실패합니다.
high에서는 프로세서 라인을 지급(payout)별, fee_cents별로 그룹화하고 내부 검사를 재실행했습니다. 다음 메모에서 수수료 라인의 합을 12,586센트로 집계했고, 분쟁 수수료를 더해 14,086센트가 되었습니다. Rivermark의 검사는 이를 누락했습니다.
첫 번째 수정 계획은 차감 라인만 인용해 규정에 걸렸습니다. 다음에는 분쟁 라인 두 건을 모두 인용했고, PLAN-2가 통과되어 ADJ-002로 POL-4에 따른 -$15.00이 기록되었습니다.
이 실험은 high가 필수였음을 보여주지 않습니다. 동일한 실패 지점에서 같은 대화 이력과 Python 메시지로 계속한 별도 재실행은 medium에 머물렀고, 동일한 게이트 거절을 포함해 수수료를 찾아냈습니다.
주 경로의 high-effort 6회 호출은 2,763 출력 토큰(그중 thinking 607)을 생성했고 비용은 $0.0484였습니다. 별도 대조(control)의 medium-effort 조사 6회 호출은 2,713 출력 토큰(그중 thinking 628)을 생성했고 비용은 $0.0464였습니다.
최종 보고서 호출 1회를 더해 대조는 총 7회 호출, $0.0615가 되었습니다. 이 호출과 비용은 주 경로의 15회 호출, $0.1190에 포함되지 않습니다.
두 경로는 동일한 실패-통지 메시지를 받았고, effort만 달랐습니다. 재실행 한 번으로 effort 효과의 크기를 측정할 수는 없지만, 이 사례에서는 high가 필수는 아니었음을 보여줍니다. 같은 가이드는 xhigh와 max를 "평가에서 품질 개선이 입증된" 경우로 제한합니다. high를 선택하기 전에 동일한 방식으로 테스트하세요.
최종 검증은 의도적으로 게이트의 두 가지 검사를 반복합니다: 근거와 쓰기 범위. 게이트는 쓰기 전에 제안을 검토하고, 최종 검증은 Python이 실제로 쓴 내용을 점검한 뒤 숫자와 원시 파일 검사를 추가합니다.
ADJ-002 이후 Python은 원시 기록, 승인된 조정, 은행 총액에서 모든 값을 다시 계산했습니다:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
네 항목 모두 통과했습니다. 조정 후 예상 지급액 $3,236.14가 예금과 일치했습니다. 두 조정 모두 조회된 라인으로 추적 가능했고, 원본 소스 데이터는 변경되지 않았으며, Python은 승인된 항목만 기록했습니다.
그제야 보고 단계가 시작됩니다. 애플리케이션은 effort를 다시 medium으로 되돌리는 메시지, 간단한 사용자 턴, 그리고 도구를 교체하는 시스템 메시지를 추가합니다:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
보고서는 최종 산출물일 뿐, 증거는 아닙니다. 후속 제안은 여전히 사람의 검토가 필요합니다. 아래 기록은 하나의 Streamlit 세션에서 권한, effort, 검사, 비용의 흐름을 따릅니다.
Streamlit은 시작부터 조정 과정을 따라갑니다. 영상: 필자
주요 조정은 medium에서 high로 전환했고, 15회 API 호출에 $0.1190, 총 70.0초(이 중 API 대기 69.0초)가 소요되었습니다. 별도의 대응 재실행은 포함하지 않습니다. 모든 수치는 응답 usage와 Claude Sonnet 5.5 요율에서 산출했습니다.
더 폭넓은 비용 분해는 저희 Claude API 가이드에서 프롬프트 캐싱과 배치 처리를 다룹니다.
input_tokens는 캐시 분기점 이후만 계산하므로, 총 입력은 앞서 링크한 프롬프트 캐싱 문서에서 설명하듯 세 필드의 합입니다. 캐시 쓰기와 읽기는 각자 요율이 있으며, thinking 토큰은 이미 output_tokens에 포함됩니다:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
조정 전체에서 Claude는 118,308개 입력 토큰 중 105,614개(약 89%)를 캐시에서 읽었고, 캐시 밖으로 과금된 입력은 636개뿐이었습니다. 아래 차트는 측정된 사용량에 네 가지 토큰 요율을 적용한 것입니다.
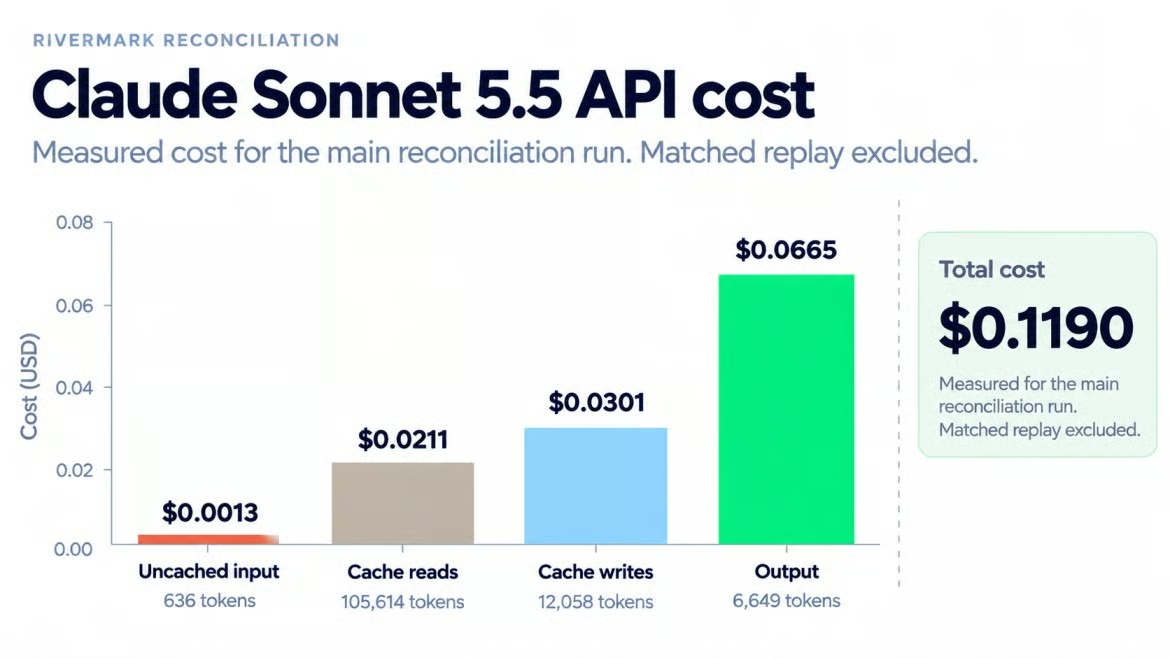
출력 토큰이 비용의 대부분을 차지했습니다. 이미지: 필자
Rivermark는 로컬 조정 기록을 씁니다. 운영 환경의 재무 시스템에는 다음이 여전히 필요합니다:
로컬, 가상 데이터. 실제 마감에는 인증, 감사 로그, 분개 승인, 데이터 보존 검토가 필요합니다.
베타 기능. 메시지별 effort, 도구 변경, thinking 업데이트에 쓰는 헤더는 변경될 수 있으니, 배포 전 다시 테스트하세요.
변동 가능한 결과. Claude Sonnet 5.5는 기본이 아닌 temperature를 거부하므로, 반복 시도 결과가 달라질 수 있습니다. 의존하기 전에 자체 데이터로 패턴을 검증하세요.
읽기 전용 도구로 조사하고, Python이 계획을 승인한 뒤에만 쓰기 도구 하나를 부여하며, 은행 예금과의 독립 검사를 통과해야만 끝나는 조정 에이전트를 만들었습니다. Claude Sonnet 5.5는 잘못 반영된 환불을 스스로 찾았지만, 이미 읽었던 $15.00 수수료로 다시 보내준 것은 실패한 검증이었습니다.
가상의 한 달을 모든 마감에 일반화하진 않겠습니다. 이어지는 것은 방식입니다. 계획이 통과할 때까지 쓰기 도구를 숨기고, 은행 기록은 모델 밖에 두며, 모든 수정에 거래 근거를 요구하고, 도구나 effort 변경은 캐시가 유지되도록 추가하세요.
독립 검사는 이 프로젝트의 축소판에서도 반드시 유지하겠습니다. effort 변경은 effort 섹션에서 다룬 이유로 신뢰 전에 시험해보겠습니다.
읽기 도구와 최종 검사를 바꿔 끼우면 같은 패턴으로 데이터 정리 보정, 고객 지원 환불, 통제된 문서 업데이트도 처리할 수 있습니다. 제가 첫 확장으로 고려할 것은 각 조정 기록 전에 사람 승인 단계를 넣는 것입니다. 실제 마감에는 필요하기 때문입니다.
이 빌드가 의존하는 Anthropic API의 기본기를 연습하려면, 저희 Introduction to Claude Models 코스를 추천합니다.
DataCamp에서 Claude 활용 학습!
강의
강의
트랙