
Khóa học
Nhập môn các mô hình Claude
3 giờ
14.7K
Claude Sonnet 5.5 là một phần của họ Claude 5.5 của Anthropic. Nó vừa được phát hành khi tôi bắt đầu dự án này, và ID mô hình API của nó là claude-sonnet-5-5. Theo tổng quan mô hình, nó có cửa sổ ngữ cảnh 1 triệu token, tối đa 128K token đầu ra, suy luận thích ứng bật mặc định và effort mặc định là high trên API. Bảng giá tiêu chuẩn là $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra.
Bài tổng quan Claude Sonnet 5.5 của chúng tôi đề cập đến điểm chuẩn, so sánh giá và quyền truy cập. Ba tính năng API của nó là mới trong bản phát hành này, và Rivermark sử dụng cả ba.
Claude Sonnet 5.5 bổ sung ba cách để thay đổi cuộc hội thoại khi nó đang chạy. Theo Có gì mới trong Claude Sonnet 5.5, không tính năng nào trong số này có trên Claude Sonnet 5:
Tác tử Rivermark là một ứng dụng Python xoay quanh một cuộc hội thoại Messages API với hai cấp quyền. Trong quá trình điều tra, Claude có thể đọc đơn hàng, hoàn tiền, giao dịch từ đơn vị xử lý, chính sách chốt sổ và bài kiểm tra đối soát của Rivermark. Sau khi được phê duyệt, nó chỉ có thể ghi lại các điều chỉnh đã được chấp thuận.
Rivermark dùng vòng lặp Messages API tùy chỉnh thay vì Claude Agent SDK vì cổng phê duyệt phải nằm giữa các lệnh gọi công cụ của Claude và việc thực thi chúng.
Mã hoàn chỉnh và dữ liệu mẫu có tại kho GitHub của Rivermark.
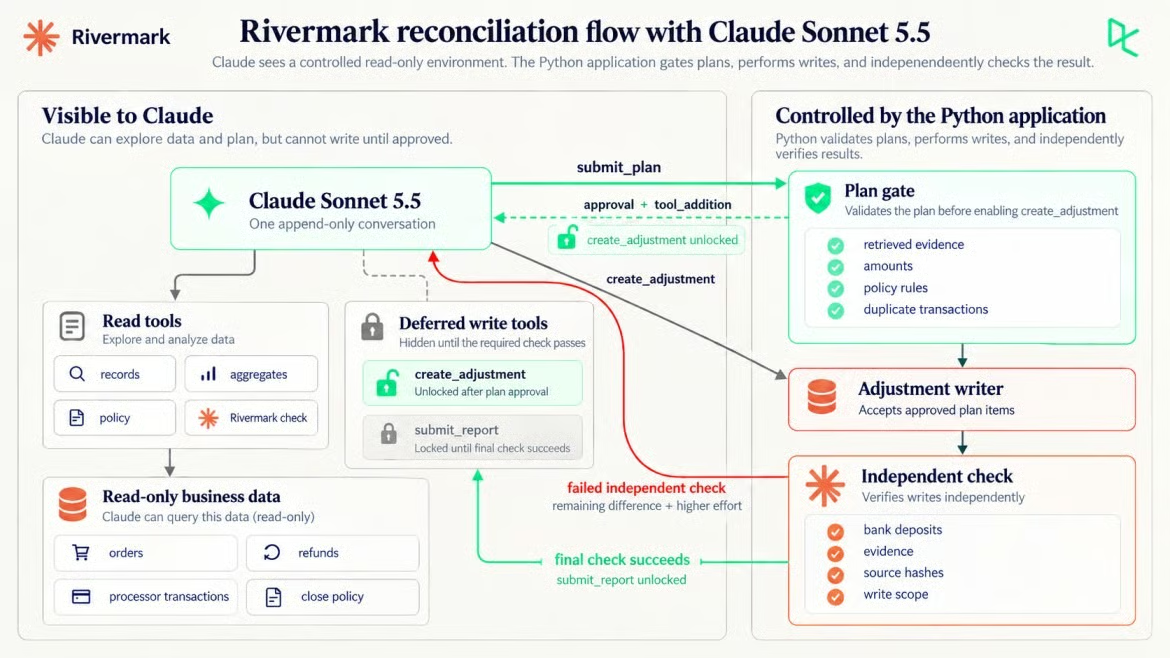
Claude đề xuất, Python cấp quyền ghi. Ảnh: Tác giả.
Kiểm tra của Rivermark báo cáo khoản chi trả kỳ vọng là $3.400,14 và tổng do đơn vị xử lý tính toán là $3.251,14, chênh $149,00. Claude phải giải thích chênh lệch giữa các hồ sơ mà không thấy hai nguyên nhân bị ẩn.
Rivermark bán ba gói theo tháng: Starter $29, Team $79 và Business $149. Mẫu chứa 58 đơn hàng tháng 9, 7 hồ sơ hoàn tiền và 65 giao dịch tháng 9 từ đơn vị xử lý. Mỗi hồ sơ từ đơn vị xử lý có một số tiền, một khoản phí và giá trị ròng.
Python, không phải Claude, quyết định khi nào đối soát hoàn tất:
Tháng là tháng 9/2026, theo ngày quyết toán của đơn vị xử lý.
Tổng tiền gửi ngân hàng tháng 9 là mục tiêu quyết toán độc lập của thí nghiệm.
“Cân bằng” nghĩa là chi trả kỳ vọng cộng điều chỉnh bằng đúng số tiền gửi đến từng xu.
Mỗi điều chỉnh trích dẫn các txn_ids của đơn vị xử lý mà Claude đã truy xuất, và số tiền của nó bằng phần ròng của các giao dịch đó.
Claude chỉ có thể thêm các điều chỉnh đã được phê duyệt và nộp báo cáo cuối cùng.
Xuất khẩu thô được băm trước khi xử lý và phải khớp sau đó.
Claude không thể kiểm tra hồ sơ ngân hàng hoặc tổng mục tiêu trong cuộc điều tra ban đầu. Sau một lần kiểm tra thất bại, Python chỉ tiết lộ chi trả kỳ vọng, tổng tiền gửi tổng hợp và phần chênh còn lại, chứ không đưa ra hồ sơ ngân hàng.
Bạn cần Python 3.10 trở lên, hỗ trợ bởi Python SDK, một khóa Anthropic API, và anthropic 1.9.0. Các lệnh PowerShell này sẽ nhân bản dự án, tạo môi trường và dựng dữ liệu mẫu:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Trên macOS hoặc Linux, dùng source .venv/bin/activate và cp .env.example .env, sau đó đặt khóa của bạn vào .env. Bài hướng dẫn biến môi trường của chúng tôi giải thích mẫu thiết lập.
streamlit run app_streamlit.py mở giao diện web hiển thị từng bước đối soát khi diễn ra, và bài hướng dẫn Streamlit của chúng tôi đề cập cấu hình.
Nếu khóa API của bạn đã hoạt động, hãy bỏ qua yêu cầu tiếp theo và chuyển sang suy luận thích ứng.
Nếu đối tượng yêu cầu và phản hồi API còn mới với bạn, bài hướng dẫn Python API của chúng tôi bao quát những điều cơ bản. Một câu hỏi về hoàn tiền là đủ để xác nhận khóa và xem các khối nội dung trả về:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Trong lần chạy của tôi, phản hồi bắt đầu bằng một khối thinking. Hãy chọn các khối theo type thay vì đọc response.content[0]; token thinking được tính là đầu ra.
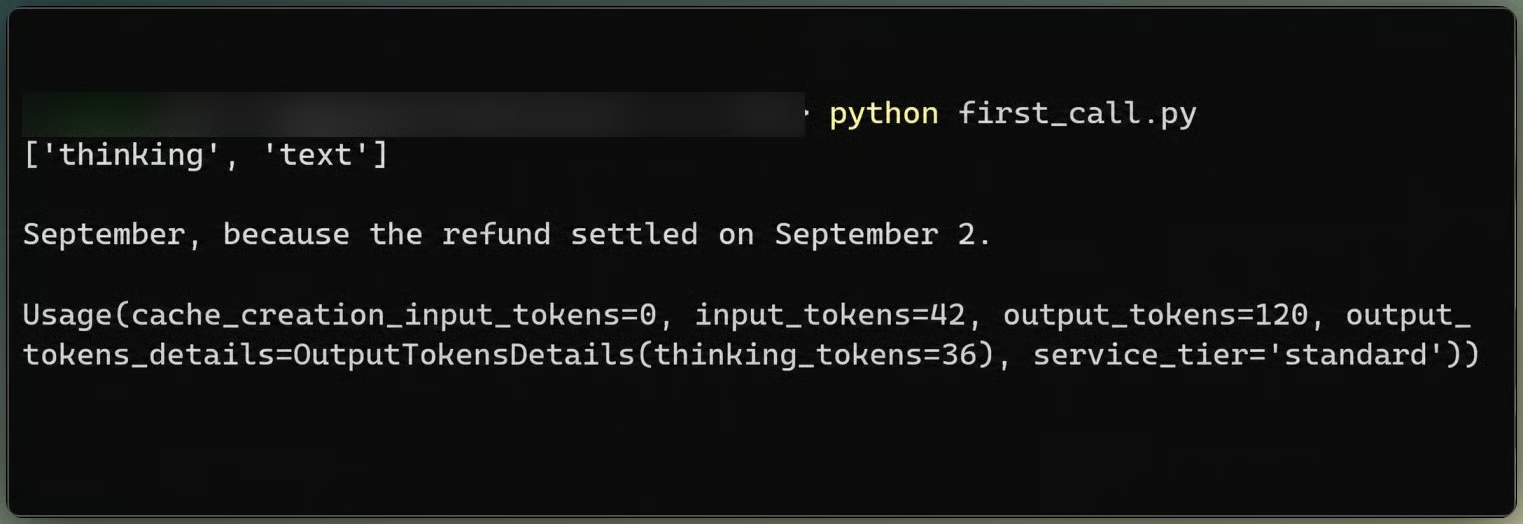
Phản hồi đầu tiên tách thinking khỏi text. Ảnh: Tác giả.
Mỗi yêu cầu gửi cùng các thiết lập cấp cao, và chỉ messages tăng dần:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Bất chấp mặc định high của API, quy trình này bắt đầu ở mức medium. Hướng dẫn về effort của Anthropic nêu: "Với tác vụ lập trình theo tác tử và dùng công cụ nhiều bước, hãy bắt đầu với medium cho bài toán được đặc tả rõ, và chuyển sang high cho bài toán khó hơn hoặc dài hơn."
Thinking vẫn là thích ứng vì thay đổi effort ở phần sau phụ thuộc vào điều này. display: "updates" (beta, thinking-display-updates-2026-08-18) trả về các ghi chú Claude viết giữa các lần gọi công cụ. Không có thiết lập đó, các khối thinking sẽ trống.
Thuộc tính cache_control cấp cao bật bộ nhớ nhắc tự động, với điểm ngắt di chuyển về sau khi cuộc hội thoại lớn dần. Yêu cầu đầu tiên ghi 2.080 token vào bộ nhớ, cao hơn nhiều so với mức tối thiểu 512 token của Claude Sonnet 5.5.
Một tác tử điều tra chỉ đọc cho phép Claude yêu cầu chứng cứ nhưng không lộ bất kỳ công cụ ghi nào. Rivermark cũng từ chối các lệnh ghi chưa được phê duyệt trong Python.
Claude có năm công cụ đọc và một công cụ đề xuất, tất cả đều strict: true. Phần mô tả nêu rõ mỗi công cụ trả về gì và không nói gì về nơi cần tìm:
list_sources trả về nguồn, cột và số dòng.
query_records trả về tối đa 40 dòng từ một nguồn, có thể kèm bộ lọc và khoảng ngày.
aggregate_records đếm dòng và tổng amount_cents theo bất kỳ cột nào.
read_policy trả về chính sách chốt sổ.
run_reconciliation_check chạy logic đối soát nội bộ hiện có của Rivermark, bao gồm cả lỗi.
submit_plan gửi chẩn đoán và điều chỉnh đề xuất tới Python để kiểm định, và không ghi gì.
Hai công cụ nữa nằm trong cùng mảng tools, nhưng defer_loading: true giữ chúng ngoài tầm nhìn của Claude lúc này. Chúng ta sẽ xem cách chúng xuất hiện sau:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Lược đồ của công cụ ghi đã biết ngay từ yêu cầu đầu tiên, nên công cụ được khai báo sẵn. Lựa chọn công cụ theo tên hoặc any sẽ trả về lỗi 400, nên phần nhắc nêu rõ khi nào dùng submit_plan.
Bài hướng dẫn kỹ thuật khung tác tử của chúng tôi giải thích cách Python quản lý các vòng lặp tác tử dài hơn. Vòng lặp của Rivermark gửi cuộc hội thoại, chạy mọi khối tool_use trong Python và nối kết quả vào. Mọi ID bản ghi mà một công cụ đọc trả về sẽ vào tập observed để cổng kế hoạch kiểm tra sau:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Lượt của trợ lý được gửi lại y nguyên như nhận được, bao gồm cả các khối thinking trống. Hướng dẫn chuyển đổi giải thích rằng Claude Sonnet 5.5 ràng buộc các khối thinking với những thông điệp trước đó, nên chỉnh sửa lịch sử có thể trả về lỗi 400.
Ở mức trung bình, cuộc điều tra mất sáu cuộc gọi API và chín lần gọi công cụ đọc. Claude kéo các khoản hoàn và nhóm các dòng của đơn vị xử lý theo reporting_category. Nó tìm ra RF-1043, khoản hoàn $149,00 cho đơn hàng ngày 31/8 được quyết toán ngày 2/9. Quy tắc chính sách POL-3 xếp nó vào tháng 9.
Sau đó nó mở cả hai dòng tranh chấp. TXN-50036 có số tiền gốc -$149,00, phí $15,00 và tác động tiền mặt ròng -$164,00. TXN-50052 trả lại khoản gốc $149,00 không kèm phí. Claude viết: "DSP-0077 ròng bằng 0 và phí $15 của nó đã được hạch toán đúng, nên RF-1043 giải thích hoàn toàn phần chênh lệch."
Claude đã nhầm khoản gốc được trả lại với tác động tiền mặt sau phí:
Cổng từ chối kế hoạch đầu tiên của Claude vì nó trích dẫn đơn hàng ORD-20813 mà không truy xuất. Claude lấy đơn hàng, gửi lại và PLAN-1 vượt qua với một điều chỉnh.
Trước khi lộ công cụ ghi, cổng kiểm tra nguồn chứng cứ và kế hoạch sẽ thay đổi gì.
Mỗi điều chỉnh trong một kế hoạch trích dẫn các txn_id của đơn vị xử lý. Cổng chỉ chấp nhận nếu mọi dòng được trích đều do một công cụ đọc trả về trong cuộc hội thoại này và các dòng đó ròng đúng bằng số tiền đề xuất:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Một điều chỉnh $15,00 chỉ trích dẫn bút toán ghi nợ của tranh chấp sẽ thất bại vì phần ròng của dòng đó là -$164,00. Kế hoạch phải trích dẫn cả bút toán đảo.
Cổng cũng kiểm tra quy tắc chính sách và trùng lặp giao dịch. Một kế hoạch bị từ chối, và quyền ghi vẫn bị khóa, nếu bất kỳ mục nào sau đây xảy ra:
Các từ chối được trả về như kết quả của công cụ submit_plan, nên Claude có thể tiếp tục điều tra và gửi lại. Cổng đã từ chối 2/4 lần gửi, và Claude sửa ở lần gọi tiếp theo. Ngay cả sau khi phê duyệt, create_adjustment chỉ chấp nhận các bút toán khớp chính xác với mục đã phê duyệt.
Sau khi cổng phê duyệt kế hoạch, Python nối thêm một thông điệp role: "system" với một khối tool_addition. Thay đổi này yêu cầu header beta inline-tools-2026-09-15. Mảng tools và mọi thông điệp trước đó giữ nguyên, nên tiền tố đã được lưu trong cache vẫn khớp. Phần hướng dẫn đến từ Python, không phải từ Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Một system message có nội dung phải theo sau một lượt user, kể cả lượt chứa các khối tool_result. Nó không thể nằm giữa một khối tool_use và kết quả của nó. System message có độ ưu tiên cao hơn, nên đừng bao giờ chèn văn bản kế hoạch của Claude, đầu ra công cụ, hoặc dữ liệu vào trong đó. Khối tool_addition gọi create_adjustment theo tham chiếu, và công cụ chỉ xuất hiện sau khi kế hoạch vượt qua.
Bộ nhớ tiếp tục hoạt động sau khi đổi công cụ. Yêu cầu đó xử lý 231 token đầu vào chưa được lưu và đọc 6.883 từ bộ nhớ.
Điều chỉnh đầu tiên là đúng nhưng vẫn chưa hoàn tất công việc. Claude đã ghi ADJ-001, -$149,00 theo POL-3, và báo cáo xong. Bài kiểm tra nội bộ của Rivermark sẽ đồng ý, hiển thị chênh lệch $0,00. Nghe có vẻ xong, nhưng thực ra chưa.
Bài kiểm tra độc lập của Python so sánh với tiền gửi ngân hàng. Chi trả kỳ vọng sau điều chỉnh là $3.251,14, tiền gửi là $3.236,14, còn lại $15,00.
Khoảng cách đó là lý do kiểm tra hoàn tất nằm trong Python, không phải trong thông điệp cuối của Claude.
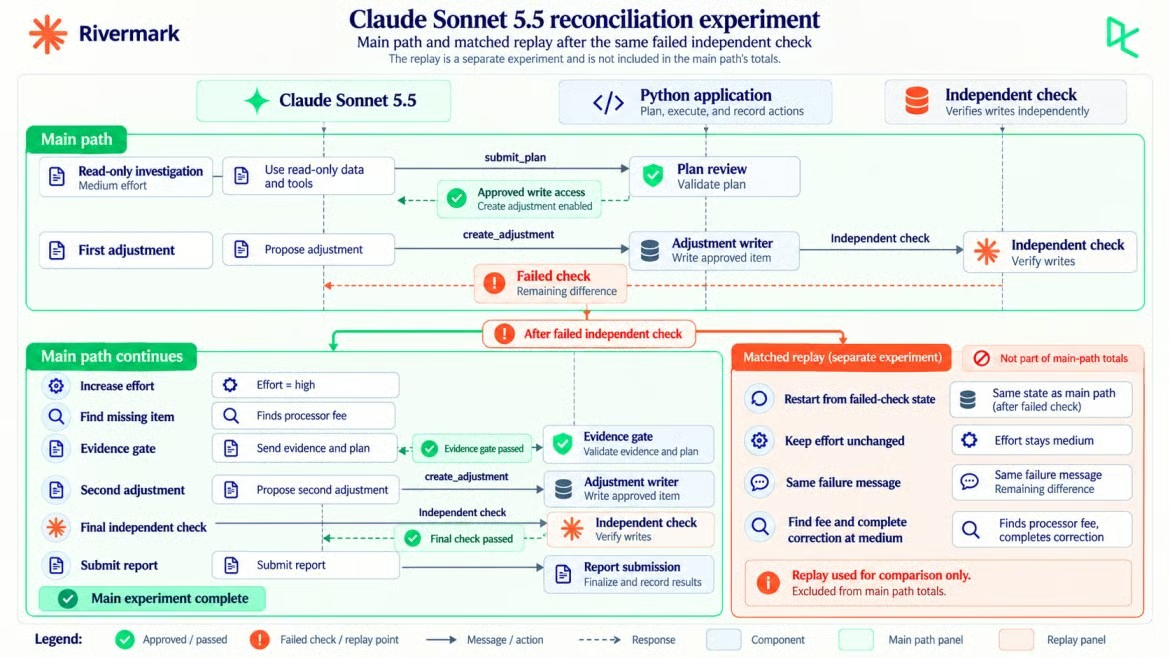
Lượt phát lại khớp rẽ nhánh từ bước xác minh thất bại. Ảnh: Tác giả.
Thay đổi effort giữa hội thoại trên Claude Sonnet 5.5 nghĩa là nối thêm một system message với content rỗng và một output_config.effort mới. Mức mới áp dụng từ lượt user tiếp theo, và mọi thứ trước đó vẫn được lưu trong bộ nhớ.
Effort theo từng thông điệp đang ở beta và cần header mid-conversation-output-config-2026-07-01. Nó cũng cần suy luận thích ứng: với between_tools, cùng thay đổi đó sẽ trả về lỗi 400. Khi bài kiểm tra độc lập thất bại, Python nối thêm thiết lập effort mới trước thông điệp người dùng tiếp theo:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Thay đổi effort cấp cao sẽ khởi động lại bộ nhớ, vì effort cấp cao là một phần của tiền tố nhắc được lưu. Dạng theo từng thông điệp thì không: yêu cầu effort cao đầu tiên đọc 8.012 token từ bộ nhớ và xử lý 4 token chưa lưu.
Phần chênh $15,00 cho Claude một mục tiêu, nhưng không phải chứng cứ cho một điều chỉnh. Cổng vẫn yêu cầu các ID giao dịch mà Claude truy xuất, và net_cents của chúng phải cộng ra -$15,00. Một điều chỉnh -$15,00 đề xuất chỉ trích dẫn TXN-50036 vẫn thất bại vì phần ròng của dòng đó là -$164,00.
Ở mức cao, Claude nhóm các dòng từ đơn vị xử lý theo khoản chi trả và theo fee_cents, sau đó chạy lại bài kiểm tra nội bộ. Ghi chú tiếp theo của nó cộng các dòng phí lên 12.586 xu. Phí cho tranh chấp nâng tổng đó lên 14.086 xu. Kiểm tra của Rivermark đã bỏ sót khoản này.
Kế hoạch sửa đổi đầu tiên của nó vi phạm quy tắc vì chỉ trích dẫn bút toán ghi nợ. Lần sau trích dẫn cả hai dòng tranh chấp, PLAN-2 vượt qua, và ADJ-002 ghi -$15,00 theo POL-4.
Thí nghiệm này không cho thấy high là cần thiết. Một lượt phát lại riêng tiếp tục từ cùng điểm thất bại với cùng lịch sử hội thoại và thông điệp Python, nhưng giữ ở medium; nó cũng tìm ra khoản phí.
Sáu cuộc gọi effort high của lượt chính tạo ra 2.763 token đầu ra (607 thinking) và tốn $0,0484. Sáu cuộc gọi điều tra effort medium của lượt đối chứng tạo ra 2.713 token đầu ra (628 thinking) và tốn $0,0464, bao gồm cùng một lần cổng từ chối.
Một cuộc gọi báo cáo cuối cùng đưa lượt đối chứng lên 7 cuộc gọi và tổng $0,0615. Không cuộc gọi hay chi phí nào trong số đó được tính vào 15 cuộc gọi và $0,1190 của lượt chính.
Cả hai lộ trình nhận cùng một thông điệp kiểm tra thất bại; chỉ effort khác nhau. Một lượt phát lại không thể đo lường kích thước của hiệu ứng effort, nhưng nó cho thấy high không cần thiết cho trường hợp này. Cùng hướng dẫn effort khuyến nghị dành xhigh và max cho trường hợp “bài đánh giá của bạn cho thấy có cải thiện chất lượng.” Hãy thử nghiệm high theo cách tương tự trước khi chọn.
Xác minh cuối cùng cố ý lặp lại 2 kiểm tra của cổng: chứng cứ và phạm vi ghi. Cổng xem xét một đề xuất trước khi ghi; xác minh cuối cùng kiểm tra những gì Python thực sự đã ghi, rồi thêm kiểm tra con số và tệp thô.
Sau ADJ-002, Python tính lại mọi thứ từ hồ sơ thô, các điều chỉnh đã phê duyệt và tổng ngân hàng:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Cả bốn đều đạt. Chi trả kỳ vọng sau điều chỉnh là $3.236,14, khớp với tiền gửi. Cả hai điều chỉnh đều lần vết đến các dòng đã truy xuất, dữ liệu nguồn thô không đổi, và Python chỉ ghi những mục đã phê duyệt.
Chỉ sau đó bước báo cáo mới bắt đầu. Ứng dụng nối thêm một thông điệp đặt effort về medium, một lượt người dùng ngắn, và một system message hoán đổi công cụ:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Báo cáo là đầu ra cuối, không phải bằng chứng. Các gợi ý tiếp theo vẫn cần con người xem xét. Bản ghi hình dưới đây theo dõi quyền, effort, kiểm tra và chi phí qua một phiên Streamlit.
Streamlit theo dõi đối soát từ đầu. Video: Tác giả.
Quy trình đối soát chính chuyển từ medium sang high, tốn $0,1190 qua 15 cuộc gọi API, và mất 70,0 giây, gồm 69,0 giây chờ API. Lượt phát lại khớp riêng không tính vào. Mọi con số đều lấy từ usage của phản hồi và mức giá của Claude Sonnet 5.5.
Để xem phân tích chi phí rộng hơn, bài hướng dẫn Claude API của chúng tôi đề cập bộ nhớ nhắc và xử lý theo lô.
input_tokens chỉ đếm phần đến sau điểm ngắt bộ nhớ, nên tổng đầu vào là tổng của ba trường, như tài liệu bộ nhớ nhắc đã liên kết giải thích. Ghi và đọc bộ nhớ có mức giá riêng, và token thinking đã nằm trong output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Trong suốt quá trình đối soát, Claude đọc 105.614 trong 118.308 token đầu vào từ bộ nhớ (khoảng 89%), và chỉ 636 token bị tính là đầu vào chưa lưu. Biểu đồ áp dụng bốn mức giá token cho mức sử dụng đo được.
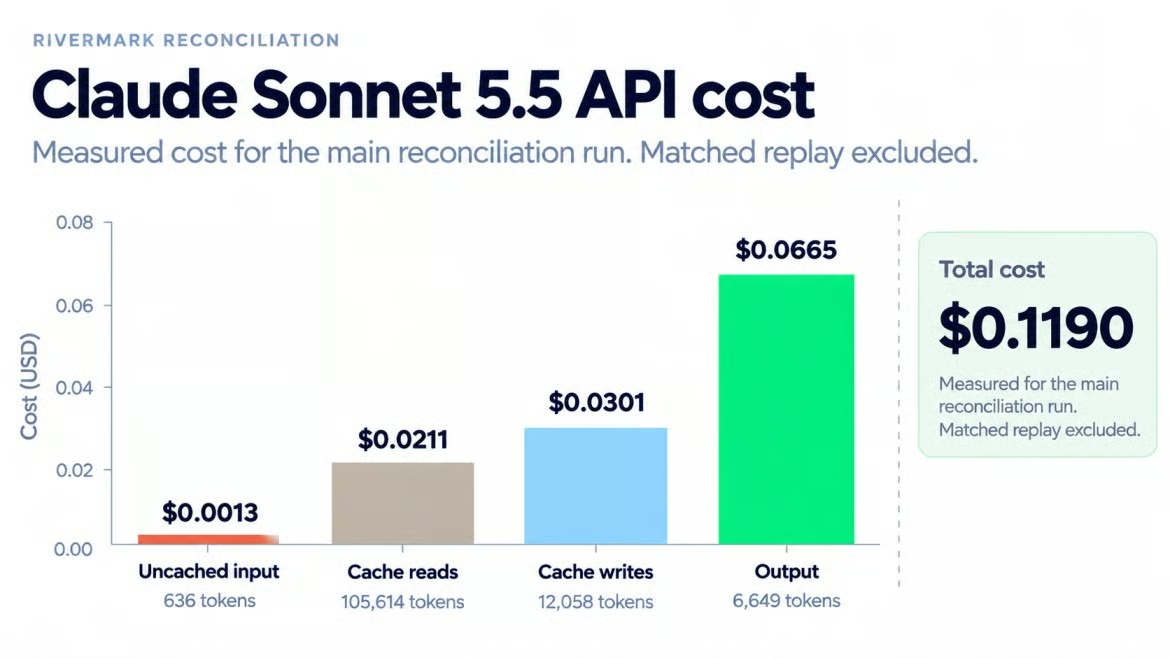
Token đầu ra chiếm ưu thế trong chi phí đo được. Ảnh: Tác giả.
Rivermark ghi bản ghi điều chỉnh cục bộ, vì vậy một hệ thống tài chính sản xuất vẫn cần:
Dữ liệu cục bộ, giả tưởng. Một kỳ chốt sổ thực cần xác thực, nhật ký kiểm toán, phê duyệt của con người cho các bút toán và xem xét lưu trữ dữ liệu.
Các tính năng beta. Header cho effort theo thông điệp, thay đổi công cụ và cập nhật thinking có thể thay đổi, nên hãy thử nghiệm lại trước khi triển khai.
Kết quả thay đổi. Claude Sonnet 5.5 từ chối nhiệt độ không mặc định, nên các lần thử lặp lại có thể khác nhau. Hãy thử mẫu này trên dữ liệu của bạn trước khi dựa vào nó.
Chúng ta đã xây dựng một tác tử đối soát điều tra bằng công cụ chỉ đọc, chỉ nhận một công cụ ghi sau khi kế hoạch của nó được Python phê duyệt, và chỉ hoàn tất khi một bài kiểm tra độc lập với tiền gửi ngân hàng đạt. Claude Sonnet 5.5 tự tìm ra khoản hoàn bị hạch toán sai, nhưng cần bài kiểm tra thất bại đó để đưa nó quay lại khoản phí $15,00 mà nó đã đọc.
Tôi sẽ không khái quát một tháng giả tưởng cho mọi kỳ chốt sổ. Điều có thể áp dụng là phương pháp: ẩn công cụ ghi cho đến khi kế hoạch vượt qua, giữ hồ sơ ngân hàng ngoài mô hình, yêu cầu chứng cứ giao dịch cho mọi điều chỉnh, và nối thêm thay đổi công cụ hoặc effort để bộ nhớ vẫn dùng được.
Bài kiểm tra độc lập là phần tôi muốn giữ lại ngay cả trong phiên bản nhỏ hơn của dự án này. Phần thay đổi effort là phần tôi sẽ thử nghiệm trước khi tin tưởng, vì lý do đã nêu trong mục effort.
Hoán đổi các công cụ đọc và bước kiểm tra cuối cho phép cùng một mẫu xử lý sửa dữ liệu, hoàn tiền hỗ trợ hoặc cập nhật tài liệu có kiểm soát. Mở rộng đầu tiên tôi muốn làm là bước phê duyệt của con người trước mỗi lần ghi điều chỉnh, vì một kỳ chốt sổ thực cần điều đó.
Để luyện các kiến thức cơ bản về Anthropic API mà bản dựng này dựa vào, tôi khuyến nghị khóa học Giới thiệu về các mô hình Claude của chúng tôi.
Học cách dùng Claude với DataCamp!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
