คอร์ส
Claude Models เบื้องต้น
3 ชม.
14.7K
Claude Sonnet 5.5 เป็นส่วนหนึ่งของตระกูล Claude 5.5 ของ Anthropic เพิ่งเปิดตัวเมื่อเริ่มโครงการนี้ และรหัสโมเดลใน API คือ claude-sonnet-5-5 ตาม ภาพรวมโมเดล มีหน้าต่างบริบท 1M โทเค็น เอาต์พุตได้สูงสุด 128K โทเค็น เปิดโหมดคิดแบบปรับได้โดยค่าเริ่มต้น และ effort เริ่มต้นใน API เป็น high ราคามาตรฐานคือ $2 ต่อหนึ่งล้านโทเค็นอินพุต และ $10 ต่อหนึ่งล้านโทเค็นเอาต์พุต
บทความ ภาพรวม Claude Sonnet 5.5 ของเราครอบคลุมเกณฑ์วัดผล การเปรียบเทียบราคา และการเข้าถึง ฟีเจอร์ API ใหม่สามอย่างมีในรุ่นนี้ และ Rivermark ใช้ทั้งหมด
Claude Sonnet 5.5 เพิ่มสามวิธีในการเปลี่ยนบทสนทนาระหว่างที่มันกำลังดำเนินอยู่ ตามหน้า มีอะไรใหม่ใน Claude Sonnet 5.5 ไม่มีอย่างใดที่ใช้ได้บน Claude Sonnet 5:
เอเจนต์ Rivermark เป็นแอปพลิเคชัน Python ที่สร้างรอบบทสนทนา Messages API หนึ่งรายการที่มีสองระดับสิทธิ์ ระหว่างการสืบค้น Claude สามารถอ่านออเดอร์ การคืนเงิน ธุรกรรมของผู้ประมวลผล นโยบายปิดบัญชี และการตรวจเช็กกระทบยอดของ Rivermark หลังจากอนุมัติแล้ว มันจะบันทึกได้เฉพาะการปรับแก้ที่อนุมัติเท่านั้น
Rivermark ใช้วงวน Messages API แบบกำหนดเองแทน Claude Agent SDK เพราะต้องมีด่านอนุมัติอยู่ระหว่างการเรียกใช้เครื่องมือของ Claude กับการดำเนินการจริง
โค้ดฉบับเต็มและข้อมูลตัวอย่างอยู่ใน ที่เก็บ Rivermark บน GitHub
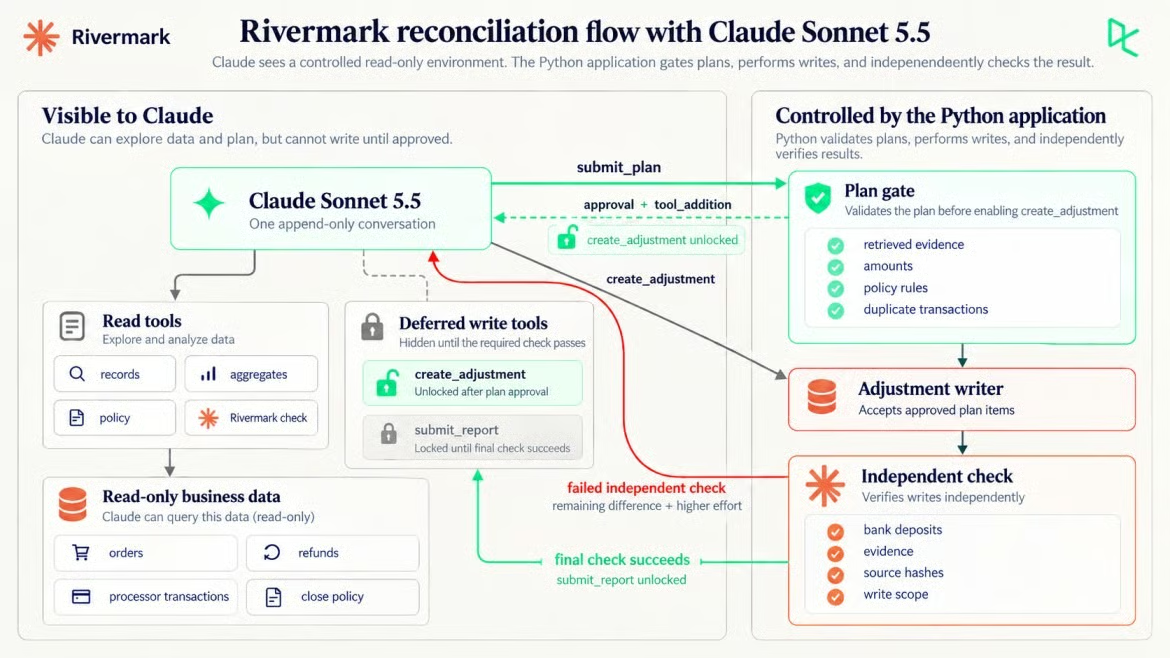
Claude เป็นผู้เสนอ Python เป็นผู้ให้สิทธิ์เขียน ภาพโดยผู้เขียน
การตรวจของ Rivermark รายงานยอดจ่ายที่คาดไว้ $3,400.14 และยอดรวมที่ผู้ประมวลผลคำนวณได้ $3,251.14 ต่างกัน $149.00 Claude ต้องอธิบายความต่างระหว่างบันทึก โดยไม่เห็นสาเหตุที่ซ่อนอยู่ทั้งสอง
Rivermark ขายสามแพลนรายเดือน: Starter $29, Team $79 และ Business $149 ตัวอย่างมีออเดอร์เดือนกันยายน 58 รายการ บันทึกคืนเงิน 7 รายการ และธุรกรรมผู้ประมวลผลเดือนกันยายน 65 รายการ แต่ละบันทึกมีจำนวนเงิน ค่าธรรมเนียม และมูลค่าสุทธิ
Python ไม่ใช่ Claude เป็นผู้ตัดสินว่าการกระทบยอดเสร็จสมบูรณ์หรือไม่:
เดือนคือกันยายน 2026 โดยอิงวันที่การชำระเงินของผู้ประมวลผล
ยอดรวมเงินฝากธนาคารเดือนกันยายนเป็นเป้าหมายการปิดยอดที่เป็นอิสระของการทดลอง
สมดุลหมายถึงยอดจ่ายที่คาดไว้บวกการปรับแก้ เท่ากับยอดฝากนั้นเป๊ะระดับเซ็นต์
ทุกการปรับแก้อ้างอิง txn_ids ของผู้ประมวลผลที่ Claude ดึงมา และจำนวนเงินต้องเท่ากับมูลค่าสุทธิของรายการเหล่านั้น
Claude เพิ่มได้เฉพาะการปรับแก้ที่อนุมัติแล้ว และส่งรายงานสุดท้ายได้เท่านั้น
ไฟล์ส่งออกดิบถูกแฮชก่อนประมวลผล และต้องตรงกันหลังจากนั้น
Claude ไม่สามารถตรวจบันทึกธนาคารหรือยอดรวมเป้าหมายระหว่างการสืบค้นครั้งแรกได้ หลังตรวจล้มเหลว Python จะเปิดเผยแค่ยอดจ่ายที่คาดไว้ ยอดฝากรวม และส่วนต่างที่เหลือ ไม่ใช่บันทึกธนาคารเอง
ต้องใช้ Python 3.10 ขึ้นไป ซึ่ง Python SDK ต้องการ คีย์ Anthropic API และ anthropic 1.9.0 คำสั่ง PowerShell เหล่านี้จะโคลนโปรเจกต์ สร้างสภาพแวดล้อม และเตรียมข้อมูลตัวอย่าง:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
บน macOS หรือ Linux ให้ใช้ source .venv/bin/activate และ cp .env.example .env แล้วใส่คีย์ลงใน .env ดู คู่มือ environment variables ของเราเพื่อทำความเข้าใจรูปแบบการตั้งค่า
streamlit run app_streamlit.py จะเปิดเว็บอินเทอร์เฟซที่แสดงทุกขั้นของการกระทบยอดแบบเรียลไทม์ และ บทเรียน Streamlit ของเราครอบคลุมการตั้งค่า
ถ้าคีย์ API ใช้งานได้อยู่แล้ว ให้ข้ามคำขอต่อไปและไปที่การคิดแบบปรับได้
หากอ็อบเจกต์คำขอและคำตอบ API ใหม่สำหรับคุณ โปรดดู คู่มือ Python API ของเราที่ครอบคลุมพื้นฐาน ถามเรื่องคืนเงินเพียงหนึ่งคำถามก็พอจะยืนยันคีย์และตรวจดูบล็อกคอนเทนต์ที่ส่งกลับ:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
ในรอบของผู้เขียน การตอบเริ่มด้วยบล็อก thinking เลือกบล็อกตาม type แทนการอ่าน response.content[0]; โทเค็น thinking ถูกคิดเป็นเอาต์พุต
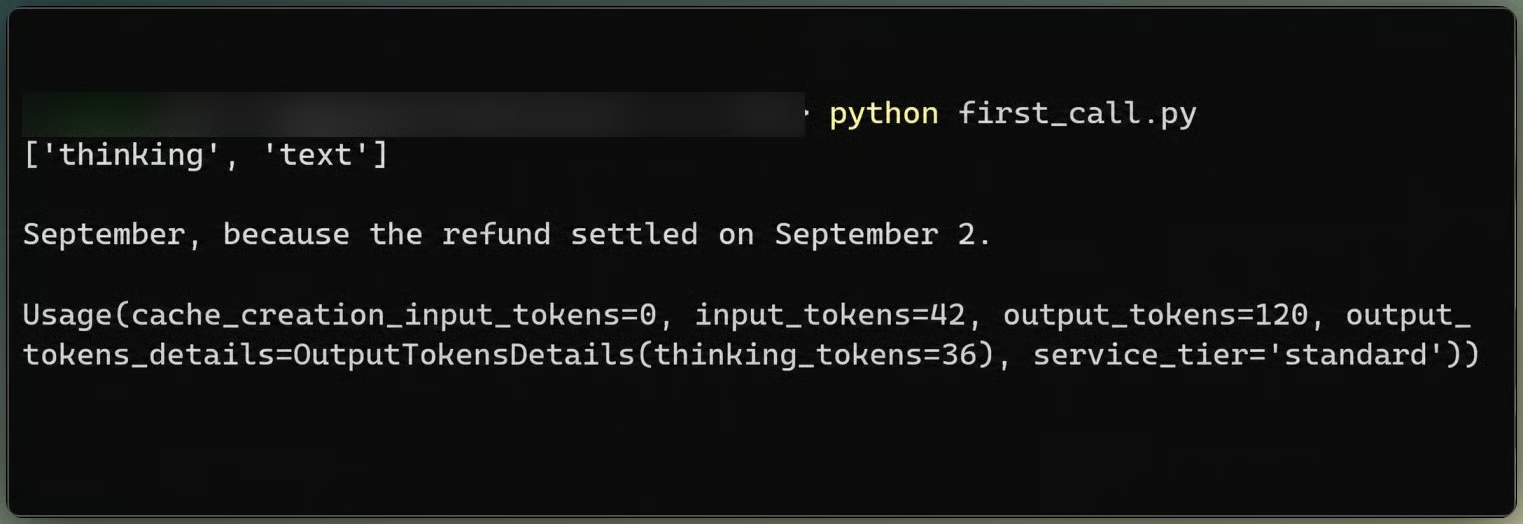
คำตอบแรกแยก thinking ออกจากข้อความ ภาพโดยผู้เขียน
ทุกคำขอส่งการตั้งค่าระดับบนสุดเดียวกัน และมีเพียง messages ที่เพิ่มขึ้น:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
แม้ค่าเริ่มต้นของ API จะเป็น high เวิร์กโฟลว์นี้เริ่มที่ medium คู่มือ effort ของ Anthropic ระบุว่า: “สำหรับงานโค้ดแบบเอเจนต์และการใช้เครื่องมือหลายขั้น เริ่มที่ medium สำหรับงานที่กำหนดไว้อย่างชัดเจน และขยับไปที่ high เมื่อยากหรือนานขึ้น”
การคิดยังคงเป็นแบบปรับได้ เพราะการเปลี่ยน effort ภายหลังขึ้นอยู่กับมัน display: "updates" (เบต้า thinking-display-updates-2026-08-18) ส่งคืนบันทึกที่ Claude เขียนระหว่างการเรียกใช้เครื่องมือ หากไม่มีการตั้งค่านี้ บล็อก thinking จะว่างเปล่า
ระดับบนสุดของ cache_control เปิดการแคชพรอมป์ต์อัตโนมัติ โดยมีจุดตัดที่เลื่อนไปข้างหน้าตามบทสนทนาที่เติบโต คำขอแรกเขียน 2,080 โทเค็นลงแคช สูงกว่าขั้นต่ำ 512 โทเค็นของ Claude Sonnet 5.5 มาก
เอเจนต์สืบค้นแบบอ่านอย่างเดียวช่วยให้ Claude ขอหลักฐานได้ แต่ไม่เปิดเครื่องมือเขียน Rivermark ยังปฏิเสธการเรียกเขียนที่ไม่ได้อนุมัติใน Python
Claude ได้เครื่องมืออ่านห้าอย่างและเครื่องมือเสนอแนะหนึ่งอย่าง ทั้งหมดมี strict: true คำอธิบายบอกเฉพาะสิ่งที่เครื่องมือส่งคืน ไม่บอกว่าควรไปหาอะไรที่ไหน:
list_sources ส่งคืนแหล่งข้อมูล คอลัมน์ และจำนวนแถว
query_records ส่งคืนได้สูงสุด 40 แถวจากหนึ่งแหล่ง พร้อมตัวกรองและช่วงวันที่แบบเลือกใส่
aggregate_records นับจำนวนแถวและรวม amount_cents ตามคอลัมน์ใดก็ได้
read_policy ส่งคืนนโยบายการปิดบัญชี
run_reconciliation_check รันตรรกะการกระทบยอดภายในของ Rivermark ที่มีอยู่ รวมทั้งบั๊ก
submit_plan ส่งการวินิจฉัยและการปรับแก้ที่เสนอให้ Python ตรวจสอบ และยังไม่เขียนอะไร
ยังมีเครื่องมืออีกสองตัวอยู่ในอาร์เรย์ tools เดียวกัน แต่ defer_loading: true ทำให้ Claude ยังไม่เห็น เดี๋ยวค่อยอธิบายว่ามันโผล่มาอย่างไรภายหลัง:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
สเกมาของเครื่องมือเขียนเป็นที่รู้ตั้งแต่คำขอแรก จึงประกาศเครื่องมือไว้ล่วงหน้า การเลือกแบบระบุชื่อหรือ any จะได้ข้อผิดพลาด 400 ดังนั้นพรอมป์ต์จึงระบุว่าเมื่อใดที่ submit_plan ใช้ได้
คู่มือ agent harness engineering ของเราอธิบายว่าทำไม Python จึงจัดการลูปเอเจนต์ที่ยาวขึ้นได้ ลูปของ Rivermark ส่งบทสนทนา รันบล็อก tool_use ใด ๆ ใน Python และผนวกผลลัพธ์ ทุกไอดีบันทึกที่เครื่องมืออ่านส่งคืนจะถูกใส่ลงในชุด observed ซึ่งด่านตรวจแผนจะเช็คภายหลัง:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
รอบของผู้ช่วยถูกส่งกลับไปเหมือนเดิมทุกประการ รวมถึงบล็อก thinking ที่ว่าง คู่มือ migration อธิบายว่า Claude Sonnet 5.5 ผูกบล็อก thinking เข้ากับข้อความก่อนหน้า ดังนั้นการแก้ไขประวัติอาจทำให้เกิดข้อผิดพลาด 400 ได้
ที่ระดับ medium การสืบค้นใช้ 6 การเรียก API และ 9 การเรียกเครื่องมืออ่าน Claude ดึงข้อมูลการคืนเงินและจัดกลุ่มบรรทัดของผู้ประมวลผลตาม reporting_category มันพบ RF-1043 การคืนเงิน $149.00 สำหรับออเดอร์วันที่ 31 สิงหาคม ที่เคลียร์วันที่ 2 กันยายน กฎนโยบาย POL-3 จัดให้อยู่ในเดือนกันยายน
จากนั้นมันเปิดสองแถวของข้อพิพาท TXN-50036 มีจำนวนเงินต้น -$149.00 ค่าธรรมเนียม $15.00 และผลกระทบเงินสดสุทธิ -$164.00 TXN-50052 คืนเงินต้น $149.00 โดยไม่มีค่าธรรมเนียม Claude เขียนว่า “DSP-0077 หักล้างกันเป็นศูนย์และค่าธรรมเนียม $15 ถูกลงบัญชีถูกต้องแล้ว ดังนั้น RF-1043 อธิบายความต่างได้ครบถ้วน”
Claude สับสนระหว่างเงินต้นที่คืนกับผลเงินสดหลังหักค่าธรรมเนียม:
ด่านตรวจแผนปฏิเสธแผนแรกของ Claude เพราะอ้างถึงออเดอร์ ORD-20813 โดยไม่ดึงข้อมูลมาก่อน Claude ดึงออเดอร์ ส่งใหม่ และ PLAN-1 ผ่านพร้อมการปรับแก้หนึ่งรายการ
ก่อนเปิดเผยเครื่องมือเขียน ด่านตรวจจะตรวจที่มาของหลักฐานและสิ่งที่แผนจะเปลี่ยน
แต่ละการปรับแก้ในแผนต้องอ้างถึง txn_id ของผู้ประมวลผล ด่านตรวจยอมรับก็ต่อเมื่อทุกบรรทัดที่อ้างกลับมาจากเครื่องมืออ่านในการสนทนาครั้งนี้ และบรรทัดเหล่านั้นมียอดสุทธิรวมเท่ากับจำนวนเงินที่เสนอ:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
การปรับแก้ $15.00 ที่อ้างเพียงรายการเดบิตของข้อพิพาทจะล้มเหลว เพราะยอดสุทธิของบรรทัดนั้นคือ -$164.00 แผนต้องอ้างถึงรายการย้อนกลับด้วย
ด่านตรวจยังตรวจตามกฎนโยบายและธุรกรรมซ้ำ แผนจะถูกปฏิเสธและสิทธิ์เขียนยังถูกล็อก หากรายการใดทำสิ่งต่อไปนี้:
การปฏิเสธจะส่งกลับมาเป็นผลลัพธ์ของเครื่องมือ submit_plan เพื่อให้ Claude สืบค้นต่อและส่งใหม่ ด่านตรวจปฏิเสธ 2 จาก 4 ครั้ง และ Claude แก้ไขได้ในครั้งถัดไป แม้หลังอนุมัติ create_adjustment ก็รับเฉพาะรายการที่ตรงกับรายการที่อนุมัติแล้วเท่านั้น
เมื่อด่านตรวจอนุมัติแผน Python จะผนวกข้อความ role: "system" พร้อมบล็อก tool_addition การเปลี่ยนแปลงนี้ต้องใช้ส่วนหัวเบต้า inline-tools-2026-09-15 อาร์เรย์ tools และทุกข้อความก่อนหน้านั้นยังไม่เปลี่ยน แคชพรีฟิกซ์จึงยังตรง ข้อความคำสั่งมาจาก Python ไม่ใช่จาก Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
system message ที่มีเนื้อหาต้องตามหลังรอบของ user แม้จะเป็นรอบที่มีบล็อก tool_result ก็ได้ ห้ามวางคั่นระหว่างบล็อก tool_use กับผลของมัน system message มีลำดับความสำคัญสูงกว่า จึงไม่ควรใส่ข้อความแผนของ Claude เอาต์พุตของเครื่องมือ หรือข้อมูล ลงไป บล็อก tool_addition ระบุชื่อ create_adjustment แบบอ้างอิง และเครื่องมือจะมองเห็นได้ก็ต่อเมื่อแผนผ่านแล้วเท่านั้น
การแคชยังคงทำงานต่อหลังการเปลี่ยนเครื่องมือ คำขอประมวลผลโทเค็นอินพุตที่ไม่ได้แคช 231 โทเค็น และอ่านจากแคช 6,883 โทเค็น
การปรับแก้ครั้งแรกถูกต้อง แต่ยังไม่ทำให้งานเสร็จ Claude บันทึก ADJ-001 -$149.00 ภายใต้ POL-3 และรายงานว่างานเสร็จแล้ว การตรวจภายในของ Rivermark จะเห็นด้วย โดยแสดงส่วนต่าง $0.00 ฟังดูเหมือนเสร็จ แต่จริง ๆ ยังไม่
การตรวจอิสระของ Python เปรียบเทียบกับยอดฝากธนาคารแทน ยอดจ่ายที่คาดไว้หลังการปรับแก้คือ $3,251.14 ยอดฝากคือ $3,236.14 และยังเหลือ $15.00
ช่องว่างนั้นคือเหตุผลที่การตรวจเสร็จสมบูรณ์ต้องอยู่ใน Python ไม่ใช่ในข้อความสุดท้ายของ Claude
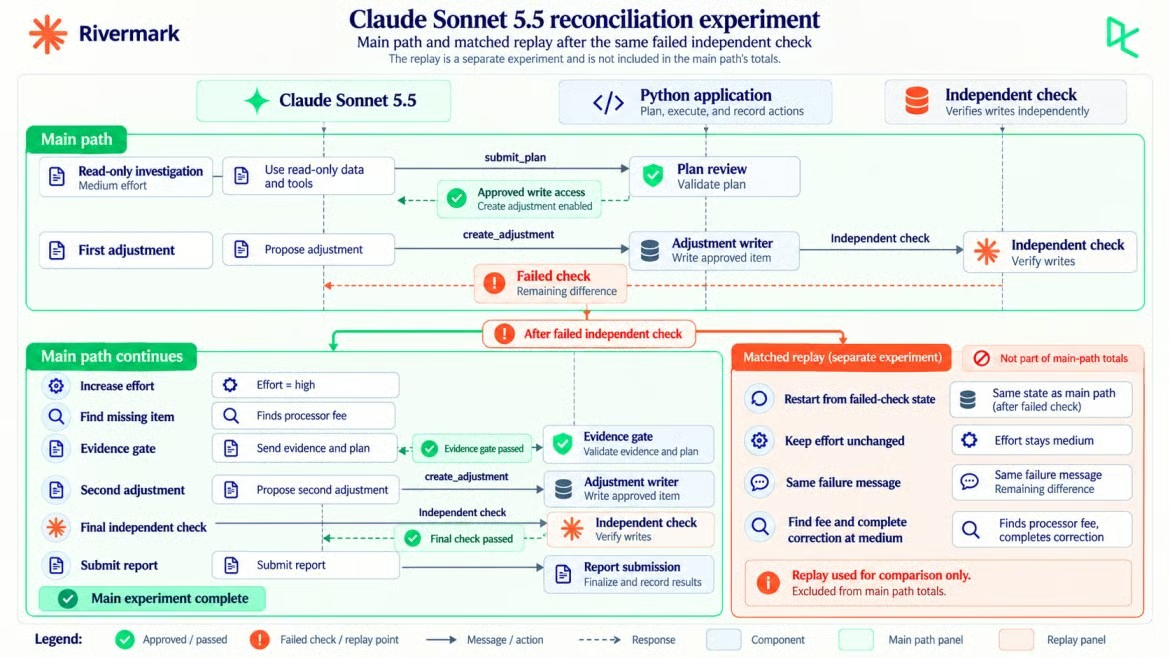
Matched replay แตกสาขาจากการตรวจล้มเหลว ภาพโดยผู้เขียน
การเปลี่ยน effort กลางบทสนทนาใน Claude Sonnet 5.5 หมายถึงการผนวก system message ที่มี content ว่างเปล่าและ output_config.effort ใหม่ ระดับใหม่จะมีผลตั้งแต่รอบ user ถัดไป และทุกอย่างก่อนหน้านั้นยังคงถูกแคช
per-message effort อยู่ในเบต้าและต้องใช้ส่วนหัว mid-conversation-output-config-2026-07-01 นอกจากนี้ยังต้องใช้การคิดแบบปรับได้: หากใช้ between_tools การเปลี่ยนแบบเดียวกันจะได้ข้อผิดพลาด 400 เมื่อการตรวจอิสระล้มเหลว Python จะผนวกการตั้งค่า effort ใหม่ก่อนข้อความ user ถัดไป:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
การเปลี่ยน effort ระดับบนสุดจะเริ่มแคชใหม่ เพราะเป็นส่วนหนึ่งของพรีฟิกซ์พรอมป์ต์ที่แคชไว้ รูปแบบ per-message ไม่เป็นเช่นนั้น: คำขอ effort สูงครั้งแรกอ่าน 8,012 โทเค็นจากแคช และประมวลผลโทเค็นที่ไม่ได้แคช 4 โทเค็น
ส่วนต่าง $15.00 ให้เป้าหมายกับ Claude แต่ยังไม่ใช่หลักฐานสำหรับการแก้ไข ด่านตรวจยังต้องใช้รหัสธุรกรรมที่ Claude ดึงมา และ net_cents ของมันต้องรวมกันเป็น -$15.00 การปรับแก้ -$15.00 ที่อ้างเพียง TXN-50036 ก็ยังไม่ผ่าน เพราะยอดสุทธิของบรรทัดนั้นคือ -$164.00
ที่ระดับ high Claude จัดกลุ่มบรรทัดของผู้ประมวลผลตามรอบจ่ายและตาม fee_cents แล้วรันการตรวจภายในอีกครั้ง บันทึกถัดไปของมันเพิ่มยอดค่าธรรมเนียมเป็น 12,586 เซ็นต์ ค่าธรรมเนียมของข้อพิพาททำให้ยอดนั้นขึ้นเป็น 14,086 เซ็นต์ ซึ่งการตรวจของ Rivermark มองข้าม
แผนที่แก้ไขครั้งแรกชนกฎนั้นเพราะอ้างเพียงรายการเดบิต ครั้งถัดไปอ้างทั้งสองบรรทัดของข้อพิพาท PLAN-2 ผ่าน และ ADJ-002 บันทึก -$15.00 ภายใต้ POL-4
การทดลองนี้ไม่ได้แสดงว่า high จำเป็น มีการเล่นซ้ำแยกที่ดำเนินต่อจากจุดล้มเหลวเดียวกันด้วยประวัติการสนทนาและข้อความจาก Python เดียวกัน แต่คงอยู่ที่ medium และพบค่าธรรมเนียมเช่นกัน
การเรียกที่ high หกรอบของการรันหลัก สร้างเอาต์พุต 2,763 โทเค็น (คิด 607) และมีค่าใช้จ่าย $0.0484 ส่วนการควบคุมแยกที่ medium หกรอบ สร้างเอาต์พุต 2,713 โทเค็น (คิด 628) และมีค่าใช้จ่าย $0.0464 รวมการปฏิเสธจากด่านตรวจเดียวกัน
การเรียกส่งรายงานสุดท้ายหนึ่งครั้งทำให้การควบคุมรวมเป็น 7 การเรียก และ $0.0615 ค่าใช้จ่าย ทั้งหมดนี้ไม่รวมอยู่ใน 15 การเรียก และ $0.1190 ของรันหลัก
ทั้งสองเส้นทางได้รับข้อความล้มเหลวเดียวกัน ต่างเพียงระดับ effort การเล่นซ้ำครั้งเดียววัดขนาดของผลกระทบจาก effort ไม่ได้ แต่แสดงว่า high ไม่จำเป็นสำหรับกรณีนี้ คู่มือ effort เดียวกันสงวน xhigh และ max สำหรับกรณีที่ “ผลการประเมินของคุณแสดงว่าคุณภาพดีขึ้น” ควรทดสอบ high แบบเดียวกันก่อนเลือกใช้
การตรวจสอบสุดท้ายจงใจทำซ้ำ 2 การตรวจของด่าน คือ หลักฐานและขอบเขตการเขียน ด่านตรวจจะทบทวนข้อเสนอเวลาก่อนเขียน ส่วนการตรวจสุดท้ายจะตรวจสิ่งที่ Python เขียนจริง แล้วเพิ่มการตรวจตัวเลขและไฟล์ดิบเข้าไป
หลัง ADJ-002 Python คำนวณทุกอย่างใหม่จากบันทึกดิบ การปรับแก้ที่อนุมัติ และยอดรวมจากธนาคาร:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
ทั้งสี่ผ่าน ยอดจ่ายที่คาดไว้หลังการปรับแก้คือ $3,236.14 เท่ากับยอดฝาก การปรับแก้ทั้งสองรายการอ้างอิงกลับไปยังบรรทัดที่ดึงมา ข้อมูลต้นทางดิบยังไม่เปลี่ยน และ Python เขียนเฉพาะรายการที่อนุมัติแล้วเท่านั้น
หลังจากนั้นจึงเริ่มขั้นรายงาน แอปพลิเคชันผนวกข้อความที่ตั้งค่า effort กลับเป็น medium ข้อความผู้ใช้สั้น ๆ และ system message ที่สลับเครื่องมือ:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
รายงานคือเอาต์พุตสุดท้าย ไม่ใช่หลักฐาน ข้อเสนอแนะภายหลังยังต้องการการทบทวนโดยมนุษย์ การบันทึกด้านล่างติดตามสิทธิ์ effort การตรวจ และต้นทุนตลอดหนึ่งเซสชัน Streamlit
Streamlit ติดตามการกระทบยอดตั้งแต่ต้น วิดีโอโดยผู้เขียน
การกระทบยอดหลักยกระดับจาก medium เป็น high มีค่าใช้จ่าย $0.1190 ตลอด 15 การเรียก API และใช้เวลา 70.0 วินาที โดยรอ API 69.0 วินาที matched replay แยกไม่รวมอยู่ ตัวเลขทุกตัวมาจาก usage ในการตอบและอัตราของ Claude Sonnet 5.5
สำหรับการแยกต้นทุนที่กว้างขึ้น ดู คู่มือ Claude API ของเราที่ครอบคลุมการแคชพรอมป์ต์และการประมวลผลแบบแบตช์
input_tokens นับเฉพาะสิ่งที่ตามหลังจุดตัดของแคช ดังนั้นอินพุตรวมคือผลรวมของสามฟิลด์ ตามที่เอกสารแคชพรอมป์ต์ที่ลิงก์ไว้ก่อนหน้าอธิบาย อัตราการเขียนและอ่านแคชมีเรตราคาแยกกัน และโทเค็น thinking รวมอยู่ใน output_tokens แล้ว:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
ตลอดกระบวนการกระทบยอด Claude อ่าน 105,614 จาก 118,308 โทเค็นอินพุตจากแคช (ประมาณ 89%) และมีเพียง 636 โทเค็นที่ถูกคิดเป็นอินพุตที่ไม่แคช กราฟนี้ใช้สี่อัตราโทเค็นกับการใช้งานที่วัดได้
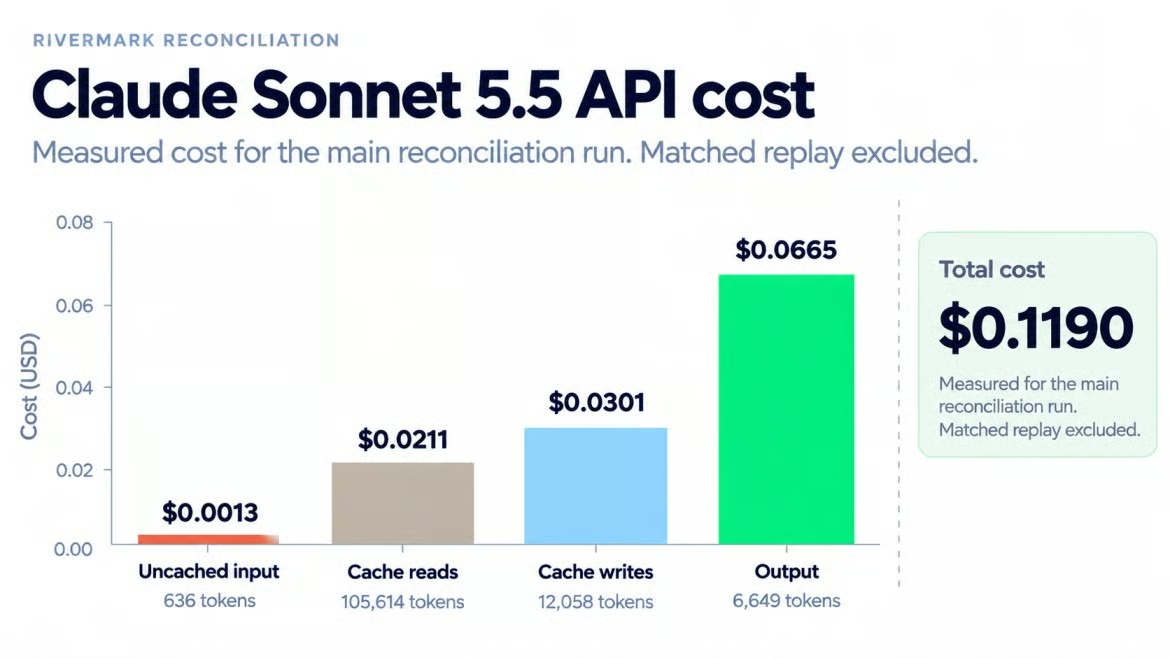
โทเค็นเอาต์พุตเป็นสัดส่วนหลักของต้นทุนที่วัดได้ ภาพโดยผู้เขียน
Rivermark เขียนบันทึกการปรับแก้แบบโลคอล ดังนั้นระบบการเงินภาคผลิตจริงยังต้องมี:
ข้อมูลโลคอลและสมมติ การปิดบัญชีจริงต้องมีการยืนยันตัวตน บันทึกการตรวจสอบ อนุมัติโดยมนุษย์ก่อนลงบัญชี และการทบทวนการเก็บข้อมูล
ฟีเจอร์เบต้า ส่วนหัวสำหรับ per-message effort การเปลี่ยนเครื่องมือ และการอัปเดต thinking อาจเปลี่ยนแปลงได้ ควรทดสอบอีกครั้งก่อนดีพลอย
ผลลัพธ์ที่แปรผัน Claude Sonnet 5.5 ไม่ยอมรับค่า temperature ที่ไม่ใช่ค่าเริ่มต้น จึงอาจให้ผลต่างกันเมื่อทำซ้ำ ควรทดสอบแพทเทิร์นกับข้อมูลของตนเองก่อนพึ่งพา
เราได้สร้างเอเจนต์กระทบยอดที่สืบค้นด้วยเครื่องมือแบบอ่านอย่างเดียว ได้เครื่องมือเขียนเพียงหนึ่งตัวหลังจากแผนของมันผ่านการอนุมัติจาก Python และเสร็จสิ้นก็ต่อเมื่อการตรวจอิสระเทียบกับยอดฝากธนาคารผ่าน Claude Sonnet 5.5 พบการคืนเงินที่วางผิดเดือนได้เอง แต่ต้องอาศัยการตรวจล้มเหลวเพื่อพามันกลับไปหาค่าธรรมเนียม $15.00 ที่มันเคยอ่านแล้ว
ไม่ควรเหมารวมหนึ่งเดือนสมมติเป็นทุกการปิดบัญชี สิ่งที่ถ่ายทอดได้คือวิธีการ: ซ่อนเครื่องมือเขียนจนกว่าแผนจะผ่าน เก็บบันทึกธนาคารไว้นอกโมเดล ต้องมีหลักฐานธุรกรรมสำหรับทุกการแก้ไข และผนวกการเปลี่ยนเครื่องมือหรือ effort เพื่อให้แคชยังคงอยู่
การตรวจอิสระคือส่วนที่จะเก็บไว้ แม้ในเวอร์ชันที่เล็กลงของโปรเจกต์นี้ ส่วนการเปลี่ยน effort คือสิ่งที่ควรทดสอบก่อนเชื่อถือ ตามเหตุผลในหัวข้อ effort
การสลับเครื่องมืออ่านและการตรวจสุดท้ายช่วยให้แพทเทิร์นเดียวกันรองรับการแก้ข้อมูลสกปรก การคืนเงินฝั่งซัพพอร์ต หรือการอัปเดตเอกสารแบบควบคุมได้ ส่วนขยายแรกที่ควรทำคือขั้นตอนอนุมัติโดยมนุษย์ก่อนบันทึกการปรับแก้แต่ละครั้ง เพราะการปิดบัญชีจริงต้องมี
เพื่อฝึกพื้นฐาน Anthropic API ที่บิลด์นี้ใช้ แนะนำคอร์ส Introduction to Claude Models ของเรา
เรียนรู้การใช้ Claude กับ DataCamp!
คอร์ส
คอร์ส
แทร็ก