Kurs
Wprowadzenie do modeli Claude
3 godz.
14.7K
Claude Sonnet 5.5 to część rodziny Claude 5.5 od Anthropic. Gdy zaczynałem ten projekt, właśnie się ukazał, a jego identyfikator modelu w API to claude-sonnet-5-5. Zgodnie z przeglądem modelu ma okno kontekstu 1M tokenów, do 128K tokenów wyjściowych, domyślnie włączone adaptacyjne myślenie oraz domyślny poziom wysiłku high w API. Standardowe stawki to 2 $ za milion tokenów wejściowych i 10 $ za milion tokenów wyjściowych.
Nasz przegląd Claude Sonnet 5.5 obejmuje benchmarki, porównanie cen i dostęp. Trzy funkcje API są nowe w tym wydaniu i Rivermark wykorzystuje wszystkie.
Claude Sonnet 5.5 dodaje trzy sposoby zmiany rozmowy w trakcie jej działania. Według co nowego w Claude Sonnet 5.5 żaden z nich nie jest dostępny w Claude Sonnet 5:
Agent Rivermark to aplikacja w Pythonie zbudowana wokół jednej rozmowy w Messages API z dwoma poziomami uprawnień. Podczas dochodzenia Claude może czytać zamówienia, zwroty, transakcje operatora, politykę zamknięcia i kontrolę uzgodnieniową Rivermark. Po zatwierdzeniu może zapisywać tylko zatwierdzone korekty.
Rivermark używa niestandardowej pętli Messages API zamiast Claude Agent SDK, ponieważ bramka zatwierdzania musi znajdować się między wywołaniami narzędzi przez Claude’a a ich wykonaniem.
Pełny kod i przykładowe dane znajdziesz w repozytorium Rivermark na GitHubie.
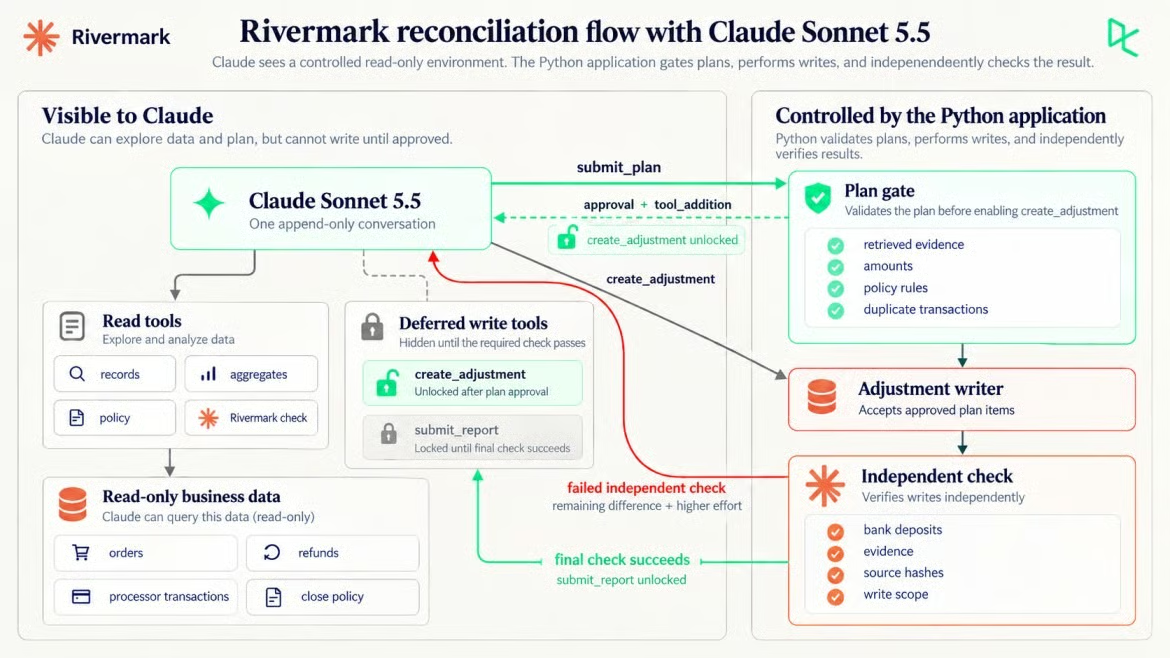
Claude proponuje, Python nadaje uprawnienia do zapisu. Ilustracja autora.
Kontrola Rivermark raportuje 3 400,14 $ jako oczekiwaną wypłatę i 3 251,14 $ jako obliczoną sumę operatora, różnica 149,00 $. Claude musi wyjaśnić różnicę między zapisami, nie widząc żadnej z ukrytych przyczyn.
Rivermark sprzedaje trzy miesięczne plany: Starter za 29 $, Team za 79 $ i Business za 149 $. Próbka zawiera 58 wrześniowych zamówień, 7 zapisów zwrotów i 65 wrześniowych transakcji operatora. Każdy zapis operatora ma kwotę, opłatę i wartość netto.
O tym, czy uzgodnienie jest zakończone, decyduje Python, a nie Claude:
Miesiąc to wrzesień 2026 według daty rozliczenia u operatora.
Suma wrześniowych wpłat bankowych jest niezależnym celem rozliczenia w eksperymencie.
Równowaga oznacza, że oczekiwana wypłata plus korekty równa się tym wpłatom co do centa.
Każda korekta wskazuje txn_ids operatora, które Claude pobrał, a jej kwota równa się ich netto.
Claude może tylko dodać zatwierdzone korekty i złożyć raport końcowy.
Surowe eksporty są haszowane przed przetwarzaniem i muszą się zgadzać po nim.
Claude nie może obejrzeć zapisów bankowych ani sumy docelowej podczas wstępnego dochodzenia. Po nieudanym sprawdzeniu Python ujawnia tylko oczekiwaną wypłatę, łączną sumę wpłat i pozostałą różnicę, ale nie same zapisy bankowe.
Potrzebujesz Pythona 3.10 lub nowszego, który SDK Pythona wymaga, klucza Anthropic API oraz anthropic 1.9.0. Te polecenia PowerShell klonują projekt, tworzą środowisko i budują dane przykładowe:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
W macOS lub Linuksie użyj source .venv/bin/activate i cp .env.example .env, a następnie umieść klucz w .env. Nasz poradnik o zmiennych środowiskowych wyjaśnia ten wzorzec.
streamlit run app_streamlit.py otwiera interfejs webowy pokazujący każdy krok uzgodnienia na żywo, a nasz samouczek Streamlit omawia konfigurację.
Jeśli twój klucz API już działa, pomiń następne żądanie i przejdź do adaptacyjnego myślenia.
Jeśli obiekty żądania i odpowiedzi API są dla ciebie nowe, nasz poradnik API w Pythonie omawia podstawy. Jedno pytanie o zwrot wystarczy, aby potwierdzić klucz i obejrzeć zwrócone bloki treści:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
W moim uruchomieniu odpowiedź zaczynała się blokiem thinking. Wybieraj bloki po type zamiast czytać response.content[0]; tokeny thinking są rozliczane jako wyjście.
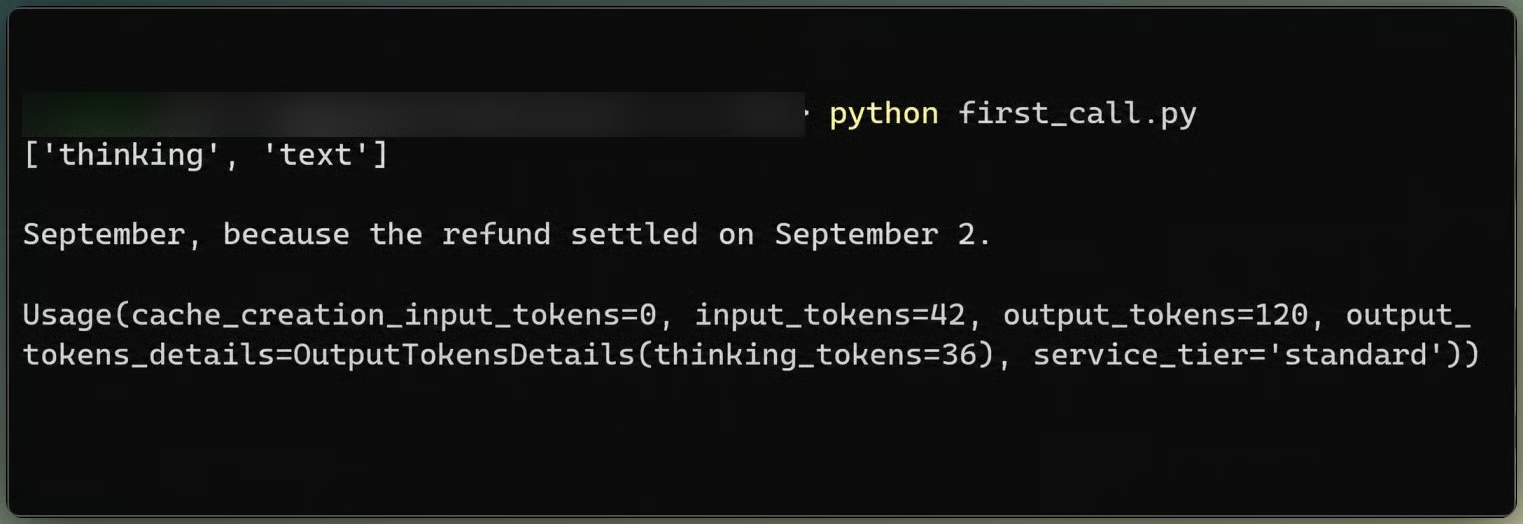
Pierwsza odpowiedź rozdziela thinking od tekstu. Ilustracja autora.
Każde żądanie wysyła te same ustawienia najwyższego poziomu, a tylko messages rośnie:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Mimo domyślnego high w API, ten workflow startuje na medium. Przewodnik Anthropic o poziomach wysiłku mówi: „Dla agentskiego kodowania i wieloetapowego użycia narzędzi zacznij od medium przy dobrze zdefiniowanych zadaniach i przejdź na high przy trudniejszych lub dłuższych.”
Myślenie pozostaje adaptacyjne, bo późniejsza zmiana wysiłku na tym polega. display: "updates" (beta, thinking-display-updates-2026-08-18) zwraca notatki Claude’a między wywołaniami narzędzi. Bez tego ustawienia bloki thinking są puste.
Najwyższopoziomowe cache_control włącza automatyczne cache’owanie promptu, z punktem granicznym przesuwającym się do przodu wraz z rozmową. Pierwsze żądanie zapisało 2 080 tokenów do cache, sporo ponad minimalne 512 tokenów w Claude Sonnet 5.5.
Agent dochodzeniowy tylko do odczytu pozwala Claude’owi żądać dowodów, ale nie udostępnia żadnego narzędzia do zapisu. Rivermark odrzuca też niezatwierdzone wywołania zapisu w Pythonie.
Claude dostaje pięć narzędzi do odczytu i jedno do złożenia propozycji, wszystkie ze strict: true. Opisy mówią, co każde narzędzie zwraca, bez wskazywania, gdzie szukać:
list_sources zwraca źródła, kolumny i liczbę wierszy.
query_records zwraca do 40 wierszy z jednego źródła, z opcjonalnym filtrem i zakresem dat.
aggregate_records zlicza wiersze i sumuje amount_cents po dowolnej kolumnie.
read_policy zwraca politykę zamknięcia.
run_reconciliation_check uruchamia istniejącą wewnętrzną logikę Rivermark, łącznie z błędami.
submit_plan wysyła diagnozę i proponowane korekty do Pythona do walidacji, nie zapisując niczego.
Dwa kolejne narzędzia znajdują się w tej samej tablicy tools, ale defer_loading: true trzyma je poza zasięgiem Claude’a na teraz. Do tego, jak się pojawią, wrócimy później:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Schemat narzędzia do zapisu jest znany przy pierwszym żądaniu, więc narzędzie jest deklarowane z góry. Wybranie narzędzia nazwanego lub any zwraca błąd 400, więc prompt precyzuje, kiedy submit_plan ma zastosowanie.
Nasz poradnik o inżynierii uprzęży agenta wyjaśnia, jak Python może zarządzać dłuższymi pętlami agenta. Pętla Rivermark wysyła rozmowę, uruchamia w Pythonie wszelkie bloki tool_use i dołącza wyniki. Każdy identyfikator rekordu zwrócony przez narzędzie do odczytu trafia do zestawu observed, który bramka planu sprawdza później:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Tura asystenta wraca dokładnie tak, jak została odebrana, włącznie z pustymi blokami thinking. Przewodnik migracji wyjaśnia, że Claude Sonnet 5.5 wiąże bloki thinking z wcześniejszymi wiadomościami, więc edytowanie tej historii może zwrócić błąd 400.
Przy medium dochodzenie zajęło sześć wywołań API i dziewięć wywołań narzędzi do odczytu. Claude pobrał zwroty i pogrupował linie operatora po reporting_category. Znalazł RF-1043, zwrot 149,00 $ za zamówienie z 31 sierpnia, rozliczony 2 września. Reguła POL-3 przypisuje go do września.
Następnie otworzył oba wiersze sporu. TXN-50036 zawiera -149,00 $ kwoty głównej, opłatę 15,00 $ i -164,00 $ efektu gotówkowego netto. TXN-50052 zwraca 149,00 $ kwoty głównej bez opłaty. Claude napisał: „DSP-0077 sumuje się do zera, a jego opłata 15 $ jest już poprawnie zaksięgowana, więc RF-1043 w pełni wyjaśnia różnicę”.
Claude pomylił zwróconą kwotę główną z efektem gotówkowym po opłatach:
Bramka odrzuciła pierwszy plan Claude’a, bo wskazał zamówienie ORD-20813 bez jego pobrania. Claude pobrał zamówienie, złożył ponownie i PLAN-1 przeszedł z jedną korektą.
Zanim pokażesz narzędzie do zapisu, bramka sprawdza, skąd pochodzą dowody i co plan miałby zmienić.
Każda korekta w planie wskazuje txn_id operatora. Bramka akceptuje ją tylko wtedy, gdy każda wskazana linia wróciła z narzędzia do odczytu w tej rozmowie i linie sumują się do proponowanej kwoty:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Korekta 15,00 $ wskazująca tylko obciążenie sporne upada, bo netto tej linii to -164,00 $. Plan musi wskazać też storno.
Bramka sprawdza też reguły polityki i zduplikowane transakcje. Plan jest odrzucony, a dostęp do zapisu pozostaje zamknięty, jeśli którykolwiek element robi którąś z tych rzeczy:
Odrzucenia wracają jako wynik narzędzia submit_plan, więc Claude może dalej badać i złożyć ponownie. Bramka odrzuciła 2 z 4 zgłoszeń, a Claude poprawiał każde w kolejnym wywołaniu. Nawet po zatwierdzeniu create_adjustment akceptuje tylko wpisy dokładnie zgodne z zatwierdzonym elementem.
Gdy bramka zatwierdzi plan, Python dołącza wiadomość role: "system" z blokiem tool_addition. Zmiana wymaga nagłówka beta inline-tools-2026-09-15. Tablica tools i wszystkie wcześniejsze wiadomości pozostają niezmienione, więc zcache’owany prefiks nadal pasuje. Tekst instrukcji pochodzi z Pythona, nie od Claude’a:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Wiadomość systemowa z treścią musi następować po turze user, także takiej z blokami tool_result. Nie może znaleźć się między blokiem tool_use a jego wynikiem. Wiadomości systemowe mają wyższy priorytet, więc nigdy nie wstawiaj do nich tekstu planu Claude’a, wyjść narzędzi ani danych. Blok tool_addition wskazuje create_adjustment przez referencję, a narzędzie staje się widoczne dopiero po przejściu planu.
Cache działał dalej po zmianie narzędzia. Żądanie przetworzyło 231 niecache’owanych tokenów wejściowych i odczytało 6 883 z cache.
Pierwsza korekta była poprawna, a mimo to nie kończyła pracy. Claude zapisał ADJ-001, -149,00 $ na podstawie POL-3, i ogłosił zakończenie. Wewnętrzna kontrola Rivermark by się zgodziła, pokazując różnicę 0,00 $. Brzmi jak koniec, ale to nie koniec.
Niezależna kontrola w Pythonie porównuje zamiast tego z wpłatami bankowymi. Oczekiwana wypłata po korektach wynosiła 3 251,14 $, wpłaty 3 236,14 $, a 15,00 $ pozostawało.
Ta luka to powód, dla którego test ukończenia żyje w Pythonie, a nie w końcowej wiadomości Claude’a.
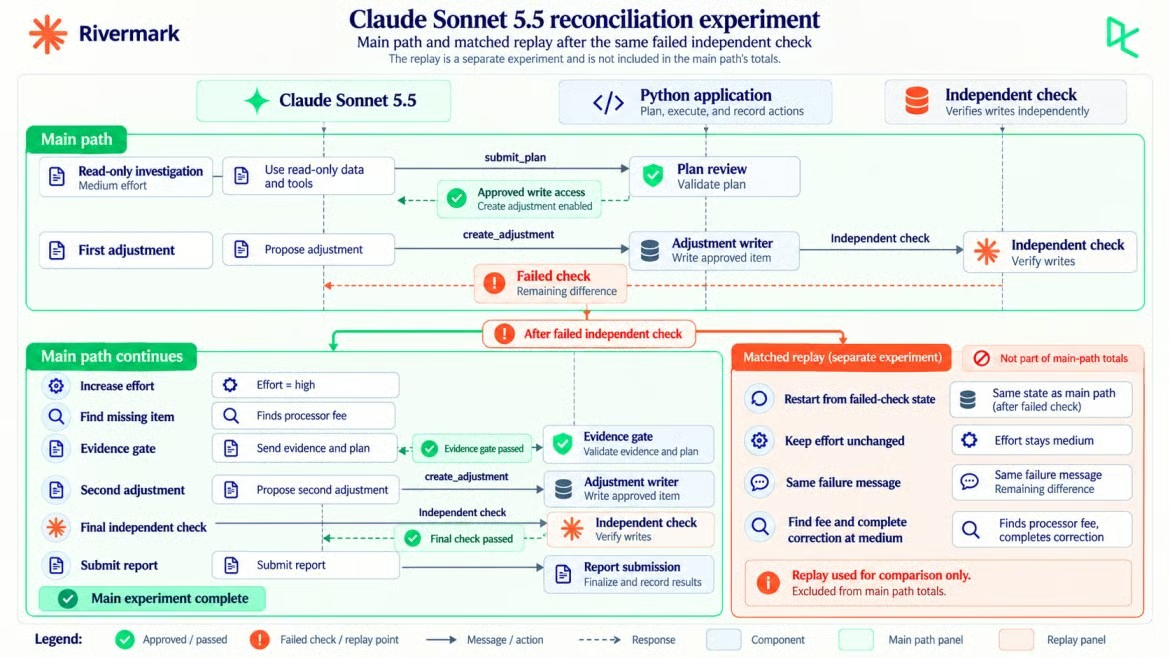
Dopasowane powtórzenie odgałęzia się od nieudanej weryfikacji. Ilustracja autora.
Zmiana wysiłku w trakcie rozmowy w Claude Sonnet 5.5 oznacza dołączenie wiadomości systemowej z pustą content i nowym output_config.effort. Nowy poziom działa od następnej tury user, a wszystko wcześniej pozostaje w cache.
Wysiłek per wiadomość jest w becie i wymaga nagłówka mid-conversation-output-config-2026-07-01. Wymaga też adaptacyjnego myślenia: przy between_tools ta sama zmiana zwraca błąd 400. Gdy niezależna kontrola się nie powiedzie, Python dołącza nowe ustawienie wysiłku przed następną wiadomością użytkownika:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Zmiana wysiłku na najwyższym poziomie zresetowałaby cache, bo wysiłek top-level jest częścią cache’owanego promptu. Forma per wiadomość tego nie zrobiła: pierwsze żądanie z high przeczytało 8 012 tokenów z cache i przetworzyło 4 niecache’owane.
Różnica 15,00 $ daje Claude’owi cel, ale nie dowody na korektę. Bramka nadal wymaga identyfikatorów transakcji pobranych przez Claude’a, a ich net_cents muszą dać -15,00 $. Proponowana korekta -15,00 $ wskazująca tylko TXN-50036 nadal odpada, bo netto tej linii to -164,00 $.
Przy high Claude pogrupował linie operatora po wypłacie i po fee_cents, po czym ponownie uruchomił kontrolę wewnętrzną. W kolejnej notatce dodał linie opłat do 12 586 centów. Opłata za spór podniosła tę sumę do 14 086 centów. Kontrola Rivermark ją pominęła.
Pierwszy poprawiony plan uderzył w tę regułę, bo wskazał tylko obciążenie. Następny wskazał obie linie sporu, PLAN-2 przeszedł, a ADJ-002 zapisał -15,00 $ na podstawie POL-4.
Ten eksperyment nie pokazuje, że high było konieczne. Osobne powtórzenie kontynuowało od tego samego punktu porażki z tą samą historią rozmowy i komunikatem Pythona, ale pozostało przy medium; również znalazło opłatę.
Sześć wywołań z high w głównym przebiegu dało 2 763 tokeny wyjściowe (607 thinking) i koszt 0,0484 $. Sześć wywołań dochodzeniowych z medium w kontroli dało 2 713 tokenów wyjściowych (628 thinking) i koszt 0,0464 $, łącznie z tym samym odrzuceniem przez bramkę.
Jedno końcowe wywołanie raportu podniosło kontrolę do 7 wywołań i łącznie 0,0615 $. Żadne z tych wywołań ani kosztów nie jest wliczone w 15 wywołań i 0,1190 $ głównego przebiegu.
Obie ścieżki dostały ten sam komunikat o nieudanym sprawdzeniu; różnił je tylko wysiłek. Jedno powtórzenie nie mierzy skali wpływu wysiłku, ale pokazuje, że high nie było konieczne w tym przypadku. Ten sam przewodnik o wysiłku rezerwuje xhigh i max na sytuacje, w których „twoje ewaluacje pokazują zysk jakości”. Przetestuj high w ten sam sposób, zanim go wybierzesz.
Końcowa weryfikacja celowo powtarza 2 kontrole bramki: dowody i zakres zapisu. Bramka przegląda propozycję przed zapisem; końcowa weryfikacja sprawdza to, co Python faktycznie zapisał, a potem dodaje kontrolę liczb i plików surowych.
Po ADJ-002 Python przeliczył wszystko od nowa na podstawie surowych zapisów, zatwierdzonych korekt i sumy bankowej:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Wszystkie cztery przeszły. Oczekiwana wypłata po korektach wyniosła 3 236,14 $, zgodnie z wpłatami. Obie korekty śledziły do pobranych linii, surowe dane źródłowe pozostały niezmienione, a Python zapisał tylko zatwierdzone wpisy.
Dopiero wtedy zaczyna się krok raportu. Aplikacja dołącza wiadomość przywracającą wysiłek do medium, krótką turę użytkownika i wiadomość systemową zamieniającą narzędzia:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Raport jest ostatnim wyjściem, nie dowodem. Jego sugestie następcze nadal wymagają ludzkiego przeglądu. Nagranie poniżej śledzi uprawnienia, wysiłek, kontrole i koszt w jednej sesji Streamlit.
Streamlit śledzi uzgodnienie od początku. Wideo autora.
Główne uzgodnienie przeszło z medium na high, kosztowało 0,1190 $ przy 15 wywołaniach API i zajęło 70,0 sekund, w tym 69,0 sekund oczekiwania na API. Osobne dopasowane powtórzenie nie jest wliczone. Każda liczba pochodzi z usage odpowiedzi i stawek Claude Sonnet 5.5.
Szersze rozbicie kosztów znajdziesz w naszym poradniku Claude API, który omawia cache’owanie promptów i przetwarzanie wsadowe.
input_tokens liczy tylko to, co przyszło po punkcie granicznym cache, więc całe wejście to suma trzech pól, jak wyjaśniają linkowane wcześniej dokumenty o cache’owaniu promptów. Zapisy i odczyty z cache mają własne stawki, a tokeny thinking są już w output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
W trakcie uzgodnienia Claude odczytał 105 614 z 118 308 tokenów wejściowych z cache (około 89%), a tylko 636 zostało rozliczonych jako niecache’owane wejście. Wykres stosuje cztery stawki tokenów do zmierzonego użycia.
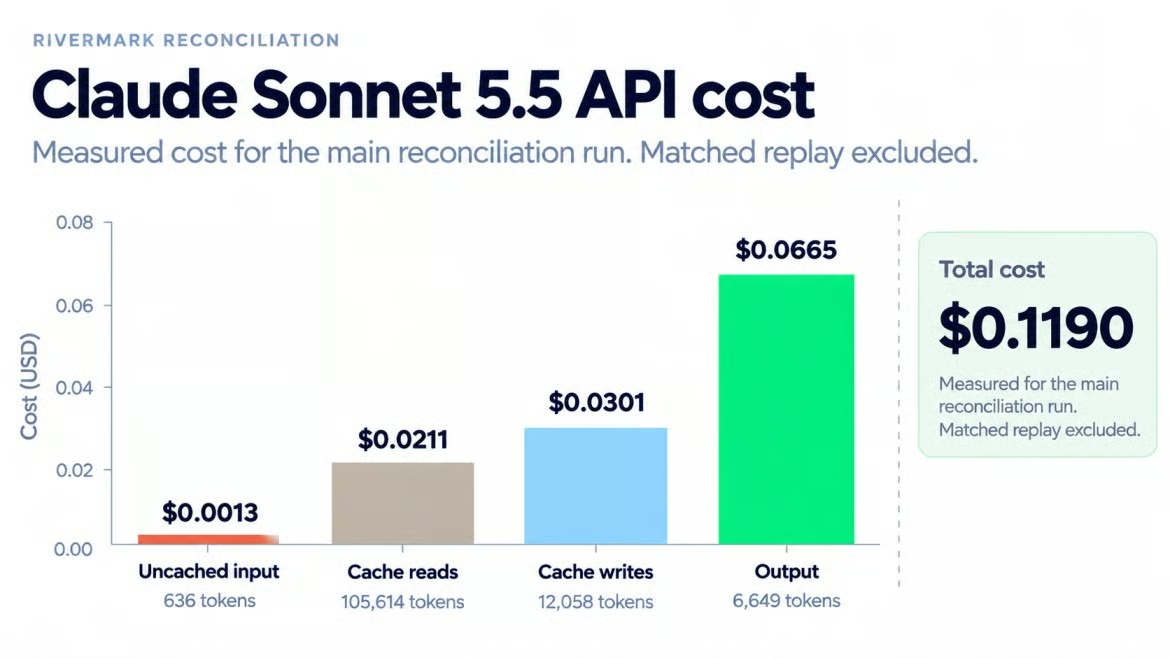
Tokeny wyjściowe dominują w zmierzonym koszcie. Ilustracja autora.
Rivermark zapisuje lokalne rekordy korekt, więc produkcyjny system finansowy wciąż potrzebuje:
Lokalne, fikcyjne dane. Prawdziwe zamknięcie wymaga uwierzytelniania, dzienników audytu, ludzkiego zatwierdzania księgowań i przeglądu retencji danych.
Funkcje beta. Nagłówki dla wysiłku per wiadomość, zmian narzędzi i aktualizacji thinking mogą się zmieniać, więc przetestuj je ponownie przed wdrożeniem.
Zmiennych wyników. Claude Sonnet 5.5 odrzuca nienaturalną temperaturę, więc powtórzenia mogą się różnić. Przetestuj wzorzec na własnych danych, zanim na nim polegniesz.
Zbudowaliśmy agenta do uzgadniania, który bada z użyciem narzędzi tylko do odczytu, dostaje jedno narzędzie do zapisu dopiero po zatwierdzeniu planu przez Pythona i kończy dopiero, gdy niezależna kontrola względem wpłat bankowych przejdzie. Claude Sonnet 5.5 sam znalazł zwrot umieszczony w niewłaściwym miesiącu, ale to nieudane sprawdzenie odesłało go z powrotem do opłaty 15,00 $, którą już czytał.
Nie uogólniałbym jednego fikcyjnego miesiąca na każde zamknięcie. To, co warto przenieść, to metoda: ukryj narzędzie do zapisu, dopóki plan nie przejdzie, trzymaj zapisy bankowe poza modelem, wymagaj dowodów transakcyjnych dla każdej korekty i dołączaj zmiany narzędzi lub wysiłku tak, aby cache przetrwał.
Niezależna kontrola to element, który zachowałbym nawet w mniejszej wersji tego projektu. Zmianę wysiłku przetestowałbym, zanim jej zaufasz, z powodów omówionych w sekcji o wysiłku.
Zamiana narzędzi do odczytu i końcowej kontroli pozwala temu samemu wzorcowi obsłużyć czyszczenie danych, zwroty w supporcie czy kontrolowane aktualizacje dokumentów. Moją pierwszą rozbudową byłby krok ludzkiej akceptacji przed zapisaniem każdej korekty, bo prawdziwe zamknięcie tego wymaga.
Aby poćwiczyć podstawy Anthropic API, na których opiera się ta budowa, polecam nasz kurs Introduction to Claude Models.
Ucz się pracy z Claude’em w DataCamp!
Kurs
Kurs
Ścieżka