Kurs
Einführung in die Claude-Modelle
3 Std.
14.7K
Claude Sonnet 5.5 ist Teil der Claude 5.5-Familie von Anthropic. Als ich das Projekt startete, war es gerade erschienen; die API-Model-ID ist claude-sonnet-5-5. Laut dem Model-Überblick verfügt es über ein 1M-Token-Kontextfenster, bis zu 128K Ausgabe-Tokens, standardmäßig aktiviertes adaptives Denken und einen Standard-Effort von high in der API. Die regulären Preise liegen bei $2 pro Million Eingabetokens und $10 pro Million Ausgabetokens.
Unser Claude Sonnet 5.5-Überblick behandelt Benchmarks, Preisvergleiche und den Zugang. Drei API-Features sind in diesem Release neu, und Rivermark nutzt alle.
Claude Sonnet 5.5 bringt drei Wege, eine Unterhaltung während des Laufs zu verändern. Laut What’s new in Claude Sonnet 5.5 gibt es diese auf Claude Sonnet 5 nicht:
Der Rivermark-Agent ist eine Python-Anwendung rund um eine Messages-API-Unterhaltung mit zwei Berechtigungsstufen. Während der Untersuchung kann Claude Bestellungen, Rückerstattungen, Prozessortransaktionen, die Abschlussrichtlinie und Rivermarks Abstimmungscheck lesen. Nach Freigabe darf es nur die genehmigten Anpassungen aufzeichnen.
Rivermark verwendet eine eigene Messages-API-Schleife statt des Claude Agent SDK, weil die Freigabeschranke zwischen Claudes Tool-Aufrufen und deren Ausführung liegen muss.
Der komplette Code und Beispieldaten liegen im Rivermark GitHub-Repository.
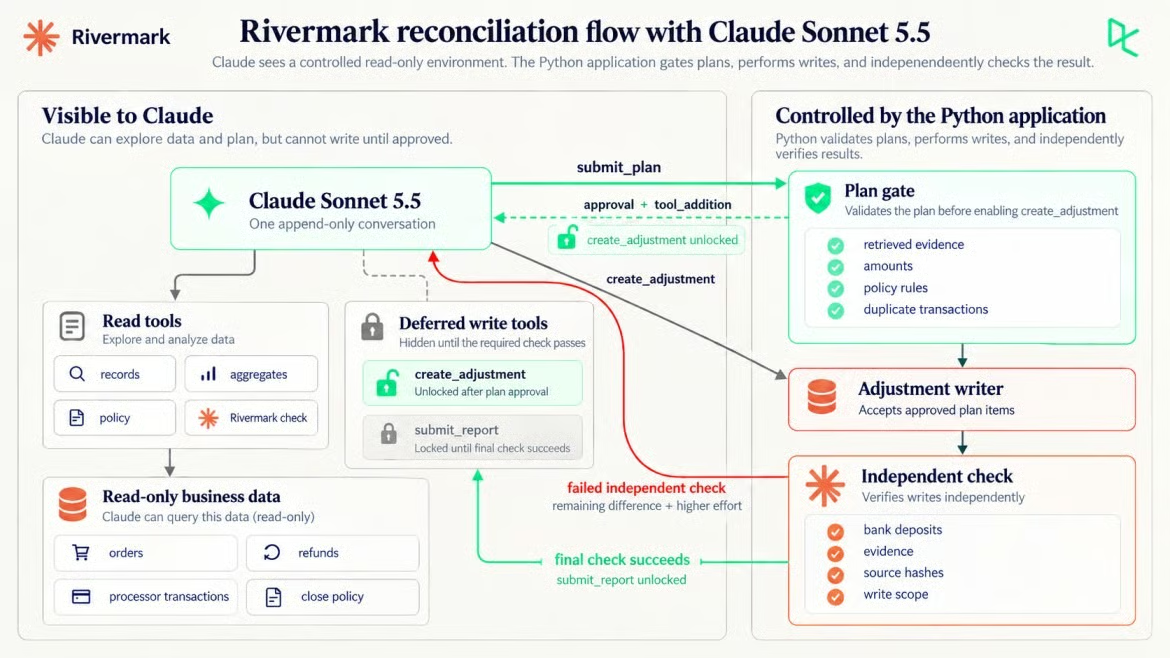
Claude schlägt vor, Python erteilt Schreibzugriff. Bild: Autor.
Rivermarks Check meldet $3,400.14 als erwartete Auszahlung und $3,251.14 als berechnete Prozessorsumme — eine Differenz von $149.00. Claude muss die Abweichung zwischen den Belegen erklären, ohne eine der verborgenen Ursachen zu sehen.
Rivermark verkauft drei Monatspläne: Starter für $29, Team für $79 und Business für $149. Das Sample enthält 58 September-Bestellungen, 7 Rückerstattungsdatensätze und 65 September-Prozessortransaktionen. Jeder Prozessor-Datensatz hat Betrag, Gebühr und Netto.
Nicht Claude, sondern Python entscheidet, ob die Abstimmung abgeschlossen ist:
Der Monat ist September 2026, nach Prozessor-Abrechnungsdatum.
Die Summe der September-Bankeinzahlungen ist das unabhängige Abgleichsziel des Experiments.
Ausgeglichen bedeutet: Erwartete Auszahlung plus Anpassungen entspricht diesen Einzahlungen auf den Cent genau.
Jede Anpassung nennt die Prozessor-txn_ids, die Claude abgerufen hat, und ihr Betrag entspricht deren Netto.
Claude darf nur genehmigte Anpassungen hinzufügen und den Abschlussbericht übermitteln.
Roh-Exporte werden vor der Verarbeitung gehasht und müssen danach übereinstimmen.
Claude darf Bankbelege oder Zielsumme während der ersten Untersuchung nicht einsehen. Nach einem fehlgeschlagenen Check zeigt Python nur die erwartete Auszahlung, die aggregierte Einzahlungssumme und die verbleibende Abweichung — nicht aber die Bankbelege selbst.
Du brauchst Python 3.10 oder neuer, was das Python SDK verlangt, einen Anthropic API-Schlüssel und anthropic 1.9.0. Diese PowerShell-Befehle klonen das Projekt, erstellen die Umgebung und bauen die Beispieldaten:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Unter macOS oder Linux verwende source .venv/bin/activate und cp .env.example .env, dann trage deinen Schlüssel in .env ein. Unser Guide zu Umgebungsvariablen erklärt das Muster.
streamlit run app_streamlit.py öffnet ein Webinterface, das jeden Schritt der Abstimmung live zeigt, und unser Streamlit-Tutorial behandelt das Setup.
Wenn dein API-Schlüssel bereits funktioniert, überspringe die nächste Anfrage und wechsle zum adaptiven Denken.
Wenn API-Request- und -Response-Objekte für dich neu sind, erklärt unser Python-API-Guide die Basics. Eine einzige Frage zur Rückerstattung reicht, um den Schlüssel zu bestätigen und die zurückgegebenen Content-Blöcke zu inspizieren:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
In meinem Lauf begann die Antwort mit einem thinking-Block. Wähle Blöcke nach type aus statt response.content[0] zu lesen; Thinking-Tokens werden als Output berechnet.
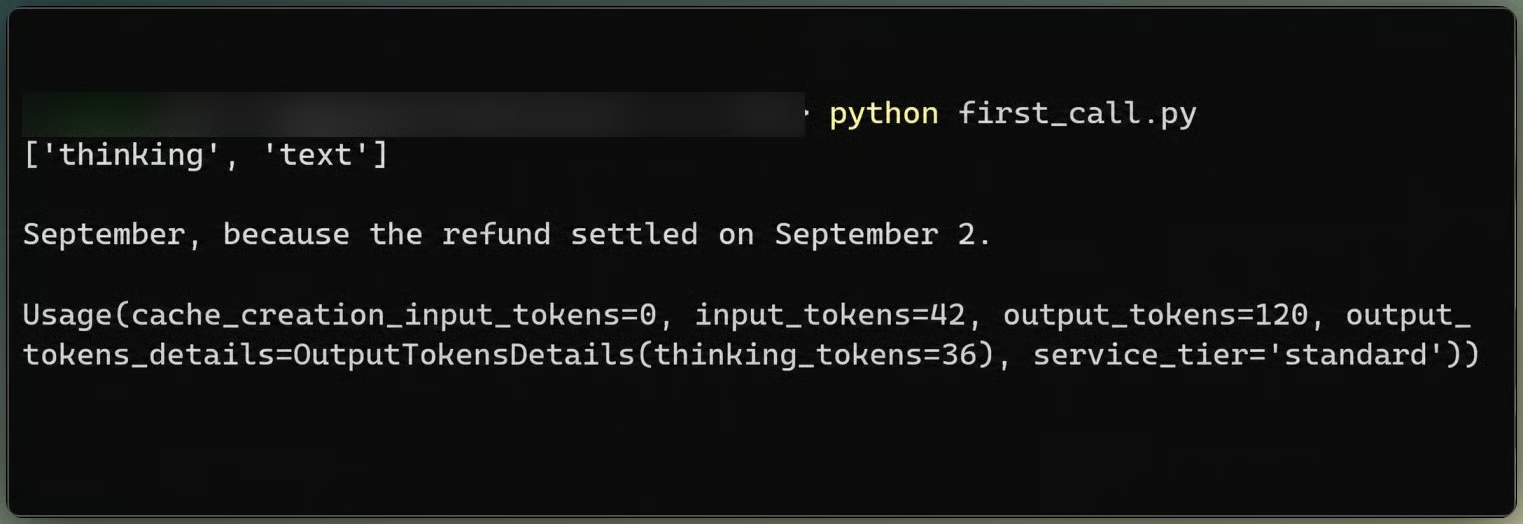
Erste Antwort trennt Thinking von Text. Bild: Autor.
Jede Anfrage sendet dieselben Top-Level-Einstellungen, nur messages wächst:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Trotz des API-Defaults high startet dieser Workflow mit medium. Anthropics Effort-Guide sagt: „Für agentisches Coden und mehrstufige Tool-Nutzung mit medium bei klar definierten Aufgaben starten und auf high wechseln, wenn sie schwieriger oder länger werden.“
Das Thinking bleibt adaptiv, weil die spätere Effort-Änderung darauf aufbaut. display: "updates" (Beta, thinking-display-updates-2026-08-18) liefert die Notizen, die Claude zwischen Tool-Aufrufen schreibt. Ohne diese Einstellung sind die Thinking-Blöcke leer.
Das Top-Level-cache_control schaltet automatisches Prompt-Caching ein, mit einem Breakpoint, der sich nach vorn verschiebt, während die Unterhaltung wächst. Die erste Anfrage schrieb 2.080 Tokens in den Cache — deutlich über Claude Sonnet 5.5s Minimum von 512 Tokens.
Ein Read-only-Untersuchungsagent erlaubt Claude, Belege anzufordern, stellt aber kein Schreib-Tool bereit. Rivermark weist zudem nicht genehmigte Schreibaufrufe in Python zurück.
Claude erhält fünf Lese-Tools und ein Vorschlags-Tool, alle mit strict: true. Die Beschreibungen sagen, was jedes Tool zurückgibt — nicht, wo zu suchen ist:
list_sources gibt Quellen, Spalten und Zeilenzahlen zurück.
query_records liefert bis zu 40 Zeilen aus einer Quelle, optional gefiltert und mit Datumsbereich.
aggregate_records zählt Zeilen und summiert amount_cents nach beliebigen Spalten.
read_policy gibt die Abschlussrichtlinie zurück.
run_reconciliation_check führt Rivermarks bestehende interne Logik aus, inklusive etwaiger Bugs.
submit_plan sendet Diagnose und vorgeschlagene Anpassungen an Python zur Validierung und schreibt nichts.
Zwei weitere Tools stehen in demselben tools-Array, aber defer_loading: true hält sie vorerst außerhalb von Claudes Sicht. Wie sie später erscheinen, folgt gleich:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Das Schema des Schreib-Tools ist bereits beim ersten Request bekannt, also wird das Tool von Beginn an deklariert. Eine benannte oder any Toolwahl liefert einen 400-Fehler, daher erklärt der Prompt, wann submit_plan anzuwenden ist.
Unser Guide zu Agent-Harness-Engineering erklärt, wie Python längere Agent-Schleifen steuern kann. Rivermarks Schleife sendet die Unterhaltung, führt etwaige tool_use-Blöcke in Python aus und hängt die Ergebnisse an. Jede von einem Lese-Tool zurückgegebene Datensatz-ID landet in einer observed-Menge, die die Plan-Schranke später prüft:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Der Assistant-Turn geht exakt unverändert zurück, leere Thinking-Blöcke inklusive. Die Migrationsanleitung erklärt, dass Claude Sonnet 5.5 Thinking-Blöcke an frühere Nachrichten bindet — Änderungen an dieser Historie können einen 400-Fehler auslösen.
Bei medium brauchte die Untersuchung sechs API-Calls und neun Lese-Tool-Aufrufe. Claude zog die Rückerstattungen und gruppierte die Prozessorzeilen nach reporting_category. Es fand RF-1043, eine $149.00-Rückerstattung für eine Bestellung vom 31. August, die am 2. September abgerechnet wurde. Richtlinie POL-3 ordnet sie dem September zu.
Dann öffnete es beide Dispute-Zeilen. TXN-50036 enthält -$149.00 Hauptbetrag, $15.00 Gebühr und -$164.00 Netto-Cash-Effekt. TXN-50052 gibt die $149.00 Hauptsumme ohne Gebühr zurück. Claude schrieb: „DSP-0077 saldiert auf Null und seine $15-Gebühr ist bereits korrekt verbucht, daher erklärt RF-1043 die Differenz vollständig.“
Claude verwechselte den zurückgezahlten Hauptbetrag mit dem Cash-Effekt nach Gebühren:
Die Schranke lehnte Claudes ersten Plan ab, weil er Bestellung ORD-20813 zitierte, ohne sie abzurufen. Claude holte die Bestellung nach, reichte erneut ein, und PLAN-1 passierte mit einer Anpassung.
Bevor das Schreib-Tool sichtbar wird, prüft die Schranke, woher die Belege stammen und was der Plan verändern würde.
Jede Anpassung in einem Plan nennt Prozessor-txn_ids. Die Schranke akzeptiert sie nur, wenn jede zitierte Zeile in dieser Unterhaltung von einem Lese-Tool zurückkam und die Zeilen auf den vorgeschlagenen Betrag saldieren:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Eine $15.00-Anpassung, die nur die Dispute-Belastung zitiert, fällt durch, weil deren Netto -$164.00 ist. Der Plan muss auch die Gegenbuchung nennen.
Die Schranke prüft auch Richtlinienregeln und Dubletten. Ein Plan wird abgelehnt — Schreibzugriff bleibt gesperrt —, wenn ein Punkt Folgendes tut:
Ablehnungen kommen als Ergebnis des submit_plan-Tools zurück, sodass Claude weiter ermitteln und erneut einreichen kann. Die Schranke lehnte 2 von 4 Einreichungen ab, und Claude korrigierte jeweils im nächsten Call. Selbst nach Freigabe akzeptiert create_adjustment nur Einträge, die exakt einem genehmigten Punkt entsprechen.
Sobald die Schranke einen Plan genehmigt, hängt Python eine role: "system"-Nachricht mit einem tool_addition-Block an. Die Änderung benötigt den inline-tools-2026-09-15-Beta-Header. Das tools-Array und alle früheren Nachrichten bleiben unverändert, sodass das gecachte Präfix weiterhin passt. Der Instruktionstext kommt von Python, nicht von Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Eine Systemnachricht mit Inhalt muss auf einen user-Turn folgen, auch wenn dieser nur tool_result-Blöcke enthält. Sie darf nicht zwischen einem tool_use-Block und dessen Ergebnis stehen. Systemnachrichten haben höhere Priorität, also füge nie Claudes Plantext, Toolausgaben oder Daten dort ein. Der tool_addition-Block referenziert create_adjustment namentlich; das Tool wird erst sichtbar, nachdem der Plan bestanden hat.
Das Caching lief nach der Tool-Änderung weiter. Die Anfrage verarbeitete 231 un-gecachte Eingabetokens und las 6.883 aus dem Cache.
Die erste Anpassung war korrekt und dennoch nicht ausreichend. Claude zeichnete ADJ-001 mit -$149.00 nach POL-3 auf und meldete Abschluss. Rivermarks interner Check hätte zugestimmt und eine Abweichung von $0.00 gezeigt. Das klingt fertig, ist es aber nicht.
Der unabhängige Python-Check vergleicht stattdessen mit den Bankeinzahlungen. Erwartete Auszahlung nach Anpassungen: $3,251.14, Einzahlungen: $3,236.14, verbleibend: $15.00.
Diese Lücke ist der Grund, warum der Abschluss-Check in Python statt in Claudes letzter Nachricht lebt.
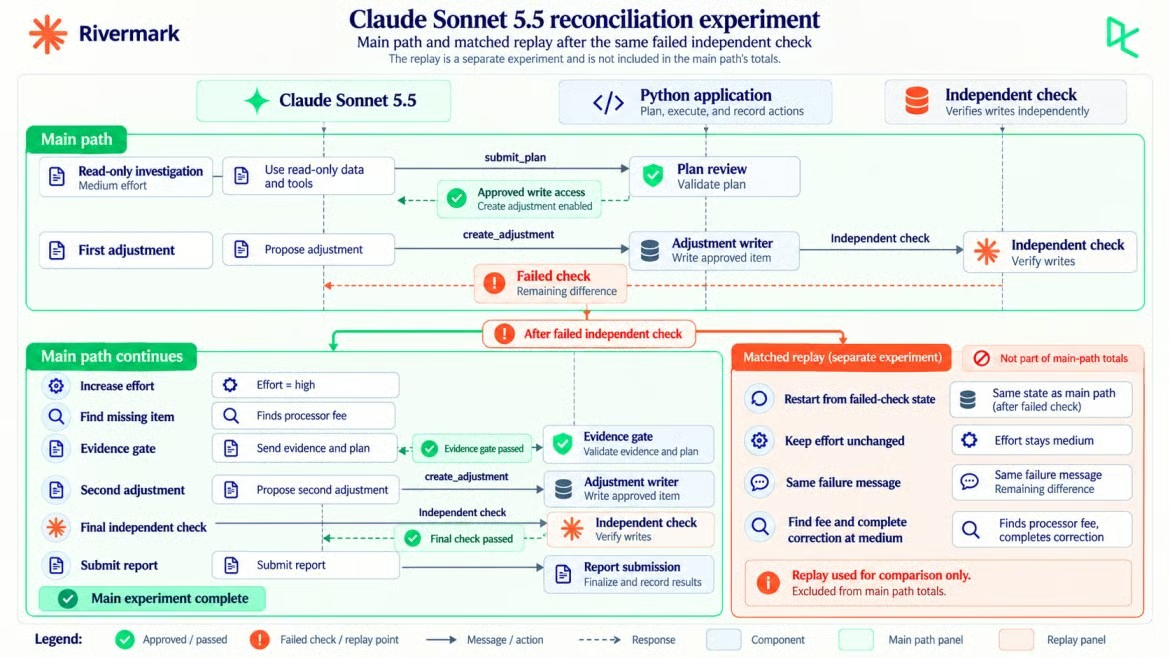
Matched Replay zweigt nach fehlgeschlagener Verifikation ab. Bild: Autor.
Effort mitten im Gespräch in Claude Sonnet 5.5 zu ändern, bedeutet, eine Systemnachricht mit leerem content und neuem output_config.effort anzuhängen. Das neue Level gilt ab dem nächsten user-Turn, alles davor bleibt gecacht.
Effort pro Nachricht ist im Beta-Stadium und benötigt den mid-conversation-output-config-2026-07-01-Header. Zudem braucht es adaptives Denken: Mit between_tools liefert dieselbe Änderung einen 400-Fehler. Wenn der unabhängige Check scheitert, hängt Python die neue Effort-Einstellung vor die nächste User-Nachricht:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Eine Top-Level-Effort-Änderung würde den Cache neu starten, da Top-Level-Effort Teil des gecachten Prompts ist. Die pro-Nachricht-Variante tat das nicht: Die erste Anfrage mit hohem Effort las 8.012 Tokens aus dem Cache und verarbeitete 4 ungecachte.
Die $15.00-Differenz gibt Claude ein Ziel, aber noch keine Belege für eine Korrektur. Die Schranke verlangt weiterhin Transaktions-IDs, die Claude abgerufen hat, und deren net_cents müssen -$15.00 ergeben. Ein vorgeschlagener -$15.00-Eintrag nur mit TXN-50036 fällt weiterhin durch, weil dessen Netto -$164.00 ist.
Mit high gruppierte Claude die Prozessorzeilen nach Auszahlung und nach fee_cents und ließ den internen Check erneut laufen. In der nächsten Notiz summierte es die Gebührzeilen auf 12.586 Cent. Die Dispute-Gebühr hob diese Summe auf 14.086 Cent an. Rivermarks Check hatte sie ausgelassen.
Der erste geänderte Plan scheiterte an dieser Regel, weil er nur die Belastung zitierte. Der nächste nannte beide Dispute-Zeilen, PLAN-2 bestand und ADJ-002 verbuchte -$15.00 unter POL-4.
Dieses Experiment zeigt nicht, dass high notwendig war. Ein separater Replay lief ab demselben Fehlerpunkt mit derselben Verlaufshistorie und Python-Nachricht weiter, blieb aber auf medium — und fand die Gebühr ebenfalls.
Die sechs Anfragen mit high im Hauptlauf erzeugten 2.763 Ausgabetokens (607 Thinking) und kosteten $0.0484. Die sechs Anfragen der separaten Kontrolle mit medium erzeugten 2.713 Ausgabetokens (628 Thinking) und kosteten $0.0464, inklusive derselben Schranken-Ablehnung.
Ein letzter Report-Call brachte die Kontrolle auf 7 Calls und insgesamt $0.0615. Keiner dieser Calls oder Kosten ist in den 15 Calls und $0.1190 des Hauptlaufs enthalten.
Beide Pfade erhielten dieselbe Fehlermeldung des Checks; nur der Effort unterschied sich. Ein einzelner Replay misst nicht die Größe eines Effort-Effekts, zeigt aber, dass high hier nicht notwendig war. Derselbe Effort-Guide reserviert xhigh und max für Fälle, in denen „deine Evals einen Qualitätsgewinn zeigen“. Teste high ebenso, bevor du es auswählst.
Die finale Verifikation wiederholt absichtlich zwei Schranken-Checks: Beleglage und Schreibumfang. Die Schranke prüft einen Vorschlag vor dem Schreiben; die Abschlussverifikation inspiziert, was Python tatsächlich geschrieben hat, und ergänzt dann die Zahlen- und Rohdaten-Checks.
Nach ADJ-002 berechnete Python alles neu aus den Rohdaten, den genehmigten Anpassungen und der Banksumme:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Alle vier bestanden. Erwartete Auszahlung nach Anpassungen lag bei $3,236.14 und entsprach den Einzahlungen. Beide Anpassungen ließen sich auf abgerufene Zeilen zurückführen, die Rohdaten blieben unverändert, und Python schrieb nur die genehmigten Einträge.
Erst danach startet der Report-Schritt. Die Anwendung hängt eine Nachricht an, die den Effort wieder auf medium setzt, einen kurzen User-Turn, und eine Systemnachricht, die die Tools tauscht:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Der Bericht ist die letzte Ausgabe, nicht der Beweis. Seine Follow-up-Vorschläge benötigen weiterhin menschliche Prüfung. Die folgende Aufzeichnung zeigt Berechtigungen, Effort, Checks und Kosten in einer Streamlit-Session.
Streamlit begleitet die Abstimmung von Anfang an. Video: Autor.
Die Hauptabstimmung wechselte von medium auf high, kostete $0.1190 über 15 API-Calls und dauerte 70,0 Sekunden, davon 69,0 Sekunden Wartezeit auf die API. Der separate matched Replay ist nicht enthalten. Alle Werte stammen aus der Response-usage und den Sätzen von Claude Sonnet 5.5.
Für eine breitere Kostenaufschlusselung behandelt unser Claude API-Guide Prompt-Caching und Batch-Verarbeitung.
input_tokens zählt nur, was nach dem Cache-Breakpoint kam. Die gesamte Eingabe ist also die Summe aus drei Feldern, wie in den verlinkten Prompt-Caching-Dokus erklärt. Cache-Writes und -Reads haben eigene Sätze, und Thinking-Tokens stecken bereits in output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Während der Abstimmung las Claude 105.614 von 118.308 Eingabetokens aus dem Cache (rund 89%), und nur 636 wurden als ungecachte Eingabe berechnet. Das Diagramm wendet die vier Token-Sätze auf die gemessene Nutzung an.
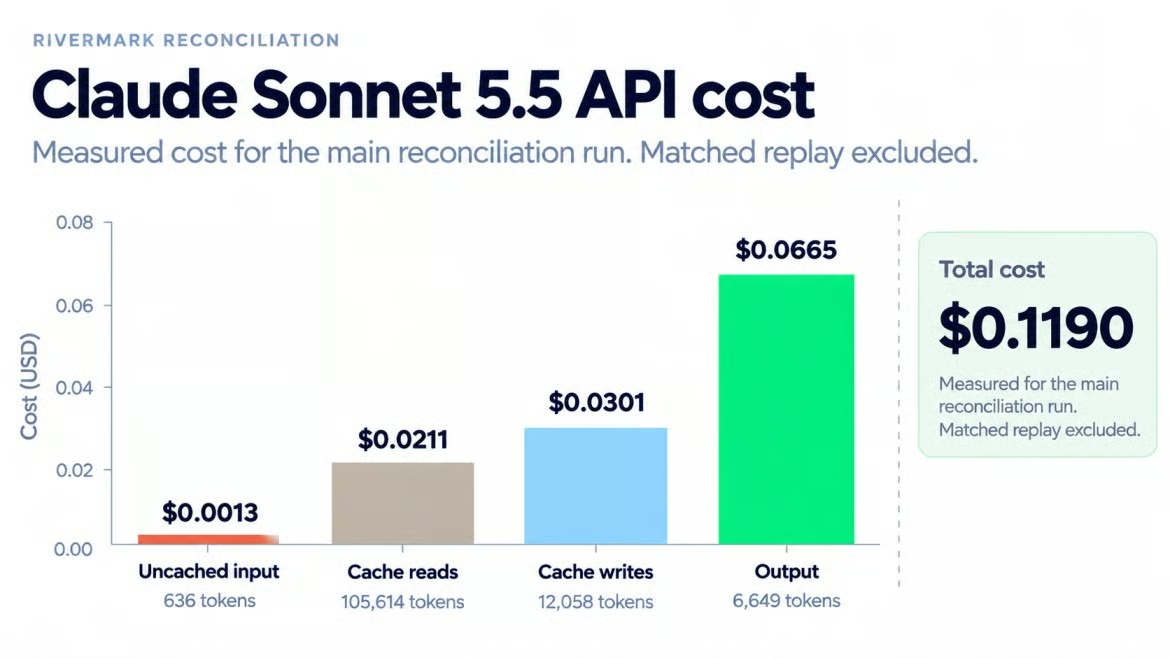
Ausgabetokens dominieren die gemessenen Kosten. Bild: Autor.
Rivermark schreibt lokale Anpassungseinträge. Ein produktives Finance-System benötigt zusätzlich:
Lokale, fiktive Daten. Ein echter Abschluss braucht Authentifizierung, Audit-Logs, menschliche Freigaben für Buchungen und eine Prüfung der Datenaufbewahrung.
Beta-Features. Die Header für Effort pro Nachricht, Tool-Änderungen und Thinking-Updates können sich ändern. Teste sie vor dem Rollout erneut.
Schwankende Ergebnisse. Claude Sonnet 5.5 lehnt nicht-default Temperatur ab, daher können Wiederholungen variieren. Teste das Muster auf deinen Daten, bevor du dich darauf verlässt.
Wir haben einen Reconciliation-Agenten gebaut, der mit Read-only-Tools ermittelt, erst nach Python-Freigabe ein Schreib-Tool erhält und erst fertig ist, wenn ein unabhängiger Abgleich mit Bankeinzahlungen passt. Claude Sonnet 5.5 fand die fehlplatzierte Rückerstattung selbst, brauchte aber den fehlgeschlagenen Check, um zu der $15.00-Gebühr zurückzukehren, die es bereits gelesen hatte.
Von einem fiktiven Monat auf jeden Abschluss zu schließen, würde ich nicht. Was übertragbar ist, ist die Methode: Schreib-Tool verbergen, bis ein Plan besteht; Bankbelege außerhalb des Modells halten; für jede Korrektur Transaktionsbelege verlangen; Tool- oder Effort-Änderungen anhängen, damit der Cache erhalten bleibt.
Den unabhängigen Check würde ich selbst in einer kleineren Version beibehalten. Die Effort-Änderung würde ich vor dem Vertrauen testen — aus den Gründen im Effort-Abschnitt.
Durch den Tausch der Lese-Tools und des Finalchecks lässt sich dasselbe Muster für Datenbereinigungen, Support-Rückerstattungen oder kontrollierte Dokument-Updates nutzen. Meine erste Erweiterung wäre ein menschlicher Freigabeschritt vor jeder geschriebenen Anpassung — ein echter Abschluss braucht ihn.
Um die Anthropic-API-Grundlagen zu üben, auf denen dieser Build beruht, empfehle ich unseren Kurs Introduction to Claude Models.
Lerne, Claude mit DataCamp zu nutzen!
Kurs
Kurs
Lernpfad
Blog
Tutorial
Derrick Mwiti
10 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Laiba Siddiqui
6 Min.