コース
Claude モデル入門
3時間
14.7K
Claude Sonnet 5.5はAnthropicのClaude 5.5ファミリーの一部です。本プロジェクト開始時にちょうどリリースされたばかりで、APIのモデルIDはclaude-sonnet-5-5です。モデル概要によると、100万トークンのコンテキストウィンドウ、最大128Kの出力トークン、デフォルトで有効なアダプティブ思考、APIのデフォルトeffortはhighです。標準の料金は、入力100万トークンあたり$2、出力100万トークンあたり$10です。
当サイトのClaude Sonnet 5.5の概要では、ベンチマーク、料金比較、アクセス方法を解説しています。本リリースで新たに加わったAPI機能のうち3つを、Rivermarkはすべて使用します。
Claude Sonnet 5.5は、会話の最中に変更を加える3つの方法を追加しました。What's new in Claude Sonnet 5.5によると、いずれもClaude Sonnet 5にはありません。
Rivermarkエージェントは、2つの権限レベルを持つ1つのMessages APIの会話を中心に構築されたPythonアプリケーションです。調査中は、Claudeは注文、返金、決済代行の取引、クローズポリシー、Rivermarkの照合チェックを閲覧できます。承認後は、承認済みの調整のみを記録できます。
Rivermarkは、承認ゲートをClaudeのツール呼び出しとその実行の間に置く必要があるため、Claude Agent SDKではなくカスタムのMessages APIループを使用しています。
完全なコードとサンプルデータはRivermarkのGitHubリポジトリにあります。
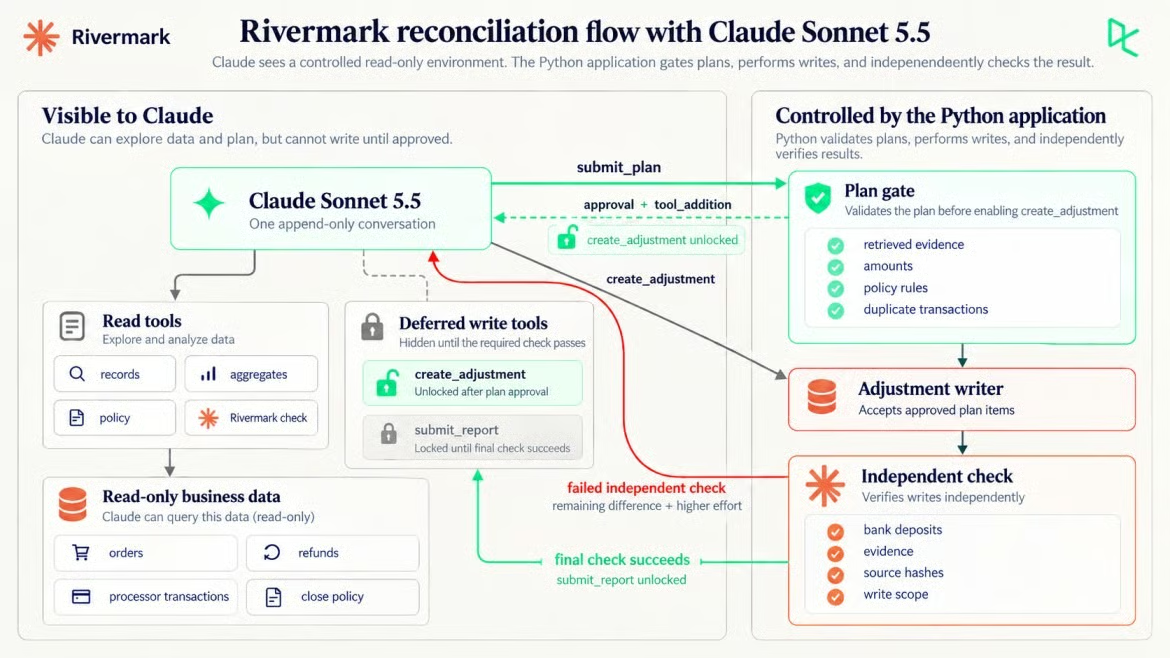
Claudeが提案し、Pythonが書き込み権限を付与。画像:著者
Rivermarkのチェックは、期待支払額$3,400.14に対して、計算された決済代行合計が$3,251.14と報告しており、差額は$149.00です。Claudeは、2つの隠れた原因を見ずに、この差を記録間の不一致として説明しなければなりません。
Rivermarkは月額プランを3つ販売しています:Starter $29、Team $79、Business $149。サンプルには9月の注文が58件、返金記録が7件、9月の決済代行の取引が65件含まれます。各決済代行レコードには、金額、手数料、純額が含まれます。
照合の完了可否を決めるのはClaudeではなくPythonです。
対象月は2026年9月(決済代行の精算日基準)。
9月の銀行入金合計が、この実験における独立した精算目標。
「一致」とは、期待支払額に調整を加えた合計が、銀行入金と1セント単位で一致すること。
すべての調整は、Claudeが取得した決済代行のtxn_idsを引用し、その金額がそれらの純額に等しいこと。
Claudeは承認済みの調整を追加し、最終レポートを提出することのみ可能。
生データのエクスポートは処理前にハッシュ化し、処理後に一致する必要がある。
Claudeは初期調査の間、銀行記録や目標合計を閲覧できません。チェックに失敗した後、Pythonは期待支払額、入金合計(集計値)、残差のみを開示し、銀行記録自体は見せません。
Python 3.10以上が必要です。これはPython SDKの要件であり、anthropic 1.9.0、Anthropic APIキーも必要です。以下のPowerShellコマンドでプロジェクトのクローン、環境作成、サンプルデータ生成を行います。
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.pymacOSやLinuxではsource .venv/bin/activateとcp .env.example .envを使い、.envにキーを設定してください。環境変数のパターンは環境変数ガイドをご参照ください。
streamlit run app_streamlit.pyを実行すると、照合の各ステップが進行に合わせて見られるWebインターフェースが開きます。セットアップはStreamlitチュートリアルをご覧ください。
APIキーがすでに動作している場合は、次のリクエストは飛ばしてアダプティブ思考に進んでください。
APIのリクエスト/レスポンスオブジェクトに不慣れな方は、Python APIガイドで基本を確認してください。返金に関する1問で、キーの確認と返ってくるコンテントブロックの点検ができます。
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)私の実行では、レスポンスはまずthinkingブロックから始まりました。最初の要素response.content[0]を読むのではなく、typeでブロックを選別してください。thinkingトークンは出力として課金されます。
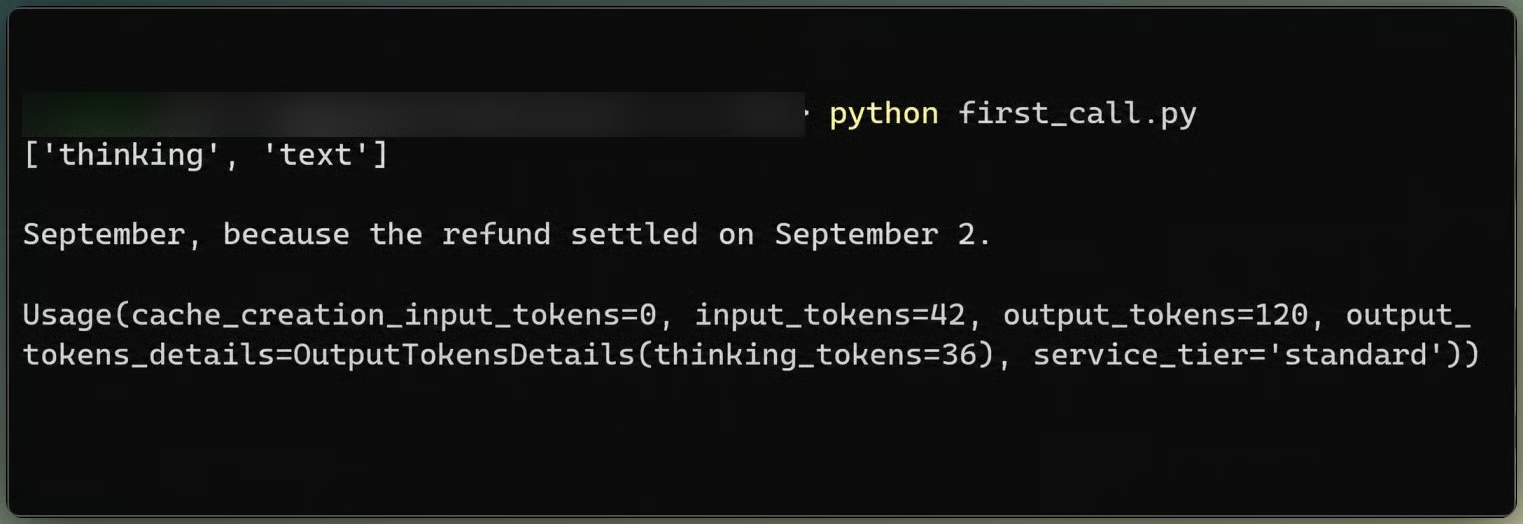
最初のレスポンスはthinkingとtextを分離。画像:著者
各リクエストは同じトップレベル設定を送り、messagesだけが増えていきます。
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)APIのデフォルトがhighであっても、本ワークフローはmediumから開始します。Anthropicのeffortガイドでは「エージェント的なコーディングや複数ステップのツール使用には、明確に定義されたタスクならmediumから始め、難易度や長さに応じてhighに上げる」と述べています。
思考はアダプティブのままにします。後段のeffort変更がそれに依存するためです。display: "updates"(ベータ、thinking-display-updates-2026-08-18)は、ツール呼び出しの合間にClaudeが書くノートを返します。この設定がないとthinkingブロックは空になります。
トップレベルのcache_controlはプロンプトキャッシュを自動で有効化し、会話が進むにつれてブレークポイントが前進します。最初のリクエストでは2,080トークンがキャッシュに書き込まれ、Claude Sonnet 5.5の最低512トークンを大きく上回りました。
読み取り専用の調査エージェントは、Claudeに証拠の要求を許可する一方、書き込みツールは公開しません。Rivermarkはまた、Python側で未承認の書き込み呼び出しを拒否します。
Claudeは5つの読み取りツールと1つの提案ツールを持ち、いずれもstrict: trueです。説明文は各ツールが返す内容だけを示し、どこを見るべきかは示しません。
list_sources:ソース、カラム、行数を返す。
query_records:1つのソースから最大40行を返し、任意のフィルタと日付範囲を指定可能。
aggregate_records:任意のカラムで行数とamount_centsの合計を集計。
read_policy:クローズポリシーを返す。
run_reconciliation_check:Rivermarkの既存の内部ロジック(不具合も含む)を実行。
submit_plan:診断と提案調整をPythonに送信して検証し、何も書き込まない。
さらに2つのツールが同じtools配列にありますが、defer_loading: trueによって現時点ではClaudeから見えません。後で表示される仕組みを説明します。
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
"input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},書き込みツールのスキーマは初回リクエスト時に既知なので、ツールは最初に宣言しておきます。指名またはanyのツール選択は400エラーになるため、プロンプトにはsubmit_planの適用条件を明記します。
当サイトのエージェント制御ハーネスの解説では、Pythonが長めのエージェントループを管理する方法を説明しています。Rivermarkのループは会話を送信し、tool_useブロックをPythonで実行して結果を追加します。読み取りツールが返したすべてのレコードIDは、後で計画ゲートが確認するobserved集合に入ります。
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
messages.append({"role": "user", "content": results})アシスタントのターンは受信したまま、空のthinkingブロックも含めてそのまま戻します。移行ガイドによれば、Claude Sonnet 5.5はthinkingブロックを前のメッセージに結び付けるため、その履歴を編集すると400エラーになることがあります。
mediumでは、調査に6回のAPI呼び出しと9回の読み取りツール呼び出しを要しました。Claudeは返金を取得し、決済代行の行をreporting_categoryでグループ化しました。8月31日の注文に対する$149.00の返金RF-1043を見つけ、9月2日に精算されています。ポリシールールPOL-3により9月計上です。
その後、紛争の2つの行を開きました。TXN-50036は-$149.00の元本、$15.00の手数料、純キャッシュ効果は-$164.00。TXN-50052は手数料なしで$149.00の元本を戻します。Claudeは「DSP-0077はネットでゼロになり、その$15の手数料はすでに正しく計上済みなので、RF-1043で差異は完全に説明できる」と記しました。
Claudeは、戻った元本と手数料控除後のキャッシュ効果を混同していました。
ゲートは、ClaudeがORD-20813を取得せずに引用したため、最初の計画を却下しました。Claudeは注文を取得して再提出し、PLAN-1は1件の調整で承認されました。
書き込みツールを公開する前に、ゲートは証拠の出所と計画が変える内容をチェックします。
計画の各調整は決済代行のtxn_idを引用します。ゲートは、引用されたすべての行がこの会話で読み取りツールから返されており、それらの純額が提案金額と一致する場合にのみ受理します。
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
紛争の借方のみを引用した$15.00の調整は、その行の純額が-$164.00であるため不合格です。計画は返戻行も合わせて引用しなければなりません。
ゲートはポリシールールと重複取引も確認します。以下のいずれかに該当する項目があると、計画は却下され、書き込み権限は開放されません。
却下はsubmit_planのツール結果として返るため、Claudeはさらに調査して再提出できます。ゲートは4件中2件を却下し、Claudeはいずれも次の呼び出しで修正しました。承認後であっても、create_adjustmentは承認項目と完全一致するエントリのみを受け付けます。
ゲートが計画を承認すると、Pythonはrole: "system"のメッセージをtool_additionブロック付きで追加します。この変更にはinline-tools-2026-09-15のベータヘッダが必要です。tools配列やそれ以前のメッセージは一切変更しないため、キャッシュ済みのプレフィックスは一致したままです。指示文はClaudeではなくPythonから与えます。
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True内容を持つシステムメッセージは、userのターンに続けて追加する必要があります(tool_resultブロックを含むものも可)。tool_useブロックとその結果の間に挿入することはできません。システムメッセージは優先度が高いため、Claudeの計画テキストやツール出力、データをここに挿入してはいけません。tool_additionブロックはcreate_adjustmentを参照名で指定し、計画が承認されてから初めてツールが見えるようになります。
ツール変更後もキャッシュは維持されました。このリクエストでは未キャッシュ入力231トークン、キャッシュから6,883トークンを読み込みました。
最初の調整は正しかったものの、作業はまだ終わっていませんでした。ClaudeはADJ-001(- $149.00、POL-3)を記録し、完了と報告しました。Rivermarkの内部チェックも$0.00の差異を示し、同意したはずです。一見、完了に思えますが、実はそうではありません。
独立したPythonのチェックは銀行入金と照合します。調整後の期待支払額は$3,251.14、入金は$3,236.14で、$15.00の差が残っていました。
このギャップこそ、完了チェックをClaudeの最終メッセージではなくPython側に置く理由です。
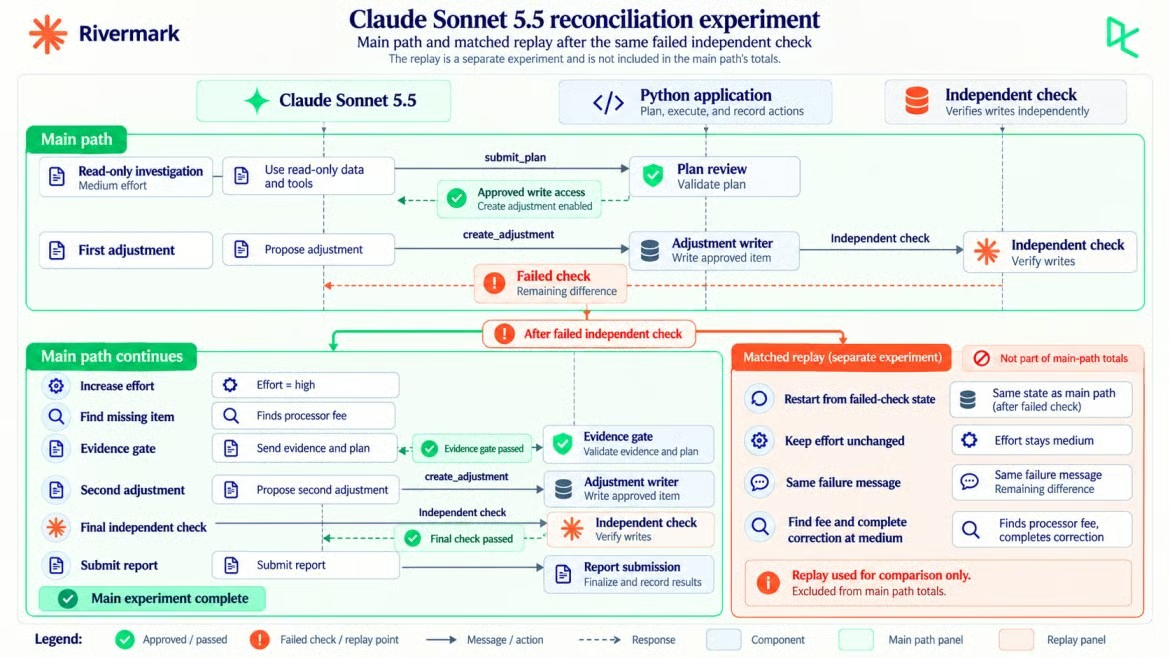
失敗した検証から分岐する一致リプレイ。画像:著者
Claude Sonnet 5.5で会話の途中にeffortを変更するには、空のcontentと新しいoutput_config.effortを持つシステムメッセージを追加します。新しいレベルは次のuserターンから適用され、それ以前はキャッシュに残ります。
メッセージ単位のeffortはベータ版で、mid-conversation-output-config-2026-07-01ヘッダが必要です。またアダプティブ思考が必要です。between_toolsでは同じ変更が400エラーになります。独立チェックが失敗したら、Pythonは次のユーザーメッセージの前に新しいeffort設定を追加します。
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
トップレベルのeffort変更は、キャッシュに含まれるプロンプトの接頭部を変えてしまうため、キャッシュを再構築します。メッセージ単位の方式では再構築されません。最初のhigh-effortリクエストは、キャッシュから8,012トークンを読み、未キャッシュは4トークンでした。
$15.00の差はClaudeに目標を与えますが、修正の根拠にはなりません。ゲートは依然として、Claudeが取得した取引IDと、それらのnet_centsが- $15.00に合計することを要求します。TXN-50036のみを引用する- $15.00の提案は、その行の純額が- $164.00であるため依然として不合格です。
highでは、Claudeは決済代行の行をペイアウト単位とfee_centsでグループ化し、内部チェックを再実行しました。次のノートでは手数料行を12,586セントに集計。紛争の手数料を加えて14,086セントになりました。Rivermarkのチェックはこれを見落としていました。
最初の修正計画は借方のみを引用していたためこのルールに抵触。次は紛争の2行を引用し、PLAN-2が承認、ADJ-002で- $15.00(POL-4)が記録されました。
この実験はhighが必須だったことを示しません。同じ失敗点から、会話履歴とPythonメッセージは同一のまま、mediumで続けた別リプレイも手数料を見つけました。
メイン実行のhigh設定の6回は2,763トークン(thinking 607)を出力し$0.0484。別の対照群のmedium設定の6回は2,713トークン(thinking 628)で$0.0464(同じゲート却下を含む)。
最終レポートの1回を加えて対照群は7回、合計$0.0615。これらの呼び出しやコストはメインの15回・$0.1190には含まれません。
両経路は同じ失敗メッセージを受け、異なるのはeffortだけです。リプレイ1回でeffortの効果の大きさは測れませんが、この事例ではhighが必須ではなかったことは示せます。同じガイドでは、xhighやmaxは「評価で品質向上が示された場合」に限るとしています。highの選択も同様に検証してからにしてください。
最終検証では、意図的にゲートの2つのチェック(証拠と書き込み範囲)を繰り返します。ゲートは書き込み前に提案を審査し、最終検証はPythonが実際に書いた内容を検査してから、数値チェックと生ファイルのチェックを追加します。
ADJ-002の後、Pythonは生データ、承認済み調整、銀行合計からすべてを再計算しました。
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
4つすべて合格しました。調整後の期待支払額は$3,236.14で入金と一致。両調整は取得済みの行に遡及可能で、生のソースデータは不変、Pythonは承認済みエントリのみを書き込みました。
ここで初めてレポート工程に移ります。アプリケーションはeffortをmediumに戻すメッセージ、短いユーザーターン、ツールを入れ替えるシステムメッセージを追加します。
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
{"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])レポートは最終出力であり、証明そのものではありません。続く提案は引き続き人のレビューが必要です。以下の録画は、1つのStreamlitセッションにおける権限、effort、チェック、コストの流れを追ったものです。
Streamlitは照合の最初から追跡します。動画:著者
メインの照合はmediumからhighに移行し、15回のAPI呼び出しで$0.1190、所要70.0秒(API待機69.0秒を含む)。別の一致リプレイは含みません。各数値はレスポンスのusageとClaude Sonnet 5.5の料金から算出しています。
より広範なコスト内訳は、当サイトのClaude APIガイドでプロンプトキャッシュとバッチ処理を解説しています。
input_tokensはキャッシュのブレークポイント以降のみを数えるため、総入力は先述のプロンプトキャッシュドキュメントにある3つのフィールドの合計です。キャッシュの書き込み・読み込みにはそれぞれ料金があり、thinkingトークンはすでにoutput_tokensに含まれます。
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
この照合全体で、Claudeは118,308個の入力トークンのうち105,614個(約89%)をキャッシュから読み込み、未キャッシュ入力として課金されたのは636個のみでした。以下のグラフは4種のトークン料金を実測使用量に適用したものです。
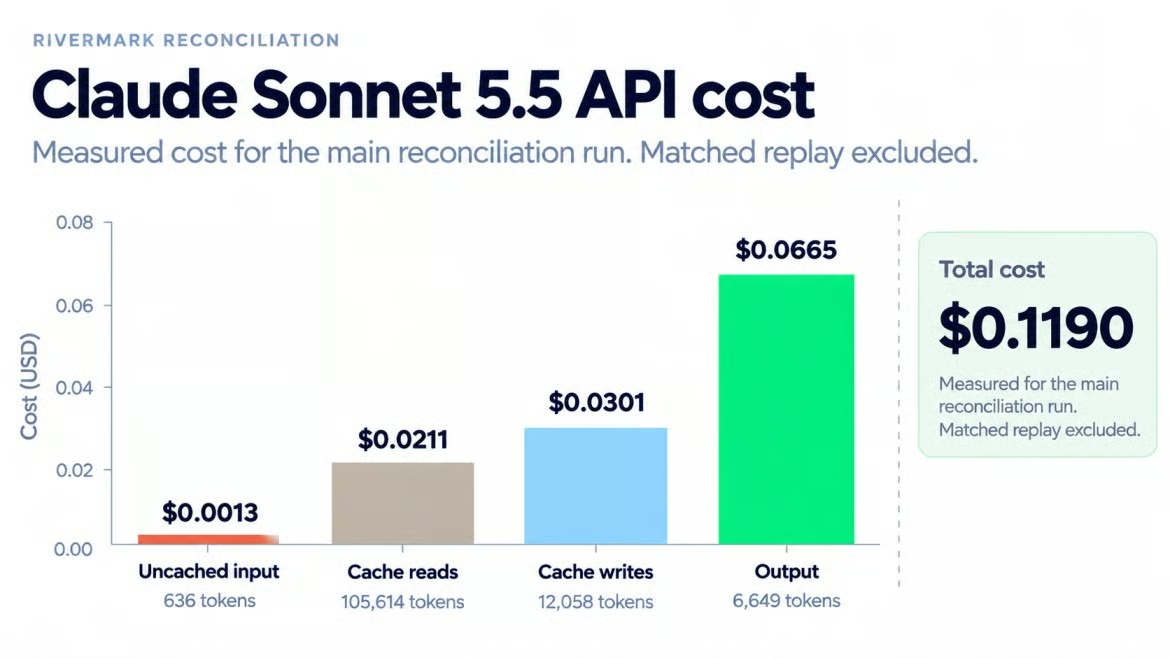
コストの大半は出力トークン。画像:著者
Rivermarkはローカルの調整記録に書き込むだけなので、本番の財務システムには次が必要です。
ローカルの架空データ。 実際のクローズには、認証、監査ログ、記帳の人的承認、データ保持の見直しが必要です。
ベータ機能。 メッセージ単位のeffort、ツール変更、thinking更新のヘッダは変更され得るため、デプロイ前に再テストしてください。
結果のばらつき。 Claude Sonnet 5.5は温度の非デフォルトを拒否するため、繰り返しでも結果が異なる可能性があります。運用前に自社データでこのパターンを検証してください。
読み取り専用ツールで調査し、Pythonが計画を承認した後にのみ1つの書き込みツールを付与し、銀行入金との独立チェックが通って初めて完了とする照合エージェントを構築しました。Claude Sonnet 5.5は誤計上の返金を自力で見つけましたが、すでに読んでいた$15.00の手数料に戻すには、検証失敗が必要でした。
架空の1か月を一般化するべきではありません。汎用的なのは方法論です。計画が通るまで書き込みツールを隠す、銀行記録はモデルの外に置く、修正ごとに取引の証拠を要求する、ツールやeffortの変更は追記してキャッシュを維持する、という点です。
独立チェックは、このプロジェクトの簡易版でも必ず残したい部分です。effort変更は、前述の理由から信頼を置く前にテストしたい部分です。
読み取りツールと最終チェックの入れ替えにより、同じパターンでデータクレンジング、サポート返金、管理されたドキュメント更新にも対応できます。最初の拡張としては、各調整の書き込み前に人による承認ステップを入れるのがよいでしょう。実務のクローズには必須です。
本構築で依拠したAnthropic APIの基礎を練習するには、当サイトのIntroduction to Claude Modelsコースをおすすめします。
DataCampでClaudeを学ぼう!
コース
コース
トラック