
Cours
Introduction aux modèles Claude
3 h
14.7K
Claude Sonnet 5.5 fait partie de la famille Claude 5.5 d’Anthropic. Il venait tout juste de sortir lorsque j’ai commencé ce projet, et son ID de modèle API est claude-sonnet-5-5. Selon l’aperçu du modèle, il offre une fenêtre de contexte d’1 million de jetons, jusqu’à 128 K jetons en sortie, une réflexion adaptative activée par défaut et un effort par défaut high sur l’API. La tarification standard est de 2 $ par million de jetons d’entrée et 10 $ par million de jetons de sortie.
Notre aperçu de Claude Sonnet 5.5 couvre les benchmarks, comparaisons de prix et modalités d’accès. Trois fonctionnalités API sont nouvelles dans cette version, et Rivermark les utilise toutes.
Claude Sonnet 5.5 ajoute trois manières de faire évoluer une conversation en cours. D’après What’s new in Claude Sonnet 5.5, aucune n’est disponible sur Claude Sonnet 5 :
L’agent Rivermark est une application Python construite autour d’une conversation unique via la Messages API, avec deux niveaux d’autorisations. Pendant l’enquête, Claude peut lire les commandes, remboursements, transactions du prestataire, la politique de clôture et le contrôle de rapprochement de Rivermark. Après approbation, il ne peut enregistrer que les ajustements validés.
Rivermark utilise une boucle personnalisée avec la Messages API plutôt que le SDK Claude Agent, car le système d’approbation doit s’intercaler entre les appels d’outils de Claude et leur exécution.
Le code complet et les données d’exemple sont disponibles dans le référentiel GitHub de Rivermark.
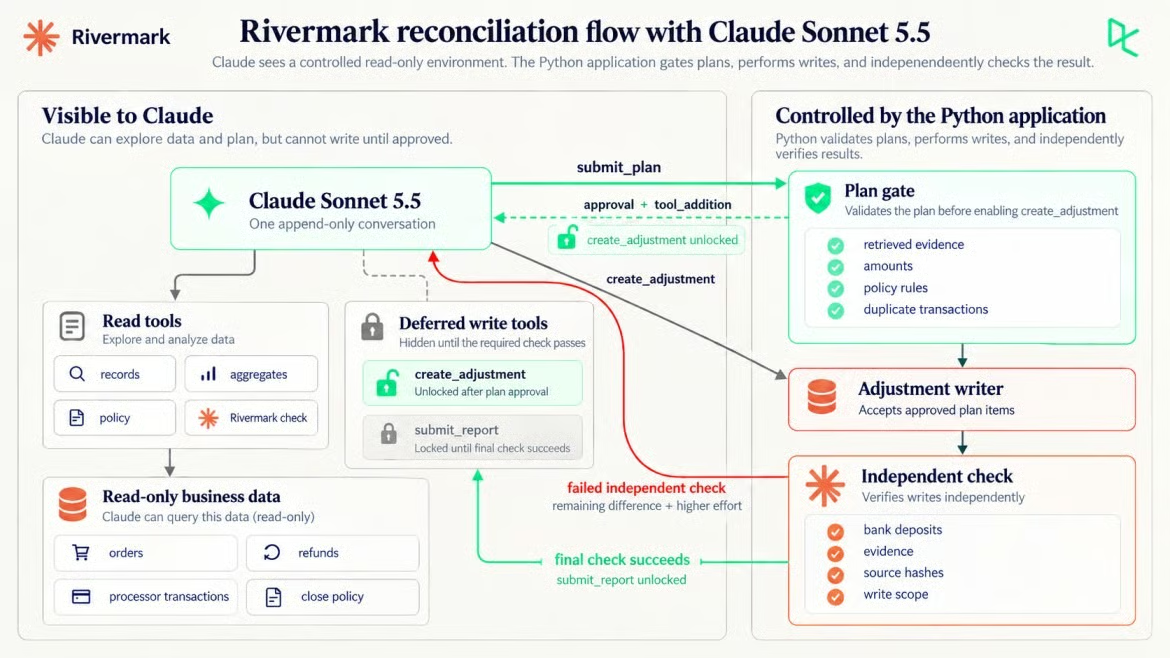
Claude propose, Python accorde l’accès en écriture. Image de l’auteur.
Le contrôle de Rivermark affiche 3 400,14 $ comme versement attendu et 3 251,14 $ comme total calculé du prestataire, soit un écart de 149,00 $. Claude doit expliquer l’écart entre les écritures sans connaître aucune des deux causes cachées.
Rivermark vend trois offres mensuelles : Starter à 29 $, Team à 79 $ et Business à 149 $. L’échantillon contient 58 commandes de septembre, 7 remboursements et 65 transactions du prestataire en septembre. Chaque écriture du prestataire comporte un montant, des frais et un net.
C’est Python, et non Claude, qui décide si le rapprochement est terminé :
Le mois est septembre 2026, selon la date de réglement du prestataire.
Le total des dépôts bancaires de septembre est la référence indépendante de réglement de l’expérience.
« Équilibré » signifie versement attendu plus ajustements égalent les dépôts, au centime près.
Chaque ajustement cite les txn_ids du prestataire que Claude a récupérés, et son montant égale leur net.
Claude ne peut qu’ajouter des ajustements approuvés et soumettre le rapport final.
Les exports bruts sont hachés avant traitement et doivent correspondre après.
Claude ne peut pas consulter les relevés bancaires ni le total cible lors de l’enquête initiale. Après un contrôle échoué, Python ne révèle que le versement attendu, le total agrégé des dépôts et l’écart restant, pas les relevés eux-mêmes.
Vous avez besoin de Python 3.10 ou plus récent, requis par le SDK Python, d’une clé API Anthropic, et de anthropic 1.9.0. Ces commandes PowerShell clonent le projet, créent l’environnement et génèrent les données d’exemple :
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Sur macOS ou Linux, utilisez source .venv/bin/activate et cp .env.example .env, puis placez votre clé dans .env. Notre guide sur les variables d’environnement explique le principe.
streamlit run app_streamlit.py ouvre une interface web qui montre chaque étape du rapprochement en temps réel, et notre tutoriel Streamlit présente l’installation.
Si votre clé API fonctionne déjà, passez la prochaine requête et allez directement à la réflexion adaptative.
Si les objets de requête et de réponse API vous sont nouveaux, notre guide sur les API en Python présente les bases. Une simple question sur un remboursement suffit à valider la clé et à examiner les blocs de contenu renvoyés :
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Lors de mon essai, la réponse commençait par un bloc thinking. Filtrez les blocs par type plutôt que de lire response.content[0] ; les jetons de réflexion sont facturés en sortie.
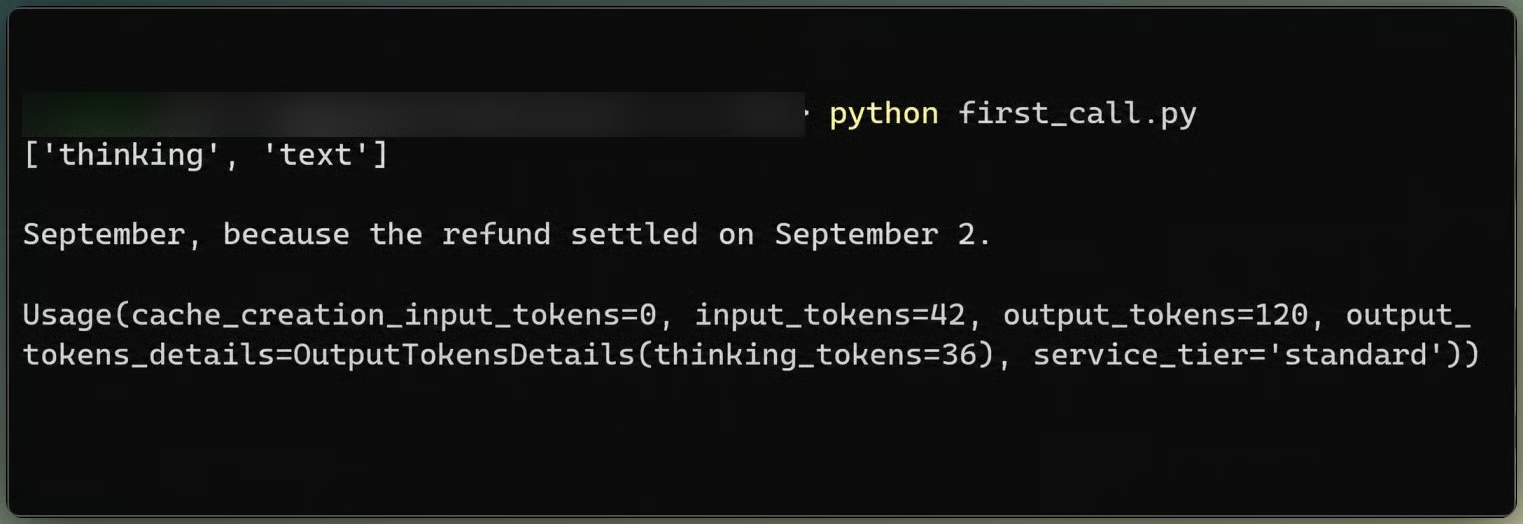
La première réponse sépare la réflexion du texte. Image de l’auteur.
Chaque requête envoie les mêmes paramètres de haut niveau, seul messages s’allonge :
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Malgré la valeur par défaut high de l’API, ce flux de travail démarre en medium. Le guide sur l’effort d’Anthropic indique : « Pour du code agentique et un usage d’outils en plusieurs étapes, commencez par medium pour les tâches bien spécifiées et passez à high pour les plus complexes ou longues. »
La réflexion reste adaptative car le changement d’effort, plus loin, en dépend. display: "updates" (bêta, thinking-display-updates-2026-08-18) renvoie les notes que Claude écrit entre les appels d’outils. Sans ce réglage, les blocs de réflexion sont vides.
Le cache_control de haut niveau active la mise en cache automatique des prompts, avec un point de rupture qui avance à mesure que la conversation grandit. La première requête a écrit 2 80 jetons dans le cache, bien au-dessus du minimum de 512 de Claude Sonnet 5.5.
Un agent d’enquête en lecture seule permet à Claude de demander des preuves sans exposer d’outil d’écriture. Rivermark rejette également toute écriture non approuvée dans Python.
Claude dispose de cinq outils de lecture et d’un outil de proposition, tous avec strict: true. Les descriptions indiquent ce que renvoie chaque outil, sans conseiller où chercher :
list_sources renvoie les sources, colonnes et nombres de lignes.
query_records renvoie jusqu’à 40 lignes d’une source, avec un filtre et une période optionnels.
aggregate_records compte les lignes et totalise amount_cents par colonne.
read_policy renvoie la politique de clôture.
run_reconciliation_check exécute la logique interne existante de Rivermark, bogues inclus.
submit_plan envoie un diagnostic et des ajustements proposés à Python pour validation, sans rien écrire.
Deux autres outils figurent dans le même tableau tools, mais defer_loading: true les maintient invisibles pour l’instant. Nous verrons plus tard comment ils apparaissent :
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Le schéma de l’outil d’écriture est connu dès la première requête, donc l’outil est déclaré d’emblée. Un choix d’outil nommé ou any renvoie une erreur 400 ; le prompt précise donc quand submit_plan s’applique.
Notre guide d’ingénierie du harnais d’agent explique comment Python peut gérer des boucles d’agent plus longues. La boucle de Rivermark envoie la conversation, exécute en Python les blocs tool_use et ajoute les résultats. Chaque identifiant de ligne renvoyé par un outil de lecture est ajouté à un ensemble observed que le sas de validation (gate) contrôlera ensuite :
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Le tour de l’assistant est renvoyé tel quel, blocs de réflexion vides compris. Le guide de migration explique que Claude Sonnet 5.5 lie les blocs de réflexion aux messages précédents, si bien que modifier cet historique peut renvoyer une erreur 400.
Avec medium, l’enquête a nécessité six appels API et neuf appels d’outils de lecture. Claude a extrait les remboursements et regroupé les écritures du prestataire par reporting_category. Il a trouvé RF-1043, un remboursement de 149,00 $ pour une commande du 31 août, réglé le 2 septembre. La règle POL-3 l’impute à septembre.
Ensuite, il a ouvert les deux écritures de litige. TXN-50036 contient un montant principal de -149,00 $, un frais de 15,00 $ et un effet net de trésorerie de -164,00 $. TXN-50052 comptabilise le retour du principal de 149,00 $ sans frais. Claude a écrit : « DSP-0077 s’annule à zéro et son frais de 15 $ est déjà correctement enregistré, donc RF-1043 explique totalement l’écart. »
Claude a confondu le principal retourné avec l’effet net en trésorerie après frais :
Le sas a rejeté le premier plan de Claude car il citait la commande ORD-20813 sans l’avoir récupérée. Claude a extrait la commande, a réémis, et PLAN-1 a été accepté avec un ajustement.
Avant d’exposer l’outil d’écriture, le sas vérifie l’origine des preuves et ce que le plan changerait.
Chaque ajustement d’un plan cite des txn_id du prestataire. Il n’est accepté que si chaque ligne citée provient d’un outil de lecture de cette conversation et si le net des lignes correspond au montant proposé :
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Un ajustement de 15,00 $ qui ne cite que le débit de litige échoue, car le net de cette ligne est de -164,00 $. Le plan doit aussi citer la contrepassation.
Le sas contrôle aussi les règles de politique et les doublons. Un plan est rejeté, et l’écriture reste verrouillée, si l’un de ses éléments :
Les rejets sont renvoyés comme résultat de l’outil submit_plan, ce qui permet à Claude de poursuivre l’enquête et de soumettre à nouveau. Le sas a rejeté 2 soumissions sur 4, et Claude a corrigé à chaque appel suivant. Même après approbation, create_adjustment n’accepte que des écritures correspondant exactement à un élément approuvé.
Une fois le plan approuvé, Python ajoute un message role: "system" avec un bloc tool_addition. Le changement nécessite l’en-tête bêta inline-tools-2026-09-15. Le tableau tools et tous les messages précédents restent inchangés, donc le préfixe en cache correspond toujours. Le texte d’instruction vient de Python, pas de Claude :
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Un message système avec du contenu doit suivre un tour user, y compris s’il ne contient que des blocs tool_result. Il ne peut pas s’intercaler entre un bloc tool_use et son résultat. Les messages système sont prioritaires : n’y insérez jamais le texte du plan de Claude, ni des sorties d’outils ou des données. Le bloc tool_addition fait référence à create_adjustment, et l’outil ne devient visible qu’après approbation du plan.
Le cache a continué de fonctionner après l’ajout d’outil. La requête a traité 231 jetons d’entrée non mis en cache et en a lu 6 883 depuis le cache.
Le premier ajustement était correct mais n’a pas soldé le rapprochement. Claude a enregistré ADJ-001, -149,00 $ selon POL-3, puis a conclu que c’était terminé. Le contrôle interne de Rivermark aurait également affiché une variance de 0,00 $. Cela semble bouclé, mais ce ne l’était pas.
Le contrôle indépendant Python se compare aux dépôts bancaires. Le versement attendu après ajustements était de 3 251,14 $, les dépôts de 3 236,14 $, et il restait 15,00 $.
C’est la raison pour laquelle la validation finale vit dans Python, pas dans le dernier message de Claude.
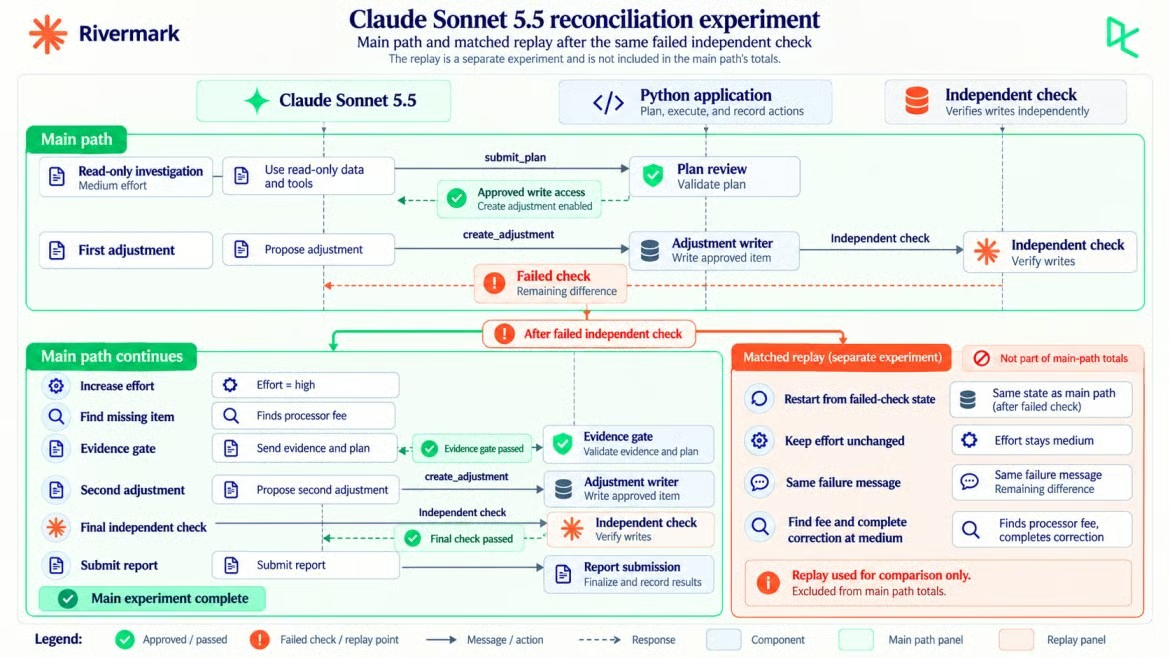
La relecture corrélée bifurque à partir de la vérification échouée. Image de l’auteur.
Changer l’effort en cours de conversation avec Claude Sonnet 5.5 consiste à ajouter un message système au content vide et un nouveau output_config.effort. Le nouveau niveau s’applique à partir du prochain tour user, et tout l’historique avant reste en cache.
L’effort par message est en bêta et nécessite l’en-tête mid-conversation-output-config-2026-07-01. Il exige aussi la réflexion adaptative : avec between_tools, le même changement renvoie une erreur 400. Quand le contrôle indépendant échoue, Python ajoute le nouvel effort avant le prochain message utilisateur :
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Un changement d’effort au niveau global redémarrerait le cache, car il modifie le préfixe du prompt. La version par message ne l’a pas fait : la première requête à effort élevé a lu 8 12 jetons depuis le cache et n’en a traité que 4 non mis en cache.
L’écart de 15,00 $ donne une cible à Claude, mais pas de preuve pour une correction. Le sas exige toujours des identifiants de transactions récupérés par Claude, et leurs net_cents doivent totaliser -15,00 $. Une proposition de -15,00 $ ne citant que TXN-50036 échoue encore, car le net de cette ligne est -164,00 $.
Avec high, Claude a regroupé les lignes du prestataire par versement et par fee_cents, puis a relancé le contrôle interne. Sa note suivante a porté les lignes de frais à 12 586 cents. Le frais du litige a porté ce total à 14 86 cents. Le contrôle de Rivermark l’avait omis.
Son premier plan amendé a buté sur cette règle car il ne citait que le débit. Le suivant a cité les deux lignes de litige, PLAN-2 a été accepté et ADJ-002 a enregistré -15,00 $ selon POL-4.
Cette expérience ne prouve pas que high était nécessaire. Une relecture séparée a repris au même point d’échec, avec le même historique de conversation et le même message Python, mais est restée à medium ; elle a aussi trouvé le frais.
Les six appels à high du run principal ont produit 2 763 jetons de sortie (dont 607 de réflexion) pour un coût de 0,0484 $. Le contrôle séparé, à medium, a produit 2 713 jetons de sortie (628 de réflexion) pour 0,0464 $, y compris le même rejet du sas.
Un dernier appel de rapport a porté le contrôle à 7 appels et 0,0615 $ au total. Aucun de ces appels ni de ces coûts n’est inclus dans les 15 appels et 0,1190 $ du run principal.
Les deux chemins ont reçu le même message d’échec de vérification ; seul l’effort différait. Une unique relecture ne permet pas de mesurer l’ampleur de l’effet de l’effort, mais elle montre que high n’était pas indispensable ici. Le même guide réserve xhigh et max aux cas où « vos évaluations montrent un gain de qualité ». Testez high de la même manière avant de l’adopter.
La vérification finale répète volontairement 2 contrôles du sas : preuves et périmètre d’écriture. Le sas évalue une proposition avant écriture ; la vérification finale inspecte ce que Python a effectivement écrit, puis ajoute les contrôles de chiffres et de fichiers bruts.
Après ADJ-002, Python a tout recalculé à partir des données brutes, des ajustements approuvés et du total bancaire :
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Les quatre ont réussi. Le versement attendu après ajustements était de 3 236,14 $, conforme aux dépôts. Les deux ajustements étaient reliés à des lignes récupérées, les données sources brutes n’avaient pas changé, et Python n’a écrit que les écritures approuvées.
Ce n’est qu’après que l’étape de rapport commence. L’application ajoute un message qui ramène l’effort à medium, un court tour utilisateur et un message système qui échange les outils :
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Le rapport est la dernière sortie, pas la preuve. Ses recommandations restent à valider par un humain. L’enregistrement ci-dessous suit autorisations, effort, contrôles et coûts lors d’une session Streamlit.
Streamlit suit le rapprochement depuis le départ. Vidéo de l’auteur.
Le rapprochement principal est passé de medium à high, a coûté 0,1190 $ sur 15 appels API et pris 70,0 secondes, dont 69,0 secondes d’attente de l’API. La relecture corrélée séparée n’est pas incluse. Chaque chiffre provient de usage dans les réponses et des tarifs de Claude Sonnet 5.5.
Pour un détail de coûts plus large, notre guide de l’API Claude traite de la mise en cache des prompts et du traitement par lots.
input_tokens ne compte que ce qui vient après le point de rupture du cache ; l’entrée totale est donc la somme de trois champs, comme l’expliquent les documents de mise en cache liés plus haut. Les écritures et lectures de cache ont leurs propres tarifs, et les jetons de réflexion sont déjà inclus dans output_tokens :
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Sur l’ensemble du rapprochement, Claude a lu 105 614 des 118 308 jetons d’entrée depuis le cache (environ 89 %), et seuls 636 ont été facturés comme entrée non mise en cache. Le graphique applique les quatre tarifs de jetons à l’usage mesuré.
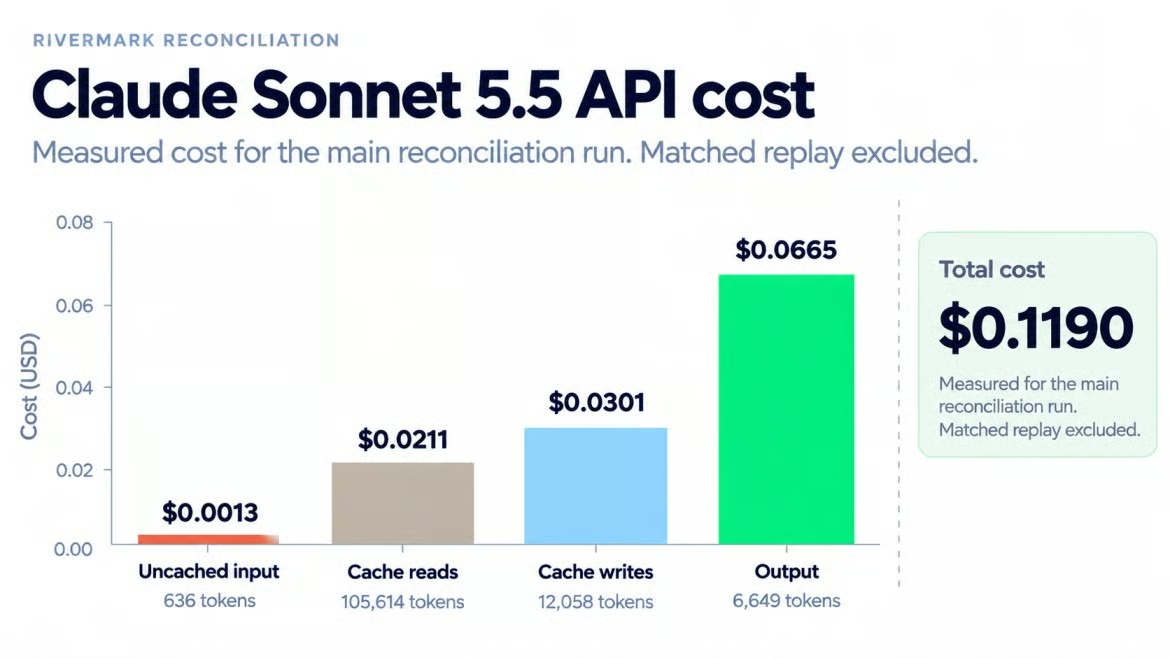
Les jetons de sortie dominent le coût mesuré. Image de l’auteur.
Rivermark écrit des ajustements en local ; un système financier de production aura encore besoin :
Données locales et fictives. Une vraie clôture exige authentification, journaux d’audit, validation humaine des écritures et revue de rétention des données.
Fonctionnalités en bêta. Les en-têtes pour l’effort par message, les changements d’outils et les mises à jour de réflexion peuvent évoluer ; refaites des tests avant le déploiement.
Résultats variables. Claude Sonnet 5.5 refuse une température non par défaut, les tentatives répétées peuvent donc différer. Testez le schéma sur vos propres données avant d’en dépendre.
Nous avons construit un agent de rapprochement qui mène l’enquête avec des outils en lecture seule, n’obtient un unique outil d’écriture qu’après approbation de son plan par Python et ne termine que lorsque le contrôle indépendant contre les dépôts bancaires réussit. Claude Sonnet 5.5 a trouvé de lui-même le remboursement mal imputé, mais il a fallu l’échec du contrôle pour le renvoyer vers le frais de 15,00 $ qu’il avait déjà lu.
Je n’étendrais pas un mois fictif à toute clôture. Ce qui se généralise, c’est la méthode : cacher l’outil d’écriture jusqu’à validation du plan, garder les relevés bancaires hors du modèle, exiger des preuves de transaction pour chaque correction et ajouter les changements d’outil ou d’effort de façon à préserver le cache.
Le contrôle indépendant est la partie à conserver même dans une version plus légère de ce projet. Le changement d’effort est la partie à tester avant de s’y fier, pour les raisons détaillées plus haut.
En intervertissant les outils de lecture et le contrôle final, le même schéma peut gérer des corrections de nettoyage de données, des remboursements support ou des mises à jour de documents contrôlées. Ma première extension serait une validation humaine avant chaque écriture d’ajustement, car une vraie clôture l’exige.
Pour vous entraîner aux bases de l’API Anthropic sur lesquelles repose cette réalisation, je vous recommande notre cours Introduction to Claude Models.
Apprenez à utiliser Claude avec DataCamp !
Cours
Cours
Cursus