Kurs
Introduktion till Claude-modeller
3 tim
14.7K
Claude Sonnet 5.5 ingår i Anthropics Claude 5.5-familj. Den hade precis släppts när jag startade det här projektet, och dess API-modell-ID är claude-sonnet-5-5. Enligt modellöversikten har den ett kontextfönster på 1 miljon token, upp till 128 000 utdata-token, adaptivt tänkande på som standard och en standardeffort high på API:et. Standard-prissättningen är $2 per miljon inmatningstoken och $10 per miljon utdata-token.
Vår översikt av Claude Sonnet 5.5 täcker benchmarkresultat, prisjämförelser och åtkomst. Tre av dess API-funktioner är nya i denna version, och Rivermark använder alla tre.
Claude Sonnet 5.5 lägger till tre sätt att förändra en konversation under körning. Enligt Vad är nytt i Claude Sonnet 5.5 finns ingen av dem på Claude Sonnet 5:
Rivermark-agenten är en Python-applikation byggd runt en Messages API-konversation med två behörighetsnivåer. Under undersökningen kan Claude läsa order, återbetalningar, inlösartransaktioner, stängningspolicy och Rivermarks avstämningskontroll. Efter godkännande kan den bara registrera de godkända justeringarna.
Rivermark använder en anpassad Messages API-loop i stället för Claude Agent SDK eftersom godkännandespärren måste ligga mellan Claudes verktygsanrop och deras exekvering.
Den kompletta koden och exempeldatan finns i Rivermarks GitHub-repo.
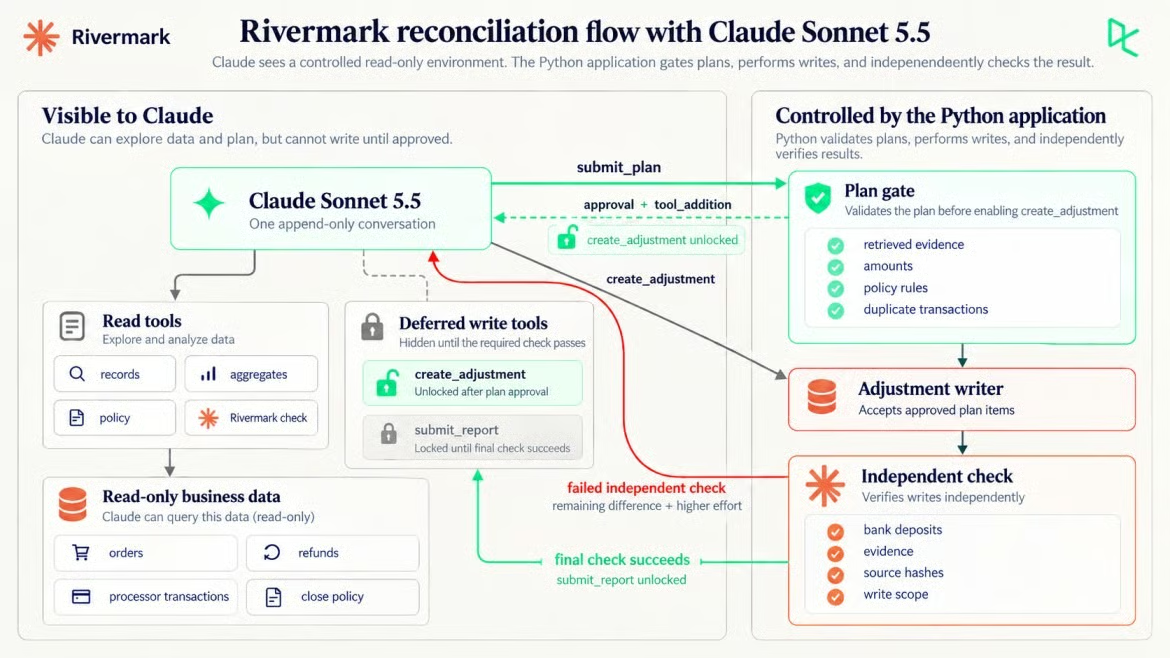
Claude föreslår, Python beviljar skrivåtkomst. Bild av författaren.
Rivermarks kontroll rapporterar $3 400,14 som förväntad utbetalning och $3 251,14 som beräknad inlösartotal, en differens på $149,00. Claude måste förklara skillnaden mellan posterna utan att se någon av de dolda orsakerna.
Rivermark säljer tre månadsplaner: Starter för $29, Team för $79 och Business för $149. Exemplet innehåller 58 septemberorder, 7 återbetalningsposter och 65 septembertransaktioner hos inlösaren. Varje inlösarpost har ett belopp, en avgift och ett nettovärde.
Python, inte Claude, avgör om avstämningen är klar:
Månaden är september 2026, enligt inlösarens avräkningsdatum.
Summan av september månads bankinsättningar är experimentets oberoende avräkningsmål.
Balans betyder att förväntad utbetalning plus justeringar exakt motsvarar dessa insättningar på centen.
Varje justering anger inlösarens txn_ids som Claude hämtade, och dess belopp motsvarar deras nettobelopp.
Claude kan bara lägga till godkända justeringar och lämna in slutrapporten.
Råexporter hash:as före bearbetning och måste matcha efteråt.
Claude kan inte inspektera bankuppgifterna eller målsumman under den initiala undersökningen. Efter ett misslyckat test visar Python bara förväntad utbetalning, total insättning och kvarvarande differens, inte själva bankuppgifterna.
Du behöver Python 3.10 eller senare, vilket Python-SDK:t kräver, en Anthropic API-nyckel och anthropic 1.9.0. Dessa PowerShell-kommandon klonar projektet, skapar miljön och bygger exempeldatan:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
På macOS eller Linux, använd source .venv/bin/activate och cp .env.example .env, lägg sedan in din nyckel i .env. Vår guide om miljövariabler förklarar mönstret.
streamlit run app_streamlit.py öppnar ett webbgränssnitt som visar varje steg i avstämningen i realtid, och vår Streamlit-handledning går igenom installationen.
Om din API-nyckel redan fungerar, hoppa över nästa anrop och gå vidare till adaptivt tänkande.
Om API-begäranden och -svar är nya för dig täcker vår Python API-guide grunderna. En enda fråga om en återbetalning räcker för att bekräfta nyckeln och inspektera de returnerade innehållsblocken:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
I min körning började svaret med ett thinking-block. Välj block efter type i stället för att läsa response.content[0]; thinking-token debiteras som utdata.
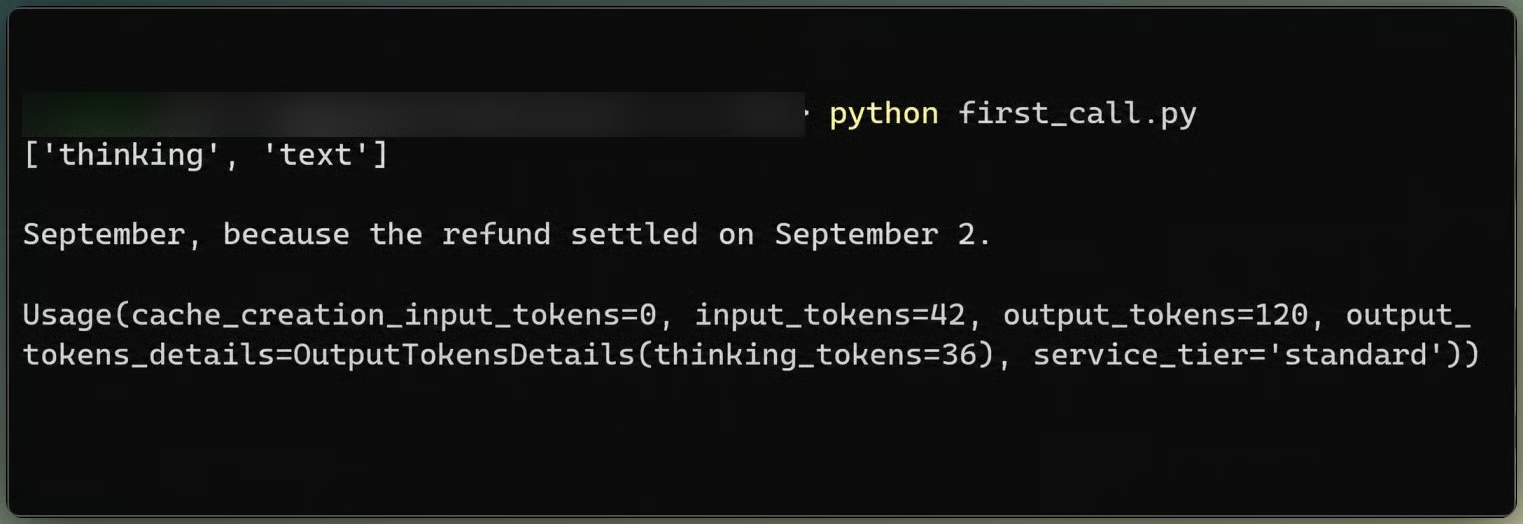
Första svaret separerar thinking från text. Bild av författaren.
Varje begäran skickar samma toppnivåinställningar, och bara messages växer:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Trots API:ets standardvärde high startar detta arbetsflöde på medium. Anthropics effort-guide säger: ”För agentiskt kodande och flerstegs verktygsanvändning, börja med medium för väl specificerade uppgifter och gå till high för svårare eller längre sådana.”
Thinking förblir adaptivt eftersom effort-ändringen senare i bygget beror på det. display: "updates" (beta, thinking-display-updates-2026-08-18) returnerar de anteckningar Claude skriver mellan verktygsanropen. Utan den inställningen är thinking-blocken tomma.
Toppnivå-cache_control slår på automatisk promptcache, med en brytpunkt som flyttas framåt när konversationen växer. Den första begäran skrev 2 080 token till cache, klart över Claude Sonnet 5.5:s miniminivå på 512 token.
En skrivskyddad undersökningsagent låter Claude begära bevis men exponerar inget skrivverktyg. Rivermark avvisar också icke godkända skrivanrop i Python.
Claude får fem läsverktyg och ett förslagsverktyg, alla med strict: true. Beskrivningarna säger vad varje verktyg returnerar och inget om var man ska leta:
list_sources returnerar källor, kolumner och antal rader.
query_records returnerar upp till 40 rader från en källa, med valfritt filter och datumintervall.
aggregate_records räknar rader och summerar amount_cents efter valfri kolumn.
read_policy returnerar stängningspolicyn.
run_reconciliation_check kör Rivermarks befintliga interna logik, inklusive buggar.
submit_plan skickar en diagnos och föreslagna justeringar till Python för validering och skriver ingenting.
Ytterligare två verktyg ligger i samma tools-array, men defer_loading: true håller dem utom synhåll för Claude just nu. Vi återkommer till hur de dyker upp senare:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Skrivverktygets schema är känt vid första begäran, så verktyget deklareras från början. Namngivet eller any verktygsval returnerar ett 400-fel, så prompten anger när submit_plan gäller.
Vår guide till agent-harness engineering förklarar hur Python kan hantera längre agentloopar. Rivermarks loop skickar konversationen, kör alla tool_use-block i Python och lägger till resultaten. Varje post-ID som ett läsverktyg returnerar hamnar i en observed-mängd som planspärren kontrollerar senare:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Assistentens tur går tillbaka exakt som mottagen, tomma thinking-block inkluderade. Migrationsguiden förklarar att Claude Sonnet 5.5 binder thinking-block till de tidigare meddelandena, så att redigera den historiken kan ge ett 400-fel.
På medium tog undersökningen sex API-anrop och nio läsvertygsanrop. Claude hämtade återbetalningarna och grupperade inlösarraderna efter reporting_category. Den hittade RF-1043, en återbetalning på $149,00 för en order 31 augusti som avräknades 2 september. Policyn POL-3 placerar den i september.
Sedan öppnade den båda tvistraderna. TXN-50036 innehåller ett -$149,00 huvudbelopp, en avgift på $15,00 och en nettokasseffekt på -$164,00. TXN-50052 återför $149,00 i huvudbelopp utan avgift. Claude skrev: ”DSP-0077 blir netto noll och dess $15-avgift är redan korrekt bokförd, så RF-1043 förklarar helt avvikelsen.”
Claude hade förväxlat återfört huvudbelopp med kasseffekten efter avgifter:
Spärren avvisade Claudes första plan eftersom den angav order ORD-20813 utan att hämta den. Claude hämtade ordern, skickade in igen och PLAN-1 gick igenom med en justering.
Innan skrivverktyget exponeras kontrollerar spärren var bevisen kom ifrån och vad planen skulle ändra.
Varje justering i en plan anger inlösarens txn_id:er. Spärren godtar den bara om varje angiven rad kom tillbaka från ett läsverktyg i den här konversationen och raderna summerar till det föreslagna beloppet:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
En justering på $15,00 som bara anger debetposten för tvisten misslyckas eftersom den radens netto är -$164,00. Planen måste ange återföringen också.
Spärren kontrollerar också policys och dubbletter. En plan avvisas, och skrivåtkomst förblir låst, om något objekt gör något av följande:
Avslag returneras som resultatet från verktyget submit_plan, så Claude kan undersöka vidare och skicka in igen. Spärren avvisade 2 av 4 inlämningar, och Claude rättade varje vid nästa anrop. Även efter godkännande godtar create_adjustment endast poster som exakt matchar ett godkänt objekt.
När spärren godkänner en plan lägger Python till ett role: "system"-meddelande med ett tool_addition-block. Ändringen kräver betarubriken inline-tools-2026-09-15. tools-arrayen och varje tidigare meddelande förblir oförändrade, så den cachade prefixet matchar fortfarande. Instruktionstexten kommer från Python, inte från Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Ett systemmeddelande med innehåll måste följa på en user-vända, inklusive en med tool_result-block. Det kan inte ligga mellan ett tool_use-block och dess resultat. Systemmeddelanden har högre prioritet, så sätt aldrig in Claudes plantext, verktygsutdata eller data i ett sådant. tool_addition-blocket namnger create_adjustment via referens, och verktyget blir synligt först efter att planen passerat.
Cachelagringen fortsatte efter verktygsbytet. Begäran bearbetade 231 icke-cachade inmatningstoken och läste 6 883 från cache.
Den första justeringen var korrekt men lämnade ändå arbetet ofärdigt. Claude registrerade ADJ-001, -$149,00 under POL-3, och rapporterade att den var klar. Rivermarks interna kontroll skulle ha hållit med och visat en avvikelse på $0,00. Det låter färdigt, men är det inte.
Den oberoende Python-kontrollen jämför i stället mot bankinsättningar. Förväntad utbetalning efter justeringar var $3 251,14, insättningarna var $3 236,14 och $15,00 återstod.
Det gapet är skälet till att slutförandekontrollen ligger i Python, inte i Claudes sista meddelande.
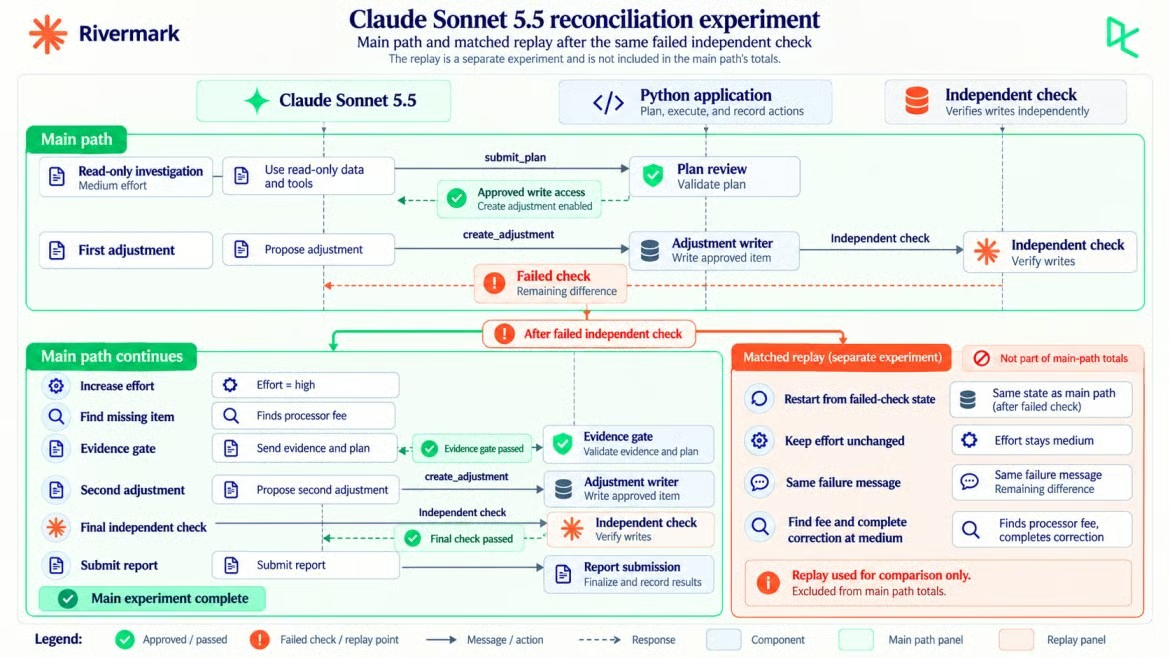
Matchad uppspelning förgrenar sig från misslyckad verifiering. Bild av författaren.
Att ändra effort mitt i konversationen på Claude Sonnet 5.5 innebär att lägga till ett systemmeddelande med tomt content och en ny output_config.effort. Den nya nivån gäller från nästa user-vända, och allt före den förblir cachat.
Effort per meddelande är i beta och kräver rubriken mid-conversation-output-config-2026-07-01. Det kräver också adaptivt tänkande: med between_tools ger samma ändring ett 400-fel. När den oberoende kontrollen misslyckas lägger Python till den nya effort-inställningen före nästa användarmeddelande:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
En förändring av effort på toppnivå skulle starta cachen från början, eftersom effort på toppnivå ingår i den cachade prompten. Formen per meddelande gjorde det inte: den första begäran med hög effort läste 8 012 token från cache och bearbetade 4 icke-cachade.
Skillnaden på $15,00 ger Claude ett mål, men inte bevis för en korrigering. Spärren kräver fortfarande transaktions-ID:n som Claude hämtade, och deras net_cents måste summera till -$15,00. En föreslagen justering på -$15,00 som bara anger TXN-50036 misslyckas fortfarande eftersom den radens netto är -$164,00.
På hög grupperade Claude inlösarraderna per utbetalning och efter fee_cents, och körde sedan om den interna kontrollen. Dess nästa notering lade avgiftsraderna till 12 586 cent. Tvisteavgiften höjde den summan till 14 086 cent. Rivermarks kontroll hade lämnat den utanför.
Dess första ändrade plan stötte på regeln eftersom den bara angav debetposten. Nästa angav båda tvistraderna, PLAN-2 passerade, och ADJ-002 registrerade -$15,00 under POL-4.
Detta experiment visar inte att high var nödvändigt. En separat uppspelning fortsatte från samma felpunkt med samma konversationshistorik och Python-meddelande, men låg kvar på medium; den hittade avgiften också.
Huvudkörningens sex anrop med high-effort gav 2 763 utdata-token (607 thinking) och kostade $0,0484. Den separata kontrollens sex medium-anrop för undersökningen gav 2 713 utdata-token (628 thinking) och kostade $0,0464, inklusive samma spärravslag.
Ett sista rapportanrop tog kontrollen till 7 anrop och $0,0615 totalt. Inga av de anropen eller kostnaderna ingår i huvudkörningens 15 anrop och $0,1190.
Båda vägarna fick samma misslyckade kontrollmeddelande; endast deras effort skilde sig. En uppspelning kan inte mäta storleken på någon effort-effekt, men den visar att high inte var nödvändig i just detta fall. Samma effort-guide reserverar xhigh och max för fall där ”dina utvärderingar visar en kvalitetsvinst”. Testa high på samma sätt innan du väljer det.
Slutlig verifiering upprepar med avsikt två spärrkontroller: bevis och skrivomfång. Spärren granskar ett förslag före skrivning; slutverifieringen inspekterar vad Python faktiskt skrev, och lägger sedan till tal- och råfilskontrollerna.
Efter ADJ-002 räknade Python om allt från råposter, godkända justeringar och banksumman:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Alla fyra passerade. Förväntad utbetalning efter justeringar var $3 236,14, vilket matchade insättningarna. Båda justeringarna spårades till hämtade rader, råkälldata förblev oförändrade och Python skrev bara de godkända posterna.
Först därefter startar rapportsteget. Applikationen lägger till ett meddelande som ställer tillbaka effort till medium, en kort användarvända och ett systemmeddelande som byter verktyg:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Rapporten är sista utdata, inte beviset. Dess uppföljningsförslag kräver fortfarande mänsklig granskning. Inspelningen nedan följer behörigheter, effort, kontroller och kostnad genom en Streamlit-session.
Streamlit följer avstämningen från start. Video av författaren.
Huvudavstämningen gick från medium till high, kostade $0,1190 över 15 API-anrop och tog 70,0 sekunder, varav 69,0 sekunder väntan på API:et. Den separata matchade uppspelningen ingår inte. Varje siffra kommer från svarets usage och Claude Sonnet 5.5:s priser.
För en bredare kostnadsuppdelning täcker vår Claude API-guide promptcache och batchbearbetning.
input_tokens räknar bara det som kom efter cache-brytpunkten, så total inmatning är summan av tre fält, som promptcache-dokumentationen förklarar. Cache-skrivningar och -läsningar har egna priser, och thinking-token ingår redan i output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Under hela avstämningen läste Claude 105 614 av 118 308 inmatningstoken från cache (cirka 89%), och bara 636 debiterades som icke-cachad inmatning. Diagrammet tillämpar de fyra token-priserna på den uppmätta användningen.
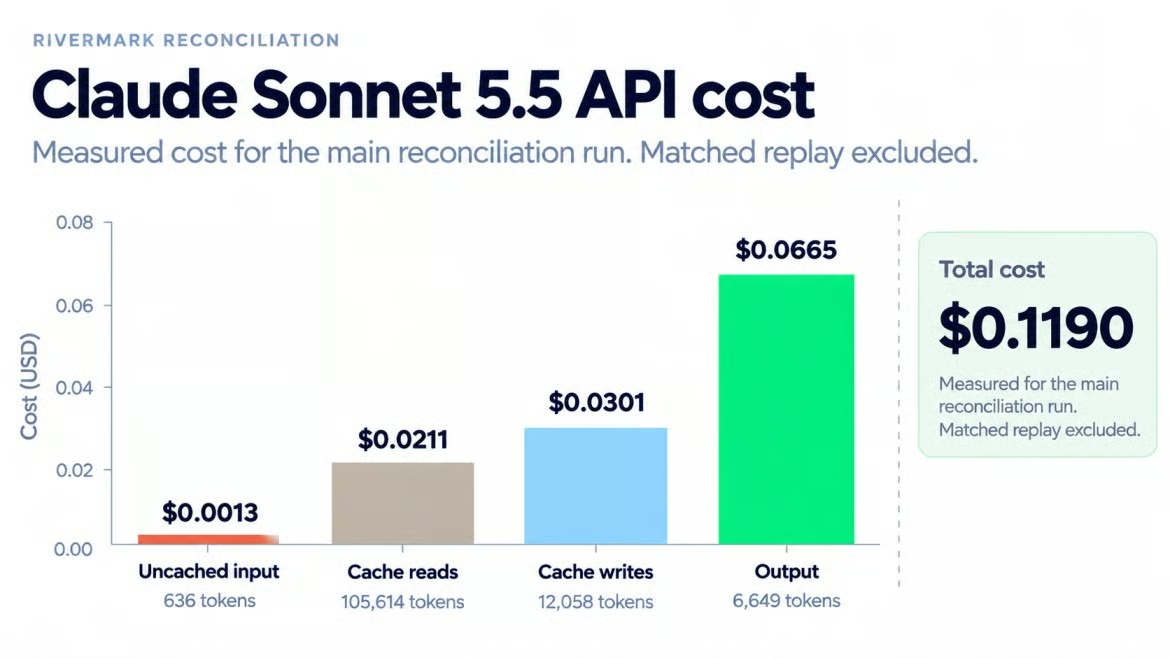
Utdata-token dominerar den uppmätta kostnaden. Bild av författaren.
Rivermark skriver lokala justeringsposter, så ett produktionssystem för ekonomi behöver fortfarande:
Lokal, fiktiv data. En riktig månadsstängning kräver autentisering, revisionsloggar, mänskligt godkännande av bokningar och en granskning av datalagring.
Beta-funktioner. Rubrikerna för effort per meddelande, verktygsändringar och thinking-uppdateringar kan ändras, så testa dem igen före driftsättning.
Varierande resultat. Claude Sonnet 5.5 avvisar icke-standardtemperatur, så upprepade försök kan skilja sig. Testa mönstret på din egen data innan du förlitar dig på det.
Vi byggde en avstämningsagent som undersöker med skrivskyddade verktyg, får ett skrivverktyg först efter att Python godkänner dess plan, och blir klar först när en oberoende kontroll mot bankinsättningar passerar. Claude Sonnet 5.5 hittade den felplacerade återbetalningen på egen hand, men det krävdes den misslyckade kontrollen för att skicka tillbaka den till avgiften på $15,00 som den redan hade läst.
Jag skulle inte generalisera en fiktiv månad till varje stängning. Det som bär över är metoden: dölj skrivverktyget tills en plan passerar, håll bankuppgifterna utanför modellen, kräv transaktionsbevis för varje korrigering och lägg till verktygs- eller effort-ändringar så att cachen överlever.
Den oberoende kontrollen är den del jag skulle behålla även i en mindre version av det här projektet. Effort-ändringen är den del jag skulle testa innan jag litar på den, av skälet som täcks i avsnittet om effort.
Att byta läsverktygen och slutkontrollen låter samma mönster hantera datastädning, supportåterbetalningar eller kontrollerade dokumentuppdateringar. Min första utökning vore ett mänskligt godkännandesteg före varje skriven justering, eftersom en riktig stängning kräver ett sådant.
För att öva grunderna i Anthropic API som detta bygge förlitar sig på, rekommenderar jag vår kurs Introduction to Claude Models.
Lär dig använda Claude med DataCamp!
Kurs
Kurs
Lärstig