Курс
Введение в модели Claude
3 ч
14.7K
Claude Sonnet 5.5 — часть семейства Claude 5.5 от Anthropic. Когда начинался этот проект, он только что вышел, а его идентификатор модели в API — claude-sonnet-5-5. Согласно обзору модели, у неё контекстное окно на 1 млн токенов, до 128K выходных токенов, адаптивное мышление по умолчанию и дефолтная степень усилий high в API. Стандартное ценообразование — $2 за миллион входных токенов и $10 за миллион выходных.
Наш обзор Claude Sonnet 5.5 охватывает бенчмарки, сравнение цен и доступ. Три функции API в этом релизе — новые, и Rivermark использует все три.
Claude Sonnet 5.5 добавляет три способа менять беседу во время её выполнения. Согласно странице Что нового в Claude Sonnet 5.5, ни одна из них недоступна в Claude Sonnet 5:
Агент Rivermark — это приложение на Python вокруг одной беседы Messages API с двумя уровнями прав. Во время расследования Claude может читать заказы, возвраты, транзакции процессора, политику закрытия и проверку сверки Rivermark. После одобрения он может записывать только одобренные корректировки.
Rivermark использует собственный цикл Messages API вместо Claude Agent SDK, потому что шлюз одобрения должен стоять между вызовами инструментов Claude и их выполнением.
Полный код и пример данных — в репозитории Rivermark на GitHub.
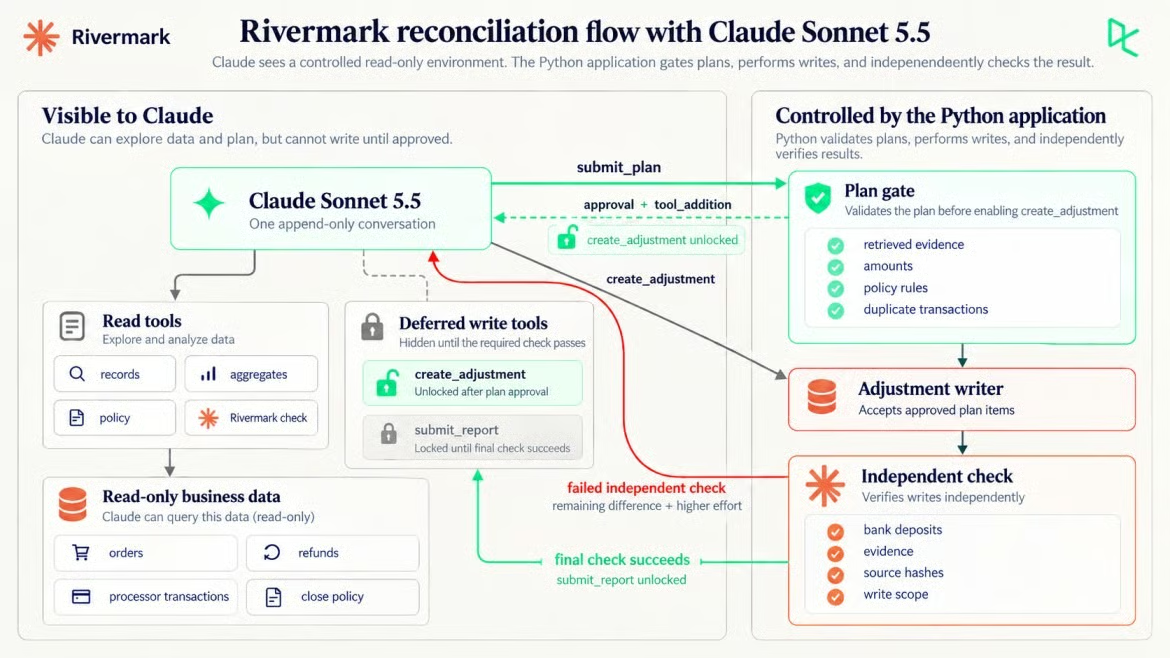
Claude предлагает, Python даёт доступ на запись. Изображение автора.
Проверка Rivermark сообщает $3 400.14 как ожидаемую выплату и $3 251.14 как рассчитанную сумму процессора — разница $149.00. Claude должен объяснить расхождение между записями, не видя ни одной из скрытых причин.
Rivermark продаёт три месячных плана: Starter за $29, Team за $79 и Business за $149. В выборке — 58 сентябрьских заказов, 7 записей о возвратах и 65 сентябрьских транзакций процессора. В каждой записи процессора есть сумма, комиссия и чистый эффект.
Решение о завершении принимает Python, а не Claude:
Месяц — сентябрь 2026 года, по дате расчёта процессора.
Сумма сентябрьских банковских депозитов — независимая целевая величина для расчёта.
Баланс соблюдён, если ожидаемая выплата плюс корректировки равны депозитам до цента.
Каждая корректировка ссылается на txn_ids процессора, которые Claude получил, и её сумма равна их чистому значению.
Claude может только добавлять одобренные корректировки и отправлять финальный отчёт.
Необработанные выгрузки хешируются до обработки и должны совпасть после неё.
Claude не может просматривать банковские записи или целевую сумму на этапе начального расследования. После неудачной проверки Python раскрывает только ожидаемую выплату, суммарный объём депозитов и оставшуюся разницу, но не сами банковские записи.
Вам нужен Python 3.10 или новее, который требует Python SDK, ключ Anthropic API и anthropic 1.9.0. Эти команды PowerShell клонируют проект, создают окружение и собирают пример данных:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
В macOS или Linux используйте source .venv/bin/activate и cp .env.example .env, затем поместите ключ в .env. Наша инструкция по переменным окружения объясняет подход.
streamlit run app_streamlit.py открывает веб‑интерфейс, который показывает каждый шаг сверки по мере выполнения, а наша инструкция по Streamlit описывает настройку.
Если ваш API‑ключ уже работает, пропустите следующий запрос и переходите к адаптивному мышлению.
Если объекты запросов и ответов API для вас новы, наша инструкция по Python API покрывает основы. Одного вопроса по возврату достаточно, чтобы подтвердить ключ и изучить возвращаемые блоки контента:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
В моём запуске ответ начинался с блока thinking. Выбирайте блоки по type вместо чтения response.content[0]; токены мышления тарифицируются как выход.
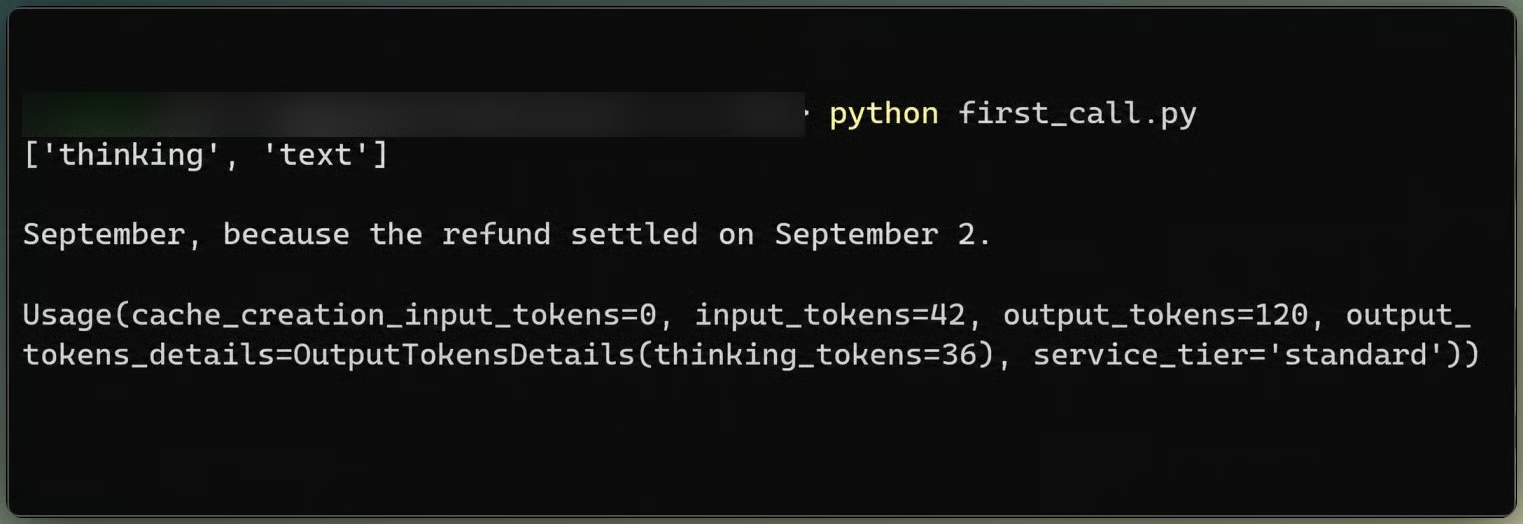
Первый ответ разделяет мышление и текст. Изображение автора.
Каждый запрос отправляет одни и те же настройки верхнего уровня, меняется только messages — он растёт:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Несмотря на дефолт high в API, этот рабочий процесс стартует с medium. В руководстве Anthropic по усилиям сказано: «Для агентного кода и многошагового использования инструментов начинайте с medium для чётко определённых задач и переходите к high для более сложных или длинных.»
Мышление остаётся адаптивным, потому что дальнейшая смена усилий от него зависит. display: "updates" (бета, thinking-display-updates-2026-08-18) возвращает заметки, которые Claude пишет между вызовами инструментов. Без этой настройки блоки мышления пустые.
Параметр верхнего уровня cache_control включает автоматическое кэширование подсказки с точкой останова, которая сдвигается вперёд по мере роста беседы. Первый запрос записал в кэш 2 080 токенов, что заметно выше минимальных 512 токенов Claude Sonnet 5.5.
Агент расследования «только для чтения» позволяет Claude запрашивать доказательства, но не даёт инструментов записи. Rivermark также отклоняет несанкционированные вызовы записи в Python.
Claude получает пять инструментов чтения и один инструмент для предложений, у всех стоит strict: true. Описания говорят только о том, что возвращает каждый инструмент, и ничего — о том, где искать:
list_sources возвращает источники, столбцы и количество строк.
query_records возвращает до 40 строк из одного источника с необязательным фильтром и диапазоном дат.
aggregate_records считает строки и суммирует amount_cents по любому столбцу.
read_policy возвращает политику закрытия.
run_reconciliation_check запускает текущую внутреннюю логику сверки Rivermark, включая существующие ошибки.
submit_plan отправляет диагноз и предложенные корректировки в Python для проверки и ничего не записывает.
Ещё два инструмента находятся в том же массиве tools, но defer_loading: true скрывает их от Claude на данном этапе. Как они появятся — разберём позже:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Схема инструмента записи известна уже в первом запросе, поэтому инструмент объявляется заранее. Выбор по имени или any вернёт ошибку 400, поэтому в подсказке указано, когда применять submit_plan.
Наше руководство по инженерии каркаса агента объясняет, как Python может управлять длинными циклами агента. Цикл Rivermark отправляет беседу, выполняет блоки tool_use в Python и добавляет результаты. Каждый ID записи, который возвращает инструмент чтения, попадает в множество observed, которое затем проверит шлюз плана:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Ход помощника возвращается ровно как получен, включая пустые блоки мышления. В руководстве по миграции объясняется, что Claude Sonnet 5.5 привязывает блоки мышления к предыдущим сообщениям, поэтому правка этой истории может вернуть ошибку 400.
На medium расследование заняло шесть вызовов API и девять вызовов инструментов чтения. Claude выгрузил возвраты и сгруппировал строки процессора по reporting_category. Он нашёл RF-1043 — возврат $149.00 по заказу от 31 августа, рассчитанный 2 сентября. Правило политики POL-3 относит его к сентябрю.
Затем он открыл обе строки спора. TXN-50036 содержит основную сумму -$149.00, комиссию $15.00 и чистый денежный эффект -$164.00. TXN-50052 возвращает основной платёж $149.00 без комиссии. Claude написал: «DSP-0077 в сумме даёт ноль, а комиссия $15 уже корректно учтена, значит RF-1043 полностью объясняет расхождение.»
Claude перепутал возвращённую основную сумму с денежным эффектом после комиссий:
Шлюз отклонил первый план Claude, потому что он ссылался на заказ ORD-20813, не будучи полученным. Claude получил заказ, отправил заново, и PLAN-1 прошёл с одной корректировкой.
Перед тем как открыть инструмент записи, шлюз проверяет происхождение доказательств и что именно изменит план.
Каждая корректировка в плане ссылается на txn_id процессора. Шлюз принимает её только если каждая указанная строка пришла от инструмента чтения в этой беседе и их сумма по нетто равна предлагаемой:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Корректировка на $15.00, ссылающаяся только на дебет по спору, провалится, потому что чистая сумма по этой строке — -$164.00. План должен ссылаться и на реверс.
Шлюз также проверяет правила политики и дубликаты транзакций. План отклоняется, и доступ на запись остаётся закрытым, если любой элемент делает что‑то из этого:
Отказы возвращаются как результат инструмента submit_plan, поэтому Claude может продолжить расследование и отправить заново. Шлюз отклонил 2 из 4 отправок, и Claude исправлял каждую в следующем вызове. Даже после одобрения create_adjustment принимает только записи, которые в точности соответствуют одобренному пункту.
Когда шлюз одобряет план, Python добавляет сообщение с role: "system" и блоком tool_addition. Для изменения нужен бета‑заголовок inline-tools-2026-09-15. Массив tools и все предыдущие сообщения не меняются, поэтому кэшированный префикс по‑прежнему совпадает. Текст инструкции приходит из Python, а не от Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Системное сообщение с контентом должно следовать за ходом user, включая тот, где есть блоки tool_result. Оно не может стоять между блоком tool_use и его результатом. Системные сообщения имеют более высокий приоритет, поэтому никогда не вставляйте в них текст плана Claude, вывод инструментов или данные. Блок tool_addition называет create_adjustment по ссылке, и инструмент становится видим только после успешного плана.
Кэширование продолжилось после смены инструмента. Запрос обработал 231 некэшированный входной токен и прочитал 6 883 из кэша.
Первая корректировка была правильной, но задача всё равно оставалась незавершённой. Claude записал ADJ-001, -$149.00 по POL-3, и сообщил о завершении. Внутренняя проверка Rivermark согласилась бы, показав расхождение $0.00. Звучит как финал, но это не так.
Независимая проверка Python сравнивает с банковскими депозитами. Ожидаемая выплата после корректировок — $3 251.14, депозиты — $3 236.14, оставалось $15.00.
Из‑за этого разрыва проверка выполнения находится в Python, а не в финальном сообщении Claude.
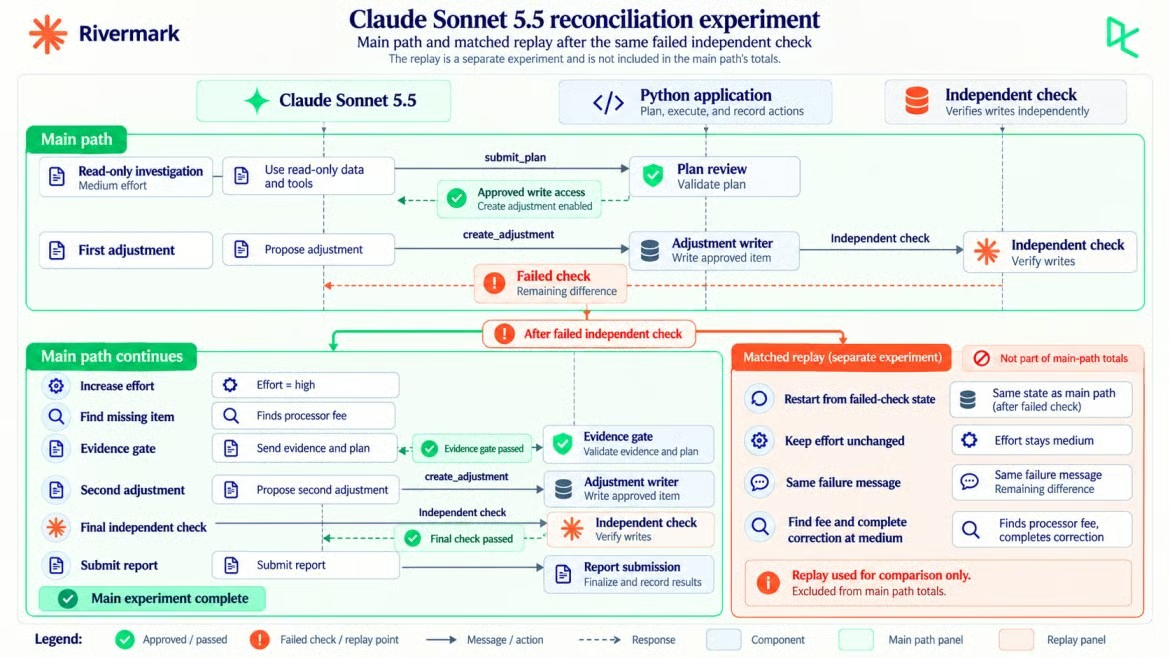
Согласованный повтор ответвляется от неудачной верификации. Изображение автора.
Смена усилий посреди беседы в Claude Sonnet 5.5 означает добавление системного сообщения с пустым content и новым output_config.effort. Новый уровень применяется со следующего хода user, и всё ранее остаётся в кэше.
Усилия на сообщение — в бете и требуют заголовок mid-conversation-output-config-2026-07-01. Также нужно адаптивное мышление: при between_tools такая же смена вернёт ошибку 400. Когда независимая проверка проваливается, Python добавляет новое значение усилий перед следующим сообщением пользователя:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Смена усилий на верхнем уровне перезапустит кэш, так как верхнеуровневые усилия — часть кэшируемого префикса подсказки. Форма «на сообщение» этого не делает: первый запрос с high прочитал 8 012 токенов из кэша и обработал 4 некэшированных.
Разница в $15.00 даёт Claude цель, но не доказательства для корректировки. Шлюз всё равно требует ID транзакций, которые Claude получил, и их net_cents должны в сумме давать -$15.00. Предложенная корректировка -$15.00, ссылающаяся только на TXN-50036, по‑прежнему провалится, потому что чистая сумма по этой строке — -$164.00.
На high Claude сгруппировал строки процессора по выплатам и по fee_cents, затем заново запустил внутреннюю проверку. В следующей заметке он добавил комиссионные строки до 12 586 центов. Комиссия по спору подняла итог до 14 086 центов. Проверка Rivermark её пропустила.
Его первый исправленный план наткнулся на это правило, потому что ссылался только на дебет. Следующий указал обе строки спора, PLAN-2 прошёл, и ADJ-002 записал -$15.00 по POL-4.
Этот эксперимент не показывает, что high был необходим. Отдельный повтор продолжил с той же точки сбоя с тем же ходом беседы и сообщением от Python, но остался на medium; он тоже нашёл комиссию.
Шесть вызовов с high в основном прогоне дали 2 763 выходных токена (607 thinking) и стоили $0.0484. Шесть вызовов с medium в отдельном контроле дали 2 713 выходных токенов (628 thinking) и стоили $0.0464, включая то же отклонение шлюзом.
Один финальный вызов отчёта довёл контроль до 7 вызовов и $0.0615 итого. Ни эти вызовы, ни их стоимость не входят в 15 вызовов и $0.1190 основного прогона.
Обе ветки получили одно и то же сообщение о неудачной проверке; различались только усилия. Один повтор не может измерить величину эффекта, но показывает, что high не был необходим в этом случае. То же руководство по усилиям оставляет xhigh и max для случаев, когда «ваши оценки показывают прирост качества». Тестируйте high так же, прежде чем выбирать.
Финальная верификация намеренно повторяет 2 проверки шлюза: доказательства и область записи. Шлюз проверяет предложение до записи; финальная верификация инспектирует то, что фактически записал Python, затем добавляет числовую проверку и проверку исходных файлов.
После ADJ-002 Python пересчитал всё по исходным данным, одобренным корректировкам и банковской сумме:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Все четыре прошли. Ожидаемая выплата после корректировок составила $3 236.14 и совпала с депозитами. Обе корректировки восходят к полученным строкам, исходные данные остались без изменений, а Python записал только одобренные записи.
Только затем начинается этап отчёта. Приложение добавляет сообщение, возвращающее усилия к medium, короткий ход пользователя и системное сообщение, которое меняет инструменты:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Отчёт — это последний вывод, а не доказательство. Его дальнейшие рекомендации всё ещё требуют человеческого просмотра. Запись ниже следует за правами, усилиями, проверками и стоимостью в одном сеансе Streamlit.
Streamlit отслеживает сверку с самого начала. Видео автора.
Основная сверка перешла с medium на high, стоила $0.1190 за 15 вызовов API и заняла 70,0 секунд, из них 69,0 секунд — ожидание API. Отдельный согласованный повтор не включён. Все цифры взяты из usage ответа и ставок Claude Sonnet 5.5.
Для более широкого разборa затрат наш гайд по Claude API рассказывает о кэшировании подсказок и пакетной обработке.
input_tokens считает только то, что пришло после точки останова кэша, поэтому общий вход — сумма трёх полей, как объясняется в документации по кэшированию подсказок выше. Запись и чтение кэша тарифицируются по своим ставкам, а токены мышления уже входят в output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
За время сверки Claude прочитал 105 614 из 118 308 входных токенов из кэша (около 89%), и только 636 были тарифицированы как некэшированный вход. Диаграмма применяет четыре ставки токенов к измеренному использованию.
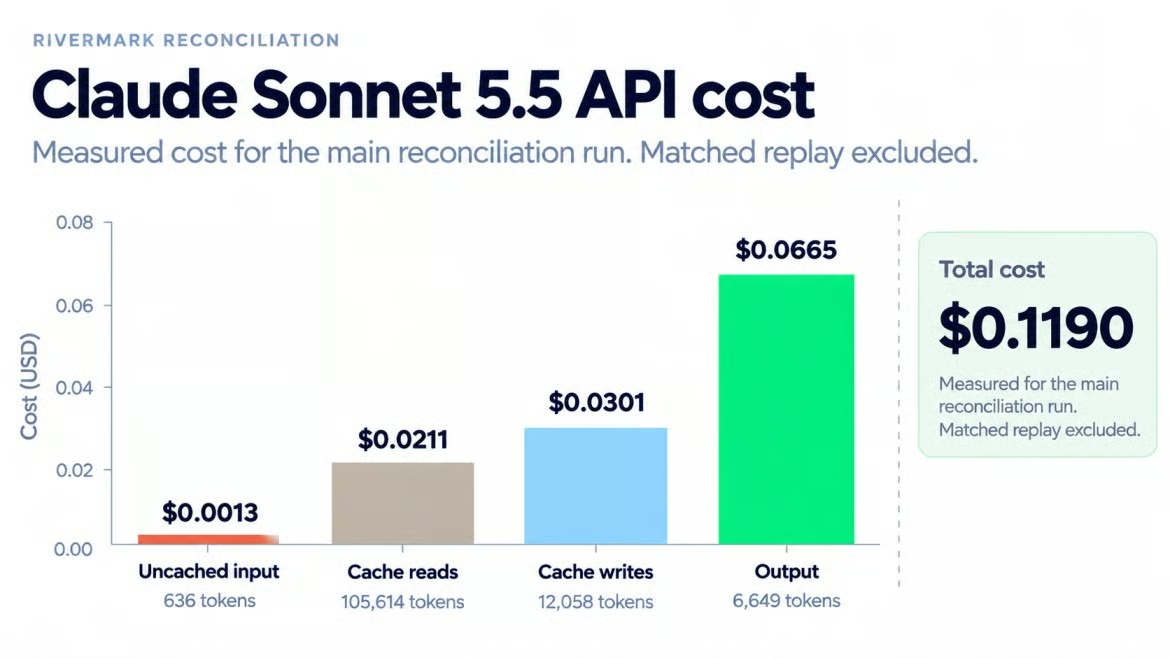
Выходные токены доминируют в измеренной стоимости. Изображение автора.
Rivermark записывает локальные корректировки, поэтому продакшен‑система для финансов по‑прежнему нуждается в следующем:
Локальные, вымышленные данные. Реальное закрытие требует аутентификации, журналов аудита, человеческого одобрения проводок и пересмотра политики хранения данных.
Бета‑функции. Заголовки для усилий на сообщение, смены инструментов и обновлений мышления могут измениться, поэтому перед развёртыванием тестируйте их заново.
Переменные результаты. Claude Sonnet 5.5 отклоняет не дефолтную температуру, поэтому повторные попытки могут различаться. Протестируйте схему на своих данных, прежде чем полагаться на неё.
Мы построили агента для сверки, который исследует с помощью инструментов только для чтения, получает один инструмент записи только после одобрения его плана Python и завершает работу, лишь когда независимая проверка по банковским депозитам проходит. Claude Sonnet 5.5 сам нашёл неправильно отнесённый возврат, но именно провальная проверка вернула его к комиссии $15.00, которую он уже видел.
Я бы не обобщал один вымышленный месяц на каждое закрытие. Что переносится — это метод: скрывайте инструмент записи до прохождения плана, держите банковские записи вне модели, требуйте доказательства транзакций для каждой правки и добавляйте изменения инструментов или усилий так, чтобы кэш сохранялся.
Независимая проверка — часть, которую стоило бы сохранить даже в упрощённой версии проекта. Смену усилий — часть, которую стоило бы протестировать прежде, чем доверять, по причинам из соответствующего раздела.
Подмена инструментов чтения и финальной проверки позволяет по той же схеме обрабатывать очистку данных, возвраты в поддержке или контролируемые обновления документов. Первым расширением стоило бы добавить шаг человеческого одобрения перед каждой записью корректировки, поскольку в реальном закрытии он нужен.
Чтобы потренироваться в основах Anthropic API, на которых держится эта сборка, рекомендуем наш курс Introduction to Claude Models.
Учитесь работать с Claude на DataCamp!
Курс
Курс
Трек