Curso
Introducción a los modelos Claude
3 h
14.7K
Claude Sonnet 5.5 forma parte de la familia Claude 5.5 de Anthropic. Acababa de lanzarse cuando empecé este proyecto, y su ID de modelo en la API es claude-sonnet-5-5. Según la visión general del modelo, tiene una ventana de contexto de 1M de tokens, hasta 128K tokens de salida, razonamiento adaptativo activado por defecto y un esfuerzo predeterminado high en la API. La tarifa estándar es de 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida.
Nuestro resumen de Claude Sonnet 5.5 cubre benchmarks, comparativas de precio y acceso. Tres de sus funciones de API son nuevas en este lanzamiento, y Rivermark las utiliza todas.
Claude Sonnet 5.5 añade tres formas de cambiar una conversación mientras se ejecuta. Según Novedades en Claude Sonnet 5.5, ninguna está disponible en Claude Sonnet 5:
El agente de Rivermark es una aplicación Python alrededor de una única conversación de la Messages API con dos niveles de permisos. Durante la investigación, Claude puede leer pedidos, reembolsos, transacciones del procesador, la política de cierre y la comprobación de conciliación de Rivermark. Tras la aprobación, solo puede registrar los ajustes aprobados.
Rivermark usa un bucle personalizado de la Messages API en lugar del Claude Agent SDK porque la compuerta de aprobación debe situarse entre las llamadas de herramientas de Claude y su ejecución.
El código completo y los datos de ejemplo están en el repositorio Rivermark en GitHub.
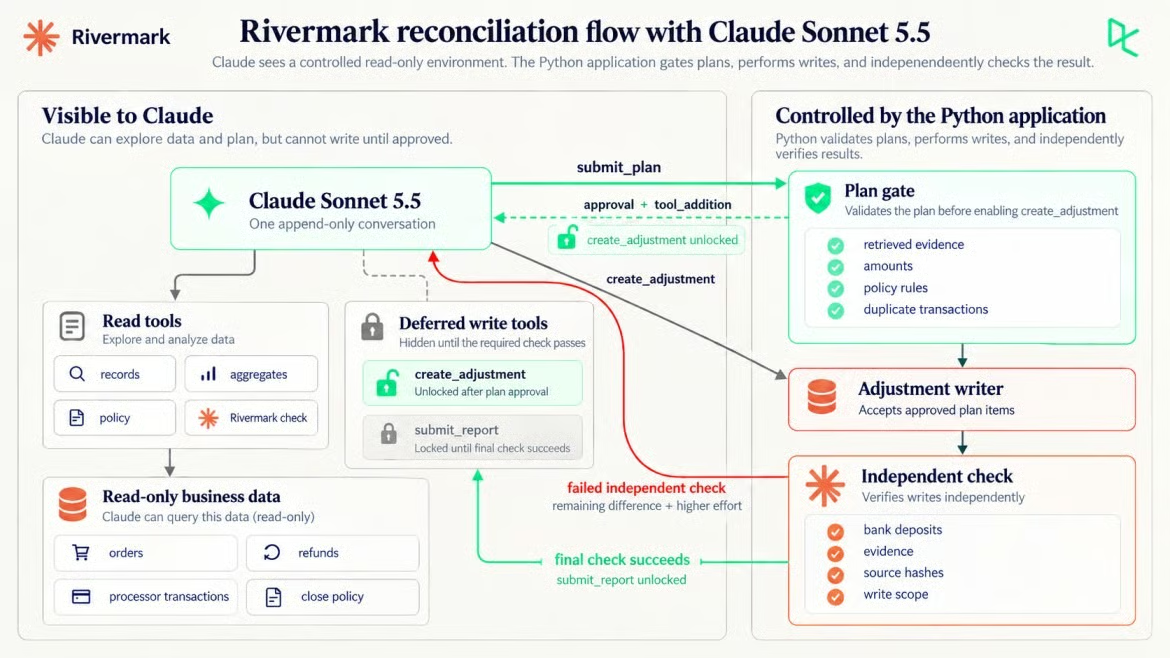
Claude propone; Python concede permiso de escritura. Imagen del autor.
La comprobación de Rivermark informa de 3.400,14 $ como pago esperado y 3.251,14 $ como total calculado del procesador, una diferencia de 149,00 $. Claude tiene que explicar la diferencia entre los registros sin ver ninguna de las causas ocultas.
Rivermark vende tres planes mensuales: Starter por 29 $, Team por 79 $ y Business por 149 $. La muestra contiene 58 pedidos de septiembre, 7 reembolsos y 65 transacciones del procesador de septiembre. Cada registro del procesador tiene un importe, una comisión y un valor neto.
Python, no Claude, decide si la conciliación está completa:
El mes es septiembre de 2026, por la fecha de liquidación del procesador.
El total de depósitos bancarios de septiembre es el objetivo de liquidación independiente del experimento.
Cuadrado significa que el pago esperado más los ajustes iguala esos depósitos al céntimo.
Cada ajuste cita los txn_ids del procesador que Claude recuperó, y su importe coincide con su neto.
Claude solo puede añadir ajustes aprobados y enviar el informe final.
Las exportaciones en bruto se hashean antes de procesar y deben coincidir después.
Claude no puede inspeccionar los registros bancarios ni el total objetivo durante su investigación inicial. Tras un fallo en la verificación, Python solo revela el pago esperado, el total agregado de depósitos y la diferencia restante, no los registros bancarios en sí.
Necesitas Python 3.10 o superior, que requiere el SDK de Python, una clave de la API de Anthropic y anthropic 1.9.0. Estos comandos de PowerShell clonan el proyecto, crean el entorno y generan los datos de ejemplo:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
En macOS o Linux, usa source .venv/bin/activate y cp .env.example .env, y luego introduce tu clave en .env. Nuestra guía de variables de entorno explica el patrón.
streamlit run app_streamlit.py abre una interfaz web que muestra cada paso de la conciliación en tiempo real, y nuestro tutorial de Streamlit cubre la configuración.
Si tu clave de API ya funciona, sáltate la próxima solicitud y pasa al razonamiento adaptativo.
Si las solicitudes y respuestas de API son nuevas para ti, nuestra guía de APIs en Python cubre lo básico. Una pregunta sencilla sobre un reembolso basta para confirmar la clave e inspeccionar los bloques de contenido devueltos:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
En mi ejecución, la respuesta empezó con un bloque thinking. Selecciona bloques por type en lugar de leer response.content[0]; los tokens de thinking se facturan como salida.
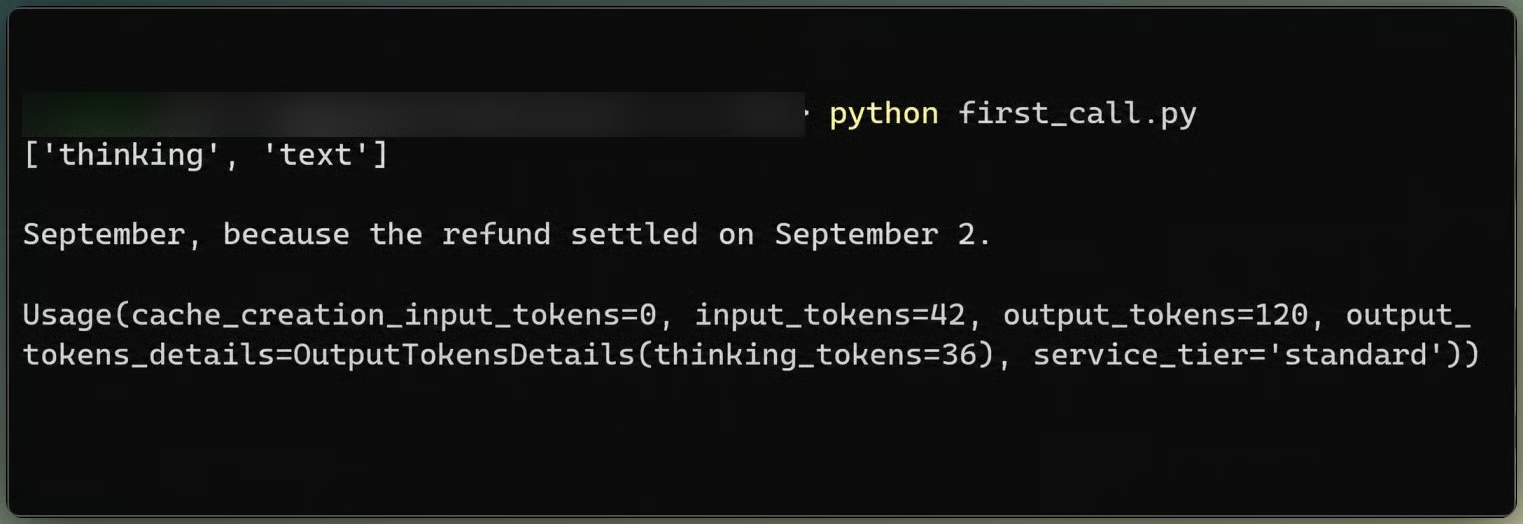
La primera respuesta separa el razonamiento del texto. Imagen del autor.
Cada solicitud envía los mismos ajustes de nivel superior, y solo messages crece:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
A pesar del valor por defecto high de la API, este flujo comienza en medium. La guía de esfuerzo de Anthropic dice: «Para codificación agéntica y uso de herramientas en varios pasos, empieza con medium en tareas bien definidas y sube a high para tareas más difíciles o largas.»
El razonamiento se mantiene adaptativo porque el cambio de esfuerzo más adelante depende de ello. display: "updates" (beta, thinking-display-updates-2026-08-18) devuelve las notas que escribe Claude entre llamadas a herramientas. Sin ese ajuste, los bloques de thinking están vacíos.
El cache_control de nivel superior activa la caché automática del prompt, con un punto de corte que avanza a medida que crece la conversación. La primera solicitud escribió 2.080 tokens en caché, muy por encima del mínimo de 512 tokens de Claude Sonnet 5.5.
Un agente de investigación de solo lectura permite que Claude solicite pruebas pero no expone ninguna herramienta de escritura. Rivermark también rechaza en Python las llamadas de escritura no aprobadas.
Claude recibe cinco herramientas de lectura y una de propuesta, todas con strict: true. Las descripciones dicen qué devuelve cada herramienta y nada sobre dónde buscar:
list_sources devuelve orígenes, columnas y recuentos de filas.
query_records devuelve hasta 40 filas de una fuente, con un filtro opcional y rango de fechas.
aggregate_records cuenta filas y totaliza amount_cents por cualquier columna.
read_policy devuelve la política de cierre.
run_reconciliation_check ejecuta la lógica interna existente de Rivermark, con sus errores incluidos.
submit_plan envía a Python un diagnóstico y los ajustes propuestos para su validación, sin escribir nada.
Hay dos herramientas más en el mismo array tools, pero defer_loading: true las mantiene fuera de la vista de Claude por ahora. Veremos después cómo aparecen:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
El esquema de la herramienta de escritura se conoce desde la primera solicitud, así que la herramienta se declara al principio. Elegir una herramienta con nombre o any devuelve un error 400, así que el prompt indica cuándo aplica submit_plan.
Nuestra guía de ingeniería del arnés de agentes explica cómo Python puede gestionar bucles de agente más largos. El bucle de Rivermark envía la conversación, ejecuta en Python los bloques tool_use y añade los resultados. Cada ID de registro que devuelve una herramienta de lectura entra en un conjunto observed que la compuerta de planes comprobará más tarde:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
El turno del asistente vuelve exactamente como se recibió, bloques de thinking vacíos incluidos. La guía de migración explica que Claude Sonnet 5.5 vincula los bloques de thinking a los mensajes anteriores, por lo que editar ese historial puede devolver un error 400.
Con esfuerzo medio, la investigación llevó seis llamadas a la API y nueve llamadas a herramientas de lectura. Claude extrajo los reembolsos y agrupó las líneas del procesador por reporting_category. Encontró RF-1043, un reembolso de 149,00 $ de un pedido del 31 de agosto liquidado el 2 de septiembre. La regla de política POL-3 lo asigna a septiembre.
Después abrió ambas filas de la disputa. TXN-50036 contiene un importe principal de -149,00 $, una comisión de 15,00 $ y un efecto de caja neto de -164,00 $. TXN-50052 devuelve los 149,00 $ de principal sin comisión. Claude escribió: «DSP-0077 netea a cero y su comisión de 15 $ ya está contabilizada correctamente, así que RF-1043 explica por completo la diferencia.»
Claude confundió el principal devuelto con el efecto de caja tras comisiones:
La compuerta rechazó el primer plan de Claude porque citaba el pedido ORD-20813 sin haberlo recuperado. Claude trajo el pedido, volvió a enviar y PLAN-1 pasó con un ajuste.
Antes de exponer la herramienta de escritura, la compuerta comprueba de dónde procede la evidencia y qué cambiaría el plan.
Cada ajuste de un plan cita los txn_id del procesador. La compuerta solo lo acepta si cada línea citada volvió desde una herramienta de lectura en esta conversación y si las líneas netean al importe propuesto:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Un ajuste de 15,00 $ que solo cita el cargo de la disputa falla porque el neto de esa línea es -164,00 $. El plan debe citar también la reversión.
La compuerta también comprueba reglas de política y transacciones duplicadas. Un plan se rechaza, y el acceso de escritura permanece bloqueado, si algún elemento hace lo siguiente:
Los rechazos se devuelven como resultado de la herramienta submit_plan, así que Claude puede seguir investigando y reenviar. La compuerta rechazó 2 de 4 envíos, y Claude corrigió cada uno en su siguiente llamada. Incluso tras la aprobación, create_adjustment solo acepta asientos que coincidan exactamente con un elemento aprobado.
Una vez que la compuerta aprueba un plan, Python añade un mensaje role: "system" con un bloque tool_addition. El cambio requiere el header beta inline-tools-2026-09-15. El array tools y todos los mensajes anteriores permanecen sin cambios, por lo que el prefijo en caché sigue coincidiendo. El texto de la instrucción viene de Python, no de Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Un mensaje de sistema con contenido debe seguir a un turno de user, incluso uno con bloques tool_result. No puede colocarse entre un bloque tool_use y su resultado. Los mensajes de sistema tienen mayor prioridad, así que nunca insertes en uno el texto del plan de Claude, la salida de herramientas o datos. El bloque tool_addition nombra create_adjustment por referencia, y la herramienta solo se hace visible después de que el plan pase.
La caché siguió funcionando tras el cambio de herramienta. La solicitud procesó 231 tokens de entrada no cacheados y leyó 6.883 desde la caché.
El primer ajuste era correcto y aun así dejó el trabajo sin terminar. Claude registró ADJ-001, -149,00 $ bajo POL-3, e informó que había acabado. La comprobación interna de Rivermark habría estado de acuerdo, mostrando una diferencia de 0,00 $. Suena a finalizado, pero no lo está.
La verificación independiente en Python compara contra los depósitos bancarios. El pago esperado tras los ajustes era 3.251,14 $, los depósitos fueron 3.236,14 $ y quedaban 15,00 $.
Esa diferencia es la razón por la que la comprobación de finalización vive en Python, no en el mensaje final de Claude.
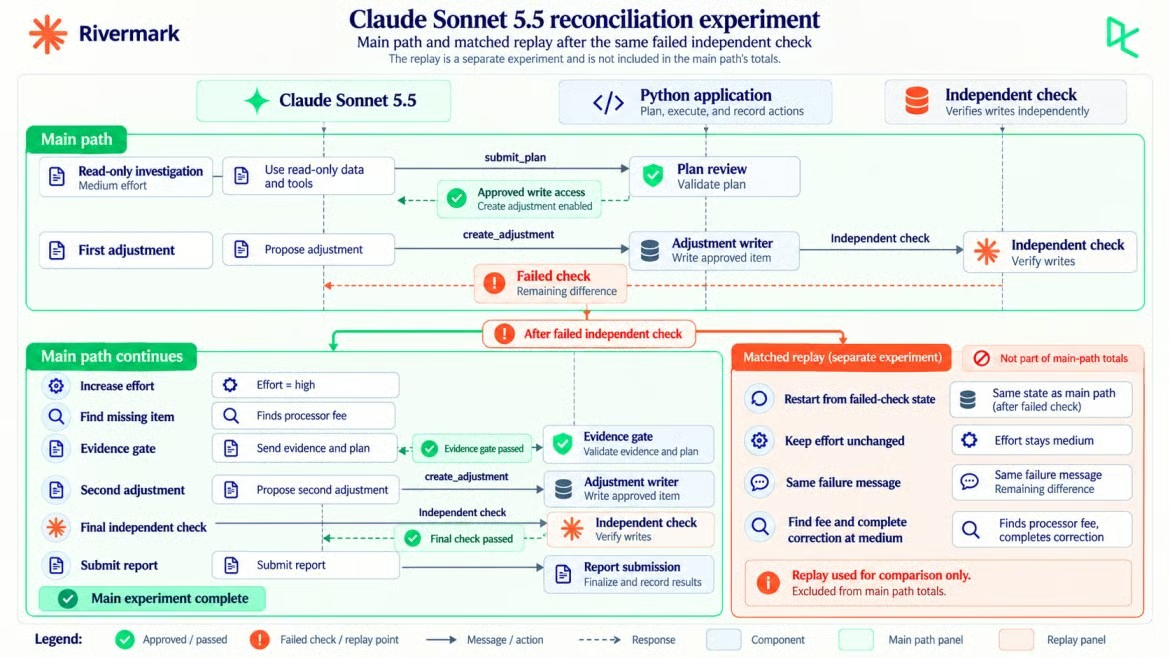
La reproducción paralela parte de la verificación fallida. Imagen del autor.
Cambiar el esfuerzo a mitad de conversación en Claude Sonnet 5.5 implica añadir un mensaje de sistema con content vacío y un nuevo output_config.effort. El nuevo nivel se aplica desde el siguiente turno de user, y todo lo anterior sigue en caché.
El esfuerzo por mensaje está en beta y necesita el header mid-conversation-output-config-2026-07-01. También requiere razonamiento adaptativo: con between_tools, el mismo cambio devuelve un error 400. Cuando falla la comprobación independiente, Python añade el nuevo ajuste de esfuerzo antes del siguiente mensaje de usuario:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Un cambio de esfuerzo de nivel superior reiniciaría la caché, ya que el esfuerzo de nivel superior forma parte del prompt cacheado. La forma por mensaje no lo hizo: la primera solicitud con esfuerzo alto leyó 8.012 tokens de la caché y procesó 4 sin caché.
La diferencia de 15,00 $ le da a Claude un objetivo, pero no evidencia para una corrección. La compuerta sigue exigiendo IDs de transacción que Claude haya recuperado, y sus net_cents deben sumar -15,00 $. Un ajuste propuesto de -15,00 $ que solo cita TXN-50036 sigue fallando porque el neto de esa línea es -164,00 $.
Con esfuerzo alto, Claude agrupó las líneas del procesador por pago y por fee_cents, y volvió a ejecutar la comprobación interna. Su siguiente nota sumó las líneas de comisiones a 12.586 centavos. La comisión de la disputa elevó ese total a 14.086 centavos. La comprobación de Rivermark la había dejado fuera.
Su primer plan enmendado chocó con esa regla porque solo citaba el cargo. El siguiente citó ambas líneas de la disputa, PLAN-2 pasó y ADJ-002 registró -15,00 $ bajo POL-4.
Este experimento no demuestra que high fuera necesario. Una reproducción separada continuó desde el mismo punto de fallo con el mismo historial de conversación y el mismo mensaje de Python, pero se mantuvo en medium; también encontró la comisión.
Las seis llamadas con esfuerzo high de la ejecución principal produjeron 2.763 tokens de salida (607 de thinking) y costaron 0,0484 $. Las seis llamadas de investigación con esfuerzo medium del control separado produjeron 2.713 tokens de salida (628 de thinking) y costaron 0,0464 $, incluyendo el mismo rechazo de la compuerta.
Una llamada final de informe llevó el control a 7 llamadas y 0,0615 $ en total. Ninguna de esas llamadas ni costes se incluyen en las 15 llamadas y 0,1190 $ de la ejecución principal.
Ambos caminos recibieron el mismo mensaje de verificación fallida; solo difería su esfuerzo. Una sola reproducción no mide la magnitud del efecto del esfuerzo, pero sí muestra que high no fue necesario en este caso. La misma guía de esfuerzo reserva xhigh y max para casos donde «tus evaluaciones demuestran una ganancia de calidad». Prueba high del mismo modo antes de seleccionarlo.
La verificación final repite a propósito 2 comprobaciones de la compuerta: evidencia y alcance de escritura. La compuerta revisa una propuesta antes de escribir; la verificación final inspecciona lo que Python realmente escribió y añade las comprobaciones numéricas y de archivos en bruto.
Tras ADJ-002, Python recomputó todo desde los registros en bruto, los ajustes aprobados y el total bancario:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Las cuatro pasaron. El pago esperado tras los ajustes fue 3.236,14 $, igual que los depósitos. Ambos ajustes se trazaron a líneas recuperadas, los datos fuente en bruto permanecieron sin cambios y Python solo escribió las entradas aprobadas.
Solo entonces empieza el paso de informe. La aplicación añade un mensaje que devuelve el esfuerzo a medium, un turno corto de usuario y un mensaje de sistema que intercambia las herramientas:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
El informe es la última salida, no la prueba. Sus sugerencias de seguimiento siguen requiriendo revisión humana. La grabación siguiente sigue permisos, esfuerzo, comprobaciones y coste en una sesión de Streamlit.
Streamlit sigue la conciliación desde el inicio. Vídeo del autor.
La conciliación principal pasó de medium a high, costó 0,1190 $ en 15 llamadas a la API y tardó 70,0 segundos, incluyendo 69,0 segundos de espera de la API. La reproducción paralela no está incluida. Cada cifra proviene del usage de la respuesta y de las tarifas de Claude Sonnet 5.5.
Para un desglose de costes más amplio, nuestra guía de la API de Claude trata la caché de prompt y el procesamiento por lotes.
input_tokens solo cuenta lo que vino después del punto de corte de la caché, así que la entrada total es la suma de tres campos, como explican los documentos de caching enlazados antes. Las escrituras y lecturas de caché tienen sus propias tarifas, y los tokens de thinking ya están dentro de output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
A lo largo de la conciliación, Claude leyó 105.614 de 118.308 tokens de entrada desde la caché (aprox. 89%), y solo 636 se facturaron como entrada no cacheada. El gráfico aplica las cuatro tarifas de tokens al uso medido.
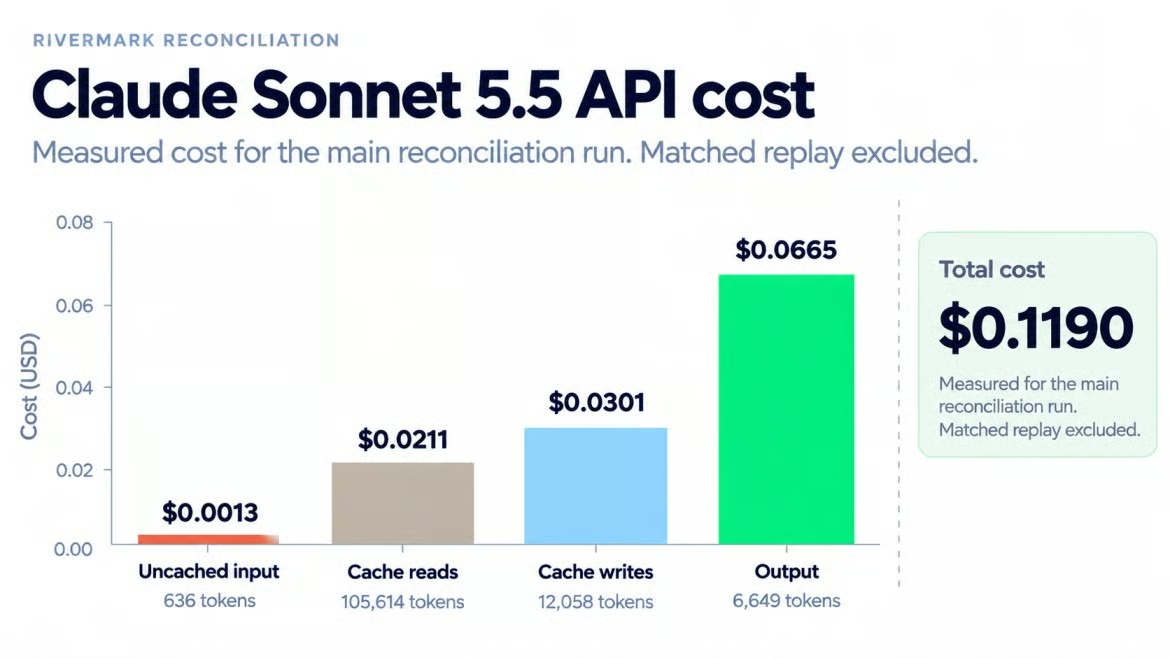
Los tokens de salida dominan el coste medido. Imagen del autor.
Rivermark escribe registros locales de ajustes, así que un sistema financiero en producción aún necesita:
Datos locales y ficticios. Un cierre real necesita autenticación, registros de auditoría, aprobación humana de asientos y una revisión de retención de datos.
Funciones en beta. Los headers para esfuerzo por mensaje, cambios de herramientas y actualizaciones de thinking pueden cambiar, así que vuelve a probarlos antes del despliegue.
Resultados variables. Claude Sonnet 5.5 rechaza temperaturas no predeterminadas, así que los intentos repetidos pueden variar. Prueba el patrón con tus propios datos antes de fiarte de él.
Hemos creado un agente de conciliación que investiga con herramientas de solo lectura, obtiene una única herramienta de escritura solo después de que Python apruebe su plan y termina únicamente cuando pasa una comprobación independiente contra los depósitos bancarios. Claude Sonnet 5.5 encontró por sí solo el reembolso mal ubicado, pero hizo falta esa comprobación fallida para devolverlo a la comisión de 15,00 $ que ya había leído.
No generalizaría un mes ficticio a todos los cierres. Lo que sí se traslada es el método: oculta la herramienta de escritura hasta que pase un plan, mantén los registros bancarios fuera del modelo, exige evidencia de transacciones para cada corrección y añade cambios de herramientas o de esfuerzo para que la caché sobreviva.
La comprobación independiente es la parte que mantendría incluso en una versión más pequeña de este proyecto. El cambio de esfuerzo es lo que probaría antes de confiar, por el motivo tratado en la sección de esfuerzo.
Intercambiar las herramientas de lectura y la comprobación final permite que el mismo patrón sirva para arreglos de limpieza de datos, reembolsos de soporte o actualizaciones controladas de documentos. Mi primera extensión sería un paso de aprobación humana antes de escribir cada ajuste, porque un cierre real lo necesita.
Para practicar los básicos de la API de Anthropic en los que se apoya este desarrollo, te recomendamos nuestro curso Introducción a los modelos Claude.
¡Aprende a usar Claude con DataCamp!
Curso
Curso
Programa
Tutorial
Abid Ali Awan
Tutorial
Tutorial
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
12 min
Tutorial
Richie Cotton
14 min
Tutorial
Zoumana Keita
14 min