Curs
Introducere în modelele Claude
3 ore
14.7K
Claude Sonnet 5.5 face parte din familia Claude 5.5 a Anthropic. Tocmai fusese lansat când am început acest proiect, iar ID-ul modelului în API este claude-sonnet-5-5. Conform prezentării generale a modelului, are o fereastră de context de 1M tokeni, până la 128K tokeni de ieșire, gândire adaptivă activată implicit și un efort implicit high pe API. Prețurile standard sunt 2 $ per milion de tokeni de intrare și 10 $ per milion de tokeni de ieșire.
Prezentarea noastră Claude Sonnet 5.5 acoperă benchmark-uri, comparații de prețuri și acces. Trei dintre funcțiile API-ului sunt noi în această versiune, iar Rivermark le folosește pe toate.
Claude Sonnet 5.5 adaugă trei modalități de a schimba o conversație în timp ce rulează. Conform Ce e nou în Claude Sonnet 5.5, niciuna nu este disponibilă pe Claude Sonnet 5:
Agentul Rivermark este o aplicație Python construită în jurul unei singure conversații cu Messages API, cu două niveluri de permisiuni. În timpul investigației, Claude poate citi comenzi, rambursări, tranzacții ale procesatorului, politica de închidere și verificarea de reconciliere a Rivermark. După aprobare, poate înregistra doar ajustările aprobate.
Rivermark folosește un loop personalizat cu Messages API în locul Claude Agent SDK pentru că poarta de aprobare trebuie să stea între apelurile de instrumente ale lui Claude și execuția lor.
Codul complet și datele de probă sunt în repository-ul Rivermark pe GitHub.
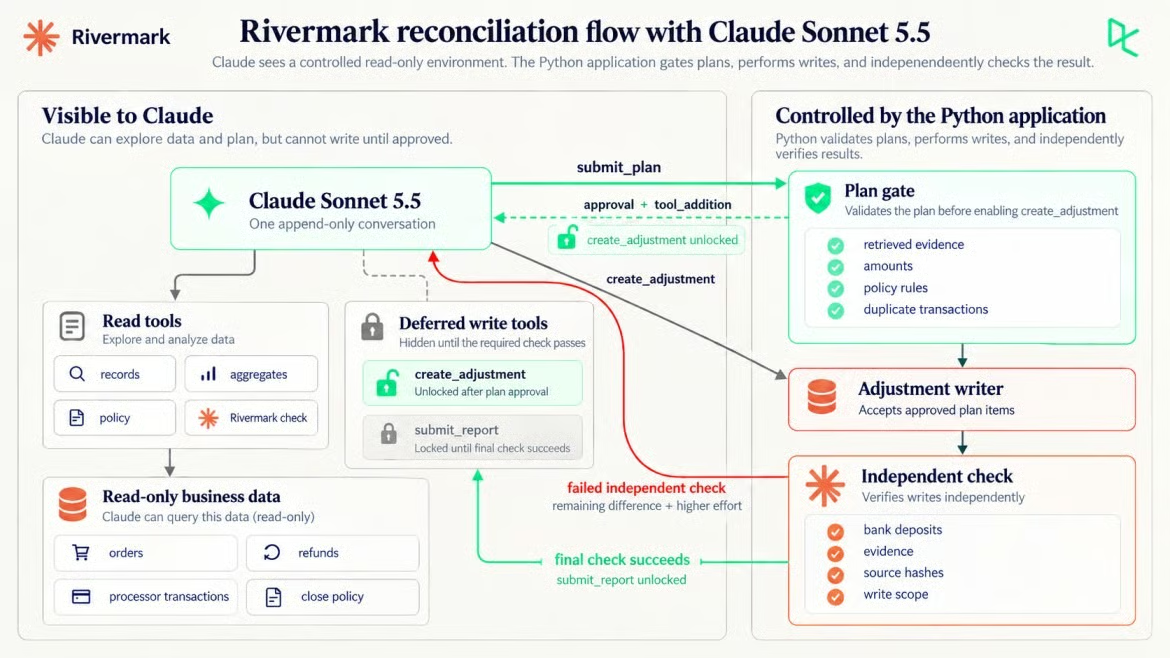
Claude propune, Python acordă acces la scriere. Imagine de autor.
Verificarea Rivermark raportează 3.400,14 $ ca plată așteptată și 3.251,14 $ ca total calculat al procesatorului, o diferență de 149,00 $. Claude trebuie să explice diferența dintre înregistrări fără să vadă niciuna dintre cauzele ascunse.
Rivermark vinde trei planuri lunare: Starter la 29 $, Team la 79 $ și Business la 149 $. Eșantionul conține 58 de comenzi din septembrie, 7 înregistrări de rambursări și 65 de tranzacții ale procesatorului din septembrie. Fiecare înregistrare a procesatorului are o sumă, un comision și o valoare netă.
Python, nu Claude, decide dacă reconcilierea e completă:
Luna este septembrie 2026, după data de decontare a procesatorului.
Totalul depunerilor bancare din septembrie este ținta independentă de decontare a experimentului.
Echilibrat înseamnă că plata așteptată plus ajustările este egală cu acele depuneri, la cent.
Fiecare ajustare citează txn_ids ale procesatorului pe care Claude le-a obținut, iar suma ei este egală cu netul acestora.
Claude poate doar să adauge ajustări aprobate și să trimită raportul final.
Exporturile brute sunt hashuite înainte de procesare și trebuie să se potrivească după.
Claude nu poate inspecta înregistrările bancare sau totalul țintă în timpul investigației inițiale. După o verificare eșuată, Python dezvăluie doar plata așteptată, totalul agregat al depunerilor și diferența rămasă, nu și înregistrările bancare în sine.
Ai nevoie de Python 3.10 sau mai nou, pe care îl cere SDK-ul Python, o cheie Anthropic API și anthropic 1.9.0. Aceste comenzi PowerShell clonează proiectul, creează mediul și construiesc datele de probă:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Pe macOS sau Linux, folosește source .venv/bin/activate și cp .env.example .env, apoi pune cheia în .env. Ghidul nostru despre variabile de mediu explică modelul.
streamlit run app_streamlit.py deschide o interfață web care arată fiecare pas al reconcilierii pe măsură ce se întâmplă, iar tutorialul nostru Streamlit acoperă configurarea.
Dacă cheia ta API deja funcționează, sari peste următoarea solicitare și treci la gândirea adaptivă.
Dacă obiectele de cerere și răspuns API îți sunt noi, ghidul nostru API Python acoperă elementele de bază. O singură întrebare despre o rambursare e suficientă pentru a confirma cheia și a inspecta blocurile de conținut returnate:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
În rularea mea, răspunsul a început cu un bloc thinking. Selectează blocurile după type în loc să citești response.content[0]; tokenii de gândire sunt taxați ca ieșire.
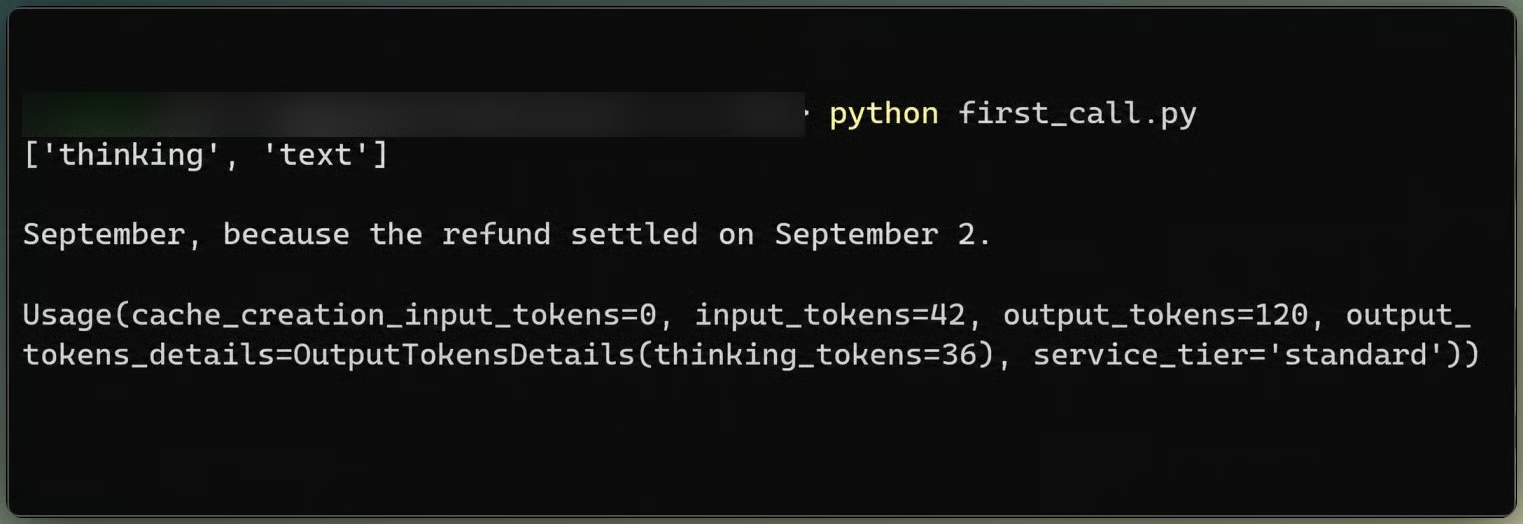
Primul răspuns separă gândirea de text. Imagine de autor.
Fiecare solicitare trimite aceleași setări de nivel superior, iar doar messages crește:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
În ciuda valorii implicite high a API-ului, acest flux de lucru pornește la medium. Ghidul Anthropic despre efort spune: „Pentru codare agentică și utilizare de instrumente în mai mulți pași, începe cu medium pentru sarcini bine specificate și treci la high pentru cele mai grele sau mai lungi.”
Gândirea rămâne adaptivă deoarece schimbarea efortului mai târziu în build depinde de asta. display: "updates" (beta, thinking-display-updates-2026-08-18) returnează notele pe care le scrie Claude între apelurile de instrumente. Fără această setare, blocurile de gândire sunt goale.
Setarea de nivel superior cache_control pornește caching-ul automat al promptului, cu un punct de întrerupere care avansează pe măsură ce conversația crește. Prima solicitare a scris 2.080 de tokeni în cache, mult peste minimul de 512 tokeni al lui Claude Sonnet 5.5.
Un agent de investigație doar pentru citire îi permite lui Claude să ceară dovezi, dar nu expune niciun instrument de scriere. Rivermark respinge, de asemenea, apelurile de scriere neaprobate în Python.
Claude primește cinci instrumente de citire și unul pentru propuneri, toate cu strict: true. Descrierile spun ce returnează fiecare instrument și nimic despre unde să caute:
list_sources returnează surse, coloane și număr de rânduri.
query_records returnează până la 40 de rânduri dintr-o sursă, cu un filtru opțional și interval de date.
aggregate_records numără rândurile și însumează amount_cents după orice coloană.
read_policy returnează politica de închidere.
run_reconciliation_check rulează logica internă existentă a Rivermark, cu bug-urile incluse.
submit_plan trimite o diagnoză și ajustări propuse în Python pentru validare, fără să scrie nimic.
Încă două instrumente stau în același array tools, dar defer_loading: true le ține deocamdată în afara vederii lui Claude. Vom ajunge mai târziu la cum apar:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Schema instrumentului de scriere este cunoscută la prima solicitare, deci instrumentul este declarat de la început. Alegerea unui instrument nominal sau any returnează o eroare 400, așa că promptul precizează când se aplică submit_plan.
Ghidul nostru despre infrastructura pentru agenți explică cum poate Python să gestioneze bucle mai lungi pentru agenți. Bucla Rivermark trimite conversația, rulează orice blocuri tool_use în Python și adaugă rezultatele. Fiecare ID de înregistrare returnat de un instrument de citire intră într-un set observed pe care poarta de plan îl verifică mai târziu:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Tura asistentului se întoarce exact cum a fost primită, inclusiv blocurile de gândire goale. Ghidul de migrare explică faptul că Claude Sonnet 5.5 leagă blocurile de gândire de mesajele anterioare, astfel că editarea acelei istorii poate returna o eroare 400.
La efort mediu, investigația a presupus șase apeluri API și nouă apeluri de instrumente de citire. Claude a extras rambursările și a grupat liniile procesatorului după reporting_category. A găsit RF-1043, o rambursare de 149,00 $ pentru o comandă din 31 august, decontată pe 2 septembrie. Regula de politică POL-3 o pune în septembrie.
Apoi a deschis ambele rânduri ale disputei. TXN-50036 conține o sumă principală de -149,00 $, un comision de 15,00 $ și un efect net de numerar de -164,00 $. TXN-50052 returnează principalul de 149,00 $ fără comision. Claude a scris: „DSP-0077 se închide la zero și comisionul de 15 $ este deja înregistrat corect, deci RF-1043 explică pe deplin variația.”
Claude a confundat principalul returnat cu efectul de numerar după comisioane:
Poarta a respins primul plan al lui Claude pentru că a citat comanda ORD-20813 fără s-o fi obținut. Claude a preluat comanda, a retrimis și PLAN-1 a trecut cu o singură ajustare.
Înainte de a expune instrumentul de scriere, poarta verifică de unde provin dovezile și ce ar schimba planul.
Fiecare ajustare dintr-un plan citează txn_id-uri ale procesatorului. Poarta o acceptă doar dacă fiecare linie citată s-a întors de la un instrument de citire în această conversație și liniile se închid la suma propusă:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
O ajustare de 15,00 $ care citează doar debitul disputei eșuează pentru că netul acelei linii este -164,00 $. Planul trebuie să citeze și reversarea.
Poarta mai verifică regulile de politică și tranzacțiile duplicate. Un plan este respins, iar accesul la scriere rămâne blocat, dacă vreun element face una dintre acestea:
Respingerile se întorc ca rezultat al instrumentului submit_plan, astfel încât Claude poate investiga mai departe și retrimite. Poarta a respins 2 din 4 trimiteri, iar Claude le-a corectat pe fiecare la următorul apel. Chiar și după aprobare, create_adjustment acceptă doar intrări care se potrivesc exact cu un element aprobat.
După ce poarta aprobă un plan, Python adaugă un mesaj role: "system" cu un bloc tool_addition. Schimbarea necesită antetul beta inline-tools-2026-09-15. Array-ul tools și fiecare mesaj anterior rămân neschimbate, astfel încât prefixul cache-uit încă se potrivește. Textul instrucțiunii vine din Python, nu de la Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Un mesaj de sistem cu conținut trebuie să urmeze după o tură user, inclusiv una cu blocuri tool_result. Nu poate sta între un bloc tool_use și rezultatul lui. Mesajele de sistem au prioritate mai mare, așa că nu insera niciodată textul planului lui Claude, ieșiri de instrumente sau date într-unul. Blocul tool_addition numește create_adjustment prin referință, iar instrumentul devine vizibil doar după ce planul trece.
Caching-ul a continuat după schimbarea instrumentului. Solicitarea a procesat 231 de tokeni de intrare necached și a citit 6.883 din cache.
Prima ajustare a fost corectă și totuși a lăsat treaba neterminată. Claude a înregistrat ADJ-001, -149,00 $ sub POL-3, și a raportat că a terminat. Verificarea internă a Rivermark ar fi fost de acord, arătând o variație de 0,00 $. Sună gata, dar nu este.
Verificarea independentă din Python compară în schimb cu depunerile bancare. Plata așteptată după ajustări era 3.251,14 $, depunerile erau 3.236,14 $, și au rămas 15,00 $.
Acest decalaj este motivul pentru care verificarea finalizării trăiește în Python, nu în mesajul final al lui Claude.
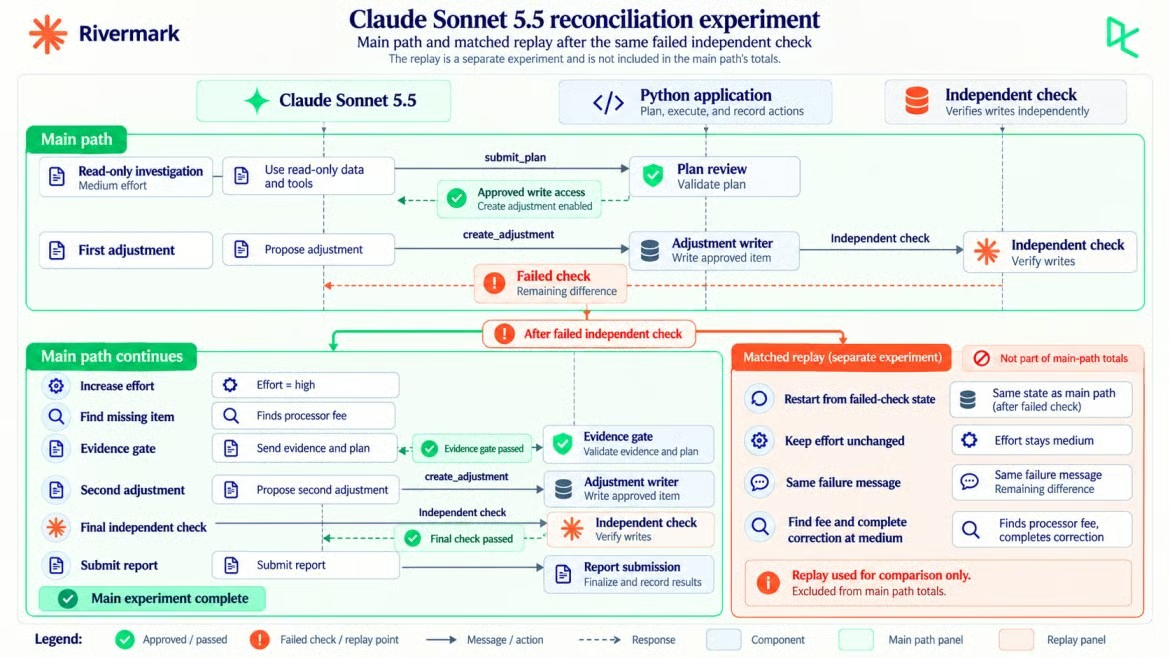
Redarea potrivită se ramifică din verificarea eșuată. Imagine de autor.
Schimbarea efortului la mijlocul conversației pe Claude Sonnet 5.5 înseamnă să adaugi un mesaj de sistem cu content gol și un nou output_config.effort. Noul nivel se aplică de la următoarea tură user, iar tot ce a fost înainte rămâne în cache.
Efortul per mesaj este în beta și are nevoie de antetul mid-conversation-output-config-2026-07-01. Are nevoie și de gândire adaptivă: cu between_tools, aceeași schimbare returnează o eroare 400. Când verificarea independentă eșuează, Python adaugă noua setare de efort înainte de următorul mesaj al utilizatorului:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
O schimbare de efort la nivel superior ar reporni cache-ul, deoarece efortul de nivel superior face parte din promptul memorat în cache. Forma per mesaj nu a făcut-o: prima solicitare cu efort ridicat a citit 8.012 tokeni din cache și a procesat 4 necached.
Diferența de 15,00 $ îi oferă lui Claude o țintă, dar nu și dovezi pentru o corecție. Poarta încă cere ID-uri de tranzacții pe care Claude le-a obținut, iar net_cents ale acestora trebuie să totalizeze -15,00 $. O ajustare propusă de -15,00 $ care citează doar TXN-50036 tot eșuează pentru că netul acelei linii este -164,00 $.
La high, Claude a grupat liniile procesatorului după plată și după fee_cents, apoi a rerulat verificarea internă. Nota următoare a adunat liniile de comisioane la 12.586 de cenți. Comisionul disputei a ridicat totalul la 14.086 de cenți. Verificarea Rivermark îl omisese.
Primul plan amendat a nimerit acea regulă pentru că a citat doar debitul. Următorul a citat ambele linii ale disputei, PLAN-2 a trecut, iar ADJ-002 a înregistrat -15,00 $ sub POL-4.
Acest experiment nu arată că high a fost necesar. O redare separată a continuat din același punct de eșec cu același istoric al conversației și același mesaj din Python, dar a rămas la medium; a găsit și ea comisionul.
Cele șase apeluri la high din rularea principală au produs 2.763 tokeni de ieșire (607 de gândire) și au costat 0,0484 $. Cele șase apeluri de investigație la medium ale controlului separat au produs 2.713 tokeni de ieșire (628 de gândire) și au costat 0,0464 $, incluzând aceeași respingere la poartă.
Un ultim apel de raport a adus controlul la 7 apeluri și 0,0615 $ în total. Niciunul dintre aceste apeluri sau costuri nu este inclus în cele 15 apeluri și 0,1190 $ ale rulării principale.
Ambele căi au primit același mesaj de verificare eșuată; doar efortul lor a diferit. O singură redare nu poate măsura mărimea oricărui efect al efortului, dar arată că high nu a fost necesar în acest caz. Același ghid de efort rezervă xhigh și max pentru cazuri în care „evaluările tale arată un câștig de calitate.” Testează high la fel înainte de a-l selecta.
Verificarea finală repetă intenționat 2 verificări ale porții: dovezi și aria de scriere. Poarta revizuiește o propunere înainte de scriere; verificarea finală inspectează ce a scris efectiv Python, apoi adaugă verificarea numerelor și a fișierelor brute.
După ADJ-002, Python a recalculat totul din înregistrările brute, ajustările aprobate și totalul bancar:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Toate cele patru au trecut. Plata așteptată după ajustări era 3.236,14 $, potrivindu-se cu depunerile. Ambele ajustări se leagă de linii obținute, datele sursă brute au rămas neschimbate, iar Python a scris doar intrările aprobate.
Abia apoi începe pasul de raportare. Aplicația adaugă un mesaj care setează efortul înapoi la medium, o scurtă tură a utilizatorului și un mesaj de sistem care schimbă instrumentele:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Raportul este ultimul output, nu dovada. Sugestiile lui de follow-up necesită în continuare revizuire umană. Înregistrarea de mai jos urmărește permisiunile, efortul, verificările și costul într-o sesiune Streamlit.
Streamlit urmărește reconcilierea de la început. Video de autor.
Reconcilierea principală a trecut de la medium la high, a costat 0,1190 $ în 15 apeluri API și a durat 70,0 secunde, incluzând 69,0 secunde de așteptare după API. Redarea potrivită separată nu este inclusă. Fiecare cifră provine din usage al răspunsului și din tarifele Claude Sonnet 5.5.
Pentru o defalcare mai amplă a costurilor, ghidul nostru Claude API acoperă caching-ul prompturilor și procesarea în lot.
input_tokens numără doar ce a venit după punctul de întrerupere al cache-ului, deci intrarea totală este suma a trei câmpuri, așa cum explică documentația de caching a promptului menționată mai devreme. Scrierile și citirile din cache au propriile tarife, iar tokenii de gândire sunt deja în output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
De-a lungul reconcilierii, Claude a citit 105.614 din 118.308 tokeni de intrare din cache (circa 89%), iar doar 636 au fost taxați ca intrare necached. Graficul aplică cele patru tarife de tokeni la utilizarea măsurată.
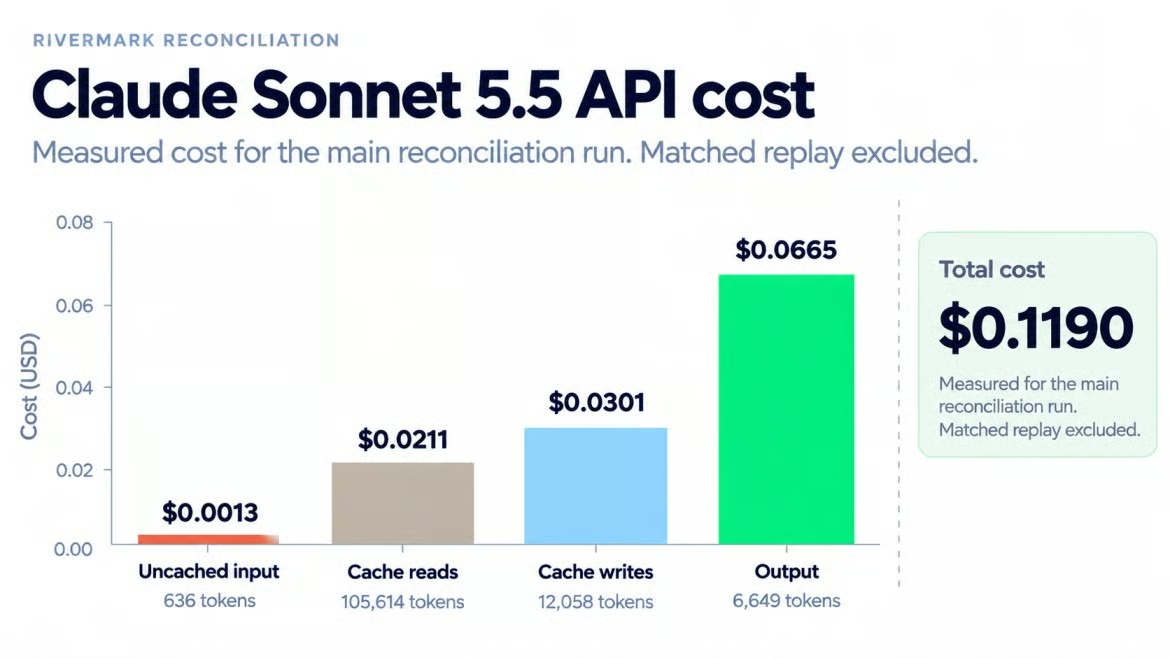
Tokenii de ieșire domină costul măsurat. Imagine de autor.
Rivermark scrie înregistrări locale de ajustări, așa că un sistem financiar de producție încă are nevoie de:
Date locale, fictive. O închidere reală are nevoie de autentificare, jurnale de audit, aprobare umană a postărilor și o revizuire a retenției datelor.
Funcții beta. Anteturile pentru efort per mesaj, schimbări de instrumente și actualizări ale gândirii se pot schimba, așa că testează-le din nou înainte de implementare.
Rezultate variabile. Claude Sonnet 5.5 respinge temperatura non-implicită, deci încercările repetate pot diferi. Testează modelul pe datele tale înainte să te bazezi pe el.
Am construit un agent de reconciliere care investighează cu instrumente doar pentru citire, primește un singur instrument de scriere doar după ce Python îi aprobă planul și finalizează doar când trece o verificare independentă față de depunerile bancare. Claude Sonnet 5.5 a găsit singur rambursarea pusă greșit, dar a fost nevoie de acea verificare eșuată pentru a-l trimite înapoi la comisionul de 15,00 $ pe care îl citise deja.
Nu aș generaliza o lună fictivă la fiecare închidere. Ce se transferă este metoda: ascunde instrumentul de scriere până când un plan trece, ține înregistrările bancare în afara modelului, cere dovezi de tranzacții pentru fiecare corecție și adaugă schimbări de instrumente sau efort astfel încât cache-ul să supraviețuiască.
Verificarea independentă este partea pe care aș păstra-o chiar și într-o versiune mai mică a acestui proiect. Schimbarea efortului este partea pe care aș testa-o înainte să am încredere, din motivul acoperit în secțiunea despre efort.
Schimbarea instrumentelor de citire și a verificării finale permite aceluiași model să gestioneze corecții de curățare a datelor, rambursări de suport sau actualizări controlate de documente. Prima mea extindere ar fi un pas de aprobare umană înainte ca fiecare ajustare să fie scrisă, deoarece o închidere reală are nevoie de așa ceva.
Pentru a exersa elementele de bază ale Anthropic API pe care se bazează acest build, recomandăm cursul nostru Introducere în modelele Claude.
Învață să folosești Claude cu DataCamp!
Curs
Curs
Traseu de învățare