
कोर्स
Claude मॉडलों का परिचय
3 घंटा
14.7K
Claude Sonnet 5.5, Anthropic के Claude 5.5 परिवार का हिस्सा है। जब मैंने यह प्रोजेक्ट शुरू किया, तब ही यह जारी हुआ था, और इसका API मॉडल ID claude-sonnet-5-5 है। the मॉडल ओवरव्यू के अनुसार, इसमें 1M-टोकन कॉन्टेक्स्ट विंडो, 128K तक आउटपुट टोकन्स, डिफॉल्ट रूप से adaptive thinking, और API पर डिफॉल्ट effort high है। मानक प्राइसिंग प्रति मिलियन इनपुट टोकन्स $2 और प्रति मिलियन आउटपुट टोकन्स $10 है।
हमारा Claude Sonnet 5.5 ओवरव्यू बेंचमार्क, कीमत तुलना, और एक्सेस को कवर करता है। इसके तीन API फीचर्स इस रिलीज़ में नए हैं, और Rivermark इन सभी का उपयोग करता है।
Claude Sonnet 5.5 बातचीत के दौरान उसे बदलने के तीन तरीके जोड़ता है। What's new in Claude Sonnet 5.5 के अनुसार, ये Claude Sonnet 5 पर उपलब्ध नहीं हैं:
Rivermark एजेंट एक Python एप्लिकेशन है जो एक Messages API बातचीत पर आधारित है, जिसमें दो अनुमति स्तर हैं। जाँच के दौरान, Claude ऑर्डर, रिफंड, प्रोसेसर ट्रांजैक्शंस, क्लोज़ पॉलिसी, और Rivermark की रिकंसिलिएशन जाँच पढ़ सकता है। मंजूरी के बाद, वह सिर्फ मंजूर किए गए एडजस्टमेंट्स दर्ज कर सकता है।
Rivermark, Claude Agent SDK के बजाय कस्टम Messages API लूप का उपयोग करता है क्योंकि अप्रूवल गेट को Claude के टूल कॉल्स और उनके निष्पादन के बीच बैठना होता है।
पूरा कोड और सैंपल डेटा Rivermark GitHub रिपोजिटरी में है।
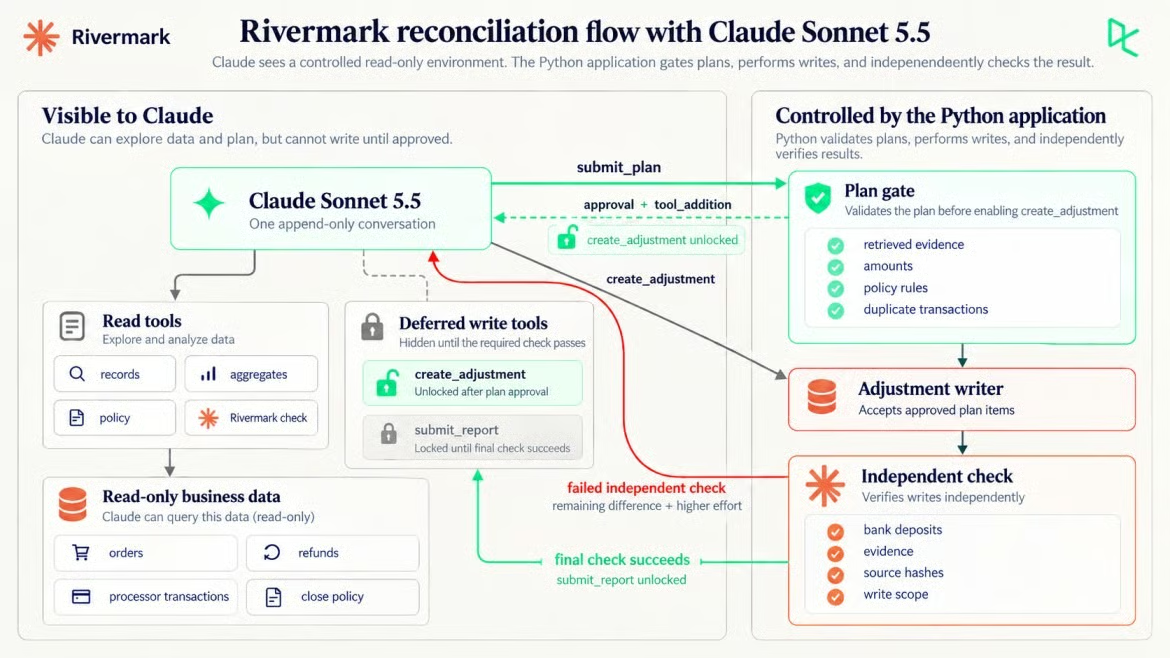
प्रस्ताव Claude करता है, लिखने की अनुमति Python देता है। चित्र: लेखक द्वारा।
Rivermark की जाँच $3,400.14 को अपेक्षित भुगतान और $3,251.14 को उसके गणितीय प्रोसेसर टोटल के रूप में रिपोर्ट करती है—$149.00 का फर्क। Claude को छिपे हुए दोनों कारणों को देखे बिना रिकॉर्ड्स के बीच का फर्क समझाना है।
Rivermark तीन मासिक प्लान बेचता है: Starter $29, Team $79, और Business $149। सैंपल में सितंबर के 58 ऑर्डर, 7 रिफंड रिकॉर्ड, और 65 सितंबर प्रोसेसर ट्रांजैक्शंस हैं। हर प्रोसेसर रिकॉर्ड में एक amount, एक fee, और एक net वैल्यू होती है।
रिकंसिलिएशन पूरा है या नहीं, यह Claude नहीं, Python तय करता है:
महीना सितंबर 2026 है, प्रोसेसर सेटलमेंट तिथि के आधार पर।
सितंबर के बैंक जमाओं का योग इस प्रयोग का स्वतंत्र सेटलमेंट टारगेट है।
Balanced का मतलब है कि expected payout प्लस adjustments सेंट तक जमाओं के बराबर हों।
हर adjustment में वे प्रोसेसर txn_ids उद्धृत हों जो Claude ने निकाले, और उसकी राशि उनके net के बराबर हो।
Claude केवल मंजूर किए गए adjustments जोड़ सकता है और अंतिम रिपोर्ट जमा कर सकता है।
प्रोसेसिंग से पहले raw एक्सपोर्ट्स का हैश लिया जाता है और बाद में मिलना चाहिए।
अपनी शुरुआती जाँच के दौरान Claude बैंक रिकॉर्ड्स या टारगेट टोटल का निरीक्षण नहीं कर सकता। असफल जाँच के बाद, Python केवल expected payout, कुल जमा, और बचा फर्क बताता है—बैंक रिकॉर्ड्स स्वयं नहीं।
आपको Python 3.10 या नया संस्करण चाहिए, which the Python SDK requires, एक Anthropic API कुंजी, और anthropic 1.9.0। ये PowerShell कमांड्स प्रोजेक्ट क्लोन करती हैं, एनवायरनमेंट बनाती हैं, और सैंपल डेटा तैयार करती हैं:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
macOS या Linux पर, source .venv/bin/activate और cp .env.example .env का उपयोग करें, फिर अपनी कुंजी .env में डालें। Our एनवायरनमेंट वेरिएबल्स गाइड exप्लेन करता है पैटर्न।
streamlit run app_streamlit.py एक वेब इंटरफ़ेस खोलता है जो रिकंसिलिएशन के हर स्टेप को होते समय दिखाता है, और our Streamlit ट्यूटोरियल seटअप कवर करता है।
यदि आपकी API कुंजी पहले से काम कर रही है, तो अगला अनुरोध छोड़ दें और adaptive thinking पर बढ़ें।
यदि API रिक्वेस्ट और रिस्पॉन्स ऑब्जेक्ट आपके लिए नए हैं, to you, हमारा Python API गाइड baसिक्स कवर करता है। एक रिफंड सवाल कुंजी कन्फर्म करने और लौटे कंटेंट ब्लॉक्स देखने के लिए काफी है:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
मेरे रन में, रिस्पॉन्स thinking ब्लॉक से शुरू हुआ। ब्लॉक्स को type से चुनें, response.content[0] पढ़ने के बजाय; thinking टोकन्स आउटपुट के रूप में बिल होते हैं।
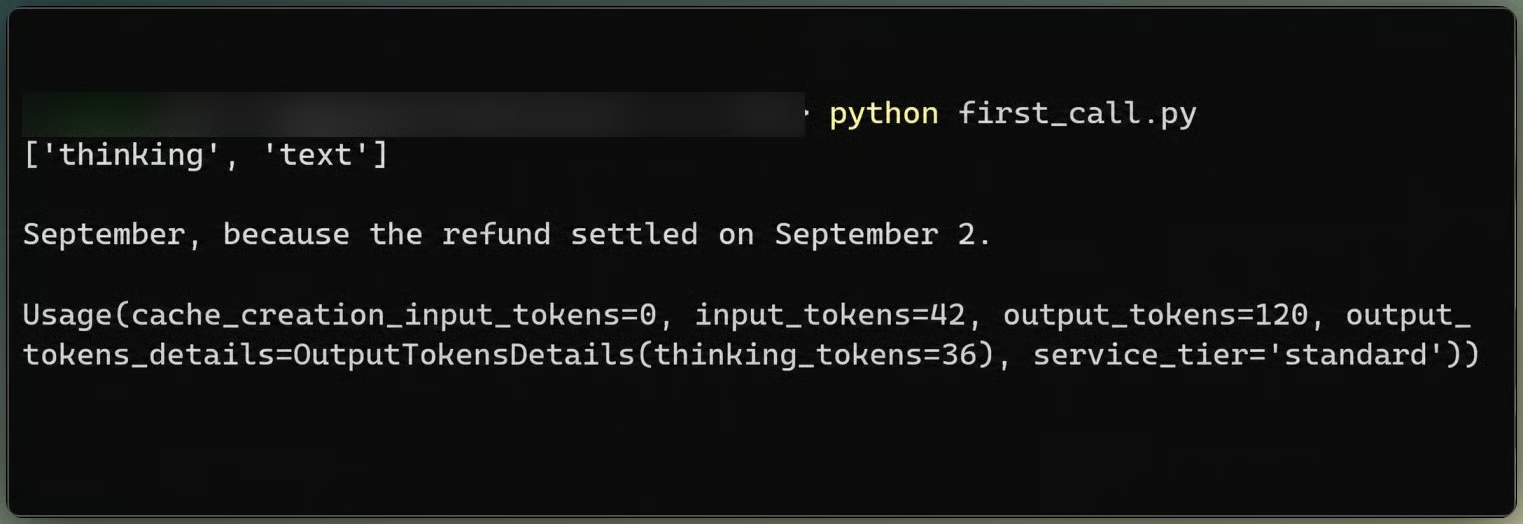
पहला रिस्पॉन्स thinking और text अलग करता है। चित्र: लेखक द्वारा।
हर रिक्वेस्ट में वही टॉप-लेवल सेटिंग्स जाती हैं, और सिर्फ messages बढ़ता है:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
API के high डिफॉल्ट के बावजूद, यह वर्कफ़्लो medium से शुरू होता है। Anthropic की effort गाइड कहती है: "एजेंटिक कोडिंग और मल्टीस्टेप टूल उपयोग के लिए, स्पष्ट रूप से परिभाषित कार्यों पर medium से शुरू करें और कठिन या लंबे कार्यों पर high पर जाएँ।"
Thinking adaptive रहता है क्योंकि आगे चलकर effort बदलना इसी पर निर्भर है। display: "updates" (बीटा, thinking-display-updates-2026-08-18) उन नोट्स को लौटाता है जो Claude टूल कॉल्स के बीच लिखता है। बिना इस सेटिंग के thinking ब्लॉक्स खाली रहते हैं।
टॉप-लेवल cache_control ऑटोमेटिक प्रॉम्प्ट कैशिंग चालू करता है, जिसमें एक ब्रेकपॉइंट बातचीत के बढ़ने के साथ आगे बढ़ता है। पहली रिक्वेस्ट ने 2,080 टोकन्स कैश में लिखे, जो Claude Sonnet 5.5 की 512-टोकन न्यूनतम सीमा से काफी ऊपर है।
एक read-only जाँच एजेंट Claude को साक्ष्य माँगने देता है पर कोई write टूल उजागर नहीं करता। Rivermark Python में अनअप्रूव्ड write कॉल्स को भी खारिज करता है।
Claude को पाँच read टूल्स और एक प्रस्ताव टूल मिलते हैं, सभी में strict: true है। विवरण बताते हैं कि हर टूल क्या लौटाता है—न कि कहाँ देखना है:
list_sources स्रोत, कॉलम, और रो काउंट्स लौटाता है।
query_records एक स्रोत से 40 तक पंक्तियाँ लौटाता है, वैकल्पिक फ़िल्टर और तारीख सीमा के साथ।
aggregate_records पंक्तियाँ गिनता है और किसी भी कॉलम के अनुसार amount_cents का कुल देता है।
read_policy क्लोज़ पॉलिसी लौटाता है।
run_reconciliation_check Rivermark की मौजूदा आंतरिक लॉजिक चलाता है, बग्स सहित।
submit_plan निदान और प्रस्तावित एडजस्टमेंट्स Python को वैधता-जाँच के लिए भेजता है, और कुछ नहीं लिखता।
दो और टूल्स उसी tools ऐरे में हैं, लेकिन defer_loading: true अभी उन्हें Claude की नज़र से बाहर रखता है। वे आगे कैसे दिखेंगे, यह बाद में आएगा:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
राइट-टूल की स्कीमा पहली रिक्वेस्ट में ही ज्ञात है, इसलिए टूल अग्रिम घोषित है। Named या any टूल चॉइस 400 एरर लौटाती है, इसलिए प्रॉम्प्ट स्पष्ट करता है कि submit_plan कब लागू होता है।
हमारी एजेंट हार्नेस इंजीनियरिंग गाइड exप्लेन करती है कि Python लंबे एजेंट लूप्स को कैसे मैनेज कर सकता है। Rivermark का लूप बातचीत भेजता है, किसी भी tool_use ब्लॉक को Python में चलाता है, और परिणाम जोड़ देता है। कोई भी रिकॉर्ड ID जो एक read टूल लौटाता है, एक observed सेट में जाती है जिसे आगे प्लान गेट जाँचेगा:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
असिस्टेंट की बारी ठीक वैसे ही वापस जाती है जैसे मिली थी, खाली thinking ब्लॉक्स सहित। माइग्रेशन गाइड बताता है कि Claude Sonnet 5.5 thinking ब्लॉक्स को पहले के संदेशों से बाँधता है, इसलिए उस हिस्ट्री को एडिट करने पर 400 एरर आ सकता है।
मध्यम पर, जाँच में छह API कॉल और नौ read-टूल कॉल लगे। Claude ने रिफंड्स निकाले और प्रोसेसर लाइनों को reporting_category के अनुसार समूहित किया। उसे RF-1043 मिला—$149.00 का रिफंड जो 31 अगस्त के ऑर्डर के लिए था और 2 सितंबर को सेटल हुआ। पॉलिसी नियम POL-3 इसे सितंबर में रखता है।
फिर उसने दोनों विवाद पंक्तियाँ खोलीं। TXN-50036 में -$149.00 का principal amount, $15.00 की फीस, और -$164.00 का net cash प्रभाव है। TXN-50052 $149.00 का principal बिना फीस लौटाता है। Claude ने लिखा: "DSP-0077 का net शून्य है और उसकी $15 फीस पहले से सही बुक हो चुकी है, इसलिए RF-1043 पूरी तरह अंतर समझा देता है।"
Claude ने लौटाए गए principal को फीस के बाद के कैश प्रभाव से गड़बड़ा दिया:
गेट ने Claude की पहली योजना इसलिए खारिज की क्योंकि उसने ऑर्डर ORD-20813 का हवाला दिया था बिना उसे निकाले। Claude ने ऑर्डर निकाला, फिर से सबमिट किया, और PLAN-1 एक adjustment के साथ पास हो गया।
राइट टूल दिखाने से पहले, गेट जाँचता है कि साक्ष्य कहाँ से आया और प्लान क्या बदलेगा।
योजना में हर adjustment प्रोसेसर txn_id का हवाला देता है। गेट तभी स्वीकार करता है जब हर उद्धृत पंक्ति इसी बातचीत में किसी read टूल से आई हो और पंक्तियाँ प्रस्तावित राशि के नेट के बराबर हों:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
सिर्फ विवाद डेबिट का हवाला देने वाला $15.00 adjustment फेल होता है क्योंकि उस पंक्ति का net -$164.00 है। प्लान को रिवर्सल का भी हवाला देना होगा।
गेट पॉलिसी नियम और डुप्लीकेट ट्रांजैक्शंस भी जाँचेगा। प्लान अस्वीकार होता है, और write एक्सेस लॉक रहता है, यदि कोई भी आइटम यह करे:
अस्वीकार submit_plan टूल परिणाम के रूप में लौटते हैं, ताकि Claude आगे जाँच कर सके और फिर सबमिट करे। गेट ने 4 में से 2 सबमिशन खारिज किए, और Claude ने अगली ही कॉल में उन्हें ठीक कर दिया। मंजूरी के बाद भी, create_adjustment केवल वही एंट्रियाँ स्वीकार करता है जो किसी मंजूर आइटम से हूबहू मिलें।
जैसे ही गेट किसी प्लान को मंजूर करता है, Python एक role: "system" संदेश जोड़ता है जिसमें tool_addition ब्लॉक होता है। इस बदलाव के लिए inline-tools-2026-09-15 बीटा हैडर चाहिए। tools ऐरे और पहले के हर संदेश जस के तस रहते हैं, इसलिए कैश्ड प्रीफ़िक्स अब भी मैच करता है। निर्देश पाठ Python से आता है, Claude से नहीं:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
कंटेंट वाला सिस्टम संदेश एक user टर्न के बाद ही आ सकता है, जिसमें tool_result ब्लॉक्स वाला टर्न भी शामिल है। यह किसी tool_use ब्लॉक और उसके परिणाम के बीच नहीं बैठ सकता। सिस्टम संदेशों की प्राथमिकता अधिक होती है, इसलिए कभी भी Claude का प्लान टेक्स्ट, टूल आउटपुट, या डेटा इनमें न डालें। tool_addition ब्लॉक create_adjustment का नाम रेफ़रेंस से देता है, और टूल केवल प्लान पास होने के बाद दिखता है।
टूल बदलाव के बाद भी कैशिंग जारी रही। रिक्वेस्ट ने 231 अनकैश्ड इनपुट टोकन्स प्रोसेस किए और 6,883 कैश से पढ़े।
पहला adjustment सही था, फिर भी काम अधूरा छोड़ गया। Claude ने ADJ-001 दर्ज किया, POL-3 के तहत -$149.00, और इसे पूरा बताया। Rivermark की आंतरिक जाँच सहमत होती—$0.00 का वेरिएंस दिखता। सुनने में पूरा लगता है, पर है नहीं।
स्वतंत्र Python जाँच तुलना बैंक जमाओं से करती है। adjustments के बाद expected payout $3,251.14 था, जमाएँ $3,236.14 थीं, और $15.00 बाकी रहे।
यही गैप कारण है कि कम्प्लीशन चेक Claude के अंतिम संदेश में नहीं, Python में है।
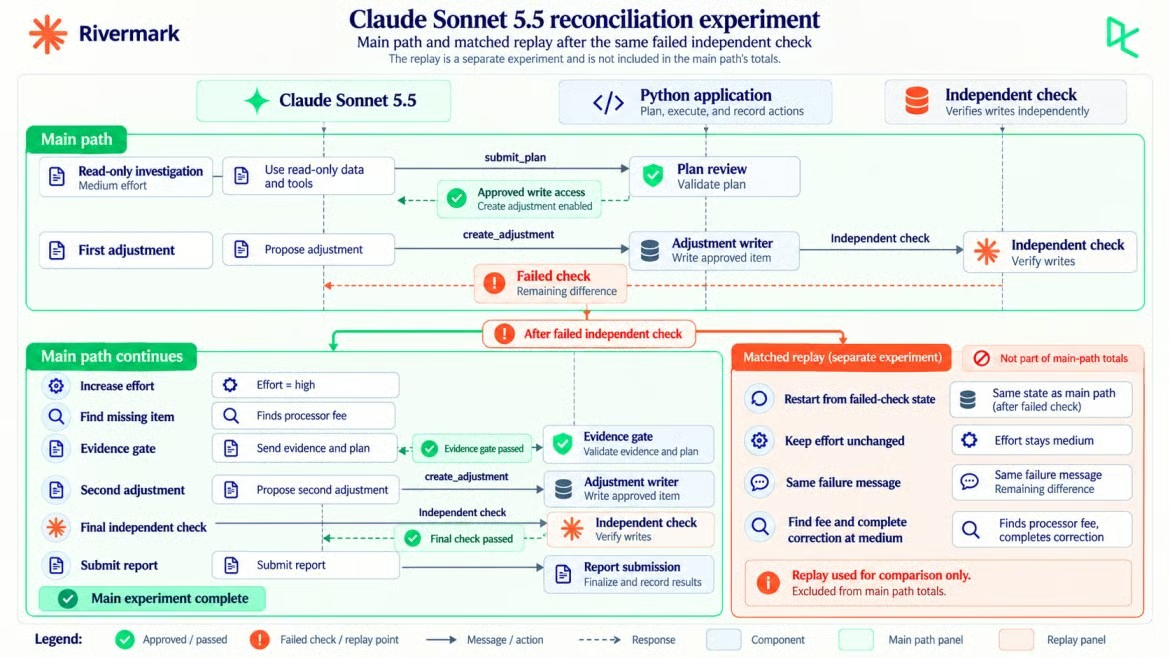
मैच्ड रीप्ले असफल वेरिफिकेशन से शाखा बनाता है। चित्र: लेखक द्वारा।
Claude Sonnet 5.5 पर बातचीत के बीच effort बदलने का मतलब है खाली content और नए output_config.effort के साथ एक सिस्टम संदेश जोड़ना। नया स्तर अगली user बारी से लागू होता है, और उससे पहले सब कैश्ड रहता है।
Per-message effort बीटा में है और mid-conversation-output-config-2026-07-01 हैडर चाहिए। adaptive thinking भी चाहिए: between_tools के साथ वही बदलाव 400 एरर देता है। जब स्वतंत्र जाँच फेल होती है, Python अगली user बारी से पहले नया effort सेटिंग जोड़ता है:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
टॉप-लेवल effort बदलने से कैश फिर से शुरू हो जाता, क्योंकि टॉप-लेवल effort कैश्ड प्रॉम्प्ट का हिस्सा है। Per-message रूप में ऐसा नहीं हुआ: पहले high-effort रिक्वेस्ट ने 8,012 टोकन्स कैश से पढ़े और 4 अनकैश्ड प्रोसेस किए।
$15.00 का फर्क Claude को एक लक्ष्य देता है, पर सुधार के लिए साक्ष्य नहीं। गेट अब भी उन्हीं ट्रांजैक्शन IDs की माँग करता है जो Claude ने निकाले हों, और उनके net_cents का कुल -$15.00 होना चाहिए। सिर्फ TXN-50036 का हवाला देने वाला प्रस्तावित -$15.00 adjustment अब भी फेल होता है क्योंकि उस पंक्ति का net -$164.00 है।
High पर, Claude ने प्रोसेसर लाइनों को payout और fee_cents के अनुसार समूहित किया, फिर आंतरिक जाँच फिर चलाई। उसके अगले नोट में फीस लाइनों का कुल 12,586 सेंट आया। विवाद फीस ने कुल 14,086 सेंट कर दिया। Rivermark की जाँच ने इसे छोड़ दिया था।
उसकी पहली संशोधित योजना इसी नियम से टकराई क्योंकि उसने केवल डेबिट का हवाला दिया था। अगली में दोनों विवाद पंक्तियाँ थीं, PLAN-2 पास हुआ, और ADJ-002 ने POL-4 के तहत -$15.00 दर्ज किया।
यह प्रयोग यह नहीं दिखाता कि high जरूरी था। उसी फेल्योर पॉइंट से अलग रीप्ले, वही बातचीत इतिहास और Python संदेश के साथ, medium पर रहा; उसने भी फीस ढूंढ ली।
मुख्य रन की छह high-effort कॉल्स ने 2,763 आउटपुट टोकन्स (607 thinking) दिए और $0.0484 की लागत आई। अलग कंट्रोल की छह medium-effort जाँच कॉल्स ने 2,713 आउटपुट टोकन्स (628 thinking) दिए और $0.0464 की लागत आई, जिसमें वही गेट रिजेक्शन शामिल है।
एक अंतिम रिपोर्ट कॉल ने कंट्रोल को 7 कॉल्स और कुल $0.0615 तक पहुँचाया। इन कॉल्स या लागतों में से कोई भी मुख्य रन की 15 कॉल्स और $0.1190 में शामिल नहीं है।
दोनों पाथ्स को वही फेल्ड-चेक संदेश मिला; फर्क सिर्फ effort में था। एक रीप्ले effort इफेक्ट का आकार नहीं माप सकता, पर यह दिखाता है कि इस उदाहरण में high जरूरी नहीं था। वही effort गाइड xhigh और max उन मामलों के लिए रखता है जहाँ "आपके इवैल्स क्वालिटी गेन दिखाते हैं।" high को चुनने से पहले उसी तरह टेस्ट करें।
अंतिम वेरिफिकेशन जानबूझकर 2 गेट जाँचें दोहराता है: साक्ष्य और write स्कोप। गेट लिखने से पहले प्रस्ताव की समीक्षा करता है; अंतिम वेरिफिकेशन यह देखता है कि Python ने वास्तव में क्या लिखा, फिर संख्या और रॉ-फ़ाइल जाँच जोड़ता है।
ADJ-002 के बाद, Python ने रॉ रिकॉर्ड्स, अप्रूव्ड एडजस्टमेंट्स, और बैंक टोटल से सबकुछ फिर से गणना किया:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
चारों पास हुए। adjustments के बाद expected payout $3,236.14 था, जो जमाओं से मेल खाता है। दोनों adjustments निकाली गई पंक्तियों तक ट्रेस हुए, रॉ सोर्स डेटा जस का तस रहा, और Python ने केवल अप्रूव्ड एंट्रियाँ लिखीं।
इसके बाद ही रिपोर्ट स्टेप शुरू होता है। ऐप्लिकेशन एक संदेश जोड़ता है जो effort को वापस medium पर सेट करता है, एक छोटा user टर्न, और एक सिस्टम संदेश जो टूल्स बदल देता है:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
रिपोर्ट अंतिम आउटपुट है, सबूत नहीं। इसके फॉलो-अप सुझाव अब भी मानवीय समीक्षा माँगते हैं। नीचे की रिकॉर्डिंग एक Streamlit सत्र में अनुमतियाँ, effort, जाँचें, और लागत को फॉलो करती है।
Streamlit शुरुआत से रिकंसिलिएशन को फॉलो करता है। वीडियो: लेखक द्वारा।
मुख्य रिकंसिलिएशन medium से high पर गया, 15 API कॉल्स में $0.1190 लागत आई, और 70.0 सेकंड लगे, जिनमें 69.0 सेकंड API का इंतज़ार था। अलग मैच्ड रीप्ले शामिल नहीं है। हर आँकड़ा रिस्पॉन्स usage और Claude Sonnet 5.5 रेट्स से आता है।
विस्तृत लागत ब्रेकडाउन के लिए, हमारा Claude API गाइड prॉम्प्ट कैशिंग और बैच प्रोसेसिंग कवर करता है।
input_tokens सिर्फ वही गिनता है जो कैश ब्रेकपॉइंट के बाद आया, इसलिए कुल इनपुट तीन फ़ील्ड्स का योग है, जैसा कि पहले लिंक की गई प्रॉम्प्ट कैशिंग डॉक बताती है। कैश राइट्स और रीड्स के अपने रेट्स हैं, और thinking टोकन्स पहले से ही output_tokens में शामिल हैं:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
पूरे रिकंसिलिएशन में, Claude ने 118,308 इनपुट टोकन्स में से 105,614 कैश से पढ़े (लगभग 89%), और सिर्फ 636 को अनकैश्ड इनपुट के रूप में बिल किया गया। चार टोकन रेट्स को मेज़र्ड उपयोग पर लागू किया गया है।
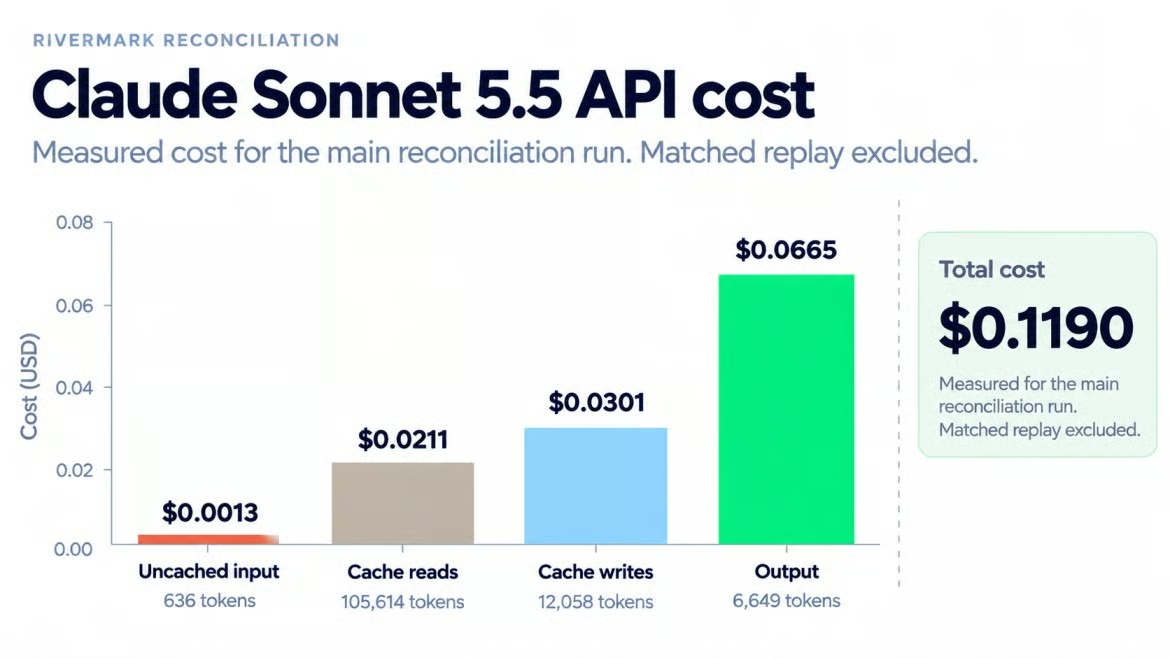
आउटपुट टोकन्स कुल लागत पर हावी हैं। चित्र: लेखक द्वारा।
Rivermark लोकल adjustment रिकॉर्ड लिखता है, इसलिए प्रोडक्शन फाइनेंस सिस्टम को अब भी ये चाहिए:
लोकल, काल्पनिक डेटा। वास्तविक क्लोज़ के लिए ऑथेंटिकेशन, ऑडिट लॉग्स, पोस्टिंग्स की मानवीय मंजूरी, और डेटा-रिटेंशन समीक्षा चाहिए।
बीटा फीचर्स। Per-message effort, टूल चेंजेज, और thinking अपडेट्स के हैडर बदल सकते हैं, इसलिए डिप्लॉयमेंट से पहले फिर टेस्ट करें।
वैरिइंग रिज़ल्ट्स। Claude Sonnet 5.5 नॉन-डिफॉल्ट टेम्परेचर को खारिज करता है, इसलिए दोहराए प्रयास अलग हो सकते हैं। भरोसा करने से पहले अपने डेटा पर पैटर्न टेस्ट करें।
हमने एक ऐसा रिकंसिलिएशन एजेंट बनाया जो read-only टूल्स से जाँच करता है, Python द्वारा प्लान अप्रूव होने के बाद ही एक write टूल पाता है, और तभी खत्म होता है जब बैंक जमाओं के खिलाफ स्वतंत्र जाँच पास हो जाती है। Claude Sonnet 5.5 ने misplaced रिफंड खुद ढूंढ लिया, लेकिन उसे $15.00 फीस पर वापस भेजने के लिए वह असफल जाँच जरूरी थी जिसे वह पहले ही पढ़ चुका था।
मैं एक काल्पनिक महीने को हर क्लोज़ पर सामान्यीकृत नहीं करूँगा। जो तरीका लागू होता है, वह है: प्लान पास होने तक write टूल छिपाएँ, बैंक रिकॉर्ड्स मॉडल के बाहर रखें, हर सुधार के लिए ट्रांजैक्शन साक्ष्य अनिवार्य करें, और टूल या effort बदलाव ऐसे जोड़ें कि कैश बना रहे।
स्वतंत्र जाँच वह हिस्सा है जिसे मैं इस प्रोजेक्ट के छोटे संस्करण में भी रखूँगा। effort बदलाव वह हिस्सा है जिसे भरोसा करने से पहले टेस्ट करूँगा—effort सेक्शन में बताये कारण से।
रीड टूल्स और अंतिम जाँच की अदला-बदली से यही पैटर्न डेटा क्लीनअप फिक्सेस, सपोर्ट रिफंड्स, या नियंत्रित दस्तावेज़ अपडेट्स को भी सँभाल सकता है। मेरा पहला विस्तार हर adjustment लिखे जाने से पहले मानवीय मंजूरी स्टेप जोड़ना होगा, क्योंकि वास्तविक क्लोज़ को इसकी ज़रूरत होती है।
Anthropic API की वे बुनियादें अभ्यास करने के लिए जिन पर यह बिल्ड टिका है, मैं recommend हमारा Introduction to Claude Models कोर्स।
DataCamp के साथ Claude का उपयोग करना सीखें!
कोर्स
कोर्स
लर्निंग पाथ