Anthropic이 Claude Opus 5.5를 라인업 최상단에 올린 지 6일 만에, 중간급 모델이 절반 가격으로 격차의 대부분을 좁혔습니다. Claude Sonnet 5.5는 한 벤치마크에서 Opus 5.5를 앞서고, 다른 항목에서도 몇 점 차로 뒤따르며, 동시에 Sonnet 5의 가격을 유지합니다.
이 패턴은 이미 여러 번 봤습니다. Claude Sonnet 5는 Opus 4.8의 에이전트형 벤치마크에 근접하면서도 비용은 훨씬 낮게 출시되었습니다. 그 이전에는 Sonnet 4.6이 같은 조건에서 Opus 4.6에 근접했습니다. 매번 플래그십이 나온 지 며칠 또는 몇 주 뒤에 중간급 모델이 등장해 절반의 가격으로 격차 대부분을 메웁니다.
이것이 외부에서 본 로그 스케일링 곡선의 모습입니다. 성능은 대략 연산량의 로그에 비례해 상승하고, 따라서 비용은 성능에 대해 대략 기하급수적으로 증가합니다. 플래그십 모델은 곡선의 최상단에 있으며, 마지막 몇 점을 사기 위해 큰 비용을 씁니다. 같은 기반 기술의 진보를 누리는 더 저렴한 모델은 몇 주 뒤에 등장해 곡선에서 더 낮은 지점만 도달하면 거의 비슷해 보입니다. 말하자면, 곡선의 대부분 가치는 여전히 저렴하고, 마지막 구간만 비싼 셈입니다.
선도 기업들이 PR과 브랜딩으로 약간의 마법을 부리는 만큼, 이 점을 짚고 넘어갈 만합니다.
요약
- Sonnet 5.5는 Anthropic의 새로운 중간급 모델로, 동일한 가격에 Sonnet 5를 대체합니다.
- 가장 두드러진 향상은 에이전트형 터미널 코딩이며, 여기서 Opus 5.5를 실제로 근소하게 앞섭니다.
- 지식 작업과 컴퓨터 사용에서는 토큰당 가격이 절반인 채로 Opus 5.5 바로 뒤에 위치합니다.
- 일상용 Claude 기본 모델로 설정하고, 개방적이며 판단이 중요한 작업에는 Opus 5.5를 유지하세요.
Claude Sonnet 5.5란?
Anthropic의 모델 문서는 Claude Sonnet 5.5를 현재 라인업에서 "속도와 지능의 최적 조합"이라고 설명합니다. Anthropic의 Claude 5.5 패밀리에서 중간급 모델로, 플래그십인 Claude Opus 5.5와 곧 출시될 Claude Haiku 5.5 사이에 위치합니다. (Haiku 5는 결국 나오지 않았지만, Haiku 5.5 소식은 계속 전하겠습니다.)
Sonnet 5와 비교하면, 점프 폭은 절반 버전 상승이 암시하는 것보다 큽니다. Opus 5.5와 Opus 5 사이의 격차가 예상보다 컸던 점을 보면 놀랍지 않습니다.
출시 글에 따르면, Anthropic은 공개한 모든 벤치마크에서 향상을 보고하며, 특히 터미널 코딩, 차트 읽기, 지식 작업 평가에서 가장 큰 도약이 있었습니다.
흥미롭게도, Anthropic은 스크린샷만으로 포켓몬 레드를 처음으로 깬 Sonnet 모델이라고 말합니다. 다소 이례적으로 들리지만, 이는 장기 과업 처리와 이미지 이해를 가늠하는 Anthropic의 대리 테스트입니다.
정리하면, 회사의 표현대로 Opus 5.5는 지속적인 판단이 필요한 복잡하고 개방형 작업에서 여전히 더 강력합니다. 하지만 Sonnet 5.5는 완료 기준이 명확한 작업에 적합한 모델로, 꽤 유용한 휴리스틱입니다.
Claude Sonnet 5.5의 핵심 기능
Sonnet 5.5의 새로운 점 대부분은 같은 일을 더 빠르고 더 적은 토큰으로 수행하는 데 초점이 있으며, API 사용자가 대비해야 할 몇 가지 변경 사항이 있습니다.
일상 작업에서 Sonnet 속도로 Opus에 근접한 결과 얻기
이전에 Opus를 써야 했던 작업을 Sonnet 5.5에 맡기고 더 빨리 받아볼 수 있습니다. Anthropic은 출력 생성이 Sonnet 5 대비 30% 이상 빨라졌으며, 작업당 사용하는 토큰도 줄었다고 말합니다. 그들이 밝힌 수치는 "작업당 최대 30% 절감"입니다.
출시 글에 인용된 초기 테스트 사용자들도 자체 수치로 이를 뒷받침합니다:
- Base44: Sonnet 5.5로 앱 빌드당 평균 3.6회 반복, Opus 5는 7.7회.
- Box: 전체 토큰 12% 감소, 실행 속도 2.4배 향상.
- Zendesk: 티켓 처리 속도 20% 향상.
- Slack: 출력 토큰 약 14% 감소.
물론 공급사가 선택한 고객 인용문입니다. 그래도 반복 횟수와 토큰 수 감소라는 일관된 패턴이 보입니다. 이는 토큰 요율과 함께 청구 금액에 큰 영향을 줍니다.
터미널과 데스크톱에서 코딩 에이전트 실행
Sonnet 5.5는 셸 명령 실행, 저장소 전반의 버그 수정, 스크린샷을 통한 데스크톱 조작 등 에이전트로 동작하도록 설계되었습니다. 출시와 동시에 Claude Code에서 사용 가능하며, Anthropic은 컴퓨터 사용 성능이 Opus 5.5에 가깝다고 설명합니다.
실무적으로는, 이제 Sonnet 5.5가 Claude Code 세션과 우리 Claude API 가이드로 직접 구축하는 에이전트 루프의 신뢰할 수 있는 기본값이 되었다는 의미입니다.
완성도 높은 문서, 슬라이드, 인터페이스 제작
Anthropic은 Sonnet 5.5의 강점으로 "날카로운 디자인 감각"을 꼽습니다. 실제로는 프런트엔드 코드를 다듬게 했을 때 더 보기 좋은 UI, 슬라이드·스프레드시트·장문 문서를 요청했을 때 더 완성도 높은 결과물을 의미합니다.
다만 이 디자인 주장은 독립적인 검증이 가장 필요한 부분입니다. 벤치마크하기 가장 어렵고, 출시 글에서도 고객 인용에 주로 의존하고 있습니다.
보안 및 생물학 관련 작업에 대한 세이프가드 예상
Sonnet 5.5는 Opus 5.5와 유사한 사이버보안 세이프가드를 탑재해 출시된 첫 Sonnet 모델입니다. 요청이 고위험 보안 작업으로 분류되면 Sonnet 5로 폴백됩니다. 생물학 관련 세이프가드는 Sonnet 5와 동일하며, Anthropic은 대부분의 소프트웨어 개발 및 생명과학 작업에는 영향이 없을 것이라고 말합니다.
또한 추론 추출을 차단하는 분류기를 포함한 첫 Sonnet이며, 생각 블록이 이를 생성한 계정과 대화에 연결됩니다. 보안 툴링을 운영한다면, 파이프라인 전환 전에 프롬프트를 반드시 테스트하세요.
약간의 코드 변경으로 Sonnet 5에서 마이그레이션
모델 ID만 바꾸면 충분하지 않습니다. Anthropic의 문서에는 Sonnet 5에서 이미 실행 중인 코드에 대해 다섯 가지 호환성 파괴 변경이 나열돼 있습니다:
-
적응형 사고가 기본값으로 켜져 있으며, 최저 설정은
between_tools로 선행 사고를 끕니다. -
도구 강제 사용은 에러를 반환합니다.
-
생각 블록은 이를 생성한 모델과 대화에 귀속됩니다.
-
구형
computer_20251124컴퓨터 사용 도구는 Claude API 및 Google Cloud에서 거부됩니다. -
advisor 도구는 더 이상 Opus 4.8, Opus 4.7, Sonnet 5를 어드바이저로 허용하지 않습니다.
조용한 변경도 있습니다. 이제 도구 호출 사이의 텍스트가 thinking 블록으로 반환됩니다. 사용자에게 텍스트를 스트리밍하는 앱은 display 설정을 업데이트하기 전까지 도구 호출 사이에 침묵하게 됩니다. 또한 temperature, top_p, top_k를 기본값이 아닌 값으로 설정하면 400 에러가 납니다. 실사용 중 발견할 수 있는 구체적 이슈입니다.
Claude Sonnet 5.5의 벤치마크 성능
Claude Sonnet 5.5는 Anthropic이 공개한 모든 벤치마크에서 Sonnet 5를 앞서고, 터미널 코딩에서는 Opus 5.5를 능가하며, 다른 항목에서는 몇 점 차로 뒤따릅니다. OpenAI의 GPT-6 Sol과 비교하면, 지식 작업 및 차트 읽기 평가에서는 앞서고 FrontierCode에서는 뒤처집니다. 아래 수치는 모두 Anthropic의 출시 글에서 인용했습니다.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Not reported |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Not reported |
| FrontierCode 1.1 (Main) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% at xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64.5% | 54.9% | 67.7% | Not reported |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Not reported |
| Chartography (no tools) | 61.6% | 15.6% | 64.4% | 53.6% |
표가 말해주는 이야기는 단순합니다. Sonnet 5 대비 큰 세대 점프, 그리고 Opus 5.5와의 근소한 격차입니다. 각 영역이 실무에 무엇을 뜻하는지 보겠습니다.
에이전트형 코딩
Terminal-Bench 4.0이 Sonnet 5.5가 두각을 보이는 곳입니다. 점수는 70.6%로 Sonnet 5의 10.3%에서 크게 올랐고, Opus 5.5의 66.4%를 앞섭니다. 이 벤치마크는 다단계 셸 워크플로 등 명령줄 환경에서 실제 작업을 완료할 수 있는지를 측정하므로, Claude Code 활용 방식과 밀접하게 맞닿아 있습니다.
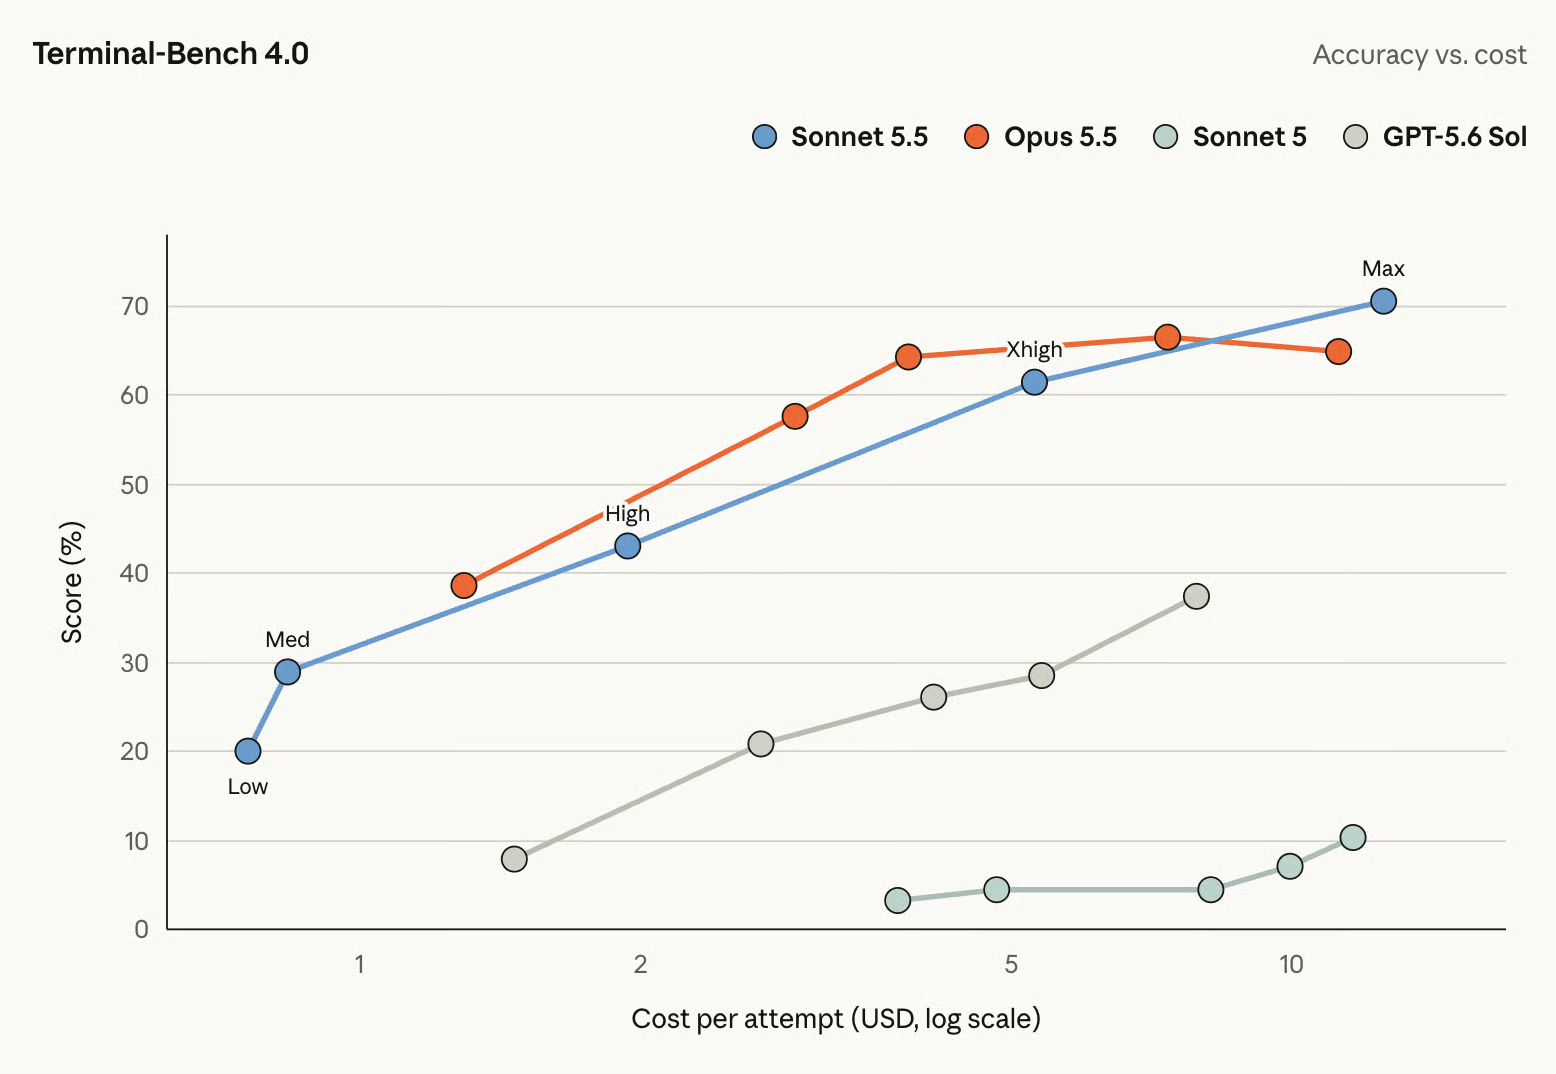
한 번의 릴리스에서 60포인트 점프는 이례적입니다. 코딩의 나머지 그림은 이만큼 드라마틱하지는 않습니다.
지식 작업
실제 직업에서 경제적 가치가 있는 과업을 Elo 방식으로 채점하는 GDPval-AA v2.1에서 Sonnet 5.5는 1844점을 기록했습니다. Opus 5.5에 2점 뒤지고, Sonnet 5보다는 거의 400점 앞섭니다.
보고서, 분석, 비즈니스 문서를 Claude로 처리하는 팀에게 표에서 가장 유용한 결과입니다. 이 영역에서 Opus 5.5의 추가 비용은 얻는 이점이 크지 않습니다.
추론과 시각 이해
도구 없이 차트를 읽고 추론하는 Chartography에서는 상대적 향상이 가장 큽니다. Sonnet 5.5는 61.6%로 Sonnet 5의 15.6% 대비 큰 폭으로 상승했습니다. Anthropic의 이미지 이해 향상 주장과 일치합니다.
컴퓨터 사용
실제 데스크톱 운영체제를 조작해 작업을 완료할 수 있는지를 측정하는 OSWorld 2.1에서 Sonnet 5.5는 80.1%에 도달했습니다. Sonnet 5의 57.0%에서 올랐고, Opus 5.5와는 2점 차입니다.
어떤 티어를 써야 할까요?
대부분의 개발자에게 이제 Sonnet 5.5가 기본 Claude 모델이어야 합니다. 작업이 충분히 개방적이어서 속도가 아니라 판단이 병목인 경우에만 Opus 5.5의 높은 가격이 타당합니다.
Anthropic의 모델 비교표에 따른 현재 라인업은 다음과 같습니다. Haiku 4.5를 제외한 네 모델 모두 100만 토큰 컨텍스트 윈도와 128K 최대 출력을 공유합니다.
| Model | Price (input / output per 1M tokens) | Latency | Best for |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Slower | 비용보다 역량이 중요한 최상위 작업 |
| Claude Opus 5.5 | $4 / $20 | Moderate | 지속적 판단이 필요한 복잡하고 개방형 작업 |
| Claude Sonnet 5.5 | $2 / $10 | Fast | 범위가 명확한 코딩, 에이전트, 문서 작업 |
| Claude Haiku 4.5 | $1 / $5 | Fastest | 대규모, 비용 민감형 작업 |
Sonnet 5.5 내에서는 effort 설정이 또 다른 지렛대입니다. Anthropic은 low, medium, high, xhigh, max의 다섯 단계로 재조정했습니다. 낮은 설정은 속도와 비용을, 높은 설정은 더 긴 추론과 자체 검증을 우선합니다. 기본값은 Claude 앱과 Claude Code에서는 medium, API에서는 high입니다.
출시 글의 한 대목은 제 사용 방식을 바꿉니다. 낮거나 중간 effort에서 Sonnet 5.5가 여러 벤치마크에서 Sonnet 5의 최고 점수를 작업당 비용 약 10분의 1로 넘습니다. 요약하면:
-
버그 수정, 리팩터링, Claude Code 세션: 기본 effort의 Sonnet 5.5.
-
고처리량 에이전트 루프와 파이프라인: Sonnet 5.5를
low또는medium으로 시작하고, 실패 시에만 effort 상향. -
명확한 스펙을 가진 어려운 코딩 문제: Opus로 가기 전 Sonnet 5.5의
xhigh또는max. -
모호하고 수일 걸리는 프로젝트: Opus 5.5.
Claude Sonnet 5.5 테스트: 실전 예시
위 벤치마크는 모두 Anthropic 자체 수치이므로, 동일한 프롬프트와 동일한 툴링으로 Claude Sonnet 5.5와 Claude Sonnet 5에 하나의 빌드 작업을 실행해 봤습니다.
작업: FiveThirtyEight의 Recent College Grads 데이터셋(미국 전공 173개, CC BY 4.0)을 단일 파일 HTML 대시보드로 변환해, 예비 학생이 수입과 고용 측면에서 카테고리를 비교하고 최고·최저 수입 전공을 찾을 수 있도록 합니다.
진짜 시험대는 데이터에 있습니다. 프롬프트에는 언급되지 않은 몇 가지 특성이 있습니다:
- 최고 소득인 석유공학은 설문 응답자가 36명에 불과하며, 173개 전공 중 76개는 100명 미만
- 소득 분포가 치우쳐 있어 단일 중앙값 막대는 많은 분산을 가립니다
- Food Science 전공은 인원 수 필드가 공란
- 직무 유형 열의 합이 취업자 수와 일치하지 않음
이 문제들을 발견하는 것이 테스트의 요지입니다. Anthropic의 "날카로운 디자인 감각" 주장도 함께 확인합니다.
주요 결과:
- 작동하는 대시보드를 낸 것은 Sonnet 5.5뿐. Sonnet 5는 cdnjs에 존재하지 않는 Chart.js 파일을 링크해(해당 URL은 404), 라이브러리가 로드되지 않았고, 일반 표를 포함한 모든 패널이 비어 렌더링됐습니다. Sonnet 5.5는 차트 라이브러리 로드 여부를 확인하고, 로드 실패 시에도 표가 동작하도록 했습니다.
- Sonnet 5.5는 소표본 함정을 대체로 포착. 응답자 30명 미만 전공에 "주의 요망" 표시를 달고 최소 응답자 수 필터를 추가했습니다. 다만 기본 뷰는 경고 없이 석유공학을 1위로 둡니다.
- Sonnet 5는 어차피 놓쳤을 것. 코드가 표본 크기와 급여 범위 열을 읽고도 사용하지 않았으며, 중앙값만으로 전공을 순위매겼습니다.
- 작은 함정은 모두 무난히 처리. 둘 다 공란인 Food Science 행을 명시적으로 처리했고, Sonnet 5.5는 직무 비율을 계산하면서 직무 열의 합이 총고용과 일치한다고 암시하지 않았습니다.
아래는 응답자 100명 이상 전공으로 필터를 설정한 Sonnet 5.5 대시보드입니다.
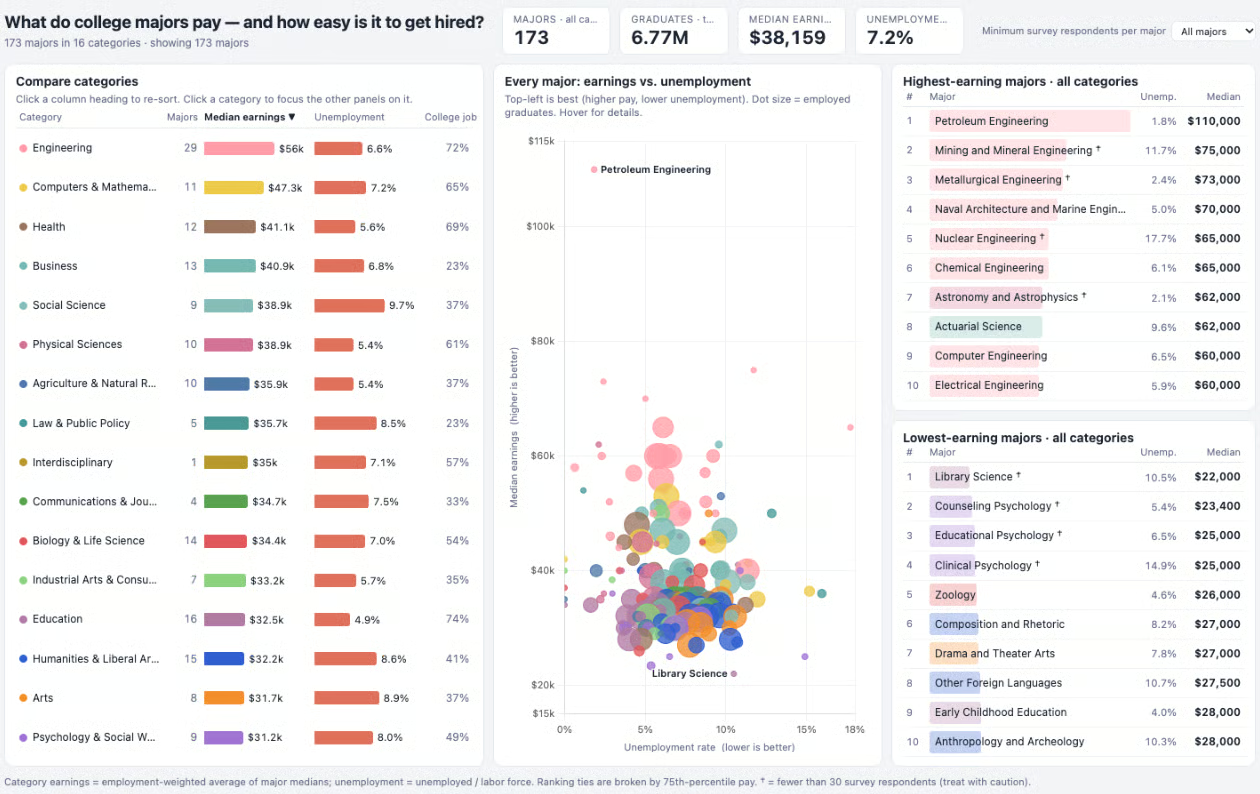
데이터 처리의 정직성 5점 만점에 4, 분석적 유용성 5, 차트·레이아웃 품질 4로 Sonnet 5.5 대시보드를 채점했습니다. 아래는 Sonnet 5의 빈 페이지입니다.
왜 Sonnet 5가 실패했을까요? 문제는 대시보드에 차트 라이브러리가 필요했는데, Sonnet 5가 cdnjs에 없는 버전을 요청했다는 점입니다. 결과는 "404" 에러였습니다. 라이브러리 없이 Sonnet 5의 코드는 "Chart is not defined"로 크래시했습니다. Sonnet 5는 페이지를 라이브러리 로드 이후에 모든 것(일반 텍스트 표까지도)이 실행되도록 작성했고, 실수를 잡아내지 못했습니다.
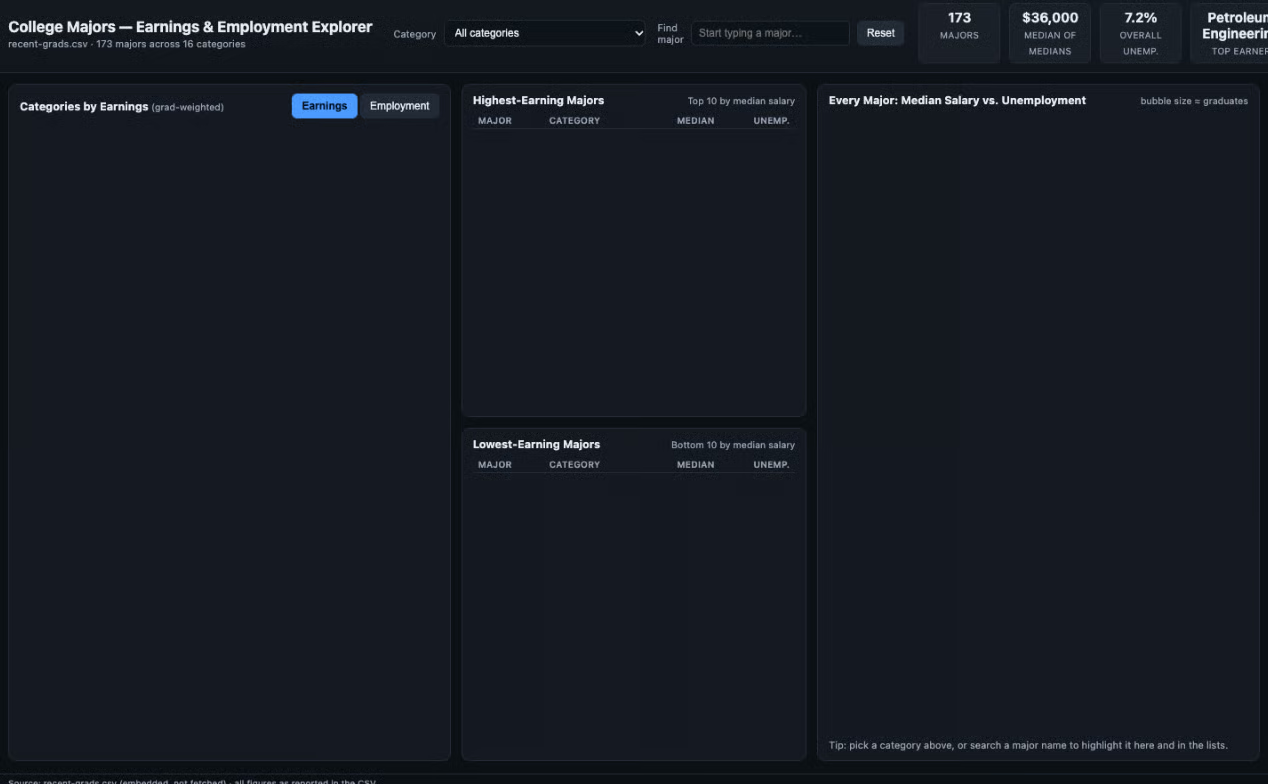
실행당 비용은 사실상 동일했습니다. Sonnet 5.5는 $0.56, Sonnet 5는 $0.57. 또한 Sonnet 5.5가 작업을 더 빨리 끝냈습니다.
그렇다면 Sonnet 5.5가 실질적인 도약일까요? 이 작업에서는 그렇습니다. Sonnet 5.5는 작동하고 희소 데이터에 경고를 주는 대시보드를 냈고, Sonnet 5는 빈 페이지를 냈습니다.
Claude Sonnet 5.5 가격 및 제공 여부
Claude Sonnet 5.5의 API 요금은 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10로 Sonnet 5와 동일하며 Opus 5.5의 절반입니다. Anthropic은 작업당 토큰 사용이 줄었다고 보고하므로, 요율이 고정돼도 실효 작업 비용은 낮아질 수 있습니다. 다만 우리의 실전 테스트에서는 두 모델 모두 작업 완료 비용이 비슷했습니다.
| Token type | Price per 1M tokens |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5-minute) | $2.50 |
| Cache write (1-hour) | $4 |
| Cache read | $0.20 |
Batch API는 입력과 출력 모두 50% 할인이 적용됩니다. 캐시 가능 최소 프롬프트는 512토큰이며, Batch API에서는 output-300k-2026-03-24 베타 헤더로 최대 30만 출력 토큰을 반환할 수 있습니다.
Sonnet 5.5는 프리뷰가 아닌 일반 제공이며, 데이터 보존 0 옵션을 지원합니다. Anthropic은 2027년 9월 28일 이전에 서비스 종료하지 않겠다고 약속합니다.
Claude Sonnet 5.5 액세스 방법
오늘 바로 Claude 앱, Claude Code, 그리고 모델 ID claude-sonnet-5-5로 API에서 Claude Sonnet 5.5를 사용할 수 있습니다. Amazon Bedrock에서는 anthropic.claude-sonnet-5-5, Google Cloud, Microsoft Foundry, AWS의 Claude Platform에서도 claude-sonnet-5-5로 제공됩니다.
아래는 최소한의 Python 호출 예시입니다. 적응형 사고가 기본으로 켜져 있어, 응답에 본문 앞서 생각 블록이 포함될 수 있습니다:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
키, 비용, 첫 프로젝트에 대한 실제 안내는 Claude API 완전 가이드를 참고하세요. 에이전트를 구축 중이라면 Claude Managed Agents 구축 튜토리얼이 다음 단계로 좋습니다. 곧 Claude Sonnet 5.5 API 튜토리얼도 발행할 예정입니다.
마무리
Anthropic은 대부분의 유료 작업, 특히 다수의 코딩 에이전트 작업이 이 새로운 중간급 모델에서 돌아가리라 보고 있습니다. 이는 Anthropic의 지식 작업 수치에서 뒤처지는 OpenAI의 GPT-6 Sol에도 직접적인 압박이 됩니다.
Sonnet 5를 사용 중이라면 지금 전환하되, API 변경 사항은 꼭 확인하세요. 무엇을 만들지 모델이 스스로 결정해야 하는 프로젝트에는 Opus 5.5를 유지하세요.
Anthropic의 모델로 빌드를 더 배우고 싶다면, Introduction to Claude Models 과정을 추천합니다.