课程
Claude 模型入门
3 小时
14.7K
Claude Sonnet 5.5 属于 Anthropic 的 Claude 5.5 系列。我开始这个项目时它刚刚发布,API 模型 ID 是 claude-sonnet-5-5。根据模型概览,它具备 100 万 token 的上下文窗口、最高 128K 输出 token、默认启用自适应思考,API 默认投入度为 high。标准定价为每百万输入 token $2、每百万输出 token $10。
我们的Claude Sonnet 5.5 概览涵盖基准、价格对比与访问方式。本次发布中有三项新的 API 功能,Rivermark 全部用到了。
Claude Sonnet 5.5 新增三种在会话运行中动态调整的方式。根据Claude Sonnet 5.5 新功能,这些在 Claude Sonnet 5 上均不可用:
Rivermark 代理是一个围绕单次 Messages API 会话构建的 Python 应用,设有两个权限级别。调查阶段,Claude 可读取订单、退款、支付通道交易、结账策略与 Rivermark 的对账检查。获批后,它只能记录已批准的调整。
Rivermark 采用自定义的 Messages API 循环,而非 Claude Agent SDK,因为审批门需要位于 Claude 的工具调用与其执行之间。
完整代码与示例数据见Rivermark GitHub 仓库。
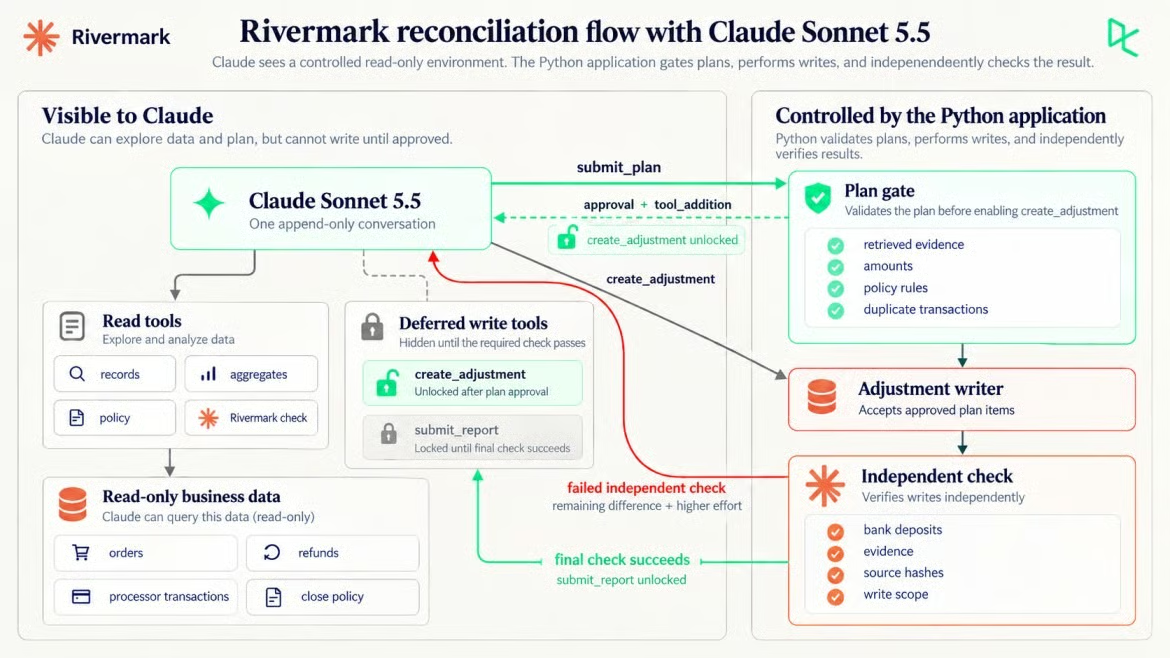
Claude 提案,Python 授权写入。作者制图。
Rivermark 的检查报告预期结算 $3,400.14,而计算的通道总额为 $3,251.14,相差 $149.00。Claude 需在看不到两个隐藏原因的情况下解释这组差异。
Rivermark 售卖三种月度套餐:Starter $29、Team $79、Business $149。示例数据包含 9 月订单 58 条、退款记录 7 条、9 月支付通道交易 65 条。每条通道记录包含金额、手续费与净额。
由 Python(而非 Claude)来判定对账是否完成:
月份为 2026 年 9 月,按照通道结算日期。
9 月银行入账合计是实验的独立结算目标。
“平衡”指预期结算加调整项与这些入账精确到美分相等。
每个调整需引用 Claude 检索到的通道 txn_ids,且其金额等于这些交易的净额。
Claude 只能添加已批准的调整并提交最终报告。
原始导出在处理前会哈希,处理后必须一致。
Claude 在初始调查阶段无法查看银行记录或目标总额。检查失败后,Python 仅披露预期结算、入账总额与剩余差额,不会展示银行记录本身。
您需要 Python 3.10 或更高版本,以及Python SDK 所要求的环境、Anthropic API 密钥,以及 anthropic 1.9.0。以下 PowerShell 命令可克隆项目、创建环境并构建示例数据:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
在 macOS 或 Linux 上,使用 source .venv/bin/activate 和 cp .env.example .env,然后将您的密钥放入 .env。我们的环境变量指南解释了这一做法。
streamlit run app_streamlit.py 可打开一个 Web 界面,实时展示对账各步骤;我们的Streamlit 教程介绍了搭建过程。
如果您的 API 密钥已经可用,请跳过下一个请求,直接进入自适应思考。
如果您不熟悉 API 请求与响应对象,请参阅我们的Python API 指南了解基础。一个退款问题就足以确认密钥并查看返回的内容块:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
在我的运行中,响应以一个 thinking 块开头。请按 type 选择块,而非读取 response.content[0];思考 token 计作输出。
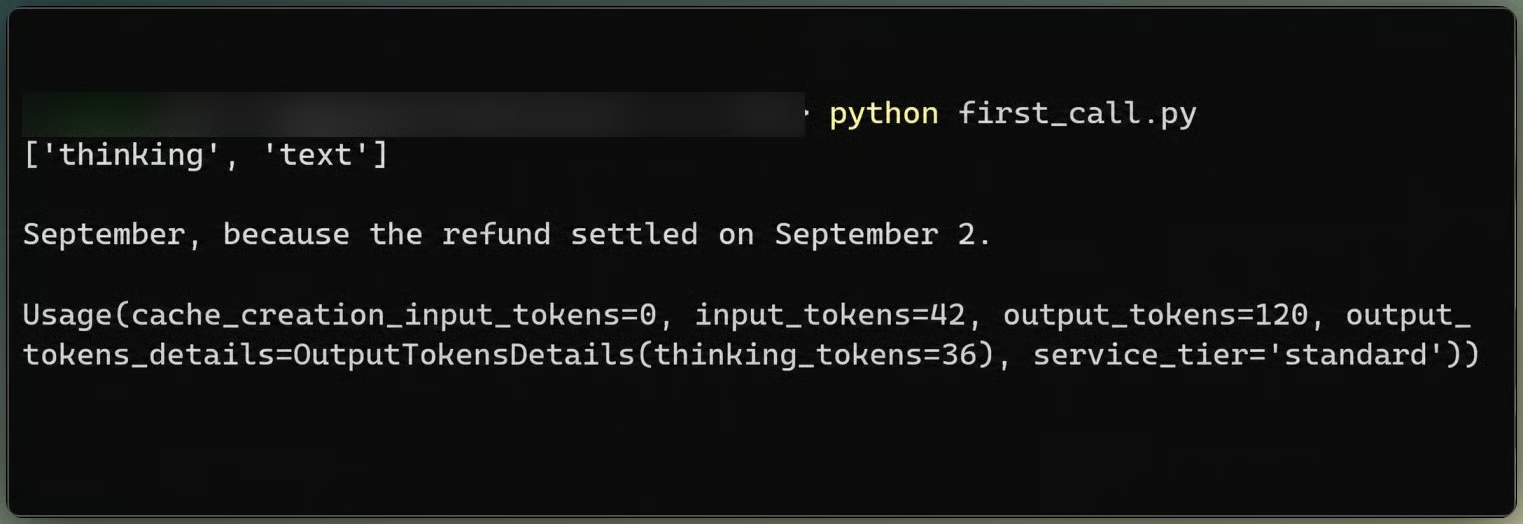
首次响应将思考与文本分离。作者截图。
每个请求发送相同的顶层设置,只有 messages 会增长:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
尽管 API 的默认值为 high,该工作流从 medium 起步。Anthropic 的投入度指南指出:“对于具备工具链能力的编程与多步工具使用,明确定义的任务从 medium 开始,更难或更长的任务再升至 high。”
思考保持自适应,因为稍后要调整投入度需要依赖它。设置 display: "updates"(测试版,thinking-display-updates-2026-08-18)可返回 Claude 在工具调用间写下的笔记。若不设置,该思考块为空。
顶层的 cache_control 打开了自动提示缓存,且会话增长时断点向前移动。第一个请求向缓存写入了 2,080 个 token,远高于 Claude Sonnet 5.5 的 512 个 token 最低标准。
只读调查代理允许 Claude 请求证据,但不暴露任何写入工具。Rivermark 也会在 Python 中拒绝未获批准的写入调用。
Claude 获得了五个读取工具与一个提案工具,均为 strict: true。描述仅说明每个工具返回什么,不告诉它去哪里找:
list_sources 返回数据源、列与行数。
query_records 从一个数据源返回最多 40 行,支持可选过滤与日期范围。
aggregate_records 按任意列统计行数与 amount_cents 合计。
read_policy 返回结账策略。
run_reconciliation_check 运行 Rivermark 现有的内部逻辑(包括其中的缺陷)。
submit_plan 将诊断与拟议调整发送至 Python 校验,不执行任何写入。
还有两个工具与其处于同一 tools 数组,但因 defer_loading: true 暂不向 Claude 显示。稍后我们将介绍它们如何出现:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
写入工具的 schema 在第一次请求时已知,因此工具会预先声明。指定命名工具或 any 工具选择会返回 400 错误,因此提示会说明何时使用 submit_plan。
我们的代理框架工程指南讲解了 Python 如何管理更长的代理循环。Rivermark 的循环会发送对话内容,在 Python 中运行任何 tool_use 块,并追加结果。读取工具返回的每个记录 ID 都会进入一个 observed 集合,供后续计划门检查:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
messages.append({"role": "user", "content": results})助理轮将原样返回,包括空的思考块。迁移指南解释说,Claude Sonnet 5.5 会将思考块绑定到较早的消息,因此编辑那段历史可能触发 400 错误。
在中等投入度下,调查用了 6 次 API 调用与 9 次读取工具调用。Claude 拉取了退款,并按 reporting_category 对通道明细分组。它找到了 RF-1043:一笔 8 月 31 日下单、9 月 2 日结算的 $149.00 退款。策略规则 POL-3 将其计入 9 月。
随后它打开了两条争议记录。TXN-50036 包含 -$149.00 本金、$15.00 手续费,以及 -$164.00 的净现金影响。TXN-50052 返还 $149.00 本金,无手续费。Claude 写道:“DSP-0077 净额为零,其 $15 费用已正确入账,因此 RF-1043 充分解释了差异。”
Claude 将返还的本金与扣费后的现金影响混淆了:
计划门驳回了 Claude 的首个计划,因为它引用了订单 ORD-20813 却未检索该订单。Claude 随后获取订单、重新提交,PLAN-1 通过并记录了一个调整。
在暴露写入工具之前,计划门会检查证据来源与计划将更改的内容。
计划中的每个调整都需引用通道 txn_id。只有当每一条被引用的明细确系本轮会话中某读取工具返回,且这些明细的净额合计等于拟议金额时,计划才会被接受:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
仅引用争议借记的一笔 $15.00 调整会失败,因为那条明细的净额是 -$164.00。计划必须同时引用冲销记录。
计划门还会检查策略规则与重复交易。若任一条目出现以下情况,计划即被驳回,写入权限保持锁定:
驳回结果以 submit_plan 工具结果返回,因此 Claude 可以进一步调查并重新提交。计划门共驳回了 4 次中的 2 次提交,Claude 随后都在下一次调用中修正。即便获批,create_adjustment 也只接受与获批条目精确匹配的写入。
一旦计划通过,Python 会追加一条 role: "system" 消息,其中包含 tool_addition 块。此变更需要 inline-tools-2026-09-15 测试版头。 tools 数组与先前所有消息保持不变,因此缓存的前缀仍可匹配。指令文本来自 Python,而非 Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
带内容的系统消息必须跟在一条 user 轮之后(包含 tool_result 也可以)。它不能位于 tool_use 与其结果之间。系统消息优先级更高,因此切勿把 Claude 的计划文本、工具输出或数据放入其中。 tool_addition 块通过引用名称 create_adjustment 指定工具,且该工具仅在计划通过后可见。
在工具变更后,缓存仍然生效。该请求处理了 231 个未缓存输入 token,并从缓存读取了 6,883 个。
首次调整本身是正确的,但仍未完成任务。Claude 记录了 ADJ-001,按 POL-3 记 -$149.00,并报告已完成。Rivermark 的内部检查也会同意,显示差额 $0.00。这听上去像是完成了,但其实并没有。
独立的 Python 检查则对比银行入账。调整后预期结算为 $3,251.14,入账为 $3,236.14,仍有 $15.00 差额。
这道缺口解释了为什么完成检查要放在 Python,而不是 Claude 的最后一条消息里。
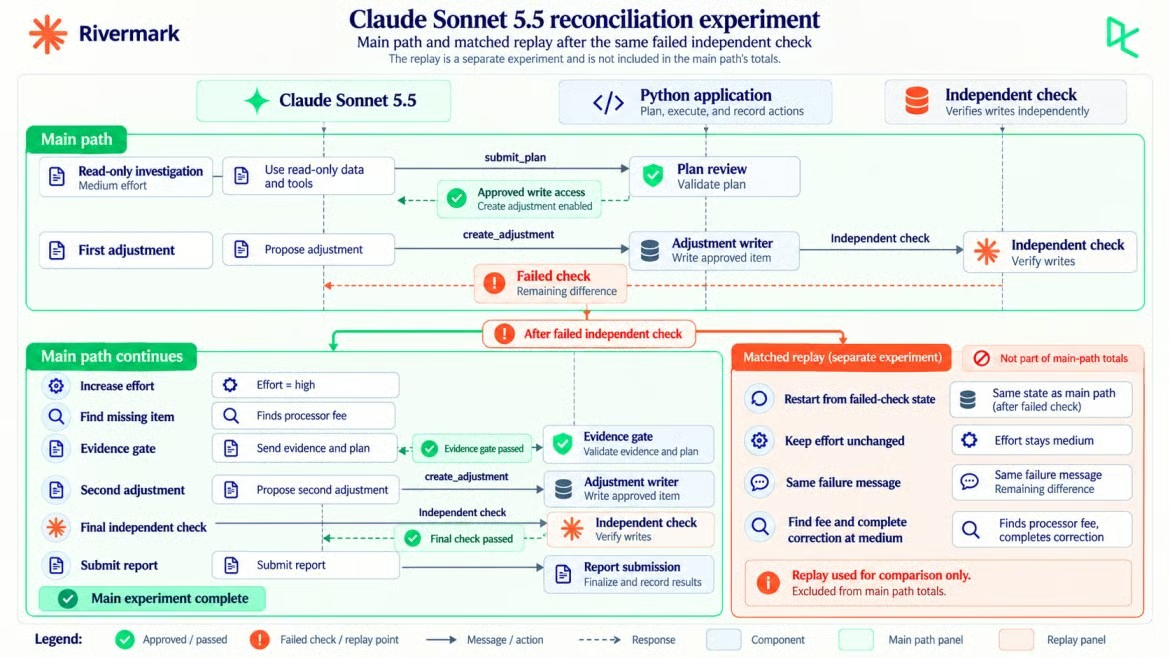
配对回放从验证失败处分支。作者制图。
在 Claude Sonnet 5.5 中途更改投入度,意味着追加一条内容为空的 content 的系统消息,并设置新的 output_config.effort。新的投入度从下一条 user 轮起生效,此前内容都可继续缓存。
按消息设置投入度处于测试阶段,需要 mid-conversation-output-config-2026-07-01 头。同时需要自适应思考:若设置为 between_tools,相同变更会返回 400 错误。当独立检查失败时,Python 会在下一条用户消息前追加新的投入度设置:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
顶层投入度变更会重启缓存,因为它属于缓存提示的一部分。按消息设置则不会:首个高投入度请求从缓存读取了 8,012 个 token,仅处理了 4 个未缓存 token。
$15.00 的差额为 Claude 提供了目标,但不是更正的证据。计划门仍要求引用 Claude 检索到的交易 ID,且其 net_cents 必须合计为 -$15.00。仅引用 TXN-50036 的 -$15.00 调整仍会失败,因为该行净额为 -$164.00。
在高投入度下,Claude 按结算批次与 fee_cents 对通道明细分组,并重跑内部检查。随后的一条笔记将手续费行合计到 12,586 美分。将争议手续费加入后,总计 14,086 美分。Rivermark 的检查将其遗漏。
它第一次修订计划因只引用借记而触发该规则。下一次同时引用两条争议明细,PLAN-2 通过,ADJ-002 按 POL-4 记录 -$15.00。
本实验并未表明 high 是必需的。一个独立回放从同一失败点继续,保留相同的对话历史与 Python 消息,但维持 medium,同样找到了该费用。
主流程的 6 次 high 投入度调用产生了 2,763 个输出 token(其中 607 为思考),花费 $0.0484。独立对照的 6 次 medium 调查调用产生了 2,713 个输出 token(其中 628 为思考),花费 $0.0464,包含同一次计划门驳回。
最后一条报告调用使对照共 7 次调用,总计 $0.0615。上述调用与成本均不计入主流程的 15 次调用与 $0.1190。
两条路径收到相同的失败检查消息,唯一区别是投入度。一次回放不足以衡量投入度的影响大小,但说明在本例中 high 并非必需。同一指南建议仅当“评测显示质量提升”时才选择 xhigh 或 max。在选用 high 前也请同样测试。
最终验证有意重复了计划门的两项检查:证据与写入范围。计划门在写入前审查提案;最终验证检查的是 Python 实际写入的内容,然后再加上数字与原始文件检查。
在 ADJ-002 之后,Python 基于原始记录、已批准的调整与银行总额重新计算了全部内容:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
四项全部通过。调整后预期结算为 $3,236.14,与入账相符。两条调整都追溯到检索到的明细,原始源数据保持不变,Python 只写入了获批条目。
此后才开始报告步骤。应用会追加一条将投入度调回 medium 的消息、一条简短用户轮,以及一条替换工具的系统消息:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
报告是最后的输出,而非证明。其后续建议仍需人工审核。 下方录屏展示了在一次 Streamlit 会话中权限、投入度、检查与成本的全过程。
Streamlit 从一开始就跟踪对账过程。作者视频。
主对账从 medium 提升到 high,耗费 $0.1190,进行了 15 次 API 调用,用时 70.0 秒(其中等待 API 69.0 秒)。单独的配对回放未计入。所有数字来自响应的 usage 与 Claude Sonnet 5.5 费率。
若需更广泛的成本拆分,请参阅我们的Claude API 指南,其中涵盖提示缓存与批处理。
input_tokens 仅统计缓存断点之后的内容,因此总输入为三个字段之和,正如前文链接的提示缓存文档所述。缓存写入与读取有各自费率,思考 token 已包含在 output_tokens 中:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
整个对账过程中,Claude 从缓存读取了 118,308 个输入 token 中的 105,614 个(约 89%),只有 636 个按未缓存输入计费。下图将四种 token 费率应用到实测用量。
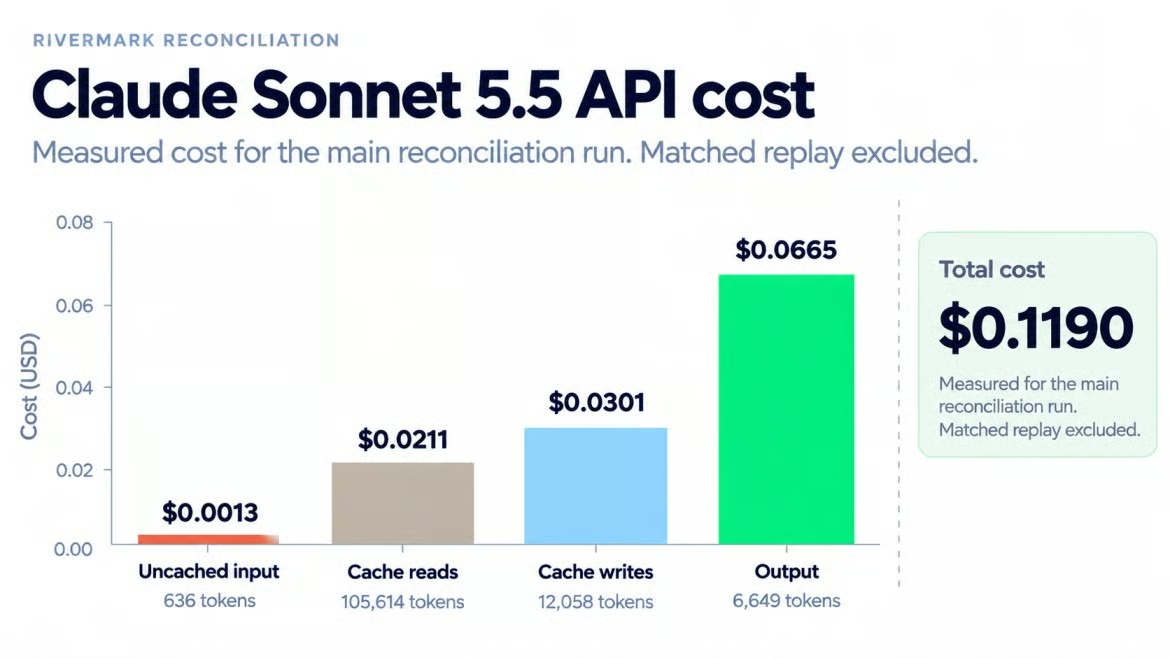
输出 token 占据主要成本。作者制图。
Rivermark 将调整记录写在本地,因此生产级财务系统仍需要:
本地、虚构数据。真实的结账需要认证、审计日志、人工审批入账,以及数据保留审查。
测试版特性。按消息投入度、工具变更与思考更新所需的头可能变化,部署前请再次测试。
结果有差异。Claude Sonnet 5.5 拒绝非默认温度,重复尝试可能不同。请先在您自己的数据上验证该模式。
我们构建了一个对账代理:用只读工具调查;在 Python 批准计划后才获得一个写入工具;只有当与银行入账的独立校验通过时才算完成。Claude Sonnet 5.5 能独立找到错放月份的退款,但需要那次失败的检查把它带回到此前已读取的 $15.00 手续费。
我不会将一个虚构月份推广到所有结账。可迁移的是方法:在计划通过前隐藏写入工具;将银行记录置于模型之外;对每个更正都要求交易证据;通过追加工具或投入度变更来保留缓存。
即便这个项目做个精简版,我也会保留独立检查。而投入度变更是我在信任前会先测试的部分,原因已在相应章节说明。
交换读取工具与最终检查,让同一模式也能处理数据清理修复、客服退款或受控文档更新。我的首个扩展会是在每次写入调整前加入人工审批,因为真实结账需要这一环节。
要练习本构建依赖的 Anthropic API 基础,我推荐我们的Claude 模型入门课程。
用 DataCamp 学习 Claude!
课程
课程
学习路径