Curso
Introdução aos modelos Claude
3 h
14.7K
O Claude Sonnet 5.5 faz parte da família Claude 5.5 da Anthropic. Ele tinha acabado de ser lançado quando iniciei este projeto, e o ID do modelo na API é claude-sonnet-5-5. De acordo com o overview do modelo, ele tem janela de contexto de 1M de tokens, até 128K tokens de saída, pensamento adaptativo ativado por padrão e esforço padrão high na API. A precificação padrão é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída.
Nosso guia do Claude Sonnet 5.5 cobre benchmarks, comparação de preços e acesso. Três recursos da API são novos nesta versão, e a Rivermark usa todos eles.
O Claude Sonnet 5.5 adiciona três formas de mudar uma conversa enquanto ela acontece. Segundo What's new in Claude Sonnet 5.5, nenhum deles está disponível no Claude Sonnet 5:
O agente Rivermark é um aplicativo Python construído em torno de uma conversa única na Messages API, com dois níveis de permissão. Durante a investigação, o Claude pode ler pedidos, reembolsos, transações do processador, a política de fechamento e a checagem de reconciliação da Rivermark. Após a aprovação, ele pode registrar apenas os ajustes aprovados.
A Rivermark usa um loop customizado da Messages API, e não o Claude Agent SDK, porque a barreira de aprovação precisa ficar entre as chamadas de ferramenta do Claude e sua execução.
O código completo e os dados de exemplo estão no repositório Rivermark no GitHub.
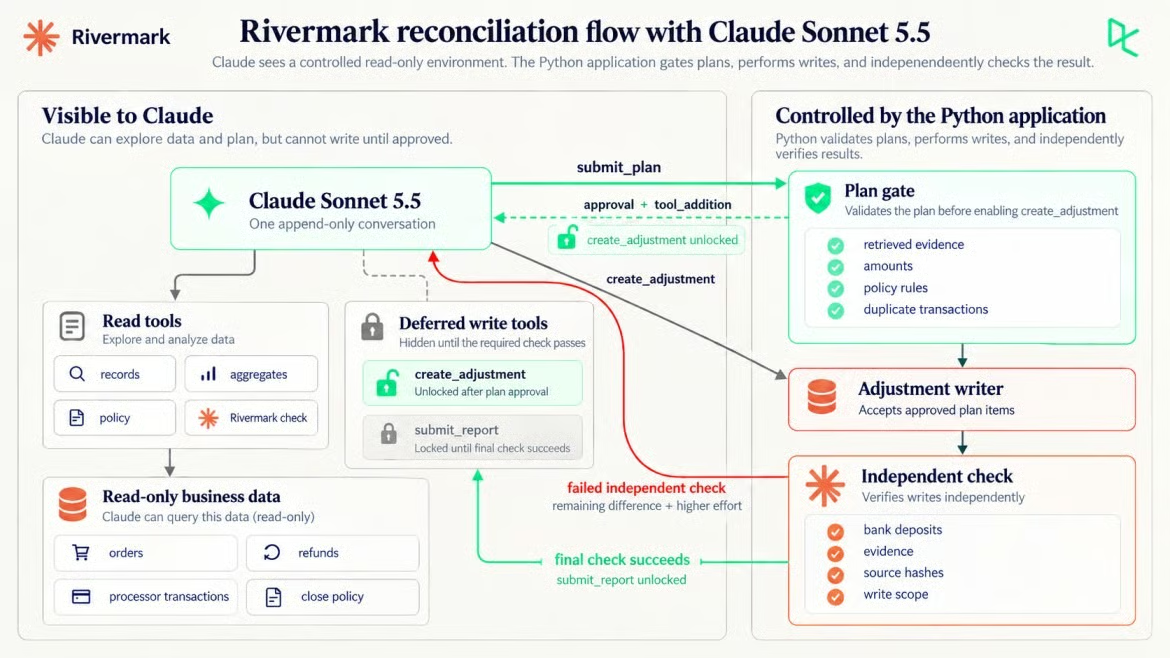
Claude propõe, Python concede acesso de escrita. Imagem do autor.
A checagem da Rivermark reporta US$ 3.400,14 como pagamento esperado e US$ 3.251,14 como total calculado do processador, uma diferença de US$ 149,00. O Claude precisa explicar a diferença entre os registros sem ver nenhuma das causas ocultas.
A Rivermark vende três planos mensais: Starter por US$ 29, Team por US$ 79 e Business por US$ 149. A amostra contém 58 pedidos de setembro, 7 registros de reembolso e 65 transações do processador em setembro. Cada registro do processador tem um valor, uma taxa e um líquido.
O Python, não o Claude, decide se a reconciliação foi concluída:
O mês é setembro de 2026, pela data de liquidação do processador.
O total dos depósitos bancários de setembro é a meta de liquidação independente do experimento.
Equilíbrio significa que o pagamento esperado mais os ajustes iguala esses depósitos no centavo.
Todo ajuste cita os txn_ids do processador que o Claude recuperou, e seu valor é igual ao líquido deles.
O Claude só pode adicionar ajustes aprovados e enviar o relatório final.
Exportações brutas são hasheadas antes do processamento e devem coincidir depois.
O Claude não pode inspecionar os registros bancários nem o total-alvo durante a investigação inicial. Após uma checagem com falha, o Python revela apenas o pagamento esperado, o total agregado de depósitos e a diferença restante, não os registros bancários em si.
Você precisa do Python 3.10 ou mais novo, o que o SDK de Python exige, uma chave da API da Anthropic e anthropic 1.9.0. Estes comandos do PowerShell clonam o projeto, criam o ambiente e geram os dados de exemplo:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
No macOS ou Linux, use source .venv/bin/activate e cp .env.example .env, depois coloque sua chave em .env. Nosso guia de variáveis de ambiente explica o padrão.
streamlit run app_streamlit.py abre uma interface web que mostra cada etapa da reconciliação em tempo real, e nosso tutorial de Streamlit cobre a configuração.
Se sua chave de API já funciona, pule a próxima requisição e vá para pensamento adaptativo.
Se objetos de requisição e resposta de API são novos para você, nosso guia de API em Python cobre o básico. Uma pergunta sobre reembolso já confirma a chave e permite inspecionar os blocos de conteúdo retornados:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Na minha execução, a resposta começou com um bloco thinking. Selecione blocos por type em vez de ler response.content[0]; tokens de thinking são cobrados como saída.
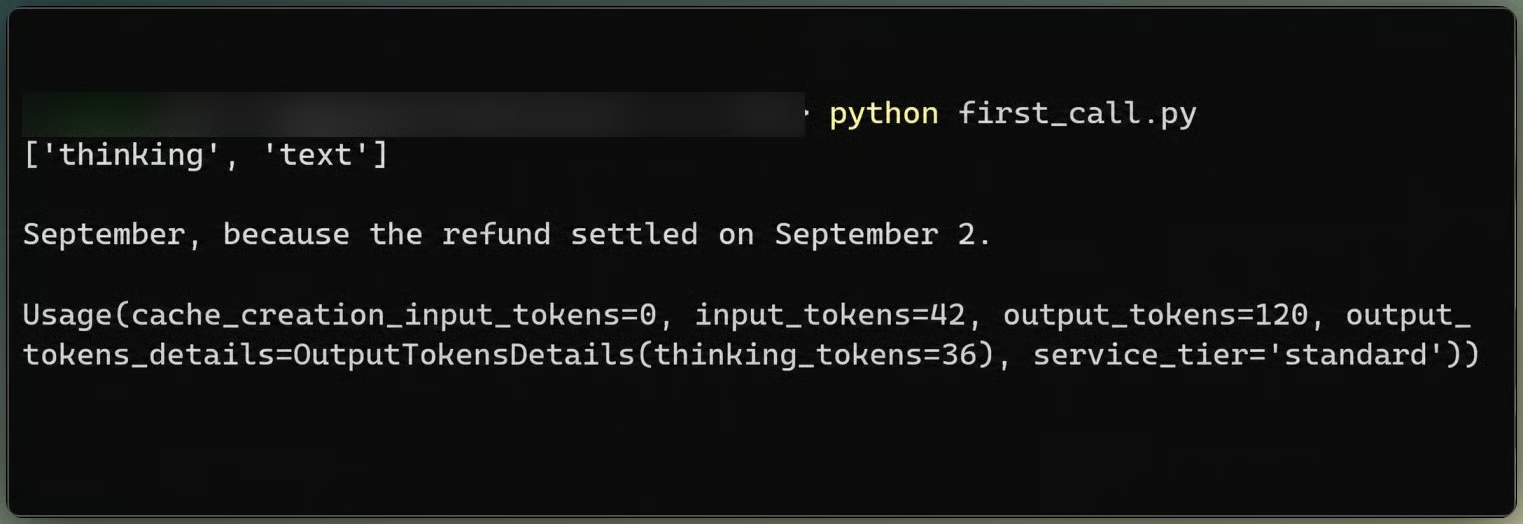
A primeira resposta separa thinking de texto. Imagem do autor.
Cada requisição envia as mesmas configurações de nível superior e só messages cresce:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Apesar do padrão high da API, este fluxo começa em medium. O guia de esforço da Anthropic diz: "Para codificação agentic e uso de ferramentas em múltiplas etapas, comece com medium para tarefas bem definidas e avance para high em casos mais difíceis ou longos."
O pensamento permanece adaptativo porque a mudança de esforço depois depende disso. display: "updates" (beta, thinking-display-updates-2026-08-18) retorna as anotações que o Claude escreve entre chamadas de ferramenta. Sem essa opção, os blocos de thinking vêm vazios.
O cache_control de nível superior liga o cache automático de prompt, com um ponto de quebra que avança conforme a conversa cresce. A primeira requisição gravou 2.080 tokens no cache, bem acima do mínimo de 512 tokens do Claude Sonnet 5.5.
Um agente de investigação somente leitura permite que o Claude solicite evidências, mas não expõe nenhuma ferramenta de escrita. A Rivermark também rejeita chamadas de escrita não aprovadas em Python.
O Claude recebe cinco ferramentas de leitura e uma de proposta, todas com strict: true. As descrições dizem o que cada ferramenta retorna e nada sobre onde procurar:
list_sources retorna fontes, colunas e contagem de linhas.
query_records retorna até 40 linhas de uma fonte, com filtro opcional e intervalo de datas.
aggregate_records conta linhas e totaliza amount_cents por qualquer coluna.
read_policy retorna a política de fechamento.
run_reconciliation_check executa a lógica interna já existente da Rivermark, com eventuais bugs.
submit_plan envia um diagnóstico e os ajustes propostos para validação em Python, sem escrever nada.
Mais duas ferramentas ficam no mesmo array de tools, mas defer_loading: true as mantém fora da visão do Claude por enquanto. Veremos como elas aparecem depois:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
O schema da ferramenta de escrita é conhecido já na primeira requisição, então a ferramenta é declarada desde o início. Escolha nomeada ou any retorna erro 400, então o prompt explica quando submit_plan se aplica.
Nosso guia de engenharia do harness de agentes explica como o Python pode gerenciar loops de agente mais longos. O loop da Rivermark envia a conversa, executa quaisquer blocos de tool_use em Python e anexa os resultados. Todo ID de registro que uma ferramenta de leitura retorna entra em um conjunto observed que o portão de plano checa depois:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
O turno do assistente volta exatamente como recebido, incluindo blocos de thinking vazios. O guia de migração explica que o Claude Sonnet 5.5 vincula blocos de thinking às mensagens anteriores, então editar esse histórico pode retornar erro 400.
Em esforço médio, a investigação levou seis chamadas de API e nove chamadas de ferramentas de leitura. O Claude puxou os reembolsos e agrupou as linhas do processador por reporting_category. Ele encontrou RF-1043, um reembolso de US$ 149,00 para um pedido de 31 de agosto liquidado em 2 de setembro. A regra de política POL-3 coloca isso em setembro.
Em seguida, ele abriu as duas linhas da disputa. TXN-50036 contém um principal de -US$ 149,00, uma taxa de US$ 15,00 e um efeito líquido de caixa de -US$ 164,00. TXN-50052 devolve o principal de US$ 149,00 sem taxa. O Claude escreveu: "DSP-0077 zera no líquido e sua taxa de $15 já está corretamente lançada, então RF-1043 explica totalmente a diferença."
O Claude confundiu a devolução do principal com o efeito de caixa após taxas:
O portão rejeitou o primeiro plano do Claude porque citava o pedido ORD-20813 sem tê-lo recuperado. O Claude buscou o pedido, reenviou e o PLAN-1 passou com um ajuste.
Antes de expor a ferramenta de escrita, o portão checa de onde vieram as evidências e o que o plano pretende mudar.
Cada ajuste em um plano cita os txn_ids do processador. O portão aceita apenas se cada linha citada voltou de uma ferramenta de leitura nesta conversa e se os líquidos dessas linhas somam o valor proposto:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Um ajuste de US$ 15,00 que cita apenas o débito da disputa falha porque o líquido dessa linha é -US$ 164,00. O plano precisa citar também a reversão.
O portão também checa regras de política e transações duplicadas. Um plano é rejeitado, e o acesso de escrita permanece bloqueado, se qualquer item fizer um destes:
As rejeições retornam como resultado da ferramenta submit_plan, então o Claude pode investigar mais e reenviar. O portão rejeitou 2 de 4 envios, e o Claude corrigiu cada um na chamada seguinte. Mesmo após a aprovação, create_adjustment aceita apenas lançamentos que correspondam exatamente a um item aprovado.
Depois que o portão aprova um plano, o Python adiciona uma mensagem role: "system" com um bloco tool_addition. A mudança exige o header beta inline-tools-2026-09-15. O array de tools e todas as mensagens anteriores permanecem inalterados, então o prefixo em cache ainda corresponde. O texto de instrução vem do Python, não do Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Uma mensagem de sistema com conteúdo precisa vir após um turno do user, incluindo um com blocos tool_result. Ela não pode ficar entre um bloco tool_use e seu resultado. Mensagens de sistema têm prioridade mais alta, então nunca insira nelas o texto do plano do Claude, saída de ferramentas ou dados. O bloco tool_addition nomeia create_adjustment por referência, e a ferramenta se torna visível só depois que o plano passa.
O cache continuou após a mudança de ferramenta. A requisição processou 231 tokens de entrada sem cache e leu 6.883 do cache.
O primeiro ajuste estava correto e, ainda assim, não concluiu o trabalho. O Claude registrou ADJ-001, -US$ 149,00 sob POL-3, e declarou tarefa concluída. A checagem interna da Rivermark teria concordado, mostrando variação de US$ 0,00. Parece finalizado, mas não é.
A checagem independente em Python compara com os depósitos bancários. O pagamento esperado após os ajustes era US$ 3.251,14, os depósitos foram US$ 3.236,14, e restaram US$ 15,00.
Essa diferença é o motivo de a verificação de conclusão viver em Python, não na mensagem final do Claude.
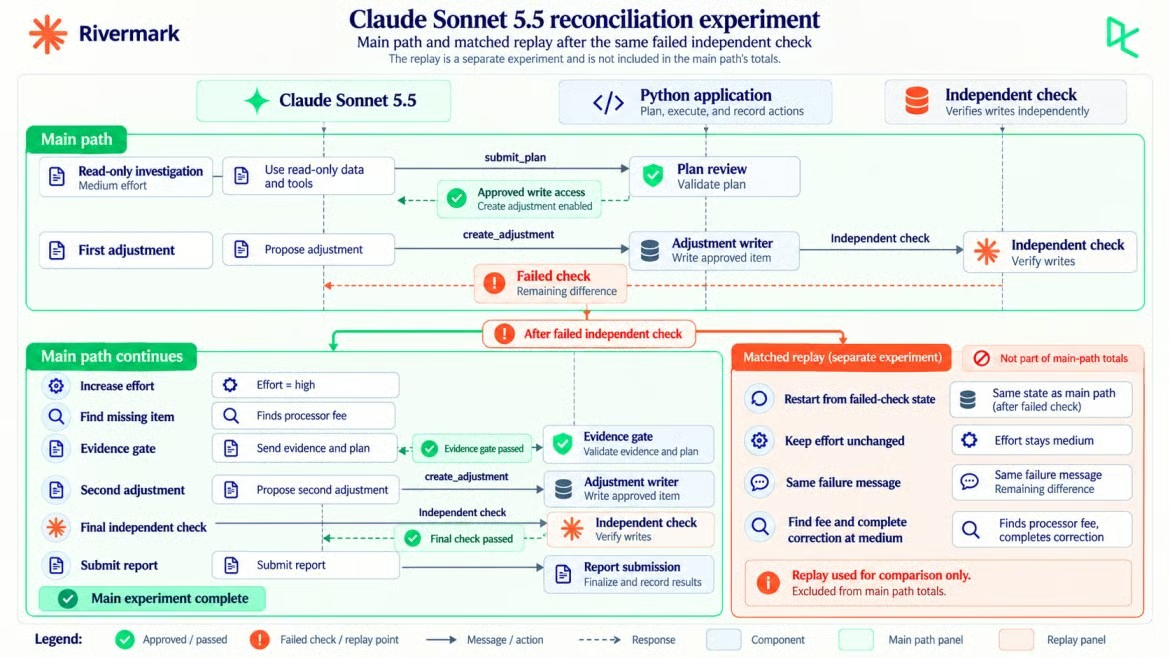
Replay equivalente bifurca a partir da verificação com falha. Imagem do autor.
Mudar o esforço no meio da conversa no Claude Sonnet 5.5 significa anexar uma mensagem de sistema com content vazio e um novo output_config.effort. O novo nível se aplica a partir do próximo turno do user, e tudo antes continua em cache.
O esforço por mensagem é beta e precisa do header mid-conversation-output-config-2026-07-01. Também precisa de pensamento adaptativo: com between_tools, a mesma mudança retorna erro 400. Quando a checagem independente falha, o Python anexa a nova configuração de esforço antes da próxima mensagem do usuário:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Uma mudança de esforço no nível superior reiniciaria o cache, já que o esforço de topo faz parte do prompt em cache. A forma por mensagem não fez isso: a primeira requisição com esforço alto leu 8.012 tokens do cache e processou 4 sem cache.
A diferença de US$ 15,00 dá ao Claude uma meta, mas não evidências para uma correção. O portão ainda exige IDs de transação que o Claude recuperou, e seus net_cents devem somar -US$ 15,00. Um ajuste proposto de -US$ 15,00 que cita apenas TXN-50036 ainda falha porque o líquido dessa linha é -US$ 164,00.
Em esforço alto, o Claude agrupou as linhas do processador por pagamento e por fee_cents, depois reexecutou a checagem interna. Sua próxima nota somou as linhas de taxa em 12.586 cents. A taxa da disputa elevou esse total para 14.086 cents. A checagem da Rivermark tinha deixado isso de fora.
Seu primeiro plano emendado esbarrou nessa regra porque citava apenas o débito. O seguinte citou as duas linhas da disputa, o PLAN-2 passou e o ADJ-002 registrou -US$ 15,00 sob POL-4.
Este experimento não mostra que high era necessário. Um replay separado continuou do mesmo ponto de falha, com o mesmo histórico de conversa e mensagem do Python, mas ficou em medium; ele também encontrou a taxa.
As seis chamadas em high da execução principal produziram 2.763 tokens de saída (607 de thinking) e custaram US$ 0,0484. As seis chamadas de investigação em medium do controle separado produziram 2.713 tokens de saída (628 de thinking) e custaram US$ 0,0464, incluindo a mesma rejeição do portão.
Uma chamada final de relatório levou o controle a 7 chamadas e US$ 0,0615 no total. Nenhuma dessas chamadas ou custos está incluída nas 15 chamadas e US$ 0,1190 da execução principal.
Ambos os caminhos receberam a mesma mensagem de falha; apenas o esforço diferiu. Um replay não mede o tamanho do efeito do esforço, mas mostra que high não foi necessário neste caso. O mesmo guia de esforço reserva xhigh e max para quando "suas avaliações mostrarem ganho de qualidade". Teste high do mesmo jeito antes de adotá-lo.
A verificação final repete de propósito 2 checagens do portão: evidência e escopo de escrita. O portão revisa uma proposta antes de escrever; a verificação final inspeciona o que o Python realmente escreveu e adiciona as checagens de números e de arquivos brutos.
Após o ADJ-002, o Python recomputou tudo a partir dos registros brutos, dos ajustes aprovados e do total bancário:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
As quatro passaram. O pagamento esperado após os ajustes foi US$ 3.236,14, batendo com os depósitos. Ambos os ajustes rastrearam linhas recuperadas, os dados-fonte brutos permaneceram inalterados e o Python escreveu apenas as entradas aprovadas.
Só então começa a etapa de relatório. O aplicativo adiciona uma mensagem que reduz o esforço de volta para medium, uma breve interação do usuário e uma mensagem de sistema que troca as ferramentas:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
O relatório é a última saída, não a prova. Suas sugestões de follow-up ainda exigem revisão humana. A gravação abaixo acompanha permissões, esforço, checagens e custo em uma sessão no Streamlit.
O Streamlit acompanha a reconciliação desde o início. Vídeo do autor.
A reconciliação principal passou de medium para high, custou US$ 0,1190 em 15 chamadas de API e levou 70,0 segundos, incluindo 69,0 segundos aguardando a API. O replay equivalente separado não está incluído. Cada número vem de usage da resposta e das tarifas do Claude Sonnet 5.5.
Para um detalhamento de custos mais amplo, nosso guia da Claude API cobre cache de prompt e processamento em lote.
input_tokens conta apenas o que veio após o ponto de quebra do cache, então a entrada total é a soma de três campos, como a documentação de cache de prompt vinculada antes explica. Escritas e leituras de cache têm suas próprias tarifas, e tokens de thinking já estão dentro de output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Ao longo da reconciliação, o Claude leu 105.614 de 118.308 tokens de entrada do cache (cerca de 89%), e apenas 636 foram cobrados como entrada sem cache. O gráfico aplica as quatro tarifas de token ao uso medido.
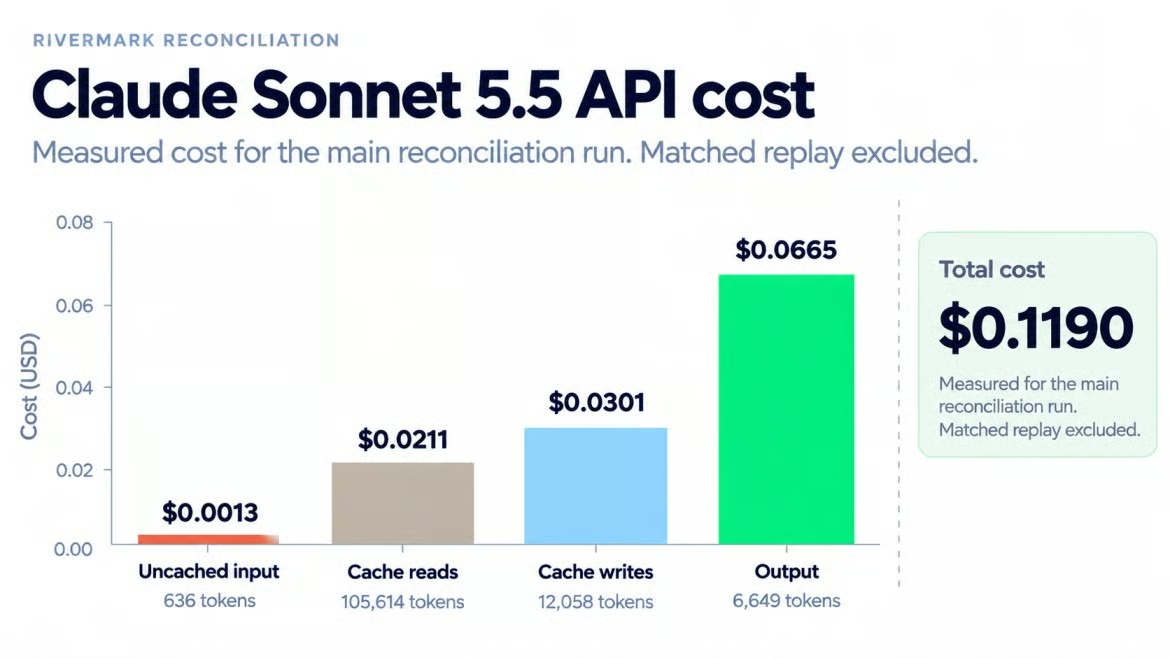
Tokens de saída dominam o custo medido. Imagem do autor.
A Rivermark grava registros locais de ajustes, então um sistema financeiro em produção ainda precisa de:
Dados locais e fictícios. Um fechamento real precisa de autenticação, trilhas de auditoria, aprovação humana de lançamentos e revisão de retenção de dados.
Recursos em beta. Os headers para esforço por mensagem, mudanças de ferramenta e updates de thinking podem mudar, então teste novamente antes de implantar.
Resultados variáveis. O Claude Sonnet 5.5 rejeita temperatura diferente do padrão, então tentativas repetidas podem variar. Teste o padrão nos seus dados antes de confiar nele.
Construímos um agente de reconciliação que investiga com ferramentas somente leitura, ganha uma ferramenta de escrita só depois que o Python aprova seu plano e só termina quando passa numa checagem independente contra depósitos bancários. O Claude Sonnet 5.5 encontrou o reembolso alocado no mês errado por conta própria, mas foi a checagem com falha que o mandou de volta à taxa de US$ 15,00 que ele já tinha lido.
Eu não generalizaria um mês fictício para todo fechamento. O que se mantém é o método: oculte a ferramenta de escrita até um plano passar, mantenha os registros bancários fora do modelo, exija evidência de transação para cada correção e anexe mudanças de ferramenta ou esforço para preservar o cache.
A checagem independente é a parte que eu manteria mesmo em uma versão menor do projeto. A mudança de esforço é a parte que eu testaria antes de confiar, pelo motivo coberto na seção de esforço.
Trocar as ferramentas de leitura e a checagem final permite que o mesmo padrão atenda a correções de limpeza de dados, reembolsos de suporte ou atualizações de documentos controladas. Minha primeira extensão seria um passo de aprovação humana antes de cada ajuste ser escrito, já que um fechamento real precisa disso.
Para praticar os fundamentos da API da Anthropic usados nesta construção, eu recomendo nosso curso Introduction to Claude Models.
Aprenda a usar o Claude com a DataCamp!
Curso
Curso
Programa
Tutorial
Abid Ali Awan
Tutorial
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
12 min
Tutorial
Moez Ali
13 min