
Cursus
Introductie tot Claude-modellen
3 uur
14.7K
Claude Sonnet 5.5 maakt deel uit van de Claude 5.5-familie van Anthropic. Het was net uitgebracht toen ik dit project startte, en het API-model-ID is claude-sonnet-5-5. Volgens de modeloverzichtspagina heeft het een contextvenster van 1M tokens, tot 128K outputtokens, standaard adaptief denken, en een standaard effort van high op de API. Standaard prijzen zijn $2 per miljoen inputtokens en $10 per miljoen outputtokens.
Ons Claude Sonnet 5.5-overzicht behandelt benchmarks, prijsvergelijkingen en toegang. Drie API-functies zijn nieuw in deze release, en Rivermark gebruikt ze allemaal.
Claude Sonnet 5.5 voegt drie manieren toe om een gesprek gaandeweg te veranderen. Volgens What’s new in Claude Sonnet 5.5 zijn ze geen van alle beschikbaar op Claude Sonnet 5:
De Rivermark-agent is een Python-applicatie rond één Messages API-gesprek met twee toestemmingsniveaus. Tijdens het onderzoek kan Claude orders, terugbetalingen, transacties van de verwerker, het sluitingsbeleid en Rivermarks reconciliatiecheck lezen. Na goedkeuring kan hij alleen de goedgekeurde aanpassingen vastleggen.
Rivermark gebruikt een eigen Messages API-lus in plaats van de Claude Agent SDK, omdat de goedkeuringspoort tussen Claude’s toolaanroepen en de uitvoering ervan moet zitten.
De volledige code en voorbeelddata staan in de Rivermark GitHub-repository.
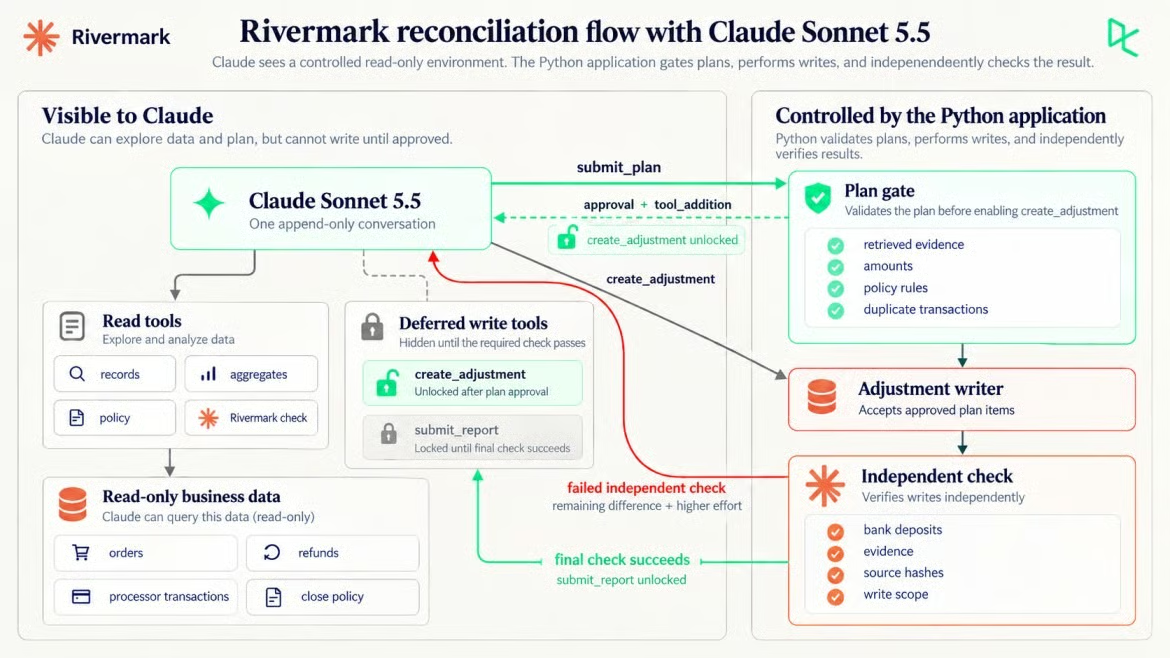
Claude doet een voorstel, Python verleent schrijfrechten. Afbeelding door de auteur.
Rivermarks check meldt $3.400,14 als de verwachte uitbetaling en $3.251,14 als de berekende totaal van de verwerker, een verschil van $149,00. Claude moet het verschil tussen de records verklaren zonder een van de verborgen oorzaken te zien.
Rivermark verkoopt drie maandabonnementen: Starter voor $29, Team voor $79 en Business voor $149. De sample bevat 58 septemberorders, 7 terugbetalingsrecords en 65 septembertransacties van de verwerker. Elk verwerkingsrecord heeft een bedrag, een fee en een nettowaarde.
Python, niet Claude, bepaalt of de afstemming voltooid is:
De maand is september 2026, op basis van de afwikkelingsdatum van de verwerker.
Het totaal aan bankstortingen in september is het onafhankelijke afwikkelingsdoel van het experiment.
In balans betekent: verwachte uitbetaling plus aanpassingen is tot op de cent gelijk aan die stortingen.
Elke aanpassing verwijst naar de door Claude opgehaalde processor-txn_ids, en het bedrag is gelijk aan hun netto.
Claude kan alleen goedgekeurde aanpassingen toevoegen en het eindrapport indienen.
Ruwe exports worden vóór verwerking gehasht en moeten erna overeenkomen.
Claude kan de bankgegevens of het doeltotaal tijdens het eerste onderzoek niet bekijken. Na een mislukte check onthult Python alleen de verwachte uitbetaling, het totale stortingsbedrag en het resterende verschil, niet de bankgegevens zelf.
Je hebt Python 3.10 of nieuwer nodig, wat de Python SDK vereist, een Anthropic API-sleutel, en anthropic 1.9.0. Deze PowerShell-opdrachten klonen het project, maken de omgeving en bouwen de voorbeelddata:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Op macOS of Linux gebruik je source .venv/bin/activate en cp .env.example .env, en zet je daarna je sleutel in .env. Onze gids voor omgevingsvariabelen legt het patroon uit.
streamlit run app_streamlit.py opent een webinterface die elke stap van de afstemming toont terwijl het gebeurt, en onze Streamlit-tutorial behandelt de setup.
Als je API-sleutel al werkt, sla de volgende request dan over en ga door naar adaptief denken.
Als API-request- en responsobjecten nieuw voor je zijn, behandelt onze Python API-gids de basis. Eén vraag over een terugbetaling is genoeg om de sleutel te bevestigen en de geretourneerde contentblokken te inspecteren:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
In mijn run begon de respons met een thinking-blok. Selecteer blokken op type in plaats van response.content[0] te lezen; thinking-tokens worden als output gefactureerd.
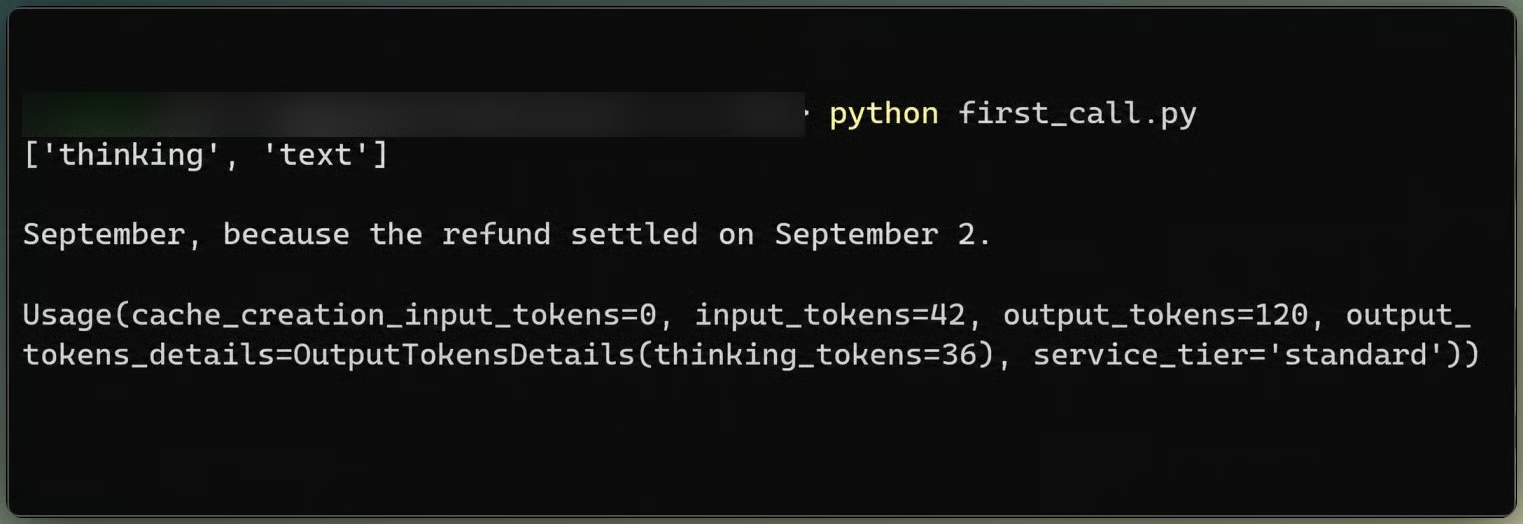
Eerste respons scheidt thinking van tekst. Afbeelding door de auteur.
Elke request verstuurt dezelfde topniveausettings, en alleen messages groeit:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Ondanks de high-standaard van de API, start deze workflow op medium. Anthropic’s effortgids zegt: "Voor agentisch coderen en meerstaps toolgebruik: begin met medium bij goed gespecificeerde taken en ga naar high voor moeilijkere of langere taken."
Thinking blijft adaptief, omdat de effortwijziging later in de build daarvan afhangt. display: "updates" (beta, thinking-display-updates-2026-08-18) retourneert de notities die Claude schrijft tussen toolcalls. Zonder die setting zijn de thinking-blokken leeg.
De top-level cache_control zet automatische promptcaching aan, met een breakpoint dat opschuift naarmate het gesprek groeit. De eerste request schreef 2.080 tokens naar de cache, ruim boven de 512-tokenminimum van Claude Sonnet 5.5.
Een read-only onderzoeksagent laat Claude om bewijs vragen maar stelt geen schrijftool bloot. Rivermark wijst ook ongeautoriseerde schrijfaanroepen in Python af.
Claude krijgt vijf leestoools en één voorsteltool, allemaal met strict: true. De beschrijvingen zeggen wat elke tool retourneert en niets over waar te zoeken:
list_sources retourneert bronnen, kolommen en rijaantallen.
query_records retourneert tot 40 rijen uit één bron, met optionele filter en datumbereik.
aggregate_records telt rijen en totaliseert amount_cents per willekeurige kolom.
read_policy retourneert het sluitingsbeleid.
run_reconciliation_check draait Rivermarks bestaande interne logica, inclusief bugs.
submit_plan stuurt een diagnose en voorgestelde aanpassingen naar Python voor validatie, en schrijft niets weg.
Nog twee tools staan in dezelfde tools-array, maar defer_loading: true houdt ze voorlopig buiten Claude’s zicht. Later leggen we uit hoe ze zichtbaar worden:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Het schema van de schrijftool is bij de eerste request al bekend, dus de tool wordt vooraf gedeclareerd. Gekozen tool op naam of any geeft een 400-fout, dus de prompt legt uit wanneer submit_plan van toepassing is.
Onze gids voor agent harness engineering legt uit hoe Python langere agentlussen kan beheren. Rivermarks lus verstuurt het gesprek, draait eventuele tool_use-blokken in Python en voegt de resultaten toe. Elk record-ID dat een leestoool retourneert, gaat in een observed-set die de planningspoort later controleert:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
De beurt van de assistant gaat exact terug zoals ontvangen, lege thinking-blokken inbegrepen. De migratiegids legt uit dat Claude Sonnet 5.5 thinking-blokken bindt aan eerdere berichten, dus het bewerken van die geschiedenis kan een 400-fout geven.
Bij medium kostte het onderzoek zes API-calls en negen leestoool-calls. Claude haalde de terugbetalingen op en groepeerde de verwerkingsregels per reporting_category. Hij vond RF-1043, een terugbetaling van $149,00 voor een order van 31 augustus die op 2 september werd afgehandeld. Beleid POL-3 plaatst die in september.
Daarna opende hij beide disputeregels. TXN-50036 bevat een -$149,00 hoofdbedrag, $15,00 aan kosten en een netto kaseffect van -$164,00. TXN-50052 boekt de $149,00 aan hoofdsom terug zonder kosten. Claude schreef: "DSP-0077 komt op nul uit en de $15 fee is al correct geboekt, dus RF-1043 verklaart het verschil volledig."
Claude verwarde de teruggeboekte hoofdsom met het kaseffect na kosten:
De poort wees Claude’s eerste plan af omdat het order ORD-20813 aanhaalde zonder die op te halen. Claude haalde de order op, diende opnieuw in en PLAN-1 werd goedgekeurd met één aanpassing.
Voordat de schrijftool wordt getoond, controleert de poort waar het bewijs vandaan komt en wat het plan zou veranderen.
Elke aanpassing in een plan noemt processor-txn_ids. De poort accepteert het alleen als elke aangehaalde regel in dit gesprek door een leestoool is teruggegeven en de regels samen optellen tot het voorgestelde bedrag:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Een aanpassing van $15,00 die alleen het debet van de dispute aanhaalt, faalt omdat het netto van die regel -$164,00 is. Het plan moet ook de terugboeking noemen.
De poort controleert ook beleidsregels en dubbele transacties. Een plan wordt afgewezen, en schrijfrechten blijven op slot, als een item een van deze dingen doet:
Afwijzingen komen terug als het resultaat van de submit_plan-tool, zodat Claude verder kan onderzoeken en opnieuw kan indienen. De poort wees 2 van de 4 inzendingen af, en Claude corrigeerde elke keer in de volgende call. Zelfs na goedkeuring accepteert create_adjustment alleen entries die exact overeenkomen met een goedgekeurd item.
Zodra de poort een plan goedkeurt, voegt Python een role: "system"-bericht toe met een tool_addition-blok. De wijziging vereist de inline-tools-2026-09-15-betaheader. De tools-array en elk eerder bericht blijven ongewijzigd, zodat de gecachete prefix nog steeds overeenkomt. De instructietekst komt van Python, niet van Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Een systeembericht met content moet volgen op een user-beurt, ook eentje met tool_result-blokken. Het kan niet tussen een tool_use-blok en het resultaat zitten. Systeemberichten hebben hogere prioriteit, dus zet nooit Claude’s plannentekst, tooloutput of data in zo’n bericht. Het tool_addition-blok noemt create_adjustment via referentie, en de tool wordt pas zichtbaar nadat het plan is goedgekeurd.
Caching ging door na de toolwijziging. De request verwerkte 231 niet-gecachete inputtokens en las 6.883 uit de cache.
De eerste aanpassing was correct en liet het werk toch onvoltooid. Claude legde ADJ-001 vast, -$149,00 onder POL-3, en meldde dat het klaar was. Rivermarks interne check zou het ermee eens zijn geweest en $0,00 verschil tonen. Dat klinkt af, maar dat is het niet.
De onafhankelijke Python-check vergelijkt in plaats daarvan met bankstortingen. Verwachte uitbetaling na aanpassingen was $3.251,14, stortingen waren $3.236,14, en $15,00 bleef over.
Dat gat is de reden dat de afrondingscontrole in Python zit en niet in Claude’s laatste bericht.
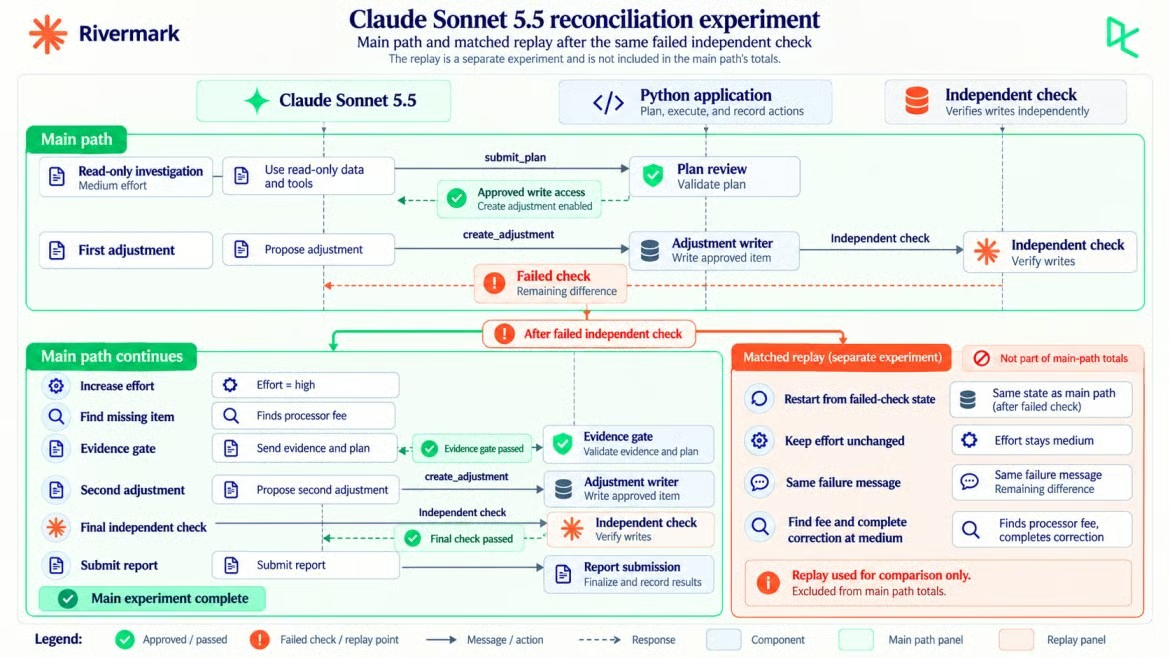
Matched replay vertakt vanaf mislukte verificatie. Afbeelding door de auteur.
Effort midden in het gesprek wijzigen op Claude Sonnet 5.5 betekent dat je een systeembericht toevoegt met lege content en een nieuwe output_config.effort. Het nieuwe niveau geldt vanaf de volgende user-beurt, en alles ervoor blijft gecachet.
Effort per bericht is in beta en vereist de mid-conversation-output-config-2026-07-01-header. Het vereist ook adaptief denken: met between_tools geeft dezelfde wijziging een 400-fout. Wanneer de onafhankelijke check faalt, voegt Python de nieuwe effortsetting toe vóór het volgende user-bericht:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Een topniveaueffortwijziging zou de cache herstarten, omdat topniveaueffort deel uitmaakt van de gecachete prompt. De per-berichtvorm deed dat niet: de eerste request met high-effort las 8.012 tokens uit de cache en verwerkte er 4 ongecachet.
Het verschil van $15,00 geeft Claude een doel, maar geen bewijs voor een correctie. De poort vereist nog steeds transactie-ID’s die Claude heeft opgehaald, en hun net_cents moeten samen -$15,00 zijn. Een voorgestelde aanpassing van -$15,00 die alleen TXN-50036 noemt, faalt nog steeds omdat het netto van die regel -$164,00 is.
Bij high groepeerde Claude de verwerkingsregels per uitbetaling en per fee_cents, en draaide de interne check opnieuw. Zijn volgende notitie telde de feeregels op tot 12.586 cent. De disputekosten verhoogden dat totaal tot 14.086 cent. Rivermarks check had die weggelaten.
Het eerste aangepaste plan raakte die regel omdat het alleen het debet noemde. Het volgende noemde beide disputeregels, PLAN-2 werd goedgekeurd, en ADJ-002 legde -$15,00 vast onder POL-4.
Dit experiment laat niet zien dat high noodzakelijk was. Een aparte replay ging verder vanaf hetzelfde faalmoment met dezelfde gespreksgeschiedenis en Python-bericht, maar bleef op medium; die vond de kosten ook.
De zes calls met high-effort in de hoofdrun produceerden 2.763 outputtokens (607 thinking) en kostten $0,0484. De zes medium-effort onderzoekscalls van de aparte controle produceerden 2.713 outputtokens (628 thinking) en kostten $0,0464, inclusief dezelfde afwijzing door de poort.
Eén laatste rapportcall bracht de controle op 7 calls en $0,0615 in totaal. Geen van die calls of kosten is opgenomen in de 15 calls en $0,1190 van de hoofdrun.
Beide paden kregen hetzelfde bericht na de mislukte check; alleen hun effort verschilde. Eén replay kan de omvang van een eventuele effortimpact niet meten, maar laat wel zien dat high voor dit geval niet nodig was. Dezelfde effortgids reserveert xhigh en max voor gevallen waar "je evaluaties een kwaliteitswinst laten zien." Test high op dezelfde manier voordat je het selecteert.
De laatste verificatie herhaalt bewust 2 poortcontroles: bewijs en schrijfscope. De poort beoordeelt een voorstel vóór het schrijven; de laatste verificatie inspecteert wat Python daadwerkelijk heeft geschreven en voegt daarna de getallen- en ruwe-bestandscontroles toe.
Na ADJ-002 herberekende Python alles op basis van de ruwe records, de goedgekeurde aanpassingen en het banktotaal:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Alle vier slaagden. Verwachte uitbetaling na aanpassingen was $3.236,14, gelijk aan de stortingen. Beide aanpassingen waren te herleiden tot opgehaalde regels, de ruwe brondata bleven ongewijzigd, en Python schreef alleen de goedgekeurde entries.
Pas dan start de rapportstap. De applicatie voegt een bericht toe dat de effort terugzet naar medium, een korte user-beurt, en een systeembericht dat de tools verwisselt:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Het rapport is de laatste output, niet het bewijs. De vervolgsuggesties vergen nog steeds menselijke beoordeling. De opname hieronder volgt permissies, effort, checks en kosten in één Streamlit-sessie.
Streamlit volgt de afstemming vanaf het begin. Video door de auteur.
De hoofdafstemming ging van medium naar high, kostte $0,1190 over 15 API-calls en duurde 70,0 seconden, waarvan 69,0 seconden wachttijd op de API. De aparte matched replay is niet meegerekend. Elk cijfer komt uit usage van de respons en de tarieven van Claude Sonnet 5.5.
Voor een bredere kostenanalyse behandelt onze Claude API-gids promptcaching en batchverwerking.
input_tokens telt alleen wat ná het cachebreakpoint kwam, dus totale input is de som van drie velden, zoals de eerder gelinkte promptcachingdocs uitleggen. Cachewrites en -reads hebben eigen tarieven, en thinking-tokens zitten al in output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Gedurende de afstemming las Claude 105.614 van de 118.308 inputtokens uit de cache (ongeveer 89%), en slechts 636 werden als ongecachete input gefactureerd. De grafiek past de vier tokenpercentages toe op het gemeten gebruik.
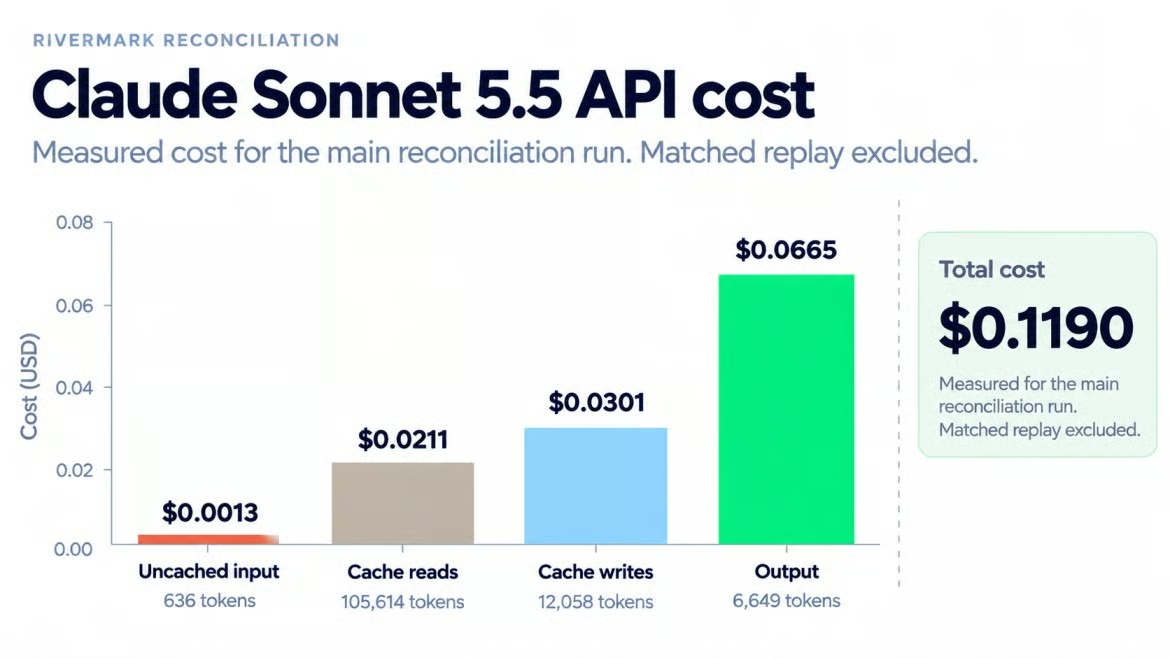
Outputtokens domineren de gemeten kosten. Afbeelding door de auteur.
Rivermark schrijft lokale aanpassingsrecords, dus een productiesysteem voor finance heeft nog steeds nodig:
Lokale, fictieve data. Een echte sluiting vereist authenticatie, auditlogs, menselijke goedkeuring van boekingen en een beoordeling van gegevensbewaring.
Betafuncties. De headers voor effort per bericht, toolwijzigingen en thinking-updates kunnen veranderen, dus test ze opnieuw voor uitrol.
Variërende resultaten. Claude Sonnet 5.5 wijst niet-standaard temperatuur af, dus herhaalde pogingen kunnen verschillen. Test het patroon op je eigen data voordat je erop vertrouwt.
We hebben een reconciliatie-agent gebouwd die onderzoekt met read-only tools, pas één schrijftool krijgt nadat Python het plan goedkeurt, en pas klaar is wanneer een onafhankelijke check tegen bankstortingen slaagt. Claude Sonnet 5.5 vond de verkeerd geplaatste terugbetaling zelf, maar die mislukte check was nodig om hem terug te sturen naar de $15,00 aan kosten die hij al had gelezen.
Ik zou één fictieve maand niet veralgemeniseren naar elke sluiting. Wat overdraagbaar is, is de methode: verberg de schrijftool tot een plan slaagt, houd de bankgegevens buiten het model, eis transactie-evidence voor elke correctie, en voeg tool- of effortwijzigingen toe zodat de cache behouden blijft.
De onafhankelijke check is het deel dat ik zelfs in een kleinere versie zou behouden. De effortwijziging is het deel dat ik zou testen vóór ik het vertrouw, om de reden die in de effortsectie wordt behandeld.
Door de leertools en de eindcontrole te wisselen kan hetzelfde patroon datacleanup-fixes, supportterugbetalingen of gecontroleerde documentupdates afhandelen. Mijn eerste uitbreiding zou een stap met menselijke goedkeuring zijn vóór elke geschreven aanpassing, omdat een echte sluiting die nodig heeft.
Om de Anthropic API-basics te oefenen waarop deze build steunt, raad ik onze Introduction to Claude Models-cursus aan.
Leren werken met Claude via DataCamp!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

