Kursus
Pengantar Model Claude
3 jam
14.7K
Claude Sonnet 5.5 adalah bagian dari keluarga Claude 5.5 milik Anthropic. Model ini baru saja dirilis ketika saya memulai proyek ini, dan ID model API-nya adalah claude-sonnet-5-5. Menurut ikhtisar model, model ini memiliki jendela konteks 1 juta token, hingga 128K token keluaran, adaptive thinking aktif secara default, dan effort default high pada API. Harga standar adalah $2 per juta token input dan $10 per juta token output.
Ulasan Claude Sonnet 5.5 kami membahas tolok ukur, perbandingan harga, dan akses. Tiga fitur API-nya baru di rilis ini, dan Rivermark menggunakan semuanya.
Claude Sonnet 5.5 menambahkan tiga cara untuk mengubah percakapan saat berjalan. Menurut Apa yang baru di Claude Sonnet 5.5, tidak ada satupun yang tersedia di Claude Sonnet 5:
Agen Rivermark adalah aplikasi Python yang dibangun di sekitar satu percakapan Messages API dengan dua tingkat izin. Selama investigasi, Claude dapat membaca pesanan, pengembalian dana, transaksi pemroses, kebijakan penutupan, dan pemeriksaan rekonsiliasi Rivermark. Setelah disetujui, ia hanya dapat mencatat penyesuaian yang disetujui.
Rivermark menggunakan loop Messages API kustom alih-alih Claude Agent SDK karena gerbang persetujuan harus berada di antara panggilan alat Claude dan eksekusinya.
Kode lengkap dan data contoh ada di repositori GitHub Rivermark.
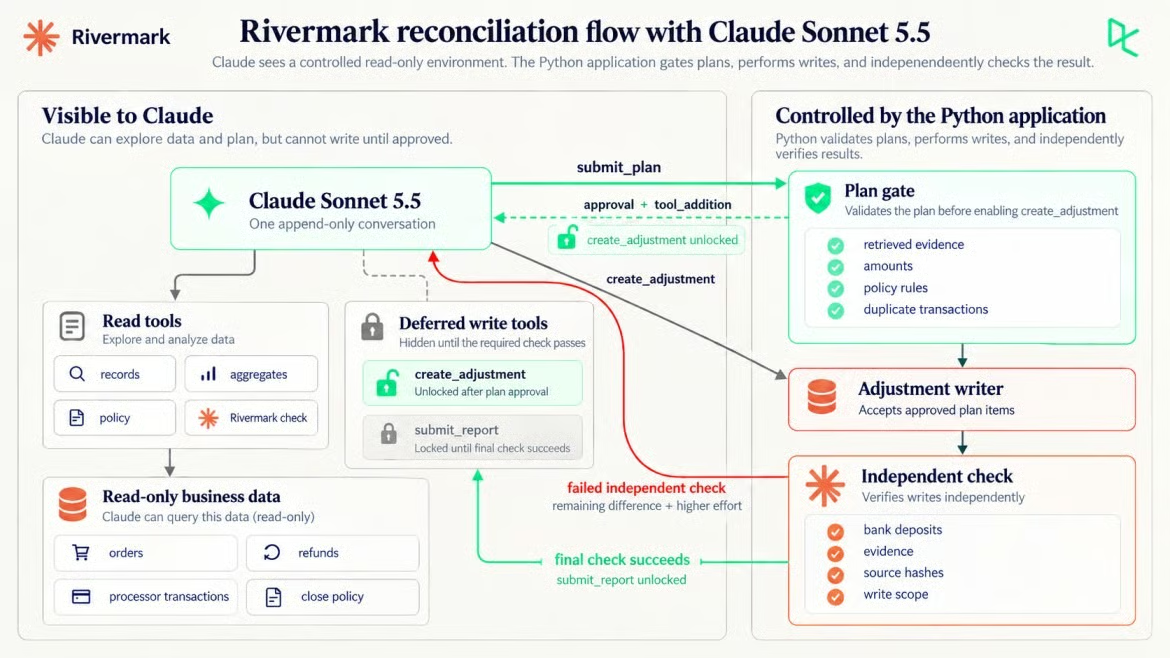
Claude mengusulkan, Python memberi akses tulis. Gambar oleh Penulis.
Pemeriksaan Rivermark melaporkan $3.400,14 sebagai payout yang diharapkan dan $3.251,14 sebagai total pemroses yang dihitung, selisih $149,00. Claude harus menjelaskan perbedaan antar catatan tanpa melihat kedua penyebab tersembunyi.
Rivermark menjual tiga paket bulanan: Starter $29, Team $79, dan Business $149. Sampel berisi 58 pesanan September, 7 catatan pengembalian dana, dan 65 transaksi pemroses September. Setiap catatan pemroses memiliki jumlah, biaya, dan nilai bersih.
Python, bukan Claude, yang menentukan apakah rekonsiliasi selesai:
Bulan adalah September 2026, berdasarkan tanggal penyelesaian pemroses.
Total setoran bank bulan September adalah target penyelesaian independen eksperimen.
Seimbang berarti payout yang diharapkan plus penyesuaian sama dengan setoran tersebut hingga ke sen.
Setiap penyesuaian menyebut txn_ids pemroses yang diambil Claude, dan jumlahnya sama dengan nilai bersihnya.
Claude hanya dapat menambahkan penyesuaian yang disetujui dan mengirim laporan akhir.
Ekspor mentah di-hash sebelum pemrosesan dan harus cocok sesudahnya.
Claude tidak dapat memeriksa catatan bank atau total target selama investigasi awalnya. Setelah pemeriksaan gagal, Python hanya menampilkan payout yang diharapkan, total setoran agregat, dan selisih yang tersisa, bukan catatan banknya.
Anda memerlukan Python 3.10 atau lebih baru, yaitu Python SDK memerlukan, kunci Anthropic API, dan anthropic 1.9.0. Perintah PowerShell berikut mengkloning proyek, membuat environment, dan membangun data sampel:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Di macOS atau Linux, gunakan source .venv/bin/activate dan cp .env.example .env, lalu masukkan kunci Anda ke .env. Panduan variabel environment kami menjelaskan polanya.
streamlit run app_streamlit.py membuka antarmuka web yang menampilkan setiap langkah rekonsiliasi saat berlangsung, dan panduan Streamlit kami membahas pengaturannya.
Jika kunci API Anda sudah berfungsi, lewati permintaan berikut dan lanjutkan ke adaptive thinking.
Jika objek permintaan dan respons API masih baru bagi Anda, panduan API Python kami membahas dasar-dasarnya. Satu pertanyaan tentang pengembalian dana sudah cukup untuk mengonfirmasi kunci dan memeriksa blok konten yang dikembalikan:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Dalam percobaan saya, respons dimulai dengan blok thinking. Pilih blok berdasarkan type alih-alih membaca response.content[0]; token thinking ditagih sebagai output.
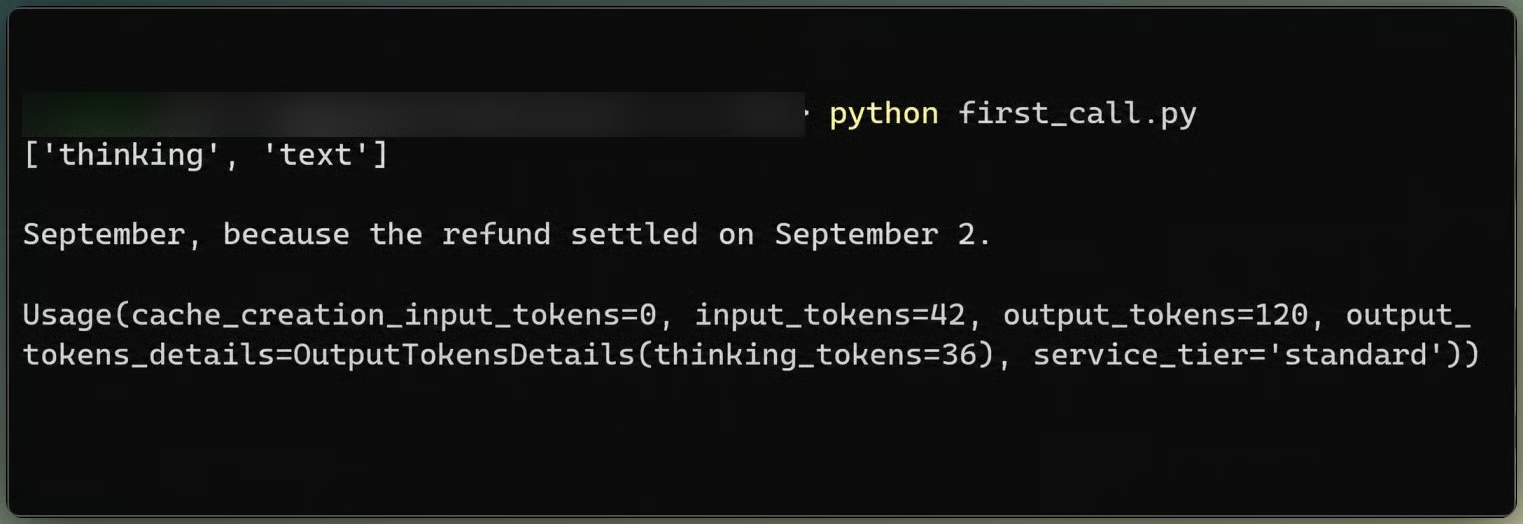
Respons pertama memisahkan thinking dari teks. Gambar oleh Penulis.
Setiap permintaan mengirim pengaturan tingkat atas yang sama, dan hanya messages yang bertambah:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Terlepas dari default API yang high, alur kerja ini dimulai pada medium. Panduan effort Anthropic menyatakan: "Untuk pengodean agentik dan penggunaan alat multilangkah, mulai dengan medium untuk tugas yang terdefinisi jelas dan beralih ke high untuk yang lebih sulit atau lebih panjang."
Thinking tetap adaptif karena perubahan effort nanti mengandalkannya. display: "updates" (beta, thinking-display-updates-2026-08-18) mengembalikan catatan yang ditulis Claude di antara panggilan alat. Tanpa pengaturan tersebut, blok thinking kosong.
Properti tingkat atas cache_control mengaktifkan prompt caching otomatis, dengan breakpoint yang bergerak maju seiring perkembangan percakapan. Permintaan pertama menulis 2.080 token ke cache, jauh di atas minimum 512 token milik Claude Sonnet 5.5.
Agen investigasi baca-saja memungkinkan Claude meminta bukti tetapi tidak mengekspos alat tulis. Rivermark juga menolak panggilan tulis yang tidak disetujui di Python.
Claude mendapatkan lima alat baca dan satu alat proposal, semuanya dengan strict: true. Deskripsinya hanya menyebutkan apa yang dikembalikan tiap alat dan tidak menyebut di mana mencarinya:
list_sources mengembalikan sumber, kolom, dan jumlah baris.
query_records mengembalikan hingga 40 baris dari satu sumber, dengan filter opsional dan rentang tanggal.
aggregate_records menghitung jumlah baris dan total amount_cents berdasarkan kolom apa pun.
read_policy mengembalikan kebijakan penutupan.
run_reconciliation_check menjalankan logika internal rekonsiliasi Rivermark yang ada, termasuk bug-nya.
submit_plan mengirim diagnosis dan penyesuaian yang diusulkan ke Python untuk validasi, tanpa menulis apa pun.
Dua alat lagi berada dalam array tools yang sama, tetapi defer_loading: true membuatnya belum terlihat oleh Claude. Nanti kita bahas bagaimana alat-alat tersebut muncul:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Skema alat tulis sudah diketahui pada permintaan pertama, jadi alatnya dideklarasikan sejak awal. Pilihan alat bernama atau any mengembalikan error 400, jadi prompt menyatakan kapan submit_plan berlaku.
Panduan rekayasa agent harness kami menjelaskan bagaimana Python dapat mengelola loop agen yang lebih panjang. Loop Rivermark mengirim percakapan, menjalankan blok tool_use apa pun di Python, dan menambahkan hasilnya. Setiap ID catatan yang dikembalikan alat baca dimasukkan ke dalam himpunan observed yang akan diperiksa gerbang rencana nanti:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Giliran asisten dikembalikan persis seperti diterima, termasuk blok thinking kosong. Panduan migrasi menjelaskan bahwa Claude Sonnet 5.5 mengikat blok thinking ke pesan sebelumnya, sehingga mengedit riwayat itu dapat mengembalikan error 400.
Pada medium, investigasi memakan enam panggilan API dan sembilan panggilan alat baca. Claude menarik data pengembalian dana dan mengelompokkan baris pemroses berdasarkan reporting_category. Ia menemukan RF-1043, pengembalian dana $149,00 untuk pesanan 31 Agustus yang diselesaikan pada 2 September. Aturan kebijakan POL-3 menempatkannya di bulan September.
Kemudian ia membuka kedua baris sengketa. TXN-50036 memuat jumlah pokok -$149,00, biaya $15,00, dan dampak kas bersih -$164,00. TXN-50052 mengembalikan pokok $149,00 tanpa biaya. Claude menulis: "DSP-0077 bernilai bersih nol dan biaya $15-nya sudah dibukukan dengan benar, jadi RF-1043 sepenuhnya menjelaskan varians."
Claude telah mengacaukan pengembalian pokok dengan dampak kas setelah biaya:
Gerbang menolak rencana pertama Claude karena menyebut pesanan ORD-20813 tanpa mengambilnya. Claude mengambil pesanannya, mengajukan ulang, dan PLAN-1 lolos dengan satu penyesuaian.
Sebelum mengekspos alat tulis, gerbang memeriksa dari mana bukti berasal dan apa yang akan diubah rencana.
Setiap penyesuaian dalam rencana menyebut txn_id pemroses. Gerbang menerimanya hanya jika setiap baris yang disebutkan dikembalikan oleh alat baca dalam percakapan ini dan baris-baris tersebut bernilai bersih sama dengan jumlah yang diusulkan:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Penyesuaian $15,00 yang hanya menyebut debit sengketa akan gagal karena nilai bersih baris tersebut adalah -$164,00. Rencana harus menyebut pembalikannya juga.
Gerbang juga memeriksa aturan kebijakan dan transaksi duplikat. Rencana ditolak, dan akses tulis tetap terkunci, jika ada item yang melakukan salah satu dari ini:
Penolakan dikembalikan sebagai hasil alat submit_plan, sehingga Claude dapat menyelidiki lebih jauh dan mengajukan ulang. Gerbang menolak 2 dari 4 pengajuan, dan Claude memperbaiki masing-masing pada panggilan berikutnya. Bahkan setelah disetujui, create_adjustment hanya menerima entri yang persis cocok dengan item yang disetujui.
Setelah gerbang menyetujui rencana, Python menambahkan pesan role: "system" dengan blok tool_addition. Perubahan ini memerlukan header beta inline-tools-2026-09-15. Array tools dan setiap pesan sebelumnya tetap tidak berubah, jadi prefiks yang di-cache masih cocok. Teks instruksi berasal dari Python, bukan dari Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Pesan sistem dengan konten harus mengikuti giliran user, termasuk yang berisi blok tool_result. Pesan ini tidak boleh berada di antara blok tool_use dan hasilnya. Pesan sistem memiliki prioritas lebih tinggi, jadi jangan pernah menyisipkan teks rencana Claude, keluaran alat, atau data ke dalamnya. Blok tool_addition menyebut create_adjustment berdasarkan referensi, dan alat menjadi terlihat hanya setelah rencana lolos.
Caching berlanjut setelah perubahan alat. Permintaan memproses 231 token input yang tidak di-cache dan membaca 6.883 dari cache.
Penyesuaian pertama sudah benar namun tetap belum menuntaskan pekerjaan. Claude mencatat ADJ-001, -$149,00 di bawah POL-3, dan menyatakan selesai. Pemeriksaan internal Rivermark akan setuju, menampilkan varians $0,00. Kedengarannya selesai, tetapi sebenarnya belum.
Pemeriksaan Python yang independen membandingkan dengan setoran bank. Payout yang diharapkan setelah penyesuaian adalah $3.251,14, setoran $3.236,14, dan tersisa $15,00.
Kesenjangan itulah alasan pemeriksaan penyelesaian berada di Python, bukan di pesan akhir Claude.
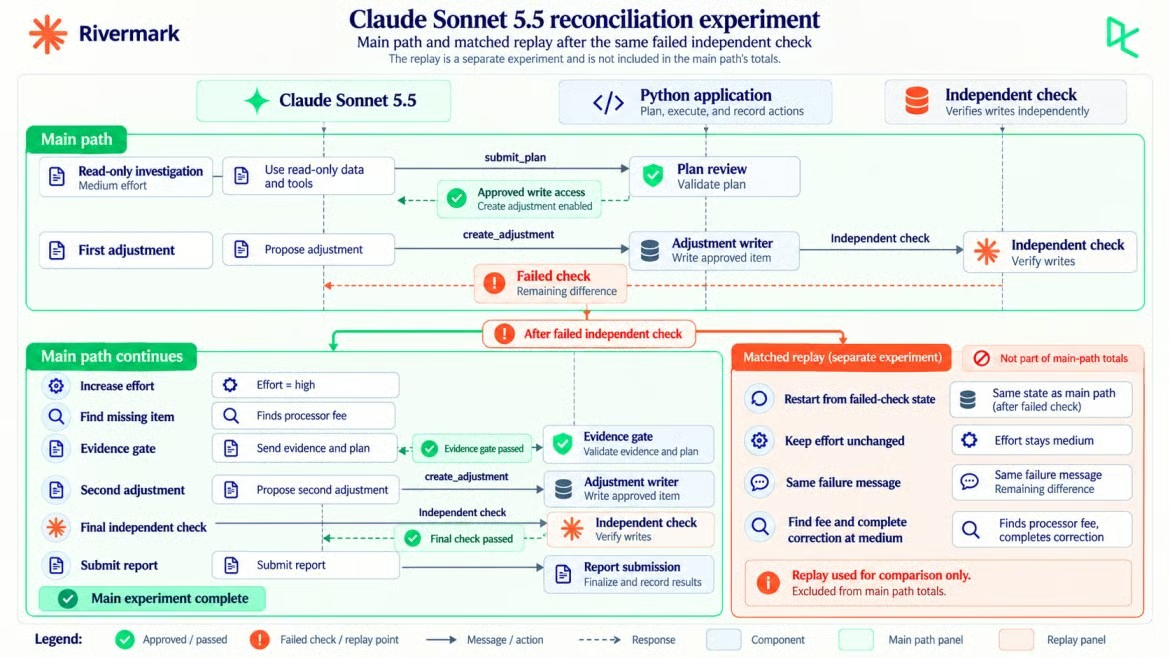
Matched replay bercabang dari verifikasi yang gagal. Gambar oleh Penulis.
Mengubah effort di tengah percakapan pada Claude Sonnet 5.5 berarti menambahkan pesan sistem dengan content kosong dan output_config.effort baru. Level baru berlaku mulai giliran user berikutnya, dan semua sebelumnya tetap di-cache.
Per-message effort masih beta dan memerlukan header mid-conversation-output-config-2026-07-01. Ia juga membutuhkan adaptive thinking: dengan between_tools, perubahan yang sama mengembalikan error 400. Ketika pemeriksaan independen gagal, Python menambahkan pengaturan effort baru sebelum pesan user berikutnya:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Perubahan effort tingkat atas akan memulai ulang cache, karena effort tingkat atas adalah bagian dari prompt yang di-cache. Bentuk per-pesan tidak demikian: permintaan pertama ber-effort tinggi membaca 8.012 token dari cache dan memproses 4 token yang tidak di-cache.
Selisih $15,00 memberi Claude target, tetapi bukan bukti untuk koreksi. Gerbang tetap mensyaratkan ID transaksi yang diambil Claude, dan net_cents-nya harus berjumlah -$15,00. Penyesuaian -$15,00 yang hanya menyebut TXN-50036 tetap gagal karena nilai bersih baris itu -$164,00.
Pada high, Claude mengelompokkan baris pemroses berdasarkan payout dan berdasarkan fee_cents, lalu menjalankan ulang pemeriksaan internal. Catatannya berikutnya menambahkan baris biaya hingga 12.586 sen. Biaya sengketa menaikkan total itu menjadi 14.086 sen. Pemeriksaan Rivermark melewatkannya.
Rencana tambahan pertamanya gagal mengenai aturan tersebut karena hanya menyebut debit. Rencana berikutnya menyebut kedua baris sengketa, PLAN-2 lolos, dan ADJ-002 mencatat -$15,00 di bawah POL-4.
Eksperimen ini tidak menunjukkan bahwa high itu perlu. Replay terpisah melanjutkan dari titik kegagalan yang sama dengan riwayat percakapan dan pesan Python yang sama, tetapi tetap di medium; ia juga menemukan biayanya.
Enam panggilan ber-effort high pada run utama menghasilkan 2.763 token output (607 thinking) dan biayanya $0,0484. Enam panggilan investigasi ber-effort medium pada kontrol terpisah menghasilkan 2.713 token output (628 thinking) dan biayanya $0,0464, termasuk penolakan gerbang yang sama.
Satu panggilan laporan terakhir membuat kontrol menjadi 7 panggilan dan total $0,0615. Tidak ada panggilan atau biaya tersebut yang termasuk dalam 15 panggilan dan $0,1190 pada run utama.
Kedua jalur menerima pesan kegagalan pemeriksaan yang sama; hanya effort-nya yang berbeda. Satu replay tidak dapat mengukur besar efek effort, tetapi menunjukkan bahwa high tidak perlu untuk kasus ini. Panduan effort yang sama menyarankan xhigh dan max untuk kasus di mana "evaluasi Anda menunjukkan peningkatan kualitas." Uji high dengan cara yang sama sebelum memilihnya.
Verifikasi akhir sengaja mengulang 2 pemeriksaan gerbang: bukti dan cakupan penulisan. Gerbang meninjau proposal sebelum menulis; verifikasi akhir memeriksa apa yang benar-benar ditulis Python, lalu menambahkan pemeriksaan angka dan file mentah.
Setelah ADJ-002, Python menghitung ulang semuanya dari catatan mentah, penyesuaian yang disetujui, dan total bank:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Keempatnya lolos. Payout yang diharapkan setelah penyesuaian adalah $3.236,14, cocok dengan setoran. Kedua penyesuaian terlacak ke baris yang diambil, data sumber mentah tetap tidak berubah, dan Python hanya menulis entri yang disetujui.
Baru setelah itu langkah pelaporan dimulai. Aplikasi menambahkan pesan yang mengatur effort kembali ke medium, giliran user yang singkat, dan pesan sistem yang menukar alat:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Laporan adalah keluaran terakhir, bukan buktinya. Saran tindak lanjutnya tetap memerlukan tinjauan manusia. Rekaman di bawah ini mengikuti izin, effort, pemeriksaan, dan biaya sepanjang satu sesi Streamlit.
Streamlit mengikuti rekonsiliasi dari awal. Video oleh Penulis.
Rekonsiliasi utama berpindah dari medium ke high, biayanya $0,1190 di 15 panggilan API, dan memakan waktu 70,0 detik, termasuk 69,0 detik menunggu API. Replay yang dicocokkan terpisah tidak termasuk. Setiap angka berasal dari usage respons dan tarif Claude Sonnet 5.5.
Untuk rincian biaya yang lebih luas, panduan Claude API kami membahas prompt caching dan pemrosesan batch.
input_tokens hanya menghitung apa yang datang setelah breakpoint cache, jadi total input adalah jumlah dari tiga field, seperti dijelaskan di dokumentasi prompt caching yang ditautkan sebelumnya. Penulisan dan pembacaan cache memiliki tarif masing-masing, dan token thinking sudah termasuk dalam output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Sepanjang rekonsiliasi, Claude membaca 105.614 dari 118.308 token input dari cache (sekitar 89%), dan hanya 636 yang ditagih sebagai input tidak di-cache. Bagan menerapkan empat tarif token ke penggunaan yang terukur.
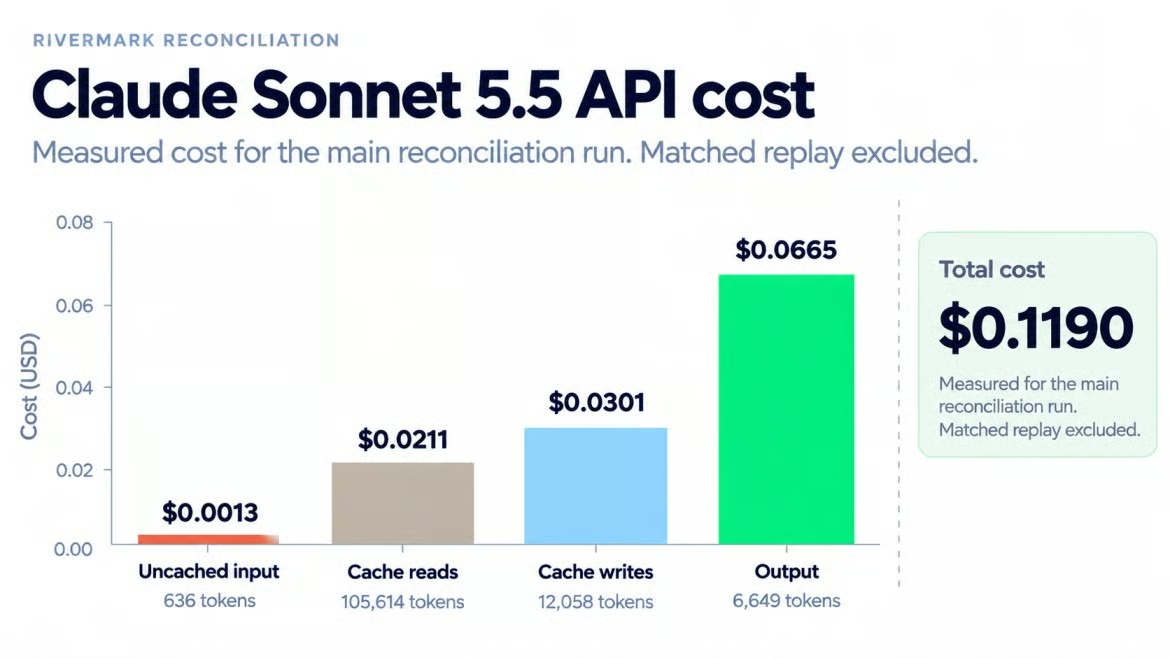
Token output mendominasi biaya yang terukur. Gambar oleh Penulis.
Rivermark menulis catatan penyesuaian lokal, jadi sistem keuangan produksi masih memerlukan:
Data lokal, fiksi. Penutupan yang nyata memerlukan autentikasi, log audit, persetujuan manusia atas pembukuan, dan tinjauan retensi data.
Fitur beta. Header untuk per-message effort, perubahan alat, dan pembaruan thinking dapat berubah, jadi uji lagi sebelum penerapan.
Hasil yang bervariasi. Claude Sonnet 5.5 menolak temperature non-default, jadi upaya berulang bisa berbeda. Uji polanya pada data Anda sendiri sebelum mengandalkannya.
Kita membangun agen rekonsiliasi yang menyelidik dengan alat baca-saja, mendapat satu alat tulis hanya setelah rencananya disetujui Python, dan selesai hanya ketika pemeriksaan independen terhadap setoran bank lolos. Claude Sonnet 5.5 menemukan pengembalian dana yang salah tempat secara mandiri, tetapi kegagalan pemeriksaan itulah yang mengarahkannya kembali ke biaya $15,00 yang sudah ia baca.
Saya tidak akan menggeneralisasi satu bulan fiksi ke setiap penutupan. Yang bisa dibawa adalah metodenya: sembunyikan alat tulis hingga rencana lolos, simpan catatan bank di luar model, wajibkan bukti transaksi untuk setiap koreksi, dan tambahkan perubahan alat atau effort agar cache tetap bertahan.
Pemeriksaan independen adalah bagian yang akan saya pertahankan bahkan dalam versi proyek yang lebih kecil. Perubahan effort adalah bagian yang akan saya uji sebelum dipercaya, karena alasan yang dibahas di bagian effort.
Menukar alat baca dan pemeriksaan akhir memungkinkan pola yang sama menangani perbaikan pembersihan data, pengembalian dana dukungan, atau pembaruan dokumen terkontrol. Perluasan pertama saya adalah langkah persetujuan manusia sebelum setiap penyesuaian ditulis, karena penutupan yang nyata membutuhkannya.
Untuk mempraktikkan dasar-dasar Anthropic API yang menjadi andalan build ini, saya merekomendasikan kursus Introduction to Claude Models kami.
Belajar Menggunakan Claude Bersama DataCamp!
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt