트랙
개발자를 위한 AI 엔지니어 보조
26시간
실습 문제하고 트랙하세요.
Google로 계속하기레스토랑에 앉자마자 웨이터가 “생수 드릴까요, 탄산수 드릴까요?”라고 묻는다고 상상해 보세요. 수분 섭취 취향에 대한 단락을 말하지는 않죠. 제시된 두 가지 옵션 중에서 하나를 고릅니다.
이제 오늘날 대부분의 앱에서 대형 언어 모델(LLM)을 사용하는 방식을 떠올려 보세요. “이 고객 지원 티켓은 결제, 배송, 반품 중 무엇에 관한 건가요?”라고 물으면, 모델은 완전한 문장으로 답을 작성하고, 우리는 그 문장을 다시 코드로 파싱해야 합니다. 현실적으로 가능한 답은 세 가지뿐인데, 그럼에도 전체 사고 과정을 위해 비용을 지불한 셈이죠.
이 새로운 유형의 모델이 메우려는 간극이 바로 이것입니다. 2026년 9월, TypeSafe AI라는 스타트업이 텍스트를 전혀 작성하지 않는 모델인 Jev를 출시했습니다.
대신, 고정된 답변 집합을 점수화하고 각 답변이 그럴듯한 정도를 알려줍니다. 몇 주 안에 OpenAI, Cloudflare, Perplexity, Microsoft까지 각자의 버전을 출시했는데, 이 분야가 얼마나 빠르게 움직이는지 보여줍니다.
이번 글에서는 이러한 AI 의사결정 모델이 무엇이고, 어떻게 작동하며, 이 아이디어의 기원이 어디인지(현재의 화제만큼 새롭지는 않습니다)를 살펴보겠습니다. 또한 독립 벤치마크 결과도 함께 확인하겠습니다.
if 문에 넣을 수 있습니다.AI 의사결정 모델은 입력과 허용된 답변 집합을 받아, 자유 텍스트를 생성하지 않고 각 답변의 확률을 반환하는 모델입니다.
핵심 아이디어는 출력이 처음부터 구조화되어 있다는 점입니다.
모델이 돌려줄 수 있는 것은 제공한 답변 중 하나뿐이므로 문장을 파싱할 필요가 없습니다. 즉, 결과를 코드의 if 문에 바로 넣을 수 있습니다.
저는 이를 두 가지 시험 유형으로 비유하는 편이 좋습니다.
대형 언어 모델은 단어를 하나씩 써 내려가는 서술형 시험을 치르는 반면, 의사결정 모델은 객관식 시험을 치르고 각 보기마다 얼마나 확신하는지도 함께 알려줍니다(신뢰도 점수).
Jev와 대부분의 Jev 대안은 세 가지 질문 유형을 지원합니다:
TypeSafe에는 이미지 내 위치 지정을 위한 실험적 Box 타입도 있지만 여기서는 다루지 않겠습니다.
TypeSafe의 공식 문서의 예시를 하나 들어보겠습니다.
state(모델이 볼 텍스트)와 questions 맵을 전송할 수 있습니다. 선택형 질문의 경우 각 옵션은 criteria라는 필드에 짧은 설명을 포함합니다.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
응답은 다음과 같았습니다.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
파싱할 텍스트가 없습니다.
선택된 옵션, 각 옵션의 확률, 최상위 확률에서 파생된 신뢰도를 함께 받습니다. 따라서 분포가 평평할수록 신뢰도는 낮습니다. 문서에서는 잘못된 사이즈와 이중 결제가 모두 언급된 티켓의 경우 반품(0.61)과 결제(0.35) 사이에 확률이 갈라지고, 신뢰도는 0.42로 떨어졌다고 합니다.
TypeSafe는 Jev를 Daniel Kahneman의 저서 Thinking, Fast and Slow에서 차용해 “System One Model”이라고 설명합니다. 왜 그럴까요?
아주 간단히 말해, 시스템 1은 빠르고 직관적인 판단이고, 시스템 2는 느리고 단계적인 추론입니다.
의사결정 모델은 빠른 쪽을 목표로 합니다.
단, 주의할 점이 하나 있습니다. 시스템 1은 빠른 실수를 저지르는 부분이기도 하며, TypeSafe의 문서도 Jev가 잘못하는 부분을 솔직하게 공개하고 있습니다. 이 점은 뒤에서 다시 다루겠습니다.
처음 이 모델을 접했을 때 헷갈렸던 점은 “의사결정 모델”이라는 말이 이미 여러 다른 것을 의미한다는 것입니다. 다음을 가리킬 수 있습니다:
따라서 이 글에서 “의사결정 모델”은 2026년 말에 출시된, 텍스트를 쓰는 대신 형식화된 답변을 점수화하는 새로운 모델 범주만을 의미합니다.
의사결정 모델이 어떻게 작동하는지 보기 전에, 일반 LLM이 답을 어떻게 만드는지 먼저 보면 도움이 됩니다. 차이를 더 쉽게 이해할 수 있습니다.
대형 언어 모델은 루프를 통해 동작합니다.
입력 텍스트를 토큰으로 바꾸고, 어휘의 각 토큰에 대한 확률을 예측한 뒤 하나를 고르고, 텍스트에 추가한 다음 이를 반복합니다.
답변의 토큰이 하나 늘 때마다 모델을 한 번 더 순전파합니다.
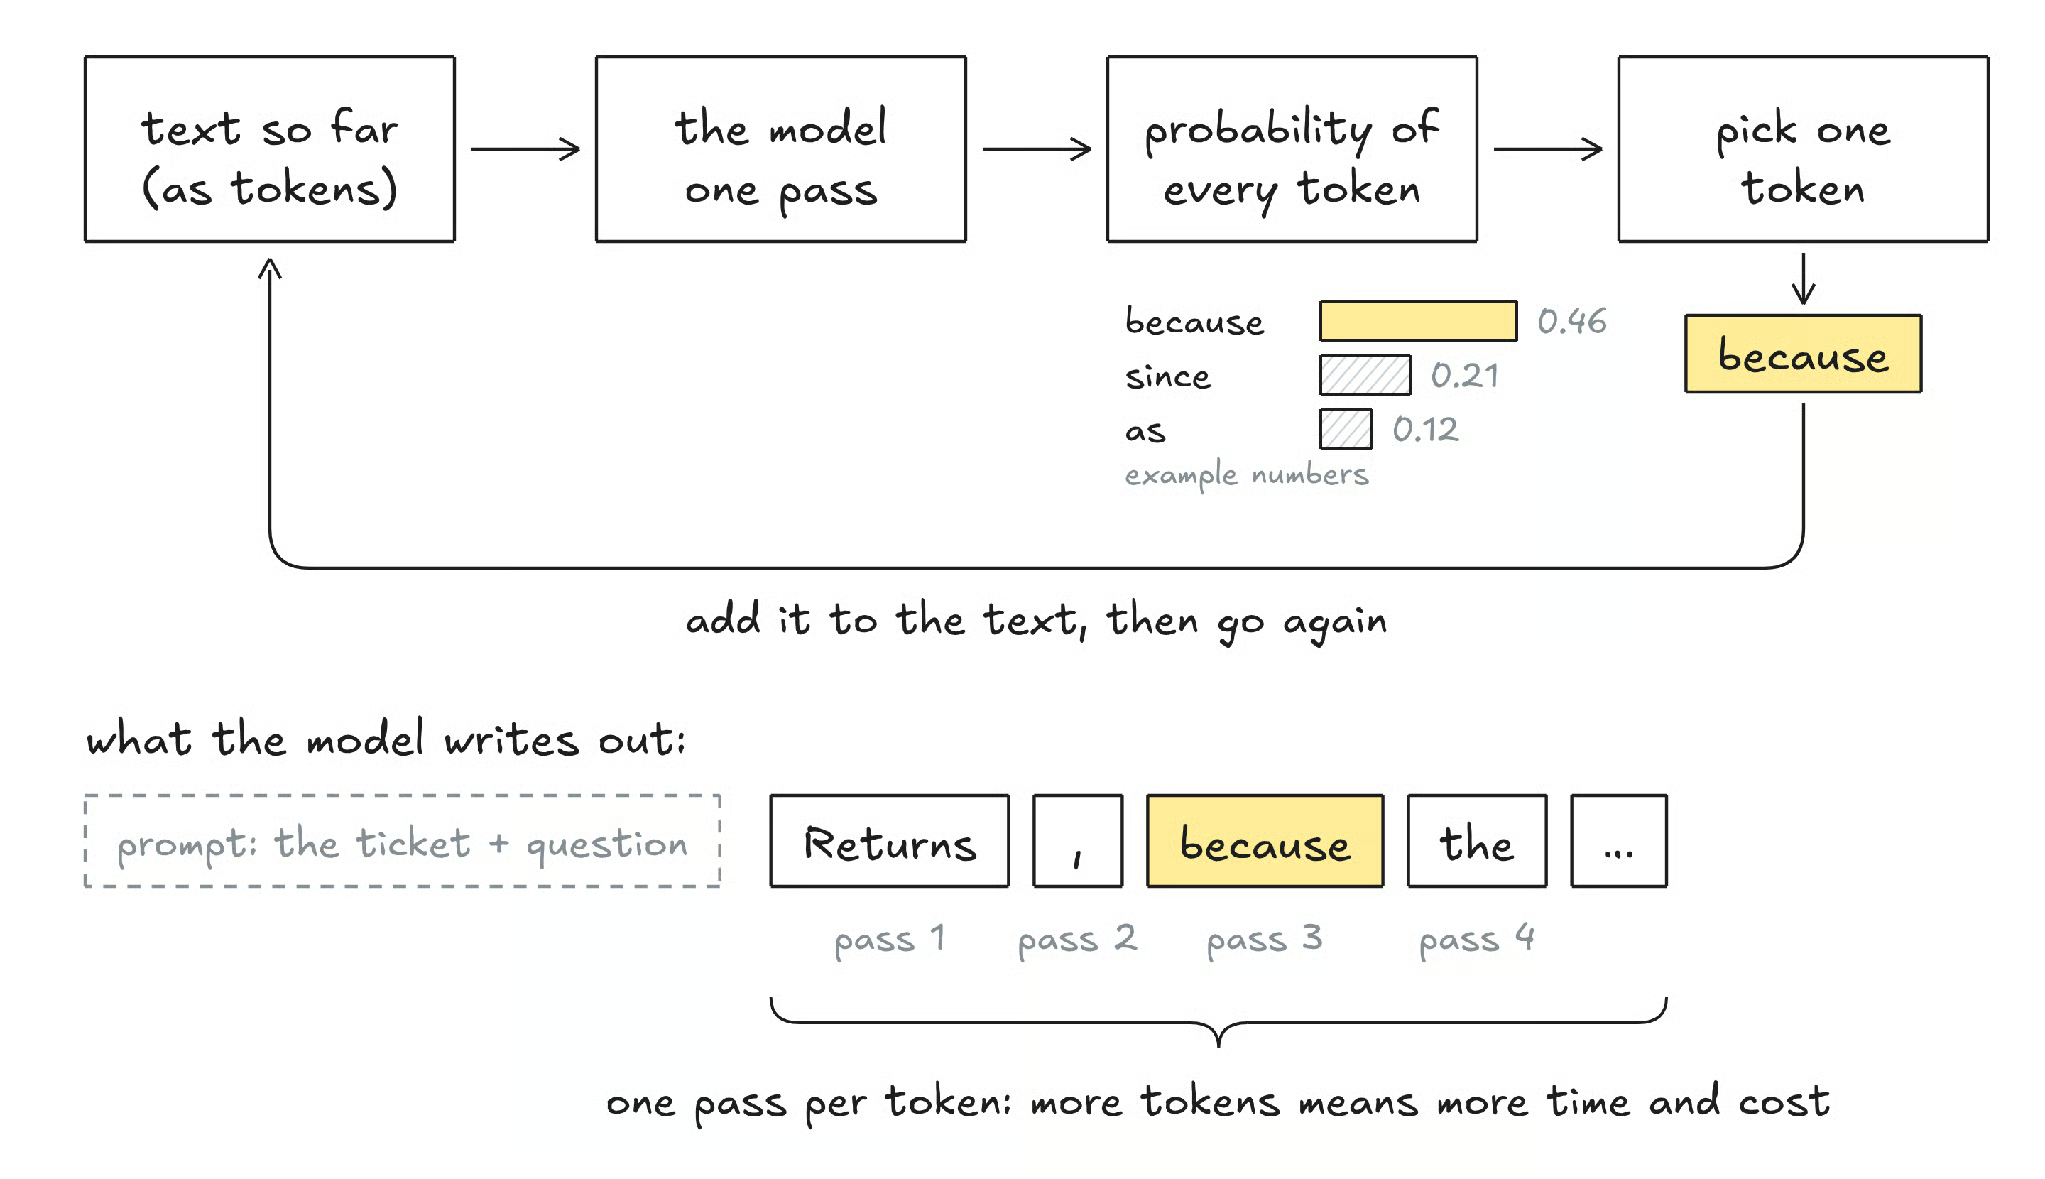
그림 1: LLM은 쓰는 토큰마다 한 번의 순전파가 필요합니다. 원저자 제작 이미지.
이 루프는 이메일, 코드, 설명을 쓰는 데는 잘 맞지만, 단순한 결정을 내릴 때는 다음과 같은 문제를 일으킬 수 있습니다:
의사결정 모델은 바로 이러한 문제를 해결하려 합니다.
이제 실제 메커니즘을 살펴보겠습니다.
여기서 이해할 만한 세 가지 아이디어가 있습니다:
각 항목을 조금 더 자세히 보겠습니다.
의사결정 모델은 입력과 질문을 읽고, 허용된 각 답변에 대한 점수를 만듭니다.
이 점수는 보통 소프트맥스 함수를 통해 확률로 변환됩니다. 짐작하듯이, 쓸 내용이 없으니 긴 루프가 존재하지 않습니다.
TypeSafe 문서에 따르면 동일 요청 내 질문들은 병렬로 평가되어, 질문을 더해도 응답 시간 변화가 거의 없습니다.
속도 이점의 대부분은 여기서 오며, TypeSafe는 Jev가 보통 70~500밀리초 내에 응답한다고 밝힙니다.
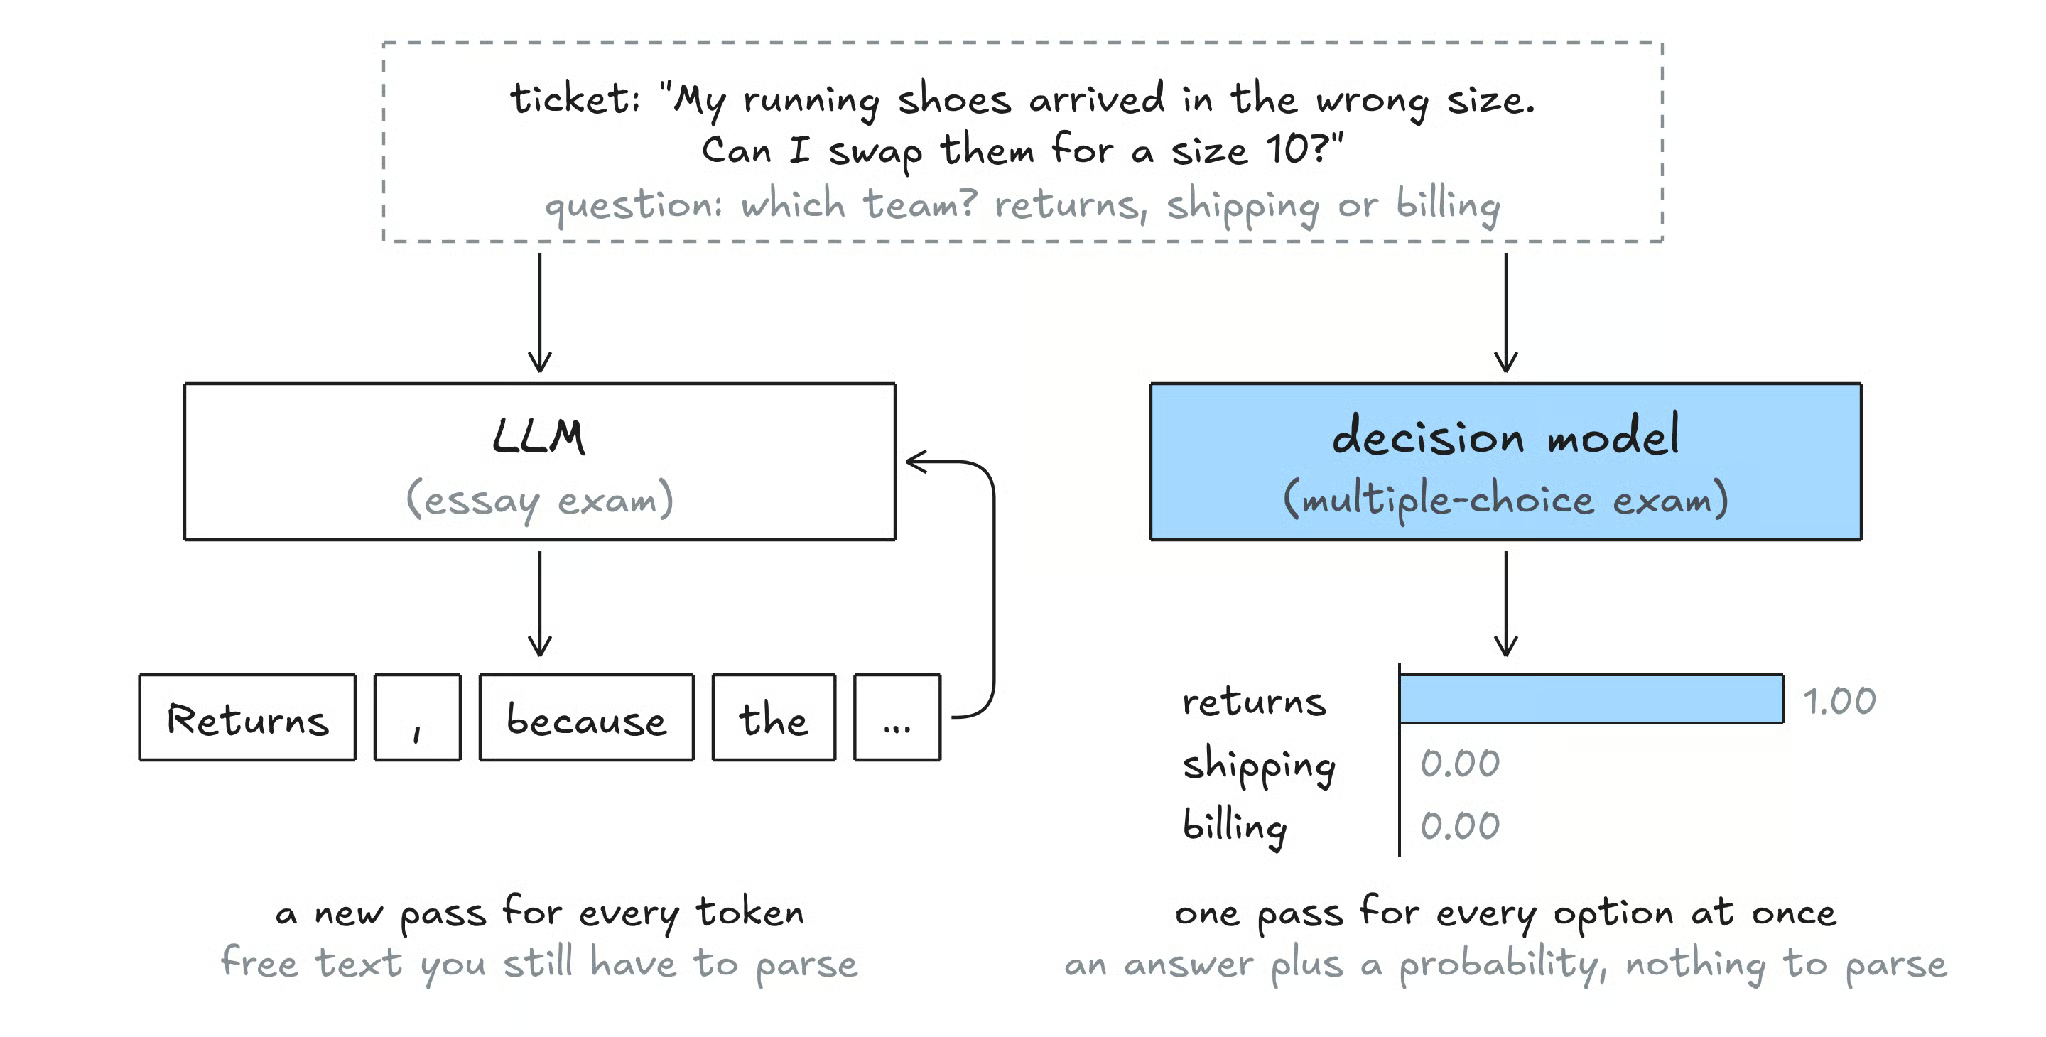
그림 2: 동일한 티켓에 대해 LLM과 의사결정 모델이 답한 모습. 원저자 제작 이미지.
단일한 “의사결정 모델 아키텍처”는 없습니다.
TypeSafe는 Jev의 작동 방식을 공개하지 않았지만, 점수를 얻는 방식은 대략 세 가지로 생각해 볼 수 있습니다:
어떤 방식을 쓰든 신경 쓰지 마세요. 세 접근 모두 결국 각 허용 답변에 대한 숫자로 귀결됩니다.
이 부분이 가장 중요하다고 생각합니다. 예시로 설명해 보겠습니다.
모델이 서로 다른 100개의 질문에 대해 “70% 가능성”이라고 했다고 합시다. 모델이 잘 보정되어 있다면, 그중 약 70개가 실제로 정답이어야 합니다.
보정이 중요한 이유는, 보정된 확률을 바탕으로 코드에서 안전한 임계값(예: “90% 이상이면 자동 승인, 그 외에는 사람에게 전달”)을 설정할 수 있기 때문입니다.
확률이 현실과 맞지 않으면, 임계값은 무의미해집니다.
벤더들은 과도한 확신을 벌점 주는 손실 함수를 사용해 이를 학습합니다.
TypeSafe는 RLCD(Reinforcement Learning for Calibrated Decisions)라 부르고, Cloudflare는 Clef 모델에서 크로스 엔트로피와 Brier 손실을 함께 사용한다고 밝힙니다.
의외일 수 있지만, 후보를 생성하는 대신 점수화하는 아이디어는 수년 전부터 있었습니다.
제 생각에 의사결정 모델은 완전히 새로운 발명이라기보다, 이를 가장 편리하게 구현한 최신 버전입니다. 기반이 된 주요 모델 계열을 살펴보겠습니다.
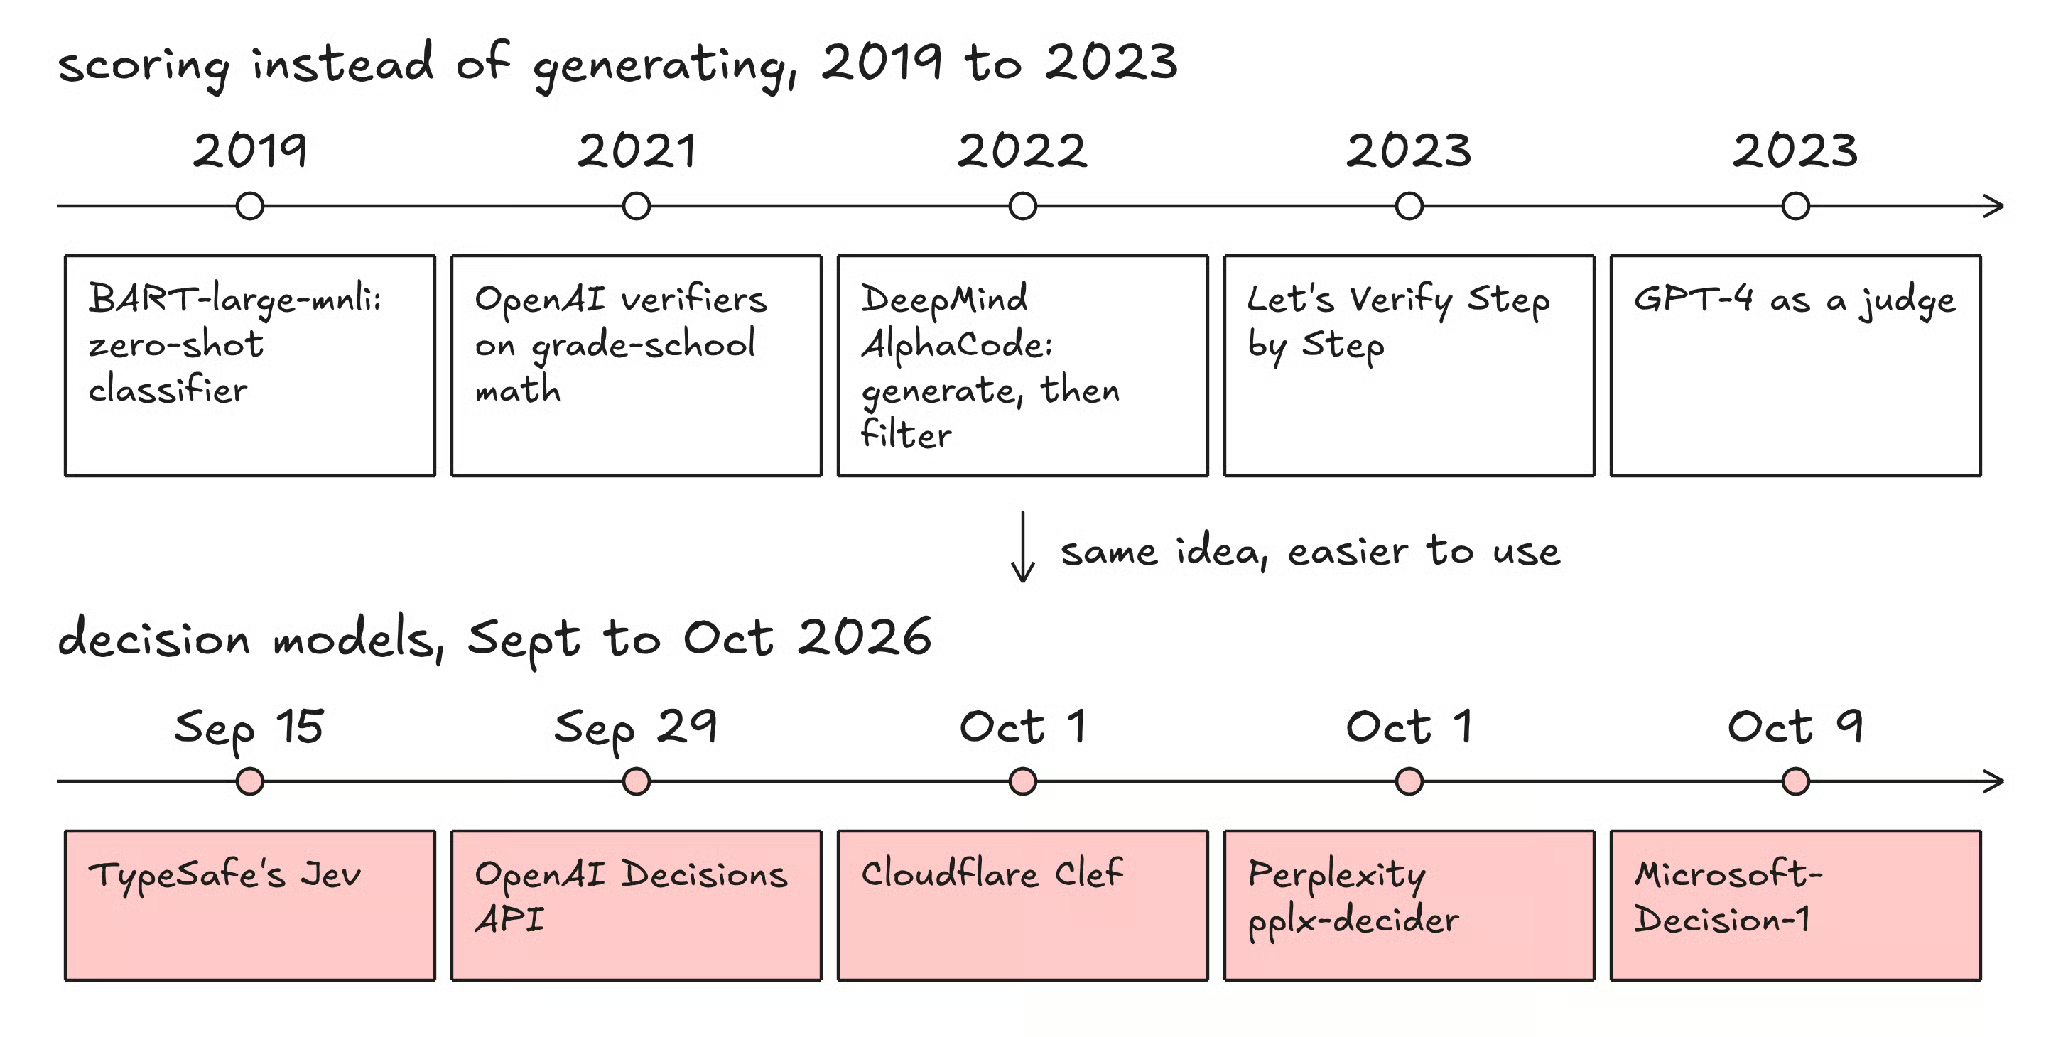
그림 3: 생성 대신 점수화는 2019년으로 거슬러 올라가며, 의사결정 모델은 2026년 버전입니다. 원저자 제작 이미지.
2019년에 이미 BART-large-mnli 같은 모델은 학습하지 않은 라벨로도 텍스트를 분류할 수 있었습니다.
각 가능한 라벨에 대해 “이 텍스트는 결제에 관한 것이다” 같은 진술을 점수화하는 방식이었습니다.
Red Hat의 AI 안전팀은 의사결정 모델이 본질적으로 이러한 제로샷 분류기를 새로운 이름으로 부르는 것에 가깝다고 제안합니다.
RAG 시스템을 구축해 보았다면 사용해 보았을 수 있습니다. 먼저 빠르게 후보(예: 50개 문서)를 검색한 다음, 크로스 인코더가 질문과 각 문서를 함께 읽고, 각 쌍에 관련성 점수를 부여합니다.
아무 것도 생성하지 않고, 점수에 따라 문서를 재배열할 뿐입니다.
LLM이 이미 생성한 답을 평가하는 스코어러입니다.
2021년 OpenAI 연구자들은 검증기를 모델에 추가하면 초등 수학에서 모델을 30배 키운 것과 비슷한 향상이 있음을 보였는데, 상당히 인상적입니다.
2년 뒤, “Let’s Verify Step by Step” 논문은 최종 답만 점수화하는 것보다 각 추론 단계별로 점수화하는 편이 더 효과적임을 보였습니다.
간단한 버전은 여러 답을 생성하고, 각각 점수화해 최선을 고르는 것입니다. DeepMind의 AlphaCode(2022)는 문제당 최대 백만 개의 프로그램을 생성하고, 예제 테스트로 약 99%를 버린 뒤 10개만 제출하는 극단적 방식을 택했습니다.
과거 Codeforces 대회 시뮬레이션 평가에서 평균적으로 상위 54.3%의 인간 참가자 수준에 올랐습니다.
경고 하나: 불완전한 스코어러를 과도하게 활용하면, 생성기가 스코어러의 약점을 파고들어 결국 품질이 떨어집니다.
이를 보상 과최적화라고 합니다.
큰 LLM이 다른 모델의 출력을 채점하는 방식입니다.
2023년 연구는 GPT-4가 인간 평가자와 80% 이상 일치했지만, 더 긴 답이나 먼저 제시된 답을 선호하는 등의 편향이 있음을 발견했습니다.
의사결정 모델은 이러한 평가자를 더 저렴하고 구조화된 방식으로 대체하려는 의도로도 판매되고 있습니다.
에너지 기반 모델은 입력–답변 쌍이 잘 맞으면 낮은 “에너지”, 맞지 않으면 높은 점수를 부여합니다.
답을 고르는 일은 결국 가장 낮은 에너지를 찾는 일, 즉 다시 후보를 점수화하는 일입니다.
Yann LeCun은 토큰을 하나씩 생성하는 방식이 진정한 지능으로 가는 길이 아니며, 에너지 기반 접근과 JEPA가 더 나은 방향이라고 수년간 주장해 왔습니다.
이제 실제로 출시된 모델을 살펴보겠습니다. 변화가 매우 빠르므로 간략히 정리합니다.
TypeSafe AI는 전 OpenAI 연구원 Diogo Almeida가 설립한 샌프란시스코의 스타트업으로, 2026년 9월 15일 Jev와 함께 DCVC가 주도한 4천만 달러 시드 라운드를 공개하며 스텔스에서 나왔습니다.
Jev는 호스팅 API입니다. 프로덕션에서는 텍스트만 받고, 이미지 입력은 실험적이며 헤더로 옵트인해야 합니다. 과금은 입력 토큰 기준이며, 출력은 숫자 몇 개뿐이므로 무료입니다.
10월 14일 Jev 1.14가 뒤이어 나왔지만, jev-latest 별칭은 여전히 Red Hat이 본문에서 테스트한 1.13.0을 가리킵니다.
출시 당시 반향이 컸습니다. Vercel은 유료 팀의 약 13%가 출시 24시간 내 AI Gateway를 통해 Jev를 사용해 보았다고 밝혔지만, 당시 게이트웨이에서는 무료였습니다.
OpenAI는 2026년 9월 29일 DevDay에서 Decisions API를 발표했습니다.
사용자 정의 고정 답변형 질문을 지원하며 GPT-6 Luna를 기반으로 합니다. 10월 6일 퍼블릭 베타로 전환되었고, Jev가 실험적으로만 지원하는 이미지 입력도 받을 수 있습니다.
Cloudflare는 2026년 10월 1일 Clef와 더 작은 Clef-flash를 공개 가중치와 Workers AI 호스팅으로 출시했습니다. 둘 다 Qwen 모델을 기반으로 하며 Jev 스타일의 요청을 받기 때문에, Jev용으로 작성된 코드를 거의 수정 없이 Clef로 돌릴 수 있습니다.
| Model | Maker | Released (2026) | Access | Notable detail |
|---|---|---|---|---|
| pplx-decider | Perplexity | October 1 | Open weights and API | Perplexity 자체 11개 벤치마크 패널에서 Jev 84.51% 대비 85.71% 자체 보고 |
| Microsoft-Decision-1 | Microsoft | October 9 | Foundry preview | 사후 학습된 9B Qwen 모델 |
| Laya | Convai Innovations | September | Open weights | 소형(4.21억 파라미터), 노트북 CPU에서 실행 가능; 모델 카드에 제로샷 엔진이 아닌 특화용 베이스라고 명시 |
이 섹션을 정리하며 눈에 띈 점은, 여기의 대부분 오픈/빅테크 모델이 일반 LLM의 파인튜닝 버전이라는 것입니다. Laya만 예외로, 의사결정 헤드를 단 인코더입니다. Jev의 내부는 비공개입니다.
제 의견으로는, 이는 완전히 새 아키텍처라기보다(보정 학습과 인터페이스 같은) 패키징이 진짜 혁신이라는 점을 뒷받침합니다.
언제 어떤 것을 써야 하는지는 다음 비교가 가장 분명합니다:
| Feature | LLM | Decision model | Fine-tuned classifier | LLM + verifier |
|---|---|---|---|---|
| Output | 자유 텍스트 | 형식화된 답과 확률 | 고정 라벨 | 여러 생성 답 중 최선 |
| Needs labeled data | 아니오 | 아니오 | 예 | 대체로 예 |
| Speed | 수 초 | 수십~수백 밀리초 | 매우 빠름 | 가장 느림 |
| Off-format answers | 가능 | 불가능 | 불가능 | 생성기에 따라 다름 |
| Explains its answer | 예 | 아니오 | 아니오 | 예 |
| Best for | 글쓰기, 코드, 추론 | 라우팅, 분류, 가드레일 | 단일 고정 대량 작업 | 수학, 테스트 가능한 코드 |
대략적인 판단 기준은 다음과 같습니다:
최고의 시스템은 이 모든 것을 섞어 쓴다고 믿습니다.
의사결정 모델은 LLM 주변의 빠른 “게이트”로 작동할 수 있습니다. 게이트는 다음을 결정합니다:
이렇게 하면, 실제로 텍스트를 작성해야 할 때만 비용이 큰 LLM이 실행됩니다.
이 섹션이 가장 중요합니다. 온라인에서 보게 될 큰 숫자들은 대체로 벤더가 제공한 것입니다. TypeSafe도 자사 속도·비용 이점의 대표 수치가 실제 사용에서 볼 수 있는 상한에 가깝다고 인정합니다.
2026년 10월, Red Hat의 AI 안전팀은 프롬프트 인젝션과 안전하지 않은 콘텐츠 탐지 두 과제에서 아홉 가지 가드레일 구성을 비교했습니다.
DiffusionGemma는 vLLM을 통해 서빙된 Gemma 텍스트-디퓨전 모델입니다.
주요 결과는 다음과 같습니다:
| Method | Type | Prompt injection accuracy | Content safety accuracy |
|---|---|---|---|
| deberta-v3-base | Fine-tuned classifier | 89.01% | - |
| granite-guardian-hap-125m | Fine-tuned classifier | - | 80.27% |
| Qwen3.6-35B | LLM-as-a-judge | 89.31% | 85.47% |
| DiffusionGemma | Decision model (open) | 87.72% | 85.53% |
| Jev | Decision model | 86.35% | 86.20% |
| Laya | Decision model (open) | 85.44% | 57.87% |
| BART-large-mnli | 2019 zero-shot classifier | 61.49% | 68.67% |
Jev는 콘텐츠 안전성에서 DiffusionGemma를 0.67%포인트 앞서 1위를 했고(Qwen 심판은 3위), 프롬프트 인젝션에서는 Qwen 심판이 1위를 했습니다.
이 분할 때문에 Red Hat은 전체적으로 의사결정 모델이 LLM 심판 대비 품질 이점을 보이지 않았다고 결론지었습니다.
하지만 제게 가장 흥미로웠던 점은, 2억 파라미터 분류기가 프롬프트 인젝션에서 불과 0.3%포인트 뒤처졌고, 중앙지연은 Jev 약 348밀리초 대비 100밀리초 미만이었다는 사실입니다.
Jev의 지연에는 대서양 횡단 왕복이 포함되었습니다. 테스트는 영국에서, TypeSafe 서버는 미국에 있었기 때문입니다.
이 왕복은 로컬 CPU 모델과의 격차만 설명해 줍니다. Qwen, Nemotron, DiffusionGemma도 미국 클러스터에서 실행됐고, Qwen은 여전히 Jev보다 빨랐습니다.
그럼에도 Red Hat은, Laya를 제외하면(작은 크기는 한계 내에서 프롬프트로 보완 가능할 때 진짜 이점) 의사결정 모델이 테스트에서 LLM 심판보다 빠르거나 저렴하거나 더 낫지 않았다고 결론지었습니다.
대학 연구팀의 연구 논문이 2026년 9월 arXiv에 게시되어, Jev를 44개 얼라인먼트 벤치마크에서 시험했습니다.
흥미롭게도 결과는 엇갈렸습니다:
실무에서는 이 선택적 예측 포인트가 매우 유용하다고 생각합니다.
의사결정 모델이 쉬운 케이스를 처리하고, 불확실한 것은 LLM이나 사람에게 넘기는 단순한 설계가 좋은 전략임을 보여줍니다.
이제 직접 의사결정 모델을 만들어 보겠습니다.
작은 오픈 LLM을 앞서 언급한 토큰 확률 트릭으로 의사결정 모델로 바꾸고, 그 확률을 실제로 신뢰할 수 있는지 확인해 보겠습니다.
먼저 다음을 사용해 패키지를 설치합니다(모두 무료 Colab 노트북에서 실행 가능):
pip install transformers torch datasets sentence-transformers numpyCPU에서 돌릴 수 있을 만큼 작은 Qwen2.5-0.5B-Instruct를 사용하겠습니다.
아이디어는 간단합니다. 옵션에 글자를 붙이고, 모델을 한 번 실행한 뒤, 다음 토큰으로서 그 글자들에 대한 확률만 봅니다.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
return {o: round(p.item(), 3) for o, p in zip(options, probs)}generate()를 호출하지 않는 점에 주목하세요. 단 한 번의 순전파만 수행하고, “A”, “B”, “C” 등의 점수만 남기고 나머지는 버립니다.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
이게 전부입니다. 약 30줄로 작동하는 의사결정 모델을 만들었습니다.
예/아니오는 선택형 질문에서 옵션이 둘뿐인 경우입니다.
이제 이 단순 버전이 어디서부터 힘들어지는지 보겠습니다.
옵션의 순서를 셔플하고 같은 질문을 다시 실행해 보세요:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
이처럼 지저분한 입력에서는, 옵션을 움직였다는 이유만으로 확률이 달라지는 경우가 흔합니다.
이를 순서 편향이라고 하며, TypeSafe도 Jev의 알려진 약점으로 첫 번째 옵션으로 기우는 경향을 명시합니다.
또한 모델이 거의 100%에 가까운 답을 자주 내기도 합니다. Berryman은 Jev 자체에 흥미로운 테스트를 했는데, 동전이 앞면이 나올 확률이 60%라고 알려주자 예/아니오 질문은 0.58을 반환해 근사했습니다.
하지만 선택형 질문(“앞면 또는 뒷면?”)은 앞면 0.99라고 반환했는데, 더 가능성 높은 답에 확률이 쏠렸기 때문입니다.
이 단계는 모두가 해보기를 권합니다. 네 가지 주제를 가진 AG News 데이터셋에서 뉴스 400건(헤드라인+짧은 설명)을 가져와, 우리의 확률이 현실과 맞는지 확인하겠습니다.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
다음으로 보정을 측정할 방법이 필요합니다. 예상 보정 오류(ECE)는 예측을 신뢰도 구간으로 묶어, 각 구간에서 평균 신뢰도와 실제 정확도의 차이를 측정합니다.
낮을수록 좋습니다:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
이제 요령입니다.
데이터를 반으로 나누고, 첫 절반에서 확률을 더 정직하게 만들 온도를 찾은 다음, 나머지 절반에서 테스트합니다.
1보다 큰 온도는 과확신 예측을 누그러뜨리고, 1보다 작은 온도는 과소확신 예측을 날카롭게 합니다.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
정확도는 변하지 않습니다. 온도로 나누어도 1위를 차지하는 옵션 자체는 바뀌지 않기 때문입니다.
변하는 것은 확신도뿐입니다.
정확한 수치는 실행마다 다르지만, 테스트 절반에서 ECE는 대체로 내려갑니다. 테스트 샘플이 200개뿐이므로 추정치는 요동칠 수 있으니, 작은 차이에 과도한 의미를 부여하지 마세요.
교훈은 간단합니다. 어떤 모델이 남의 데이터에서 보정되었다고 해서, 당신의 데이터에서도 자동으로 보정된다는 뜻은 아닙니다.
“생성 말고 점수화” 아이디어가 얼마나 흔한지 보여주기 위해, RAG 설정에서도 같은 방식을 보겠습니다.
크로스 인코더가 각 문단을 질문과 함께 점수화하고, 우리는 그저 정렬합니다:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
역시 아무 것도 생성하지 않습니다. 모델은 각 후보에 숫자만 부여합니다.
가장 자주 언급되는 활용 사례는 다음과 같습니다:
| Use case | How a decision model helps |
|---|---|
| 에이전트 라우팅 | 다음 단계를 처리할 도구 또는 하위 에이전트를 결정합니다. |
| 가드레일 | 프롬프트 인젝션이나 안전하지 않은 콘텐츠를 LLM에 도달하기 전에 표시합니다. |
| 지원 티켓 분류 | 팀, 주제, 긴급도에 따라 티켓을 라우팅합니다. |
| 문서 접수 | 각 문서에 대해 고정된 체크리스트 질문에 답합니다. |
| 검색 및 RAG | 검색된 문단을 관련성에 따라 재순위화합니다. |
| 신용 및 이상징후 | 리스크를 점수화합니다. 다만 사람에 대한 의사결정은 여전히 인간 검토가 필요합니다. |
| 로보틱스 | 느린 LLM 계획기와 저수준 모터 제어 사이의 빠른 계층으로 작동할 수 있으나, 아직은 가설적입니다. |
로보틱스는 개인적으로 가장 흥미로운 포인트입니다.
Berryman은 Jev 같은 모델이 느린 LLM의 고수준 계획과 로봇 관절을 움직이는 운동학 모델 사이에 위치할 수 있다고 제안합니다.
다만, TypeSafe의 잘 알려진 둠(Doom) 데모는 원시 이미지가 아니라 텍스트 텔레메트리를 Jev에 공급했다는 점은 알아둘 가치가 있습니다.
의사결정 모델은 유용하지만, 과대평가하고 싶지는 않습니다.
기억해야 할 주요 한계는 다음과 같습니다:
AI 의사결정 모델은 답변을 생성하는 대신 후보를 점수화한다는 오래된 아이디어를 훨씬 쓰기 쉽게 만들었습니다.
학습 데이터가 필요 없고, 형식화된 답을 받으며, 여러 질문을 한 번에 할 수 있습니다.
제 생각에 진짜 혁신은 이러한 패키징입니다.
의사결정 모델은 LLM 주변에서 빠르고 저렴한 게이트로 자리 잡아, 간단한 결정을 처리하고, 실제로 글을 써야 할 때만 비용이 큰 모델이 동작하게 될 것입니다.
Top DataCamp Courses
트랙
트랙
실습 문제하고 트랙하세요.
Google로 계속하기