
Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleBayangkan Anda duduk di restoran dan pelayan bertanya, “Air biasa atau berkarbonasi?” Anda tidak menjawab dengan paragraf tentang preferensi hidrasi; Anda memilih salah satu dari dua opsi yang diberikan.
Sekarang pikirkan bagaimana kita menggunakan large language model (LLM) di sebagian besar aplikasi saat ini. Kita menanyakannya, “Apakah tiket dukungan ini tentang penagihan, pengiriman, atau pengembalian?” dan model membalas dengan kalimat lengkap, yang kemudian harus kita uraikan dengan kode. Padahal realistisnya, hanya ada tiga jawaban yang mungkin, tetapi kita tetap membayar untuk seluruh proses berpikir.
Inilah celah yang coba diisi oleh jenis model baru ini. Pada September 2026, sebuah startup bernama TypeSafe AI merilis Jev, sebuah model yang sama sekali tidak menulis teks.
Alih-alih, ia memberi skor pada satu set jawaban tetap dan memberi tahu seberapa mungkin masing-masing jawaban. Dalam beberapa minggu, OpenAI, Cloudflare, Perplexity, dan Microsoft juga merilis versi mereka sendiri, menunjukkan betapa cepatnya bidang ini bergerak.
Dalam artikel ini, saya ingin membahas apa itu model keputusan AI, bagaimana cara kerjanya, dan dari mana sebenarnya ide ini berasal (jauh lebih tua daripada yang disarankan hype ini). Saya juga akan melihat temuan tolok ukur independen.
if.Model keputusan AI adalah model yang menerima input dan serangkaian jawaban yang diizinkan dan mengembalikan probabilitas dari setiap jawaban, tanpa menghasilkan teks bebas.
Gagasan utama dari model-model ini adalah bahwa keluarannya sudah terstruktur.
Anda tidak pernah perlu mengurai sebuah kalimat karena model hanya bisa mengembalikan salah satu jawaban yang Anda sediakan. Ini berarti hasilnya bisa langsung masuk ke pernyataan if di kode Anda.
Saya suka memikirkan perbedaannya sebagai dua jenis ujian.
Sebuah large language model mengerjakan ujian esai, menulis jawabannya kata demi kata, sedangkan model keputusan mengerjakan ujian pilihan ganda dan juga memberi tahu seberapa yakinnya untuk setiap kotak (skor kepercayaan).
Jev dan sebagian besar alternatif Jev mendukung tiga jenis pertanyaan:
TypeSafe juga memiliki tipe Box eksperimental untuk melokalisasi objek dalam gambar, yang akan saya lewati di sini.
Berikut contoh dari dokumentasi TypeSafe sendiri.
Anda bisa mengirim state (yang merupakan teks yang ingin Anda jadikan fokus model) dan peta questions. Untuk pertanyaan choice, setiap opsi disertai deskripsi singkat di bidang bernama criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Dan ini adalah responsnya:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Tidak ada teks yang perlu diurai.
Anda mendapatkan opsi terpilih, probabilitas untuk setiap opsi, dan nilai kepercayaan yang diturunkan dari probabilitas teratas, sehingga distribusi yang lebih datar berarti kepercayaan lebih rendah. Dalam dokumentasi, tiket yang lebih berantakan yang menyebutkan ukuran salah dan biaya ganda membagi probabilitas antara returns (0,61) dan billing (0,35), dan kepercayaannya turun ke 0,42.
TypeSafe menggambarkan Jev sebagai “System One Model,” meminjam dari buku Daniel Kahneman Thinking, Fast and Slow. Mengapa demikian?
Dengan bahasa yang sangat sederhana, Sistem 1 adalah penilaian cepat berdasarkan intuisi, dan Sistem 2 adalah penalaran lambat selangkah demi selangkah.
Model keputusan dimaksudkan menjadi yang cepat.
Satu catatan: Sistem 1 juga bagian otak kita yang membuat kesalahan cepat, dan sebagai kredit bagi TypeSafe, dokumennya sendiri secara terbuka mencantumkan di mana Jev salah. Kita akan kembali ke hal ini nanti.
Satu hal yang membingungkan saya saat pertama membaca ini adalah bahwa “model keputusan” sudah berarti beberapa hal lain. Ini bisa merujuk pada:
Jadi agar jelas, dalam artikel ini, “model keputusan” hanya berarti kategori baru model yang dirilis pada akhir 2026 yang memberi skor pada jawaban bertipe alih-alih menulis teks.
Sebelum membahas bagaimana model keputusan bekerja, ada baiknya melihat bagaimana LLM normal menghasilkan jawabannya. Menurut saya ini memudahkan melihat perbedaannya.
Sebuah large language model bekerja dalam sebuah loop.
Ia mengubah teks kita menjadi token, memprediksi probabilitas untuk setiap token dalam kosakatanya, memilih satu, menambahkannya ke teks, lalu mengulang.
Setiap token tambahan dalam jawaban berarti satu forward pass lagi melalui model.
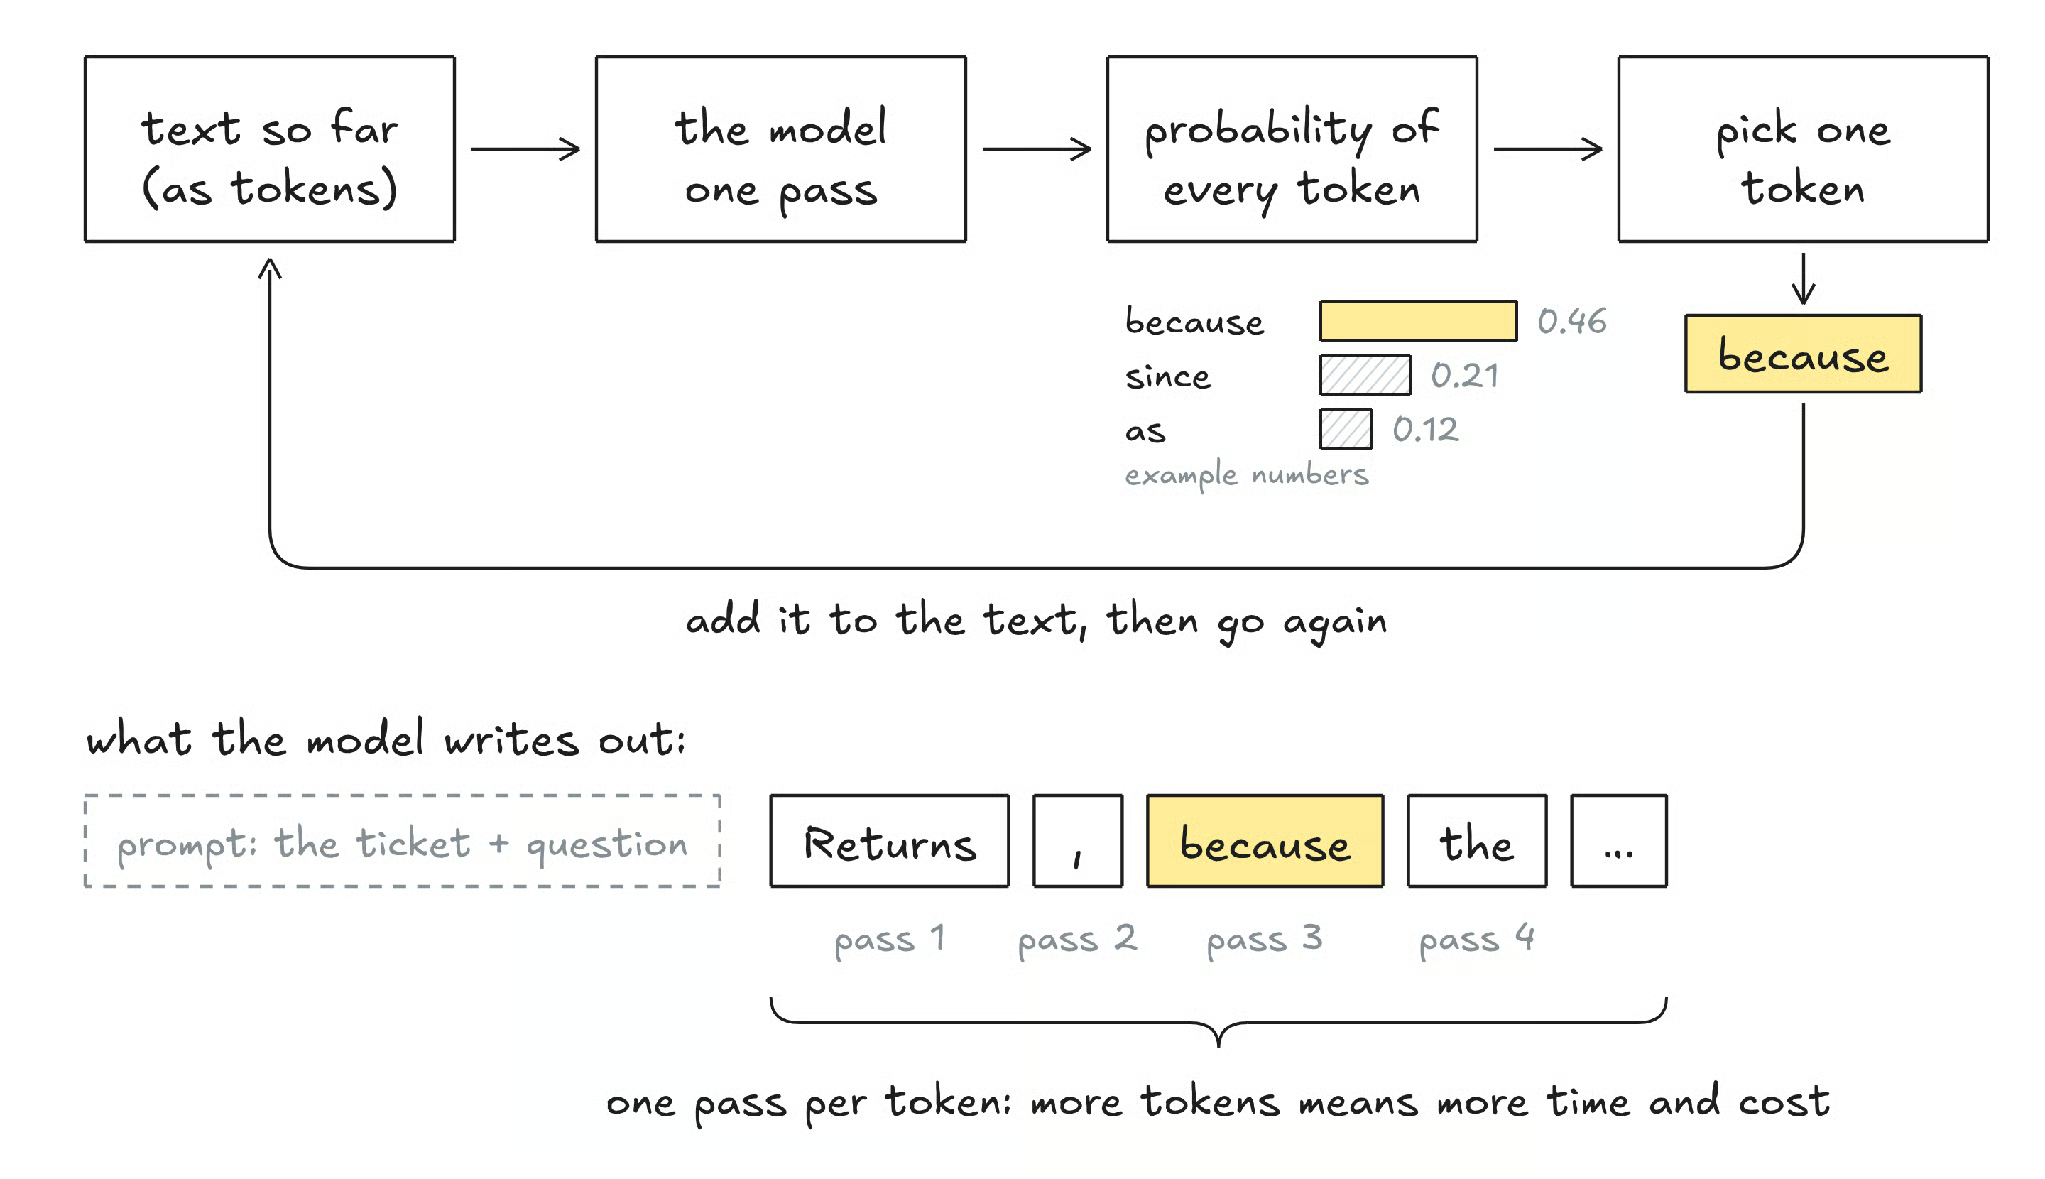
Gambar 1: Sebuah LLM membutuhkan satu forward pass untuk setiap token yang ditulisnya. Gambar asli oleh penulis.
Loop ini bekerja baik untuk menulis email, kode, atau penjelasan, tetapi untuk keputusan sederhana, ini bisa menimbulkan beberapa masalah:
Model keputusan mencoba memperbaiki masalah-masalah inilah.
Sekarang mari masuk ke mekanismenya.
Ada tiga ide yang perlu dipahami di sini:
Mari kita lihat masing-masing secara singkat.
Sebuah model keputusan membaca input dan pertanyaan Anda lalu menghasilkan skor untuk setiap jawaban yang diizinkan.
Skor tersebut biasanya diubah menjadi probabilitas menggunakan fungsi softmax. Seperti yang bisa ditebak, tidak ada loop panjang karena tidak ada yang perlu ditulis.
Dokumentasi TypeSafe juga menyebutkan bahwa pertanyaan dalam satu permintaan dievaluasi secara paralel, sehingga menambah pertanyaan hampir tidak mengubah waktu respons.
Di sinilah sebagian besar kecepatan berasal, dan TypeSafe mengatakan Jev biasanya merespons sekitar 70 hingga 500 milidetik.
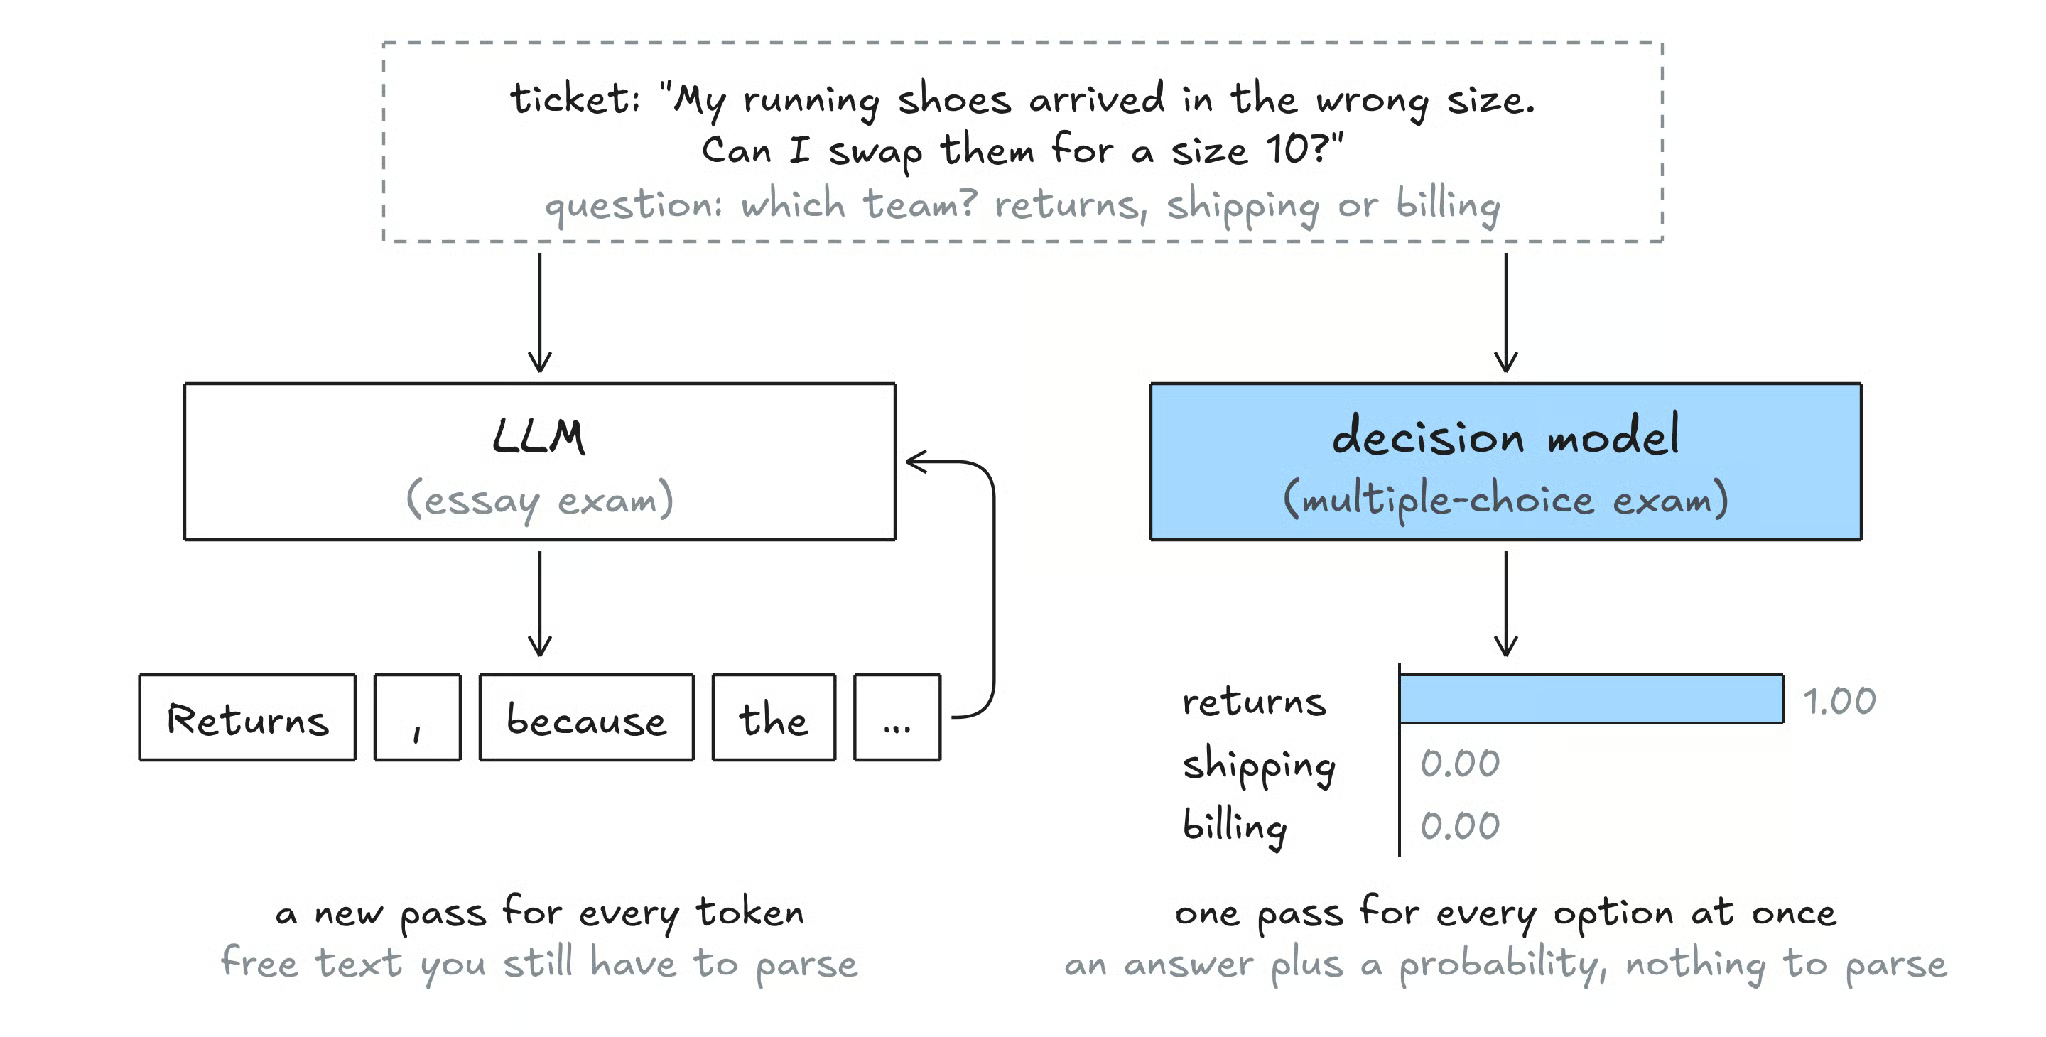
Gambar 2: Tiket yang sama, dijawab oleh LLM dan oleh model keputusan. Gambar asli oleh penulis.
Tidak ada satu “arsitektur model keputusan” tunggal.
TypeSafe belum memublikasikan cara kerja Jev, tetapi kira-kira ada tiga cara untuk mendapatkan skor ini:
Tidak perlu pusing mana yang digunakan di mana: ketiganya berakhir di tempat yang sama, yakni sebuah angka untuk setiap jawaban yang diizinkan.
Ini bagian yang menurut saya paling penting, jadi izinkan saya memberi contoh.
Bayangkan sebuah model mengatakan “70% kemungkinan” pada 100 pertanyaan berbeda. Jika modelnya terkalibrasi dengan baik, sekitar 70 dari jawaban tersebut seharusnya benar.
Kalibrasi penting karena probabilitas yang terkalibrasi memungkinkan kita menetapkan ambang aman di kode, seperti “setujui otomatis di atas 90%, selain itu kirim ke manusia.”
Jika probabilitas tidak sesuai kenyataan, ambang tersebut tidak bermakna.
Vendor melatih ini dengan fungsi loss yang menghukum kepercayaan berlebihan.
TypeSafe menyebut metodenya Reinforcement Learning for Calibrated Decisions (RLCD), sedangkan Cloudflare menyebutkan memasangkan cross-entropy dengan Brier loss untuk model Clef-nya.
Ini mungkin mengejutkan Anda, tetapi gagasan memberi skor kandidat alih-alih menghasilkannya sudah ada selama bertahun-tahun.
Menurut saya, model keputusan adalah versi terbaru dan paling nyaman daripada sebuah penemuan benar-benar baru. Berikut keluarga model utama yang menjadi dasarnya.
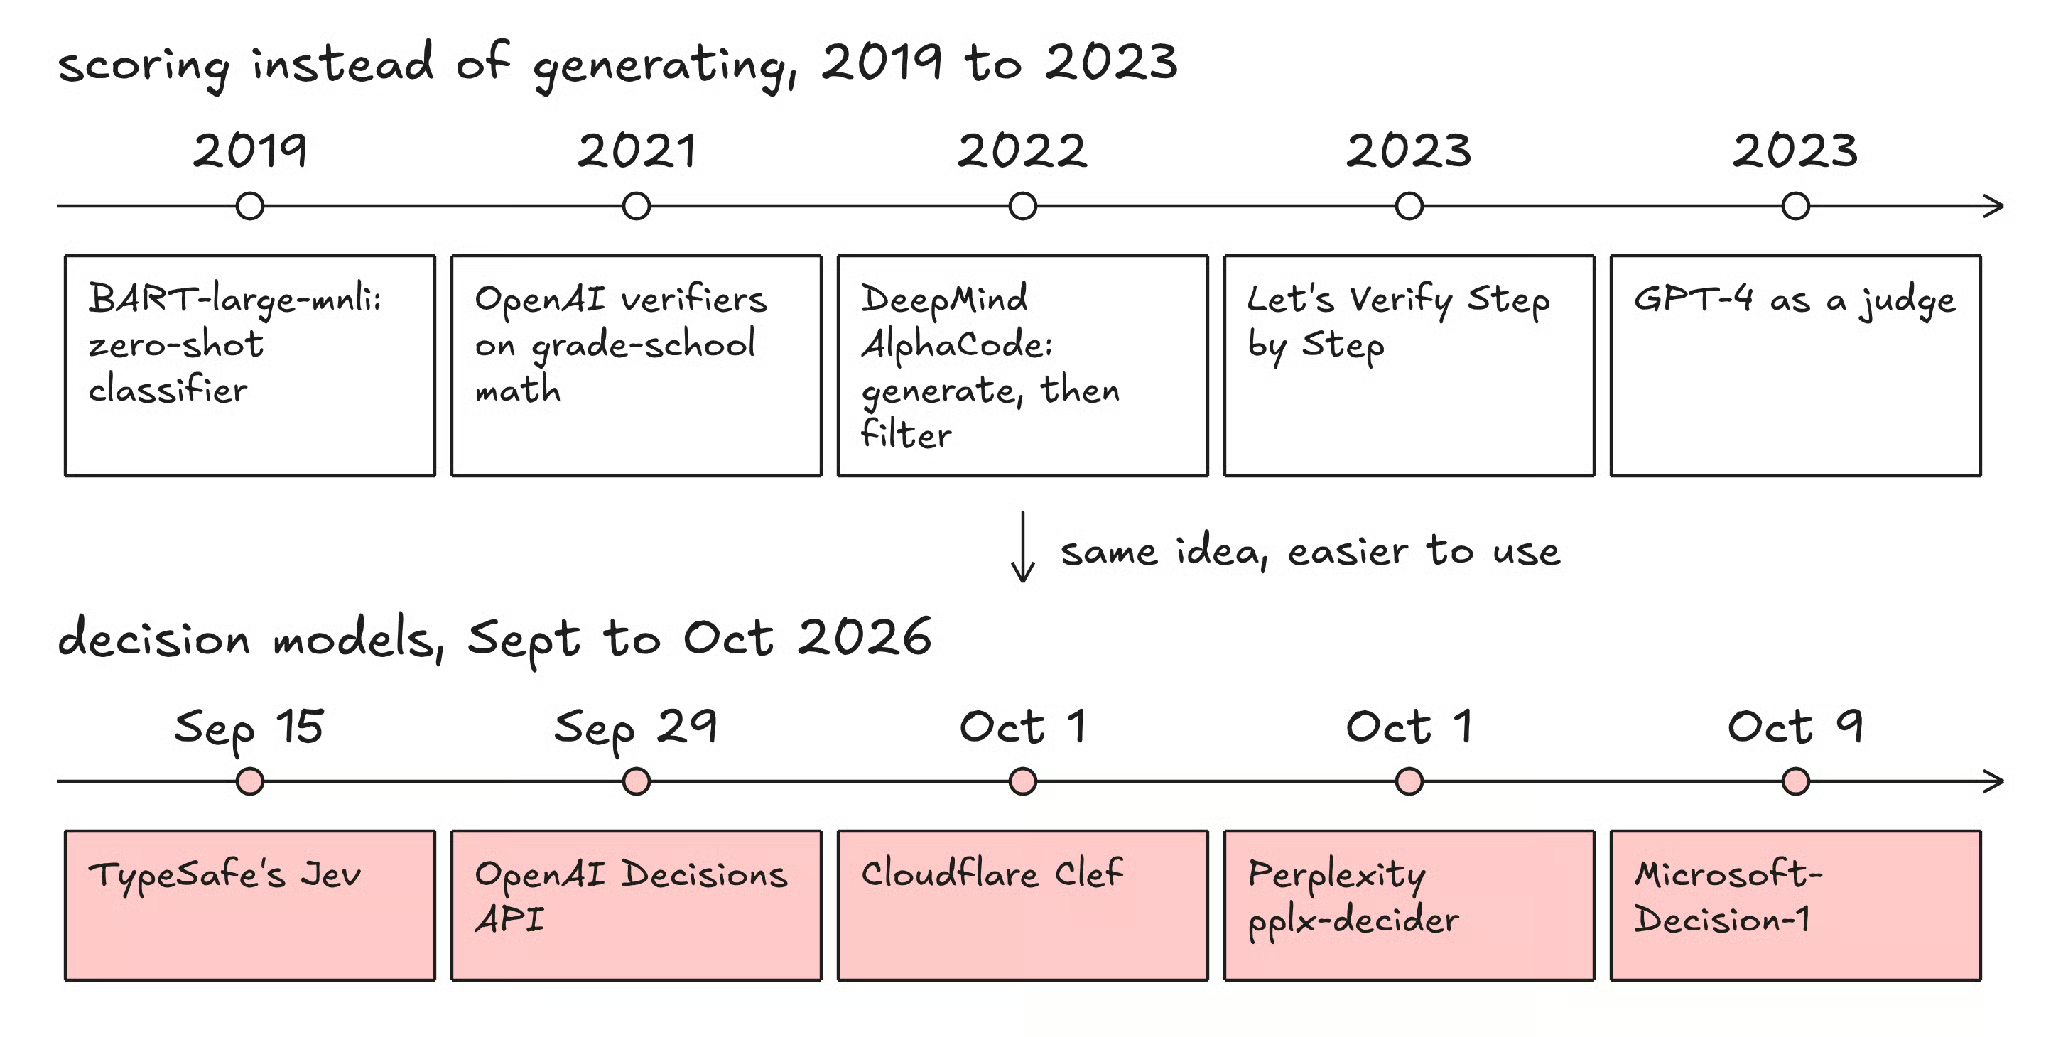
Gambar 3: Penskoran alih-alih generasi kembali ke 2019, dan model keputusan adalah versi 2026. Gambar asli oleh penulis.
Pada 2019, model seperti BART-large-mnli sudah bisa mengelompokkan teks ke label yang tidak pernah dilatih.
Mereka melakukan ini dengan memberi skor pada pernyataan seperti “teks ini tentang penagihan” untuk setiap label yang mungkin.
Tim keamanan AI Red Hat menyarankan bahwa model keputusan pada dasarnya hanyalah zero-shot classifier ini dengan nama baru.
Jika Anda pernah membangun sistem RAG, Anda mungkin pernah menggunakan salah satunya. Anda terlebih dahulu mengambil daftar pendek dengan cepat (misalnya 50 dokumen), lalu cross-encoder membaca pertanyaan Anda dan masing-masing dokumen secara bersama-sama dan memberi skor relevansi pada setiap pasangan.
Tidak ada yang dihasilkan; dokumen hanya diurutkan ulang berdasarkan skornya.
Ini adalah penilai yang memberi nilai pada jawaban yang sudah dihasilkan LLM.
Pada 2021, peneliti OpenAI menunjukkan bahwa menambahkan verifier ke model memberikan peningkatan pada matematika tingkat sekolah dasar kira-kira setara dengan membuat model 30 kali lebih besar, yang menurut saya mencolok.
Dua tahun kemudian, makalah “Let’s Verify Step by Step” menunjukkan bahwa memberi skor pada setiap langkah penalaran bekerja lebih baik daripada hanya memberi skor pada jawaban akhir.
Versi sederhananya adalah menghasilkan banyak jawaban, memberi skor masing-masing, dan menyimpan yang terbaik. AlphaCode dari DeepMind (2022) mendorong ini ke ekstrem dengan menghasilkan hingga satu juta program per masalah, membuang sekitar 99% menggunakan uji contoh, lalu mengirim hanya 10.
Dalam evaluasi simulasi pada kontes Codeforces lampau, peringkat rata-ratanya berada di 54,3% teratas dari kompetitor manusia.
Satu peringatan: jika Anda mendorong terlalu keras pada penilai yang tidak sempurna, kualitas akhirnya turun karena generator mengeksploitasi kesalahan penilai.
Istilah teknisnya adalah reward overoptimization.
Ini saat sebuah LLM besar menilai keluaran model lain.
Sebuah studi 2023 menemukan bahwa GPT-4 sependapat dengan juri manusia lebih dari 80% waktu tetapi juga memiliki bias, seperti lebih menyukai jawaban yang lebih panjang atau mana pun yang ditampilkan pertama.
Model keputusan sebagian dijual sebagai pengganti juri ini yang lebih murah dan terstruktur.
Sebuah energy-based model memberi skor “energi” rendah pada pasangan input dan jawaban yang cocok dengan baik dan skor tinggi pada pasangan yang tidak cocok.
Memilih jawaban kemudian berarti menemukan energi terendah, yang lagi-lagi adalah memberi skor kandidat.
Yann LeCun telah berpendapat selama bertahun-tahun bahwa menghasilkan token demi token bukan jalur menuju kecerdasan sejati, dan bahwa pendekatan berbasis energi dan JEPA adalah arah yang lebih baik.
Sekarang saya ingin membahas model yang benar-benar telah dirilis. Perkembangan sangat cepat di sini, jadi saya akan menyingkat masing-masing.
TypeSafe AI adalah startup San Francisco yang didirikan oleh Diogo Almeida, mantan peneliti OpenAI, dan keluar dari mode stealth pada 15 September 2026 dengan Jev dan pendanaan awal $40 juta yang dipimpin DCVC.
Jev adalah API terkelola. Di produksi hanya menerima teks; input gambar bersifat eksperimental dan memerlukan header opt-in. Penetapan harga ditagihkan berdasarkan token input, dan output gratis, yang masuk akal ketika keluarannya hanya beberapa angka.
Jev 1.14 menyusul pada 14 Oktober, meskipun alias jev-latest masih menunjuk ke 1.13.0, versi yang diuji Red Hat nanti dalam artikel ini.
Peluncurannya ramai. Vercel mengatakan sekitar 13% tim berbayarnya mencoba Jev melalui AI Gateway dalam 24 jam pertama, meskipun saat itu gratis di gateway.
OpenAI mengumumkan Decisions API di DevDay pada 29 September 2026.
API ini bekerja dengan pertanyaan yang ditentukan pengguna yang memiliki set jawaban tetap dan dibangun di atas GPT-6 Luna. Berpindah ke beta publik pada 6 Oktober, dan juga dapat menerima gambar, yang pada Jev hanya didukung secara eksperimental.
Cloudflare merilis Clef dan Clef-flash yang lebih kecil pada 1 Oktober 2026, dengan bobot terbuka dan hosting di Workers AI. Keduanya dibangun di atas model Qwen dan menerima permintaan bergaya Jev, sehingga kode yang ditulis untuk Jev dapat diarahkan ke Clef dengan sangat sedikit perubahan.
| Model | Pembuat | Rilis (2026) | Akses | Detail penting |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 Oktober | Bobot terbuka dan API | Laporan diri 85,71% vs 84,51% milik Jev pada panel 11 tolok ukur milik Perplexity sendiri |
| Microsoft-Decision-1 | Microsoft | 9 Oktober | Pratinjau Foundry | Model Qwen 9B pasca-pelatihan |
| Laya | Convai Innovations | September | Bobot terbuka | Kecil (421M parameter), berjalan di CPU laptop; kartu modelnya menyebutnya basis untuk spesialisasi, bukan mesin zero-shot |
Yang benar-benar menonjol bagi saya saat menyusun bagian ini adalah bahwa sebagian besar model open dan big-tech di sini adalah versi LLM normal yang di-fine-tune. Laya adalah pengecualian: ia adalah encoder dengan kepala keputusan. Internal Jev tidak diungkapkan.
Menurut saya, ini mendukung gagasan bahwa inovasi sebenarnya adalah pengemasan (yaitu antarmuka dan pelatihan untuk kalibrasi) daripada sekadar arsitektur baru.
Cara paling jelas untuk memutuskan kapan menggunakan yang mana adalah perbandingan:
| Fitur | LLM | Model keputusan | Classifier yang di-fine-tune | LLM + verifier |
|---|---|---|---|---|
| Keluaran | Teks bebas | Jawaban bertipe dan probabilitas | Label tetap | Terbaik dari beberapa jawaban yang dihasilkan |
| Butuh data berlabel | Tidak | Tidak | Ya | Sering |
| Kecepatan | Detik | Puluhan hingga ratusan milidetik | Sangat cepat | Paling lambat |
| Jawaban di luar format | Mungkin | Tidak mungkin | Tidak mungkin | Tergantung generator |
| Menjelaskan jawabannya | Ya | Tidak | Tidak | Ya |
| Paling cocok untuk | Penulisan, kode, penalaran | Routing, triase, guardrail | Satu tugas tetap ber-volume tinggi | Matematika, kode dengan tes |
Aturan praktis kasar saya seperti ini:
Saya percaya sistem terbaik mencampur semuanya.
Saya bisa melihat model keputusan bertindak sebagai “gerbang” cepat di sekitar LLM. Sebuah gerbang memutuskan:
Dengan begitu, LLM yang mahal hanya berjalan saat sesuatu benar-benar perlu ditulis.
Bagian ini paling penting, karena sebagian besar angka besar yang Anda lihat online berasal dari vendor sendiri. Bahkan TypeSafe mengakui bahwa keunggulan kecepatan dan biaya utamanya berada di sisi atas dari apa yang akan Anda lihat dalam penggunaan nyata.
Pada Oktober 2026, tim keamanan AI Red Hat membandingkan sembilan set guardrail pada dua tugas: menangkap injeksi prompt dan menangkap konten tidak aman.
DiffusionGemma adalah model difusi teks Gemma yang dilayani melalui vLLM.
Berikut hasil paling menarik:
| Metode | Tipe | Akurasi injeksi prompt | Akurasi keselamatan konten |
|---|---|---|---|
| deberta-v3-base | Classifier yang di-fine-tune | 89,01% | - |
| granite-guardian-hap-125m | Classifier yang di-fine-tune | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Model keputusan (open) | 87,72% | 85,53% |
| Jev | Model keputusan | 86,35% | 86,20% |
| Laya | Model keputusan (open) | 85,44% | 57,87% |
| BART-large-mnli | Zero-shot classifier 2019 | 61,49% | 68,67% |
Jev berada di urutan pertama untuk keselamatan konten, unggul 0,67 poin persentase dari DiffusionGemma (juri Qwen ketiga), dan juri Qwen berada di urutan pertama untuk injeksi prompt.
Pembagian itu yang membuat Red Hat tetap bisa mengatakan model keputusan tidak menunjukkan peningkatan kualitas atas juri LLM secara keseluruhan.
Tetapi hal yang paling menarik bagi saya adalah bahwa classifier 200 juta parameter hanya tertinggal 0,3 poin persentase pada injeksi prompt, dengan latensi median di bawah 100 milidetik dibanding sekitar 348 pada Jev.
Latensi Jev termasuk perjalanan lintas Atlantik, karena pengujian dijalankan dari Inggris dan server TypeSafe berada di AS.
Lompatan itu hanya menjelaskan kesenjangan dengan model CPU lokal. Qwen, Nemotron, dan DiffusionGemma juga berjalan di kluster AS, dan Qwen masih lebih cepat daripada Jev.
Meski begitu, Red Hat menyimpulkan bahwa model keputusan tidak memberikan jawaban yang lebih cepat, lebih murah, atau lebih baik daripada LLM-as-a-judge dalam pengujian mereka, kecuali Laya, yang ukurannya kecil adalah keunggulan nyata jika Anda bisa menyiasati batasannya dengan prompt.
Sebuah makalah riset dari para peneliti universitas, diposting ke arXiv pada September 2026, menguji Jev pada 44 tolok ukur alignment.
Hasilnya campuran dengan cara yang menarik:
Saya pikir poin prediksi selektif ini sangat berguna dalam praktik.
Ini menunjukkan bahwa desain sederhana di mana model keputusan menangani kasus mudah dan meneruskan yang tidak pasti ke LLM atau manusia adalah strategi yang baik.
Sekarang mari kita bangun model keputusan sendiri.
Kita akan mengubah LLM open-source kecil menjadi model keputusan menggunakan trik probabilitas token dari sebelumnya lalu memeriksa apakah kita benar-benar bisa mempercayai probabilitasnya.
Pertama, kita perlu memasang paket-paket ini (semua ini bisa dijalankan di notebook Colab gratis):
pip install transformers torch datasets sentence-transformers numpyKita akan menggunakan Qwen2.5-0.5B-Instruct, yang cukup kecil untuk berjalan di CPU.
Idenya sederhana: kita memberi label opsi dengan huruf, menjalankan model sekali, dan hanya melihat probabilitas huruf-huruf tersebut sebagai token berikutnya.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Perhatikan bahwa kita tidak pernah memanggil generate(). Kita melakukan satu forward pass, menyimpan skor untuk “A”, “B”, “C”, dan seterusnya, lalu membuang sisanya.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Dan memang itu saja. Kita baru saja membuat model keputusan yang berfungsi dalam sekitar 30 baris.
Pertanyaan ya/tidak pada dasarnya adalah pertanyaan choice dengan dua opsi.
Sekarang mari lihat di mana versi sederhana ini mulai kesulitan.
Coba acak urutan opsi dan jalankan pertanyaan yang sama lagi:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Pada input berantakan seperti ini, kita sering melihat probabilitas bergeser hanya karena opsi dipindahkan.
Ini disebut bias urutan, dan TypeSafe memang mencantumkan kecenderungan ke opsi pertama sebagai salah satu kelemahan Jev yang diketahui.
Anda juga mungkin melihat model sering memberikan jawaban hampir 100%. Berryman menjalankan uji bagus pada Jev sendiri, di mana ia memberi tahu sebuah koin mendarat sisi gambar 60% dari waktu, dan pertanyaan ya/tidak mengembalikan 0,58, yang mendekati.
Tetapi pertanyaan choice (“gambar atau angka?”) mengembalikan 0,99 untuk gambar, karena probabilitas runtuh ke jawaban yang lebih mungkin.
Ini langkah yang menurut saya sebaiknya dijalankan semua orang. Kita akan mengambil 400 item berita dari dataset AG News (masing-masing adalah judul plus deskripsi singkat), yang memiliki empat topik, lalu memeriksa apakah probabilitas kita sesuai kenyataan.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Berikutnya, kita perlu cara mengukur kalibrasi. Expected calibration error (ECE) mengelompokkan prediksi ke dalam bin kepercayaan dan memeriksa seberapa jauh rata-rata kepercayaan di tiap bin dari akurasi sebenarnya.
Perlu diperjelas, semakin rendah semakin baik:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Ini triknya.
Kita membagi data menjadi dua, menggunakan separuh pertama untuk mencari temperatur yang membuat probabilitas lebih jujur, lalu menguji pada separuh kedua.
Temperatur di atas 1 melunakkan prediksi yang terlalu percaya diri, sedangkan temperatur di bawah 1 mempertajam prediksi yang terlalu ragu.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Akurasinya tidak berubah, karena membagi dengan temperatur tidak mengubah opsi mana yang berada di peringkat pertama.
Hanya kepercayaan yang berubah.
Angka pasti Anda akan bergantung pada run Anda, tetapi ECE pada bagian uji biasanya akan turun. Dengan hanya 200 item uji, estimasinya berisik, jadi jangan terlalu menganggap serius perbedaan kecil.
Pelajarannya sederhana: model yang terkalibrasi pada data orang lain tidak berarti terkalibrasi pada data Anda.
Untuk menunjukkan betapa umum ide “beri skor, jangan hasilkan” ini, berikut hal yang sama dalam pengaturan RAG.
Sebuah cross-encoder memberi skor setiap potongan teks terhadap pertanyaan dan kita tinggal mengurutkannya:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Sekali lagi, tidak ada yang dihasilkan: model hanya memberi angka untuk setiap kandidat.
Berikut use case yang paling sering muncul:
| Use case | Bagaimana model keputusan membantu |
|---|---|
| Routing agen | Memutuskan alat atau sub-agen mana yang harus menangani langkah berikutnya. |
| Guardrail | Menandai injeksi prompt atau konten tidak aman sebelum mencapai LLM. |
| Triase dukungan | Merutekan tiket berdasarkan tim, topik, dan urgensi. |
| Penerimaan dokumen | Menjawab daftar periksa pertanyaan tetap tentang setiap dokumen. |
| Pencarian dan RAG | Mengurutkan ulang potongan yang diambil berdasarkan relevansi. |
| Kredit dan penipuan | Memberi skor risiko, meski keputusan tentang orang sebaiknya tetap melibatkan tinjauan manusia. |
| Robotika | Bisa bertindak sebagai lapisan cepat antara perencana LLM yang lambat dan kendali motor tingkat rendah, meski ini masih spekulatif. |
Poin robotika adalah yang paling saya sukai secara pribadi.
Berryman menyarankan model seperti Jev bisa duduk di antara LLM lambat yang membuat rencana tingkat tinggi dan model kinematika yang menggerakkan sendi robot.
Namun perlu diketahui, demo Doom TypeSafe yang terkenal memberi Jev telemetri teks alih-alih citra mentah.
Model keputusan bermanfaat, tetapi saya tidak ingin melebih-lebihkan.
Berikut keterbatasan utama yang saya temukan untuk diingat:
Model keputusan AI mengambil ide lama tentang memberi skor kandidat alih-alih menghasilkan jawaban, dan membuatnya jauh lebih mudah digunakan.
Anda tidak membutuhkan data pelatihan; Anda mendapat jawaban bertipe, dan Anda bisa menanyakan banyak pertanyaan sekaligus.
Menurut saya, pengemasan inilah inovasi sebenarnya.
Saya memperkirakan model keputusan akan duduk di sekitar LLM sebagai gerbang cepat dan murah yang menangani keputusan sederhana, sehingga model yang mahal hanya berjalan saat sesuatu benar-benar perlu ditulis.
Kursus Teratas di DataCamp
Program
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




